Cross-view Transformers for real-time Map-view Semantic Segmentation

Сегодня обсудим статью о том, как решить задачу BEV-сегментации в camera-only-режиме.

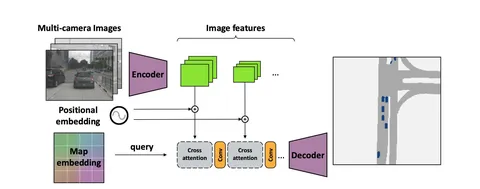
Авторы используют данные нескольких камер, информацию об их фокусном расстоянии, повороте и расположении. Изображения с камер эмбеддятся и складываются с позиционными эмбеддингами: MLP поверх вектора, посчитанного с помощью информации о положении камеры. Он сонаправлен с осью объектива и проходит сквозь кодируемый пиксель.

Подход позволяет сэкономить время работы модели: учесть положение камеры относительно эго-машины и окружающего мира, не восстанавливая глубину эксплицитно.

Эмбеддинг BEV’а для каждой камеры свой. Это разность выучиваемого позиционного эмбеддинга BEV’а и MLP поверх позиции камеры относительно окружающего мира. Так query приводят в ту же модальность, что и позиционные эмбеддинги для изображений.

Авторы используют два блока с cross-attention’ом с последующим свёрточным слоем, чтобы модель глубже изучила данные. Учитывают q — эмбеддинг BEV’а, k — сумму позиционных эмбеддингов и фичей изображений, v — просто фичи изображений. В итоге за счёт скалярного произведения внутри attention’а предполагается, что модель учится имитировать косинусную близость между BEV’ом и информацией с камер, указывая каждой ячейке BEV-а на релевантную визуальную информацию.

В конце декодер из свёрток и upsample-блоков расшифровывает выход трансформера в плотную карту, для которой выполняется сегментация.

Благодаря отказу от реконструкции глубины авторам удалось добиться SOTA-результатов: x4 к скорости по сравнению с предыдущим топовым методом.

Разбор подготовила ❣️ Алина Речина
404 driver not found
329 просмотров · 7 реакций Открыть в Telegram · Открыть пост на сайте
DaViT: Dual Attention Vision Transformers

Одна из актуальных задач персепшна — разработка архитектуры, способной одновременно улавливать глобальный контекст и эффективно обрабатывать изображения высокого разрешения. iGPT, методы оптимизации и другие современные подходы чаще всего заключаются в поиске компромисса между качеством, полнотой контекста и вычислительной сложностью.

Сегодня разберём статью о принципиально новом механизме селф-аттеншна на уровне всего изображения — DaViT. В отличие от ViT и его модификаций, работающих с пикселями или патчами, это решение учитывает глобальный контекст, сохраняя при этом вычислительную эффективность относительно пространственного размера изображения.

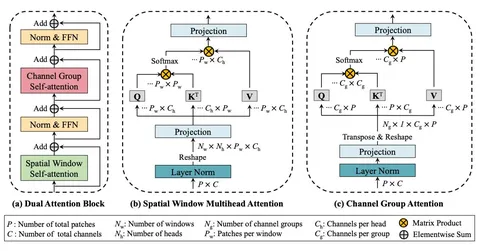
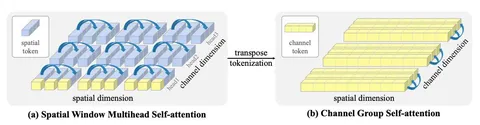
В основе модели — всё тот же трансформер ViT, но с дополнительной особенностью. Токен всего канала изображения хранится в специальных channel-токенах. По сути это транспонированная версия spatial-токенов.

Рассмотреть архитектуру в подробностях можно на верхней схеме. Она включает два трансформер-блока: пространственного и группового селф-аттеншнов. Благодаря попеременному применению двух этих типов внимания, модель одновременно улавливает и локальные небольшие взаимодействия, и глобальные изменения на уровне всего изображения. На нижней схеме — механизм внимания модели.

Кроме того, DaViT работает не квадратично, как ViT и Swin, а за линейное время от размера токена. Этого удалось добиться, группируя channel-токены. В результате DaViT обогнала Swin и другие топовые модели по скорости и качеству на задачах классификации, детекции и сегментации.

Без обучения на дополнительных данных версии ВDaViT-Tiny (28,3M параметров), DaViT-Small (49,7M) и DaViT-Base (87,9M) продемонстрировали 82,8%, 84,2%, и 84,6% — топ-1 точности ImageNet-1K на момент публикации. При дальнейшем масштабировании DaViT на 1,5B парах «текст+изображение» DaViT-Gaint достигает 90,4% точности.

Код доступен на GitHub авторов.

Разбор подготовил ❣️ Давид Дигмелов
404 driver not found
679 просмотров · 28 реакций Открыть в Telegram · Открыть пост на сайте
Mask2Map: Vectorized HD Map Construction Using Bird's Eye View Segmentation Masks

Что будет, если объединить лучшие практики из Deformable-DeTR, DN-DeTR, Mask2Former, MapTR и MapTR v2? Узнаем из статьи о Mask2Map — методе построения векторных HD-карт по данным автомобильных сенсоров.

Главная идея довольно проста: получить хорошее представление дорожной разметки в виде BEV-масок, а затем использовать эти маски как геометрическую подсказку для векторного декодера.

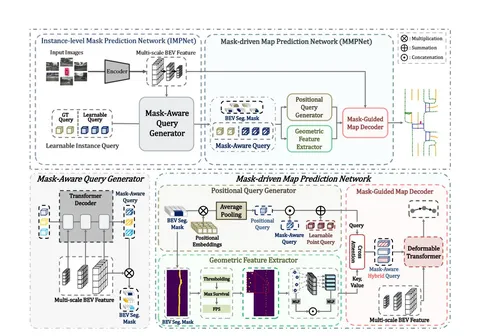
Mask2Map состоит из двух основных частей:

🔴 IMPNet строит instance-level сегментацию по BEV-фичам сенсоров и формирует маски вместе с соответствующими query.

🔴 MMPNet превращает эту информацию в векторные элементы карты: предсказывает их класс, геометрию и порядок точек.

Пайплайн начинается с построения BEV-представления. Фичи от сенсоров переводят в BEV и обрабатывают на нескольких масштабах. Дальше Mask2Former-подобная часть выполняет инстанс-сегментацию: получает собственную маску и эмбеддинг объекта для каждого элемента карты.

После этого плотную маску нужно превратить в компактное геометрическое представление. Для этого её бинаризуют, прореживают скользящим окном, оставляя репрезентативные точки, и в конце применяют Farthest Point Sampling (FPS). В результате вместо большого числа пикселей остаётся небольшой набор пространственных координат (x, y).

Параллельно модули PQG и GFE формируют query и добавляют в них семантическую и геометрическую информацию из BEV. Идея в том, чтобы дать декодеру более осмысленную стартовую точку, чем полностью свободные обучаемые эмбеддинги.

Дальше всё это попадает в Mask-Guided Map Decoder. Полученные из масок точки используются как геометрические подсказки и опорные точки для деформируемого кросс-аттеншна, после чего декодер восстанавливает итоговую векторную геометрию элементов HD-карты.

Если совсем упростить, архитектуру можно представить так: сенсоры → BEV → instance masks → опорные точки → vector map. То есть левая часть Mask2Map во многом напоминает Mask2Former, а правая — MapTR/Deformable DETR, связанные BEV-масками, которые дают векторному декодеру сильный spatial prior.

Вместо того чтобы заставлять DETR-подобный декодер полностью с нуля искать геометрию дорожных элементов, авторы сначала решают более простую задачу сегментации, а затем используют её результат для инициализации и направления векторного предсказания.

Отдельно во время обучения используется знакомая по DN-DETR идея расшумления queries: GT-объекты искусственно зашумляются, после чего модель учится восстанавливать исходную геометрию. Это помогает стабилизировать обучение и облегчает сопоставление query с объектами карты.

По результатам авторов Mask2Map на момент публикации заметно превосходил предыдущие методы на nuScenes и Argoverse2: прирост составлял до 10,1% mAP и 4,1% mAP. Познакомиться с кодом можно на GitHub проекта.

Разбор подготовил ❣️ Денис Глазов
404 driver not found
826 просмотров · 21 реакций Открыть в Telegram · Открыть пост на сайте
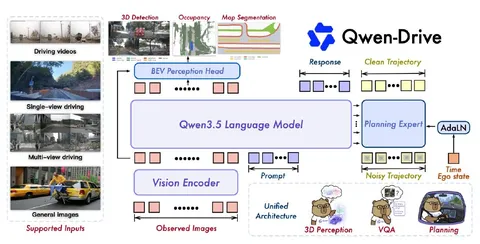
Qwen-Drive-1.0: An Initial Step towards a Vision-Language Foundation Model for Autonomous Driving

Современные подходы к автономному вождению часто разделяют восприятие, предсказание и планирование на отдельные модули. Но сейчас всё больше моделей переходят на end-to-end-предсказание с дообучением VLM под задачи вождения.

В частности, 31 августа команда Alibaba выпустила Qwen‑Drive‑1.0 — собственную модель в этой области. Это интересный релиз, потому что команда Qwen — один из безусловных лидеров в мире опенсорсных VLM, но это её первый заход в модели для вождения.

Авторы стартуют с Qwen3.5-4B и дообучают её, исходят из ключевых дизайн-принципов:

🔴 Для длинного хвоста ситуаций нужно минимально менять исходную VLM так, чтобы она при этом продолжала справляться с общими темами.
🔴 Для хорошего понимания сцены важны подзадачи 3D-реконструкции и разнообразный visual QA.

Чтобы достичь этого, предобученную VLM усилили двумя элементами:

🔴 BEV-голова для персепшна извлекает явную 3D-информацию: детекция объектов, предсказание occupancy, сегментация карты.
🔴 Planning Expert генерирует будущую траекторию эго-автомобиля на основе представлений VLM, используя flow matching.

Qwen‑Drive‑1.0 обучают в четыре стадии: первые две — для персепшна, следующие — для планнера.

1. Претрейн перспешна. Замораживают основную модель, обучают только новую BEV-голову на задачах 3D-детекции, occupancy, сегментации.
2. Совместное обучение персепшна и VQA. Размораживают визуальный энкодер и VLM. Обучают модель одновременно на данных для 3D-персепшна и «вопросах-ответах» по сцене вождения. Секретный ингредиент — микс данных: 64,3% составляют задачи вождения, 26% — общие задачи VAQ, 9,7% — 3D-персепшн. Это позволяет приобрести навыки вождения, не забывая общие знания.
3. Претрейн Planning Expert. Замораживают основную модель, обучают эксперта генерировать траектории.
4. Обучение с подкреплением (RL). Финально дотюнивают Planning Expert.

Собственные сырые данные почти не собирали, но смогли адаптировать широкий набор из примерно 30 публичных датасетов (включая nuScenes, Waymo WOD-E2E, NAVSIM). Многое пришлось унифицировать: например в таксономии классов объединили все типы автомобилей. Геометрию пришлось сгладить, чтобы получить одинаковую растеризацию карты и идентичные траектории на 50 точек. Для VQA-вождения многие запросы переформулировали большими умными VLM.

В итоге свои гипотезы авторы частично подтвердили: общие знания почти не проседают, бенчмарки очень близки к исходным. Понимание дорожной ситуации значительно улучшилось.

При этом Qwen-Drive-1.0 справляется с вождением так же хорошо, как специализированные end-to-end-модели. Новая модель получила PDMS 90,7 на NavSim. Это хороший результат, хотя и не SOTA: end-to-end SimWAM выбила 91,5, а модель со скорингом CLOVER — 94,5.

Интересно, что персепшн используют только для обучения, в инференсе планнера его нет. В аблэйшне авторы пробуют совсем исключить персепшн-стадию — планнер при этом работает не сильно хуже.

Модель выглядит симпатичной, авторы не бенч-максят, а честно валидируют общий подход.

Разбор подготовил ❣️ Кирилл Федянин
404 driver not found
910 просмотров · 24 реакций Открыть в Telegram · Открыть пост на сайте
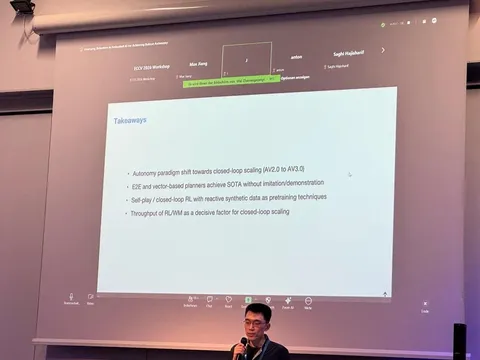
Автономный транспорт на ECCV 2026: несколько слов о долгосрочном развитии

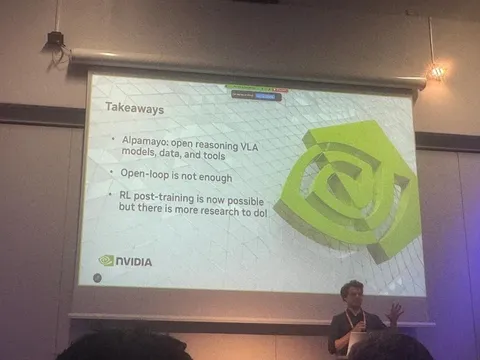
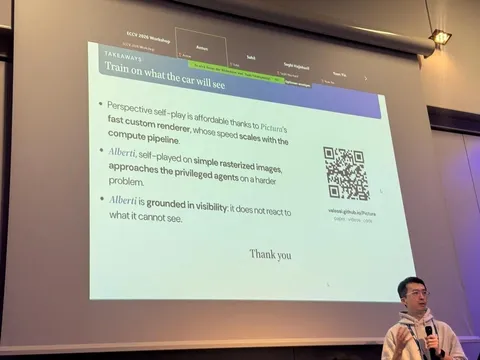
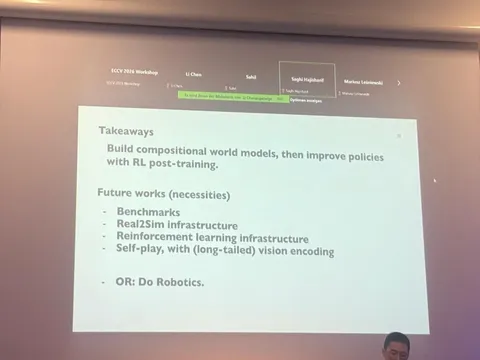
На воркшопе Emerging Behaviors for Achieving Robust Autonomy обсуждали надёжность автономного транспорта. В нескольких докладах, как из индустрии, так и из академии, чётко прослеживались одни и те же тезисы по развитию планировщиков для автономных автомобилей:

🔴 Развитие ML-планировщиков движется в сторону end-to-end-моделей.
🔴 Уже сейчас индустрия активно использует RL для обучения ML-планировщиков: пока в варианте RL post-training в симуляции. Ресёрч идëт в сторону RL-обучения с нуля, в том числе и для end-to-end-сетей.
🔴 И в индустрии, и в академии интенсивно пытаются использовать Self-play RL. Это был один из важных ингредиентов успеха AlphaGo, которая тренировалась играть сама с собой в го и в итоге впервые обыграла человека в эту игру.
🔴 Чтобы RL для end-to-end планировщика заработал, нужен быстрый симулятор с достаточно высоким качеством имитации сенсоров: без sim-to-real gap. Это пока остается исследовательской задачей. Даже NVIDIA, которая довольно далеко продвинулась в задаче симуляции сенсоров для роботов, пишет о том, что sim-to-real gap все ещё частая проблема.
🔴 Надёжный планировщик не сделать только на основе записанных логов. Симулятор должен уметь генерировать сложные случаи для обучения и тестирования. Для этого нужна эффективная world model, созданием которой занимаются и в академии, и в индустрии.

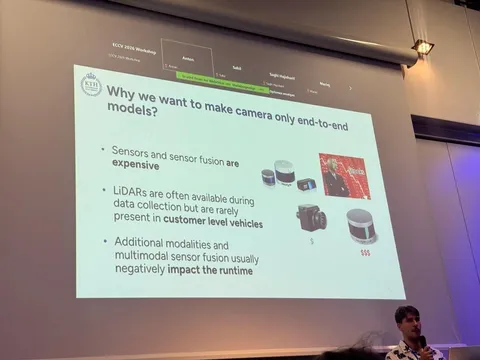
Академические боли тоже остаются прежними. В докладе PRIX: Learning to Plan from Raw Pixels for End-to-End Autonomous Driving авторы добились SOTA на нескольких бенчмарках для планировщика в автономном транспорте. Но на последнем слайде честно написали, что не могут предсказать, как модель будет вести себя в реальности, на живом роботе или автомобиле с ограниченными вычислительными возможностями. Это общая проблема академических исследований: своего флота автомобилей у них нет, а открытые бенчмарки требуют дополнительной валидации.

Наблюдениями поделился ❣️ Виктор Юрченко
404 driver not found
683 просмотров · 23 реакций Открыть в Telegram · Открыть пост на сайте
π0.5: a VLA with Open-World Generalization

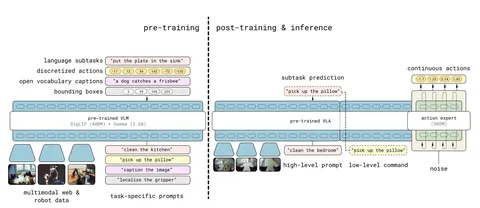
π0 — система, которая помогает делать large-scale pre-training для робототехники, где нет web-scale-датасетов. Как она устроена, рассказывали в одном из предыдущих постов. А сегодня разберём статью о новой версии системы — π0.5.

В статье речь идёт о роботах-манипуляторах, но сама идея общая задача → semantic subtask → low-level actions выглядит применимой и к другим embodied-системам — например, автономному транспорту.

Чтобы превратить π0 в π0.5, авторы придумали несколько важных вещей. Во-первых, токенайзер FAST:

🔴 переводят траектории в частотное представление с помощью discrete cosine transform (DCT),
🔴 обнуляют незначимые коэффициенты,
🔴 оставшиеся коэффициенты разворачивают в одномерную последовательность и объединяют в BPE-токены.

На этапе претрейна next-token-prediction с CE учится гораздо быстрее диффузии и легко смешивается с другими задачами для претрейна VLM (ещё вернёмся к этому). На post-train добавляется диффузионный action-эксперт, с помощью которого итоговая модель предсказывает непрерывные траектории.

Во-вторых, модель учат предсказывать не только действия, но и подзадачи. Например, «взять подушку» для задачи «убраться в спальне». Для этого используют как размеченные траектории роботов, так и обычные vision-language-данные из интернета — картинки с текстовой разметкой (их на порядки больше, чем траекторий).

Таким образом, в претрейне используют очень разнородные материалы: траектории разных роботов, задачи на предсказание высокоуровневых действий и VLM-данные из интернета. Авторы называют этот подход heterogeneous co-training и связывают с ним способность модели обобщаться на новые окружения и задачи.

Этап 1. Тело VLM претрейнят на смеси данных. Для размеченных траекторий модель сначала предсказывает текстовые токены подзадачи, а на их основе — FAST-токены траектории.

Этап 2. На пост-трейне добавляется action-эксперт. Вся модель файнтьюнится под мобильных роботов-манипуляторов с помощью CE для FAST-токенов и flow-matching loss для непрерывной траектории. При этом эксперт видит весь префикс, включая подзадачу, но не FAST-токены.

Для быстрого инференса FAST-токены уже не генерируются. Модель сначала определяет высокоуровневую подзадачу, затем эксперт предсказывает непрерывную траекторию на её основе.

Эксперименты показали, что такой подход к обучению помогает улучшить генерализацию: робосистема начинает лучше справляться с долгосрочными многошаговыми задачами. Для автономных роботов это, например, самостоятельная уборка целой комнаты в незнакомом доме.

Разбор подготовил ❣️ Сергей Репьевский
404 driver not found
1 046 просмотров · 21 реакций Открыть в Telegram · Открыть пост на сайте
BEVDiffuser: Plug-and-Play Diffusion Model for BEV Denoising with Ground-Truth Guidance

Денойзинг-диффузионки итеративно превращают нормальный шум в изображения. Но есть проблема: результат такой генерации непредсказуем. Чтобы победить это, процесс расшумления можно представить в виде нейросети, обучив её на узкоспециализированном датасете и добавив кондишнинги — например, на расположение объектов внутри сцены (layout).

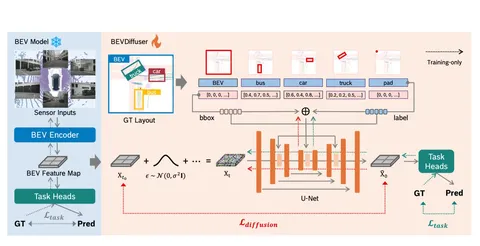
Оба этих подхода требуют обучения дополнительных моделей. Сегодня разберём статью о том, как применить layout-conditioning во время обучения диффузионки для денойзинга BEV feature, не меняя архитектуру энкодера.

Основные этапы — на схеме. После энкодера featuremap не передают в Task Heads, а расшумляют. На этом всё могло бы закончиться получением идеально расшумлённого представления, если бы не одно «но»: шум оригинальный, безошибочно восстановленных BEV map’ов нет. То есть, вместо денойзинга featuremap’ы диффузионка может сгенерировать фейковую сцену, потому что куда расшмуляться — непонятно.

Авторы предлагают считать изначальный шум достаточной оценкой того, как выглядит система без шума и оптимизироваться исходя из этого, параллельно с задачей расшумления.

Энкодер замораживают. Денойзинг-диффузионку используют как супервайзера BEV-энкодера без вмешательства в его архитектуру.

Результаты впечатляют: на момент выпуска BEVDiffuser показывал SoTA-результаты на датасете nuScenes: +12,3% в mAP и +10,1% in NDS для детекции 3D-объектов по сравнению с другими популярными моделями.

Разбор подготовила ❣️ Дарья Сапожникова
404 driver not found
1 068 просмотров · 16 реакций Открыть в Telegram · Открыть пост на сайте
Learning Rollout from Sampling: An R1-Style Tokenized Traffic Simulation Model

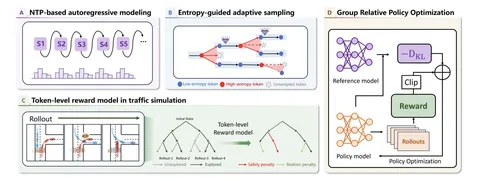
Сегодняшняя статья о том, как адаптировать RL-алгоритм GRPO к задачам автономного транспорта. Авторы проанализировали распределение энтропии для разных сцен и по результатам сформулировали следующее:

1. У сложных сцен (Waymo Hard) более высокая энтропия токенов, поэтому имеет смысл увеличить exploration.

2. В простых сценах (Waymo Easy), наоборот, излишнее семплирование вносит ненужный шум.

Лучше использовать адаптивное семплирование. Авторы предлагают вариант, где параметр K в TopK зависит от энтропии: K_t = k_min + (k_max — k_min) / (1 + e^(-H_t))

Авторы утверждают, что при таком разделении по сложности после RL уменьшается энтропия и улучшаются метрики в hard-кейсах. От себя добавлю, что не хватает ablation, какое распределение энтропии получается после обычного RL.

Отдельного внимания заслуживают выбор параметров и способ обучения:

🔴 При group-нормализации нет деления на STD, только вычитают среднее — из-за небольшого количества траекторий дисперсия может быть шумной.
🔴 Делают KL-дивергенцию на претрейн-политику (ref-политика).
🔴 В качестве ревордов используют произведение ADE_like_reward и Collision_reward.
🔴 Замораживают энкодер агентов и карты за исключением последнего слоя

Таким образом, авторы предлагают подход для эффективного баланса между exploration и exploitation. Предложенный сетап RL выглядит интересно, и некоторые идеи вполне могут работать на практике.

Разбор подготовил ❣️ Павел Лукьянов
404 driver not found
1 155 просмотров · 21 реакций Открыть в Telegram · Открыть пост на сайте
LISO: Lidar-only Self-Supervised 3D Object Detection

Разметка 3D-боксов очень дорогая, долгая и плохо масштабируется. А сырых LiDAR-логов, наоборот, очень много. Сегодня разберём статью о том, как использовать лидарные данные о движении объектов для разметки.

Сначала авторы готовят начальную разметку. Пайплайн такой:

1. По соседним LiDAR-кадрам считают ego motion — движение эго-агента.
2. Вычисляют scene flow — движение каждой точки между кадрами.
3. Вычитают ego motion из scene flow, чтобы получить residual motion — относительное движение.
4. Точки с ненулевым residual motion считают движущимися объектами.
5. Кластеризуют точки с ненулевым residual motion и собирают их в 3D-боксы.
6. Следят, как перемещаются боксы с течением времени, и чистят шум — так получается начальная разметка.

Следующий этап — итеративный self-training. Модель-детектор обучают на полученной разметке и прогоняют по начальной разметке, чтобы получить новые боксы. Потом снова строят треки, фильтруют шум, улучшают разметку и обновляют псевдо-GT. Обучение повторяется до тех пор, пока и псевдо-разметка и сама модель не улучшатся до требуемых пределов.

Хотя начальная разметка содержит только движущиеся объекты, детектор обучается на single-frame point cloud — поэтому постепенно начинает находить и способные двигаться объекты. Например, припаркованные машины. То есть движение используется только как bootstrap-сигнал, а дальше модель дообучается по геометрии сцены.

На момент публикации LISO стабильно обгонял другие self-supervised-подходы на WOD, KITTI, AV2 и nuScenes, хотя до fully-supervised-моделей ему ещё было куда расти.

Разбор подготовил ❣️ Фарух Яушев
404 driver not found
1 151 просмотров · 22 реакций Открыть в Telegram · Открыть пост на сайте
Long-Range 3D Perception — датасет и методы детекции отдалённых объектов

Сегодня вас ждёт подборка статей на тему детекции отдалённых объектов. Это важная задача, поскольку на скорости 100 км/ч автомобиль проезжает ~28 м/с, поэтому для безопасного торможения и перестроения нужно видеть препятствия на расстоянии 150–200 метров, а классические бенчмарки такую дальность обрезают. NuScenes размечен до 50–80 м, KITTI — до 70 м.

Дальние объекты — это отдельная боль: у лидара на 150 метрах на объект остаются единицы точек, на камере он занимает десятки пикселей, и в датасетах таких объектов на порядки меньше ближних, из-за чего модели переобучаются на ближнюю зону. Поэтому начнём с датасета — здесь лучше всего подходит Argoverse 2. Он содержит 1000 размеченных картиночных сцен с семью камерами, объекты размечены на удалении до 200 метров. Каждая сцена длится 30 секунд, частота — 20 fps. Датасет размечен по 30 категориям, причём почти все категории имеют более 10 000 боксов. Лидар работает на 10 Гц.

Основные методы для детекции отдалённых объектов:

LiDAR-only
FSD, FSDv2 — полностью sparse lidar-only модели. Основная идея: собрать точки в группы (соответствующие объектам) и процессить эти группы отдельно. Внутри каждой группы точки предсказывают центры объектов, которые далее используются для предсказания бокса. В v2 кластеризация в группы заменена на работу с виртуальными вокселями (локальное объединение точек). Основные результаты представлены на Argoverse 2 до 200 метров. FSDv2 показывает результаты, близкие к SoTA c latency < 100ms.

Camera-only (Far3D)
Far3Det — чтобы построить модель для отдалённых объектов, авторы решили «почистить» датасет NuScenes от сцен с неполной разметкой, оставив только те, в которых размечены все объекты вплоть до 80 метров. Также предложили вариант адаптивного NMS (AdaNMS) для изменения IoU threshold в зависимости от расстояния.

Far3D — SoTA на NuScenes в сетапе camera-only на момент публикации. Результаты на Argoverse 2 похуже, чем у FSDv2, но это sparse camera-only модель. На основе StreamPETR построена модель, в которой используются адаптивные query. Для их генерации на этапе LSS лучи кидаются на основе 2D-детекций.

Fusion
Towards Long-Range 3D Object Detection for Autonomous Vehicles — статья с двумя улучшениями для детекции отдалённых объектов. Во-первых, это использование двух отдельных сетей для ближних (до 110 м) и отдалённых (от 100 м) объектов с фьюзом детектов на пересечении. Во-вторых, авторы используют Multimodal Virtual Point для генерации псевдолидарных точек на основе 2D Instance Segmentation. Результаты посчитаны для Argoverse 2: каждый из фиксов улучшает FSDv2;

SparseFusion — по сути является sparse-версией BEVFusion. Для обеспечения разреженности все свёрточные операции заменены на sparse. На этапе LSS берутся только top K расстояний из распределения вдоль лучей. Сами лучи кидаются только внутри боксов 2D-детекций. Результаты сравниваются на Argoverse 2. По метрикам SparseFusion немного переигрывает BEVFusion, при этом по latency метод более чем в три раза быстрее. Но на срезе 100–200 метров результаты у BEVFusion чуть лучше.

Что в итоге выбрать?
• LiDAR-only — FSDv2: результаты близкие к SoTA на Argoverse 2 при latency < 100 мс, самый практичный вариант для продакшена.
• Camera-only — Far3D: SoTA на nuScenes, но на Argoverse 2 заметно уступает лидарным методам — камер пока недостаточно для надёжной детекции на 200 м.
• Fusion — SparseFusion: в 3+ раза быстрее BEVFusion при сопоставимом качестве, но на срезе 100–200 м dense-подход всё ещё чуть точнее — на дальности разреженность даёт о себе знать.

Общий тренд хорошо виден: работают sparse-архитектуры вкупе с адаптивными приёмами (AdaNMS, адаптивные query, отдельные головы для разных дальностей). А среди датасетов Argoverse 2 с разметкой до 200 м фактически стал стандартом для long-range задач.

Разбор подготовил ❣️ Иван Лунев
404 driver not found
1 238 просмотров · 23 реакций Открыть в Telegram · Открыть пост на сайте
FutrTrack: A Camera-LiDAR Fusion Transformer for 3D Multiple Object Tracking

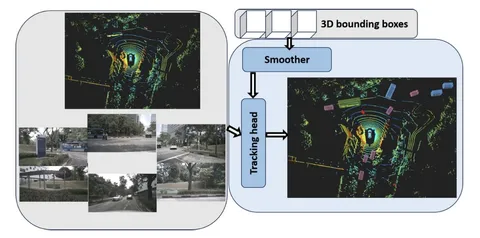
Сегодня разберём работу о модульном фреймворке для трёхмерного трекинга множества объектов. Подход основан на совместном использовании трёх типов информации:

📌BEV-фичей, извлечённых из данных камер и LiDAR;
📌detection queries, полученных при уточнении 3D-детекций;
📌track queries, перенесённых с предыдущего кадра.

BEV-фичи вычисляют с помощью стандартного пайплайна BEVFusion.

Detection queries получают из отдельного блока smoother. Это энкодер-декодерная архитектура, обученная на вспомогательной задаче временного уточнения исходных 3D-детекций. Энкодер собирает для каждой детекции контекст по нескольким кадрам. Декодер уточняет положение, размеры и класс объекта.

При этом в основной трекер передаются не сами итоговые детекции, а извлечённые из промежуточного слоя object-query-представления, сформированные в процессе решения задачи уточнения. Они и становятся detection queries текущего кадра.

Track queries — промежуточные query-представления, сформированные основным трекинговым декодером на предыдущем кадре. Для подтверждённых активных треков модель сохраняет связанные с ними скрытые представления и передаёт их на следующий кадр. Таким образом, между кадрами переносятся не сами предсказанные боксы, а признаки, аккумулирующие информацию о положении, классе и идентичности каждого отслеживаемого объекта.

После независимого кодирования все три типа информации объединяются с помощью трансформера с multi-head attention. Track queries предыдущего кадра выступают в роли queries, detection queries текущего кадра — keys, а BEV-фичи — values. Благодаря этому модель сопоставляет активные треки с новыми детекциями и извлекает из BEV-представления необходимый пространственный и семантический контекст.

Декодер предсказывает обновлённые координаты, размеры, классы, идентификаторы и значения уверенности объектов. Промежуточные query-представления подтверждённых треков рекуррентно передаются на следующий кадр, поэтому непрерывность трекинга поддерживается без отдельной модели движения или фильтра.

Система заточена на модульность: можно менять способ получения BEV‑фич, а также подключать разные детекторы, обучая их независимо или совместно.

Авторы показывают, что FutrTrack превосходит предыдущие трансформерные методы по основным метрикам 3D-трекинга. При этом он всё ещё уступает SOTA-трекерам, основанным на гибридных пайплайнах, в которых обучаемые нейросетевые компоненты сочетаются с явно заданными моделями движения или ассоциации объектов.

Таким образом, полностью data-driven подход на основе трансформеров пока не демонстрирует устойчивого преимущества над системами, использующими геометрические и вероятностные ограничения. Особенно важными такие ограничения остаются в ситуациях с неполными или неоднозначными наблюдениями. Например, при длительных перекрытиях, пропусках детекций или в плотном трафике.

Разбор подготовил ❣️ Олег Данилин
404 driver not found
1 089 просмотров · 23 реакций Открыть в Telegram · Открыть пост на сайте
RadarDistill: Boosting Radar-based Object Detection Performance via Knowledge Distillation from LiDAR Features

Lidar-only детекторы работают заметно лучше, чем radar-only. Причиной тому — разница в качестве данных. Лидар фиксирует более точные и многочисленные точки, в то время как радар склонен выдавать false-positive и false-negative результаты из-за переотражений и других физических тонкостей. Улучшить работу radar-only детекторов можно благодаря дистилляции.

Сегодня разберём статью о том, как получить мощный radar-only детектор с помощью lidar-only детектора. Авторы предложили несколько способов продвинутой дистилляции, учитывающих разную природу лидарных и радарных данных.

Наивная дистилляция путём матчинга фичей лидарного энкодера в фичи радарного работает плохо. Это происходит из-за особенностей радарных и лидарных данных: разной плотности точек, зашумлённости, рассинхронизации сенсоров.

Авторы предлагают три способа улучшения дистилляции:

1. Cross-Modality Alignment. Использование небольшой FPN-like сетки поверх радарной фичамапы, чтобы сделать радарные фичи такими же плотными, как лидарные.

2. Activation-based Feature Distillation. Перевзвешивание лосса в областях фичамапы с ранней стадии энкодера, где есть амплитудные лидарные фичи, помогает акцентировать внимание нейросети на релевантных областях BEV-а.

3. Proposal-based Feature Distillation. Перевзвешивание лосса в областях фичамапы с поздней стадии энкодера позволяет сфокусировать внимание нейросети на областях с GT.

Полная архитектура RadarDistill — на схеме выше. Обратите внимание, что лидары используются только на этапе обучения и не требуются для инференса.

Использование всех трёх улучшений одновременно позволяет увеличить mAP в 2 раза и NDS в 1,25 раз на nuScenes относительно radar-only from scratch.

Разбор подготовил ❣️ Владимир Филипенко
404 driver not found
1 170 просмотров · 20 реакций Открыть в Telegram · Открыть пост на сайте
Вас посетил маленький, но очень громкий робот-рекламщик

Время сделать перерыв. Например, перечитать один из наших обзоров ICML 2026:

➡️ Генерация реального города Seoul World Model, memory bias в RL, совместное обучение VLA и WM: что обсуждают на ICML 2026 [1/2]

➡️ Генерация реального города Seoul World Model, memory bias в RL, совместное обучение VLA и WM: что обсуждают на ICML 2026 [2/2]

➡️ Три статьи об автономном транспорте с ICML 2026

➡️ Безопасность, ускорение end-to-end, prediction в частотной области: чем запомнился ещё один день ICML 2026

#YaICML2026

Поймал в объектив робота-рекламщика и лучшие моменты ICML 2026 ❣️ Иван Дубровин
404 driver not found
1 292 просмотров · 23 реакций Открыть в Telegram · Открыть пост на сайте
Безопасность, ускорение end-to-end, prediction в частотной области: чем запомнился ещё один день ICML 2026

В этом году конференция продолжает бить собственные рекорды по количеству участников. В основной программе — 168 устных докладов и почти 5900 постеров.

Рассказываем о трёх классных постерах про АТ.

CorrectionPlanner: Self-Correction Planner with Reinforcement Learning in Autonomous Driving

Авторы предлагают архитектуру планера, которая умеет корректировать траекторию во время декодинга. Если голова-критик утверждает, что предложенный токен небезопасен, то он добавляется в список невалидных. Авторы называют его correction trace. На этот список обуславливается следующая, исправляющая генерация.

Перегенерация продолжается до тех пор, пока не найдётся валидный токен или не достигнется заданное максимальное количество коррекций. В последнем случае дефолтный токен — «продожать делать то, что делаем сейчас».

Претрейн делают через imitation learning, а потом замораживают его и используют для интерактивности агентов. В то же время саму модель дообучают реагировать на небезопасные роллауты через RL с положительным ревордом за прогресс и отрицательным — за столкновения.

AutoMoT: A Unified Vision-Language-Action Model with Asynchronous Mixture -of-Transformers for End-to-End Autonomous Driving

Работа об архитектуре для ускорения end-to-end за счёт разделения и асинхронного инференса медленного VLM reasoner и быстрого action expert.

Большую предобученную VLM-модель замораживают: инференсят независимо и асинхронно от action-модели, с которой их объединяет общий attention. Между тяжёлыми пересчётами латентов используют KV-кеш.

Авторы по сути показали, что необязательно дообучать VLM на специфику задачи автономного вождения — достаточно улучшить action-часть. И за счёт независимого асинхронного инференса action-эксперта значительно снизили latency.

TF-FACE: Time-Frequency Fusion Learning via Frequency-Domain Adaptive and Controllable Enhancement for Trajectory Prediction

В этой статье предлагают делать предикшн в частотной области вместо временной, потому что в ней естественным образом разделены:

• Низкочастотные составляющие — тренды. Например, движение вперед.
• Высокочастотные сигналы. Например, локальный обгон или уступание пешеходу.

Предлагают новую архитектуру, которую называют Gated Frequency Domain Attention Mechanism. Она прогоняет Q, K и V через преобразование Фурье и attention, адаптированный для комплексных чисел.

Утверждают, что такое разделение позволяет локальным пертурбациям не влиять на глобальную цель, которая содержится в тренде.

#YaICML2026

Собрал лучшее ❣️ Иван Дубровин
404 driver not found
1 014 просмотров · 23 реакций Открыть в Telegram · Открыть пост на сайте
Три статьи об автономном транспорте с ICML 2026

Продолжаем рассказ о тематических работах на крупнейшей международной конференции по машинному обучению. Впечателниями делится наш коллега из команды автономного транспорта Иван Дубровин.

CoIRL-AD: Collaborative-Competitive Imitation-Reinforcement Learning in Latent World Models for Autonomous Driving

Авторы пытаются решить главную проблему imitation learning — выход модели в out of distribution под накапливающимся влиянием расхождений предсказанных и GT-траекторий. Предлагают решать это через объединение IL и RL, чтобы добавить в обучение exploration и расширить распределение, которое модель видела на обучении, что само по себе не новая идея.

Реализуют с помощью collaborative-competitive-сетапа. IL и RL политики — это две разные модели, которые обучаются параллельно и раз в какое-то количество шагов «соревнуются» на валидационном сете. Веса проигравшего заменяются на линейную комбинацию с весами победителя, и обучение продолжается. Выходы обеих моделей также используются для обучения latent world model, которая нужна для скоринга действий RL-агента.

RL при этом не совсем настоящий, потому что использует GT. В качестве реворда — произведение L2-отклонения от GT-траектории, умноженное на collision score. Это же произведение используют как главную метрику.

Замеры, судя по всему, только в OL.

Motion Planning in Compressed Representation Spaces

Авторы сводят задачу guided-планирования к жадному поиску по квантизированным латентным токенам:

• Обучают токенизатор траекторий, обусловленный на окружение, с reconstruction-лоссом.
• Поверх выходов энкодера делают софт-квантизацию, из чего получают набор латентных токенов.
• К латетным токенам применяют nested dropout — случайно отбрасывают хвосты случайной длины, чтобы форсить coarse-to-fine иерархическую структуру. В таком случае каждый префикс декодируется в полную траекторию, и можно делать жадный поиск.

На постере — пример получения траектории левого поворота из найденных жадно трёх токенов. В качестве критерия поиска используют максимизацию суммарного изменения heading влево.

У токенов получается фиксированная семантика, которая переносится в разные ситуации. Любая последовательность токенов декодируется в валидную тракеторию. В частности, команда поворота влево не будет работать, если поворота налево нет.

SafeDec: Constrained Decoding for Safe Autoregressive Generalist Robot Navigation Policies

Авторы заносят контур безопасности на этап декодирования траектории. Используя Signal Temporal Logic (формальный язык для описания требований к сигналам), руками задают правила, которым должны соответствовать траектории.

Для каждого следующего токена результирующая траектория проверяется на соответствие правилам. Если есть нарушение, то токен, который приведёт к невалидному стейту, полностью маскируется (hard constained decoding). Или перевзвешивается распределение (robust constrained decoding).

HCD помогает обеспечить 100% безопасность, но иногда приводит к отсутствию валидных токенов и снижает success rate. RCD даёт трейд-офф между соблюдением STL и успехом.

#YaICML2026

404 driver not found
743 просмотров · 24 реакций Открыть в Telegram · Открыть пост на сайте
Генерация реального города Seoul World Model, memory bias в RL, совместное обучение VLA и WM: что обсуждают на ICML 2026 [2/2]

Продолжаем всё ближе подбираться к автономному транспорту в продолжении обзора работ с ICML, которая прямо сейчас продолжается в Сеуле.

DriveWorld-VLA: Unified Latent-Space World Modeling with Vision–Language–Action for Autonomous Driving

К сожалению, не получилось пообщаться с авторами. В статье они предлагают совместно обучать VLA- и WM-модели, чтобы у них был общий latent state. То есть, чтобы можно было генерировать потенциальные развития событий без вычислительно тяжелых пиксельных симуляций.

Обучают в три этапа.

1. Совместно VLA и VM: с маппингом картинок c камер, текстовых инструкций и BEV в общее пространство фичей, из которого параллельно предсказывают будущие BEV и действия эго.

2. Энкодер и action-голова замораживаются, обучается генерация будущих стейтов, обусловленная на действие.

3. Размораживается action-голова, и добавляется reward-модель, которая учится скорить будущие стейты по предложенным действиям.

В итоге получается попытка сделать модель, которая «представляет» потенциальные развития событий и выбирает наиболее подходящее действие.

Position: RL Researchers Need to Distinguish Between Solving Simulators and Using Simulators as a Proxy

Интересная position-статья с весьма очевидным названием, в котором авторы напоминают RL-щикам про разницу между «решением симулятора» и «использованием симулятора как прокси».

Иными словами: политики, хакнувшие реворд, плохо ведут себя в реальном мире. Кажется, статья больше нацелена на ресёрчеров, которым нужно бить бенчмарки, чтобы их статьи принимались в журналы.

С практической точки зрения, когда модели уже ездят в реальном городе, пользы в этих советах немного. По сути, единственный прикладной совет, — хорошие аугментации, которые позволяют политике быстрее найти нужные стейты, ускоряют сходимость. Весьма очевидная мысль, но всё равно было интересно пообщаться с автором.

#YaICML2026

Запомнил и рассказал ❣️ Иван Дубровин
404 driver not found
983 просмотров · 19 реакций Открыть в Telegram · Открыть пост на сайте
Генерация реального города Seoul World Model, memory bias в RL, совместное обучение VLA и WM: что обсуждают на ICML 2026 [1/2]

6 июля в Южной Корее стартовала одна из крупнейших конференций о машинном обучении — ICML. Участников очень много, работы охватывают самые разные тематики. Личным топом выступлений и постеров, полезных для автономного транспорта, делится наш коллега Иван Дубровин.

Seoul World Model

На Expo Talk авторы из Naver рассказали, как используют RAG поверх фотографий street view, чтобы генерировать настоящий Сеул, а не вооображать что-то похожее. Это позволяет эффективно обучаться, не запоминая весь мир, а также использовать постоянно обновляющиеся данные из карт без полного переобучения. Основной фокус — неперывная генерация на километровых масштабах.

На вход инференс получает глобальные координаты и текстовый промпт с описанием. В презентации приводили примеры генераций с разной погодой и временем суток, которые выглядели весьма правдоподобно, а также с наводнением, НЛО и Годзиллой, которые, ожидаемо, выглядели как кринж.

Во время инференса модель обращается к геобазе с картинками: проецирует виды на нужное положение камеры и использует их как основу для генерации. Чтобы бороться с окклюзиями, используют наборы фотографий, разнесённых во времени. Окружающие машины пока что просто бэкграунд, их ни на что не кондишнят.

Из зала спрашивали про SWM для обучения self-driving VLA моделей, но авторы подчеркнули, что пока сосредоточены на реалистичности и бесшовной генерации для больших расстояний.

Красиво, но хотелось бы больше деталей реализации.

Investigating Memory in RL with POPGym Arcade

Исследование моделей с памятью в MDP- и POMDP-сетапах. Для экспериментов авторы воссоздали на JAX популярные игрушечные среды с возможностью переключаться между полной и частичной наблюдаемостью.

Основной вывод — в полностью наблюдаемых средах, где вся информация содержится в последнем кадре, модели с памятью тратят капасити на историю и теряют из-за этого качество в настоящем. Авторы называют этот эффект memory bias.

Яркий пример: добавление шума в наблюдение 50 степов в прошлом значительно изменяет распределение на выходе. Другими словами, наблюдение out of distribution может заметно влиять на предсказания, пока остаётся в контексте.

DDP-WM: Disentangled Dynamics Prediction for Efficient World Models

Тоже не совсем про автономный транспорт, но уже ближе. Авторы оптимизируют WM для планирования роборуки через MPC.

Текущие SOTA-подходы применяют self-attention на все визуальные токены, не учитывая, происходит ли в соответствующих регионах какая-либо динамика. При этом динамика обычно содержится довольно разреженно.

Авторы предлагают добавить легковесный ViT, который предсказыват бинарную маску изменяющихся регионов. Основной тяжёлый трансформер работает только на «интересных» токенах, а с остальными потом считается cross-attention для восстановления деталей. Показывают бенчмарки, побитые как по скорости (вплоть до x9,2!), так и по точности.

В следующей части обзора обсудим ещё две яркие работы.

#YaICML2026

Запомнил и рассказал ❣️ Иван Дубровин
404 driver not found
782 просмотров · 20 реакций Открыть в Telegram · Открыть пост на сайте
Умеют ли трансформеры водить машину?

Трансформеры уже умеют писать код, генерировать тексты и рисовать картины. Сегодня разберём нашу статью о том, как в Яндексе используют архитектуры на основе трансформеров для планирования движения и почему это сильно отличается от привычных задач генеративных моделей.

Любая система автономного движения опирается на модуль Motion Planner — алгоритм, который несколько раз в секунду решает, куда должен переместиться робот или автономный автомобиль. То есть превращает их восприятие мира в конкретные действия: руление, торможение, ускорение.

В индустрии популярны два подхода к построению Motion Planner: классический, с разделением на perception и planning, и end-to-end, когда модель получает на вход сырые данные сенсоров и сразу выдаёт управляющие действия, без промежуточной стадии perception.

Мы в Яндексе используем классический подход. Формально перед нами задача sequence-to-sequence: на вход приходят временные последовательности стейтов, и нам нужно предсказать будущие стейты. Для решения используем трансформеры.

🔴 Энкодер временного контекста. Для каждого агента и эго у нас есть последовательность стейтов за последние несколько секунд. Мы пропускаем её через энкодер с attention по временной оси — чтобы модель учитывала динамику движения.

🔴 Энкодер карты. Карта — статическая структура, которую также нужно преобразовать в эмбеддинги. Обычно её разбивают на фрагменты с фиксированным числом точек и кодируют каждый фрагмент отдельным энкодером. Мы используем PointNet, но это лишь один из возможных вариантов.

🔴 Взаимодействие всех объектов. Движение любого участника зависит не только от его собственной истории, но и от поведения остальных агентов и структуры дороги. Поэтому результаты всех энкодеров объединяются трансформером с attention между всеми сущностями сцены, чтобы модель могла учитывать все взаимодействия при планировании.

На выходе этого блока получается три вида эмбеддингов: агентов, карты и эго.

🔴 Декодеры будущих стейтов. На эмбеддинги навешиваются головы-декодеры, которые предсказывают будущие стейты. В нашей конфигурации — авторегрессионный трансформерный декодер. Он формирует следующий стейт, учитывая предыдущие предсказания, а также делая аттеншн на других агентов и карту при декодинге каждого стейта.

Всё, что описано выше, — лишь часть большой системы. Внутренние детали токенизации или точный формат выходов сегодня не разбираем. А больше подробностей об обучении ищите в статье на Хабре.

Разбор подготовил ❣️ Максим Спорышев
404 driver not found
1 430 просмотров · 28 реакций Открыть в Telegram · Открыть пост на сайте
Occupancy Grid Prediction [2/2]

Продолжаем серию постов о 3D occupancy perception. В первой части обсудили особенности подхода и общие тренды, а сегодня разберём три актуальные работы.

Одна из особенностей Agent Occupancy Grid — воксели агентов движутся и в системе координат мира, и в системе эго-агента. Это значит, что можно предсказывать Occupancy Grid Flow — то есть, направление и скорость перемещения каждого вокселя.

Let Occ Flow: Self-Supervised 3D Occupancy Flow Prediction

Авторы предлагают решать задачи Occupancy Grid (OG) и Occupancy Grid Flow (OG Flow) prediction, не используя 3D-аннотации. Для этого они обращаются к данным изображений и Optical Flow, полученным из внешней модели.

В общих чертах это работает так:

🔴 2D→3D-энкодер извлекает признаки изображений и строит из них трёхмерный тензор благодаря проекциям на 3D-плоскости.
🔴 Temporal Fusion выравнивает признаки с учетом движения эго-агента, и с помощью deformable attention извлекает временные признаки для разных уровней высоты.
🔴 Rendering-Based Optimization — две разные головы предсказывают Semantic Occupancy Grid и Occupancy Grid Flow. Полученные результаты рендерят на плоскости камер с помощью NeuS и сравнивают с уже существующими изображениями Optical Flow и картами глубин.
🔴 Flow-Oriented Optimization разделяет оптимизацию динамических и статических областей для улучшения сходимости.

ALOcc: Adaptive Lifting-Based 3D Semantic Occupancy and Cost Volume-Based Flow Predictions

Архитектура для предсказания Occupancy Grid и Occupancy Grid Flow. Её главные элементы:

🔴 Adaptive Lifting. Это аналог LSS, но с учётом внутриобъектной и межобъектной окклюзий.
🔴 Semantic Prototype-Based Occupancy Head. В голове предсказания OG используют обучаемые векторы (прототипы), которые инвариантны к BEV- и 3D-представлениям.
🔴 Cost Volume-Based Flow Prediction Head. Для головы предсказания OG Flow вводят тензор, который содержит скалярные произведения всех сдвигов 3D-признаков относительно соседних таймстемпов. Это позволяет семантически сопоставить движущихся агентов в разные моменты времени.

UniOcc: A Unified Benchmark for Occupancy Forecasting and Prediction in Autonomous

Бенчмарк для всех задач Occupancy Grid. Авторы предлагают унифицированное представление данных и инструменты для конвертации открытых датасетов разных форматов.

Задачи условно делят на три категории: предсказание OG, OG Flow и OG/OG Flow с использованием парных проездов.

🔴 Для nuScenes и Waymo синтезировали псевдоразметку с помощью Occ3d, OpenOccupancy и SurroundOcc.
🔴Для движков симуляции Carla и openCOOD — нагенерировали сцен с точными ground truth.

Также авторы предлагают универсальный набор инструментов для задач детекции, трекинга и выравнивания объектов в OG и новые метрики: правдоподобность размеров объектов, временную консистеность формы объекта и фонового окружения.

А какие интересные статьи о 3D occupancy perception находили вы? Расскажите в комментариях!

Разбор подготовил ❣️ Антон Семенюта
404 driver not found
1 771 просмотров · 20 реакций Открыть в Telegram · Открыть пост на сайте
Occupancy Grid Prediction [1/2]

Сегодня начнём серию постов о 3D occupancy perception. В первой части обсудим особенности подхода и общие тренды, а в следующей — разберём несколько актуальных работ.

Для этого подхода сцену представляют плотной 3D-решёткой (вокселями) с семантикой и метками «занято» или «пусто». В отличие от BEV, в 3D occupancy perception явно моделируют высоту, что критично для сложных городских сцен. Например, для случаев, когда 3D occupancy справляется лучше, чем 2D: небольшие камни или куски мусора на дороге, которые проще пропустить между колёс, а не объезжать. Или края досок, вылезающие за пределы грузовика: если они достаточно высоко, легковой автономный автомобиль без проблем под ними проедет.

В общих чертах стек охватывает технологии:

🔴 от 2D→3D-преобразований (проекция из 3D на камеру и обратно с предсказанием глубины, кросс-аттеншн);
🔴 до пространственно-временного фьюжна признаков с нескольких камер и мультимодальной интеграции камеры, лидара и радара.

Среди популярных методов обучения — self-supervised, weak, strong. Среди метрик — IoU, MIoU и ray-MIoU (это IoU вдоль каждого луча камеры). Ключевыми датасетами считаются nuScenes, Waymo и SemanticKITTY.

Тренд последних лет — стремительный рост vision-centric-методов. Камеры дешевеют, текстуры улучшаются, а за счёт продвинутого 2D→3D и temporal fusion разница в качестве предсказаний на основе данных камер и лидаров стремительно сокращается. Но лидар по-прежнему обеспечивает наилучшую геометрию, а мультимодальные схемы ещё не всегда стабильно опережают одномодальные — потенциал фьюжна до сих пор не раскрыт.

При грамотной оптимизации (облегчённые головы, разреженные представления, ускорение инференса) можно получить ~10–13 FPS на Occ3D-nuScenes при MIoU около 40%. Это уже близко к практическим требованиям.

Главные вызовы подхода: реальное время на бортовом железе, робастность к погодным условиям, окклюзиям и отказам сенсоров, а также обобщение без дорогой плотной 3D-разметки. На горизонте — occupancy flow для моделирования динамики, модель мира и использование occupancy как единого представления для восприятия, предсказания и планирования.

В следующем посте разберём несколько актуальных работ, посвящённых 3D occupancy perception.

Разбор подготовил ❣️ Иван Лунев
404 driver not found
4 552 просмотров · 35 реакций Открыть в Telegram · Открыть пост на сайте
VoxelNeXt: Fully Sparse VoxelNet for 3D Object Detection and Tracking

Классические dense-подходы, применяемые поверх воксельных featuremap’ов требуют большого количества вычислений и пост-процессинга (например, NMS). Сегодня разберём статью о попытках оптимизировать это.

Авторы предлагают решать задачу 3D-детекции на лидарных точках в fully-sparse режиме. Для построения такого детектора используют классический spconv-based лидарный бэкбон. Но с улучшениями:

🔴 В изначальный FPN добавили больше featuremap’ов в низком разрешении с последующим апсэмплом. Это значительно увеличило размер эффективного рецептивного поля.

🔴 В конец лидарного бэкбона добавили пуллинг по высоте. Вычислений стало меньше, но метрики не изменились.

🔴 Добавили spatially voxel pruning, «размазывающий» только воксели с достаточно большими магнитудами.

🔴 Кандидатов в боксы отбирали не NMS, а sparse-max-пуллингом. С точки зрения метрик это оказалось почти эквивалентной заменой.

В статье много ablation’ов по всем предложенным изменениям. По результатам замеров на nuScenes, подход позволяет получить сравнимое с лидерами качество 3D-детекции при значительно лучшем latency.

Разбор подготовил ❣️ Владимир Филипенко
404 driver not found
4 445 просмотров · 25 реакций Открыть в Telegram · Открыть пост на сайте
POV: ведём вас читать обзоры и лучшие статьи ICRA 2026

Сегодня заключительный день конференции. И вот что рассказали о ней наши коллеги:

➡️ Чем запомнился первый день ICRA 2026
➡️ И ещё одно мнение о первом дне в канале ML Underhood
➡️ Земной автомобиль, луноход или марсианский ровер — на ICRA 2026 припаркуются все
➡️ Заметки о втором дне в канале ML Underhood
➡️ Residual RL, генерация сложных сценариев поведения и безопасность движения: что обсуждали в третий день ICRA 2026

А вот работы, которые отметил оргкомитет ICRA 2026.

Награду Best Conference Paper Award получили две статьи:

🔴 SymSkill: Symbol and Skill Co-Invention for Data-Efficient and Reactive Long-Horizon Manipulation
Интересный не-ML-подход к манипуляционным задачам.

🔴 OmniRetarget: Interaction-Preserving Data Generation for Humanoid Whole-Body Loco-Manipulation and Scene Interaction
Обучение гуманоидов на человеческих демонстрациях — новый способ ретаргетинга, который сохраняет расстояния до объектов, точки контактов, связи с окружением.

В категорию Best paper in Robotic Learning попала одна работа:

Do You Know Where Your Camera Is? View-Invariant Policy Learning with Camera Conditioning
Необычный кондишенинг положения камер в VLA-моделях.

В качестве Best Perception paper отметили ещё одну интересную статью:

FindAnything: Open-Vocabulary and Object-Centric Mapping for Robot Exploration in Any Environment
Exploration и mapping над пространством объектов. Робот ищет произвольный объект в неизвестной локации и по пути строит карту всего, что нашёл. Про каждый объект запоминает языковое описание, положение в пространстве, геометрию и визуальные признаки.

#YaICRA26

Говорили и показывали ❣️ Максим Спорышев и Егор Волков
404 driver not found
3 164 просмотров · 27 реакций Открыть в Telegram · Открыть пост на сайте
Residual RL, генерация сложных сценариев поведения и безопасность движения: что обсуждали в третий день ICRA 2026

Продолжаем трансляцию с главной международной конференции о робототехнике и автоматизации. Сегодня в подборку самого интересного вошёл один доклад и пять постеров.

Residual Off-Policy RL for Finetuning Behavior Cloning Policies

Работа от Amazon Frontier AI & Robotics, посвящённая планированию движения. Проблематика рассматривается на роботах, но те же подходы можно применить к автономному транспорту.

Для больших VLA хорошо работает behaviour-cloning-претрейн, но RL пока масштабируется плохо: недостаточно данных, сложно учиться на success rate длинных горизонтов, а пространства экшнов слишком большие (в статье упоминаются 29 DOF), чтобы покрывать их в RL.

Авторы предлагают учить Residual RL — политику, которая даёт небольшую добавку к экшну от BC. А ещё делятся рецептом реализации:

🔴Off-policy RL — показывают, что Residual PPO в 200 (!!!) раз менее эффективен, чем Residual off-policy.
🔴Много апдейтов на один роллаут.
🔴N-steps returns.

Learning to Annotate Delayed and False AEB events: a Practical System for Extreme Class Imbalance and Asymmetric Label Noise

Постер о том, как работает AEB в Lixiang. Говорят, что в проде используют и rule-based, и модель. Чаще срабатывает rule-based, модель тюнят для более сложных сценариев. Данные собирают по экстренным торможениям всех пользователей Lixiang. Датасетами, конечно же, не делятся.

Search3D: Hierarchical Open-Vocabulary 3D Segmentation

Второй постер о новом подходе к open vocabulary от ETH, Google и Stanford. Застать авторов, к сожалению, не получилось.

VL-DPO: Vision-Language-Guided Finetuning for Preference-Aligned Autonomous Driving

Третий постер — от Waymo. Взяли VLM, собрали преференсы, обучили DPO. Но не для end2end-, а для motion-LM-модели. На метриках open-loop стало лучше, на closed-loop не проверяли.

COMPASS: Cross-embOdiment Mobility Policy via ResiduAI RL and Skill Synthesis

Ещё один Residual RL на четвёртом постере: на этот раз от NVIDIA. Авторы пишут что обучение только в симуляторе хорошо работает в реальности без sim2real.

Conditional Flow-VAE for Safety-Critical Traffic Scenario Generation

Пятый постер — работа Waabi AI о генерации сложных сценариев поведения. Учат генеративную модель на обычных данных, потом на малом числе кейсов тренируют для неё флоуматчинг, который переводит оригинальное распределение в более safety critical.

#YaICRA26

Подсмотрел для вас интересное ❣️ Максим Спорышев
404 driver not found
952 просмотров · 21 реакций Открыть в Telegram · Открыть пост на сайте
Земной автомобиль, луноход или марсианский ровер — на ICRA 2026 припаркуются все

Позади второй день конференции — продолжаем делиться самым интересным об автономном вождении. Слово Максиму Спорышеву:

Среди докладчиков были те, кто буквально делает космолёты. Они рассказали о локализации для lunar landing, навигации на Марсе и детекции аномалий в космосе — только представьте, какие у них байки про продакшн.

Понравились три постера. Первый — от Waabi AI. Они реализовали 3D-реконструкцию в зоне, ближайшей к исходному треку. Хорошее решение для симуляции перестроения, но не подходящее для сложных разворотов и прокладывания нового маршрута.

Тесты проводят на дистанциях 3, 4 и 5 метров от исходных положений камер: делают feedforward-рендеринг с помощью 3D Gaussian Splatting, добавляют шум и денойзят всё диффузией, которая училась восстанавливать изображения на дистанции 3 метра.

Второй постер — об обучении через имитацию действий других участников дорожного движения. Чтобы собрать тренировочный датасет, авторы берут сцены на nuPlan, выбирают на них одного-двух хороших агентов и трансформируют их движение так, будто всё происходит от лица эго-агента. Плохие данные фильтруют по метрикам комфорта, пройденной дистанции и TTC.

С ростом количества данных эффективность обучения падает: между первыми точками графика заметна большая разница, а ближе к 100 тысячам сцен её почти нет. Для проверки использовали модель PLUTO.

На третьем постере — self-supervised-способ трекинга на лидарных облаках через кластеризации точек и фильтры Калмана. Жаль, что не удалось поймать авторов: они утверждают, что работают на уровне supervised-трекеров.

Отдельно отмечу два доклада, номинированных на звание лучших работ.

Do You Know Where Your Camera Is? View-Invariant Policy Learning with Camera Conditioning

Статья о robotic manipulation, но решаемая в ней проблема актуальна и для автономного транспорта.

Авторы показывают, что качество всех VLA сильно просаживается, если меняется положение камер: в сетапах с рандомным размещением success rate проседает в пару раз.

Решение — подавать положение камер через Plücker ray-maps. То есть задавать луч камеры для каждого пикселя шестью дополнительными числами: дельтами и моментами.

С таким кондишенингом на камеры авторы отыгрывают просадку: success rate становится в пару раз лучше, чем у обычных VLA.

FP3: A 3D Foundation Policy for Robotic Manipulation

Авторы критикуют vision-энкодеры в современных VLA и утверждают, что без трёхмерного представления о мире не обойтись.

Взамен предлагают сетап обучения с Uni3D в качестве энкодера. Он показывает довольно высокие success rates: до 90% на некоторых тасках.

Напоследок авторы показывают профит от масштабирования своего трансформера до 1,3B.


Конференция продлится до 5 июня — ещё вернёмся с новой порцией наблюдений.

#YaICRA26

404 driver not found
2 161 просмотров · 20 реакций Открыть в Telegram · Открыть пост на сайте
Чем запомнился первый день ICRA 2026

С 1 по 5 июня в Вене идёт International Conference on Robotics & Automation. Хайлайтами первого дня поделился Максим Спорышев — руководитель службы поведения и предсказания движения в Автономном транспорте Яндекса.

Доклады

🔴Команда исследователей из Huawei, NVIDIA Research, OpenDriveLab b Shanghai AI Laboratory рассказала о своём пост-трейновом фреймворке World Engine: как он помог им проехать 200 км по Шанхаю без дизенгейджмента. Обещают выпустить в опенсорс — что-то уже доступно на GitHub. Работа показалась интересной с точки зрения генерации safety-critical-кейсов.

🔴 NVIDIA объявили, что вслед за недавним релизом модели Alpamayo 2 и симулятора выложат огромный датасет и запустят челлендж AlpaSim. 25 стран, 2500 городов и 1700 часов проездов — звучит супермощно, очень ждём!

Постеры

🔴 Первые три фото — целый воркшоп о предикшне поведения пешеходов. Авторы рассуждают о самой острой проблеме: предсказать действия пешеходов довольно сложно, особенно в парадигме, что их поведение зависит от движения автономного транспорта. Но хороших решений пока нет.

🔴 На четвёртом фото постер о том, как подбустить персепшн в тумане. Результат работы авторы проверяли на датасете KITTI.

🔴 Пятый постер — ещё один способ токенизировать таргет, чтобы предсказывать движение автономного транспорта.

🔴 На шестом фото работа о подходе к обучению, актуальном для SDG. Авторы рассматривают пайплайн обучения с normalizing flows для задач манипуляции: IL➡️Critic offline Warmup➡️Offline RL➡️Online RL.

#YaICRA26

404 driver not found
1 178 просмотров · 31 реакций Открыть в Telegram · Открыть пост на сайте
Vision Mamba: Efficient Visual Representation Learning with Bidirectional State Space Model

Беспилотный транспорт в свой работе полагается на данные различных сенсоров: камер, лидаров, радаров. Для обработки этих данных — например, для детекции объектов на дороге — обычно используют нейросети. Вычислительная мощность железа на борту автомобиля ограничена, поэтому нейросети должны быть не только точными, но и быстрыми. Сегодня разберём статью о таком фреймворке на основе мощного бэкбона Mamba.

Подход space state models часто используют в LLM для моделирования длинных последовательностей. Авторы предлагают адаптировать этот подход для компьютерного зрения.

В основе архитектуры — deep-learning-модель Mamba. Визуальные данные чувствительны к взаимному расположению и контексту. Чтобы модель учитывала это и справилась с CV, авторы предложили добавить к ней новый блок Bidirectional Mamba с энкодером.

Архитектура Vision Mamba (или просто Vim) — на схеме. Входное изображение делится на патчи, которые превращаются в токены. Последовательность токенов подаётся на вход Vim-энкодеру. В отличие от Mamba, новый энкодер может перенаправлять токены не только вперёд, но и назад по флоу обработки.

Полученную модель можно использовать в качестве бэкбона для 2D-задач: для классификации, детекции и сегментации. Особенность Vision Mamba в том, что она растёт не квадратично от количества токенов как трансформеры, а линейно. А значит, хорошо подходит для задач CV на изображениях с высоким разрешением.

Vision Mamba немного превзошла по top-1 accuracy на ImageNet трансформенную модель DeiT и значительно обогнала её по скорости и потреблению памяти.

Познакомиться с новой моделью можно на GitHub авторов.

Разбор подготовил ❣️ Илья Кувыкин
404 driver not found
1 220 просмотров · 20 реакций Открыть в Telegram · Открыть пост на сайте
Distillation with time

Сегодня разберём сразу две статьи о дистилляции с учётом временного контекста.

RCTDistill: Cross-Modal Knowledge Distillation Framework for Radar-Camera 3D Object Detection with Temporal Fusion

Учитель — LiDAR-детектор, ученик — camera-radar-детектор с time fuse. У обоих BEVFusion-архитектура. Авторы рассматривают, как решить три проблемы дистилляции:

1. Специфика данных. Камеры плохо оценивают расстояние до объектов, а у радаров — низкое угловое разрешение.

Для решения предлагают использовать модуль Range-Azimuth KD (RAKD), который подобно BEVDistill взвешивает L2-лосс между BEV-фичами. Только здесь маска использует размеры объектов, расстояние до эго-машины и угол, формируя эллипсы.

2. Временное смещение динамических объектов. Простой time fuse (concat + conv) не моделирует пространственное смещение объектов между кадрами.

С этой проблемой борется Temporal KD (TKD), который также формирует эллипсоидную маску на BEV. Таким образом учитывают скорость и историю траектории объекта.

3. Неэффективное объединение модальностей. При наивном слиянии модальностей фичи переднего плана и фона смешиваются.

С этим помогает модуль Region-Decoupled KD (RDKD). В качестве лосса он использует матрицы косинусных расстояний векторов BEV'а по выбранным позициям, где у ученика больше heatmap score.

Distilling Future Temporal Knowledge with Masked Feature Reconstruction for 3D Object Detection

В этой работе учитель — SparseBEV с фреймами из прошлого и будущего. Ученик такой же, только без информации о будущем. Авторы разбираются, как грамотно передавать ученику информацию о будущем.

Две основные идеи:

1. Future-Aware Feature Reconstruction.
Сначала вводят Temporal Self-Attention (TSA) — чтобы учитель мог агрегировать информацию с фреймов будущего.

Потом для выхода ученика маскируют некоторую долю токенов, восстанавливают её генератором и считают лосс. Так ученик тренируется строить фичи, обогащённые знанием о будущем, не имея к нему прямого доступа.

Подобный генератор есть на уровне картиночных фичей (после FPN), а также на уровне BEV queries.

2. Future-guided Logit Distillation.
Лоссы классификации и регрессии минимизируют через венгерский алгоритм. Когда у учителя есть знания о будущем, он выдаёт больше true negative.

Авторы обеих статей утверждают, что их подходы помогают улучшить перфоманс, одновременно сэкономив вычислительные мощности и решив ключевые проблемы дистилляции для задачи мультимодальной 3D-детекции.

Разбор подготовила ❣️ Елизавета Мирова
404 driver not found
1 163 просмотров · 16 реакций Открыть в Telegram · Открыть пост на сайте
UniMotion: A Unified Motion Framework for Simulation, Prediction and Planning

Сегодня разберём статью о UniMotion — едином фреймворке на основе decoder-only-трансформерной архитектуры, который объединяет в себе сразу три задачи: симуляцию, предсказание и планирование.

Новый фреймворк позволяет одновременно обучать модель для генерации разнообразных движений и долгосрочного предсказания траекторий, при этом разделяя общие представления между задачами.

Для обучения авторы используют:

🔴 NTP (Next-Token Prediction) — симуляция.
🔴 LFR (Long-range Future Regression) — предсказание.
🔴 Комбинированный подход — планирование.

Чтобы специализировать модель для каждой из задач:

RL Fine-tuning для симуляции
GRPO-подобный подход. Генерируют n траекторий как группу, но градиент активируют только для одной, случайно выбранной, что позволяет экономить вычисления. Считают kinematic и collision reward для каждой из траекторий. Чтобы получить advantage A, нормализуют reward’ы внутри группы. А потом обновляют политики вождения с их учётом. В результате траектории становятся более реалистичными и физичными. А ещё — лучше укладываются в правила дорожного движения

Multi-modal Fine-tuning для предсказаний
LFR обеспечивает только одну траекторию. Но для multi-modal их нужно несколько, поэтому авторы добавляют легковесный трансформерный декодер. Он переводит фичи основной модели в локальную систему координат агента. А потом, используя якорные точки намерений intention points, генерирует траектории для разных намерений. Лосс для траекторий — Gaussian NLL, для классификации режимов — кросс-энтропийный. Благодаря учёту намерений движение становится разнообразнее.

Pred2Gen Fine-tuning для планирования
После основного обучения авторы учат модель предсказывать траектории окружающих её агентов. Для этого заменяют сильно ошибочные предсказания на ground truth, а сами плохие предсказания отправляют в модель, чтобы end-to-end дообучить генерацию эго-агента. Так модель адаптируется к реальному инференсу, где работает со своими же предсказаниями/

Авторы утверждают, что на момент публикации модель стабильно демонстрировала SoTA-результаты и может стать легко масштабируемым решением, помогающим разнообразить симуляцию, предсказание и планирование движения.

Разбор подготовила ❤️ Арина Ромашкина
404 driver not found
1 192 просмотров · 18 реакций Открыть в Telegram · Открыть пост на сайте
FastPillars: A Deployment-friendly Pillar-based 3D Detector

В BEV-based-детекторах часто используют sparse-свёртки. Но их не так-то просто перевести в формат, оптимизированный для инференса: развернуть, квантизировать и конвертировать в TRT.

Лидарный pillar-based-энкодер FastPillars не использует sparse-свёртки, не теряя при этом в скорости и точности. Сегодня разберём статью о том, как он устроен.

У архитектуры FastPillars четыре основных блока: MAPE, Backbone, Neck и Center-Head. Рассмотреть, как всё устроено, можно на схеме. Neck и Center-Head довольно стандартные. Бóльший интерес представляют первые два блока.

MAPE или Max-and-Attention Pillar Encoding — специальный энкодер для pillar’ов, который лучше учитывает локальную геометрию. Например, хорошо находит людей, спрятанных за объектами. А ещё обходится небольшими вычислительными мощностями и легче деплоится в embedded-приложениях.

Чтобы точнее определять объекты, MAPE, по сути, производит positional-энкодинг — рассчитывает для каждого pillar’а один feature-вектор: параллельно вычисляет два вектора и усредняет их. Один вектор получается с помощью MLP и max-энкодинга — просто max-pool по размерности количества точек. Другой вектор вычисляют так называемым аттеншн-энкодингом, который на самом деле представляет собой взвешивание фичей для точек pillar’а и их суммирование по той же размерности. В целом блок напоминает Squeeze-And-Excitation.

Для Backbone к обычному ResNet-34 авторы применили computation reallocation design: оказалось, что с бóльшим количеством слоёв начальные блоки лучше обрабатывают изображения. А для блоков ближе к концу разница не так заметна, можно оставить по одному слою. В итоге авторы увеличили количество слоёв в первых блоках и уменьшили в последних.

В Neck сфьюзили фичи из слоёв 8x и 16x как в PillarNet. Head — обычный center-based detection head. Чтобы лучше локализовывать объекты, дополнительно к типичным детекционным лоссам напрямую оптимизировали IoU-лосс.

Всего в FastPillars четыре лосса: фокальный, L1, регрессионный DIoU и отдельный для IoU.

На момент публикации, в 2023 году, FastPillars показывал SoTA-результаты на Waymo Open Dataset. Познакомиться с кодом детектора можно на GitHub авторов.

Разбор подготовил ❣️ Антон Семенюта
404 driver not found
1 332 просмотров · 29 реакций Открыть в Telegram · Открыть пост на сайте
Gigaflow: Robust Autonomy Emerges from Self-Play

Сегодня разберём статью о self-play-симуляторе для reinforcement learning (RL).

Авторы показывают, что с помощью симуляции можно относительно дёшево обучить простую модель, достигающую SoTA-результатов на большинстве closed-loop-бенчмарков.

Ключевая идея — добиться необходимого поведения можно и без ground-truth-данных. То есть, вместо разметки и записанных траекторий можно просто дать агентам взаимодействовать друг с другом в большом количестве сцен. У Gigaflow достаточно быстрый симулятор, чтобы за время обучения модель успевала «проехать» миллиарды виртуальных километров — это огромное разнообразие ситуаций.

Среда представляет собой набор карт, на которых случайным образом размещаются агенты (автомобили, велосипедисты, пешеходы). Для каждого агента задаётся последовательность waypoint’ов, через которые он должен проехать — каждая симуляция уникальна.

Чтобы приблизить симуляцию к реальности, вводят частичную наблюдаемость (агенты не знают полного состояния других участников), шум в состояниях и динамике. В результате без явного сценарного программирования возникают сложные взаимодействия: пробки, слияния потоков и нерегулируемые перекрёстки.

Одна и та же нейросетевая политика управляет всеми агентами в сцене. Чтобы разнообразить их поведение, используют кондишнинг: задают для каждого агента параметры, определяющие его тип, физические характеристики и предпочтения в поведении.

Обучение проводят с помощью алгоритма PPO. Функция награды включает несколько компонентов: достижение цели, соблюдение ПДД, комфортность вождения, а также штрафы за столкновения и другие нарушения. Интересная особенность — advantage filtering. Обучение фокусируется на наиболее информативных состояниях, в которых действие существенно влияет на результат, а простые ситуации постепенно отфильтровываются.

У Gigaflow лучшие метрики на трёх популярных бенчмарках: CARLA, nuPlan и Waymax. Причём все результаты получены в режиме zero-shot — модель не обучалась ни на одном из этих датасетов.

Разбор подготовил ❣️ Тимур Петров
404 driver not found
1 216 просмотров · 24 реакций Открыть в Telegram · Открыть пост на сайте