SimpleBEV: Improved LiDAR-Camera Fusion Architecture for 3D Object Detection

О perception много статей с графиками и кодом, но лишь единицы попадают в топ лидерборда nuScenes — главного датасета для автономного вождения. Именно там нашлась китайская статья, которую разберём сегодня.

Встречайте новый фреймворк SimpleBEV для слияния данных лидара и камер. Его фишка — максимальная простота при топовой точности.

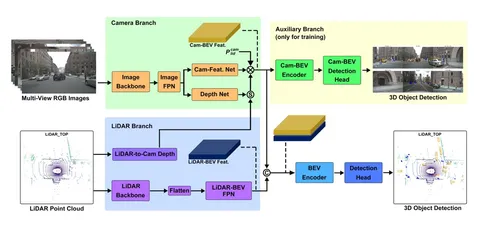
SimpleBEV — по сути, улучшенный BEVFusion. Верхнеуровнево они мало чем отличаются, но если присмотреться повнимательнее, можно заметить два основных обновления.

Во-первых, способ, которым авторы получают глубину изображения и переводят то, что сняли камеры, в 3D-сцены: умное поднятие камеры.

1. Просят каскадную нейросеть предсказать глубину по картиночным фичам.
2. Ground truth проецируют лидарные точки на картинки с камер. Облако точек разрежено, поэтому получить глубину ground truth получится не для всех из них.
3. Конкатенируют данные из пункта 1 и 2, чтобы получить композитное распределение глубины — заполняют пробелы лидарных данных предсказаниями нейросети.

Во-вторых, архитектура лидарного энкодера. Все 3D-карты разных масштабов, получившиеся после вокселизации и Sparse-свёрток, авторы конкатенируют и переводят в BEV. По их словам, это помогает терять меньше информации с мелкими масштабами.

Кроме этого, авторы использовали ансамблирование и TTA. А ещё — увеличили количество hidden-размерностей в лидарном энкодере. Кода нет, поэтому цифрами подтвердить это предположение не получится.

Всё это позволило получить на тестовом датасете NDS = 77,6 — что соответствует топ-3–топ-4 на nuScenes. NDS разных модификаций BEVFusion при этом — 71,8 и 72,9. То есть улучшения подрастили метрику на 5+ единиц.

Для валидации ансамблирование и TTA не использовали, а разрешение картинок было поменьше. Значения метрик при такой постановке задачи уменьшились, но SimpleBEV всё ещё впереди других версий BEVFusion: 73,5 против 71,0 и 71,4.

Наибольший рост метрик помогает получить комбинация transformer-based head, аугментации вставками, multi-scaled feature fusion и увеличения каналов лидарного энкодера в 2 раза.

SimpleBEV доказывает: иногда простые решения работают лучше, не стоит гнаться за сложными фьюжн-архитектурами. Качественное выравнивание данных в BEV, простое сложение признаков и мощный тренировочный пайплайн дали авторам почти SoTA-результат с меньшими вычислениями, что делает SimpleBEV очень практичным кандидатом для реальных систем.

Разбор подготовил ❣️ Иван Лунев
404 driver not found
1 129 просмотров · 37 реакций Открыть в Telegram · Открыть пост на сайте
Scaling Laws of Motion Forecasting and Planning

Waymo, подразделение беспилотных автомобилей Google, выпустили техрепорт о том, как масштабируются модели. Похожая статья об LLM сильно повлияла на свою сферу несколько лет назад. А теперь аналогичное исследование провели для планировщиков движения автомобилей.

Сегодня разберёмся, есть ли оптимальное соотношение между размером нейросети и количеством обучающих примеров: такое, чтобы получить лучший результат в рамках заданного бюджета вычислений.

Архитектура модели — обычный для планировщиков энкодер-декодер трансформер. Энкодеру c early fusion подают на вход информацию о сцене: дорожный граф, историю агентов (людей, машин, светофоров и других участников дорожного движения) за последние 5 секунд. Декодер из полученных эмбеддингов предсказывает дискретные ускорения для 8 агентов, а конечные траектории эго-автомобиля и других агентов восстанавливаются по Verlet.

В отличие от Wayformer и MotionLM, где фичи агента кодируются в локальной системе координат каждого агента, в этой статье кодирование происходит в одной системе — в системе координат эго (global frame).

Авторы обучали модель в режиме teacher forcing, используя cross-entropy loss. Датасет состоял из 6 млн уникальных и разнообразных (по утверждениям авторов) проездов, из которых простой фильтрацией и дедупликацией сэмплировали тридцатисекундные сегменты. Для получения большего числа сцен из этих сегментов используют скользящее окно 1,5 секунды.

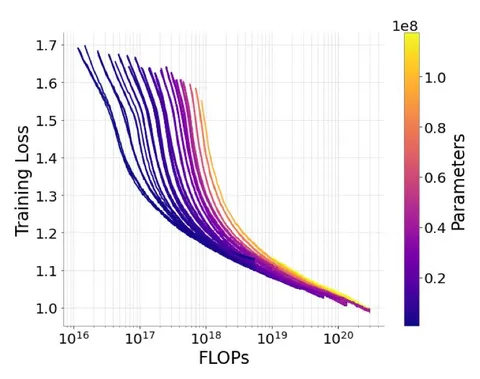
Всего авторы обучили 84 модели (от 900K параметров до 118M). Они систематически меняли размеры модели, датасета и бюджета вычислений. Число параметров варьировали за счёт количества слоев энкодера и декодера (соотношение ширины к глубине — 8 или 16). В одинаковый бюджет модели с меньшим и большим числом параметров укладывались изменением числа шагов в обучении.

🔴Аналогично LLM, производительность модели повышается в зависимости от общего бюджета вычислений.
🔴Лосс обучения модели сильно коррелирует с метриками её оценки.
🔴Сlosed-loop-метрики улучшаются при масштабировании — это важно в рассуждениях о пригодности показателей open-loop для разработки моделей.
🔴Training loss параметризуют как L(N, D), где N — число параметров в модели, D — размер датасета. Оптимальные значения N, D ищут при фиксированном бюджете C (FLOPs). В ходе экспериментов N_opt ~ C^(0,63), D_opt ~ C^(0,44), iso-FLOPs кривые моделировали параболами, которые отличаются для разных категорий агентов.
🔴При исследовании масштабируемости по мере увеличения бюджета на инференсе сэмплировали разное число мод, после кластеризации их оставалось 6. Сначала качество по distance-метрикам растёт, потом наступает момент, когда дальнейшее увеличение бюджета нецелесообразно. От себя добавлю, что здесь было бы интереснее посмотреть, как меняется closed-loop performance.
🔴Авторы сравнили сетапы с эго-агентом в лоссе и без, оценивая качество по эго val loss. В первом случае значение функции потерь ожидаемо оказывается лучше. Но для сетапа с zero-shot предсказанием эго-качество тоже улучшается по мере увеличения бюджета. Для достижения таких же результатов, как в сетапе с эго-агентом, zero-shot требуется больше данных (примерное соотношение — 2-3 к 10).

Разбор подготовил ❣️ Павел Лукьянов
404 driver not found
1 377 просмотров · 31 реакций Открыть в Telegram · Открыть пост на сайте
Direct Post-Training Preference Alignment for Multi-Agent Motion Generation Models Using Implicit Feedback from Pre-training Demonstrations

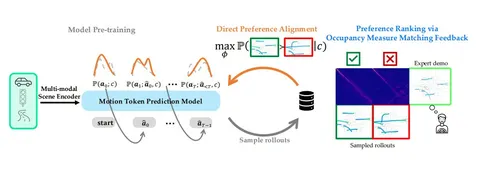
Авторы статьи предложили новый подход к дообучению traffic prediction-моделей без участия человека. Вместо ручной разметки или явной reward-функции они получают скрытые предпочтения (implicit preferences) из экспертных данных (GT).

С помощью distance-функции исследователи измеряют, насколько поведение модели отклоняется от поведения эксперта, и на основе этого ранжируют сгенерированные траектории. В итоге формируются пары более предпочтительных и менее предпочтительных траекторий, по которым обучается модель, увеличивая относительную вероятность «лучших» траекторий по сравнению с базовой (pretrained) моделью.

В качестве distance-функции авторы используют optimal transport на признаковом представлении траекторий — смотрят на разницу между распределениями фич агентов на каждом тике траектории, причём вектора суммируются таким образом, чтобы добиться инвариантности времени — получается распределение фич, которое работает и в будущем, и в прошлом. Фичи агентов извлекаются из траектории путём occupancy measure matching.

Для дообучения модели используется contrastive learning, вдохновлённое DPO, но адаптированное под задачи планирования движения. В отличие от DPO, предпочтения не аннотированы вручную, а определяются по близости траектории к GT (ground truth).

В качестве референсной модели взята Motion LM на 1М, и после дообучения итоговая модель показывает лучшие результаты, чем референсная. При этом на Waymo Open Sim Agents Challenge результаты эксперимента не лучше, чем SOTA больших моделей с размером 10-100М наподобие SMART или BehaviorGPT.

Отдельно авторы показывают, что дообучать модель на парах GT vs generated — это не очень хорошо, потому что, имея дело с траекториями из разных распределений, дискриминатор слишком хорошо выучивает косвенные признаки, например, волнообразность сгенерированной траектории, то есть не то, что нужно для решения задачи.

Разбор подготовил ❣️ Алексей Найденов
404 driver not found
1 101 просмотров · 16 реакций Открыть в Telegram · Открыть пост на сайте
RefAV: Towards Planning-Centric Scenario Mining

Пока беспилотник накатывает часы по дорогам города, он собирает огромный массив информации об окружающем мире и событиях в нём. Каждая система (а в автомобиле их сотни) пишет свои данные. А ещё — умеет поставлять дополнительную информацию о событии, которое описывает. Например, датчик безопасности отправляет водителю предупреждение, а в логи записывает, что причина алерта — неисправность в двигателе или превышение скорости. В итоге, когда машина возвращается на базу, мы получаем огромный, частично размеченный массив данных. Хранить его удобнее в виде структуры, которую грубо можно назвать табличкой.

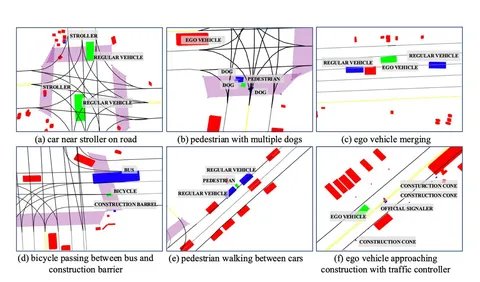
Но как найти в этой табличке данные, действительно интересные для теста, обучения или аналитики? По-настоящему интересных событий среди записей не так уж много. К тому же, иногда требуется отыскать что-то совсем экстравагантное: например, как дети перебрасывают портфель над машинами, или уточка ведёт утят через дорогу и решила отдохнуть на полпути.

В сегодняшней статье авторы пытаются найти «золотые» примеры событий в огромном массиве данных, оперируя полуразмеченым потоком, который записал автомобиль.

Идея в своей основе очень проста — давайте навайбкодим функцию, которая будет проверять, подходит ли нам записанное событие. Для начала авторы попробовали следующий бейзлайн: просили LLM посмотреть в записанные данные и сказать, подходят ли они к запросу с описанием. Подходят — добавляем в датасет, нет — пропускаем.

Эта механика задумывалась как слабая точка для начала, но удивила экспериментаторов тем, что показала отличный результат по восстановлению интересных сцен. Для теста метода использовали вручную размеченные данные.

Окончательный алгоритм посложнее:

1. Руками создать описания функций, которые помогут отфильтровать только подходящие данные из всех записей (например is_speed_limit(all_data)-> bool).
2. Отдать LLM список этих функций и попросить построить из них более сложные — будущие фильтры для строчек из таблицы.
3. Полученной композитной функцией отфильтровать данные. Спойлер: останутся только интересные случаи!

Так авторы собрали RefAV — набор данных из 10 000 различных запросов на естественном языке, которые описывают сложные мультиагентные взаимодействия. Данные о планировании движения получены из 1000 журналов данных, записанных датчиками Argoverse 2.

RefAV можно использовать в качестве тестового датасета для ваших пайплайнов сбора данных: ищите его и код фильтров на Github авторов.

Разбор подготовил ❣️ Дмитрий Хорошилов
404 driver not found
969 просмотров · 23 реакций Открыть в Telegram · Открыть пост на сайте
Заводите моторы — мы отправляемся в увлекательную поездку без водителя! Добро пожаловать в 404 Driver Not Found — канал об ML в автономном транспорте, который ведут инженеры из Яндекса. Здесь вы найдёте разборы актуальных научных статей, обзоры профильных конференций, авторские подборки полезных материалов для ML’щика в сфере АТ и многое другое.

Подписывайтесь, чтобы строить свой маршрут в мире автономного транспорта вместе с нами и оставаться в курсе главных тенденций индустрии 🚗
874 просмотров · 30 реакций Открыть в Telegram · Открыть пост на сайте