Distillation with time

Сегодня разберём сразу две статьи о дистилляции с учётом временного контекста.

RCTDistill: Cross-Modal Knowledge Distillation Framework for Radar-Camera 3D Object Detection with Temporal Fusion

Учитель — LiDAR-детектор, ученик — camera-radar-детектор с time fuse. У обоих BEVFusion-архитектура. Авторы рассматривают, как решить три проблемы дистилляции:

1. Специфика данных. Камеры плохо оценивают расстояние до объектов, а у радаров — низкое угловое разрешение.

Для решения предлагают использовать модуль Range-Azimuth KD (RAKD), который подобно BEVDistill взвешивает L2-лосс между BEV-фичами. Только здесь маска использует размеры объектов, расстояние до эго-машины и угол, формируя эллипсы.

2. Временное смещение динамических объектов. Простой time fuse (concat + conv) не моделирует пространственное смещение объектов между кадрами.

С этой проблемой борется Temporal KD (TKD), который также формирует эллипсоидную маску на BEV. Таким образом учитывают скорость и историю траектории объекта.

3. Неэффективное объединение модальностей. При наивном слиянии модальностей фичи переднего плана и фона смешиваются.

С этим помогает модуль Region-Decoupled KD (RDKD). В качестве лосса он использует матрицы косинусных расстояний векторов BEV'а по выбранным позициям, где у ученика больше heatmap score.

Distilling Future Temporal Knowledge with Masked Feature Reconstruction for 3D Object Detection

В этой работе учитель — SparseBEV с фреймами из прошлого и будущего. Ученик такой же, только без информации о будущем. Авторы разбираются, как грамотно передавать ученику информацию о будущем.

Две основные идеи:

1. Future-Aware Feature Reconstruction.
Сначала вводят Temporal Self-Attention (TSA) — чтобы учитель мог агрегировать информацию с фреймов будущего.

Потом для выхода ученика маскируют некоторую долю токенов, восстанавливают её генератором и считают лосс. Так ученик тренируется строить фичи, обогащённые знанием о будущем, не имея к нему прямого доступа.

Подобный генератор есть на уровне картиночных фичей (после FPN), а также на уровне BEV queries.

2. Future-guided Logit Distillation.
Лоссы классификации и регрессии минимизируют через венгерский алгоритм. Когда у учителя есть знания о будущем, он выдаёт больше true negative.

Авторы обеих статей утверждают, что их подходы помогают улучшить перфоманс, одновременно сэкономив вычислительные мощности и решив ключевые проблемы дистилляции для задачи мультимодальной 3D-детекции.

Разбор подготовила ❣️ Елизавета Мирова
404 driver not found
1 175 просмотров · 16 реакций Открыть в Telegram · Открыть пост на сайте
UniMotion: A Unified Motion Framework for Simulation, Prediction and Planning

Сегодня разберём статью о UniMotion — едином фреймворке на основе decoder-only-трансформерной архитектуры, который объединяет в себе сразу три задачи: симуляцию, предсказание и планирование.

Новый фреймворк позволяет одновременно обучать модель для генерации разнообразных движений и долгосрочного предсказания траекторий, при этом разделяя общие представления между задачами.

Для обучения авторы используют:

🔴 NTP (Next-Token Prediction) — симуляция.
🔴 LFR (Long-range Future Regression) — предсказание.
🔴 Комбинированный подход — планирование.

Чтобы специализировать модель для каждой из задач:

RL Fine-tuning для симуляции
GRPO-подобный подход. Генерируют n траекторий как группу, но градиент активируют только для одной, случайно выбранной, что позволяет экономить вычисления. Считают kinematic и collision reward для каждой из траекторий. Чтобы получить advantage A, нормализуют reward’ы внутри группы. А потом обновляют политики вождения с их учётом. В результате траектории становятся более реалистичными и физичными. А ещё — лучше укладываются в правила дорожного движения

Multi-modal Fine-tuning для предсказаний
LFR обеспечивает только одну траекторию. Но для multi-modal их нужно несколько, поэтому авторы добавляют легковесный трансформерный декодер. Он переводит фичи основной модели в локальную систему координат агента. А потом, используя якорные точки намерений intention points, генерирует траектории для разных намерений. Лосс для траекторий — Gaussian NLL, для классификации режимов — кросс-энтропийный. Благодаря учёту намерений движение становится разнообразнее.

Pred2Gen Fine-tuning для планирования
После основного обучения авторы учат модель предсказывать траектории окружающих её агентов. Для этого заменяют сильно ошибочные предсказания на ground truth, а сами плохие предсказания отправляют в модель, чтобы end-to-end дообучить генерацию эго-агента. Так модель адаптируется к реальному инференсу, где работает со своими же предсказаниями/

Авторы утверждают, что на момент публикации модель стабильно демонстрировала SoTA-результаты и может стать легко масштабируемым решением, помогающим разнообразить симуляцию, предсказание и планирование движения.

Разбор подготовила ❤️ Арина Ромашкина
404 driver not found
1 212 просмотров · 18 реакций Открыть в Telegram · Открыть пост на сайте
FastPillars: A Deployment-friendly Pillar-based 3D Detector

В BEV-based-детекторах часто используют sparse-свёртки. Но их не так-то просто перевести в формат, оптимизированный для инференса: развернуть, квантизировать и конвертировать в TRT.

Лидарный pillar-based-энкодер FastPillars не использует sparse-свёртки, не теряя при этом в скорости и точности. Сегодня разберём статью о том, как он устроен.

У архитектуры FastPillars четыре основных блока: MAPE, Backbone, Neck и Center-Head. Рассмотреть, как всё устроено, можно на схеме. Neck и Center-Head довольно стандартные. Бóльший интерес представляют первые два блока.

MAPE или Max-and-Attention Pillar Encoding — специальный энкодер для pillar’ов, который лучше учитывает локальную геометрию. Например, хорошо находит людей, спрятанных за объектами. А ещё обходится небольшими вычислительными мощностями и легче деплоится в embedded-приложениях.

Чтобы точнее определять объекты, MAPE, по сути, производит positional-энкодинг — рассчитывает для каждого pillar’а один feature-вектор: параллельно вычисляет два вектора и усредняет их. Один вектор получается с помощью MLP и max-энкодинга — просто max-pool по размерности количества точек. Другой вектор вычисляют так называемым аттеншн-энкодингом, который на самом деле представляет собой взвешивание фичей для точек pillar’а и их суммирование по той же размерности. В целом блок напоминает Squeeze-And-Excitation.

Для Backbone к обычному ResNet-34 авторы применили computation reallocation design: оказалось, что с бóльшим количеством слоёв начальные блоки лучше обрабатывают изображения. А для блоков ближе к концу разница не так заметна, можно оставить по одному слою. В итоге авторы увеличили количество слоёв в первых блоках и уменьшили в последних.

В Neck сфьюзили фичи из слоёв 8x и 16x как в PillarNet. Head — обычный center-based detection head. Чтобы лучше локализовывать объекты, дополнительно к типичным детекционным лоссам напрямую оптимизировали IoU-лосс.

Всего в FastPillars четыре лосса: фокальный, L1, регрессионный DIoU и отдельный для IoU.

На момент публикации, в 2023 году, FastPillars показывал SoTA-результаты на Waymo Open Dataset. Познакомиться с кодом детектора можно на GitHub авторов.

Разбор подготовил ❣️ Антон Семенюта
404 driver not found
1 370 просмотров · 29 реакций Открыть в Telegram · Открыть пост на сайте
Gigaflow: Robust Autonomy Emerges from Self-Play

Сегодня разберём статью о self-play-симуляторе для reinforcement learning (RL).

Авторы показывают, что с помощью симуляции можно относительно дёшево обучить простую модель, достигающую SoTA-результатов на большинстве closed-loop-бенчмарков.

Ключевая идея — добиться необходимого поведения можно и без ground-truth-данных. То есть, вместо разметки и записанных траекторий можно просто дать агентам взаимодействовать друг с другом в большом количестве сцен. У Gigaflow достаточно быстрый симулятор, чтобы за время обучения модель успевала «проехать» миллиарды виртуальных километров — это огромное разнообразие ситуаций.

Среда представляет собой набор карт, на которых случайным образом размещаются агенты (автомобили, велосипедисты, пешеходы). Для каждого агента задаётся последовательность waypoint’ов, через которые он должен проехать — каждая симуляция уникальна.

Чтобы приблизить симуляцию к реальности, вводят частичную наблюдаемость (агенты не знают полного состояния других участников), шум в состояниях и динамике. В результате без явного сценарного программирования возникают сложные взаимодействия: пробки, слияния потоков и нерегулируемые перекрёстки.

Одна и та же нейросетевая политика управляет всеми агентами в сцене. Чтобы разнообразить их поведение, используют кондишнинг: задают для каждого агента параметры, определяющие его тип, физические характеристики и предпочтения в поведении.

Обучение проводят с помощью алгоритма PPO. Функция награды включает несколько компонентов: достижение цели, соблюдение ПДД, комфортность вождения, а также штрафы за столкновения и другие нарушения. Интересная особенность — advantage filtering. Обучение фокусируется на наиболее информативных состояниях, в которых действие существенно влияет на результат, а простые ситуации постепенно отфильтровываются.

У Gigaflow лучшие метрики на трёх популярных бенчмарках: CARLA, nuPlan и Waymax. Причём все результаты получены в режиме zero-shot — модель не обучалась ни на одном из этих датасетов.

Разбор подготовил ❣️ Тимур Петров
404 driver not found
1 231 просмотров · 24 реакций Открыть в Telegram · Открыть пост на сайте
Diffusion-Based Planning for Autonomous Driving with Flexible Guidance

Современные learning-based подходы к планированию часто не могут сбалансировать конкурирующие цели обучения и требования к безопасности движения из-за ограниченной адаптивности и сложностей с пониманием мультимодальных форм поведения, типичных для людей. К тому же, результаты обучения находятся в зависимости от резервной стратегии с предопределёнными правилами.

Авторы сегодняшней статьи попробовали решить проблему мультимодальности, планируемой траектории и соблюдения требований безопасности переходом на диффузионный планнер. Они используют архитектуру на базе DiT, которая учится предсказывать траектории эго и агентов. Чтобы генерировать более безопасные траектории (примеры потенциалов: signed distance между эго и агентами, отклонение скорости от заданного коридора, jerk) исследователи используют classifier guidance с заранее заданными потенциалами.

Обучаются на nuPlan. При этом на довольно небольшой архитектуре получается SOTA на nuPlan среди learning-based подходов. Если же добавить refine, получается SOTA среди всех. Авторы утверждают, что в качестве refine используют готовый модуль из STR-2, который добавляет оффсеты к выходам модели и скорит траектории, используя PDM.

В diffusion-based planning используются аугментации current_state'а: исследователи заменяют положение, угол, скорость и ускорение на дельту из равномерного. Потом прибегают к quintic interpolation, чтобы перестроить GT. Данные переводят в эгоцентрическую систему координат и применяют z-score нормализацию к x-координатам и пропорционально скейлят y-координаты.

Для дополнительного сравнения команда проекта собрала собственный датасет, который состоит из 200 часов реальных данных работы автономного доставщика, которому можно ездить по велодорожкам, поэтому чаще всего он взаимодействует с пешеходами и велосипедистами. Результаты этого масштабного теста подтвердили, что Diffusion Planner обеспечивает производительность на уровне SOTA в различных стилях вождения.

Разбор подготовил ❣️ Марк Нужнов
404 driver not found
1 296 просмотров · 30 реакций Открыть в Telegram · Открыть пост на сайте
Две статьи о дистилляции для 3D-детекции с разнородными данными

Разные сенсоры автономного транспорта дают модели неоднородную информацию о сцене: лидар — разреженную геометрию, камеры — плотное визуальное представление. Сегодня разберём сразу две статьи о том, как в таком случае дистиллировать модели для задач 3D-детекции.

BEVDistill: Cross-Modal BEV Distillation For Multi-View 3d Object Detection

Фреймворк BEVDistill решает две важные проблемы дистилляции в BEV:

🔴 преобладание на feature maps маловажного фона, который слабо помогает обучению;
🔴 риск передать студенту ошибки — ложные срабатывания учителя.

Для этого авторы предлагают два взаимодополняющих компонента.

Первый, Dense Feature Distillation, фокусирует студента на областях BEV-карты, которые содержат критически важную информацию о реальных объектах. Это достигается путём построения гауссиан вокруг центров GT 3D-боксов.

Гауссианы объединяются в карту весов, где ячейкам вблизи объектов присваиваются высокие значения, а фоновым областям — низкие. Эта карта взвешивает лосс между BEV feature maps учителя и студента и способствует тому, что студент внимательнее согласовывает свои признаки с учителем именно в релевантных для объектов локациях.

Второй, Sparse Instance Distillation (SID), решает проблему потенциального вреда от дистилляции на основе ошибочных предсказаний учителя. SID сознательно фокусируется не на всех предсказанных учителем объектах, а только на надёжных.

Для предсказаний вычисляются веса, и дистилляционный лосс взвешивается этими значениями. Это гарантирует, что студент учится перенимать паттерны только из корректных предсказаний учителя, меньше обращая внимание на его ложные срабатывания.

Рассмотреть весь фреймворк можно на первой схеме, познакомиться с решением поближе — на GitHub авторов.

Representation Disparity-aware Distillation for 3D Object Detection

Авторы этой статьи подводят нас к проблеме селективности в дистилляции с другой, более фундаментальной стороны. Они сосредоточились на явлении рассогласования представлений (representation disparity) — различиях в распределениях признаков учителя и студента.

Стандартная дистилляция не учитывает, что это рассогласование неоднородно по пространству feature map. Ключевая идея RDD — явно измерить локальное расхождение (disparity) между признаками учителя и студента в областях предсказаний (в областях, где был предсказан объект).

На второй схеме видно: области с высоким значением указывают на значительное несоответствие, означающее, что студенту сложнее перенять знания учителя именно в этих местах. RDD использует эти веса для дистилляционного лосса, что фокусирует обучение на тех зонах, где студент сильнее всего отклоняется от учителя.

Авторы утверждают, что на момент выхода статьи их подход позволил повысить mAP для CP-Voxel-S с 54,0% до 57,1% на датасете nuScenes. Этот результат лучше, чем у модели-учителя, хотя cтудент использует лишь около 41,6% её FLOPs.

Разбор подготовила ❣️ Елизавета Мирова
404 driver not found
1 031 просмотров · 28 реакций Открыть в Telegram · Открыть пост на сайте
MV2DFusion: Leveraging Modality-Specific Object Semantics for Multi-Modal 3D Detection

Модели с Lift Splat Shoot (LSS) хороши, но у них есть ограничения. Главное из них заключается в том, что при удалении от эго-агента точность и плотность BEV-фичей падает. А значит, ухудшается качество моделей, основанных на BEV. Методы с нелинейным BEV частично решают эту проблему, но они, как правило, упираются в потолок скорости работы при увеличении расстояния, на которое должна «видеть» машина.

Query-based-подходы, не формирующие BEV, позволяют создавать быстрые и точные модели, однако объединять фичи разных модальностей в такой постановке гораздо сложнее. Сегодня разберём статью об одной из реализаций — SOTA-модели для мультимодальной 3D-детекции.

MV2DFusion — perception-модель, использующая query-based-парадигму. Она фьюзит модальности, прогоняя предикты детекций из разных модальностей через один Deformable DETR, но учитывая особенности этих модальностей:

🔴 Для 2D-детекций она отдельно предсказывает категориальное распределение их глубин, как в LSS — свойство query на всё время работы модели, которое особым образом учитывается в Self- и Cross-Attention.

🔴 Лидарные 3D-детекции на основе облака точек она считает обычными точками в пространстве.

Потом все детекции конкатенируют и пропускают через трансформер. Темпоральность авторы реализовали путём добавления top-K query из T последних таймстепов в Self-Attention. Подробнее рассмотреть архитектуру модели можно на схеме.

Авторы утверждают, что гибкость MV2DFusion позволяет интегрироваться с любыми детекторами на основе изображений и облаков точек. По сравнению с BEVFusion (w/ CenterPoint), этот метод заметно улучшает качество, особенно на датасете Argoverse2 с long-range-предсказаниями на 204 метра. При этом MV2DFusion в 2 раза быстрее и использует в 3 раза меньше памяти.

Разбор подготовил ❣️ Тимур Ахмадуллин
404 driver not found
1 065 просмотров · 18 реакций Открыть в Telegram · Открыть пост на сайте
π0: A Vision-Language-Action Flow Model for General Robot Control

Сегодня разберём статью о важной для self-driving теме из смежной области — как делать large-scale pre-training, если обучающих данных исчезающе мало.

У ребят, которые создают автономных роботов, обучающих датасетов ещё меньше, чем у нас. Авторы из команды Physical Intelligence предлагают решение: прикручивают flow-matching-декодер для экшнов к VLM, натренированной на internet-scale-датасете.

Архитектурно эта система устроена следующим образом:

1. Изображения с камер и текст задания попадают в префикс, проходят через VLM (PaliGemma 3B на базе Gemma 2) — получается KV-кеш.

2. В получившуюся последовательность после префикса добавляют эмбеддинг текущего состояния — вектора Q из 18 float-значений.

3. Траекторию на H=50 шагов, предсказывают с помощью flow-matching-декодера на 300M параметров, используя KV-кеш из 1 и 2.

Если у робота меньше трёх камер, вместо недостающих изображений указывают нули. Аналогично, если размерность стейта меньше 18, дополняют вектор нулями до 18 значений.

При этом у аттеншна блочно-каузальная маска:

🔴 префикс учитывает только собственные данные,
🔴 вектор состояния Q ориентируется и на себя, и на префикс,
🔴 траектория опирается и на собственные значения, и на Q, и на префикс,
🔴 внутри каждого блока маска полная: все смотрят на всех.

Так как префикс лежит в KV-кеше, важно, чтобы у декодера траектории были те же количество слоёв и размерность слоя. Но можно уменьшить размерность в MLP: именно так удаётся получить 300M параметров в декодере траектории при 3B в VLM.

Сначала модель претрейнят на составном датасете:

🔴 9,1% разнообразных опенсорс-данных — Oxe Magic Soup (2 Гц + 10 Гц),
🔴 остальные 90% (903M таймстепов на 68 заданий для single-/dual-arm роботов) — π0-dataset,
🔴 чтобы избежать дисбаланса, каждую task-robot-пару взвешивают с весом n⁰˒⁴³.

Потом обучают все части модели: image-backbone, VLM, Action-Expert. А во время пост-трейнинга каждый Action-Expert файнтюнится на своём task-specific-датасете.

В инференсе 10 шагов интегрирования (денойзинга). Он работает 73 мс на RTX 4090 (86 мс с задержкой сети). Для 20-герцовых роботов инференс делают каждые 0,8 секунды (после 16 шагов), для 50 Гц роботов — каждые 0,5 секунды (после 25 шагов). Для траекторий пробовали добавлять temporal ensembling, но результаты получились хуже чем open-loop.

Авторы утверждают, что на момент публикации были в топе всех популярных бенчмарков.

Разбор подготовил ❣️ Сергей Репьевский
404 driver not found
1 156 просмотров · 21 реакций Открыть в Telegram · Открыть пост на сайте
Openpilot 0.11 — первый робо-агент, обученный только на симуляциях

Команда Comma.ai опубликовала интересный пост, где утверждает, что впервые в истории индустрии выпустила на дороги робо-агент, полностью обученный в вымышленной нейросетями симуляции.

Немного контекста: в Comma.ai разрабатывают систему помощи водителю, совместимую со многими моделями автомобилей. Система работает на втором уровне автономности — умный лейн-кипинг в широком спектре сценариев. Эта задача гораздо проще, чем полностью автономное вождение, что позволяет Comma.ai экспериментировать.

В то время как Waymo и британская команда Wayve интегрируют модели мира в свои пайплайны, Comma.ai идёт ещё дальше и отказывается от всего, кроме модели мира. Похожую идею предлагали учёные из Беркли в классической для робототехники статье DayDreamer — интересно, что этот подход удалось адаптировать для автономного вождения.

Вот что предлагают создатели Openpilot 0.11:

Шаг 1. Собрать 40 тысяч часов интересных видео, записанных флотом автономного транспорта и разбить их на сцены по 10 секунд с частотой 5 Гц.

Шаг 2. Обучить на этом датасете двухголовую модель мира:

🔴 первая голова предсказывает по видеоконтексту следующее действие эго-агента,
🔴 вторая — генерирует следующий кадр по видеоконтексту и только что полученному следующему действию.

Потом к контексту добавляется сгенерированный кадр, и процесс повторяется.

Секретный ингредиент — подавать на вход модели не только две секунды истории, но и последнюю секунду в эпизоде. Так ей понадобится предсказывать только промежуточную траекторию — это значительно улучшает сходимость. В итоге получается достаточно реалистичный симулятор вождения, который генерирует следующий кадр по двум секундам видео и действию эго.

Шаг 3. Обучить в полученном симуляторе небольшую модель-водителя, которая должна сходиться в финальное состояние по одному лишь видео, не видя последний кадр. Щедро насыпать шум на всех стадиях для устойчивости.

Openpilot 0.11 обучали on-policy — модель много едет по сгенерированной ей самой траектории, что выгодно отличает подход от обычного imitation learning.

При этом награды или штрафы не задавались явно — по опыту reinforcement learning, конструирование наград иногда всё только портит. Авторы усвоили горький урок: для того чтобы всё сошлось, достаточно увеличить количество данных и размер модели.

Единственная проблема, которая остаётся, — модель-водитель может научиться ломать симуляцию непредсказуемыми способами. Авторы утверждают, что это решается за счёт гипотезы большого мира: одновременно увеличивать и модель мира, и размеры водителя так, чтобы мир всегда был на порядок больше.

В парадигме Level 2 получается хороший результат — агент держит линию и расстояние до других, объезжает запаркованные авто. Но вопрос, будет ли это скейлиться на более сложные задачи, остаётся открытым.

Разбор подготовил ❣️ Кирилл Федянин
404 driver not found
5 058 просмотров · 34 реакций Открыть в Telegram · Открыть пост на сайте
EMMA: End-to-End Multimodal Model for Autonomous Driving

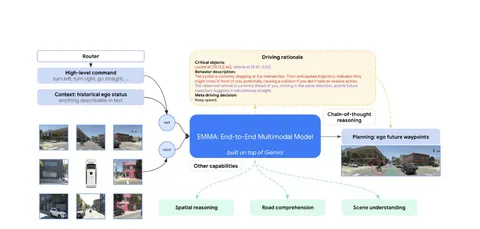
Сегодня разберём статью об EMMA — end-to-end модели на основе LLM для задач автономного вождения.

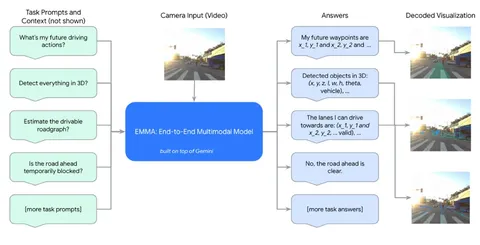
Верхнеуровнево архитектуру EMMA можно рассмотреть на схеме. В качестве LLM авторы используют Gemini. На входы модели подают изображения с камер (camera-only), историю ego и подсказки маршрутизатора. HD-карты не используются.

Chain-of-thought начинается с описания сцены (scene description), потом модель выделяет участников движения (critical objects) и переходит к описанию их поведения (behavior description of critical objects). А в конце — принимает решение, как управлять транспортным средством (meta driving decision).

Задачи перспешна (3D object detection, road graph estimation, scene understanding) решает Gemini — по изображениям с камер и соответствующим им промптам. Чтобы выбрать лучшую моду, модель считает попарные L2-расстояния между всеми траекториями. Топ-1 становится траектория с наименьшим средним L2.

Из плюсов EMMA — неплохие значения ADE по сравнению с Wayformer и MotionLM. Но недостатков у модели много:

🔴 повышенные вычислительные требования,
🔴 необходимость адаптировать сетку для обработки данных с лидаров,
🔴 сложности оценки модели в closed-loop,
🔴 небольшое число обрабатываемых изображений с камер.

EMMA — один из примеров того, как можно применять LLM для задач автономного вождения, выбивая при этом неплохие значения метрик open-loop. В целом, end-to-end подходы набирают всю большую популярность. Думаю, дальнейшие исследования будут направлены на преодоление вычислительных ограничений и внедрение симуляции сенсоров в closed-loop.

Разбор подготовил ❣️ Павел Лукьянов
404 driver not found
2 995 просмотров · 19 реакций Открыть в Telegram · Открыть пост на сайте
GaussianLSS — Toward Real-world BEV Perception: Depth Uncertainty Estimation via Gaussian Splatting

Авторы сегодняшней статьи предлагают альтернативу LSS. Для этого от задачи классификации распределения глубины они переходят к регрессии параметров распределения (среднего и дисперсии). В результате точно так же предсказывается распределение, но лоссы считаются иначе.

В GaussianLSS вместо BEVPool или BEVPoolv2 используется классическая растеризация через diff-gaussian-rasterization (как в компьютерных играх: проецируем полигоны/гауссианы на камеру/BEV). Именно так авторы получают BEV-фичи для прикладных задач, при этом увеличивая FPS за счёт diff-gaussian-rasterization. По FPS они побеждают всех конкурентов на бенчмарках, не сильно теряя в качестве.

Распределение вероятности по бинам предсказывается аналогично стандартному LSS. Но затем авторы считают среднее, поскольку знают, на каком расстоянии находится каждый бин, и дисперсию. Получаются точки в системе координат камеры (каждый пиксель — u,v и глубина для него — d). Они перегоняются в мировые координаты через внешние и внутренние матрицы калибровок.

Откуда вообще берётся распределение глубины? Как мы помним, в классическом LSS есть волшебный DepthNet, который предсказывает распределение глубины каждого пикселя и новые фичи. Авторы ещё немного модифицируют его так, чтобы получать ещё и opacity. Кажется, это сделано, потому что того требуют библиотеки для растеризации гауссиан. Но этот параметр можно как-нибудь использовать. Например, вы не хотите видеть бесполезное для ваших задач небо на BEV-фичах — благодаря opacity от него можно избавиться.

Итого, авторы получают в 3D-пространстве точки, у каждой из которых есть координата, матрица ковариаций (на самом деле немного вырожденная, потому что гауссиана растянута вдоль «луча», проходящего через пиксель камеры), а кроме того — opacity и фичи. Дальше можно просто взять и отрендерить гауссианы. У оригинальной diff-gaussian-rasterization не очень хорошая лицензия, но есть и «народная» реализация этой библиотеки.

После растеризации получаются стандартные BEV-фичи, которые можно использовать привычным способом.

Разбор подготовил ❣️ Денис Глазов
404 driver not found
1 243 просмотров · 28 реакций Открыть в Telegram · Открыть пост на сайте
Distilling Multi-modal Large Language Models for Autonomous Driving

Сегодня разберём статью о попытке дистиллировать VLM (а именно LLaVA-1.5-7b) в планнер — в теории это улучшает понимание сцен и подчищает длинные хвосты.

Ход мысли интересный:

🔴 VLM по умолчанию знает о мире больше, чем стандартная планнерная модель.
🔴 Чем больше размер, тем лучше обработка нишевых ситуаций.
🔴 Дистилляция позволяет эффективно упаковать оба предыдущих преимущества в меньшую модель для деплоя.

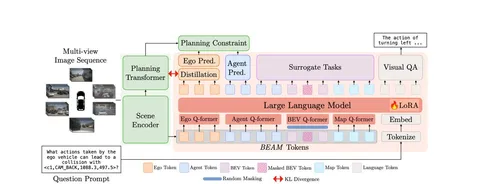
Для реализации авторы предлагают использовать предобученную для вождения end-to-end модель с промежуточными векторными представлениями. VLM, в свою очередь, умеет отвечать на вопросы, и у неё тоже есть выходные эмбеды — обе модели доучивают параллельно, накладывая ограничение: их векторные пространства должны быть похожи по KL.

Но если обучать VLM только предсказывать движение, она схлопнется и утратит свои обширные знания о мире. Чтобы избежать этого, обучение обогащают несколькими типами задач. Во-первых, реконструкцией маскированных токенов-агентов как в BERT. Во-вторых, ответами на текстовые вопросы. Например, учат отвечать, какая на улице погода или что будет делать агент перед нашим ТС. Чем лучше понимание сцены, тем выразительнее выход модели — векторное пространство.

Чтобы это всё работало, авторы адаптируют:

🔴 Входы. Учат Q-Former слои проекций для каждого типа данных (bev, карта, промпт). В итоге получается набор токенов, которые последовательно отдают в VLM.
🔴 Выходы. Готовят отдельные головы, чтобы предсказывать положения эго и агентов, решать синтетические задания и отвечать на текстовый промпт текстом.

Основную часть LLaVa авторы тренируют с помощью LORA: не трогают все веса, а только доучивают небольшие поправки к ним.

Этот подход напоминает известный способ быстрой разработки мультимодальных моделей, когда векторные представления претренированной LLM и картиночного энкодера файнтюнят на задачах в духе visual QA.

Попытку авторов дистиллировать VLM в планнер можно считать удачной:

🔴 Количество коллизий уменьшилось вдвое по сравнению с исходной end-2-end моделью.
🔴 Дистилляция прошла успешно, модель фактически не проседает на тесте без VLM.

Разбор подготовил ❣️ Кирилл Федянин
404 driver not found
1 328 просмотров · 21 реакций Открыть в Telegram · Открыть пост на сайте
Old but gold: Data Engine на примерах OWL и SAM [2/2]

Продолжаем разбирать популярные подходы к построению foundation model. В первой части обсудили SimCLR и DINO, сегодня в программе — Data Engine на примерах OWL и SAM.

У текстового и картиночного доменов есть одна общая черта — переход от стандартных пайплайнов разметки к комбинированным. Это когда одну половину данных обрабатывает человек, а к другой подключается модель.

Хороший пример human-in-the-loop pipeline: RLHF (reinforcement learning from human feedback) завёлся для текстового домена, но не работает для компьютерного зрения. Так для задач обработки изображений появился родственный пайплайн — model-in-the-loop.

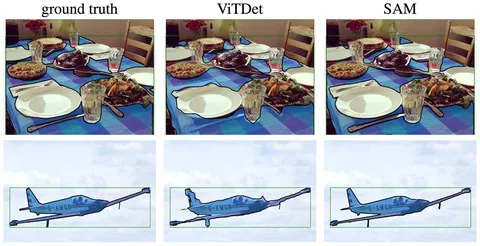
Работы Scaling Open-Vocabulary Object Detection (OWLv2) и Segment Anything (SAM) вышли в одно и то же время. Обе они посвящены схожему концепту Data Engine:

1. Модель v1 обучают на датасете, собранном мануально.
2. Модель v1 участвует в псевдоразметке примеров. Разметку по необходимости корректирует человек — получается псевдодатасет.
3. На полученном псевдодатасете обучают модель v2.
4. Модель v2 порождает следующую волну разметки. Алгоритм можно повторять до тех пор, пока не получится модель с нужным качеством.

Дообучение модели на собственных предсказаниях работает, если осмысленно подойти к отбору этих самых предиктов: добавлять в датасет только самые сложные, противоречивые примеры.

Качественную задачу можно свести к количественной, если хорошо настроить конвейерную автоматику движка данных на каждом из этапов:

🔴 обучение очередной итерации модели,
🔴 отбор сцен, сложных для новой версии модели,
🔴 псевдоразметка моделью,
🔴 корректировка человеком при необходимости.

Пересмотреть подход к отбору данных пытаются во многих современных работах. Например, в DINOv2, Llama2 и Llama3 много внимания уделяют дедупликации данных и улучшению разнообразия датасетов. А также ищут способы повысить эффективность обучения на выросшем корпусе данных.

Разбор подготовил ❣️ Сергей Ким
404 driver not found
1 232 просмотров · 24 реакций Открыть в Telegram · Открыть пост на сайте
Old but gold: SimCLR и DINO [1/2]

Сегодня начнём разбирать популярные подходы к построению foundation model. Первым двум работам уже много лет, но их основные идеи до сих пор актуальны.

A Simple Framework for Contrastive Learning of Visual Representations (или просто SimCLR)

Эта статья была очень популярна в своё время, хотя её идея совсем проста.

Есть несколько изображений. Каждое из них аугментируют двумя способами, после чего подают на вход модели-эмбеддеру все аугментированные изображения. А дальше — обычный contrastive learning. Эмбеды, соответствующие аугментациям одного и того же изображения, приближают друг к другу, одновременно отдаляя от эмбедов прочих аугментированных изображений. Заранее размечать данные при таком подходе не нужно.

Авторы рассуждают, какие именно рецепты аугментаций лучше подойдут для задачи self-distillation. Общий компонент рецептов — разбиение аугментаций на сильные и слабые: одно аугментированное изображение из пары всегда будет испорчено сильнее, чем другое

DINO: Emerging Properties in Self-Supervised Vision Transformers

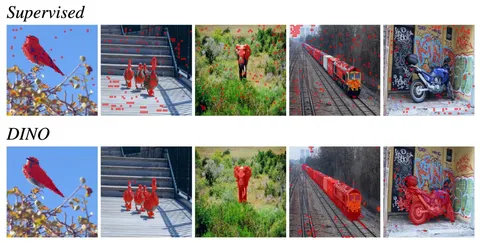
В этой статье используется метод self-distillation, для которого лейблы тоже не нужны. Моделью-учителем становится компиляция последних итераций ученика.

Изображение, которое подаётся на вход учителю и ученику, аугментируют по-разному:

🔴 Для модели-учителя готовят глобальные аугментации (для простоты можно считать, что они строятся по всей картинке целиком, без crop-and-resize).
🔴 Для ученика — локальные (кусочек изображения).

Авторы не привязываются к конкретной архитектуре, но отмечают, что лучших результатов удаётся достигнуть с помощью ViT.

После выхода статьи метод DINO эволюционировал: в 2023 году появился DINOv2, в 2025 — DINOv3. Но изменения скорее инженерные: авторы работали над обогащением данных интересными примерами, дедупликацией, а также над ускорением и эффективизацией процесса обучения

В следующей серии поговорим о semi-supervised подходах к построению foundation model.

Разбор подготовил ❣️ Сергей Ким
404 driver not found
1 283 просмотров · 37 реакций Открыть в Telegram · Открыть пост на сайте
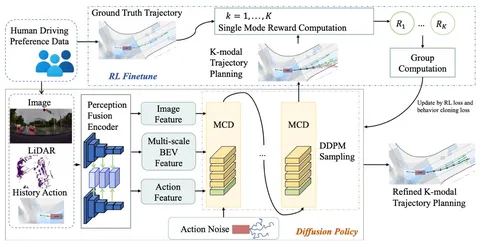
Learning Personalized Driving Styles via Reinforcement Learning from Human Feedback

Обычно планировщики для вождения обучаются на демонстрациях очень разных водителей. Одни предпочитают водить безопасно, другие — быстрее оказываться дома за счёт более рисковых манёвров. Типичная модель-планировщик выдаёт усреднённое вождение. В сегодняшней статье авторы задаются вопросом, как сделать стиль вождения планировщика более выраженным.

RLHF (reinforcement learning from human feedback) — тот самый алгоритм, который используют для алайнмента моделей под потребности людей в текстовых LLM, в том числе в оригинальном ChatGPT: людей просили людей ранжировать ответы, и по их оценкам нейросеть обучалась говорить приятное и полезное.

Алгоритм редко применялся для решения задач автономного транспорта. В этой статье авторы тоже получили своего рода кашу из топора: фундаментальная идея подхода сохранилась, но реализацию каждой детали изменили. Тем не менее, ключевой результат всё равно получился интересным:

🔴 Разделили стили вождения в сценах на шесть классов — от очень спокойного до очень агрессивного.
🔴 С помощью небольшого файнтюна научили модель менять стиль вождения.

Исходная архитектура — мультимодальная диффузионка. Не самый типичный выбор для планировщика, но и не первое упоминание такого подхода: претрейн для всех стилей одинаковый, а диффузионка позволяет лучше сохранять всё распределение возможных траекторий.

Самое интересное происходит во время дообучения. Если для претрейна используют данные о водителях с очень разными стилями вождения, то для файнтюна предлагают фильтровать сцены, оставляя только подходящие. Далее тренируют отдельную модель награды, которая должна присваивать траекториям одинакового стиля более высокий скор, если их сгенерировал человек, а не претрейн-модель. Эти награды помогают дообучить основную модель с GRPO на крошечном датасете: 5 тысяч сцен против полумиллиона в претрейне. То есть, авторы буквально активируют определённый стиль, в котором модель уже умеета водить.

Метод отлично работает — на бенчмарке ощутимо меняется профиль скорости, метрики сильно растут в соответствии со стилем. На общих датасетах результаты ожидаемо немного проседают, но не драматично.

Разбор подготовил ❣️ Кирилл Федянин
404 driver not found
1 273 просмотров · 30 реакций Открыть в Telegram · Открыть пост на сайте
MADrive: Memory-Augmented Driving Scene Modeling

Сегодня разберём нашу статью о новом фреймворке для реконструкции дорожных сцен в задачах автономного вождения — MADrive. Он объединяет в себе две идеи:

🔴 3D Gaussian Splatting (3DGS), чтобы реконструировать объекты и сцены, а потом генерировать новые кадры (novel-view synthesis).
🔴 Внешний банк объектов. Он помогает создавать реалистичные кадры с тех ракурсов, для которых не хватало исходных данных.

Как это работает
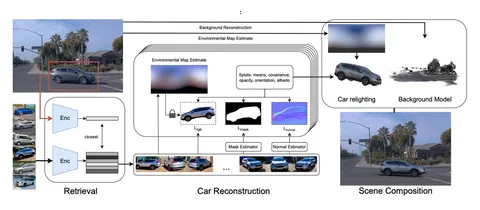
Мы декомпозируем сцену на статический фон (дорога, здания, деревья) и динамику (автомобили). Фон восстанавливаем c помощью 3DGS по данным с камер, уже известным положениям камер в проезде и лидарным 3D-точкам (как начальное приближение для положения сплатов).

Для эффективной работы с автомобилями мы предварительно собрали датасет MAD-Cars. В него вошли около 70 тысяч 360-градусных видеозаписей автомобилей разных моделей и цветов.

Чтобы реконструировать автомобили при обработке проезда:

1. Выделяем каждый автомобиль на сцене в 3D-бокс.
2. Получаем 2D-кроп по проекции бокса на кадр.
3. Считаем эмбеддинг SigLIP2 для кропа и уточняем цвет машины с помощью Qwen2.5-VL.
4. Находим похожую машину в MAD-Cars по эмбеддингу и цвету (косинусное сходство).
5. Для найденного автомобиля строим новую 3D-модель c помощью 2D Gaussian Splats. Попутно явно разделяем цвет автомобиля и влияние освещения, при котором записывали 360-градусное видео для MAD-Cars.
6. Переосвещаем восстановленную 3D-модель автомобиля с учётом освещения на реконструируемой сцене. Вставляем модель в сцену на место реальной машины.

Зачем это нужно
MADrive позволяет достоверно генерировать синтетические сенсорные данные для новых дорожных сценариев. MAD-Cars полезен для многих задач 3D Computer Vision — от реконструкции до генерации сцен.

Познакомиться с MADrive и MAD-Cars можно на странице проекта, а узнать больше об их создании — на Хабре.

Разбор подготовил ❣️ Кирилл Струминский
404 driver not found
1 273 просмотров · 44 реакций Открыть в Telegram · Открыть пост на сайте
DINO-MOT: 3D Multi-Object Tracking With Visual Foundation Model for Pedestrian Re-Identification Using Visual Memory Mechanism

В этом исследовании ищут решение задачи 3D Multi-Object Tracking (3D-MOT) в контексте автономного вождения. Акцент делают на том, как повысить точность отслеживания пешеходов.

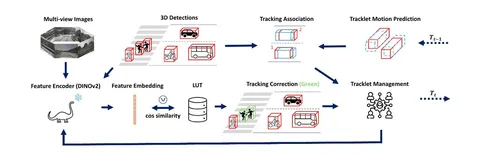
Фреймворк DINO-MOT, по мнению авторов, расширяет классический подход Tracking-by-Detection за счёт интеграции DINOv2. Ключевая идея — использование визуальной информации с камер для повторной идентификации (Re-Identification) пешеходов. Это позволяет снизить количество ID switches до 12,3%.

3D-детекции пешеходов проецируются на 2D-изображения, из которых извлекают области интереса (кропы). Эти изображения обрабатывают энкодером DINOv2: получают признаковые эмбеддинги и сравнивают их с визуальной памятью (Lookup Table) с помощью косинусной схожести для коррекции треков.

Прогноз движения на основе расширенного фильтра Калмана, двухэтапная ассоциация с обобщённым IoU и другие элементы фреймворка обеспечивают робастность трекинга для различных классов объектов.

На момент публикации DINO-MOT лидирует на бенчмарк-наборе nuScenes: устанавливает новое SoTA-значение по метрике AMOTA — 76,3%.

По результатам абляционных исследований, интеграция DINOv2:

🔴 Позволяет стабильно снижать ID switches для пешеходов, если использовать различные детекторы.
🔴 Не оказывает негативного влияния на общую точность трекинга.

Замеры производительности указывают на потенциальную применимость подхода в реальном времени, что делает его практичным для автономных систем.

Разбор подготовила ❣️ Ольга Ротова
404 driver not found
1 155 просмотров · 22 реакций Открыть в Telegram · Открыть пост на сайте
MoDAR: Using Motion Forecasting for 3D Object Detection in Point Cloud Sequences

Сегодня разберём статью на стыке perception и BL (behavior layer). Объединив очень разные элементы восприятия (perception) и предсказания (prediction) робота, команда Waymo улучшила обнаружение 3D-объектов для детекторов, которые работают с облаками точек и их последовательностями.

В чём проблема? Современные системы плохо справляются с обнаружением перекрытых и удалённых объектов. Обработка множества лидарных кадров требует огромных ресурсов. Можно было бы фьюзить облака точек на уровне объектов, потому что это дешевле с точки зрения вычислений. Но тогда возникают проблемы с выравниванием (alignment).

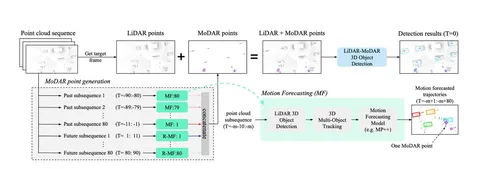
Система MoDAR вместо прямой обработки всех кадров использует прогнозирование движения как дополнительную модальность. Алгоритм создаёт виртуальные точки с информацией о предсказанных позициях объектов из прошлых и будущих кадров.

Способ, который придумали авторы, помогает прокачать качество обработки облаков. На основе предсказаний траекторий из BL они создали для детектора виртуальную модальность под названием MoDAR (по аналогии с LiDAR).

Точки MoDAR — это центры объектов по предсказаниям из прошлого в настоящее (онлайн) и из будущего в настоящее (офлайн). Они образуют новую легковесную модальность: число точек, полученных из временного контекста 18 секунд (9 из прошлого + 9 из будущего) меньше, чем в одном лидарном фрейме.

Полный флоу решения — на схеме. Авторы используют два 3D-детектора: CenterPoint и SWFormer. В качестве модели предсказания движения выбрали MultiPath++, обученный на Waymo Open Motion Dataset.

На 3-frame SWFormer + 18 секунд MoDAR удалось существенно повысить качество (mAPH) в сложных кейсах (L2-срез на Waymo Open Dataset). При этом практически SoTA-результат не требует значительных дополнительных вычислительных затрат.

404 driver not found
1 302 просмотров · 33 реакций Открыть в Telegram · Открыть пост на сайте
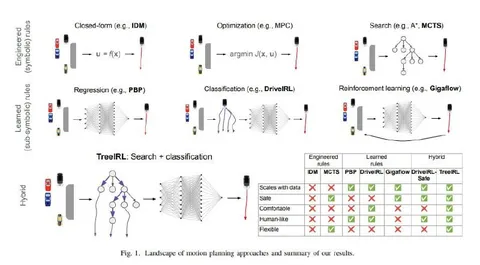
TreeIRL: Safe Urban Driving with Tree Search and Inverse Reinforcement Learning

Сегодня разберём статью, в которой авторы предлагают использовать поиск монте-карло по дереву (Monte-Carlo Tree Search, MCTS) для задачи планирования. Как и в обычном MCTS, сначала генерируется множество траекторий, а затем на каждом шаге поддерживается баланс между перспективными направлениями и теми, которые ещё не исследованы.

Перспективность направления определяется функцией награды, учитывающей несколько факторов:

🔴 штраф за рывки (для комфорта),
🔴 штраф за столкновения с машинами и людьми,
🔴 адекватное расстояние до агента спереди,
🔴 следование на скорости около максимальной разрешённой,
🔴 остановки в местах, где это необходимо,
🔴 опционально — предобученная PPO-политика и её функция ценности V.

Исследователи генерируют всего 400 траекторий и выбирают из них 100 наиболее перспективных кандидатов по награде. Отобранные траектории удовлетворяют формальным требованиям, однако не все из них применимы в реальности.

Для решения этой проблемы авторы обучают отдельную модель на inverse reinforcement learning. Её задача — дать скалярное значение z, которое позволит из представленных траекторий выбрать наиболее «человекоподобную». При обучении используется таргет exp(z_i)/sum_z(exp(z)) — подходящая траектория определяется по подобию в L2-норме. В итоге из 100 траекторий-кандидатов остаётся только одна, лучшая по IRL-оценке. Она удовлетворяет формальным критериям и похожа на то, как водил бы человек.

Этот метод отличается от обычного подхода, где сначала нейросеть генерирует несколько траекторий, а потом их проверяют на формальную безопасность. Это свежий взгляд, но, к сожалению, остаётся неочевидным, насколько хорошо он масштабируется: подход тестировался как адаптивный круиз-контроль, и модель предсказывала только продольные рывки. С этим ограничением мы имеем всего 5 возможных действий против, например, 169 в другом популярном методе, MotionLM. Количество возможных деревьев в таком случае астрономически меньше — 390 тысяч против 600 квадриллионов.

Что касается результатов работы модели, то в категории адаптивного круиз-контроля на бенчмарке nuPlan TreeIRL показала себя весьма хорошо. Модель также применялась на дорогах общего пользования и смогла проехать 400 км без вмешательств.

Разбор подготовил ❣️ Кирилл Федянин
404 driver not found
1 298 просмотров · 25 реакций Открыть в Telegram · Открыть пост на сайте
Топ статей 2025: выбор команды 404 driver not found

Пока все (и мы тоже) вспоминают, как работать после праздников, предлагаем почитать наши любимые разборы из прошлого года.

CenterPoint и TransFusion: обзор двух подходов к задаче детекции
Разбор сразу двух статей о SoTA-способах 3D-детекции.

RefAV: Towards Planning-Centric Scenario Mining
Статья о том, как навайбкодить фильтры и получить «золотые» примеры событий в огромном массиве данных, оперируя полуразмеченым потоком, который записал автомобиль.

Direct Post-Training Preference Alignment for Multi-Agent Motion Generation Models Using Implicit Feedback from Pre-training Demonstrations
Новый подход к дообучению traffic prediction-моделей без ручной разметки.

DetZero: Rethinking Offboard 3D Object Detection with Long-term Sequential Point Clouds
Фреймворк для офлайн-детекции и трекинга на основе длинных последовательностей лидарных точек (до 200 кадров), который занимает первое место на лидербордах WOD 3D Detection и WOD 3D Tracking.

А если вдруг пропустили, вот топ-5 2025, который сформировали вы.

В 2026 продолжим разбирать научные статьи, делиться интересными находками и обсуждать горячие вопросы индустрии — не переключайтесь!

Продолжает делиться с вами интересным ❣️ команда
404 driver not found
1 092 просмотров · 15 реакций Открыть в Telegram · Открыть пост на сайте
Топ-5 статей 2025: выбор читателей 404 driver not found

Наш канал появился совсем недавно, но подвести промежуточные итоги уже можно.

Спасибо, что были с нами в этом году, читали и лайкали! Собрали обзоры, которые понравились вам больше всего: сохраняйте себе и делитесь с друзьями.

SimpleBEV: Improved LiDAR-Camera Fusion Architecture for 3D Object Detection
О perception много статей с графиками и кодом, но лишь единицы попадают в топ лидерборда nuScenes — главного датасета для автономного вождения. Именно там нашлась эта статья.

UnO + GASP
Разбор двух похожих и крайне интересных статей на довольно редкую в сфере автономного транспорта тему претрейна.

Sparse4D v3: Advancing End-to-End 3D Detection and Tracking
Обсудили ещё одну редкую тему: End-to-End 3D Detection and Tracking, а именно — детектор Sparse4Dv3 с хорошими метриками на nuScenes.

Scaling Laws of Motion Forecasting and Planning
Waymo, подразделение беспилотных автомобилей Google, выпустило техрепорт о том, как масштабируются модели. Похожая статья об LLM сильно повлияла на свою сферу несколько лет назад. А теперь аналогичное исследование провели для планировщиков движения автомобилей.

Closed-Loop Supervised Fine-Tuning of Tokenized Traffic Models
Статья о том, как ребята из NVIDIA заняли первое место в лидерборде WOSAC от Waymo. Обсуждали цикл SFT, а не способы токенизации, слои архитектуры или внутренний cross attention.

А какие статьи запомнились в этом году вам? Расскажите в комментариях.

С наступающим! После праздников мы вернёмся с новыми разборами. До встречи в новом году!

Сформировали этот топ ❤️ уважаемые подписчики
404 driver not found
1 147 просмотров · 28 реакций Открыть в Telegram · Открыть пост на сайте
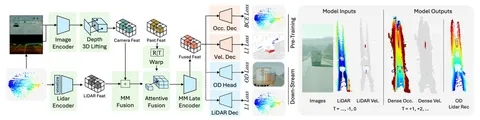
Self-Supervised Sparse Sensor Fusion for Long Range Perception

Авторы этой статьи предлагают новый подход к long-range perception: sparse-voxel-фьюжн камер и лидара с временным контекстом и SSL-предобучением. Всё это и собственный long-range-датасет позволили решению претендовать на SoTA на бенчмарках.

Ключевые фичи:

🔴 Sparse voxel representation вместо BEV помогает скейлиться на дальние расстояния.
🔴 Camera–LiDAR-фьюжн. Изображения с камер обрабатываются по схеме RGBD → Vision Mamba (ViM) → depth-module (RNN уточняет глубину) → sparse voxel lifting.
🔴 Temporal fusion (временной контекст). Главная фишка — sparse window attention: делают аттеншн для вокселя с предыдущего кадра к его соседям в кубике 3×3×3.
🔴 Self-supervised pretraining (UnO-like), чтобы сэкономить на разметке.

Архитектура решения — на схеме выше. Камерные фичи энкодят отдельно, поднимают в 3D, а затем фьюзят с лидарными. Потом добавляют временной контекст, делают аттеншн и передают в две головы, которые предсказывают occupancy и velocity.

Данных мало — чтобы получить нормальную разметку, нужно гораздо больше. Поэтому авторы собрали собственный датасет из информации о поездках на грузовике с 5 синхронными камерами и 4D-лидаром Aeva (radial speed, 400 м, 10 Гц). Радара не было. Так удалось собрать 60 тысяч кадров, из которых 35 тысяч разметили для детекции.

Image encoder и depth-module обучали вместе. Потом — reconstruction, depth supervision и дистилляционные лоссы фичей. Occupancy- и velocity-голову претрейнили SSL. В конце обучались распознавать объекты.

Результаты впечатляют:

🔴 Depth Prediction: −27% MAE и −25% MSE vs SoTA при инференсе в 0,064 с на памяти 1,3 ГБ.
🔴 Object Detection: +26.6% к SoTA SAMFusion.

В целом, работа подтверждает: sparse-представления в сочетании с временным контекстом и SSL-предобучением дают заметный выигрыш именно в long-range-сценариях, где BEV-подходы быстро упираются в вычисления и память. Метод выглядит особенно убедительно как практичный компромисс между качеством, дальностью и стоимостью разметки.

Разбор подготовил ❣️ Владислав Поляков
404 driver not found
1 106 просмотров · 22 реакций Открыть в Telegram · Открыть пост на сайте
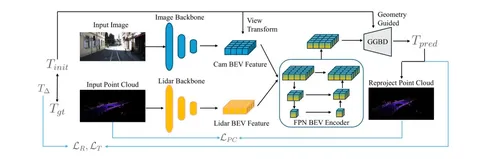
BEVCalib: LiDAR-Camera Calibration via Geometry-Guided Bird’s-Eye View Representations

Авторы сегодняшней статьи утверждают, что создали первый targetless-подход с BEV. Опираясь на идею о том, что каждый BEV-объект соответствует определённой области в пространстве, они геометрически упростили маппинг таких объектов из разных модальностей.

Знакомьтесь, BEVСalib — модель для калибровок экстринсиков cam2lidar на основе BEVFusion.

Её архитектура (на первой схеме) почти полностью повторяет BEVFusion: изображение и облако точек попадают каждое в свой энкодер, проходят Fuser и FPN. Для предсказания матрицы калибровок результат попадает в Geometry-Guided BEV Decoder (или просто GGBD).

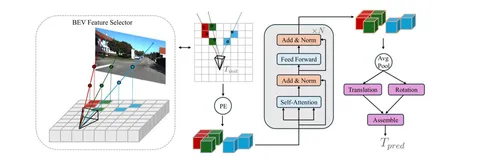
GGBD — разработка авторов. Она состоит из двух модулей:

🔴 Feature Selector — запоминает координаты, куда спроецировались камерные фичи.
🔴 Refinement Module — применяет self-attention к фичам по запомненным координатам.

После нескольких SA-блоков используется Global Average Pooling и выход из векторов перемещения и кватерниона поворота. Кватернион поворота затем преобразуют в матрицу трансформации и объединяют с вектором перемещения. Рассмотреть процессы подробнее можно на второй схеме.

Лоссы стандартные:

🔴 Geodesic Loss на кватернион + регуляризация на нормальность вектора.
🔴 Smooth-L1 Loss для вектора перемещения.
🔴 Reprojection Loss на координаты облаков точек (по сути, L2).

BEVСalib — SoTA. Результаты работы модели обгоняют по качеству такие архитектуры, как Regnet, LCCNet, CalibAnything и Koide3. На датасетах KITTI, NuScenes и собственном наборе авторов CALIBD ошибка составляет ±0,1 угла для roll, pitch и yaw вне зависимости от раскалибровки.

Модель опенсорсная: попробовать её и посмотреть демо можно на официальном сайте.

Разбор подготовил ❣️ Антон Семенюта
404 driver not found
1 429 просмотров · 24 реакций Открыть в Telegram · Открыть пост на сайте
CenterPoint и TransFusion: обзор двух подходов к задаче детекции

Сегодня разберём сразу две статьи о SoTA-способах предсказывать положения объектов.

Center-based 3D Object Detection and Tracking

Если коротко, это Objects as Points. Авторы решают задачу детекции на облаках точек с помощью CenterNet на BEV-фичах.

CenterNet — 2D-object-детектор. Вместо поправок к anchor-боксам он предсказывает center-боксы (их размеры, глубины, ориентацию).

В CenterPoint авторы добавили стадию рефайнмента предсказанных боксов на основе BEV-фичей, взятых из середин граней боксов CenterNet.

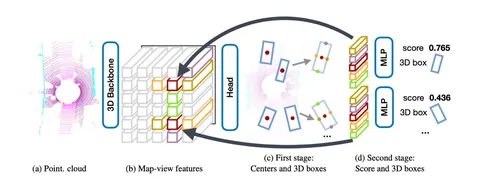
Архитектура (на первой схеме) состоит из трёх основных этапов:

1. 3D-Backbone выделяет фичи из облака точек.
2. СenterNet помогает получить из фичей 3D-боксы и их центры.
3. На стадии рефайнмента для каждого бокса по расположению достают и стакают 5 BEV-фичей. Перцептрон рассчитывает поправки к боксу и уверенность в нём (score) — это помогает уточнить предсказания.

Center-based-подходы лучше работают на классах объектов с особенностями — например, с необычными размерами. По результатам на nuScenes, авторы считают свой подход SoTA.

TransFusion: Robust LiDAR-Camera Fusion for 3D Object Detection with Transformers

В этой статье авторы решают задачу детекции с помощью данных камеры и лидара: мягко объединяют их с помощью cross-attention.

В основе TransFusion — DETR-like-подход с инициализацией object queries в локальных максимумах хитмапа, предсказанного по BEV-фичам.

DETR преобразует фичи объекта в вектора, добавляет positional encoding и подаёт результат на вход трансформер-декодера — так получаются вектора фич, которые знакомы с исходной картинкой.

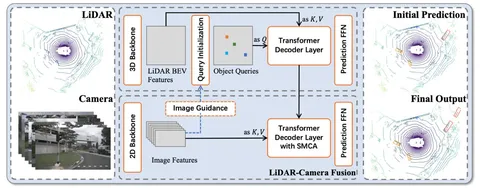
Голова-детектор (вторая схема) состоит из двух последовательных трансформеров-декодеров:

🔴 Первый осуществляет cross-attention из object queries в BEV-фичи.
🔴 Второй связывает полученные фичи с картинками с помощью spatially modulated cross-attention (SMCA).

Механизм SMCA между object queries и данными с камер помогает модели лучше отслеживать связанные области изображения.

TransFusion также показал SoTA-результаты на nuScenes. Авторы предлагают использовать этот подход для ускорения и упрощения задач 3D-сегментации.

Разбор подготовил ❣️ Владимир Филипенко
404 driver not found
1 095 просмотров · 24 реакций Открыть в Telegram · Открыть пост на сайте
Суперинтеллект и обучение в задачах робототехники: что обсуждают на NeurIPS 2025

Продолжаем репортаж с обеих площадок главной ML-конференции года. Новости из американского Сан-Диего читайте в канале ML Underhood. А двумя примечательными докладами из Мехико поделится Дмитрий Быков, руководитель группы AI-планирования робота доставки.

Спойлер: речь пойдëт об обучении с подкреплением.

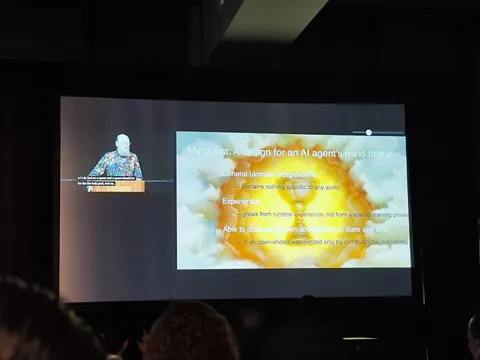
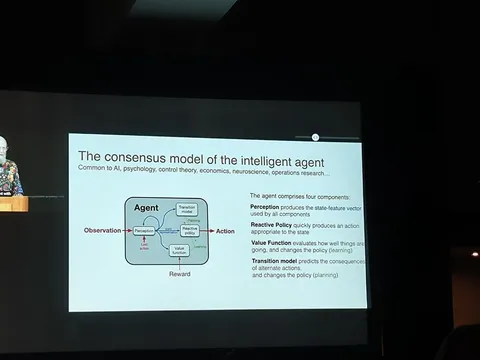
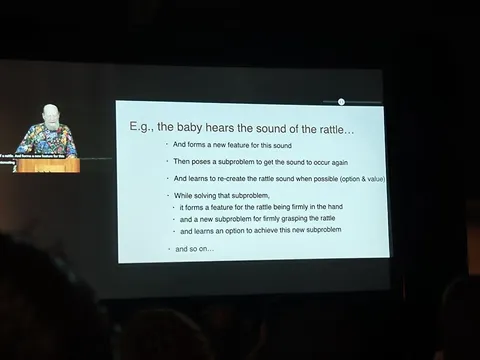
The OaK Architecture: A Vision of SuperIntellegence from Experience

Выступление Rich Sutton о том, каким он видит суперинтеллект.

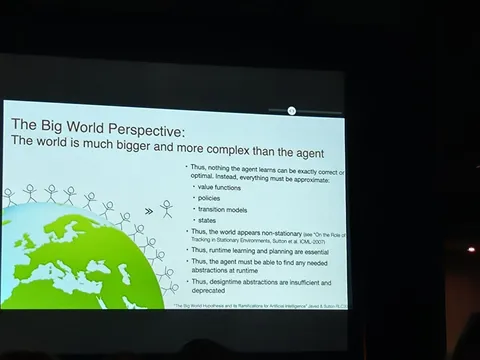
Первое, на что он обращает внимание, — авторы большинства работ вносят во множество доменов знания, которые помогают решить конкретные задачи. Но одновременно с этим их вклад начинает влиять на результаты работы моделей и делает их неоптимальными.

У суперинтеллекта, по его мнению, должно быть понятное представление о награде. Такое, чтобы у него появились все верхнеуровневые признаки, необходимые для формулирования подзадач, решение которых будет приближать награду.

При появлении новых признаков должна разрастаться и transition model (пространство действий которые возможно совершить).

PRINT: Preference-based Reinforcement Learning with Multimodal Feedback and Trajectory Syntesis from Foundation Models

Ребята сделали схему для обучения моделей, которые управляют роботом. В итоге смогли обогнать методы на моделях с одной из модальностей.

Сконструировать нормальный реворд сложно, а ручная разметка — очень дорогая. Чтобы обойти это, авторы попробовали обучаться на предпочтениях, сгенерированных моделями.

Несмотря на то, что текстовые модели любят галлюционировать, а VLM плохо сохраняют временные взаимодействия, их комбинация работает сильно лучше — они компенсируют недостатки друг друга.

В начале обучения авторы обходятся траекториями, сгенерированными LLM: генерируют, перемешивают и просят LLM выбрать лучшую. А дальше объединяют вердикты LLM и VLM.

Ещë один трюк — включение в лосс причинности. Так за счëт модели получается найти лучшие варианты и вознаградить их.


#YaNeurIPS25

Заметил на конференции ❣️ Дмитрий Быков
404 driver not found
871 просмотров · 21 реакций Открыть в Telegram · Открыть пост на сайте
NeurIPS 2025: начало

Началась главная ML-конференция — NeurIPS. В этом году она проходит сразу на двух площадках: в американском Сан-Диего и в мексиканском Мехико.

Мы будем рассказывать о том, что происходит в Мексике. Впечатления руководителя группы AI-планирования робота доставки Дмитрия Быкова читайте в ML Underhood. А здесь самым запоминающимся поделился наш коллега Владислав Фахретдинов из команды восприятия робота доставки.

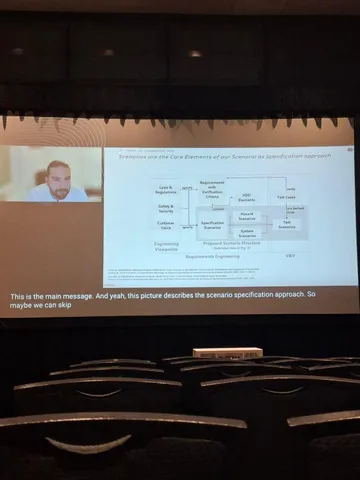
Главный мотив первого дня — безопасность и масштабируемость автономного транспорта. В отличие от ограниченной тестовой среды, в реальном мире, бесконечное количество ситуаций, когда система должна вести себя безопасно по отношению к другим и самой себе. Обсуждали, как эффективно тестировать автономные системы с учётом этого.

Сначала были доклады про построение сценариев и их реализацию. TL;DR: тестировать что-либо на реальных задачах слишком долго и дорого, лучше использовать симуляторы, а потом приближать их данные к реальности с помощью генеративных моделей

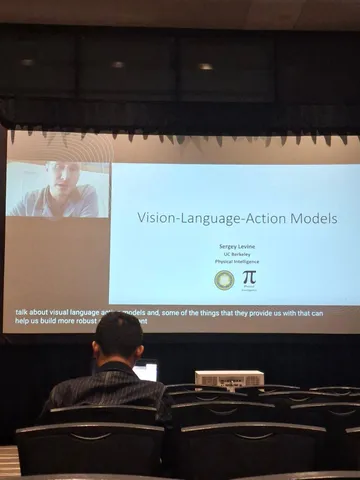
Далее был простой, но интересный рассказ Sergey Levine из UC Berkley про историю развития VLA от LLM и VLM до будущего в построении foundation-моделей.

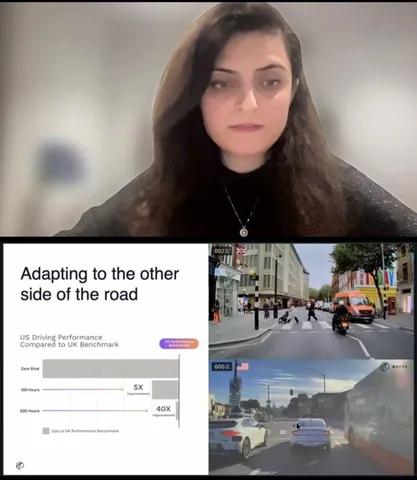
Самую интересную работу, на мой взгляд, привезла команда Wayve, которая делает автономный транспорт.

Во-первых, они показали свою автономную систему. Она обучается end-to-end, на вход принимает сенсоры, на выходе возвращает всё для управления, также есть контур безопасности. Обучив систему на данных и
з UK, ребята проверили её на 500 других городах и показали, что модель стала лучше адаптироваться к дорожным и географическим условиям.

Во-вторых, ребята привезли сразу две своих foundation-модели:

GAIA-2 — модель генерации реального мира, которая на основе начальных данных с камер и условий (положения и поведение агентов и самого транспортного средства, состояние окружения) умеет фотореалистично предсказывать изображения с камер.

Модель состоит из двух частей: токенизатора для перевода видео в латентное пространство и модели мира для генерации будущего латентного состояния мира.

Вторая модель — LINGO-2 — VLA. Она добавила в систему общие человеческие знания и размышления, а также
возможность описывать действия.

Комбинация этих моделей:

🔴 E2E — помогает системе быть более устойчивой и лучше обобщаться, но требует много данных.
🔴 Модель симуляции мира — позволяет проводить сколь угодно разнообразные тесты и проверять безопасность системы.
🔴 VLA — делает систему еще более устойчивой и обобщаемой.

У себя на сайте ребята пишут про L4-уровень автономности, также там много интересных видео. И хотя они ещё не вышли на уровень массовой масштабируемости, в их машине вполне ездит Huang — думаю, можно считать их разработки будущим отрасли.


#YaNeurIPS25

Выбрал самое интересное из событий первого дня ❣️ Владислав Фахретдинов
404 driver not found
1 008 просмотров · 33 реакций Открыть в Telegram · Открыть пост на сайте
DetZero: Rethinking Offboard 3D Object Detection with Long-term Sequential Point Clouds

Авторы этой статьи утверждают, что их алгоритм работает лучше, чем ручная разметка, если оценивать по методике 3DAL от Waymo. Знакомьтесь, DetZero — фреймворк для офлайн-детекции и трекинга на основе длинных последовательностей лидарных точек (до 200 кадров), который занимает первое место на лидербордах WOD 3D Detection и WOD 3D Tracking.

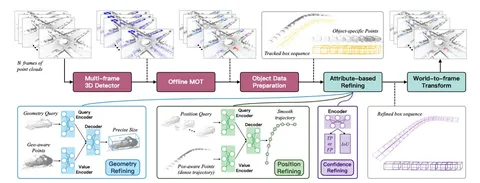
В основе фреймворка — двухпроходный алгоритм. Общий пайплайн работы с данными выглядит так:

🔴 Мультикадровый детектор получает на вход N кадров с облаками точек.
🔴 Первый проход: офлайн-трекер генерирует точные и полные треки объектов с помощью модификации CenterPoint. В DetZero учитывают плотность точек и используют не один, а пять соседних кадров. А ещё — добавили TTA и ансамбль однотипных моделей.
🔴 Второй проход: пообъектное рассмотрение треков. Для треков каждого объекта готовят собственные последовательности лидарных точек — используют только те точки, которые заметаются боксами трека. Боксы немного расширяют, чтобы замести окрестность побольше.
🔴 Треки улучшают с помощью трёх одновременных действий: уточнение геометрических размеров объекта, сглаживание траектории движения и перерасчёт уверенности.
🔴 Все треки собирают в единую картинку и превращают в лейблы. Точки, связанные с объектом, переводят в систему координат bounding box. После этого происходит geometry (GRM), position (PRM) и confidence (CRM) уточнение при помощи обучаемых моделей на основе PointNet.

В 2023 году DetZero занял первое место в рейтинге обнаружения 3D-объектов от Waymo с производительностью обнаружения 85,15 mAPH.

Рассмотреть алгоритм в деталях можно на схеме, попробовать — на Github авторов.

Разбор подготовил ❣️ Александр Пономарчук
404 driver not found
926 просмотров · 26 реакций Открыть в Telegram · Открыть пост на сайте
Sparse4D v3: Advancing End-to-End 3D Detection and Tracking

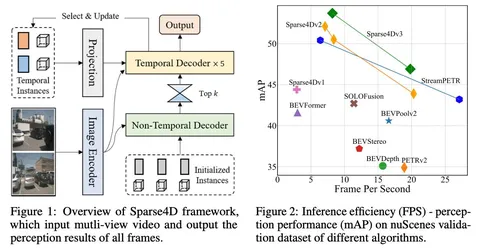
Сегодня разберём одну из немногих статей об End-to-End 3D Detection and Tracking. Речь пойдёт о детекторе Sparse4Dv3 с хорошими метриками на nuScenes — главном опенсорс-датасете для автономного транспорта.

Sparse4D — camera-only multi-view 3D-детектор, который авторы постоянно развивают. Сегодня у него уже три версии, и в самой последней появился multi-object tracking. Но обо всём по порядку.

Sparse4D v1. Первый подход — энкодер-декодер архитектура camera-only multi-view детектор с временным контекстом.

Из кадров видео, которое подаётся на вход, выделяются image-features с нескольких камер с разными масштабами и таймстемпами. Декодер делает последовательный фьюз этих фичей, используя 3D-anchor-box. После декодера инстансы рефайнят (доуточняют) с учётом confidence. Результат работы модели — предсказание положения 3D-box (задаются координатами, размерами и скоростью).

Sparse4D v2 — улучшение первой версии за счёт применения рекуррентной схемы с фьюзом временного контекста. Дополнительно улучшить сходимость обучения модели на ранних шагах помогли данные о глубине лидара.

Sparse4D v3. Авторы ускорили обучение и улучшили сходимость модели:

🔴 Temporal Instance Denoising — зашумили GT и добавили в обучение.
🔴 Decoupled Attention: заменили сложение на конкатенацию в механизме attention.
🔴 Quality Estimation: оценили centerness (уверенности в координатах) и yawness (уверенности в поворотах) в общий confidence каждого предсказания, а потом прокинули это в loss.

А ещё в этой версии появилась возможность трекинга. Чтобы реализовать её, авторы добавили в информацию каждого предикта идентификатор (id): для предиктов из предыдущих кадров они сохранялись, для новых — генерировались заново. Так процесс трекинга не требует дообучения или файнтьюнинга детектора. Это просто дополнительная функциональность — назначение и сохранение id во времени.

Познакомиться с решением поближе можно на Github авторов.

Разбор подготовила ❣️ Ольга Ротова
404 driver not found
3 304 просмотров · 35 реакций Открыть в Telegram · Открыть пост на сайте
Closed-Loop Supervised Fine-Tuning of Tokenized Traffic Models

Сегодня разберём статью о том, как ребята из NVIDIA заняли первое место в лидерборде WOSAC от Waymo. Речь пойдёт о цикле SFT, а не о способах токенизации, старых слоях архитектуры или внутреннем cross attention.

CAT-K — стратегия файнтюнинга, основанная на top-k-подходе. Её авторы поднимают проблему миссматча распределений во время обучения и на инференсе.

Для обучения в open-loop используются траектории водителей как условия (обуславливание на историю) в режиме behavior cloning. Но при симуляциях на инференсе агенты двигаются уже не по таким же хорошим траекториям в closed-loop, а по своим собственным: с ошибками, которые накапливаются при последовательной генерации движения. Так могут возникать состояния, неучтённые в обучении.

В качестве бейзлайна авторы используют авторегрессионный подход SMART с дельта-токенами:

1. Фиксируют сетку по времени с шагом 0,5–2 секунды прошлого и 8 секунд будущего.
2. На каждом шаге по времени предсказывают для каждого агента токен с собственным сдвигом в координатах.

Обычно авторегрессионные модели для Traffic Motion тренируют с помощью teacher-forcing как LLM модели: формулируют Traffic Motion как Next-Token-Prediction. Но для того, чтобы уменьшить миссматч авторы адаптируют Cross-Entropy Method (или модный SFT из LLM).

Как устроен CEM:

1. Генерирация набора траекторий (в closed-loop)
2. Отбор лучших кандидатов по метрике элиты.
3. Дообучение в режиме teacher-forcing на элитах.

Элиты — моды в распределении, индуцируемом обученной моделью. Они близки к GT-тракеториям. То есть, если дообучаться на хороших траекториях из симуляций в closed-loop, миссматч между обучением и инференсом уменьшится.

Остаётся только адаптировать дельта-токены для CEM:

1. Выбрать K самых вероятных токенов на текущем шаге генерации.
2. Из K самых вероятных токенов выбрать тот, что лучше всего аппроксимирует GT.
3. Использовать выбранный токен для пересчёта следующего состояния.

Контроль количества элит при генерации помогает избежать лишних симуляций и их фильтрации: дискретизация дельта-токенов — дискретизация первого порядка.

Внедрение CAT-K помогло небольшой политике моделирования токенизированного трафика с 7 миллионами параметров превзойти модель с 102 миллионами параметров из того же семейства моделей и занять первое место в таблице лидеров Waymo Sim Agent Challenge на момент подачи заявки.

Разбор подготовил ❣️ Тингир Бадмаев
404 driver not found
3 090 просмотров · 33 реакций Открыть в Telegram · Открыть пост на сайте
UnO + GASP

Сегодня обсудим две похожие и крайне интересные статьи на довольно редкую в сфере автономного транспорта тему претрейна — UnO: Unsupervised Occupancy Fields for Perception and Forecasting и GASP: Unifying Geometric and Semantic Self-Supervised Pre-training for Autonomous Driving.

Первая статья вышла в июне 2024 года. Её авторы, коллеги из Waabi, вдохновились идеями из мира LLM и придумали, как запускать SSL-претрейн BEV-like-энкодеров. Для этого они:

1. Прогоняют сцену через энкодер, получая BEV.
2. Затем генерируют query:
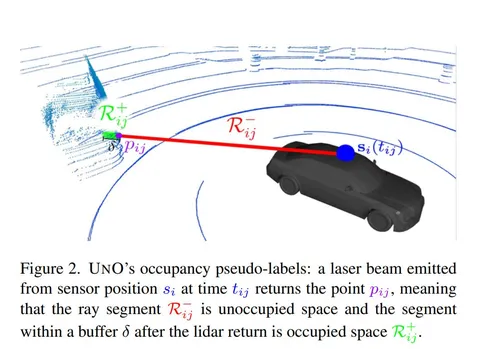
2.1 Луч лидара летит от ego до объекта. Если на пути луча нет препятствий, значит для любой точки на этом отрезке occupancy равняется нулю (можно ехать).
2.2 Когда луч лидара попадает в объект, в этой точке (плюс eps за эту точку) occupancy равняется единице.
3. Через Deformable Attention подтягивают фичи с BEV для каждой точки из пункта 2 и решают задачу классификации occupancy.
4. Query можно генерировать из «будущих кадров», то есть предсказывать occupancy для точек x, y, z, t.

В результате энкодер выучивает какие-то разумные фичи сцены и понимает, куда движутся объекты в сцене. Авторы также делают SFT для семантической сегментации BEV и показывают, что их претрейн даёт хорошие результаты, особенно при нехватке размеченных данных.

В марте 2025-го другая группа исследователей выпускает статью о развитии метода — GASP. Здесь авторы добавляют ещё несколько UnO-like-голов. В этом подходе для каждой точки query можно предсказывать не только occupancy, но и DINO-фичи, которые проецируются с картинки на лидарную точку. Таким образом семантика «проливается» в претрейн.

Кроме того, зная GT-траекторию, можно сэмплировать из неё точки (а также некоторый радиус) и задавать этим точкам класс 1, а остальным — 0, затем решая классификацию вида «хотим ли мы туда ехать».

Далее авторы делают SFT на тех же задачах, что и в UnO, получая ещё более качественные результаты. GASP — по сути тот же UnO, но быстрее, выше, сильнее.

Разбор подготовил ❣️ Денис Глазов
404 driver not found
949 просмотров · 37 реакций Открыть в Telegram · Открыть пост на сайте