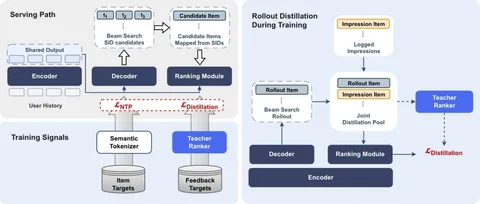
О первой статье Gryphon мы уже рассказывали. Теперь вышла вторая работа, Gryphon-v2: One Model in Place of a Cascade, где мы попробовали заменить одной моделью весь рекомендательный каскад.
В первой версии Gryphon уже объединял Semantic-ID generation и item-level scoring. Пользовательская история кодировалась один раз, а дальше модель генерировала кандидатов и сама их скорила. Но финальное ранжирование всё ещё оставалось за отдельным production ranker.
Gryphon-v2 делает всё внутри одной модели: декодер генерирует 1024 Semantic ID, из которых набирается до 1200 треков, и Ranking Module сразу ранжирует выдачу для пользователя.
Компактный Ranking Module мы обучаем дистилляцией: в роли учителя выступает большой трансформер, проученный на годе таргетов без единой ручной фичи. Чтобы Gryhon-v2 качественно решал задачу полного каскада, мы разработали Rollout Distillation: во время обучения текущая версия декодера генерирует кандидатов через beam search, учитель их оценивает, а Ranking Module тренируется воспроизводить эти оценки. Так модель лучше ранжирует кандидатов, похожих на тех, с которыми встретится на инференсе. Больше 90% уникальных кандидатов для дистилляции приходят именно из таких rollout’ов.
В A/B-тесте на Яндекс Музыке Gryphon-v2 поставили вместо полного production-каскада. Число активных пользователей выросло на 1,41%. Total listening time выросло на 1,62%, лайки — на 7,12%, доля недослушанных треков снизилась на 9,65%.
Это первый эксперимент в Яндексе, где одна модель смогла заменить собой полный каскад, прирастив метрики.
Над статьёй работали коллеги из нескольких команд рекомендательных технологий Яндекса: Анна Липкина, Дарья Тихонович, Виктор Януш, Мария Ульянова, Олег Сорокин, Владислав Додонов, Илья Мурзин, Денис Бурштейн и Николай Савушкин.
ML Underhood