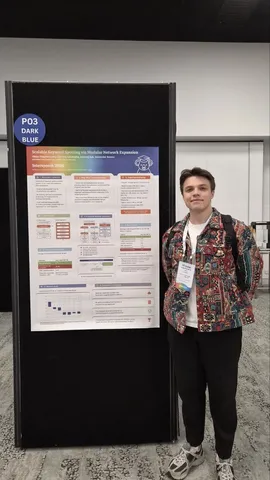
Мы на Interspeech — и не с пустыми руками

¡ɹǝpun uʍop ɯoɹɟ ʎɐp,ƃ

Ой..

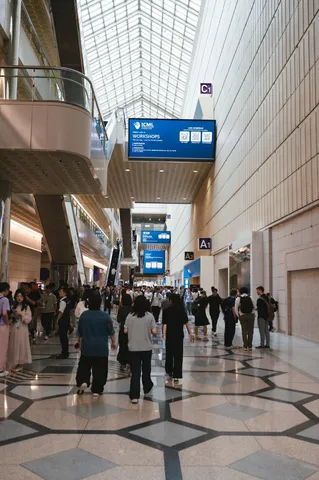
То есть, привет из Австралии, где в эти дни, вплоть до 1 октября, проходит конференция Interspeech — о речевых технологиях и обо всём, что рядом. Мы, разумеется, на месте и будем рассказывать о самом интересном, что увидим (подписывайтесь на канал Speech Info, чтобы точно ничего не пропустить). А первыми впечатлениями поделился разработчик из службы технологий голосового ввода Яндекса Николай Коновальчук.

Если говорить о конференции в целом, то у участников тут есть две основных модели поведения. Есть условные Eleven Labs и Google, которые пытаются нанимать людей — мне буквально всучили мерч в обмен на контакты. С другой стороны, есть люди, которые пытаются что-то продать: либо услуги по разметке данных, либо готовые датасеты. Представители таких компаний очень активны. Один человек подошёл ко мне на афтерпати и завёл разговор только для того, чтобы предложить свои услуги; другой человек сперва спрашивал меня о постере, а потом выдал мерча и попытался продать свои услуги. И это только те, кто сами подходили. А в общем, тут, наверное, больше половины участников что-то продают.

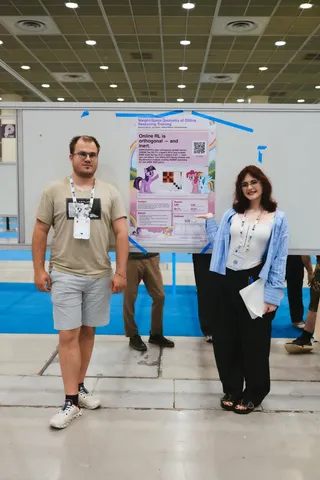
Что касается постеров, то, разумеется, всего увидеть мне пока не удалось. Кое-что любопытное, к сожалению, посмотреть не сумел, потому что стоял у нашего постера, но сегодня были интересные вещи. На оралах об использовании моделей в ограниченных условиях тоже было довольно интересно.

Вообще, прикольно. Люди приветливые, кормят нормально.


О каком же постере говорит Николай? А вот о каком — Scalable Keyword Spotting via Modular Network Expansion. Это статья о том, как дёшево, сердито и (совсем) без потерь расширить словарь детектора ключевых фраз. Подробнее о методе мы писали вот тут.

Не переключайтесь — впереди ещё много интересного с Interspeech!

#YaInterspeech26

ML Underhood
881 просмотров · 17 реакций Открыть в Telegram · Открыть пост на сайте
Как сделать интерактивного агента с помощью KV‑кеш‑манипуляций

AI-ассистенты, роботы и другие агенты должны уметь получать новые данные прямо во время вычислений и корректировать свои действия на ходу без полного перезапуска. Исследователь Yandex Research Георгий Якушев в статье на Хабре рассказывает, как реализовать такую интерактивность во время инференса с помощью KV-кеша. Ниже коротко о главном. 

В статье предлагают рассматривать KV‑кеш как активное состояние выполнения модели. Оно определяет, какие результаты предыдущих вычислений увидит новый запрос, в каком причинном порядке они расположены и какие промежуточные состояния могут повлиять на следующий токен. Если изменить структуру и доступность кеша, изменится и вычисление, которое выполняет модель, хотя её параметры и представления токенов останутся прежними.

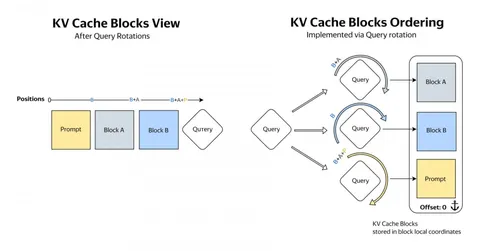
Вместо одного длинного контекста, к которому последовательно дописывается ответ, можно хранить набор дополняемых блоков. Отдельные блоки соответствуют входящим сообщениям пользователя, внутреннему рассуждению, ответу агента, результатам вызова инструментов, визуальным наблюдениям или работе других субагентов. Разным процессам при этом доступны разные логические представления одних и тех же физических блоков.

Для моделей с RoPE это можно сделать без повторного кодирования и копирования всего кеша. Пусть ρ(x, i) обозначает применение поворота к вектору x в позиции i. Тогда произведение запроса и ключа можно записать так: ρ(q, i_q)ρ(k, i_k)⊤ = ρ(q, i_q − i_k)k⊤.

Блок кеша достаточно один раз сохранить в локальных координатах. Во время запроса attention kernel применяет к текущему query поворот, зависящий от конкретного блока. Один и тот же физический блок в разных потоках оказывается на разных логических позициях. Плоский append‑only‑тензор превращается в переиспользуемую память с несколькими представлениями.

Также в статье рассматриваются методы параллельного инференса: Hogwild! Inference и AsyncReasoning (мы, кстати, писали о первом тут, а о втором — тут). В Hogwild несколько экземпляров LLM выполняют одну задачу, синхронизируясь через KV-кеш. AsyncReasoning тоже предполагает использование двух потоков одной LLM: первый генерирует выходные токены, а второй — ризонинг. Благодаря этому модель может выдавать ответы раньше, чем завершаются рассуждения, при этом не жертвуя качеством.

А о том, как работают мультимодельные системы, как Qwen3.5 играет в Doom и какие ограничения есть у вычислений в несколько потоков — читайте в полной статье на Хабре. Оригинальный пост на английском языке — в блоге Yandex Research. 

ML Underhood
1 793 просмотров · 24 реакций Открыть в Telegram · Открыть пост на сайте
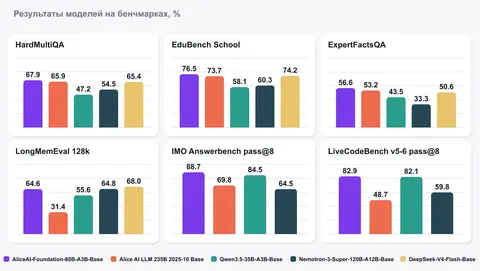
Выложили собственную претрейн-модель AliceAI‑Foundation-80B‑A3B‑Base — от обучения с нуля до опенсорса под лицензией Apache 2.0.

Это MoE-модель с 80 млрд параметров, из которых при генерации активны около 3 млрд. При обучении не использовались веса сторонних опенсорсных моделей. Весь путь до релиза занял около полугода: за это время команда пересобрала корпус, проверила архитектурные решения и гиперпараметры, а также добавила отдельные данные для рассуждений и взаимодействия с инструментами.

По внутренним претрейн-замерам модель обходит более крупные DeepSeek‑V4‑Flash‑Base и Nemotron‑3‑Super‑Base на ряде задач — от фактологических вопросов до математики и кода. На IMO AnswerBench и LiveCodeBench она лидирует среди сравниваемых открытых претрейнов. Предыдущую Alice AI LLM 235B модель также удалось превзойти на нескольких группах задач — при почти втрое меньшем общем и примерно в семь раз меньшем активном числе параметров.

Вместе с весами опубликовали технический отчёт на Хабре. В нём — устройство датасета, scaling laws, стабилизация MoE, абляционные эксперименты и подходы, которые не сработали. Среди интересных наблюдений:

— для корректного подбора гиперпараметров по scaling laws пришлось пересобрать валидационные датасеты так, чтобы loss на них больше коррелировал с качеством модели;
— много внимания уделили стабилизации обучения и борьбе с ростом активаций, который приводил к взрыву обучения;
— одного обучения сложным рассуждениям оказалось недостаточно для агентских навыков — взаимодействия с инструментами пришлось добавлять уже в претрейн.

Модель и бенчмарки (WikiWebFacts и HardMultiQA) уже на Hugging Face. Полный техрепорт — на Хабре.

ML Underhood
3 965 просмотров · 94 реакций Открыть в Telegram · Открыть пост на сайте
Выпустили агента «Исследовать» в Алисе AI. Рассказываем, почему сделали ставку на обвязку и как это теперь поддерживать

Агент «Исследовать» — это режим Deep Research’а в чате с Алисой AI. Он умеет строить оптимальный план для решения сложной пользовательской задачи. Для этого делает сотни поисков по запросу, пишет Python‑код, ходит на сайты, анализирует скачанные файлы и многое другое.

Работа над агентом началась примерно год назад. Как раз тогда — после релиза DeepSeek‑R1 — случился бум ризонинг‑моделей. Команда агента «Исследовать» и её лид Прохор Гладких, стартовали с того, что научили режим «Рассуждать» работать со свежими данными из сети. Сделали простой RAG-пайплайн с мультизапросным поиском, где запросы генерировала сама LLM. Пользователи оценили качество ответов, и стало понятно, что нужен полноценный Deep Research.

Как обычно, действовать нужно было быстро и в условиях всяческих ограничений. Поэтому решили сделать ставку на обвязку (харнесс) вокруг LLM. Ведь, меняя одну лишь обвязку на той же модели, мы получаем скачки метрик на десятки пунктов. Например, на SWE-bench с 3,8% до 12,5%, а на BrowseComp с 1,9% до 51,5%.

Кроме того, каждый токен в контексте и каждый лишний вызов модели — это GPU-время. Чтобы оптимизироваться тут, сделали три вещи.

1) Отдали обработку поисковых сниппетов обученному классификатору вместо LLM.
2) В инструменты стали ходить только когда это реально нужно для исследования.
3) Генерацию плана перевели на модель полегче без потери качества.

В итоге стоимость запроса сократилась в 6,6 раза, латенси для 90% запросов сократилась с 30 минут до 2,5. То есть пользователи стали получать ответы с тем же качеством ощутимо быстрее.

Пожалуй самый яркий фейл за время работы — то, что пришлось целиком выкинуть первый прототип, собранный на CodeAgent. Эта модель вызывает инструменты, генерируя Python‑код. И метрики там сразу вышли приличные: FRAMES — 75, SimpleQA — 81, GAIA — 26, пониже, потому что агент не умел работать с файлами.

Радовались до тех пор, пока не попробовали протащить решение в прод. Сгенерированный код нужно исполнять в песочнице с доступом в интернет, а значит — за пределами внутреннего контура. При этом инструменты агента живут внутри контура, поэтому пришлось бы пробрасывать tool-call из внешней сети внутрь, что небезопасно. К счастью, в то время вышла опенсорс-модель с хорошим function calling. За две недели команда полностью переписала агента: отказалась от CodeAgent и перешла на классический function calling loop. Ещё за неделю побили метрики первого прототипа.

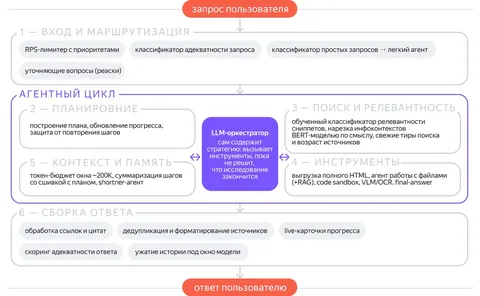
После переезда на function calling агент начал обрастать обвязкой. В основе классический агентный цикл: модель вызывает инструменты, пока не решит, что исследование закончено. Стратегию держит опять же сама модель: строит план, обновляет его по ходу и решает, куда копать дальше. Увидеть, что наросло вокруг этого цикла за год, можно на схеме в шапке поста.

Решение выглядит крутым, но есть нюанс. Мы помним, что каждый компонент обвязки — заплатка под текущее ограничение модели. С очередным релизом эти компоненты могут устареть. Поэтому харнесс нужно не только наращивать, но и регулярно срезать, снова и снова измеряя пользу каждого компонента на каждом релизе модели. И это — недели работы.

Поэтому следующий большой шаг — автоадаптация харнесса без ручной перенастройки. Обязательно поделимся результатами в новых постах.

В полной версии статьи на Хабре разобрали кейсы, из которых понятнее, как именно наращиваем и срезаем обвязку, поделились замерами на публичных бенчмарках и ключевыми метриками.

ML Underhood
2 443 просмотров · 29 реакций Открыть в Telegram · Открыть пост на сайте
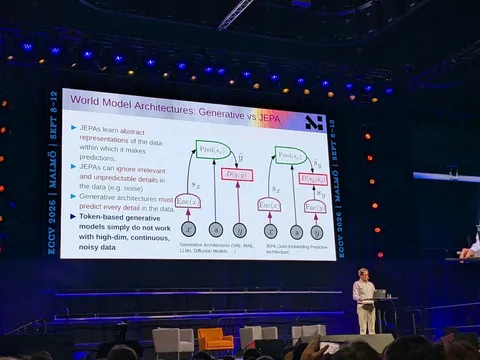
Вчера на ECCV послушали кейноут Яна Лекуна — делимся основными тезисами.

Лекун начал с контраста между успехами AI в программировании и математике и его способностью действовать в физическом мире. Среди проблем — работа с высокоразмерными непрерывными данными (сырым видео, аудио и сигналами с датчиков), зависимость агентов от большого числа демонстраций и слабая адаптация к новым задачам.

🔴Интеллект — это способность решать новые задачи с минимальным обучением. Лекун отделяет её от накопления знаний и освоения фиксированного набора навыков. Термин AGI он критикует: человеческий интеллект тоже специализирован, а ключевое свойство — быстрая адаптация к незнакомым ситуациям.

🔴Моделировать мир через предсказание следующего кадра — по мнению Лекуна, неверный путь. Будущее на уровне пикселей неоднозначно, а такая детализация часто не нужна для выбора действий. Вместо этого он предлагает обучать абстрактные представления и предсказывать изменения в их пространстве.

На этом принципе построена JEPA (Joint Embedding Predictive Architecture), предложенная Лекуном в 2022 году: энкодер кодирует целевые данные, а предиктор по контексту предсказывает их представление. В модели мира предсказание также учитывает действие. Ошибка считается между представлениями, что позволяет игнорировать несущественные и непредсказуемые детали исходного сигнала.

🔴Модель мира позволяет планировать действия. Предсказывая последствия разных действий, система может искать последовательность, которая приводит к цели. Поэтому основным механизмом выбора действий Лекун предлагает сделать model-predictive control. RL при этом отводится роль корректировки модели мира или критика, когда фактический результат расходится с прогнозом.

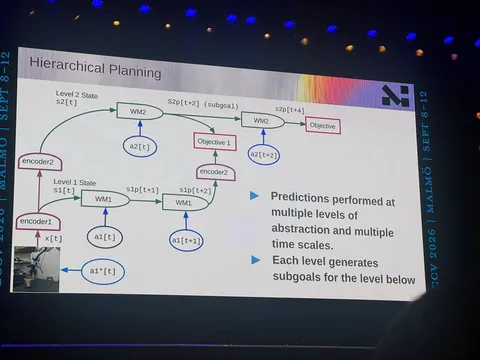
🔴Для сложного планирования нужна иерархия моделей мира. В показанной архитектуре на каждом уровне работают своё представление состояния и своя модель динамики. Верхние уровни предсказывают более абстрактные изменения на длинных временных масштабах и задают подцели нижним. Нижние — планируют более конкретные действия на коротком горизонте. Иерархия здесь относится и к задачам, и к самим моделям, которые обеспечивают планирование.

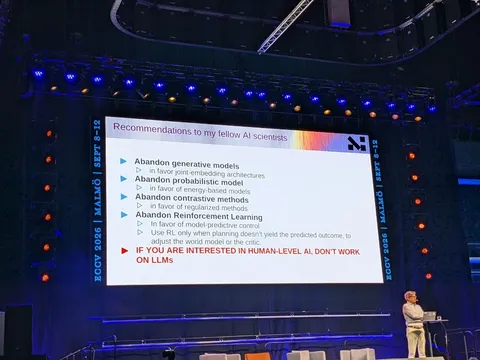
В финале Лекун обратился к исследователям, чья цель — AI человеческого уровня, и рекомендовал им сменить исследовательский фокус: с генеративных архитектур на joint-embedding, с вероятностных моделей на energy-based models, с контрастивного обучения на методы с регуляризацией, с RL-я на управление на основе прогнозирующих моделей. По его мнению, именно в этих направлениях стоит искать путь к таким системам. В этом же контексте прозвучал призыв сместить внимание с LLM на обучение представлений и моделей мира.

А после — селфи со слушателями, как всегда. Заметки с той стороны объектива принесли ❣ Александр Шишеня, Ангелина Гнедина, Виктор Юрченко, Роман Исаченко и Полина Комиссарова.

#YaECCV2026

ML Underhood
1 734 просмотров · 39 реакций Открыть в Telegram · Открыть пост на сайте
Сегодня мы опенсорсим модель, результатом работы которой пользуются 49,5 млн пользователей ежемесячно

Наша компактная языковая модель, обученная с нуля, формирует быстрые ответы Алисы AI под поисковой строкой. Артур Петросян, Назар Погосский, Никита Семёнов, Антон Викторов и Дима Калашников разобрали на Хабре, как она устроена и как её обучали. Ниже коротко о главном.

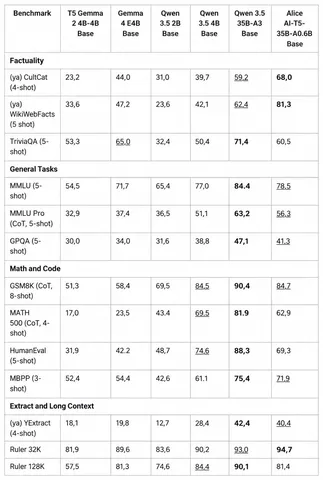
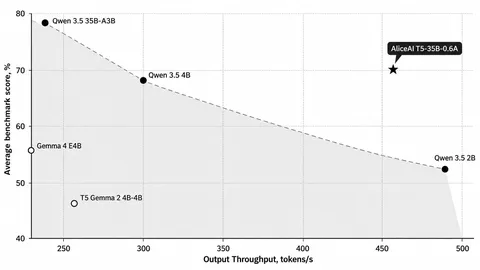
AliceAI-T5-35B-A0.6B — Encoder–Decoder с 34,35B параметров и разреженными MoE-слоями: в каждом для токена выбираются восемь экспертов из 512. Архитектуру подбирали под поисковый сценарий — обработать найденные документы и быстро сформировать ответ. Претрейн шёл на 15 триллионах токенов на задаче UL2-денойзинга. Затем контекст растянули с восьми до 128 тысяч токенов через YaRN. Как итог претрейна: после одинаковой процедуры алаймента — у AliceAI-T5-35B-A0.6B-Base 77% винрейта против Qwen3.5-2B в слепом SbS.

Отдельный сюжет — балансировка MoE. При масштабировании обучения балансировка со вспомогательным лоссом оказалась нестабильной: роутинг в энкодере коллапсировал. Переход на aux-free routing из DeepSeek-V3 решил проблему.

В поисковом пайплайне BERT-подобный экстрактор на 80 млн параметров сокращает документы до полезных для генератора фрагментов. Для его дообучения алгоритм на основе Cross-Entropy RL подбирает варианты контекста с учётом качества ответа и штрафа за длину. Сокращение контекста дало около +40% к пропускной способности без потери качества в наших экспериментах. Для продуктовой версии — SFT на ответах, отобранных через Rejection Sampling или улучшенных через Critique & Revision; затем RLHF на GSPO. Пользовательские сигналы тоже идут в обучение: отдельная reward-модель предсказывает Профицит и даёт один из сигналов для RLHF.

У итоговой модели в онлайн-эксперименте винрейт 56,7% против Google AI Overview. Приглашаем пощупать модель, почитать статью и поделиться впечатлениями в комментариях!

ML Underhood
4 853 просмотров · 71 реакций Открыть в Telegram · Открыть пост на сайте
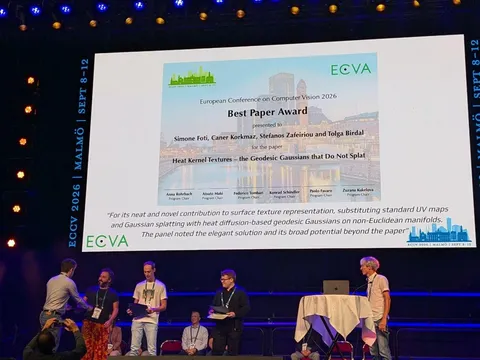
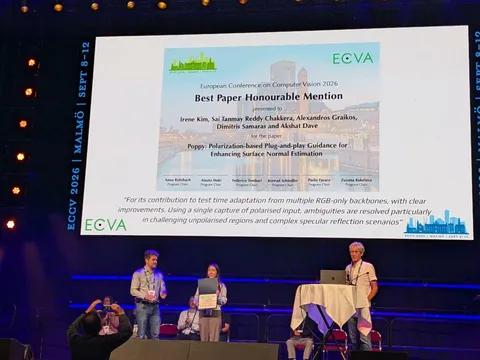
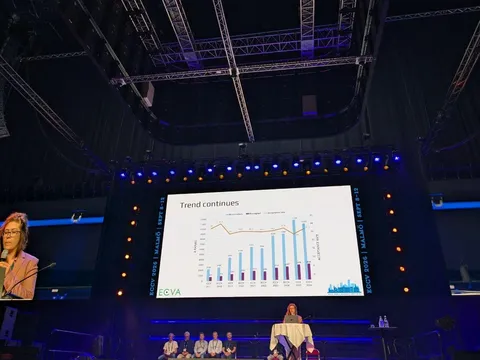
Немного цифр и Best Paper Awards на ECCV 2026

Сегодня на конференции раздавали награды — их получили пять выдающихся работ.

💫 Best Paper Award досталась статье Heat Kernel Textures — the Geodesic Gaussians that Do Not Splat. Авторы предложили новый способ накладывать текстуры на 3D-объекты без UV-развёртки.

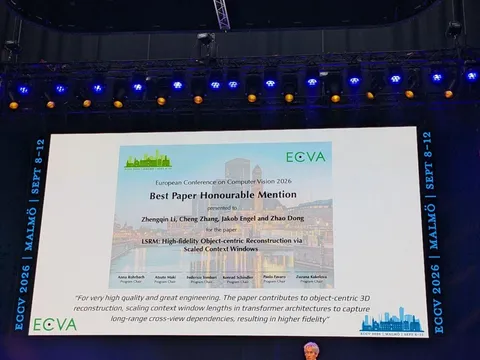
💫 Best Paper Honorable Mention дали работам Poppy: Polarization-Based Plug-and-Play Guidance for Enhancing Surface Normal Estimation и LSRM: High-Fidelity Object-Centric Reconstruction via Scaled Context Windows.

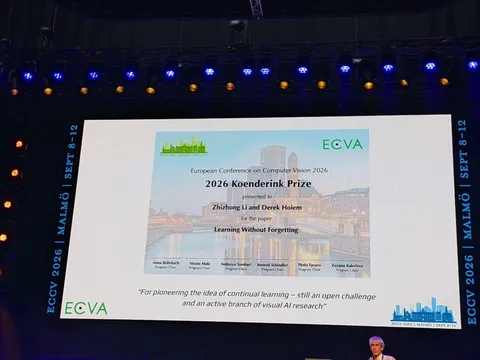
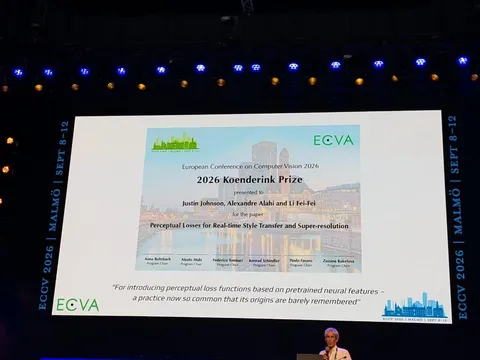
💫 Test of Time Awards вручили проверенным временем статьям Learning Without Forgetting и Perceptual Losses for Real-Time Style Transfer and Super-Resolution. Первые версии обеих вышли в 2016 году.

Что же касается главных цифр, они вот такие:

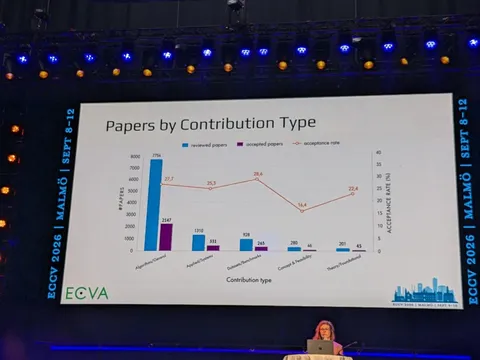
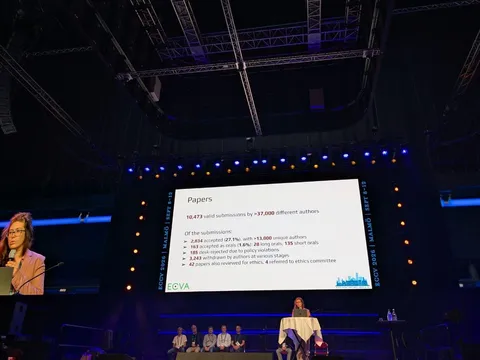
🔴На конференцию подали 10 473 работы от 37 тысяч авторов, а приняли 2 834 статьи.
🔴Oral получили всего 163 работы (1,6%).
🔴В программе три дня основной конференции, два дня воркшопов и туториалов, три keynote и экспо с 34 компаниями.

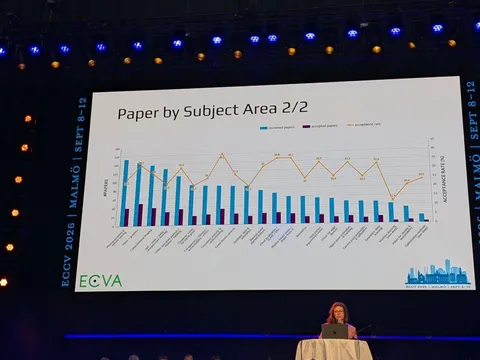
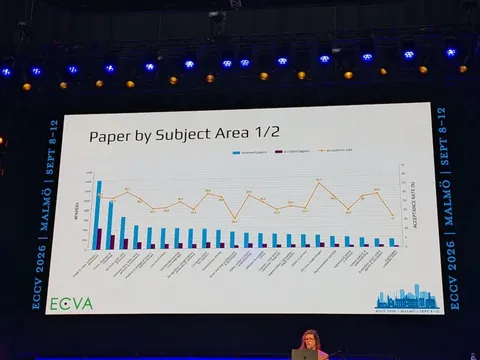
Самая большая тема в программе с заметным отрывом — генерация картинок и видео. Следом идут vision-language & reasoning и 3D. Генерация и мультимодальность всё сильнее определяют повестку.

#YaECCV2026

ML Underhood
1 364 просмотров · 21 реакций Открыть в Telegram · Открыть пост на сайте
Привезли статьи на ECCV в Швецию!

С 8 по 12 сентября в Мальмё проходит 19-я European Conference on Computer Vision — одна из крупнейших конференций по компьютерному зрению. Сегодня рассказываем о статьях исследователей Яндекса, принятых на конференцию в основной трек и на воркшопы.

Revisiting Autoregressive Models for Generative Image Classification

Над статьёй работали исследователи Yandex Research Илья Судаков, Артём Бабенко и Дмитрий Баранчук.

Авторы пересматривают потенциал авторегрессионных моделей в классификации изображений. Метод на основе RandAR оценивает изображение при разных случайных порядках визуальных токенов и агрегирует результаты. Это снижает зависимость от конкретного порядка и помогает модели учитывать разные области и свойства объекта.

В экспериментах метод превосходит диффузионные и предыдущие AR-классификаторы по точности и устойчивости к сдвигам распределения данных. При этом он работает до 25 раз быстрее диффузионных классификаторов. По качеству метод сопоставим с передовыми дискриминативными моделями — заметное достижение для генеративных классификаторов. Код авторы выложили на GitHub.

DuET: Dual Expert Trajectories for Diffusion Image Editing

Над статьёй работали исследователи Yandex Research Лидия Троешестова и Сергей Кастрюлин, а также Александр Устюжанин из Alice AI ART.

DuET — training-free-метод улучшения качества редактирования в unified-моделях генерации и редактирования картинок. Он основан на интуиции: если мы учим одну модель делать и генерацию, и редактирование, то и на инференсе можно попробовать использовать оба режима. Оказывается, что в середине генерации можно временно отключить привязку к исходному изображению и перевести модель в режим text-to-image, а затем вернуть её к редактированию. Это позволяет более эффективно использовать генеративные способности модели.

У метода есть адаптивный вариант, который автоматически определяет, для каких правок нужно такое переключение. В результате решение повышает точность и естественность редактирования, уменьшает количество артефактов и при этом сохраняет важные детали исходного изображения.

Revisiting Classifier-Free Guidance Methods in Latent Diffusion Models

Среди авторов — Сергей Кастрюлин из Yandex Research, а также Артём Сергиевский и Артём Туревич из НИУ ВШЭ.

Classifier-Free Guidance — повсеместно используемый метод улучшения качества визуальной генерации в диффузионных моделях. За последние четыре года вышло огромное количество статей, предлагающих улучшение исходного подхода. При этом большинство статей плохо сравниваются с конкурентами, замеряются на неинформативных бенчмарках или проверяют качество на устаревших моделях.

Цель работы — актуализировать понимание о том, где область находится сейчас. Для этого исследователи сравнили восемь методов на основе Classifier-Free Guidance, не требующих дополнительного обучения, на моделях Stable Diffusion 3.5 Medium и FLUX.2 4B Base. Все методы тестировались в одинаковых условиях на задачах композиции объектов, соответствия текстовому запросу, генерации текста и рассуждения на основе знаний.

В статье собраны результаты бенчмарков и примеры генераций, поэтому методы можно сравнить не только по числам, но и визуально. Спойлер: страшные руки тоже присутствуют.

#YaECCV2026

ML Underhood
1 266 просмотров · 28 реакций Открыть в Telegram · Открыть пост на сайте
Финальные впечатления от ICML 2026 и любопытные исследования

Карина Романова, которая занимается LLM-агентами в Алисе, поделилась впечатлениями от ICML на Хабре. В тексте рассказывается и о статьях, и о воркшопах, и об организации мероприятия — обязательно почитайте. А здесь — о трёх исследованиях Яндекса, которые представили на конференции и которые отметила Карина. 

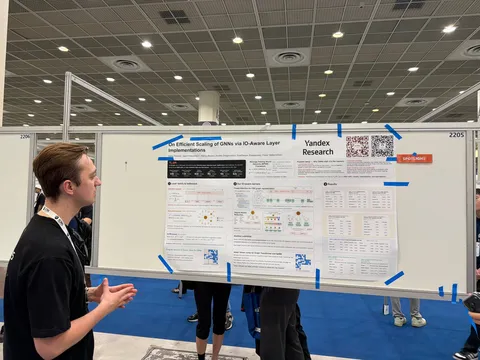
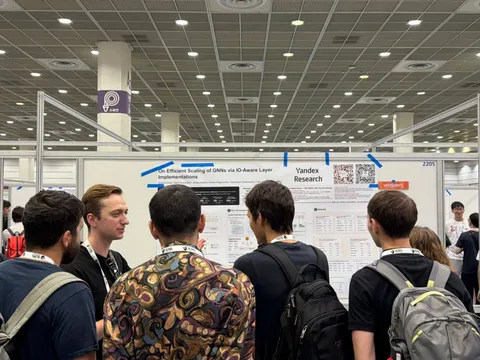
On Efficient Scaling of GNNs via IO-Aware Layers Implementations

Когда мы пытаемся ускорить GNN на GPU, сразу хочется оптимизировать математические вычисления. На практике же выясняется, что GNN чаще упираются не в compute, а в память и скорость передачи данных.

Авторы разобрали популярные семейства графовых моделей, нашли их узкие места при работе с памятью и адаптировали низкоуровневые GPU-оптимизации под особенности графовых данных, по сути, применив IO-aware-подход, похожий на идеи из FlashAttention.

Что получилось

Для GATv2: кастомные GPU-ядра показали ускорение до 8,5 раз относительно библиотеки DGL (медиана — в два раза), а пиковое потребление памяти снизилось до 76 раз (медиана — в шесть раз).

Для Graph Transformer: отдельная block-sparse-реализация под Tensor Cores ускорила работу до 7,3 раза на локально плотных графах.

GraphPFN: A Prior-Data Fitted Graph Foundation Model

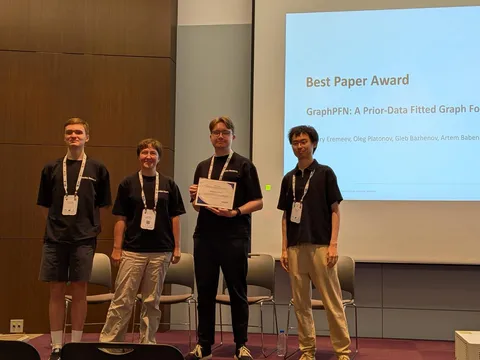
Воркшоп был посвящён развитию graph foundation models — переходу от узкоспециализированных моделей для отдельных задач к универсальным foundation-моделям для работы с графами. Сама статья о GraphPFN, к слову, получила Best Paper Award.

Как устроена GraphPFN

— В основе — подход PFN: модель развивает концепцию Prior-Data Fitted Networks.
— GraphPFN предобучают на миллионах специально сгенерированных синтетических графов.
— Благодаря синтетическому претрейну модель умеет работать с реальными графами прямо «из коробки» в режиме in-context learning без долгого переобучения или после минимального файнтюнинга.
— Результаты: на широком наборе реальных графовых датасетов GraphPFN показала лучшие результаты среди протестированных в работе подходов.

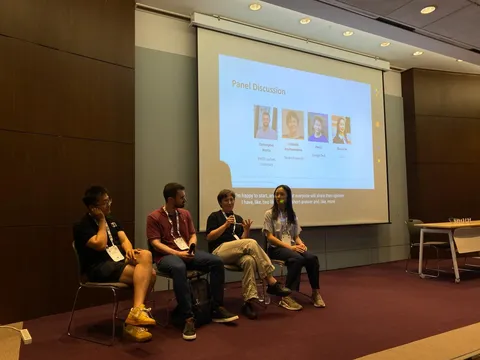
В рамках того же воркшопа Людмила Прохоренкова из Yandex Research участвовала в панельной дискуссии о будущем graph foundation-моделей вместе с исследователями из RWTH Aachen, Georgia Tech и Arizona State University. На панельной дискуссии обсуждались последние достижения, открытые проблемы и перспективные направления развития графовых foundation-моделей.

Weight-Space Geometry of Offline Reasoning Training

Обычно offline RL-лоссы для RFT, RIFT, DFT, Offline GRPO и DPO сравнивают с SFT по финальной accuracy. Мы решили посмотреть на другую сторону этих методов: насколько различаются изменения, которые они вносят в модель. 

Как проводили эксперимент

Чтобы сравнение было честным, мы зафиксировали условия:

— Взяли единый набор математических rollout’ов.
— Обучили все шесть методов на модели Qwen3-4B-Instruct с attention-only LoRA.
— Сравнили получившиеся LoRA-дельты (ΔW).

Что получилось

Оказалось, что у SFT, RFT и RIFT эти дельты направлены почти в одну сторону, хотя их величина различается. DFT отклоняется от этого направления заметно сильнее, а у Offline GRPO около 67% апдейта глобально и до 86% в последних слоях приходится на компоненту, ортогональную направлению SFT. 

DPO занимает почти отдельное подпространство и показывает лучшую accuracy в нашем протоколе. Однако его обучали с learning rate в десять раз меньше и на меньшем числе примеров, поэтому разницу нельзя объяснять только устройством лосса. 

Получается, что разные методы могут сильно различаться по формуле, но в контролируемом эксперименте приводить к неожиданно близким направлениям адаптации весов. При этом важно учесть, что вывод относится именно к фиксированным математическим rollout’ам, Qwen3-4B-Instruct и attention-only LoRA, а не ко всем весам и сценариям обучения вообще.

#YaICML2026

ML Underhood
1 937 просмотров · 32 реакций Открыть в Telegram · Открыть пост на сайте
Фрод и безопасность на KDD: заметки с трёх треков

Продолжаем рассказывать о том, что было на KDD. В этот раз интересным поделится аналитик из группы внешних угроз и безопасности Владислав Альчиков. Ему слово.

Помимо классических треков о рекомендательных системах и AI, в этом году на KDD заметно больше говорили об антифроде и безопасности ML и LLM. Причём как о полноценном отдельном направлении — с воркшопами, research-сессиями и попытками задать архитектурные стандарты. Ниже — о трёх треках, которые удалось послушать, и о том, что показалось важным.

AI for Fraud and Abuse (AI-FA)

Первый в истории KDD воркшоп целиком о фроде. Организаторы — команда Safety из Google. Главный тезис воркшопа в том, что фрод перестал быть изолированной проблемой отдельных доменов — сегодня его всё чаще поддерживают автоматизированные агенты и кросс-платформенные генеративные ИИ-фреймворки.

Запомнились два доклада. Первый — о применении графовых foundation-моделей для транзакционного антифрода, где схемы мошенничества постоянно меняются. Второй — об LLM-аугментации обучающих датасетов без сбора новых реальных данных. Это даёт сразу два эффекта: проактивно закладывает в модель ещё не встречавшиеся сценарии фрода и частично снимает survivorship bias в разметке. Поскольку мы не видим тот фрод, который в своё время пропустили, и потому учимся на смещённой выборке.

Research-трек Adversarial Attacks, Privacy & Security

Это шесть 20-минутных докладов об атаках и защите. Здесь выделю BRP (Block Revert Patch) — query-efficient-атаку в decision-based black-box-сеттинге. Ключевая идея: оценивать успех атаки не только тем, удалось ли обмануть модель, но и тем, сколько запросов на это понадобилось. Это смещает фокус с «возможности атаки в принципе» на её практическую применимость.

Trustworthy LLM — воркшоп в парадигме blue sky

Здесь представили концепцию Trustworthy Agent Network (TAN). Основной посыл: безопасность мультиагентных систем нужно встраивать в архитектуру, а не «прикручивать» сверху постфактум-проверками и мониторингом. Авторы формулируют четыре базовых принципа, на основе которых планируют дальше выводить конкретные архитектуры и критерии проектирования для реальных мультиагентных систем.

Все три трека, при разной степени зрелости, бьют в одну точку: фрод и атаки на ML/LLM-системы становятся автоматизированными и агентными, а значит и защита должна становиться системной и встроенной. Будь то на уровне данных (LLM-аугментация), метрик атак (query-efficiency) или архитектуры целых мультиагентных сетей (TAN). Похоже, в следующем году эта тема на KDD станет ещё заметнее.

#YaKDD26

ML Underhood
1 860 просмотров · 14 реакций Открыть в Telegram · Открыть пост на сайте
Обзор подходов по uplift-моделированию на KDD 2026

KDD 2026 в Южной Корее подошла к концу. Разберём несколько работ, связанных с uplift-моделированием, которые представили на конференции. Все они — от китайских бигтехов и с подтверждёнными онлайн-экспериментами.

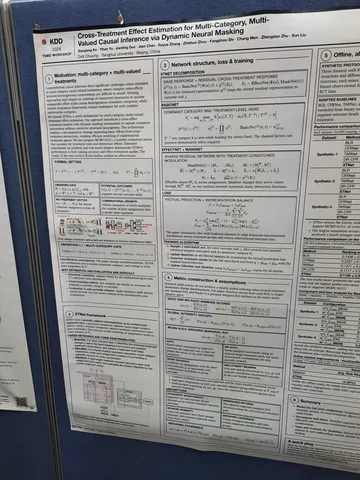
Cross-Treatment Effect Estimation for Multi-Category, Multi-Valued Causal Inference via Dynamic Neural Masking (XTNet)

Работа от DiDi о том, как оценивать uplift, когда у нас несколько категорий воздействий и у каждой — своя градация интенсивности. Вместо отдельной головы под каждую комбинацию авторы разделяют эффект на базовый и кросс-эффект, а веса под конкретную комбинацию генерируют масками — архитектура не раздувается экспоненциально. Отдельно предлагают cost-aware-метрику MCMV-AUCC, учитывающую стоимость воздействий и убывающую отдачу, с доказательством меньшей ошибки ранжирования, чем у Qini и AUUC. A/B-тест в 32 городах дал +2,43% GMV — идею декомпозиции на базовый и кросс-эффект вполне можно брать на вооружение.

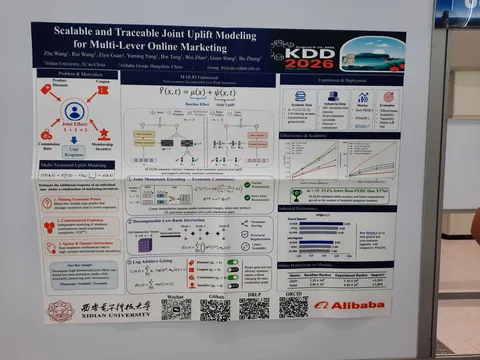
Scalable and Traceable Joint Uplift Modeling for Multi-Lever Online Marketing (M-DLRI)

Продолжение той же истории от Xidian и Alibaba, но с упором на экономический здравый смысл: большая скидка не должна предсказывать меньше продаж. Монотонность зашивают структурно через изотонное кодирование с интерполяцией. Экспоненциальный рост параметров лечат CP-разложением тензора взаимодействий — сложность становится линейной по числу рычагов. А слагаемые заодно дают атрибуцию: видно, какой именно рычаг тянет совместный эффект. Месяц A/B на Alimama: +5,35% GMV и +7,26% Sales. Takeaway: структурные приоры работают как регуляризация и вытягивают качество там, где комбинаций много, а данных мало.

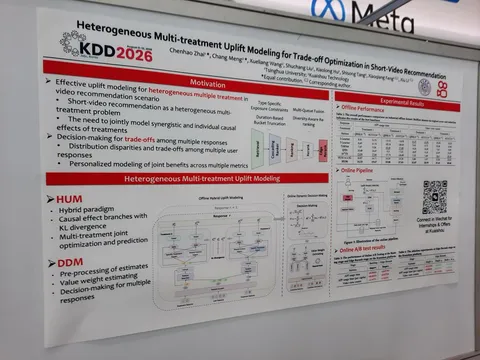
Heterogeneous Multi-treatment Uplift Modeling for Trade-off Optimization in Short-Video Recommendation (HMUM)

Работа от конкурента TikTok — Kuaishou — рассматривает случай, когда воздействия — это не скидки, а разные стратегии ранжирования, чьи эффекты на метрики прямо конфликтуют: время в приложении против числа просмотров. Офлайн-модель — отдельные ветви под каждое воздействие, чтобы не ловить конфликт градиентов, но с общей надстройкой для синергии. Понравился аккуратный трюк: контрольные предсказания разных ветвей стягиваются KL-дивергенцией, ведь распределение «без воздействия» обязано быть одинаковым. Онлайн-часть убирает ручные константы при взвешивании конфликтующих метрик и предсказывает персональные веса ценности каждого отклика в реальном времени. Приросты в промилле, зато трейд-офф действительно снимается, и всё уже в проде с околонулевым оверхедом.

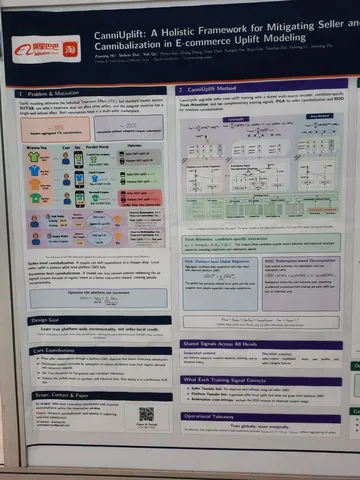
CanniUplift: A Holistic Framework for Mitigating Seller and Incentive Cannibalization in E-commerce Uplift Modeling

И, наконец, Taobao и Tmall показывают, что в маркетплейсе SUTVA нарушается сразу с двух сторон.

1. Каннибализация между продавцами: купон переключает пользователя с дорогого товара на дешёвый, локальный аплифт вырос, GMV платформы упал — лечат сверкой суммы предсказаний по всем магазинам с общим GMV пользователя, так что рост за счёт соседа штрафуется на уровне лосса.

2. Каннибализация стимулов: человек купил, но не активировал купон, и модель записывает органический спрос себе в заслугу — здесь исход раскладывают на пути с погашением и без. Baseline переоценивал суммарный эффект примерно на 35%, а после исправлений A/B дал +4,08% инкрементального GMV при −2,45% затрат. Takeaway: если оптимизируете локальную метрику в экосистеме с конкуренцией, стоит хотя бы раз просуммировать свои же предсказания и сравнить с реальностью.

#YaKDD26

Увидел интересное ❣ Денис Ишков

ML Underhood
1 845 просмотров · 24 реакций Открыть в Telegram · Открыть пост на сайте
Выкатили Sona Technical Report — о модели, которая заменила весь рекомендательный стек Яндекс Музыки

В этом месяце у службы рекомендательных технологий Яндекса произошли сразу два больших релиза.

Сначала показали вторую версию Gryphon — unified-архитектуры, которая объединяет в себе кандидатогенерацию и ранжирование. Это альтернативный OneRec подход к построению рекомендательных end-to-end-моделей.

А сегодня представили Sona — итог целого года работы команды, в результате которого удалось заменить весь стек рекомендаций Яндекс Музыки на единую модель. Внутри репорта — много деталей об архитектуре, инфраструктуре, многочисленные аблейшны. Это лучшее внедрение трансформеров в истории А/B-тестов в Яндекс Музыке.

Три основные вещи, благодаря которым это получилось.

1. Масштабируемая архитектура

Encoder-decoder, обучающийся хронологически на задачу Next Token Prediction без единой ручной фичи. Одной из самых сложных частей было сделать рецепт токенизации, который бы обеспечивал рост качества при росте словаря и числа токенов на документ.

2. Единая модель кандидатогенерации и ранжирования

OneRec ранжирует кандидатов отдельной моделью, причём с использованием ручных фич. Мы же стремились к совместному рецепту обучения и инференса. Проблема в том, что задача ранжирования слишком спарсовая и модель просто не обучается выполнять её достаточно хорошо. Решение — сжать год данных в ранжирующую модель, обучающуюся авторегрессивно, дистиллировать эти знания в совместную модель.

3. Инфраструктура обучения и инференса

Любые большие изменения в ML приводят к настолько же большим изменениям в инфраструктуре. Нам пришлось фактически построить новый движок рекомендаций с нуля. Очень важной компонентой стало онлайн-обучение: end-to-end-путь события от возникновения до обновления модели в инференсе укладывается в 1 час в 99% случаев.

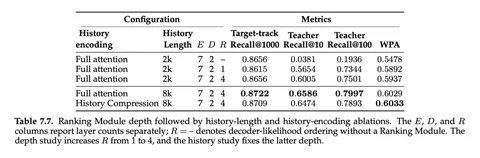
Чтобы лучше понять, что именно в модели поменялось между двумя А/B-тестами — который показывали в Gryphon-v2 и который репортим в Sona, — посмотрите табличку с масштабированием слоёв ранжирующего модуля и контекста и компрессией истории (картинка №2).

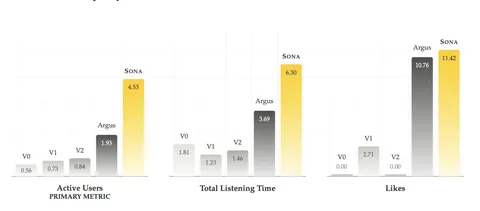
По сравнению же с текущей продакшен-системой в Sona получили статзначимый рост главных метрик:

🔴+4,53% Active Users — основной метрики эксперимента;
🔴+6,30% Total Listening Time — общего времени прослушивания;
🔴+11,42% Likes — количества лайков.

Причём это прирост поверх улучшений от предыдущих внедрений, которые оставались в контрольной выборке в продакшне.

Рост Active Users оказался в 2,35 раза выше прироста, который ранее дала Argus — самая сильная модель, использовавшаяся на этой поверхности до Sona.

Главный результат работы — получили одну совместно обучаемую модель, которая заменяет собой многоступенчатый рекомендательный каскад и при этом повышает качество рекомендаций на реальном пользовательском трафике.

Подробнее о том, как всё устроено и как к этому пришли, руководитель службы рекомендательных технологий Николай Савушкин расскажет на Practical ML Conf.

ML Underhood
2 779 просмотров · 45 реакций Открыть в Telegram · Открыть пост на сайте
Выложили препринт второй части Gryphon о рекомендациях в Яндекс Музыке

О первой статье Gryphon мы уже рассказывали. Теперь вышла вторая работа, Gryphon-v2: One Model in Place of a Cascade, где мы попробовали заменить одной моделью весь рекомендательный каскад.

В первой версии Gryphon уже объединял Semantic-ID generation и item-level scoring. Пользовательская история кодировалась один раз, а дальше модель генерировала кандидатов и сама их скорила. Но финальное ранжирование всё ещё оставалось за отдельным production ranker.

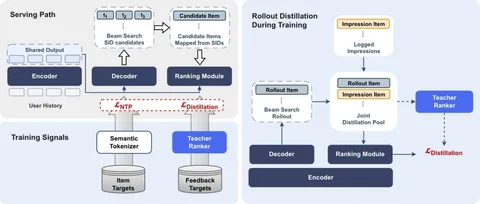
Gryphon-v2 делает всё внутри одной модели: декодер генерирует 1024 Semantic ID, из которых набирается до 1200 треков, и Ranking Module сразу ранжирует выдачу для пользователя.

Компактный Ranking Module мы обучаем дистилляцией: в роли учителя выступает большой трансформер, проученный на годе таргетов без единой ручной фичи. Чтобы Gryhon-v2 качественно решал задачу полного каскада, мы разработали Rollout Distillation: во время обучения текущая версия декодера генерирует кандидатов через beam search, учитель их оценивает, а Ranking Module тренируется воспроизводить эти оценки. Так модель лучше ранжирует кандидатов, похожих на тех, с которыми встретится на инференсе. Больше 90% уникальных кандидатов для дистилляции приходят именно из таких rollout’ов.

В A/B-тесте на Яндекс Музыке Gryphon-v2 поставили вместо полного production-каскада. Число активных пользователей выросло на 1,41%. Total listening time выросло на 1,62%, лайки — на 7,12%, доля недослушанных треков снизилась на 9,65%.

Это первый эксперимент в Яндексе, где одна модель смогла заменить собой полный каскад, прирастив метрики.

Над статьёй работали коллеги из нескольких команд рекомендательных технологий Яндекса: Анна Липкина, Дарья Тихонович, Виктор Януш, Мария Ульянова, Олег Сорокин, Владислав Додонов, Илья Мурзин, Денис Бурштейн и Николай Савушкин.

ML Underhood
2 002 просмотров · 49 реакций Открыть в Telegram · Открыть пост на сайте
Registers Matter for Pixel-Space Diffusion Transformers

Сегодня разбираем свежую статью от команды Visual GenAI в Yandex Research на тему регистров в картиночных диффузионках.

Немного контекста

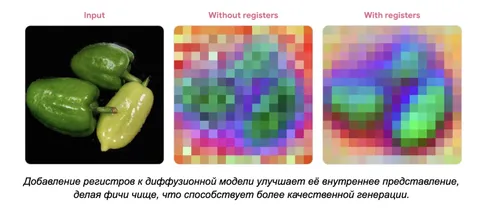
Изначально регистры придумали для визуальных трансформеров. В self-supervised-моделях вроде DINO обнаружили «артефакты»: некоторые патч-токены получали слишком высокие нормы, а CLS-токен начинал смотреть не на основной объект, а, например, на фон. Такие аутлайеры появлялись на разных слоях и портили внутренние фичи модели.

В статье Vision Transformers Need Registers нашли изящное решение: добавить к последовательности несколько пустых токенов — регистров. После прохода модели их просто выбрасывают. При этом аутлайеры переезжают из патчей в регистры, а внутренние представления становятся чище. Техника хорошо сработала на классификации, сегментации и оценке глубины и постепенно стала стандартной для self-supervised ViT.

Регистры в диффузионных трансформерах

Авторы решили проверить, что происходит с регистрами в диффузионных трансформерах. Для этого посмотрели на несколько pixel-space- и latent-space-моделей и обнаружили, что привычных для ViT аутлайеров в них нет. Нормы патч-токенов распределяются равномерно, и из-за этого кажется, что регистры диффузионкам не нужны.

Но если всё-таки добавить несколько пустых токенов, качество стабильно растёт.

При этом эффект не такой, как в ViT. В обычном визуальном трансформере регистры просто забирают уже существующие аутлайеры из патчей. В DiT аутлайеров изначально нет, и они появляются только после добавления регистров, причём именно в этих пустых токенах.

Зачем же DiT регистры

Авторы сделали вывод, что диффузионным трансформерам выгодно иметь аутлайеры, но без регистров их некуда поместить. В диффузионном лоссе участвуют все патчи, поэтому лосс ограничивает их нормы. Регистры же в лоссе не участвуют и становятся свободными слотами для аутлайеров.

Интересно, что после добавления регистров уменьшаются нормы самих патч-токенов, а внутренние фичи становятся чище и содержат меньше высокочастотного шума. Сильнее всего эффект на высоких уровнях шума.

Сами регистры делятся на две группы:

1) Одни содержат семантическую информацию и отвечают за разные части изображения (объект, фон или передний план).

2) Другие имеют высокую норму, но почти ничего не говорят о классе: они нужны скорее для сброса высокочастотного шума из патч-токенов.

Где регистры работают лучше

Лучше всего регистры работают в pixel space. VAE- и RAE-энкодеры уже сжимают изображение и убирают часть высокочастотного шума, делая пространство более удобным для диффузии. В пиксельном пространстве такой обработки нет, поэтому польза от регистров максимальная.

Ещё важный момент: добавлять их лучше не с первого слоя, а примерно с середины модели. На ранних слоях регистры могут набрать бесполезную информацию и протащить её дальше.

Register guidance

В результате работы исследователи предлагают решение в виде register guidance. Одна и та же модель умеет работать с регистрами и без них: вариант без регистров используют как слабую модель, от предикта которой отталкиваются при генерации. Такой guidance улучшает визуальные детали, а в сочетании с classifier-free guidance даёт прирост качества.

Код доступен на GitHub, веса моделей — на Hugging Face, а все материалы — на странице работы.

Рассказал о работе ❣ Никита Стародубцев

ML Underhood
2 103 просмотров · 29 реакций Открыть в Telegram · Открыть пост на сайте
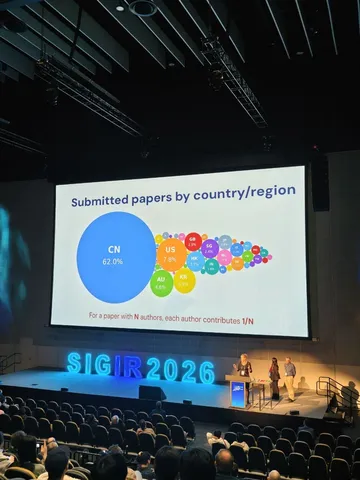
Конференция за конференцией — мы на SIGIR 2026!

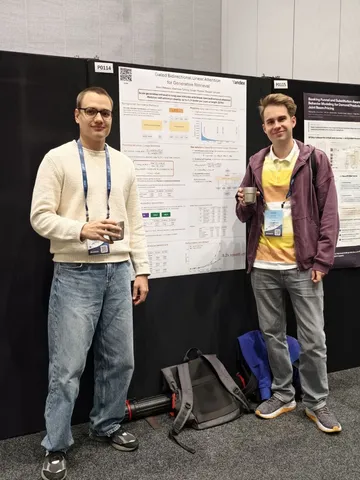
В эти дни в Мельбурне проходит конференция по исследованиям и разработке информационного поиска. И мы уже там, чтобы посмотреть (и вам показать) интересное, а также представить собственную работу — Gated Bidirectional Linear Attention for Generative Retrieval.

В рекомендательных системах generative retrieval обычно строится по схеме «энкодер–декодер». Энкодер обрабатывает историю взаимодействий пользователя, после чего авторегрессионный декодер генерирует рекомендуемые объекты. В крупных стриминговых сервисах активные пользователи со временем накапливают очень длинные истории. По мере их роста энкодер становится одним из основных узких мест с точки зрения задержки, поскольку вычислительная сложность внимания с softmax квадратично зависит от длины последовательности.

В статье предлагают Gated Bidirectional Linear Attention (GBLA) — слой двунаправленного аттеншена с линейной вычислительной сложностью, который расширяет линейное внимание тремя компонентами: локальным каузальным смешиванием с помощью Conv1D, гейтингом ключей на уровне последовательности для мягкого забывания и выходным слоем gated RMSNorm.

На крупномасштабном датасете «Яндекс Музыки» гибридный энкодер, в котором блоки self-attention (SA) и GBLA чередуются в соотношении 1:2 — один блок SA, за которым следуют два блока GBLA, — достигает качества двунаправленного self-attention.

Бонусом держите фото с места событий и фотографию крутого зубастого участника конференции.

#YaSIGIR26

ML Underhood
2 259 просмотров · 23 реакций Открыть в Telegram · Открыть пост на сайте
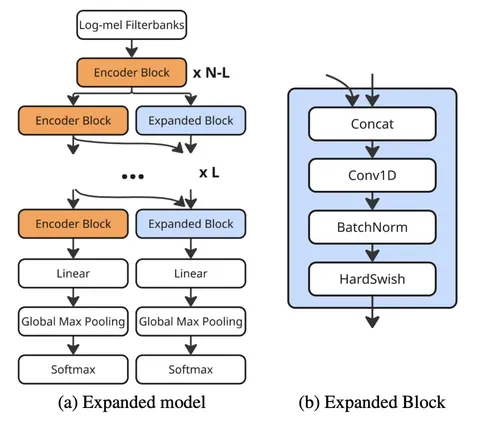
Scalable Keyword Spotting via Modular Network Expansion

Сегодня рассказываем о статье от команды технологий голосового ввода Яндекса. Работу приняли на конференцию Interspeech 2026, которая пройдёт с 27 сентября по 1 октября в Сиднее.

Авторы предложили новый способ обновлять набор голосовых команд в умных устройствах без забывания уже известных. Наш коллега Виктор Хаймоненко рассказал о методе подробнее.

Чтобы расширить набор команд, поддерживаемых устройством с голосовым управлением, нужно дообучить модель распознавания речи. Но есть проблема: часто такие модели забывают команды, которые уже знали, или начинают хуже понимать их. Это называют catastrophic forgetting.

Есть методы непрерывного обучения, например EWC (elastic weight consolidation), которые уменьшают эффект, но не устраняют его полностью. В работе предложили другой подход — модульное расширение модели. Он хорошо решает проблему и при этом требует меньше вычислительной мощности, чем те же LoRA и адаптеры.

Предлагается не менять всю работающую нейросеть, а просто добавлять к ней компактный модуль, отвечающий за распознавание новых команд. Эта ветка использует промежуточные признаки, которые извлекает основная модель, но имеет собственный классификатор для новых команд. При этом параметры базовой модели остаются неизменными, поэтому результаты её работы для старых команд не страдают.

Новый метод требует небольшого увеличения размера нейросети. Общее количество дополнительных параметров — не больше 10% от числа параметров изначальной модели.

Эффективность проверили на открытом датасете Google Speech Commands. В экспериментах модель должна была выучить новые пары команд и при этом продолжить поддерживать старые. Метод снизил среднюю долю пропущенных новых команд (FRR) с 6,46% до 4,37% по сравнению с отдельной моделью аналогичного размера и превзошёл методы адаптеров и LoRA.

Для сравнения, при обычном полном дообучении всей модели она хорошо усваивала новые команды, но гораздо хуже распознавала старые: средняя доля пропущенных известных команд выросла с 2,71% до 69,08%.

Об особенностях процесса обучения и том, как обходили ограничения, рассказали на Хабре.

ML Underhood
1 949 просмотров · 48 реакций Открыть в Telegram · Открыть пост на сайте
Рассказываем о новой unified-модели в Alice AI

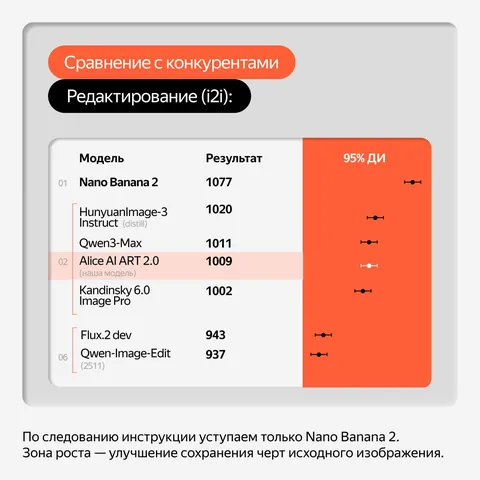
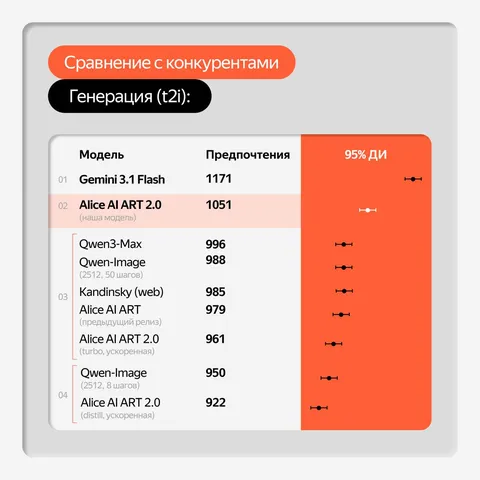
С недавних пор в Алисе AI и Шедевруме появилась обновлённая модель — Alice AI ART 2.0. Пользователи уже сейчас могут протестировать два базовых сценария её работы: Text-to-Image и Image-to-Image.

Для Яндекса этот релиз — первый шаг к тому, чтобы получить unified-модель с едиными метриками и стеком, которая одинаково хорошо умеет и в T2I, и в I2I. Команда генеративных моделей в компьютерном зрении рассказала на Хабре об экспериментах на этом пути, которые сработали и не сработали. Делимся основным.

С чего начали

Стартовали, имея две сущности. С одной стороны, картиночный генератор Alice AI ART 1.0 — свёрточная модель с текстовым энкодером на базе LLM. С другой — редактирование с отдельной базовой моделью и пайплайном инференса. Это разделение было дорогим и приносило много сложностей. Каждое обновление приходилось дважды переносить, данные готовились по-разному, метрики T2I и I2I было тяжело сравнивать между собой, стадии обучения были рассогласованы.

Что хотели от релиза

Цели было две: свести две модели в одну и при этом поднять качество каждой. В T2I целились на рост релевантности и отрисовки текста на картинке. В I2I старались поднять общее качество, но с акцентом на важных для наших пользователях задачах: любые изменения с участием людей и стилизация. Критически важно было, чтобы объединённая модель не уступала по качеству раздельным, а лучше — превосходила их.

Главный герой этого обновления — unified-претрейн

Он включает данные обоих типов: «текст → картинка» и «картинка + инструкция → картинка». Была гипотеза, что общий визуальный и текстовый контекст перетекает между задачами и улучшает качество. Например, концепты (объекты, предметы, действия, стили), выученные на T2I, становятся доступны в I2I без дополнительного сбора данных. И это действительно подтвердилось.

Мы также унифицировали архитектуру, перейдя на single-stream MMDiT с VLM в качестве текстово-картиночного энкодера, и увеличили размер генератора по сравнению с Alice AI ART 1.0. Важным оказалось использовать:

🔴Joint attention — текстовые и визуальные токены идут через общий аттеншн, а не двумя раздельными ветками.
🔴U-RoPE — позиционное кодирование, дружелюбное к разным разрешениям и к конкатенации картинка + текст (что особенно важно для I2I).

Результаты

Alice AI ART 2.0 стала намного более качественной в обеих задачах и по нашим замерам заметно отстаёт только от Gemini 3.1 Flash.

Но главный показатель — это реакция пользователей. Скачивание результатов генерации и редактирования выросло на 37 %, а запросов на генерацию с персонажем стало больше на 23 %.

В обзоре мы пробежались по верхам. В основном посте — подробно об аналитике и замерах, динамике обучений. Есть также таблицы с результатами и рассказ о том что у нас не сработало.

ML Underhood
3 055 просмотров · 35 реакций Открыть в Telegram · Открыть пост на сайте
По следам воркшопов и постерных сессий

Вчера мы анонсировали активности с участием наших исследователей на ICML 2026. Теперь делимся фото и впечатлениями спикеров о том, как это было.

Дмитрий Еремеев, Yandex Research:

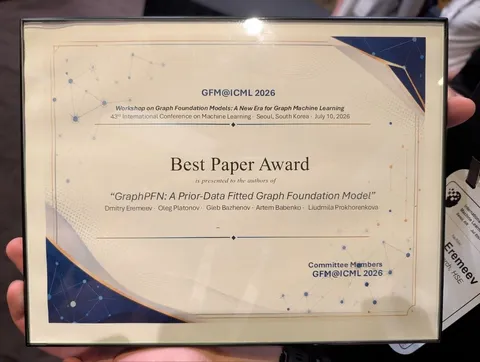
Для меня это первая конференция — всё было в новинку, проходило очень насыщенно. Одну из наших статей, GraphPFN, мы представляли в формате постера на основной конференции, а ещё я выступал с докладом по ней на воркшопе по Graph Foundation Models. На постерах многие хвалили работу, часто задавали содержательные вопросы. В итоге GraphPFN ещё и получил best paper award на воркшопе!

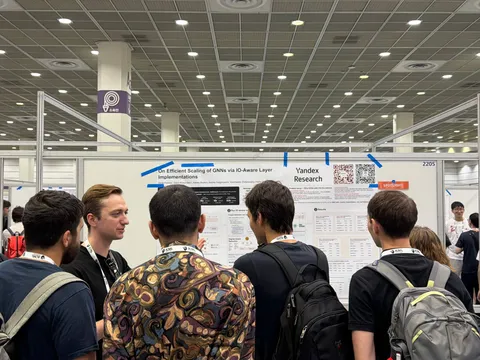
К сожалению, не смог нормально посмотреть другие постеры и пообщаться с авторами, так как большинство релевантных нам работ были во время постерных сессий, когда мы сами представляли свои работы. Тем не менее, судя по представленным статьям, таким как PluRel или RDB-PFN, область движется именно в том направлении, которое мы считаем перспективным и важным и в котором активно развиваемся сами. Это не может не радовать!


Карина Романова, старший разработчик:

Я участвовала в воркшопе по Mechanistic Interpretability. К нашей статье был большой интерес со стороны исследователей из известных зарубежных университетов. Многие хвалили идею и говорили, что исследование будет полезно для их проектов.

Сам воркшоп был очень сильным. Нашли много хороших работ. Например, о том, как обучили VLA-агента в среде и выявили случаи, когда модель начинает «сходить с ума» (MultiSTEVE-1s). Или о том, что активации модели содержат больше информации для определения важных шагов рассуждения, чем сами токены (Reasoning Models Know What’s Important, and Encode It in Their Activations).

Было приятно поделиться опытом наших исследований с коллегами на международной площадке и перенять их опыт.


#YaICML2026

ML Underhood
12 240 просмотров · 27 реакций Открыть в Telegram · Открыть пост на сайте
Получили Best Paper Award на воркшопе ICML 2026!

Статья GraphPFN: A Prior-Data Fitted Graph Foundation Model получила статус лучшей работы на воркшопе Graph Foundation Models: A New Era for Graph Machine Learning 💫

Машинное обучение на графах сейчас проходит примерно тот же путь, который несколько лет назад проделали NLP и CV — от узкоспециализированных моделей к foundation models. Именно вокруг этого строилась программа воркшопа.

Людмила Прохоренкова из Yandex Research приняла участие в панельной дискуссии вместе с известными исследователями в этой области из RWTH Aachen, Georgia Tech и ASU.

Мы представили графовую foundation model, развивающую подход Prior-Data Fitted Networks (PFN). Она предобучается на миллионах специально сгенерированных синтетических графов, а затем может эффективно решать задачи на реальных данных как в режиме in-context learning, так и после дообучения. На широком наборе реальных графовых датасетов GraphPFN обходит все остальные протестированные модели.


Поздравляем графовую команду!

#YaICML2026

ML Underhood
4 339 просмотров · 122 реакций Открыть в Telegram · Открыть пост на сайте
Сегодня завершился ещё один день постерных сессий на ICML 2026

А завтра — встречаемся на воркшопах. Ниже — расписание со временем по Сеулу и местами проведения.

Graph Foundation Models: A New Era for Graph Machine Learning

Oral-презентация
10:00–10:40 (KST)
Room 308

GraphPFN: A Prior-Data Fitted Graph Foundation Model
Спикер: Дмитрий Еремеев, Yandex Research

Постерная сессия
12:10–14:00 (KST)
Room 308

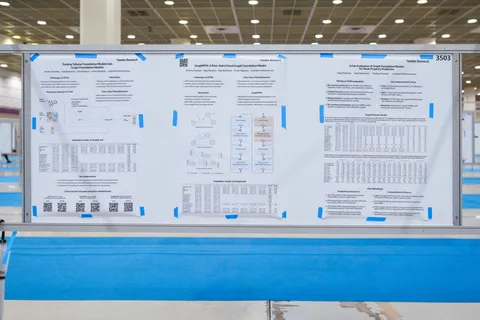
• GraphPFN: A Prior-Data Fitted Graph Foundation Model

• Turning Tabular Foundation Models into Graph Foundation Models

• A Fair Evaluation of Graph Foundation Models for Node Property Prediction

Команда исследователей Yandex Research: Дмитрий Еремеев, Олег Платонов, Глеб Баженов, Артём Бабенко и Людмила Прохоренкова


Workshop on Mechanistic Interpretability

Weight-Space Geometry of Offline Reasoning Training
11:00–12:00 (KST)
Hall C, Poster board 216

Среди авторов — Карина Романова и Владимир Платонов с коллегами из Keenable.ai


Workshop on Weight-Space Symmetries: from Foundations to Practical Applications

Analyzing Stream Collapse in Hyper-Connections
15:30–17:00 (KST)
Room 403

Среди авторов — Екатерина Алимаскина, Yandex Research, и коллеги из BRAInLab


4th Structured Probabilistic Inference & Generative Modeling

ReCache: Learning Budget-Aware Caching Schedules for Diffusion Models via REINFORCE
08:00–17:00 (KST)
Hall D1

Среди авторов — Кирилл Струминский, Yandex Research, и коллеги из НИУ ВШЭ

Registers Matter for Pixel-Space Diffusion Transformers
08:00–17:00 (KST)
Hall D1

Команда исследователей Yandex Research: Никита Стародубцев, Илья Судаков, Илья Дробышевский, Артём Бабенко и Дмитрий Баранчук


Foundations of Deep Generative Models: Understanding Memorization, Generalization, and Reasoning

Registers Matter for Pixel-Space Diffusion Transformers
08:00–17:00 (KST)
Room 318

Команда исследователей Yandex Research: Никита Стародубцев, Илья Судаков, Илья Дробышевский, Артём Бабенко и Дмитрий Баранчук


Если вы тоже на ICML, приходите послушать выступления, посмотреть постеры и обсудить работы с авторами!

#YaICML2026

ML Underhood
8 824 просмотров · 29 реакций Открыть в Telegram · Открыть пост на сайте
Первые рекорды ICML 2026 в Сеуле

На вчерашних welcome remarks отметили, что в этом году ICML вновь побила собственные масштабы: организаторы получили 24,7 тысяч сабмитов от более чем 76 тысяч авторов, а в рецензировании участвовали почти 18 тысяч экспертов. В основной программе — 6 докладов, 168 устных выступлений и почти 5900 постеров.

По тематике ожидаемо лидируют LLM — им посвящены 18% всех принятых работ. Следом идут computer vision с 7,9% и генеративные модели с 5,3%.

Наш коллега Алексей Зотов посетил несколько очных докладов и две постерные сессии — и поделился впечатлениями.

Понравилась организация постерной сессии: статьи сгруппированы по тематикам, поэтому рядом с интересной работой часто оказываются ещё 3-4 релевантных.

Из минусов — в этот раз слушателей так много, что иногда приходится стоять в очереди, чтобы задать вопрос или хотя бы рассмотреть постер популярной работы. Также стоит отметить высокий средний уровень статей — получилось почерпнуть действительно много интересных идей уже в первый день.

Для себя в основном искал темы, связанные с RLHF/RLVR для алайнмента LLM. В работе Why Tree-Style Branching Matters показали, как эффективнее обучать ризонинг-модели на RLHF-сигнал, где вариативность ответа может добавлять шум в оценку качества рассуждений. А на очном докладе Don't Force the Fit: Bounded Log-Likelihood Loss for Enhanced Reasoning in Large Language Models предложили простой и эффективный метод улучшения SFT на ризонинг-цепочках — его нам предстоит аккуратно проверить, так как результаты, показанные в презентации, пока выглядят чересчур оптимистично.

Много внимания уделено проблемам нестабильности RL-обучения. Работы Rethinking the Trust Region in LLM Reinforcement Learning и Stable Asynchrony: Variance-Controlled Off-Policy RL for LLMs предлагают несколько алгоритмических изменений, направленных на повышение стабильности.

А в статье Spurious Rewards: Rethinking Training Signals in RLVR показывают, что несовершенства современных RL-алгоритмов не только вызывают проблемы со стабильностью обучения, но и могут приводить к парадоксальным результатам.


#YaICML2026

ML Underhood
1 618 просмотров · 24 реакций Открыть в Telegram · Открыть пост на сайте
Обзор погодных моделей на ICML 2026

Разбираем несколько работ, связанных с прогнозированием погоды. Не все одинаково убедительны, но тем интереснее.

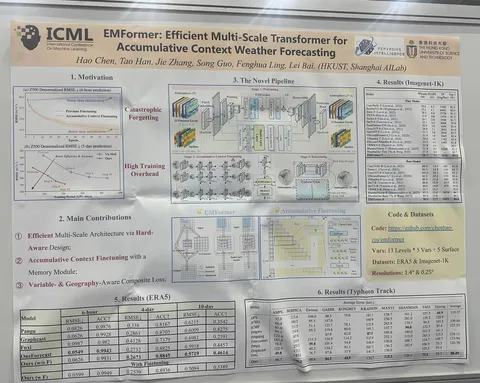
EMFormer: Efficient Multi-Scale Transformer for Accumulative Context Weather Forecasting

Очередная посредственная глобальная модель погоды. Цель исследования: улучшить RMSE глобальной детерминистской модели на пятые и десятые сутки. Для этого авторы с нуля обучают свою архитектуру, затем проводят хитрый файнтюн (делают KV-кэш на каждом роллаут-шаге и конкатенируют с KV на следующем). Сравниваются со старыми моделями — RMSE становится ниже, но само по себе это мало что значит. Осадки сделать не получилось, тестов на физичность тоже нет. Зачем нужна эта работа, когда есть ансамбли, — не ответили. Для 2026 года статья выглядит откровенно слабо: от самой постановки задачи до реализации.

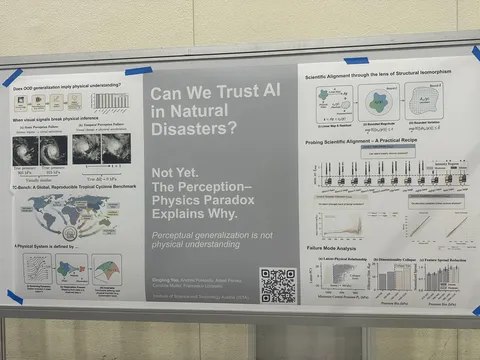
The Perception-Physics Paradox: Probing Scientific Alignment with TC-Bench

Любопытная работа с предсказуемым исходом. Условно, фото урагана со спутника выступает своего рода прокси для давления. Вопрос: могут ли латенты этих фото выступать в качестве осмысленных прокси? В этом и был эксперимент, и ответ — не могут. Методологически сделали хорошо, в чём-то даже математически элегантно, но будто бы не очень понятно, зачем. Было любопытно послушать размышления автора о фундаментальных причинах неудачи.

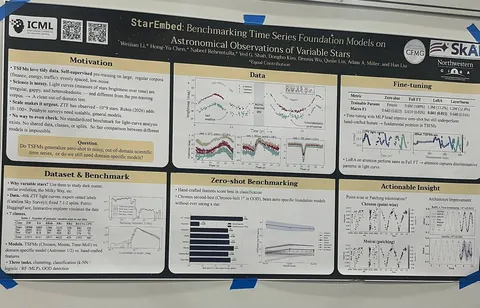
StarEmbed: Benchmarking Time Series Foundation Models on Astronomical Observations of Variable Stars

Не совсем о погоде, но полезно. Взяли временные ряды из астрономии и пробенчмаркали time series foundation models (TSFM) на этих незнакомых неидеальных данных. Проверили и в zero-shot, и в подтюненных сетапах. Как полагается, в сравнение добавляют и общепризнанный классический подход. Любопытно, что год назад команда Нейрометеума делала ровно то же самое с теми же моделями, но для прогноза приземной температуры в собственной формулировке. Результаты у нас вышли одинаковые — модели справляются на удивление хорошо, но побить классику не выходит. Наш алгоритм лежит на полке до лучших времён, но главный take away на будущее: файнтюн помогает, но несильно, а также стоит уделить внимание токенизации. В общем, было обоюдно приятно, что кто-то ещё пытается применить TSFM для научных задач.

Собрал интересное ❣ Павел Анисимов

#YaICML2026

ML Underhood
1 762 просмотров · 37 реакций Открыть в Telegram · Открыть пост на сайте
Мы уже на ICML 2026! 🇰🇷

Аннён, друзья! Инженеры и исследователи Яндекса шлют привет из Сеула, где сегодня стартует ICML 2026. Ниже собрали расписание наших постеров — со временем (по Сеулу) и местом проведения. Если вы тоже на ICML, приходите пообщаться, обсудить статьи и задать вопросы авторам.

7 июля (вторник)
GraphPFN: A Prior-Data Fitted Graph Foundation Model
10:30–12:15 (KST)
Hall A, Poster #2411

One-Step Gradient Delay is Not a Barrier for Large-Scale Asynchronous Pipeline Parallel LLM Pretraining
10:30–12:15 (KST)
Hall A, Poster #3610

Unveiling the Role of Data Uncertainty in Tabular Deep Learning
14:00–15:45 (KST)
Hall A, Poster #2802


8 июля (среда)
SoftSign: Smooth Sign in Your Optimizer for Better Parameter Heterogeneity Handling
14:30–16:15 (KST)
Hall A, Poster #3708


9 июля (четверг)
Inverse Entropic Optimal Transport Solves Semi-supervised Learning via Data Likelihood Maximization
10:30–12:15 (KST)
Hall A, Poster #2603

On Efficient Scaling of GNNs via IO-Aware Layers Implementations (Spotlight)
17:00–18:45 (KST)
Hall A, Poster #2205

Relevance-Based Embeddings: Lightweight Candidate Retrieval via Heavy-Ranker Calls
17:00–18:45 (KST)
Hall A, Poster #4007


Подробнее о работах основного трека рассказали тут и отдельно — о Spotlight-статье.

#YaICML2026

ML Underhood
3 682 просмотров · 38 реакций Открыть в Telegram · Открыть пост на сайте
ICML стартует уже в понедельник!

Мы уже рассказывали о Spotlight-работе, которую наши исследователи представят на конференции в Сеуле. Сегодня расскажем о других, не менее крутых статьях.

GraphPFN: A Prior-Data Fitted Graph Foundation Model

Исследователи из Yandex Research Дмитрий Еремеев, Олег Платонов, Глеб Баженов, Артём Бабенко, Людмила Прохоренкова создали графовую foundation model, развивающую подход Prior-Data Fitted Networks (PFN). Она предварительно обучается на миллионах специально сгенерированных синтетических графов, а затем может эффективно решать задачи на реальных данных как в режиме in-context learning, так и после дообучения. На широком наборе реальных графовых датасетов GraphPFN обходит все остальные протестированные модели.

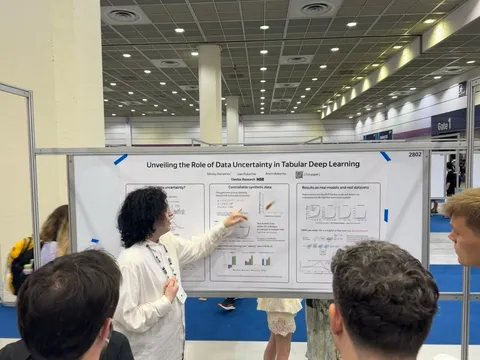
Unveiling the Role of Data Uncertainty in Tabular Deep Learning

Авторы из Yandex Research Николай Карташев, Иван Рубачёв и Артём Бабенко, исследуют, почему современные методы глубокого обучения показывают высокое качество в задачах на табличных данных. Многие успешные идеи последних лет — эмбеддинги числовых признаков, retrieval-augmented-архитектуры и продвинутое ансамблирование (TabM) — неявно повышают способность моделей работать с высокой неопределённостью в данных. Статья предлагает новый взгляд на недавний прогресс в DL на табличных данных, помогает понять, какие механизмы могут стоять за успехами современных табличных моделей, и задаёт направление для разработки новых методов.

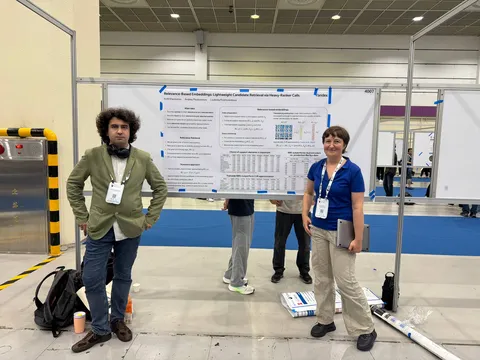
Relevance-Based Embeddings: Lightweight Candidate Retrieval via Heavy-Ranker Calls

Исследователи Яндекса — Кирилл Шевкунов и Людмила Прохоренкова — рассматривают задачу поиска наиболее релевантных объектов для заданного запроса.
Авторы предлагают способ строить эмбеддинги запросов и объектов с использованием информации от самой модели ранжирования. Подход учитывает релевантность запроса набору опорных объектов. Это позволяет получать более информативные представления и эффективнее находить кандидатов для дальнейшего ранжирования.

One-Step Gradient Delay Is Not a Barrier for Large-Scale Asynchronous Pipeline Parallel LLM Pretraining

Среди авторов статьи — исследователи Яндекса Филипп Змушко, Егор Петров, Нурсултан Абдуллаев и Михаил Хрущев. Работа выполнена в сотрудничестве с BRAIn Lab и MBZUAI.

В статье исследуется асинхронный pipeline parallelism для обучения больших языковых моделей. Такой подход позволяет повысить загрузку GPU, избавляясь от простоев видеокарт в пайплайне, однако долгое время считалось, что задержка градиентов ухудшает качество обучения. Авторы показывают, что проблема зависит не столько от факта самой задержки, сколько от типа используемого параллелизма, а также оптимизатора. В частности, Muon сохраняет значительную устойчивость в асинхронном режиме, а предложенная техника, основанная на Error-Feedback, дополнительно сокращает разрыв между синхронным и асинхронным обучением, позволяя обучать модели на масштабе 10B MoE без потери качества.

SoftSign: Smooth Sign in Your Optimizer for Better Parameter Heterogeneity Handling

Дмитрий Феоктистов из Yandex Research совместно с коллегами из BRAIn Lab предлагают новый подход к оптимизации нейронных сетей, основанный на сглаженной версии sign-обновлений. Он позволяет учитывать различия в поведении отдельных параметров модели и адаптировать величину обновлений во время обучения под них. На основе этой идеи разработали оптимизаторы SoftSignum и SoftMuon. Они стабильно превосходят классические sign-based-методы и AdamW на широком наборе задач.

О работах, которые представим на воркшопах, расскажем отдельно. И даже покажем, как это выглядело вживую.

#YaICML2026

ML Underhood
2 385 просмотров · 37 реакций Открыть в Telegram · Открыть пост на сайте
Ускорили перевод видео в Яндекс Браузере — задистиллировали диффузионный декодер TTS

Делимся свежей хабростатьёй о том, как ускорили синтез речи при переводе видео в Яндекс Браузере. Зачем это понадобилось, где были подводные камни и что в итоге уехало в прод — рассказал ML-инженер команды TTS в Яндексе Цырен-Доржо Цыбиков.

С чего стартовали

Внутри TTS — каскад из трёх частей:
🔴языковая модель предсказывает аудиотокены по тексту;
🔴диффузионный декодер восстанавливает мел-спектрограмму из латентов;
🔴вокодер превращает её в звуковую волну.

После того как оптимизировали языковую модель (она долго была самой тяжёлой), узким местом стал декодер латентов: его forward pass запускается на каждом шаге семплинга, а шагов — десятки. Его и взялись ускорять.

Что сделали с аттеншном

Прогнали инференс через torch.profiler и увидели, что время съедают рукописный QKVAttention и пересчёт RelativePositionBias на каждой итерации. Дальше — по нарастающей:
🔴перевели self-attention на SDPA (memory-efficient) и закешировали bias → 2,5× на уровне QKVAttention и почти вдвое меньше GPU-памяти, всё без переобучения;
🔴проверили гипотезу RoPE + FlashAttention — и честно её похоронили: на наших размерах тензоров она не обогнала кешированный baseline. Зато получили полезный отрицательный результат;
🔴как более сильную архитектуру посмотрели DiT (на него уже перешли F5-TTS, CosyVoice3): качество выше, латенси сопоставимое.

Главный буст — дистилляция флоуматчинга

Самое интересное — поверх флоуматчинг-декодера навесили две дистилляции:
🔴CFG-distill: вместо двух forward pass'ов на шаг (conditional + unconditional) student воспроизводит guided-предсказание за один проход;
🔴progressive distillation: student учится за один шаг делать то, что teacher делает за два, и число шагов итеративно уменьшается вдвое.

Вместе это срезало число шагов семплинга с ~20 до 3 при паритете качества по SBS (наивное снижение шагов так не умеет — звук заметно проседает). Бонус progressive distillation — почти не пришлось трогать прод-код инференса, поменяли число шагов в конфиге.

Итог

Эти ускорения вместе дали примерно 1,5× ускорения всего TTS-пайплайна целиком. На практике это позволило на четверть сократить использование GPU в TTS-компоненте.

Подробности, замеры и блок с выводами — на Хабре.

ML Underhood
6 311 просмотров · 66 реакций Открыть в Telegram · Открыть пост на сайте
Везём восемь статей на основной трек ICML!

В этом году наши исследователи представят на ICML восемь работ в основной программе и ещё восемь — на воркшопах.

На ICML 2026 было подано 23 918 работ — вдвое больше, чем в 2025 году. Из них приняли 6 352 статьи (26,6%), а статус Spotlight получили только 536 работ — 2,2% от всех поданных заявок. Это статьи, которые получили самые высокие оценки программного комитета.


Начинаем серию постов о принятых работах со Spotlight-статьи On Efficient Scaling of GNNs via IO-Aware Layers Implementations, посвящённой эффективному масштабированию графовых нейросетей.

Что исследовали

Авторы — Дарья Фомина из команды ML-инфраструктуры, Вячеслав Ждановский из команды разработки инференса, Фёдор Великонивцев из Yandex Research и студенты ШАД — исследуют, как ускорить обучение и инференс Graph Neural Networks на GPU. Несмотря на популярность таких моделей, их производительность часто ограничивается не вычислениями, а неэффективной работой с памятью на GPU и большим объёмом передачи данных.

Что получилось

Исследователи разработали набор GPU-ядер для наиболее популярных семейств графовых нейросетей — от графовых свёрток и агрегирующих операторов до современных архитектур, таких как Graph Transformers и GATv2. Эксперименты на крупных графах показывают заметное ускорение работы и снижение потребления памяти по сравнению с существующими решениями.

Кроме того, авторы изучили влияние переупорядочивания вершин графа в памяти GPU и показали, что его эффективность зависит как от структуры графа, так и от особенностей доступа к данным.

Статья уже выложена на Arxiv, а код — на GitHub.

#YaICML2026

ML Underhood
6 436 просмотров · 61 реакций Открыть в Telegram · Открыть пост на сайте
Как устроена голосовая активация в Яндекс Дропс

Недавно Яндекс запустил свои первые ИИ-наушники — Яндекс Дропс. В числе прочего они умеют распознавать обращение «Алиса», а отвечает за эту способность компонент, который мы внутри называем «споттером» (чуть подробнее писали о споттерах тут). И если с голосовой активацией в колонках всё плюс-минус понятно, то перенести её в наушники — это челлендж.

О том, что было сложного в этом процессе и как в итоге выкрутились, рассказал на Хабре Григорий Афанасенко из команды голосовых технологий. А мы пересказываем самое интересное.

Для начала следовало выбрать чип, который позволил бы споттеру работать непрерывно и постоянно искать обращение в окружающем шуме. Большинству CPU такое не под силу — поэтому взяли чип с NPU (Neural Processing Unit). Решение казалось практически беспроигрышным — но ещё подкинуло сложностей в процессе.

Даже с NPU надо было придумать, как оптимизировать потребление энергии. Решили сделать два этапа — и тем самым уменьшили нагрузку в пять раз:

1. Лёгкая модель VAD (Voice Activity Detector) отделяет голос от фонового шума.

2. Когда VAD услышал голос, включается споттер и разбирается, «Алиса» это или нет.

Также была проблема с тем, что модели из умных колонок в наушники никак бы не влезли. Надо было ужать модель под NPU, сохранив качество распознавания. Провели ряд оптимизаций (разбили подсчёт зависимостей на два шага с помощью Depthwise‑separable convolution, добавили дистилляцию знаний и квантование в 8 бит) — и уместили модель в 200 КБ.

А теперь возвращаемся к той самой проблеме в NPU. Выяснилось, что SDK производителя чипа накладывает жёсткие ограничения на архитектуру: размер ядра свёртки — до 15 фреймов для обычных свёрток и до 11 фреймов для depthwise.

Пришлось сделать сеть глубже, чтобы набрать нужный контекст, а вместо Hardswish выбрать ReLU, которая хорошо ведёт себя после квантования. Но тут получили затухание градиента, из-за которого нижние слои почти не обучались. Помог переход на residual‑архитектуру.

А ещё, после долгих экспериментов с SDK, разобрались, как использовать для наших моделей стриминг, — и увеличили модель в два раза.

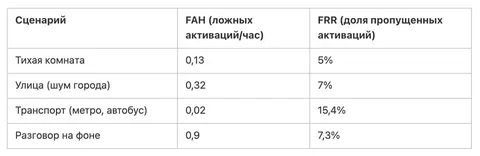
Качество споттера оценивали по числу ложных срабатываний в час и доле пропущенных верных активаций. Лучший баланс, разумеется, в тихой комнате. На улице качество чуть ухудшается, а в транспорте система почти не срабатывает ложно, но цена за это — высокий уровень пропусков. Ещё один сложный сценарий — разговор на фоне: доля пропусков небольшая, а вот число ложных активаций возрастает ощутимо.

Подробнее о том, как собирали данные для обучения и почему решили отказаться от модели для быстрых команд, рассказали в хабростатье. Там же — о дальнейших планах по развитию технологии.

ML Underhood
2 488 просмотров · 48 реакций Открыть в Telegram · Открыть пост на сайте
Какие ML-тренды принесла прошедшая ICLR 2026

О собаках на постерах и моде на микростенды мы уже писали. Но на конференции были замечены и другие (более серьёзные) тренды, о которых рассказали на Хабре Мария Никифорова, старший разработчик службы качества претрейна YandexGPT, и Дарья Шатько, руководитель ML в Yandex Crowd. Делимся главным.

Агентские системы — везде и всюду

2026-й стал для ICLR годом автономных агентов. Фокус исследований сместился с отдельных моделей на проектирование долгоживущих агентских систем, которые могут планировать на несколько шагов вперёд, выстраивать сложные цепочки зависимых вызовов инструментов, накапливать память и опыт, поддерживать мультиагентность и даже эволюционировать без дообучения базовой модели.

Новые подходы к развитию памяти агентских систем

Простое расширение контекстного окна до миллионов токенов не решило проблему памяти агентских систем. Большая история диалога зашумляет контекст, увеличивает вычислительную сложность и ведёт к деградации качества ответов. На ICLR оформился тренд: агенту нужна управляемая, структурированная память, способная к компрессии и абстрагированию опыта. На конференции было много подходов на эту тему, и среди них можно выделить два особенно интересных. Первый — переход от сырых трейсов к семантическим графам знаний. Второй — многоуровневая компрессия памяти и предсказание пользовательского интента.

Speculative Execution в агентах

Чем автономнее становятся агенты, тем сильнее растёт latency. Если нужно последовательно вызвать несколько инструментов, дождаться ответов, сделать выводы и спланировать следующий шаг, инференс растягивается на десятки секунд. Исследователи предложили перенести фундаментальный принцип спекулятивного выполнения (Speculative Execution) из многопоточных CPU и спекулятивного декодирования LLM на уровень агентской оркестрации.

Интерактивные среды — новый стандарт оценки агентов

Обычные бенчмарки с вопросом и правильным ответом всё хуже отражают реальные способности агентских систем. Агент может ошибиться не только в финальном ответе — он также может выбрать не тот инструмент, плохо спланировать шаги, зациклиться, неправильно понять состояние среды или сломаться из-за изменений интерфейса.

На смену привычным тестам с фиксированным инпутом и golden-ответом пришли динамические платформы, которые изолируют агента в интерактивном окружении и замеряют его живучесть на долгих задачах. В основном исследователи фокусировались на трёх вещах: поведении агента на длинных горизонтах, стратегии сбора информации и устойчивости к изменениям UI и среды.

RL учит поведению, а не ответам

RL для агентских систем перестает быть способом дообучить модель на правильный финальный ответ. Теперь систему учат правильно вести себя в процессе: исследовать среду, пользоваться памятью, выбирать инструменты, общаться с пользователем и не делать лишних действий.

Текстовая диффузия выходит в прод

Ещё недавно Diffusion LLMs воспринимались как необычная альтернатива авторегрессионным LLM, но к ICLR 2026 она уже оформилась в заметное направление. Теперь изучают не то, работает ли это вообще, а более практичные вещи: как масштабировать DLM, при каких режимах обучения они ведут себя лучше авторегрессионных моделей, и в каких задачах не-авторегрессионная параллельная генерация действительно даёт преимущество.

Продолжаем экономить компьют

По мере роста моделей и датасетов эксперименты становятся всё дороже. Исследователи чаще оптимизируют сам процесс разработки: какую смесь данных брать, какие гиперпараметры переносить на большой масштаб, как понять, какие примеры реально повлияли на поведение модели.

На ICLR особенно выделялись два направления: 1) data selection — поиск максимально полезных данных в рамках ограниченных экспериментов, 2) ускорение инференса моделей.

В наш пост уместился только верхенеуровневый рассказ о заметных тенденциях, а в полной статье вы найдёте ещё и структурированную подборку работ по каждой теме.

#YaICLR26

ML Underhood
2 452 просмотров · 29 реакций Открыть в Telegram · Открыть пост на сайте
ICRA — день второй, насыщенный

Вена продолжает удерживать статус столицы робототехники — по крайней мере, на время проведения конференции. Вот что интересного увидели, услышали и узнали на мероприятии.

• В задаче генерации сцены предлагают EP-Diffuser. Модель похожа на MotionDiffuser, но использует полиномы в качестве входов и выходов диффузера (в отличии от MotionDiffuser, где вход — сырые вектора, а выход — PCA компоненты).
• Много статей об автоматической парковке: есть end-to-end-решения и подходы с декомпозицией задачи на предсказание интентов агентов и дальнейшую генерацию траектории, согласованной с интентами агентов.
• Несколько работ посвящены предсказанию опасных траекторий. Например, манёвров перестроения с подрезанием автономного автомобиля для последующей проверки в симуляции.
• Одни авторы собрали целый мини-город в масштабе 1:15 для тестирования планера.

Бонусом — пачка весёлых роботов: они играют в казике, гоняют мячик и машут крыльями.

Ну и напоминаем, что если хотите почитать больше разборов с ICRA, подписывайтесь на наш канал @DriverNotFound. Там в ближайшее время будет прямо много ИКРЫ. Простите, пожалуйста.
Интересное увидели ❣ Егор Волков и Максим Спорышев

#YaICRA26

ML Underhood
2 216 просмотров · 21 реакций Открыть в Telegram · Открыть пост на сайте