Алиса теперь понимает английский — и делает это без ущерба для русского. В колонках и чате заработал билингвальный ASR, а вместе с ним — сценарии для практики английского.

В нашем новом канале @speechinfo — подробности от команды, которая это реализовала. Подписывайтесь, чтобы быть в курсе свежих разборов на тему аудио и ML!
2 102 просмотров · 28 реакций Открыть в Telegram · Открыть пост на сайте
Билингвальный ASR — уже в станциях и чате с Алисой

Мы с хорошими новостями — теперь Алиса знает два языкаа: русский и английский! При этом распознавание русского не пострадало, а стало даже лучше. Обновлённая Алиса и поддержит диалог с носителем, и поможет улучшить навыки новичка. Мы ликуем, пользователи в восторге, а вот репетиторы и всем известная сова немного грустят.

Евгений Ганкович, руководитель группы ASR, рассказал, с какими вызовами столкнулась команда:

— Необходимо было обучить модель, которая способна работать с новым языком, при этом критически важно было не просадить качество на русском.
— Домен английского для русскоговорящих пользователей специфичен и не решается с помощью открытых данных.
— End-of-utterance (EOU) по многим причинам работает у англоговорящих пользователей иначе.
Разберём, почему нужно было создавать билингвальную модель, а не обучать две отдельные.

Сложность решения в том, что заранее неизвестно, на каком языке поступит запрос: пользователь может начать на русском, а продолжить на английском или наоборот.

В теории можно использовать классификатор: задан запрос, система определяет язык и направляет его в соответствующую модель. Но чтобы точно определить язык, придётся подождать несколько секунд. К тому же такая система сложнее в поддержке и плохо справляется со смешанными языками (см. «смотря какой fabric, смотря сколько details»).

Выходит, что разумный путь — развивать текущий русскоязычный стек до двуязычного и использовать одну модель, которая инкапсулирует логику выбора языка.

Однако и здесь есть подводные камни. Даже незначительное ухудшение распознавания на русском негативно скажется на пользовательском опыте. Поэтому новую логику в модель нужно добавлять осторожно. Причём улучшения вносятся в две ключевые части голосового стека:

- End-of-utterance (EOU) — модель на основе аудио и паршального распознавания, которая определяет, когда пользователь закончил говорить.
- E2E Seq2Seq на базе трансформеров — модель распознаёт завершённый фрагмент речи на русском или английском языках.

Чтобы улучшить эти две компоненты, нужны данные. Начать можно с открытых — но это другой домен: и акустика, и пользователи отличаются. Поэтому мы привлекли отдельных людей для создания более подходящих нам данных. Так собрали рабочее решение, но не сразу получили нужное качество.

Следующим шагом провели тесты на сотрудниках Яндекса, которые использовали колонку с раскатанной технологии. На этой стадии смогли собрать ошибки, необходимые для улучшения модели. Группы, на которые раскатывали технологию, росли по мере улучшения модели, а мы всё тоньше настраивали модель.

По мере появления данных мы проводили эксперименты с обеими моделями, подбирая датамиксы и гиперпараметры тренировок. И в какой-то момент достигли качества для полноценного распознавания целевых запросов на английском. Интересно, что в этих экспериментах получилось немного улучшить качество русского, так что исходную задачу даже перевыполнили.

Оставалось разобраться с EOU. Здесь были сложности из-за режима «тьютора», в котором можно вести диалог с Алисой. Пользователи сценария могут делать паузы, растягивать слова, и в таких случаях обычная модель может преждевременно обрезать речь. Дослушивать мы тоже не можем — это может повлиять на другие компоненты и ответы Алисы сильно замедлятся.

Решение крылось в добавлении в пайплайн EoU более робастной и стабильной модели, способной учитывать паузы и длительность речи. Хотелось бы рассказать о технологии подробнее, но для этого потребуется описать весь пайплайн распознавания — если вам интересно, дайте знать в комментариях.

В итоге мы получили результат, который стал важной частью большого релиза:

— Голосовой набор сообщений на английском языке в чате и колонке;
— Сценарий «тьютор» на колонке: пользователи могут вести диалог с Алисой, получать фидбек и переводить текст голосом.

Зовём протестировать, что у нас получилось: попробуйте поговорить с Алисой на английском или скажите: «Алиса, давай практиковать английский».

Евгений Ганкович ❣ Специально для Speech Info
2 077 просмотров · 30 реакций Открыть в Telegram · Открыть пост на сайте
Как устроена модель исправления ошибок в нейроредакторе Яндекс Браузера — часть I

В конце сентября в Яндекс Браузере запустили нейроредактор — это инструмент, который исправляет ошибки в тексте, делает его более читабельным и грамотным. С момента релиза функциями нейроредактирования в Браузере воспользовались с 18 миллионов устройств.

Сегодня ML-разработчик в Яндексе Никита Авдосев расскажет о модели исправления ошибок, которая работает «под капотом» нейроредактора. В первой части разбора поговорим о качестве исправления ошибок и работы с промптом. А во второй — о перфомансе.

Качество исправления ошибок

Предполагалось, что модель для исправления будут использовать с целыми текстами или их фрагментами. Сценарий такой: вы выделяете текст, а на выходе получаете скорректированный вариант без опечаток, с правильными окончаниями и корректно расставленными знаками препинания. Поэтому модель обучали на целых текстах, в исправлении которых LLM показывала себя хорошо.

Однако на практике оказалось, что весьма популярен и другой сценарий — выделить только одно слово с ошибкой и отправить его. Это логично, если слово подчеркнул браузер, но изначально инженеры не учли такого варианта.

Проведенные инженерами проверки показали, что в 41% случаев модель исправляла слово неверно либо не исправила вовсе, потому что у неё не было контекста. Результат весьма сомнительный, поэтому инженеры решили исправить эту недоработку. После всех улучшений модели доля ошибок в коррекции коротких текстов и отдельных слов сократилась до 16%.

Можно задаться вопросом: «А 16% — это много или мало?» Для сравнения, в Яндексе замерили, как хорошо срабатывает «опечаточник» — отдельный механизм внутри Браузера, который отвечает за подсветку неправильно написанных слов, когда вы печатаете, и предлагает варианты исправления (если достаточно в них уверен). Это не LLM, а алгоритм, который обращается к словарю. Задача непростая, но сейчас «опечаточник» отлично справляется с 75% ошибок. Значит, в этом плане модель превосходит решение, которое давно себя зарекомендовало.

Качество работы с промптом

В момент выхода нейроредактора наиболее важной новой фичой для разработчиков была возможность работы с промптами. Чтобы можно было поставить какую-то задачу — например, переписать текст так, как будто его автор бандит или сократить текст до двух абзацев — и нейросеть постарается её выполнить, в значительной мере опираясь на предложенный текст.

После релиза в Яндексе учли реальные пользовательские сценарии и обновили модель, сделали больший акцент на популярные задачи. Для этого пришлось обновить датасеты для обучения и замеров.

Однако при таком подходе, когда упор только на популярное, из виду пропадает «хвост» — редкие, нечастотные запросы, которые составляют 15-20% от общего числа. Однако и на таких важно фокусироваться, потому что именно на их основе можно почувствовать реальную «умность» моделей

И если способ измерения качества на «хвосте» более-менее понятен, то с вопросом дообучения дела обстоят сложнее. Ведь задачи в большинстве своем уникальные, креативные и не всегда очевидно сформулированы — вдобавок их мало. Научить модель чему-то на основе одного примера почти невозможно. Да, она увидит пример, но вероятность того что в будущем она начнёт решать подобные задачи хорошо крайне мала.

Поэтому инженеры компании сфокусировались на двух направлениях:

— генерализация — способность модели решать разные задачи, в том числе те которые раньше не видела. Для этого нужно увеличивать разнообразие задач и их формулировок;
— создание синтетических данных. Речь об обучающих примерах, сгенерированных более крупными моделями.

За счёт синтетики инженеры сумели количественно и качественно расширить хвост креативных запросов. В датасет из текстов и промптов добавили примерно 5 тысяч примеров. И теперь запросы вроде «перепиши как гопник» стали работать креативнее, чем раньше.

ML Underhood
2 564 просмотров · 37 реакций Открыть в Telegram · Открыть пост на сайте
YandexGPT 5 Lite Instruct теперь в опенсорсе 🎉

В феврале в открытый доступ вышла Pretrain-версия, а сейчас очередь дошла и до YandexGPT 5 Lite Instruct. Это модель на 8 миллиардов параметров с размером контекстного окна в 32К токенов.

О претрейне мы уже писали вот тут, а алайнмент аналогичен тому, через который проходит YandexGPT 5 Pro. На этапе SFT концентрировались на сложных запросах, а также методах фильтрации и ранжирования данных. В рамках RLHF комбинировали RL-подходы, которые дают лучшие результаты: DPO, LogDPO и PPO. Подробнее об этом читайте на Хабре.

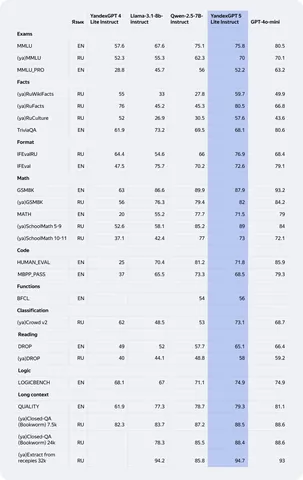
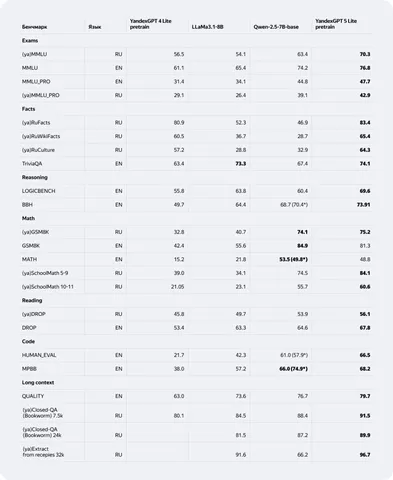
По результатам внутреннего слепого попарного сравнения (side-by-side) новая модель YandexGPT 5 Lite превосходит Qwen-2.5-7B-instruct в 62% случаев и не уступает GPT-4o mini в решении стандартных задач сервисов Яндекса. Показатели бенчмарков можно посмотреть в таблице.
А ещё обновили лицензию: теперь можно использовать модель не только в некоммерческих целях, но и в коммерческих до 10 миллионов выходных токенов в месяц. Если ваши объёмы выше, напишите на почту, указанную в тексте лицензии.

Модель доступна на Hugging Face. Там же есть и квантизованная версия с поддержкой GGUF. YandexGPT 5 Lite Instruct совместима с llama.cpp и Ollama.

ML Underhood
17 336 просмотров · 65 реакций Открыть в Telegram · Открыть пост на сайте
Как ML рассаживает деревья в Яндекс Картах

Год назад в Яндекс Картах в Москве и Петербурге появились трёхмерные деревья, которые добавляют реалистичности и помогают пользователям лучше ориентироваться на местности. В этом посте Стас Лебедев, разработчик группы AI-картографирования, рассказывает, как устроен ML, который рассаживает деревья в Картах.

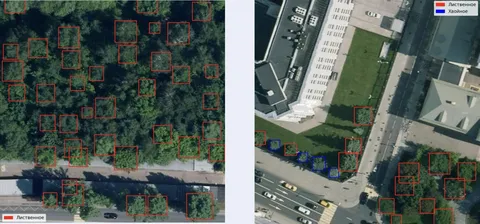
Разработанная модель умеет три вещи: определять деревья на аэросъёмке, отличать лиственные породы от хвойных и оценивать размеры деревьев. Каждому дереву подбирается подходящая 3D-модель, которую размещают на карте. Фактически моделей всего две: лиственная или еловая, а для эффекта разнообразия они масштабируются и немного поворачиваются.

Работа с данными

Основная сложность была в том, чтобы собрать и правильно обработать данные. Нашли несколько источников разметки — каждый со своими нюансами. В итоге использовали два:

— разметку от сообщества картографов «Народная карта» — она содержала несколько тысяч деревьев с достаточной точностью, но этого было мало для обучения модели;
— один из публичных датасетов геоданных — показал хорошую точность, но низкую полноту; немного уступал данным от картографов и отличался по параметрам съёмки.

Обучение

Модель предобучили на публичном датасете и разметке картографов. Она смогла базово отличать деревья, но качество предсказаний было низким, особенно по полноте. Помогла доразметка с «активным обучением»: прицельно размечали изображения, на которых модель часто сомневалась и возвращала предсказания рядом с порогом принятия решения.

За два месяца дополнительно разметили около 60 тысяч деревьев в Москве, Петербурге и Калининграде. При этом модель определила 4 миллиона деревьев за два дня — это показывает, как автоматизация сокращает трудозатраты на разметку данных.

Архитектура

В основе архитектуры — классическая UNet-модель с ResNet в качестве бэкбона. Нейросеть предсказывала попиксельную карту вероятностей наличия дерева в каждой точке. Изначально поиск деревьев был тесно связан с поиском точечной дорожной разметки (стрелочки на асфальте). На абстрактном уровне — это очень похожие вещи. Поэтому разработанные решения базируются на одних и тех же идеях, почерпнутых из этой статьи.

Проблему с недооценкой количества деревьев решали с помощью focal loss — модифицированной кросс-энтропийной функции, которая увеличивает влияние сложных для локализации объектов. Дополнительно повысили вес ошибок, связанных с пропусками, чтобы модель не игнорировала малозаметные деревья. Без такого перераспределения потерь предсказания смещались в сторону фона — то есть модель чаще выбирала класс «нет дерева», чем «есть дерево».

Модель научилась хорошо определять, где находится дерево, но также ей нужно было понимать, какого оно типа и какая 3D-модель для него нужна. А для этого надо понять ширину и высоту. Мы обратили внимание на модель DeepForest, которая плохо находила центры, но хорошо предсказывала ширину. Решили объединить усилия: нашей моделькой находили локализацию деревьев, а DeepForest просили сказать, какой они ширины. В результате получили данные, на которых смогли обучить модель предсказывать ширину по локализации: где находится дерево и как выглядит этот маленький кусочек снимка.

Благодаря картографам у нас также были данные вида: «это дерево, и оно имеет ширину Х и высоту Y». Мы уже научились находить дерево и определять его ширину. Осталось взять имеющиеся данные и научиться с их помощью предсказывать высоту. Вуаля — мы получили модель, которая умеет локализовывать (находить местоположение) + вычислять ширину (по локализации) + вычислять высоту (по ширине и тому, как дерево выглядит).

Результаты и планы

В итоге модель помогла разметить для Москвы почти 3 млн деревьев, а для Петербурга — 1,1 млн деревьев.
Сейчас система работает на аэросъемке, но в будущем есть планы перевести её на спутниковые снимки. Это ускорило бы обновление карт, поскольку спутниковая съёмка дешевле и проводится чаще. Однако разрешение спутниковых снимков ниже, и для такого перехода нужны дополнительные исследования и более сложные модели.

ML Underhood
3 028 просмотров · 47 реакций Открыть в Telegram · Открыть пост на сайте
Личный опыт инженеров Яндекса — Никита Киселёв

Сотрудники компании продолжают рассказывать нашему каналу о своей работе, успехах и вызовах. Сегодня на очереди Никита Киселёв, руководитель службы любви к дискавери в Яндекс Картах.

#YaMLpeople

ML Underhood
2 846 просмотров · 17 реакций Открыть в Telegram · Открыть пост на сайте
Как и зачем Алису учат понимать интонации

Алису учат откликаться не только на её имя, но и на определённые команды и даже интонации. Причём вторая задача — на порядок сложнее. В этом посте Дмитрий Солодуха, руководитель команды голосовой активации, рассказал, как она решается.

Голосовая активация — это распознавание фраз в потоке звука, поступающих на микрофоны умного устройства. А модель, которая решает задачу голосовой активации, называют споттером. В Яндексе работают над командными и интонационными споттерами. И если первые в проде уже какое-то время, то вторые — только с 27 февраля этого года и пока только на Станции Миди.

Как устроен споттер в целом:

1. На вход поступает сырой сигнал с частотой 16 кГц.
2. Преобразуем его в спектрограммы с помощью оконного преобразования Фурье. Это позволяет перейти от временной размерности к частотной.
3. Затем уменьшаем размерность, используя мел-шкалу и логарифмирование.

После этого можно подавать данные в свёрточную сеть. Мы используем свёрточную сеть до 1 млн параметров, похожую на MobileNet, но с одномерными DepthwiseSeparable свёртками вместо двумерных. Линейные слои заменяем их низкоранговым приближением, а вместо Swish берём Hard-Swish — его адаптацию, которую удобно вычислять на железе.

Идея интонационного споттера

В какой-то момент базовый споттер улучшили настолько, что он стал отличать произнесённое в девайс слово «Алиса» от обращённого к человеку. Мы подумали, что можно пойти дальше и обучить другой споттер понимать по интонации, что нужно активироваться и отправить запрос на сервер. Это упростит жизнь пользователям и позволит нам сэкономить на произносимых «Алисах».

Пользователи часто забывают произносить «Алиса» перед запросом, то есть ожидают от неё диалога. Умение активироваться на интонацию становится точкой входа в общение ассистента с пользователем.

Но здесь столкнулись с проблемами: неочевидно, откуда брать данные, нет готовой разметки, а также непонятно, в какой момент устройство должно активироваться.

Сначала попробовали использовать данные, которые наговорили асессоры, но из-за того, что люди использовали неестественные интонации, датасет выходил плохим.

Тогда решили взять данные от ASR — не только из активаций, но и из дослушиваний — режима, в котором колонка проактивно продолжает диалог. Например, если я спрашиваю: «Алиса, какая погода в Минске?», она отвечает и уточняет: «А хотите узнать погоду в Белграде?». При этом пользователь не говорит «Алиса» повторно. Это уже похоже на естественный диалог, хотя и не лишено ограничений, которых не будет у интонационного споттера: дослушивания работают не на каждый запрос и ждут пользователя только в коротком интервале около 3–5 секунд.

Мы пересэмплировали полученные данные, чтобы убрать смещение в сторону популярных запросов, и получили нужный датасет.

Для разметки использовали решение соседней команды ASR — классификацию на side-speech. Суть в том, что ASR пытается на последнем этапе своей работы понять, действительно ли речь имела полезный смысл. Мы немного доработали исходные метки и получили для себя псевдолейблы, которые буквально говорят нам, подходящая интонация для активации или нет.

На видео показано, как интонационный споттер работает и решает более сложные задачи, чем стандартная активация на имя. В итоге это позволяет Алисе быть более человечной в диалоге.

ML Underhood
3 400 просмотров · 26 реакций Открыть в Telegram · Открыть пост на сайте
Личный опыт инженеров Яндекса — Петр Вытовтов

Погода в доме, конечно, важна, но нужно и на улицу выходить. А чтобы дождь или снег не застали вас врасплох, стоит ознакомиться с прогнозом.

В его создании сегодня ключевую роль играют нейросети, которые анализируют огромные массивы данных. О том, как эти технологии преобразили сервис Яндекс Погода, а также о своих профессиональных достижениях и вызовах нашему каналу рассказал Петр Вытовтов — руководитель группы машинного обучения направления.

#YaMLpeople

ML Underhood
2 496 просмотров · 22 реакций Открыть в Telegram · Открыть пост на сайте
YandexGPT 5 уже в опенсорсе и Алисе

Сегодня Яндекс показал миру новое поколение больших языковых моделей — YandexGPT 5. Старшая модель YandexGPT 5 Pro доступна в чате с Алисой и Yandex Cloud через API. Ну а претрейн-версия младшей модели YandexGPT 5 Lite Pretrain — уже лежит на Hugging Face.

Все подробности о процессе обучения можно прочитать в статье на Хабре. А в этом посте — главные факты о свежей опенсорсной модели Яндекса.

YandexGPT 5 Lite Pretrain — модель на 8 миллиардов параметров с длиной контекста 32 тысячи токенов. Претрейн проходил в два этапа: сначала модель обучили на 15 триллионах токенов текста на русском и английском языках, а потом использовали 320 миллиардов токенов высококачественных данных, включая образовательный контент.

На первом этапе датасет больше чем на половину состоял из веб-документов, остальное — код, математика и специфичные данные. Под последними подразумеваются синтетика (сгенерированные YandexGPT 4 вопросы на основе проверенных источников) и внутренние наработки компании (например, внутренняя база Яндекса Fact Snippet и новый корпус данных Переводчика).

На втором этапе датасет на четверть состоял из веб-страниц и почти в равных пропорциях содержал математику, код и образовательные данные. Также была небольшая часть аугментаций фактовых документов, другой синтетики и датасетов сервисов.

По сравнению с моделью предыдущего поколения, YandexGPT 4 Lite Pretrain, новая модель показывает ощутимый рост качества в решении математических задач и написании кода. А в сравнении с зарубежными аналогами, такими как LLaMa3.1-8B и Qwen-2.5-7B-base, она лидирует почти во всех типах задач.

Ещё раз приглашаем пощупать модель, почитать статью на Хабре с деталями обучения и не забыть поделиться впечатлениями в комментариях!


ML Underhood
7 779 просмотров · 39 реакций Открыть в Telegram · Открыть пост на сайте
Документный LLM-переводчик в Яндексе

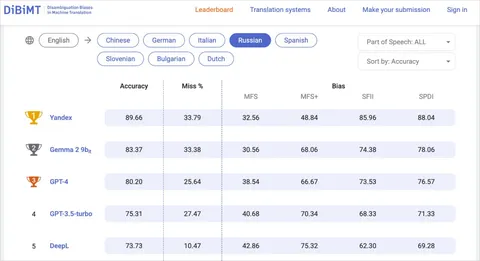
Яндекс запустил новую модель для документного перевода на основе YandexGPT. Она уже работает в Поиске, Умной камере и Нейропереводчике Яндекс Браузера, а также заняла первое место в бенчмарке DiBiMT по переводу с английского на русский. Обо всех нюансах работы переводчика и о том, как его создавали, на Хабре рассказал руководитель группы базового качества перевода Николай Карпачёв. А здесь — кратко о главном.

Документный перевод предполагает адаптацию на другой язык не каждого отдельного предложения, а всего текста. Почему это важно? Причин несколько. Например, английское «you» может означать как «ты», так и «вы», но без контекста модель не понимает, какой вариант выбрать. Термины и стилистика могут «прыгать» внутри текста, а пропущенные элементы, понятные носителю языка, в переводе превращаются в бессмысленный набор слов. Люди воспринимают текст иначе: мы читаем книги, статьи, субтитры — всё целиком. Значит, и машинный перевод должен работать так же.

Инженеры Яндекса попробовали перевести тексты LLM-моделью «из коробки», без дообучения, но столкнулись с типичными ошибками: пропущенные фрагменты, лишние добавления, галлюцинации. Чтобы этого избежать, модель пришлось адаптировать. На первом этапе подготовили данные, включая не только классические парные предложения, но и переводы документов, полученные автоматическим выравниванием и с помощью синтетики. Дообучение проходило в форматах LoRA и P-Tuning.

На следующем этапе модель дообучалась с помощью технологии alignment. Разные варианты переводов сравнивались редакторами-профессионалами. Полученные оценки использовали для оптимизации методом Contrastive Preference Optimization (CPO). На этой стадии происходит исправление существующих ошибок и проблем LLM-модели, найденных редакторами. Это позволило минимизировать ошибки, связанные с потерей информации и несогласованностью.

В итоге по метрике MQM новая модель переводит тексты почти так же хорошо, как человек. Количество грубых ошибок сократилось в два раза по сравнению с предыдущей версией, а финальный результат оказался даже лучше GPT-4o.

ML Underhood
7 170 просмотров · 43 реакций Открыть в Telegram · Открыть пост на сайте
Личные итоги года инженеров Яндекса — Максим Спорышев

Середина февраля 2025-го — не помеха для подведения итогов 2024-го. Тем более, если они такие интересные, как сегодняшние. Ими поделился руководитель группы алайнмента модели планирования движения в Яндексе Максим Спорышев. Он рассказал о собственных успехах и о том, чем ему запомнился прошлый год.

#YaMLpeople

ML Underhood
2 677 просмотров · 19 реакций Открыть в Telegram · Открыть пост на сайте
Как в Яндексе заменили сложную разметку на LLM

В конце прошлой осени Команда качества поиска одной из первых в Яндексе смогла существенно удешевить сложную асессорскую разметку за счёт генеративной модели. Татьяна Климук, руководитель Службы исследований и качества ранжирования, рассказала, как работали над технологией.

Яндекс использует услуги тысяч асессоров, которые каждый день выполняют десятки тысяч заданий по оценке выдачи с точки зрения качества и релевантности. Это дорогой, долгий и сложный процесс.

Идея проекта в том, чтобы отдать рутинную работу по разметке сильной нейронке. При этом мы не отказываемся от асессоров, а переключаем их на разметку более важных и сложных кейсов, а также поручаем контролировать корректность работы модели.

Архитектура

Мы начали с экспериментов с базовым претрейном от YandexGPT. На вход подавали сжатую инструкцию, запрос и контент документа, на выходе получали решение о принадлежности к одной из категорий релевантности.

Однако промптинг даже SoTA-моделей пока не даёт нужного качества на нестандартных кейсах. Инструкция оказывается для них настолько сложной, что без дообучения ни одна модель не справляется с ней. Поэтому на старте получилось выжать только 55% качества асессоров.

Тогда мы сделали ряд улучшений:

— Взяли претрейн от Нейро, который лучше понимает поисковый домен и легче обучается решать поисковые задачи.
— Обучались не просто на метку класса, но и на подготовленные Chain-of-Thoughts, чтобы научить модель больше думать перед тем, как она даёт ответ.
— Добавили внешние данные — знания, необходимые для понимания контекста, которые нельзя извлечь из текста. Пример таких знаний — то, какие страницы в сети официальные, а какие — нет.
— Подавали данные для обучения в нужном порядке — от более мусорных к более качественным.

Так мы добились качества 102% относительно разметки асессоров, что уже было неплохо. Но оставался риск «сломать» Поиск — поэтому нужно было проверить модель на разных классах запросов, исключить риск деградации со временем и учесть другие нюансы.

Решение

В итоге мы придумали решение, которое использует оценку как от людей, так и от нейросети. Мы стали извлекать из неё не только ответ по инструкции, но ещё и уверенность в этом предсказании. В зависимости от степени уверенности мы принимали решение, использовать ли в задаче человеческий ресурс.

— Если модель уверена в ответе, скорее всего, задача простая и не требует помощи асессоров. С этими кейсами она нередко справляется даже лучше людей. Таких задач оказалось около половины от общей массы.
— Если модель не до конца уверена в ответе, привлекаем её вместо одного из трёх асессоров. Размер этой зоны — около 30%.
— Когда модель говорит, что совсем не уверена в решении, отдаём задачу трём сильным асессорам — как это происходит в стандартном процессе. Таких задач порядка 20%.

Результаты и планы

С помощью этого решения мы получили 105% качества и 60% экономии денег.

Мы уже используем его экспериментально в разметке обучающих и валидационных пулов для моделей ранжирования, но конечный мониторинг интегрального качества поиска пока остаётся на людях.

Планируем продолжать наращивать качество и запускаться на новых разметках. Также в долгосрочных планах — свести процесс к промптингу, когда ты не обучаешь модель, а описываешь задачу текстом. Так мы сможем более гибко менять инструкции разметок без переобучения модели.

Мы рассчитываем, что решение поможет нам перекинуть рутину на нейронки, а людям давать более интересные и сложные задачи.

ML Underhood
15 958 просмотров · 69 реакций Открыть в Telegram · Открыть пост на сайте
Как создаются трейлеры в Яндекс Музыке

Трейлеры дают возможность быстро познакомиться с новой музыкой, чтобы решить, стоит ли погружаться в неё дальше. Трейлеры в Яндекс Музыке есть у треков, альбомов, плейлистов и исполнителей. Фрагмент для трейлера каждого трека выбирается на основе предсказаний нейросети. И в ваших итогах 2024 года тоже играл трейлер из любимых треков. О том, как создаются такие трейлеры, нашему каналу рассказал старший разработчик из команды Музыки Николай Глазырин.

Чтобы сделать трейлер для трека, нужно совсем немного: определить его начало и конец 🙂 Мы хотим, чтобы в трейлер попал самый яркий и узнаваемый законченный фрагмент трека. А ещё — чтобы фрагменты разных композиций могли плавно перетекать друг в друга.

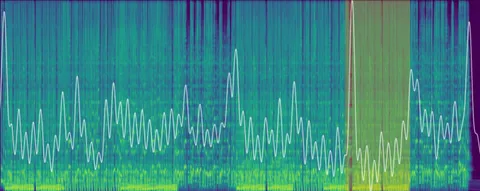
Мы обучили модель, которая умеет предсказывать в треке одновременно границы тактов, позиции битов (по-русски их обычно называют тактовыми долями) и наилучшие моменты для начала трейлера. Это небольшой encoder-only-трансформер на 0,5М параметров, который принимает на вход аудио с частотой дискретизации 22050 Гц, а на выходе с шагом в 1/75 секунды предсказывает три числа: вероятность найти в этот момент бит, границу такта и начало подходящего для трейлера фрагмента. Для обучения мы используем нашу нейромузыку, несколько открытых датасетов с границами тактов и тактовых долей, а также небольшой собственный датасет с размеченными вручную позициями начала трейлера.

При обучении модель осваивает одновременное решение этих трёх задач. Можно заметить, что вся разметка состоит из каких-то позиций внутри трека и привязана к его темпу. Поэтому очень помогает во время обучения аугментировать данные путем ускорения-замедления аудио, чтобы модель не привязывалась к каким-то более популярным темпам.

Выходы модели мы сглаживаем полосовыми фильтрами, чтобы избавиться от лишнего шума. Диапазон частот для каждого выхода подобран отдельно, чтобы соответствовать разумному. Например, темп музыки обычно находится в диапазоне 50–200 ударов в минуту, поэтому и тактовые доли должны встречаться с примерно такой же частотой. В сглаженных выходах уже очень просто определить локальные максимумы, которые и отмечают интересующие нас моменты времени.

Для начала трейлера мы выбираем момент с максимальным значением на соответствующем выходе модели. Если в треке есть вокал (что проверяется другой моделью), то выбираем такой момент, чтобы в трейлере тоже был вокал. Конец трейлера ставим ровно через 8 тактов после начала. А чтобы трейлеры можно было красиво смиксовать, добавляем ещё небольшой фрагмент трека (1 такт) прямо перед началом. На этом фрагменте во время воспроизведения громкость плавно поднимается, а на последнем такте — наоборот, плавно затухает, что даёт плавный переход между трейлерами разных треков.

Наша модель маленькая, и поэтому достаточно быстрая, и при необходимости может работать даже на CPU. Это важно, поскольку в нашем каталоге десятки миллионов треков и ещё десятки тысяч добавляются каждый день.

ML Underhood
2 889 просмотров · 25 реакций Открыть в Telegram · Открыть пост на сайте
Личные итоги года инженеров Яндекса — Александр Шишеня

2025 год вступил в свои права, поэтому можно хорошенько осмыслить, что произошло в 2024-м. Мы попросили ML-специалистов из Яндекса рассказать, какими были для них минувшие 12 месяцев. Первый на очереди — ведущий разработчик службы компьютерного зрения Александр Шишеня. Он рассказал о своих профессиональных успехах и планах.

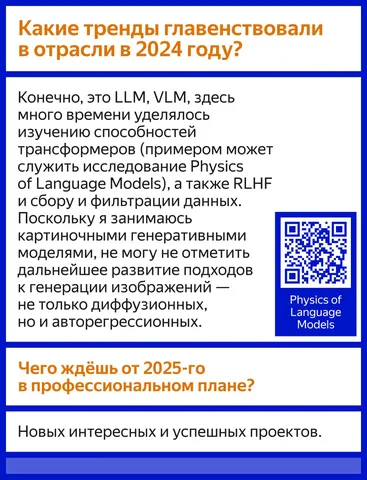
Александр упоминает статью Physics of Language Models.

А в канале CV Time вы сможете почитать о лучших статьях по мнению Александра. Там, кстати, ещё много интересного — подписывайтесь!

#YaMLpeople

ML Underhood
2 656 просмотров · 24 реакций Открыть в Telegram · Открыть пост на сайте
NPU в Яндекс Станции

В Станции Миди, Дуо Макс и ТВ Станции устанавливают нейронные процессоры (NPU). О том, зачем они нужны и с какими трудностями специалисты компании столкнулись при их использовании, нашему каналу рассказал ML-разработчик Александр Ростов.

Вычислительные ресурсы Станции ограничены, а если поставить в такое небольшое устройство слишком мощный процессор, он будет сильно нагреваться. Решение — NPU, который берёт на себя расчёты, связанные с моделями. Это чип, созданный специально для работы с нейросетями и ускорения ML-задач.

Так, до внедрения нейронного процессора разработчикам приходилось делать маленькие модели голосовой активации или споттерные модели — до миллиона параметров. Благодаря NPU в Станции теперь есть модели и на десятки миллионов параметров. Это позволило существенно прибавить в качестве, а также снизить число ложных срабатываний и случаев, когда колонка не реагирует на запрос пользователя.

По сути, NPU выступает в роли верификатора, проверяя, не допустила ли ложного срабатывания модель, работающая на CPU. Кроме того, NPU позволяет уменьшить CPU-модель и тем самым снять часть нагрузки с центрального процессора. Из-за этого вся система стала работать быстрее.

NPU работает со свёрточными нейросетями. Они учатся на GPU, затем конвертируются для применения с помощью библиотеки TensorFlow Lite для работы на NPU. Чип полностью используется споттерными моделями, однако на Станции Дуо Макс он отвечает и за распознавание жестов.

При тренировке NPU-моделей возникла проблема: стандартные датасеты оказались непригодны для обучения хорошей NPU-модели. Это было связано как со спецификой работы верификатора, так и с увеличением размера модели. CPU-модель работает на всём потоке звука, и количество негативных примеров преобладает над активациями. В свою очередь, верификатор работает только на активациях CPU-модели, поэтому видит в основном позитивные примеры.

Для снижения числа случаев, когда колонка не реагирует на пользователя, понадобилось «ухудшить» CPU-модель, чтобы она активировалась чаще. Так как обучающие данные изначально состояли из активаций более хорошей CPU-модели, это вызвало появление ложных активаций, которых верификационная модель не видела при обучении.

Чтобы решить эти проблемы, потребовалось собрать новый датасет, а также увеличить его в несколько раз.

ML Underhood
3 140 просмотров · 27 реакций Открыть в Telegram · Открыть пост на сайте
Яркие истории о разработках Яндекса в 2024 году

За минувший год ML’щики Яндекса сделали много интересного, и о многом мы писали в нашем канале. Перед вами небольшая ретроспектива — предлагаем вспомнить разработки и улучшения в продуктах за 2024 год.

Библиотека YaFSDP

Блиц-интервью с руководителем службы претрейна YandexGPT Михаилом Хрущевым. Узнали много интересного о библиотеке YaFSDP, которая ускоряет обучение больших языковых моделей.

Как устроен YandexART, YandexART 1.3 и генерация видео в Шедевруме

Сразу три поста о прекрасном — об искусстве. Первый — о мультимодальной модели для генерации изображений YandexART в целом. Второй — о новой версии нейросети, основанной на латентной диффузии, что позволяет здорово экономить вычислительные ресурсы. Третий пост вышел в сентябре — аккурат под костры рябин. В публикации речь идет об улучшенной генерации видео в Шедевруме. Рассказали, как она устроена и как обучали модель.

Как работает Нейро

Весной Яндекс запустил сервис для поиска ответов на вопросы, заданные на естественном языке — Нейро. Под капотом у него, разумеется, LLM. А как модель себя проявляет — читайте в этом кулинарном посте с сакраментальным вопросом: «А какие же щи без капусты?»

Алиса на казахском языке, локальный ASR в Яндекс Станции и эхоподавление

Три поста о голосовом ассистенте Яндекса. Первый рассказывает, как Алису учили говорить на казахском языке. Архитектура здесь схожа с той, что и у русскоязычного ассистента, однако есть свои тонкости. Подробно рассказали о них в самом лингвистически заряженном посте года.

Второй пост — о создании локальной системы автоматического распознавания речи в Станции. Технические возможности колонки накладывают на разработчиков ограничения, с которыми приходится мириться. Об этом (и многом другом) и рассказали.

Третий пост об эхоподавлении (AEC). Рассказываем, как оно устроено, а заодно о новом бета-датасете, на котором инженеры перебирали гиперпараметры, чтобы добиться улучшения качества.

OmniCast в погоде

OmniCast — новая технология, принятая на вооружение Яндекс Погодой. Она позволяет точно предсказывать осадки и циклоны, используя данные как с профессиональных, так и с любительских метеостанций.

Улучшенный фотоперевод

Осенью мы обновили фотоперевод — теперь понимать зарубежные мемы, распечатанные на бумаге (бывает и такое), совсем просто. Новая модель лучше выделяет семантические блоки, а переведённый текст стал больше похож на оригинальный благодаря алгоритму затирания. О том, что и как ещё изменилось — рассказываем в посте.

ML Underhood
2 958 просмотров · 22 реакций Открыть в Telegram · Открыть пост на сайте
🎄Эхоподавление у Алисы — как оно устроено и как улучшилось за год

Представим ситуацию. Яндекс Станция играет музыку, пока вы готовите новогодний стол. Очередное блюдо отправляется в духовку, и вам нужно узнать, на какое время ставить таймер. Вы спокойно спрашиваете у Алисы, а она отвечает даже несмотря на шум, который сама производит. Но как это работает? Ведь колонка небольшая, динамики находятся рядом с микрофонами. К просьбе от человека примешивается музыка, а сам звук постоянно отражается как от стен помещения, так и внутри самой колонки. Как же Станция поняла ваш запрос?

Всё дело в эхоподавлении (Acoustic Echo Cancellation, AEC). Небольшая модель внутри станции разделяет входящие аудиосигналы на фрагменты, а затем отфильтровывает их с помощью фильтра Калмана. Если во фрагменте есть активационная фраза, то Алиса войдет в режим ожидания команды. Здесь помогает и шумоподавление. Оно нужно, чтобы «отрезать» от активационной фразы посторонние шумы — например, голоса родни или стенания Ипполита из «Иронии судьбы» из телевизора.

В 2024 году AEC улучшилась. О том, что добавилось, и сопутствующих трудностях нашему каналу рассказал разработчик из команды улучшения качества звука Антон Порфирьев.

Во-первых, у Алисы появились быстрые команды. Благодаря им не нужно обращаться к ассистенту по имени, чтобы переключить или выключить песню. Внедрение этой возможности потребовало перебора параметров AEС, ведь нужно было сделать так, чтобы Алиса реагировала не только на своё имя, но и на обособленные команды вроде «тише» или «следующая». Работа над быстрыми командами помогла сделать систему эхоподавления в целом более эффективной.

Второе улучшение коснулось не только эхо, но и шумоподавления — AEC применяется как отдельно, так и после него. Раньше для обеих операций использовались одни и те же гиперпараметры, теперь — разные. Конфигурации подаются на отдельные каналы, и такое изменение дало прирост в качестве.

Ещё одно интересное нововведение — бета-датасет. Раньше у Яндекса был доступ только к «лабораторным» данным, записанным в специальной студии. Они не отражали реальную ситуацию полностью, ведь эхо и реверберация звука в лабораториях всегда примерно одни и те же. Новый датасет даёт модели возможность учиться на реальных случаях во всём их многообразии.

Датасет начали разрабатывать ещё в прошлом году, но внедрили в 2024-м. Этот набор собран из данных, полученных от бета-тестеров, у которых Станция логирует всё, что происходит за несколько секунд до фразы активации. Эти секунды отрезаются от записи и складываются с чистыми активациями, записанными в лабораторных условиях. Так получаются синтетические данные, которых легко можно получить очень много.

При этом здесь активационная фраза не так важна, ведь первостепенное значение играет именно эхо. Поэтому для разных записей бета-тестеров можно использовать одну и ту же запись активации из лаборатории. Разница в объёмах датасетов значительная: если лабораторный состоит из примерно 5 тысяч записей, то бета-датасет — из порядка 50 тысяч. На получившемся наборе и перебирали гиперпараметры модели, что дало значительный прирост качества.

Вот так работает эхоподавление в Яндекс Станции. Напоследок, поздравляем вас с наступающим Новым годом! А команда ML Underhood уходит на каникулы, чтобы в январе вернуться с новыми интересными историями из мира машинного обучения.

ML Underhood
2 754 просмотров · 47 реакций Открыть в Telegram · Открыть пост на сайте
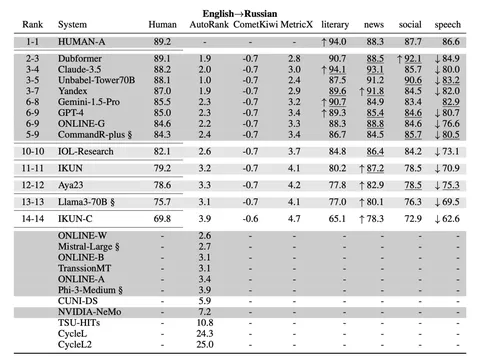
Как модель перевода от Яндекса вошла в топ-5 на конкурсе в рамках конференции WMT

В последний год у Яндекса появилась хорошая LLM для перевода. А насколько хорошая мы решили проверить на соревнованиях, которые прошли в рамках девятой Конференции по машинному переводу (WMT). По итогам модель Яндекса заняла пятое место из 14.

Речь идёт о модели, которая сейчас доступна всем в видеопереводе. Почему именно она? Всё дело в условиях соревнований. Для перевода там давали документы с HTML-структурой, поэтому и модели-участники должны были поддерживать её. У части документов была озвучка, которой позволяли воспользоваться — то есть сперва распознать речь, а уже затем перевести её.

Организаторы стремились к тому, чтобы на конкурсные тексты невозможно было заранее обучить модель. Это значит, что использовали весьма редкие документы.

Специальную модель для WMT в Яндексе не делали, а заработанное пятое место связывают сразу с несколькими факторами. Во-первых, это переход от перевода отдельных предложений к переводу целых параграфов, что позволило учитывать контекст, а значит — улучшить итоговый результат.

Важно и то, что модель Яндекса училась на перефразах. Специалисты брали уже переведённое автоматикой предложение и просили изменить его так, чтобы перевод был больше похож на человеческий. На этих перефразах, в частности, и обучали модель. Кроме того, модель Яндекса умеет сохранять структуру оригинальных размеченных документов.

Вероятно, что модель Яндекса — самая маленькая из тех, кому удалось попасть в топ-5. Остальные конкурсанты представляют собой большие мультилингвальные LLM. Наша же ориентирована на пару языков русский и английский.

Победителя определяли с помощью оценки человеком. Однако для отбора конкурсантов использовали LLM-as-a-Judge-метрику — MetricX от Google.

ML Underhood
2 609 просмотров · 27 реакций Открыть в Telegram · Открыть пост на сайте
Суцкевер на NeurIPS: хайлайты

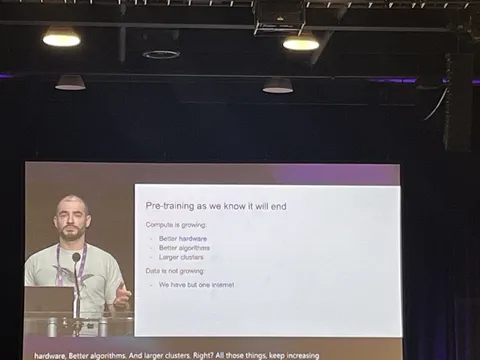
Доклад Ильи Суцкевера на NeurIPS уже разобрали на цитаты. Больше всего обсуждают идеи о росте агентности, конце претрейна и закона масштабирования. Нам удалось послушать доклад на конференции — делимся моментами, которые показались важными.

Нерезиновые данные
Претрейна на данных из интернета скоро не будет — всё, что можно, уже собрали, а синтетика просто копирует старое. Будущее за уникальными проприетарными датасетами, а успех моделей будет зависеть не от их размера, а от качества данных, на которых они обучаются.

Конец scaling law
Больше не работает scaling law, который до сих пор точно предсказывал рост качества моделей при увеличении данных и вычислений. Но это не значит, что прогресс остановится: как с законом Мура, новые этапы развития технологий откроют другие способы оптимизации.

Будущее за агентами (умными)
Сейчас модели чаще всего повторяют то, что уже видели на этапе обучения. Агенты же смогут самостоятельно анализировать ситуацию и придумывать новые стратегии. Точного рецепта для создания таких агентов пока нет, но Илья уверен, что это вопрос времени.

Интуитивность и непредсказуемость
Будущее будет связано с самосознанием систем. Пока что моделям не хватает умения находить нестандартные решения, они опираются на заранее заложенные шаблоны. Когда ИИ научится рассуждать по-настоящему, системы станут интуитивнее и одновременно непредсказуемее.

Эволюция как подсказка для ИИ
Идея в том, что ИИ может развиваться по принципам природы: адаптироваться, «мутировать» и улучшаться. Илья провёл аналогию между развитием интеллекта у животных и масштабированием моделей. Генетические алгоритмы уже используют для оптимизации архитектур, в будущем модели смогут разрабатывать такие алгоритмы сами.

В конце доклада Илья сказал: “All kinds of stuff is possible” — уже распечатали и повесили этот слайд в офисе.

ML Underhood

#YaNeurIPS
2 658 просмотров · 26 реакций Открыть в Telegram · Открыть пост на сайте
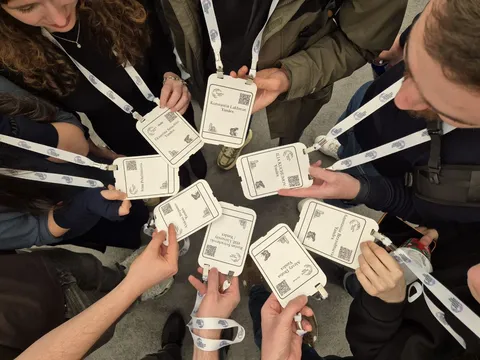
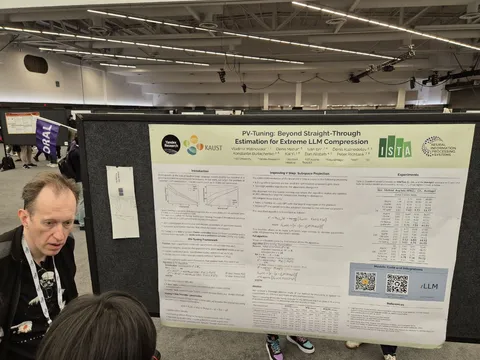
Ещё немного атмосферных фото и видео

⚪Команда Яндекса: встреча у стенда со статьёй.
⚪Наша первая статья (PV-Tuning: Beyond Straight-Through Estimation for Extreme LLM Compression).
⚪Аншлаг на докладе Fei-Fei Li (From Seeing to Doing: Ascending the Ladder of Visual Intelligence).
⚪Масштабы и пространства конференции.
⚪Новогодний робот на стенде Booster Robotics.

ML Underhood

#YaNeurIPS
1 763 просмотров · 23 реакций Открыть в Telegram · Открыть пост на сайте
Атмосфера NeurIPS: стенды участников

На конференции представлены стенды как гигантов, так и малоизвестных компаний. Показываем те, которые привлекли наше внимание.

⚪Amazon — основной акцент сделали на демонстрации технологий: посетители могут увидеть и попробовать решения в действии.

⚪Alibaba Cloud — представляют себя как полнофункциональную платформу для инженеров.

⚪Writer — фокус на оптимизации рабочих процессов для корпоративных клиентов.

⚪Lambda — продвигают Private Cloud, представлены физические серверные стойки и оборудование.

⚪Meta AI* — показывают Llama и демо других своих продуктов.

*Meta признана экстремистской организацией, а Facebook и Instagram запрещены на территории РФ

ML Underhood

#YaNeurIPS
1 631 просмотров · 20 реакций Открыть в Telegram · Открыть пост на сайте
Удаление облаков, трекинг антилоп и другие кейсы с NeurIPS

Продолжаем следить за NeurIPS 2024. Сегодня на связи Алексей Друца, Director, Technology Adoption at Yandex Cloud. Делимся его заметками о туториалах и статьях второго дня конференции.

Первым привлёк внимание туториал Evaluating Large Language Models — Principles, Approaches, and Applications о базовых подходах к оценке LLM. Особенно полезно ознакомиться тем, кто сталкивается с острым желанием контрагентов решить все проблемы за счёт получения модели идеального качества. Мы-то с вами знаем, что копать надо ещё и в сторону продуктовых метрик. Подробнее об этом туториале — в канале Душный NLP.

Туториал Opening the Language Model Pipeline: A Tutorial on Data Preparation, Model Training, and Adaptation от ребят из Ai2. Базовый обзор того, как готовится LLM, из каких этапов состоит пайплайн её построения. Подробно описано, как работать с данными для обучения, обрабатывать, вычищать, принимать решения по ним. Разбираются этапы предобучения и постобучения.

А ещё — несколько статей с увлекательными и местами неожиданными кейсами.

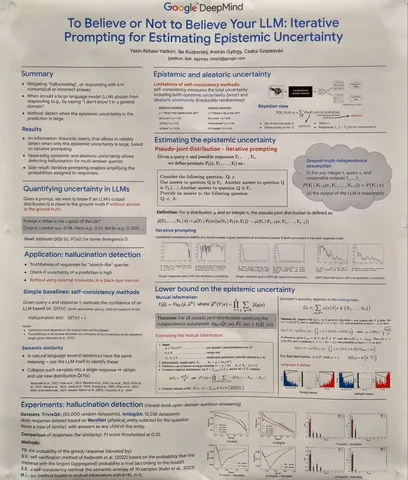
To Believe or Not to Believe Your LLM: IterativePrompting for Estimating Epistemic Uncertainty
Авторы предложили метрику для оценки уровня неопределённости LLM и того, насколько ей можно доверять. Метод основан на итеративных промптах без привлечения внешних данных.

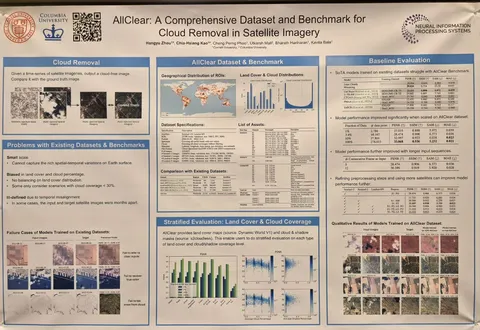
AllClear: A Comprehensive Dataset and Benchmark for Cloud Removal in Satellite Imagery
Кейс с датасетом об удалении облаков со спутниковых снимков. Исследователи определяют, что происходит под облаком, за счёт данных в других диапазонах спектра. Потенциально полезная вещь для тех, кто занимается картами. Облака — те что на небе, а не вычислительные.

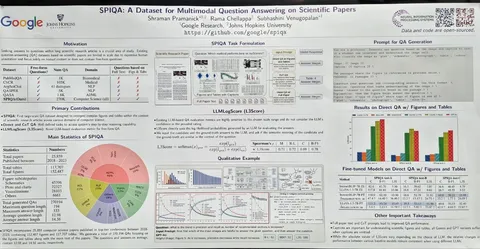
SPIQA: A dataset for multimodal question answering on scientific papers
Датасет по мультимодальным вопросам и ответам из научных статей. Пример работы со сложными текстами, специфической терминологией и задачей поиска ответа. Особенность датасета — наличие картинок и таблиц (которые часто встречаются в научных статьях), а главное — вопросов и ответов по их содержанию. Прогнав несколько моделей и разных вариаций промтов, делают вывод, что использование полного текста статьи и приемов Chain-of-Thoughts приводит к значительно более высокому перформансу модели на датасете.

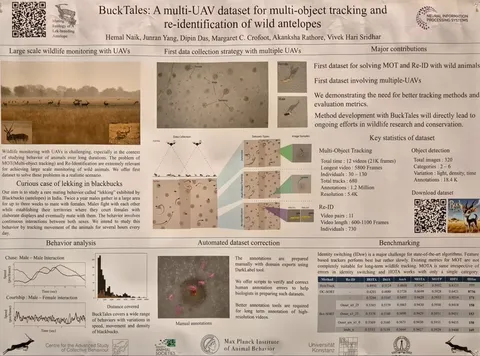
BuckTales: A multi-UAV dataset for multi-object tracking and re-identification of wild antelopes
Авторы с помощью дронов и искусственного интеллекта создали набор данных для изучения диких антилоп. Он позволяет отслеживать движения множества животных одновременно и распознавать каждую особь в сложных условиях дикой природы.


Контент с NeurIPS продолжает залетать прямиком в вашу ленту. Будем на связи!

ML Underhood

#YaNeurIPS
1 722 просмотров · 20 реакций Открыть в Telegram · Открыть пост на сайте
Первый день NeurIPS: интересные доклады и немного инсайтов

На конференции сейчас находится Катя Серажим, руководитель управления качества поиска. Она поделилась впечатлениями от выступлений и поговорила с некоторыми участниками. Слово Кате.

Понравился доклад от Waymo: AI for Autonomous Driving at Scale. Они обзорно рассказали про свой стек: используют трансформеры, пытаются создать собственную Foundation-модель для автономных машин и интегрируют VLM для разметки. Докладчик, правда, больше «лицо» проекта, а за подробностями отсылает к команде.

Интересный туториал Opening the Language Model Pipeline: A Tutorial on Data Preparation, Model Training, and Adaptation — с практическими советами по обучению LLM. Любопытно, что некоторые их выводы сходятся с нашими: например, 10k примеров для SFT (Supervised Fine-Tuning) и 100k для обучения с подкреплением по вознаграждению (Reward) оказались разумными цифрами.

А ещё пообщалась на экспо с исследователями из разных компаний и собрала немного любопытного:

⚪️Ресёрчер из Facebook поделился, что компания всё активнее вкладывается в обучение с подкреплением (RL). Считают, что задача претрейна уже решена, и теперь важно оптимизировать последовательность обучения (RS, DPO, PPO). Используют синтетику, меняя инстракты: например, из диалога о физике «делают» диалог о биологии.

⚪️А вот Google, как оказалось, по-прежнему ориентированы на улучшение результатов через претрейн. Говорят, что их новая модель не уступает на некоторых бенчмарках o1 как раз благодаря качественному предобучению.


Продолжаем следить за NeurIPS, будем делиться самым интересным.

ML Underhood

#YaNeurIPS
1 578 просмотров · 37 реакций Открыть в Telegram · Открыть пост на сайте
NeurIPS 2024 в Ванкувере: первые цифры и впечатления

Вчера стартовала NeurIPS, одна из самых крупных и значимых конференций по машинному обучению. Для затравки — несколько интересных цифр:

⚪16 500 зарегистрированных участников (рекорд для конференции)
⚪4 037 статей основной секции
⚪460 статей по датасетам и бенчмаркам

А вот и впечатления первого дня.

Костя Лахман:
Бесконечная очередь на регистрацию, которая, не останавливаясь, идёт змейкой. Кажется, на самом деле, это лента Мёбиуса, и нас обманывают.


Катя Серажим:
Если говорить про тренды, было уже два доклада с упоминанием специализированных Foundation Models: для автономного транспорта и e-commerce.


Настя Беззубцева:
В Exhibition Area крайне оживлённо. Провела там около двух часов — успела обойти только треть стендов и пообщаться с некоторыми участниками. Например, спросила у HR Tesla, дают ли они имена своим роботам — к сожалению, нет.


В следующих постах продолжим делиться инсайтами и трендами!

ML Underhood

#YaNeurIPS
1 715 просмотров · 33 реакций Открыть в Telegram · Открыть пост на сайте
iCD — метод быстрого редактирования изображений

Мы уже рассказывали о восьми статьях, которые Yandex Research представит на конференции NeurIPS. Сегодня подробнее остановимся на одной из них, посвящённой методу инвертируемой дистилляции (Invertible Consistency Distillation, iCD).

Современные модели хороши в генерации изображений, но когда дело касается редактуры — могут возникать проблемы. Основная проблема заключается в необходимости точной инверсии: кодирования изображения в латентное пространство и последующей реконструкции, которая должна сохранить исходные детали и при этом интегрировать текстовые запросы. Существующие методы редактирования требуют больших вычислительных ресурсов и значительного времени — вплоть до 50 и более шагов инференса.

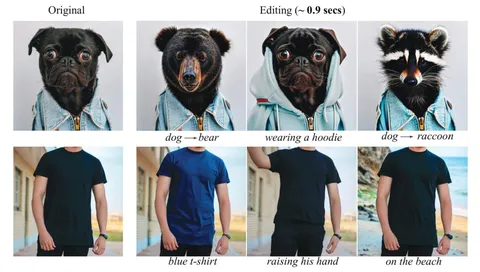
iCD призван решить этот недостаток. Суть метода заключается в создании двунаправленных моделей: одна из них кодирует изображения в латентное пространство, другая — декодирует их обратно. Таким образом, можно довольно быстро отредактировать картинку. Скажем, добавить на фотографию какой-нибудь объект или заменить собаку на медведя или енота.

Чтобы улучшить соответствие между текстовым запросом и сгенерированным изображением используют технику Dynamic Classifier-Free Guidance (Dynamic CFG). На начальных этапах преобразования, когда уровень шума высок, CFG не работает, что способствует разнообразию генераций. На поздних этапах CFG работает, обеспечивая более точное соответствие текстовому промпту.

Благодаря всему этому, редактирование изображения с использованием метода iCD занимает всего 7–8 шагов инференса.

ML Underhood
2 123 просмотров · 21 реакций Открыть в Telegram · Открыть пост на сайте
PPO для YandexGPT 4 Lite

Недавно инженеры Яндекса использовали онлайн-обучение с подкреплением для YandexGPT 4 Lite. На файнтюне этой модели использовались как DPO, так и PPO. Павел Темирчев, один из разработчиков команды алаймента Яндекса, рассказал нам, как внедряли эти методы.

Proximal Policy Optimization (PPO) — метод, который предполагает применение размеченных асессорами данных для обучения reward-модели. Это итеративный и весьма трудоёмкий процесс. Сложность, в частности, заключается в том, что модель должна прямо во время обучения генерировать ответы. Кроме того, необходимо хранить в памяти GPU не только обучаемую, но и ряд вспомогательных моделей. Например, value-модель, которая содержит информацию о наградах и используется в алгоритме как бейзлайн.

Важной частью внедрения PPO для обучения YandexGPT 4 Lite стало создание правильной инфраструктуры — от этого зависит примерно 50% успеха. Кроме того, была проведена большая работа с обучающим множеством. Инженеры перебрали разные варианты того, на чём можно обучать модель.

Также было важно не дать модели переобучиться под reward-модель. Для этого существует практика штрафа, который накладывается, если обучаемая модель слишком далеко ушла от SFT. В Яндексе попробовали применить разные варианты штрафов, чтобы выбрать наиболее подходящий.

Из хаков использовали, например, нормализацию advantage, то есть разницы награды за ответ и средней награды. Этот трюк позволяет получить более стабильную сходимость взамен теоретических гарантий.

На алайменте YandexGPT 4 Lite проводили сперва онлайн RL — PPO, а затем DPO. Комбинация методов позволила получить хорошие результаты, которые превосходят полученные от каждого метода отдельно.

Делитесь своими мыслями о PPO и DPO в комментариях!

ML Underhood
2 608 просмотров · 23 реакций Открыть в Telegram · Открыть пост на сайте
Что везём на NeurIPS — часть 2

В продолжение предыдущего поста — ещё четыре статьи, которые Yandex Research представит на конференции.

Invertible Consistency Distillation for Text-Guided Image Editing in Around 7 Steps

Авторы стремятся к тому, чтобы научить дистиллированные модели text-to-image-диффузии способности эффективно редактировать реальные изображения. Исследователи представляют инвертируемую дистилляцию (invertible Consistency Distillation, iCD). Она позволяет добиться качественного редактирования всего за 7–8 шагов инференса.

Rethinking Optimal Transport in Offline Reinforcement Learning

Обычно в офлайн-обучении с подкреплением данные предоставляются разными экспертами, и некоторые из них могут быть неоптимальными. Чтобы получить эффективную политику, необходимо «сшить» наилучшие действия из набора данных. Для решения этой задачи авторы переосмыслили офлайн-обучение с подкреплением как задачу оптимального транспорта. На основе этого представили алгоритм, направленный на нахождение политики, которая сопоставляет состояния с частичным распределением наилучших действий экспертов для каждого заданного состояния.

The Iterative Optimal Brain Surgeon: Faster Sparse Recovery by Leveraging Second-Order Information

В статье авторы объединяют два известных подхода получения точных разреженных сетей — Iterative Hard Thresholding (IHT) и Optimal Brain Surgeon (OBS) — в единую сущность Iterative Optimal Surgeon, наследующую сильные стороны обоих подходов с теоретическими гарантиями. Эффективность предложенного алгоритма валидируется на моделях для задач компьютерного зрения и больших языковых моделях.

Lower Bounds and Optimal Algorithms for Non-Smooth Convex Decentralized Optimization over Time-Varying Networks

В статье рассматривается задача минимизации суммы выпуклых функций, хранящихся децентрализованно на вычислительных узлах, соединённых коммуникационной сетью. Авторы сосредотачиваются на самой сложной и недостаточно изученной ситуации, когда целевые функции негладкие, а связи в сети могут меняться со временем. Для решения данной задачи предлагается численный алгоритм с наилучшей известной на данный момент теоретической скоростью сходимости, а также доказывается, что достигнутая скорость сходимости не может быть улучшена и является оптимальной.

ML Underhood
2 913 просмотров · 23 реакций Открыть в Telegram · Открыть пост на сайте
Что везём на NeurIPS — часть 1

В декабре пройдёт конференция NeurIPS, где учёные из исследовательского подразделения Яндекса — Yandex Research — представят целых восемь статей. В двух постах расскажем, какие именно.

SpecExec: Massively Parallel Speculative Decoding for Interactive LLM Inference on Consumer Devices

SpecExec — простой метод параллельного декодирования, оптимизированный для работы с более крупными драфтовыми моделями, что позволяет генерировать до 20 токенов за итерацию целевой модели. Он берёт наиболее вероятные продолжения токенов из черновой модели и создаёт кэш в форме дерева для целевой модели, которое затем проверяется за один проход. Метод особенно полезен для значительного ускорения генерации при использовании больших языковых моделей в режиме офлодинга, где показывает ускорение до 15–20x. Подробнее о SpecExec вы можете почитать в этом посте.

PV-Tuning: Beyond Straight-Through Estimation for Extreme LLM Compression

Статья о сжатии больших языковых моделей, таких как LLaMA 3 и Mistral. Авторы предлагают новый метод — PV-Tuning, который позволяет дообучать уже сжатые (квантованные) веса нейросети, чтобы лучше исправлять ошибки квантизации. Это особенно важно при экстремальном сжатии в 1–2 бита на параметр, когда обычные методы квантования полностью ломают модель. За счёт более эффективного (и теоретически обоснованного) дообучения дискретных квантованных весов PV-Tuning позволяет достичь оптимума по Парето, например, для моделей семейства LLaMA-2 при 2 битах на параметр — то есть, это первое 2-битное сжатие таких моделей, которое имеет смысл на практике. Подробнее о методе читайте в этом посте.

Sequoia: Scalable, Robust, and Hardware-aware Speculative Decoding

Sequoia — алгоритм спекулятивного декодирования, использующий оптимизированные статические асимметричные деревья для спекуляции. Значительно превосходит методы с симметричными деревьями, показывая ускорение в диапазоне 2–4х для Llama-подобных моделей и до 10x с использованием офлодинга.

Challenges of Generating Structurally Diverse Graphs

Статья о генерации структурно разнообразных графов. Авторы рассматривают и сравнивают несколько алгоритмов оптимизации разнообразия: подходы, основанные на стандартных моделях случайных графов, оптимизацию локальных графов, генетические алгоритмы и нейрогенеративные модели.

ML Underhood
2 628 просмотров · 25 реакций Открыть в Telegram · Открыть пост на сайте
Хотите знать ещё больше об ML?

Собрали каналы о машинном обучении — хорошие, разные и от инженеров из Яндекса.

🔥 Душный NLP — здесь специалисты из Яндекса разбирают статьи о новых моделях и методах их обучения.

👍 Рекомендательная — канал о рекомендательных системах, где освещают тенденций и обсуждают новости.

👀 CV Time — канал о компьютерном зрении и самых интересных технологиях, связанных с ним.

🖍 ML Underhood — вы находитесь здесь рассказываем о закулисье ML и личном опыте инженеров.

Подписывайтесь, чтобы всегда быть в курсе трендов мира ML!
3 495 просмотров · 27 реакций Открыть в Telegram · Открыть пост на сайте
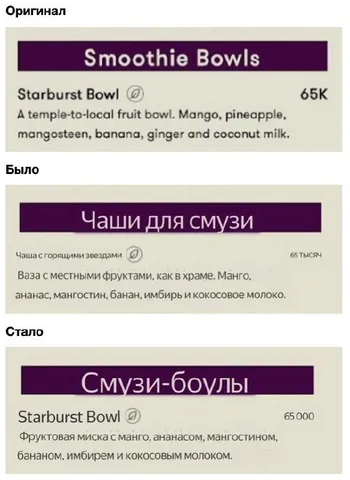
Улучшенный фотоперевод от Яндекса

Яндекс обновил функцию фотоперевода — новая версия уже доступна в Браузере и Переводчике. Коротко расскажем, как всё устроено с точки зрения ML.

В вебе, а также в приложениях для iOS и Android, в Яндекс Переводчике применяется transformer-based модель перевода, которая получила рост качества в 10%. А в Яндекс Браузере и Умной камере используется модель перевода на основе YandexGPT. По метрике оценки качества её перевод улучшился до 79 баллов из 100. Человек по той же метрике получает 85 баллов.

Обновили и модель компьютерного зрения. Теперь модель лучше выделяет семантические блоки: абзацы, предложения, пункты в списках и так далее. Благодаря этому перевод становится точнее, а визуализация — лучше.

А ещё инженеры из Яндекса реализовали алгоритм затирания оригинального текста, чтобы фон выглядел так же, как и в оригинале. Для реализации затирания использовали алгоритм PatchMatch, а для повышения контраста — APCA (Advanced Perceptual Contrast Algorithm). Также применили Yandex Sans Text Cond с Medium начертанием и добавили контрастную полупрозрачную обводку вокруг букв. В результате чего сильно выросли все метрики по аспектам визуализации (читаемость, подбор фона, размер шрифта).

А что в итоге? Обновлённый фотоперевод обошёл Google Lens в качестве (50% против 39%), читаемости (90/100 против 86/100), соответствии размера текста (91/100 против 79/100) и подбора фона (88/100 против 43/100).

Такой вот новый фотоперевод. Делитесь в комментариях мнением о нём!

ML Underhood
2 836 просмотров · 40 реакций Открыть в Telegram · Открыть пост на сайте