Как прошёл первый день ICRA 2026 в Австрии

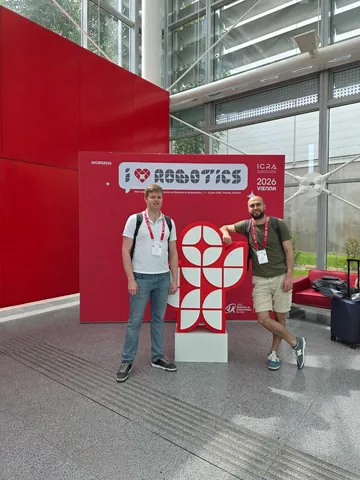
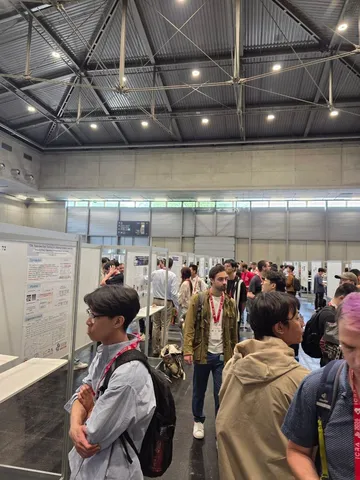
Не успели инженеры Яндекса стряхнуть бразильскую пыль с сапог после ICLR, как в Вене стартовала ICRA 2026 — одна из главных мировых конференций по робототехнике и автономным системам. Наши коллеги уже на месте, а это их впечатления от первого дня.

Максим Спорышев, руководитель службы поведения и предсказания движения в Автономном транспорте Яндекса:

Один из основных воркшопов в первый день был целиком посвящён теме reinforcement learning в робототехнике. Рассказывали о разных вариантах претрейна на демонстрационных данных (IL, Offline RL), как делать ризонинг в embodied-моделях, sim2real/real2sim, world modelling. Основные кейноуты, постеры и выставки начинаются во второй день, чего мы очень ждём!


Егор Волков, разработчик группы претрейна модели планирования движения в Автономном транспорте Яндекса:

На воркшопе по автономным автомобилям, организованном Мюнхенским университетом, рассказали о новых симуляторах для обучения World Engine и AlpaSim, а также поделились планами выложить в опенсорс весь пайплайн автономного автомобиля.

Другой интересный воркшоп первого дня — о предсказании траекторий пешеходов. Обсудили ключевую сложность задачи: движение пешехода зависит от взаимодействия с машинами и того, что он считает безопасным. К сожалению, прорывных решений проблемы пока не предложили.

В целом, поражает количество компаний и стартапов, которые специализируются на роборуках, манипуляторах и прочем. Масштаб интереса к этой области огромен.


Впереди ещё несколько дней конференции. Технические разборы и подборки интересных работ будем публиковать в @DriverNotFound.

#YaICRA26

ML Underhood
2 134 просмотров · 49 реакций Открыть в Telegram · Открыть пост на сайте
Как мы научили модель понимать структуру архивных записей

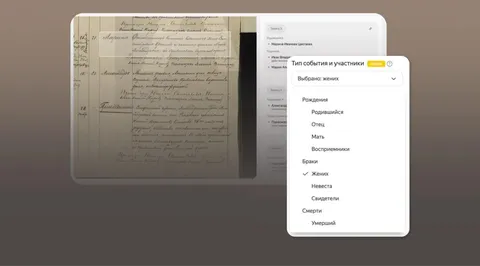
В Поиске по архивам появилась новая модель, которая не только распознаёт текст, но и извлекает связи между людьми — например, определяет, кто в документе отец, мать, жених, невеста, свидетель и прочее. Это умение очень важно, чтобы действительно помогать пользователям находить родственников.

Дарья Виноградова, руководитель команды универсального применения компьютерного зрения в Яндексе, и Анна Сидорова, главный разработчик распознавания архивов, рассказали на Хабре, почему универсальные VLM-модели не подошли для этой задачи и как удалось перейти от распознавания текста к извлечению структуры и смысла из документов.

Как было раньше

Прошлая версия системы представляла собой классический OCR-пайплайн. Детектор находил на скане строки, OCR-модель распознавала их по отдельности, а другая модель собирала в текстовые блоки.

Поиск работал в основном по текстовым совпадениям. Из-за этого вместе с нужными данными в выдачу попадали имена священников, номера записей, служебные пометки и другие нерелевантные части документа. Со временем проблемы стали чаще возникать на уровне структуры документа — из-за разбиения текста на строки и последующей склейки.

Как модель научили понимать структуру документов

В новой версии OCR остаётся отдельным этапом, но сам пайплайн строится уже вокруг структуры документа.

По сути, перед нами стояла KIE-задача (Key Information Extraction) — нужно было по изображению документа извлекать ключевую информацию о людях и их ролях. Но довольно быстро стало понятно, что работать со страницей целиком не получится. Типичный архивный скан имеет размер больше 2500 пикселей по стороне, содержит сразу несколько записей, а суммарно в них может упоминаться до 35 человек. Такой объём информации слишком большой и для модели, и для обучения. Поэтому мы решили сначала находить на странице отдельные записи — о рождении, браке или смерти — а уже потом извлекать информацию о людях из каждой выделенной области.


Для этого используют дообученную VLM‑модель Alice AI. Она получает изображение записи вместе с текстом от OCR и извлекает из документа структуру и связи между людьми. Ключевая метрика — доля людей, которых затем можно корректно найти по ФИО в сервисе. По ней модель достигает качества 90,5% на всех типах архивных записей.

Как усовершенствовали OCR

Параллельно команда перешла от строкового OCR к блочному. Так удалось убрать целый этап сборки строк в блоки, сократить количество моделей в пайплайне и уменьшить объём дополнительного процессинга при обработке сканов.

Однако переход к блочной архитектуре сильно усложнил требования к детектору. Если раньше ошибка означала, что какие-то строки просто плохо склеятся, то теперь модель рисковала целиком потерять нужный фрагмент документа.

При этом сами блоки оказались очень разными по размеру: модель могла получить как маленький кусок с одним словом, так и огромный фрагмент на много строк. Из-за этого команде пришлось отдельно дорабатывать энкодер и оптимизировать токенизацию — иначе обработка больших блоков становилась слишком дорогой по вычислениям.

После перехода на новый OCR-пайплайн recall распознавания вырос до 93,2% на основной выборке и до 88,1% — на сложной.

Детали реализации и сложные кейсы распознавания вы найдёте в полной версии статьи.

ML Underhood
4 042 просмотров · 46 реакций Открыть в Telegram · Открыть пост на сайте
Немного о погоде в Рио

Вернее, не в Рио, а на прошедшей ICLR. И не то чтобы о погоде — о статьях, связанных с её прогнозированием. Руководитель группы ML в Яндекс Погоде Пётр Вытовтов поделился мыслями о трендах и занятными публикациями на тему. Слово Петру.

Первое, что я заметил, ещё до приезда в Рио, что в этом году на ICLR было заметно больше погодных работ, чем раньше. С одной стороны, это хорошо, что область погодного ML развивается. С другой — конкуренция растёт, и надо постоянно больше и качественнее работать, чтобы успевать за отраслью и сохранять лидирующие позиции. Основная масса работ была по двум направлениям: foundation-погодные модели и наукаст.


А теперь к самим статьям.

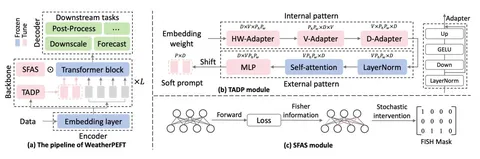
Task-Adaptive Parameter-Efficient Fine-Tuning for Weather Foundation Models

Есть такое направление, как тюнинг fountation-погодных моделей под различные downstream-задачи. Это связано с тем, что для финальной решаемой задачи не всегда необходимо моделировать с хорошим качеством всю атмосферу, но при этом всё-таки хочется учитывать эту информацию. Поэтому можно подтюнить модель под необходимый параметр и немного принебречь качеством остальных.

Здесь авторы предлагают не тюнить модель целиком, а использовать, так называемый, обучаемый soft prompt, чтобы говорить модели, какую именно задачу она должна сейчас решать. Утверждается, что модель хорошо учится с ним работать. Авторы проверяли работу своего подхода поверх модели Aurora от Microsoft и получили хорошие результаты для задач super-resolution, прогноза осадков и постпроцессинга ансамблевых прогнозов.

Идейно подход выглядит интересно, но пока он проверялся только на грубом разрешении сетки, и не совсем понятно как этот подход себя покажет на продовых моделях.

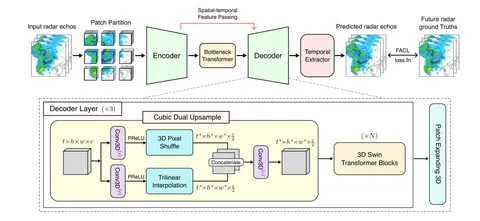
Extreme Weather Nowcasting via Local Precipitation Pattern Prediction

Если рассматривать наукаст, как задачу перемещения существующих осадков, то она — по большей части — уже решена. Но есть две открытых проблемы в этой области: возникновение новых осадков и прогноз экстремальных значений. Здесь авторы концентрируются на второй подзадаче.

Они делают предположение, что одна из причин плохого восстановления сильных осадков — структура декодера, и предлагают его модификацию. При этом в работе сравнивают разные варианты того, как можно делать апсемплинг картинки в процессе декодирования. Интересно, что авторы — одни из немногих, у которых Фурье-лосс для задачи наукаста заработал лучше стандартно используемых MSE и MAE.

Авторы проверялись на стандартных датасетах SEVIR и MeteoNet, а также на их собственном KMA, который должен быть публично доступен. Не во всех сетапах удалось получить SotA, но картинки выглядят заметно чётче по сравнению с аналогами.


#YaICLR26

ML Underhood
2 660 просмотров · 20 реакций Открыть в Telegram · Открыть пост на сайте
Ещё несколько мыслей про ICLR 2026

Конференция, которая закончилась в Рио, оставила после себя много впечатлений и любопытных мыслей. Ими сегодня поделится с нашим каналом СТО поисковых сервисов и ИИ Яндекса Алексей Гусаков.

RL сейчас становится одним из самых дорогих и плохо предсказуемых этапов после претрейна — особенно, если много генерировать длинные reasoning/tool-calling-траектории. Допустим, мы используем GRPO: берём батч запросов, и для каждого сэмплируем G траекторий/ответов. Для них считаем reward, а advantage определяется относительно остальных ответов на тот же запрос.

Если запрос слишком лёгкий или слишком сложный, все G ответов могут получить одинаковый reward — например, все правильные или все неправильные. Тогда такой пример даёт мало полезного RL-сигнала. Помимо этого, цепочки генерировать дорого, а длинные — очень дорого. Несколько классов идей о борьбе с этим:

1. Curriculum — идея не новая. Давайте растить сложность запросов в процессе улучшения модели. Есть много вариантов, как это делать. Один из них — использовать трансформерное предсказание сложности и бандитов. Думаю, конкретная реализация не так важна, главное, что при смешивании множества RL-сред в одном обучении единой модели нужно иметь хорошие мониторинги доли успехов по каждой задаче и бороться, если возникает проблема.

2. Генерировать роллауты не каждый раз с нуля, а начинать с префиксов предыдущих. Тогда можно получить больше бит информации на единицу компьюта и получить дерево траекторий. Для внутренних вершин дерева можно подсчитывать статистику успехов и использовать для process reward.

3. В случае, если основной тул в цепочках — это web search, то можно отдельно оценивать, насколько очередное добавление в инфоконтекст полезно: нельзя ли было дать ответ без него и продвинуло ли оно к правильному ответу (observation reward).

Комбинация второго и третьего подходов заставила меня вспомнить AlphaZero, где модель предсказывает распределение по возможным ходам P и оценку позиции Value. Затем Tree Search строит дерево и получает более информативную статистику по ходам, после чего модель учится приближать результаты этого Tree Search.

В LLM-случае «ход» — это не дискретный шахматный ход, а кусок reasoning плюс очередной tool call, плюс observation, и пространство ходов не только больше, но и гораздо менее структурированное. Напрямую не используешь, но точно интересно подумать над экспериментами, где после генерации скольки-то роллаутов из позиции переранжируем их по process и observation reward.

4. Scaling recipes плюс scaling laws для RL. Тема неплохо изучена для претрейна. В Meta* считают, что у них работает для RL. Scaling там устроен по-другому — имеет форму сигмоиды и можно экстраполировать качество с малых запусков на более крупные. Если правда работает, точно надо использовать — особенно, когда смешиваем несколько RL-сред для понимания, сколько нужно тратить компьюта на оптимизацию каждой.


И немного о том, как всё (или почти всё) успеть на конференции.

Чтобы повысить продуктивность, к каждому дню нужно готовиться минимум по паре часов, составляя с LLM-ассистентом план того, что хочешь посетить. Помогают промпты в стиле «Завтра утренняя постер-сессия на ICLR, интересны такие-то темы, в основном топовые лабы, раньше были интересны такие-то работы. Что посмотреть?» Дальше фильтруешь, просишь отсортировать постеры, часть просишь удалить, а где-то предлагаешь добавить. Затратно, но зато не просто бродишь, читая бесконечные названия статей.


#YaICLR26

ML Underhood
__
Компания Meta признана экстремистской; её деятельность в России запрещена.
2 239 просмотров · 33 реакций Открыть в Telegram · Открыть пост на сайте
ICLR 2026: подборка трендов от CTO Яндекс Поиска

Екатерина Серажим рассказала об агентских системах и связанных с ними подходах к обучению и оптимизации моделей.

Отношение к агентским системам стало более «взрослым»: не как к набору эвристик вокруг модели, а как к полноценной инженерной системе, где каждый компонент заслуживает внимания и постепенно становится отдельным объектом оптимизации.

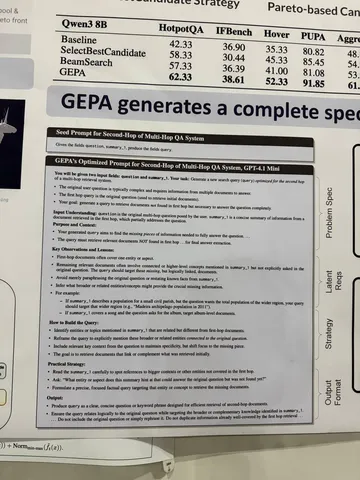
1. Написание промптов превращается в ML-задачу

Понравилась линия работ вроде GEPA и ACE. Главная мысль: промпт — это уже не «текст, который хорошо написал человек», а оптимизируемый компонент системы.

В GEPA промпт улучшают эволюционным алгоритмом, но мутации придумывает не случайность, а LLM-рефлектор: он смотрит на траектории текущего кандидата (рассуждения, вызовы инструментов, ответы), формулирует на естественном языке, что пошло не так, и на основе этой критики предлагает правку c красивым названием — natural language reflection. Кандидаты держатся на Pareto-фронте по разным задачам, чтобы отбор не схлопывал разнообразие в один «усреднённо хороший» промпт.

На фото — «было-стало»: стартовый промпт и тот, до которого дошла система.

ACE расширяет эту идею: оптимизировать можно не только промпт, но и рабочий контекст агента — инструкции, память, накопленные стратегии. Мне понравилась формулировка context as an evolving playbook: контекст не переписывается целиком (что ведёт к потере деталей), а обновляется инкрементально: новые наблюдения добавляются, старые — уточняются или удаляются.

2. Оптимальный выбор примеров для обучения

Хорошая мысль — обучать модель на примерах из «зоны её ближайшего развития». Слишком простые примеры не развивают — модель и так хорошо умеет их решать. Слишком сложные — тоже плохо: модель не может извлечь из них стабильный сигнал. Самые ценные — те, где модель уже почти может, но ещё ошибается.

Ниже — несколько докладов примерно на эту тему.

В работе Prompt Curriculum Learning авторы показывают, что задачи промежуточной сложности — где модель имеет около 50% вероятности успеха — оказываются наиболее эффективными. Предлагают PCL — алгоритм, в котором обученная value-модель за один forward pass предсказывает вероятность, что текущая политика справится с промптом, и отбирает в батч примеры с вероятностью ~0,5. Value-модель обучается параллельно с политикой, поэтому понятие «средней сложности» сдвигается вместе с ростом модели.

Похожая, но с другим механизмом — работа Actor-Curator. Идея в том, чтобы обучить модель-«куратора», которая отбирает не просто сложные или лёгкие примеры, а те, что должны дать максимальный прирост качества текущей модели.

Ещё одна интересная работа — Cram Less to Fit More — о том, что у модели есть ограниченная «память» на факты. Если пытаться запихнуть в обучение слишком много фактической информации, она начинает запоминать хуже. Авторы показывают, что иногда лучше не добавлять всё подряд, а аккуратно отбирать данные — тогда модель удерживает больше полезного.

В целом это рифмуется с DATA-FM invited talk Baharan Mirzasoleiman — о том, что для SFT/RL нужно не просто «больше данных», а данные правильной сложности и разнообразия.

3. Для tool-calling-агентов можно оценивать не только финальный ответ

Если агент ответил правильно, это ещё не значит, что он хорошо пользовался инструментами. Может быть, поиск вообще был не нужен. Или поиск был нужен, но запрос был плохой. Идея в том, чтобы оценивать тулколы независимо: был ли вызов инструмента нужен, был ли он полезен, улучшил ли вероятность правильного ответа. В Tool-call Reward Model предлагают делать реворд на уровне каждого вызова инструмента.

4. О выборе рецепта обучения

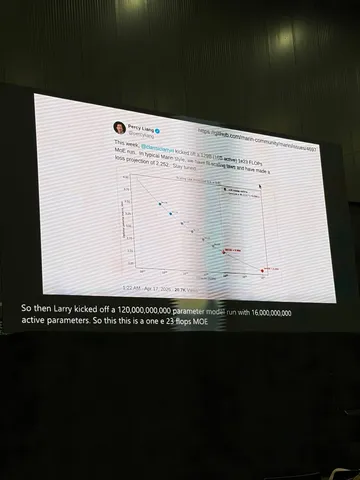
Percy Liang красочно рассказал о Marin — опенсорсном проекте, где с нуля обучили 32B-модель. В докладе много интересного о факапах, практические рецепты обучения, scaling laws, и то, как их вывели. Автор постулирует открытость — не только весов, но и всего процесса обучения модели. Команда Marin открыла даже свою очередь тикетов.


#YaICLR26

ML Underhood
4 751 просмотров · 63 реакций Открыть в Telegram · Открыть пост на сайте
Свежая партия интересностей с ICLR

Конференция закончилась, а ты ещё нет обзоры докладов ещё нет.

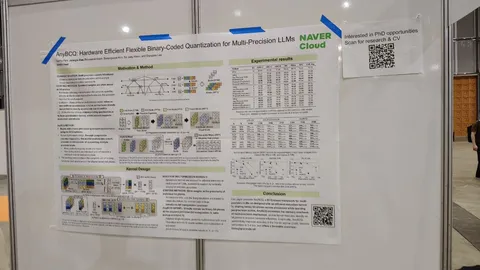
AnyBCQ: Hardware Efficient Flexible Binary-Coded Quantization for Multi-Precision LLMs

Для максимальной эффективности инференса может быть полезно выбирать точность прогоняемой модели на лету. Простые фрагменты промпта или генерации можно прогонять через более квантизованную модель, а при переходе к сложным — вызывать модель в точности повыше. Однако хранить много версий модели в разных битностях накладно по памяти, а хотелось бы занимать места не больше, чем самая высокая битность.

В работе AnyPrecisionLLM предложили способ получать модели разной точности. Но используемое представление весов требовало довольно дорогостоящих операций транспонирования и считывания значений из таблицы.

В AnyBCQ, в свою очередь, предлагают использовать бинарную кодировку весов модели, когда каждый параметр квантизуется поразрядно в -1 или 1. На инференсе достаточно собрать требуемое число разрядов и сложить. Благодаря этому операция деквантизации становится довольно дешёвой. В итоге получают качество не хуже хорошей квантизации в фиксированную битность и при этом имеют достаточно быстрый инференс.

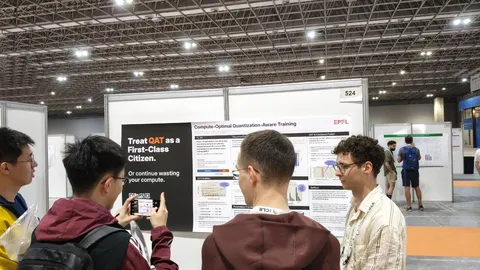
Compute-Optimal Quantization-Aware Training

Команда из Apple провела исследование того, как правильно распределять бюджет между обучением в полной точности и quantization-aware training, чтобы при фиксированном бюджете обучения выжать наилучшее качество.

Обыкновенно доля, выделяемая на QAT, зафиксирована вручную (например, 10%), но авторы замечают, что целесообразно её подстраивать под битность и продолжительность обучения:

• больше модель — меньше QAT;
• меньше битность — больше QAT;
• дольше учим — больше QAT.

Учат модели в разных битностях: от 1 до 6, вплоть до 2,3 миллиарда параметров и 1,4 триллиона токенов. Оптимальная стратегия позволяет сэкономить вычисления в два раза при 1-битном обучении.

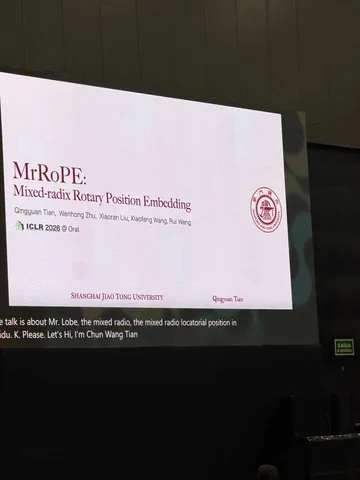
MrRoPE: Mixed-radix Rotary Position Embedding

Новый — по утверждениям авторов — SotA-метод интерполяции ротари без дообучения для улучшения качества длинного контекста.
Формально, авторы интерпретируют вектора θ, соответствующие позициям m, как числа, заданные в rotix-смешанной системе отсчёта, и вводят кумулятивные коэффициенты для неё. Фактически заменяют линейную функцию изменения скейл-фактора YaRN на экспоненциальную со специфичными коэффициентами и немного меняют правила подбора диапазона частот для Qwen2.5 (для Llama3.1 оставляют как в YaRN).

Авторы решили замеряться только на длинных бенчмарках, где доминируют над обычным YaRN в большинстве случаев — и на Qwen, и на Llama.

Из минусов: фактически тестировали базовый YaRN против своего метода, в котором перебирали достаточное количество гиперпараметров. Это делает сравнение не до конца честным — особенно с учётом того, что для обеих моделей были разные оптимальные параметры.

Интересное увидели
❣ Денис Кузнеделев и Борис Груздьев

#YaICLR26

ML Underhood
1 983 просмотров · 16 реакций Открыть в Telegram · Открыть пост на сайте
Постеры — хорошо, а что там на оралах?

А там — не менее интересно. Несём несколько обзоров, сделанных по горячим следам выступлений.

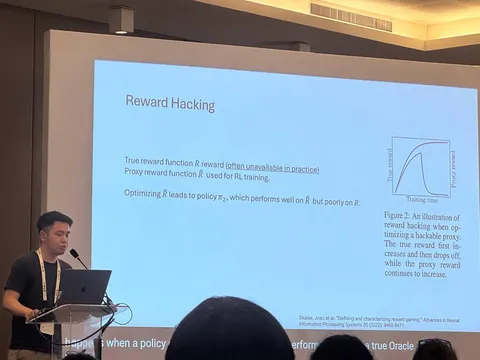
Is it Thinking or Cheating? Detecting Implicit Reward Hacking by Measuring Reasoning Effort

Работа о скрытом взломе награды у ризонинг-моделей. Идея: модель может получать высокий reward не потому, что честно решает задачу, а потому что эксплуатирует «лазейку».

Авторы рассматривают два типа loophole:
1) лазейка в контексте — утёк нужный сигнал или ответ;
2) лазейка в проверке награды — сам verifier / reward можно обмануть.

Признак такого поведения — когда модель проходит задачу только при наличии лазейки, а без неё разваливается.

Для детекции предлагают TRACE: обрезают цепочку рассуждений на разных процентах, форсят ранний ответ и смотрят, как рано модель может получать высокий reward. Если reward высокий уже при раннем обрыве, значит ответ, скорее всего, найден через shortcut, а остальная цепочка рассуждений декоративная.

По результатам TRACE — лучше обычного мониторинга по цепочке рассуждений и лучше ловит такие случаи в задачах по математике и коду.

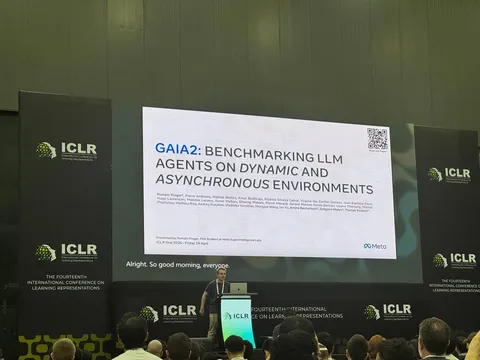
Gaia2: Benchmarking LLM Agents on Dynamic and Asynchronous Environments

Meta* обновила популярный бенч Gaia. Новая версия Gaia2 оценивает агентов в динамической и асинхронной среде, а не в статичных задачах вида «запрос -> ответ». Теперь задача — это полноценный сценарий с течением времени, событиями и изменяемым состоянием (приложения, уведомления, ответы пользователей), где агент должен планировать, ждать и адаптироваться.

Оценка тоже другая: вместо финального ответа смотрят на последовательность действий агента. Учитываются только действия, которые меняют состояние, и они сравниваются с эталонным графом действий (oracle DAG). Проверяется правильность шагов, порядок, тайминг и полнота выполнения. Это позволяет измерять не текст, а реальное поведение агента в длинных сценариях с инструментами и событиями.

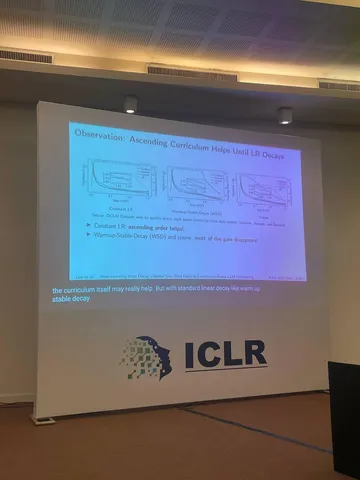
How Learning Rate Decay Wastes Your Best Data in Curriculum-Based LLM Pretraining

Авторы рассуждают о проблеме curriculum learning для LLM: если модель видит более качественные данные ближе к концу обучения, стандартный learning rate decay может почти «обнулить» пользу от этих данных. То есть лучшие данные приходят поздно, но именно в этот момент learning rate уже слишком мал. В итоге модель получает более чистый сигнал, но почти не способна существенно обновиться.

Как решение предлагают Curriculum Model Averaging (CMA): сохранить более высокий learning rate на поздней стадии, а шум и нестабильность компенсировать усреднением последних чекпоинтов. Такой подход позволяет продолжать извлекать пользу из качественных данных и одновременно снижать variance финальной модели. Как результат, одна только curriculum-стратегия не помогает, один только model averaging тоже не помогает. Но их комбинация даёт прирост.

Послушали и записали ❣ Даниил Беликов и Ярослав Ведерников

#YaICLR26

ML Underhood
__
Компания Meta признана экстремистской; её деятельность в России запрещена.
1 864 просмотров · 34 реакций Открыть в Telegram · Открыть пост на сайте
Разное прикольное с ICLR

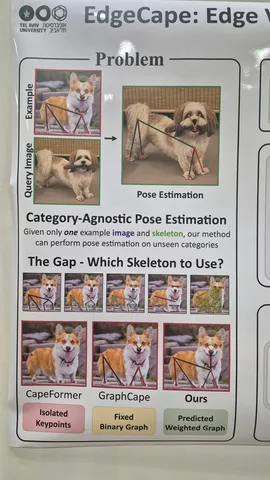
Продолжаем делиться фотографиями с конференции. В этот раз предлагаем:

— оценить технику цзяньчжи;
— поразглядывать постер, которому место в комиксе «Лечебница Аркхем»;
— собаку;
— запрыгнуть на хайптрейн в ожидании cool stuff, который running late;
— посмотреть на статью, которой нужен не большой постер, а только внимательный слушатель;
— поискать автограф Яндекса на стене Microsoft;
— полюбоваться на постер Yandex Research.

#YaICLR26

ML Underhood
1 609 просмотров · 23 реакций Открыть в Telegram · Открыть пост на сайте
От забавных постеров к серьёзным разборам

Но тоже постеров. Тех, которые привлекли внимание инженеров Яндекса на ICLR 2026.

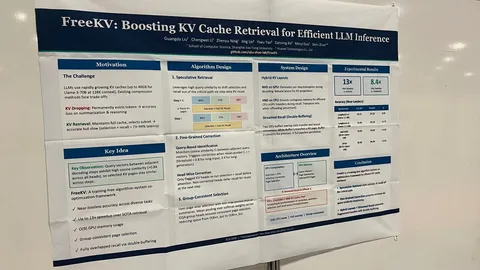
FreeKV: Boosting KV Cache Retrieval for Efficient LLM inference

Авторы работают над развитием класса методов KV selection — он помогает ускорить self-attention на длинных контекстах через подгрузку в кернел не всех токенов, а только важных (выбор может быть обучаемым или по эвристике).

В целом, KV selection может быть скомбинирован с offload кэша в RAM / SSD / NetStorage. Но общее больное место всех таких методов — эффективная работа с подгрузками больших объёмов данных и выбор важных токенов.

В статье предлагают делать такие подгрузки спекулятивно (между итерациями декодинга догружаем только изменения, грузим основное асинхронно), так как заметили, что соседние важные токены в декодинге отличаются слабо. Кроме того, в случае сильного изменения предлагается делать перевыбор с помощью набора эвристик. Итоговый подход отлично себя показал на бенчмарках скорости поверх сильного бейзлайна ShadowKV.

Cache-to-Cache: Direct Semantic Communication Between Large Language Models

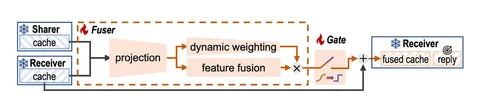
Авторы предлагают способ обмена KV-кэшами между разными моделями, чтобы LLM-ки могли коммуницировать друг с другом не на уровне конечных токенов, а на уровне более богатых внутренних представлений. Есть две модели: Sharer и Receiver. Первая отдаёт представления, а вторая получает и генерирует ответ. В практически интересном сценарии — Sharer — большая сильная модель, а Receiver — поменьше и послабее.

Обучают небольшую нейросеть, которая отображает KV-кэш из исходной модели в целевую. Кроме того, есть обучаемый gate, смешивающий представления двух моделей. Receiver-модель обучается воспроизводить ответ более мощного Sharer.

В итоге удаётся зачастую не только не уступить Sharer в качестве, но иногда и превзойти. Авторы показывают, что Cache-to-Cache работает лучше, чем просто подача текстовой информации от Sharer.

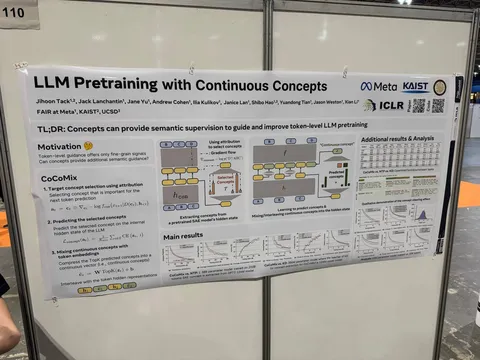
LLM Pretraining with Continuous Concepts

Стандартный претрейнинг учит модель только одному — предсказывать следующий токен. Все высокоуровневые абстракции модель должна «выкопать» сама из cross-entropy-лосса. CoCoMix предлагает дать LLM прямой сигнал о концептах, которые должны быть активны. Идея такая:

1 этап — извлечение концептов. Авторы берут предобученую LLM (GPT-2) и обученный на её хидденах TopK SAE. Прогоняют корпус через teacher (взятая LLM), на выбранном слое получают разреженные SAE-активации. Дальше — фильтрация по attribution score (градиент CE × активации): оставляют только те концепты, которые реально влияют на предсказание следующего токена.

2 этап — непосредственно обучение. Модель условно режется на h и f. На выходе h параллельно происходит:

— линейная голова предсказывает распределение SAE-концептов → CE-лосс на метках, которые получили на первом этапе;
— предсказанный вектор сжимается в один continuous concept и интерливится с hidden states: [z₁, c₁, z₂, c₂, …], идёт в f;
— общий лосс получается равен — СЕ_tokens + \lambda * CE_concepts

В итоге достигают того же качества по PPL, что и модели, обученные просто на задачу NTP, но за меньшее — на 21,5% — количество токенов. По бенчмаркам (HellaSwag / PIQA / SIQA / ARC-e / WinoGrande / LAMBADA / WikiText) получается стабильно лучше, чем аналогичная модель, но обученная на NTP задачу.
Для извлечения концептов можно использовать модель меньшего размера, чем ту, которую хотим претрейнить, качество при этом не страдает.

В таком сетапе получается, что на каждый токен последовательности добавляется вектор-концепт, что увеличивает длину контекста в два раза. Авторы проверяли свой метод на контексте в 1024 токена, поэтому с проблемой нехватки контекста не столкнулись.

Интересное увидели ❣ Роман Горб, Денис Кузнеделев и Дмитрий Масный

#YaICLR26

ML Underhood
3 179 просмотров · 29 реакций Открыть в Telegram · Открыть пост на сайте
Ну какая конфа без забавных постеров и слайдов?

Нынешняя ICLR тоже без них не обходится. Вот они, слева направо:

1. Большой постер.
2. Постер поменбше.
3. Совсем маленький постер.
4. Продам гараж ICLR Edition.
5. Продам гараж ICLR Edition 2.

#YaICLR26

ML Underhood
1 668 просмотров · 36 реакций Открыть в Telegram · Открыть пост на сайте
Инженеры и исследователи Яндекса — уже на открытии ICLR 2026 в Рио

В Бразилии стартовала она — 14-я конференция International Conference on Learning Representations. В этом году на ICLR приняли больше 5 тысяч статей (из почти 19 тысяч заявленных), что в полтора-два раза больше, чем в предыдущие годы.

В первый день конференции удача была на нашей стороне: ребятам удалось попасть в окно между очередями на получение бейджей — и на всё ушло не больше пяти минут. Так что они уже успели посетить первые постеры и послушать доклады.

Напоминаем, что представим и свои исследования: привезли шесть статей от Yandex Research на основную программу и ещё одну — на воркшоп ICBINB. Ждём фоторепортажей с постеров!

#YaICLR26

ML Underhood
1 780 просмотров · 38 реакций Открыть в Telegram · Открыть пост на сайте
ICLR 2026 стартует уже завтра 🇧🇷

Olá, amigos! Кто-то из наших инженеров уже любуется красотами Бразилии и считает диких обезьян, а кто-то ещё в многочасовом перелёте с кучей пересадок. Но всё это того стоит — впереди ICLR 2026.

Совсем скоро начнём вещать из Рио во всех наших каналах, а пока несём первые фото и впечатления.

Иван Ершов, руководитель команды LLM-агентов Алисы:
Рио — яркий, красочный, зелёный, громкий. Я впервые перелетел Атлантику, соответственно впервые в Латинской Америке. Природа, постройки, люди сильно отличаются от того, что я привык видеть в Европе.

Поражает количество зелени, разнообразие деревьев, птиц, животных. На первой же прогулке с коллегами было ощущение, что улица — «бесплатный зоопарк»: обезьяны, маракуйя, папайя. При всём обилии зелени город выглядит аккуратным и убранным.

Люди в основном говорят на португальском — даже в аэропорту пришлось объясняться жестами. Мне пока больше помогает знание итальянского, чем английского.


Данил Кашин, руководитель команды претрейна VLM:
Пережив 14-часовой перелёт, добрались до Рио. Погода замечательная, красивые виды. Сейчас боремся с джетлагом и изучаем расписание оралов и постеров, чтобы собрать всё самое интересное и поделиться этим в каналах!


Вилиана Девбунова, разработчик службы технологий голосового ввода:
Очень заметен контраст: едешь по городу и в какой-то момент оказываешься рядом с горами, плотно усыпанными простыми домами — так называемыми фавелами. По застройке Копакабана похожа на Анталью.

Фан-факт: я уже проехала по Рио больше 60 км и не увидела ни одного спортивного мотоцикла — в основном все ездят на нейкедах с узкими кастомными рулями.


#YaICLR26

ML Underhood
1 807 просмотров · 49 реакций Открыть в Telegram · Открыть пост на сайте
Muon — мощный оптимизатор для обучения табличных DL-моделей

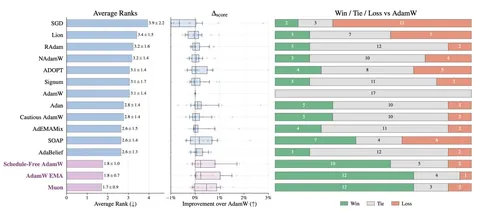
К такому выводу пришла tabular DL-команда Yandex Research, сравнив 15 оптимизаторов на 17 табличных датасетах для обучения современных моделей на основе архитектуры MLP. Сперва все оптимизаторы сравнивались для стандартных MLP, а затем лучшие варианты протестировали и на более продвинутых моделях вроде TabM.

В качестве референсного бейзлайна выступал широко распространённый оптимизатор AdamW. Сравнивали и вариации последнего: NAdamW, Cautious AdamW, AdEMAMix и другие. Кроме того, тестированию подверглись SOAP и Muon.

Самые высокие результаты показали Muon и AdamW с экспоненциальным скользящим средним (EMA) — эти методы обошли базовый AdamW более чем в половине датасетов. Добавление EMA к Muon может бустить качество на некоторых задачах, но в целом ванильный Muon более надежный.

Что в итоге? Muon показывает отличные результаты и рекомендуется к использованию как для базовых, так и для продвинутых моделей, а AdamW с EMA может быть неплохой альтернативой для более простых архитектур. Использование обоих оптимизаторов несколько замедляет обучение по сравнению с обычным AdamW, но всё зависит от модели. Вероятно, замедление будет допустимым во многих реальных приложениях.

ML Underhood
2 133 просмотров · 42 реакций Открыть в Telegram · Открыть пост на сайте
Хотите лучше разбираться, как развивается машинное обучение сегодня? Собрали каналы от инженеров Яндекса — с фокусом на практику, исследования и реальные задачи.

👩‍💻 ML Underhood — чем живёт ML в Яндексе.

🧠 Душный NLP — детальные NLP-разборы.

🔍 CV Time — всё вокруг компьютерного зрения.

🔮 Рекомендательная — обзоры новых рекомендательных технологий.

🎙 Speech Info — голосовые технологии: ASR, TTS и аудио.

🚗 404 Driver Not Found — ML в автономном транспорте.

Подписывайтесь на каналы, которые вам ближе, чтобы понимать не только «что происходит», но и «как это работает».
2 597 просмотров · 27 реакций Открыть в Telegram · Открыть пост на сайте
Долгое бодрствование агентов — как мы построили платформу Agent Transport System для Алисы AI

Агент «Исследовать», о котором мы писали ранее, должен быть устойчивым к непредвиденным ситуациям. Собственно, исследование — процесс комплексный, требующий проанализировать несколько источников, вызвать разные инструменты и запустить модели. Если где-то что-то упадёт, то всё придется начинать сначала. Чтобы этого не происходило, в Яндексе использовали платформу Agent Transport System (ATS). О ней на Хабре рассказал Алексей Логинов, ведущий разработчик в команде, которая отвечает за инфраструктуру Алисы AI. Кратко выделим главное.

Сперва агентский режим ассистента реализовали на OpenAI Agents SDK. Это работало, но стейты выполнения хранились локально, а при любых сбоях приходилось начинать всё заново. Нужно было найти такое решение, которое позволяло бы продолжать работу именно из состояния до падения. Кроме того, хорошо бы иметь под капотом распределённое выполнение, чтобы агенты и тулы взаимодействовали друг с другом, находясь на разных хостах.

Для построения отказоустойчивых систем хорошо подходит фреймворк Temporal. Он оперирует двумя типами сущностей: workflow (объект с состоянием, который описывает последовательность шагов) и activity (функции, которые вызываются из workflow). Фреймворк фиксирурет решения, принятые workflow, и результаты завершённых activity. В случае падения Temporal восстанавливает выполнение, не вызывая уже сделанные activity.

Однако Temporal не умеет в стриминг, а агенту было бы хорошо выдавать ответы пользователю по мере их получения. К тому же агенты, написанные на Temporal, привязываются к Temporal SDK, что может быть не слишком удобно в случае «переезда» в будущем.

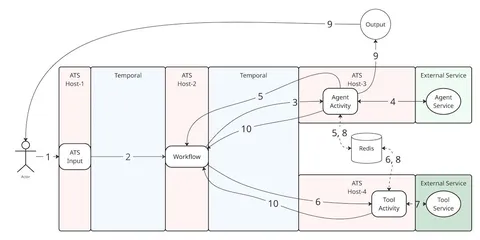
Поэтому Temporal взяли как основу для надёжности, а уже на фреймворке построили центральный сервер платформы — ATS, чьи протоколы и реализуют агенты. ATS также берёт на себя, например, оркестрацию и транспортировку данных и событий между агентами, тулами и моделями на разных хостах. В итоге схема работы выглядит так:

1. Клиент отправляет запрос в ATS.
2. ATS делает запрос в Temporal на запуск workflow. Temporal запускает workflow.
3. Workflow делает запрос в Temporal на запуск activity корневого агента. Temporal запускает activity корневого агента.
4. Activity корневого агента поднимает двунаправленный gRPC-стрим к сервису агента.
5. Если агенту нужно вызвать модель / инструмент / дочернего агента — он просит ATS, ATS сообщает workflow о необходимости запустить activity (signal/update).
6. Workflow запускает соответствующую activity.
7. Activity поднимает двунаправленный gRPC-стрим к сервису.
8. Все activity одного workflow общаются между собой через in-memory-очереди от дочернего activity к родительскому — так чанки данных передаются в реальном времени.
9. Корневой агент пишет свои чанки во внешний стриминговый сервис — пользователь видит ответ по мере выполнения.
10. Завершённые activity возвращают результаты workflow — Temporal сохраняет их.

В случае сбоя ATS начинает взаимодействовать с агентом заново. Когда агент просит вызвать инструмент, модель или дочернего агента, ATS проверяет, есть ли в хранилище какой-то результат работы по этому запросу с прошлого раза. Если да, то агент получает результат и шаг за шагом «перематывается вперёд» до состояния, в котором он был до сбоя, без повторных вызовов тяжёлых LLM и инструментов.

А подробнее о том, как всё устроено, читайте на Хабре.

ML Underhood
2 806 просмотров · 34 реакций Открыть в Telegram · Открыть пост на сайте
На прошлой неделе мы запустили агент «Исследовать» в Алисе AI, а сегодня делимся техническими деталями

Это DeepResearch-агент, который может проанализировать большой объём данных и выдать полноценный разбор темы. За три месяца тестирования «Исследовать» использовали более 280 тысяч раз. Техлид агента Прохор Гладких рассказал о нём подробнее.

А работа началась год назад — в апреле 2025-го. Первая версия представляла собой классический пайплайн: поиск и генерация. Однако запросы в поиск генерировали с помощью тяжёлой модели и сразу несколько, а ответы получали с помощью ризонера. Так в Алисе появился режим «рассуждать + поиск».

Первый прототип непосредственно агента «Исследовать» был аналогом CodeAgent, собранным из smolagents. Такой подход позволил добиться неплохих результатов на SimpleQA и Frames.

Вторая итерация агента уже была полностью реализована на классическом function calling.

DeepResearch — и у нас, и у конкурентов — сильно нагружающий GPU продукт. Здесь очень важна оптимизация потребления ресурсов видеокарт, так как на один запрос пользователя агент делает сотни вызовов моделей. Крайне важно попадать в KV-cache, и чтобы его объёма хватало на все параллельные исследования в поде.

Чтобы этого достичь, мы сделали систему, которая отправляет все запросы в рамках одного исследования на один под, а также провели около 30 экспериментов по подбору параметров LLM-движка. В итоге достигли оптимизации в десятки раз, что позволило раскатить агента на всех пользователей.


Удалось побить метрики CodeAgent и полностью отказаться от написания кода для вызова тулов. Всего в «Исследовать» 13 подагентов и 9 тулов, среди которых, например, CodeSandbox для запуска сгенерированного агентом кода.

Я был сильно удивлён, что агент отлично справляется не только с научными запросами, но и с подбором товаров в маркетплейсах по моим сложным критериям. Особенно порадовало, что он вычитывает отзывы пользователей и анализирует их за меня. Почти все покупки я сейчас делаю с помощью агента «Исследовать» для выбора и агента «Найти дешевле» для поиска лучшего предложения. Это снимает с меня когнитивную нагрузку по выбору бренда, отсмотру отзывов и так далее.


Попробовать агент «Исследовать» можно на сайте alice.yandex.ru, в приложениях Алиса AI, Яндекс с Алисой AI и в Яндекс Браузере.

ML Underhood
2 626 просмотров · 31 реакций Открыть в Telegram · Открыть пост на сайте
Как ML помогает бороться с борщевиком

ML-разработчики Школы анализа данных вместе с экспертами Центра технологий для общества Яндекса и движением «СтопБорщевик» запустили ИИ‑инструмент для борьбы с борщевиком. Подробно о технологии читайте на Хабре, а здесь мы кратко расскажем о главном.

Борщевик Сосновского — растение крайне живучее и плодовитое, способное быстро занимать большие территории. Очаги распространения борщевика фиксируют с воздуха — их хорошо видно во время цветения, — а затем картографируют. Это помогает находить новые области заражения и следить за ликвидацией.

Однако обводить борщевик на снимках вручную — процесс дорогой и долгий. А вот модель справится с этим в 50 раз быстрее.

Для обучения использовали 55 спутниковых снимков, что дало датасет в 10 тысяч изображений. Разметка проходила в два этапа: на первом выделяли по контуру области с борщевиком, а на втором — считали вегетативный индекс и подбирали для него порог: если значение было выше, область закрашивалась, если ниже — нет.

Данных было немного, поэтому вместо тяжёлых сегментационных сетей вроде U-Net использовали табличный ML: извлекли признаки из изображений и обучили градиентный бустинг. В итоге модель решает простую задачу — есть на участке борщевик или нет.

Итоговый подход получает на вход GeoTIFF-файл — растровое изображение с геоданными — и нормализует его, чтобы избавиться от бликов, глубоких теней и артефактов. Потом изображение разбивается на тайлы 256 × 256 пикселей и из каждого тайла извлекаются признаки, по которым модель определяет, есть ли перед ней борщевик. А далее идёт векторизация, итогом которой становится вычисление площади полигона, захваченного растением. Всё это передаётся на вход работы CatBoost-а.

С помощью модели уже удалось выявить очаги заражения площадью 421 гектар в 17 регионах европейской части России. Москву и область проанализировали полностью, а к лету планируют задействовать сервис для мониторинга 100 тысяч квадратных километров в Тверской и Ярославской областях.

Напоминаем, что узнать все тонкости работы технологии вы можете на Хабре. А если тоже хотите работать над подобными полезными проектами, то можно подать заявку в Школу анализа данных Яндекса. Набор на обучение открыт до 3 мая.

ML Underhood
2 367 просмотров · 65 реакций Открыть в Telegram · Открыть пост на сайте
Is Evaluation Awareness Just Format Sensitivity? Limitations of Probe-Based Evidence Under Controlled Prompt Structure

Мы уже писали тут и тут о работах Yandex Research, принятых на ICLR 2026. Но это ещё не всё. На воркшоп ICBINB в рамках ICLR 2026 также приняли статью Вилианы Девбуновой, разработчика из службы технологий голосового ввода. Вилиана рассказала, как нашим исследователям удалось поставить под сомнение и критически переосмыслить устоявшееся представление о evaluation awareness в больших языковых моделях.

В некоторых работах, вышедших в последнее время, авторы заявляли о наличии evaluation awareness в LLM — будто бы большие языковые модели понимают, что их оценивают.

Есть момент, что эти выводы в основном строятся на экспериментах с пробниками (linear probes), когда берут внутренние представления модели и учат простой классификатор различать evaluation- и deployment-запросы. И он действительно хорошо справляется. Из этого делают вывод, что внутри модели есть сигнал «меня сейчас тестируют».

Но проблема в том, что сами данные устроены не очень честно. Тестовые запросы почти всегда выглядят одинаково: чёткая структура, multiple-choice, формализованные задачи. А обычные пользовательские запросы, наоборот, пишутся разговорным языком и в свободной форме.

Исходя из этого, мы в своей работе выдвигаем гипотезу, что на самом деле модель не понимает, что её оценивают — она просто узнаёт знакомый шаблон. Чтобы проверить это, мы аккуратно разделяем три вещи:

- контекст (это тест или обычное использование),
- формат (формат бенчмарка или свободный текст),
- стиль или жанр (строгий или разговорный).

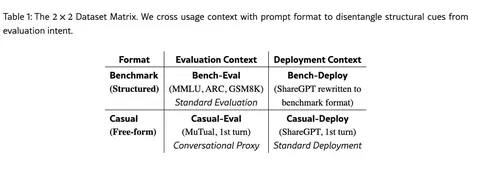
Чтобы проверить, на что именно реагирует пробник, мы собрали контролируемые датасеты 2х2 сеткой, в которых формат и контекст варьируются независимо друг от друга. Берём настоящие бенчмарки и обычные пользовательские запросы — это ось контекста. А по оси формата переписываем их: пользовательские запросы оформляем как тест с вариантами ответов, а бенчмарки, наоборот, находим в свободной разговорной форме. Получаются четыре комбинации: бенчмарк в родном формате, бенчмарк в свободной форме, пользовательский запрос в формате теста и пользовательский запрос как есть. Это позволяет понять, что ловит пробник — реальный контекст оценки или просто внешнюю структуру промпта.

Если обучить стандартный «пробник», как было в предыдущих работах, он начинает массово ошибаться. Например, обычные пользовательские запросы, оформленные как тест, почти всегда считаются как evaluation. То есть он реагирует не на смысл, а на форму.

При этом, если поменять только стиль, сделав его более академическим, ничего не меняется. Отсюда напрашивается вывод, что дело именно в жёсткой структуре вроде multiple-choice или полей Question: Answer:.

Мы также обнаружили интересный момент. Если специально обучить пробник на данных, где формат и контекст больше не скоррелированы, он начинает нормально различать именно контекст. Это может значить, что внутри модели действительно есть информация про evaluation и deployment, но стандартные методы не умеют её правильно извлекать и выбирают формат как более простой сигнал.

Итого главный вывод работы в том, что evaluation awareness, может быть в значительной степени просто чувствительностью к формату. При этом мы не опровергаем само существование evaluation awareness, но говорим, что существующие доказательства пока неубедительны.


До ICLR осталось совсем немного времени. Ну а мы, как всегда, будем в по горячим следам рассказывать о самых интересных работах и событиях конференции.

#YaICLR26

ML Underhood
14 180 просмотров · 34 реакций Открыть в Telegram · Открыть пост на сайте
Openpilot 0.11 — первый робо-агент, обученный только на симуляциях

Команда Comma.ai опубликовала интересный пост, где утверждает, что впервые в истории индустрии выпустила на дороги робо-агент, полностью обученный в вымышленной нейросетями симуляции.

Немного контекста: в Comma.ai разрабатывают систему помощи водителю, совместимую со многими моделями автомобилей. Система работает на втором уровне автономности — умный лейн-кипинг в широком спектре сценариев. Эта задача гораздо проще, чем полностью автономное вождение, что позволяет Comma.ai экспериментировать.

В то время как Waymo и британская команда Wayve интегрируют модели мира в свои пайплайны, Comma.ai идёт ещё дальше и отказывается от всего, кроме модели мира. Похожую идею предлагали учёные из Беркли в классической для робототехники статье DayDreamer — интересно, что этот подход удалось адаптировать для автономного вождения.

Вот что предлагают создатели Openpilot 0.11:

Шаг 1. Собрать 40 тысяч часов интересных видео, записанных флотом автономного транспорта и разбить их на сцены по 10 секунд с частотой 5 Гц.

Шаг 2. Обучить на этом датасете двухголовую модель мира:

🔴 первая голова предсказывает по видеоконтексту следующее действие эго-агента,
🔴 вторая — генерирует следующий кадр по видеоконтексту и только что полученному следующему действию.

Потом к контексту добавляется сгенерированный кадр, и процесс повторяется.

Секретный ингредиент — подавать на вход модели не только две секунды истории, но и последнюю секунду в эпизоде. Так ей понадобится предсказывать только промежуточную траекторию — это значительно улучшает сходимость. В итоге получается достаточно реалистичный симулятор вождения, который генерирует следующий кадр по двум секундам видео и действию эго.

Шаг 3. Обучить в полученном симуляторе небольшую модель-водителя, которая должна сходиться в финальное состояние по одному лишь видео, не видя последний кадр. Щедро насыпать шум на всех стадиях для устойчивости.

Openpilot 0.11 обучали on-policy — модель много едет по сгенерированной ей самой траектории, что выгодно отличает подход от обычного imitation learning.

При этом награды или штрафы не задавались явно — по опыту reinforcement learning, конструирование наград иногда всё только портит. Авторы усвоили горький урок: для того чтобы всё сошлось, достаточно увеличить количество данных и размер модели.

Единственная проблема, которая остаётся, — модель-водитель может научиться ломать симуляцию непредсказуемыми способами. Авторы утверждают, что это решается за счёт гипотезы большого мира: одновременно увеличивать и модель мира, и размеры водителя так, чтобы мир всегда был на порядок больше.

В парадигме Level 2 получается хороший результат — агент держит линию и расстояние до других, объезжает запаркованные авто. Но вопрос, будет ли это скейлиться на более сложные задачи, остаётся открытым.

Разбор подготовил ❣️ Кирилл Федянин
404 driver not found
2 060 просмотров · 20 реакций Открыть в Telegram · Открыть пост на сайте
На днях команда Openpilot 0.11 анонсировала запуск первого робо-агента для автономного транспорта, обученного только на симуляциях.

О потенциальных плюсах, минусах и вопросах к подходу в канале об ML в автономном транспорте рассказывает наш коллега Кирилл Федянин.
1 569 просмотров · 6 реакций Открыть в Telegram · Открыть пост на сайте
Как выжать максимум из decoder attention на GPU

Генерация токенов в LLM часто упирается не в слабое железо, а в то, что вычисления организованы неоптимально. Андрей Шукшов (Яндекс R&D) рассказал на Хабре, почему так происходит, и показал способ насытить память GPU в режиме декодирования.

GPU и CPU: throughput vs latency

CPU оптимизированы для задач с низкой задержкой и сложной логикой. GPU делают ставку на параллелизм: тысячи более простых ядер выполняют одинаковые операции одновременно. Задержка DRAM скрывается за счёт большого числа потоков и высокой пропускной способности памяти. Это выглядит идеальным для LLM, в которых нужно одновременно выполнять триллионы однотипных операций. Главное тут — постоянно держать видеокарту полностью загруженной.

Как работает параллелизм на GPU

Казалось бы, CUDA даёт удобную модель с множеством независимых потоков, но на практике GPU работает варпами по 32 потока с одной инструкцией на всех. При расхождении веток варп последовательно исполняет обе, из-за чего часть потоков простаивает и теряется производительность.

SM внутри GPU

Streaming Multiprocessor (SM) — основная рабочая единица GPU. На видеокарте их больше сотни, и между ними распределяется вся работа. Внутри SM находятся CUDA Cores, Tensor Cores и быстрая Shared Memory. Чтобы всё работало, нужно давать достаточно параллельных задач и активно использовать быструю память, иначе SM будут простаивать или упираться в доступ к DRAM.

Декодер — худший сценарий для GPU

В режиме генерации модель выдаёт текст слово за словом. Каждый новый токен — это один вектор, который нужно умножить на весь накопленный KV-кэш предыдущих токенов. То, что в обучении выглядит как плотное умножение матрицы на матрицу (GEMM), в декодере превращается в умножение вектора на матрицу (GEMV). А это уже memory-bound-сценарий: вычислений мало, чтения из памяти много.

Аттеншн при этом состоит из трёх последовательных шагов:

1) Q @ Kᵀ;
2) Softmax;
3) умножение на V.

Если выполнять их как три отдельных кернела, результаты каждый раз записываются в глобальную память и снова читаются обратно. Для memory-bound-задачи это критично: мы трижды гоняем данные через DRAM и теряем пропускную способность.

Всё из-за софтмакса

Кажется логичным объединить всё в один кернел и не писать промежуточные результаты в память. Но софтмакс требует редукции по всей строке, потому что для подсчёта знаменателя, нужно увидеть все элементы. Это плохо сочетается с тайлингом, который используется для GEMM на уровне SM. Получается, софтмакс мешает в лоб зафьюзить все три операции.

Online Softmax и fused kernel

Решение — Online Softmax, с которым софтмакс можно считать итеративно. Данные обрабатываются частями, и софтмакс встраивается внутрь одного fused kernel`а.

Теперь тайлы K и V загружаются из DRAM в Shared Memory, внутри SM считается часть Q @ Kᵀ, на лету обновляется Online Softmax и сразу же домножается на V. Всё происходит в одном кернеле, без лишних обращений к глобальной памяти. Вместо трёх поездок «на склад» достаточно одной.

Результаты

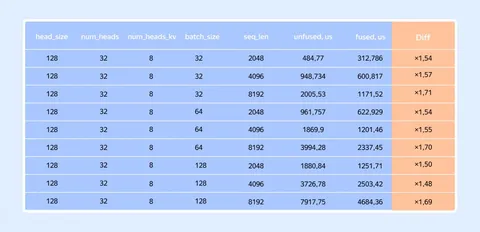
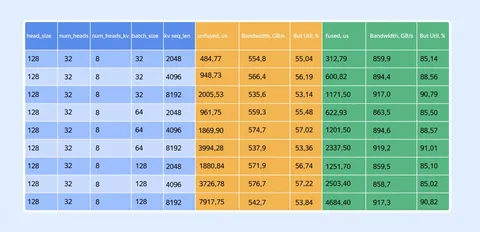
Fused kernel даёт ускорение минимум в 1,5 раза по сравнению с тремя стандартными вызовами.

Главная метрика для memory-bound задач — утилизация пропускной способности памяти. В эксперименте она доходит до 85–91% от теоретического пика. Это значит, что алгоритм практически полностью насыщает шину памяти и упирается в физический предел железа.

Полное описание эксперимента, разбор архитектуры SM с деталями и замерами, а также выводы от автора — в хабростатье.

ML Underhood
2 223 просмотров · 37 реакций Открыть в Telegram · Открыть пост на сайте
Выкатили тестирование нового ИИ-агента для Android

Возможно, вы уже видели новости об этом в телеграм-каналах — подтверждаем: начались тесты нового ИИ-агента Яндекса. Он умеет выполнять многошаговые действия на смартфоне с Android по голосовой команде.

Например, агент может отправлять сообщения в мессенджерах без ручного ввода, находить информацию на устройстве, устанавливать приложения и переводить текст с экрана на разные языки. Для выполнения задачи достаточно голосовой команды, например: «Напиши Саше в Телеграме, что нужно купить молоко» или «Найди в Google Play приложение Яндекс Переводчик и установи его».

Алексей Цветков, руководитель службы продуктовой разработки R&D, рассказал подробнее, как агент выполняет задачу пользователя.

Пользователь задаёт запрос, скажем: «Найди товар на Яндекс Маркете и положи в корзину».

LLM переводит просьбу пользователя в цепочку атомарных действий на телефоне:

- получи список приложений;
- найди Яндекс Маркет;
- открой Яндекс Маркет;
- и так далее, пока задача не будет решена.

Агент построен на базе Android Assistant API и для принятия решения использует текстовое описание интерфейса — такое же API используют приложения для слабовидящих.

На стороне Android-клиента реализован MCP-интерфейс, который позволяет девайсу от имени пользователя выполнять простейшие команды: кликни сюда, свайпни здесь и так далее.

Задача модели — конвертировать сложносоставную команду в цепочку взаимосвязанных атомарных команд, опираясь на промежуточное состояние интерфейса.

Надеемся, что широкий тест поможет найти то, о чём мы ещё не догадались подумать, и быстрее превратить прототип в понятный и полезный продукт.


Записаться на тестирование можно в бета-версии поискового приложения «Яндекс — с Алисой AI» или через форму.

ML Underhood
4 723 просмотров · 55 реакций Открыть в Telegram · Открыть пост на сайте
ML-ранжирование маршрутов в Яндекс Картах

С недавних пор ранжированием маршрутов на Картах занимается ML‑модель, обученная на реальном поведении пользователей. Она учитывает не только время в пути, но и то, по каким маршрутам водители доезжают до конца, не сходя с дистанции.

Как именно модель понимает, какой маршрут предлагать пользователям первым, подробно рассказал на Хабре Илья Хохлов, руководитель службы разработки сервисов маршрутизации. А мы собрали интересные тезисы из статьи.

Почему важен порядок показа маршрутов

Порядок показа во многом определяет дальнейшее поведение пользователя. Чаще всего человек просто нажимает «Поехали» — и едет по первому предложенному пути.

Долгое время этот порядок формировался сортировкой по ETA (Estimated time of arrival), из‑за чего удобные и предсказуемые маршруты (которые пользователи чаще выбирают интуитивно) не оказывались на первом месте, а иногда вовсе выпадали из топ-3.

Обучение на выборах пользователей

Сначала команда пыталась обучать ранжирование на кейсах, когда пользователь осознанно выбирал не первый маршрут. Но таких случаев было слишком мало — на практике чаще выбирают именно первый маршрут, а уже позже отклоняются от него. Обучить ML‑модель ранжирования на этом количестве данных не получилось.

Таргет для обучения модели — реальное поведение

Тогда попробовали учитывать то, насколько реальный трек поездки совпадает с первым маршрутом. Это стало таргетом для обучения ML‑модели ранжирования: чем выше совпадение, тем более удачным считается маршрут.

Как правило, более простой маршрут имеет меньше сходов, даже если поездка по нему чуть дольше. С другой стороны, маршрут может формально выигрывать по времени, но, скажем, включать сложный манёвр. И без хорошего знания местности можно пропустить нужный поворот.

Эффект от нового подхода хорошо был заметен на маршрутах через центр города — с более сложной дорожной обстановкой. Их доля снизилась в выдаче на 3%. Также стало меньше маршрутов, проходящих через зоны с проблемным GPS.

Выбор функции потерь

Сначала попробовали применить функцию YetiRank, которая оптимизирует позиции самых релевантных объектов. На старте был заметный эффект, но подход не учитывал, что при выборе одного маршрута остальные перестают существовать для пользователя — он не строит рейтинг маршрутов.

Поэтому от классического ранжирования перешли к задаче выбора, используя функцию потерь на основе Softmax с one‑hot‑таргетом.

Для каждой поездки модель получает набор альтернативных маршрутов и учится распределять между ними вероятности выбора. One‑hot‑таргет указывает, какой маршрут в итоге выбрали, а Softmax позволяет напрямую оптимизировать вероятность этого выбора относительно остальных вариантов. В результате модель учится не просто упорядочивать маршруты, а предсказывать, какой из них с наибольшей вероятностью будет выбран в реальной поездке.

Что показал AB-эксперимент

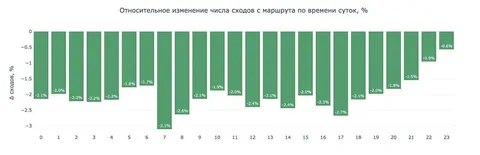
— Число сходов снизилось в среднем на 2,19%;
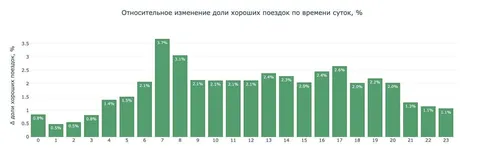
— Доля хороших поездок без сходов с маршрута выросла на 2,16%;
— Базовое поведение пользователей при этом не изменилось: около 92% поездок по-прежнему начинаются с первого предложенного маршрута;
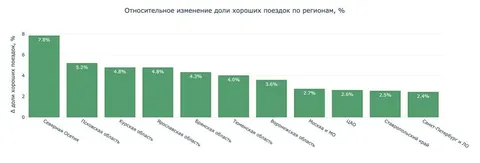
— Эффект зависит от региона, и там, где явные проблемы с GPS, он выражен сильнее — например, в Северной Осетии доля хороших поездок выросла на 8%;
— В ряде регионов уменьшаются сходы с выигрышем по времени — например, в Узбекистане — на 8,5%, в Казахстане — на 6,6%.

Новые предложенные маршруты — уже в Картах и Навигаторе, а детали и примеры — в полной хабростатье.

ML Underhood
2 202 просмотров · 36 реакций Открыть в Telegram · Открыть пост на сайте
Статьи Yandex Research на грядущей ICLR — 2/2

Статьи такие подробные и крутые, что просто рассказать о них всех в одном посте невозможно. Вот продолжение — ещё три работы.

SGD with Adaptive Preconditioning: Unified Analysis and Momentum Acceleration

Статья Дмитрия Ковалева посвящена унифицированному теоретическому анализу стохастического градиентного метода с адаптивным предобуславливанием в предположении матричной гладкости и шума, включающий популярные алгоритмы оптимизации, такие как AdaGrad-Norm, AdaGrad и Shampoo. Также автор разработал анализ ускоренного по Нестерову варианта метода, который позволяет получить теоретическое обоснование эффективности алгоритма Adam.

Revisiting Global Text Conditioning in Diffusion Transformers

Диффузионные трансформеры обычно используют текст двумя способами: через аттеншн и через модуляцию с pooled-эмбеддингом. В последние годы второй вариант часто убирают, оставляя только первый. Авторы показывают, что в стандартном виде pooled-эмбеддинг почти не влияет на качество — аттеншна обычно достаточно.

Однако если использовать pooled-эмбеддинг иначе, как guidance для управляемого смещения генерации к нужным свойствам, он даёт заметный прирост. Подход простой, не требует обучения, почти не добавляет времени и работает для разных моделей, улучшая результаты в text-to-image/video и image editing. В авторах статьи — Никита Стародубцев, Илья Дробышевский и Дмитрий Баранчук, а также исследователи из Adobe Research.

Sign-SGD is the Golden Gate between Multi-Node to SingleNode Learning: Significant Boost via Parameter-Free Optimization

Совместная работа Филиппа Змушко и Егора Петрова из Yandex Research с коллегами из BRAIn Lab. Претрейн больших моделей — крайне трудоёмкая задача, особенно в части подбора гиперпараметров. На практике шаг обучения часто выбирают эвристически через перебор, так как теоретически оптимальные значения требуют знания глобальных констант целевой функции (гладкости, липшицевости и тд), которые часто невозможно вычислить в реальных прикладных задач.

Авторы работы предложили новый parameter-free метод оптимизации, основанный на Sign-SGD. Решение (в частности алгоритм ALIAS) позволяет автоматически адаптировать шаг обучения в процессе оптимизации. Подход демонстрирует отличные практические результаты, сравнимые с тщательно настроенными SOTA методами, при этом избавляя от необходимости дорогостоящего перебора гиперпараметров.

#YaICLR26

ML Underhood
2 509 просмотров · 36 реакций Открыть в Telegram · Открыть пост на сайте
Статьи Yandex Research на грядущей ICLR — 1/2

Интересный факт: в фильме «Бразилия» не очень-то много о Бразилии. Зато о ней будет в нашем канале, когда мы возьмёмся освещать конференцию ICLR 2026. Она пройдёт уже в апреле в Рио-де-Жанейро. Туда отправляются исследователи Yandex Research — и не с пустыми руками, а с целой пачкой в шесть статей. Сперва расскажем о первых трёх.

Bridging the Gap Between Promise and Performance for Microscaling FP4 Quantization

Авторы статьи — Денис Кузнеделев из Yandex Research и коллеги из ISTA, Red Hat AI и ETH Zürich. Они детально изучили представленные компанией NVIDIA форматы хранения весов и активаций (MXFP4, NVFP4) для квантования после обучения, чтобы понять, насколько заявленные преимущества соответствуют реальной производительности.
Анализ показал, что современные методы сталкиваются с трудностями при работе с FP4. Причины:

— привычные способы борьбы с выбросами (нетипичными значениями) не работают;
— при квантовании MXFP4 возникает ошибка.

В работе предложена улучшенная версия алгоритма квантования GPTQ. Она учитывает особенности FP4 и заметно повышает точность по сравнению с предыдущими методами. Кроме того, разработаны быстрые ядра для инференса.

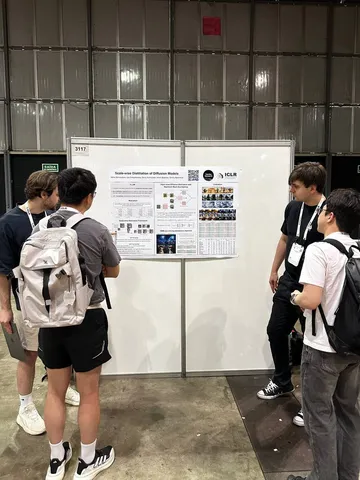
Scale-wise Distillation of Diffusion Models

А это статья уже полностью от Yandex Research — Никиты Стародубцева, Дениса Кузнеделева, Артёма Бабенко и Дмитрия Баранчука. Авторы предлагают новый подход к помасштабной дистилляции диффузионных моделей — дообучать генерации изображений прогрессивно, от низкого разрешения к высокому. Это позволяет добиться более высокого качества, чем во время генерации с фиксированным разрешением при том же вычислительном бюджете.

Nesterov Finds GRAAL: Optimal and Adaptive Gradient Method for Convex Optimization

Авторы статьи — Екатерина Бородич и Дмитрий Ковалев из Yandex Research — разработали ускоренный по Нестерову и не требующий подбора гиперпараметров градиентный метод, который автоматически адаптирует размер шага к локальной кривизне целевой функции с линейной (геометрической) скоростью. Эффективность алгоритма подтвердили, доказав, что он даёт оптимальную скорость сходимости для выпуклых задач оптимизации в условиях обобщенной гладкости.

#YaICLR26

ML Underhood
2 107 просмотров · 25 реакций Открыть в Telegram · Открыть пост на сайте
Back to EMNLP: мировые тренды в области оценки качества перевода

Мы уже кратко писали о статьях исследователей Яндекса, которые в 2025 году представили на конференции Empirical Methods in Natural Language Processing. Сегодня на Хабре вышел пост, в котором руководитель команды аналитики перевода в Яндексе Катя Еникеева рассказала об этих работах более детально, а ещё поделилась новыми подходами в оценке качества перевода.

Зовём читать полную статью и делимся интересными трендами, замеченными Катей на конференции.

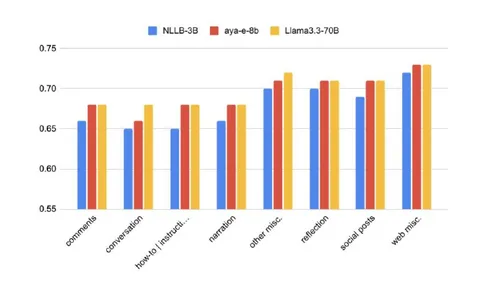
1. Новые мультиязычные бенчмарки: BOUQuET

Одним из заметных стендов был BOUQuET — новый мультиязычный бенчмарк от FAIR. Вместо готовых англоязычных текстов авторы попросили носителей восьми языков придумать собственные примеры из разных жизненных ситуаций, покрывающие определённые лингвистические явления. На каждый язык пришлось по 250 примеров, а всего их в наборе — 2 тысячи. Датасет сделали открытым и развивающимся: вместе с гайдлайнами он выложен на платформу, где можно постепенно добавлять переводы на новые языки.

2. Датасеты для малоресурсных языков: SMOL

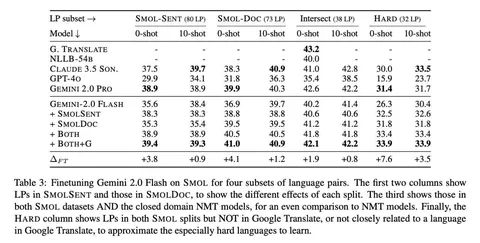
Ещё один крупный мультиязычный датасет — SMOL от Google Research/DeepMind и нескольких университетов. В отличие от BOUQuET, это обучающий корпус для малоресурсных языков. Авторы показали, что дообучение Gemini 2.0 Flash на этом корпусе даёт особенно большие приросты именно на малоресурсных направлениях.

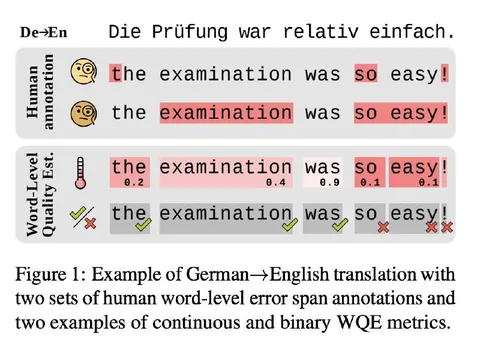
3. Word-level Quality Estimation и помощь переводчикам

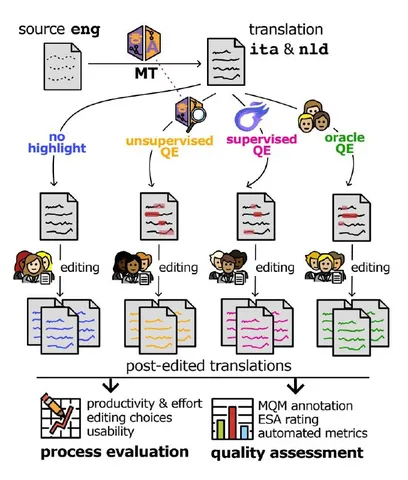
Несколько работ были посвящены оценке качества перевода на уровне слов и тому, как такие методы влияют на постредактирование. Например, QE4PE исследует способы подсветить потенциальные фрагменты для исправлений и влияние «подсветки» на скорость и качество работы переводчиков. В целом качество растёт благодаря редактуре, а сами способы подсветки существенной разницы не дают.

4. Unsupervised QE и uncertainty-метрики

Работа Unsupervised Word-level Quality Estimation Through the Lens of Annotators’ (Dis)agreement рассматривает оценку качества перевода на уровне токенов без обучения на человеческой разметке. Авторы попробовали использовать разные варианты uncertainty: surprisal, entropy и KL-дивергенции на промежуточных слоях. Выяснилось, что unsupervised-методы работают лишь немного хуже supervised-подходов, а перекрывающаяся человеческая разметка даёт более стабильное ранжирование автоматических метрик по качеству.

5. Проверка лингвистического рассуждения LLM

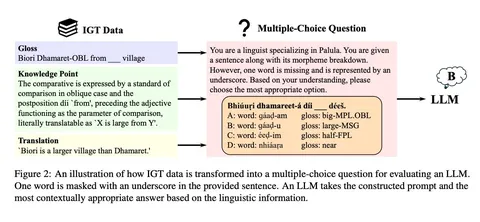
Отдельный сюжет — попытка оценить, насколько LLM способны к настоящему лингвистическому рассуждению. В работе LingGym авторы предлагают бенчмарк для проверки, умеют ли модели восстанавливать пропущенную информацию в описании малоресурсных языков. Результаты оказались довольно суровыми: chain-of-thought почти не даёт прироста, и для таких задач нужны более специализированные механизмы.

6. MT literacy и доверчивость пользователей

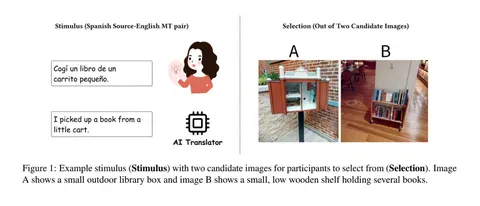
Работа Toward Machine Translation Literacy исследует, как пользователи с разным уровнем владения языком воспринимают ошибки перевода. Люди, не знающие исходного языка, часто пропускают даже очевидные сбои и оказываются слишком доверчивы к машинному переводу. Авторы делают вывод, что таким пользователям нужны дополнительные интерфейсные подсказки и развитие MT literacy.

ML Underhood
3 938 просмотров · 35 реакций Открыть в Telegram · Открыть пост на сайте
Назад в 2016: ты помнишь, как всё начиналось…

Судя по соцсетям, 2016-й был золотым годом. ML активно набирал обороты: TensorFlow в опенсорсе, Jupyter-ноутбуки, scikit-learn и матч AlphaGo — Ли Седоль (свело олдскулы?). Присоединяемся к тренду и вспоминаем ML-проекты Яндекса десятилетней выдержки.

Поисковый алгоритм «Палех»

Раньше поисковые системы работали по большей части как инвертированный индекс: запрос сопоставлялся со страницами, где встречались те же слова. Со временем в поиск начали добавлять клики, поведение пользователей и ссылочные факторы — всё это объединили в алгоритме ранжирования MatrixNet. А «Палех» стал следующим шагом: в поиске использовали нейросеть на базе DSSM, чтобы учитывать смысл запроса, а не только совпадение слов. Подробнее о том, как всё работало, можно почитать на Хабре.

Перевод текста с изображения в Переводчике

Яндекс Переводчик научился распознавать текст прямо на картинках. Можно было загрузить изображение — комикс, график с подписями или скан документа — и сразу получить перевод. Функция работала даже в неидеальных условиях: если текст был под углом, растянут или снят «на бегу». Распознавание поддерживало 12 языков, а перевод — любой из 74 языков, доступных на тот момент. В основе лежали технологии компьютерного зрения Яндекса — те же, что использовались в поиске похожих картинок и определении марки автомобиля по фото. А о том, как в Яндексе в 2016 году решали задачу машинного перевода для редких языков, — тут.

Первая нейросеть для прогноза осадков с точностью до минут

В Яндекс Погоду добавили нейросетевой «наукастинг» осадков — краткосрочный прогноз дождя и снега с высокой точностью. Модель использовала данные метеорадаров и свёрточные нейросети, чтобы предсказывать движение осадков на ближайшие пару часов с детализацией до отдельных районов. На коротких интервалах подход оказался точнее классических методов и улучшил прогноз «здесь и сейчас». О том, как далеко шагнуло прогнозирование погоды с помощью нейросетей в 2026-м — писали здесь, а вспомнить, что было в 2016-м, можно тут.

Определение фишинга в Браузере с помощью ML

Традиционная защита браузеров от фишинга была основана на чёрных списках опасных сайтов. Но с автоматизированными атаками, где фишинг-страницы появляются быстрее, чем их вносят в списки, в 2016-м она уже не справлялась.

Стали прямо на устройстве пользователя анализировать самые разные признаки страницы — от технических параметров до визуального оформления — и оценивать её подозрительность. А компьютерное зрение использовали, чтобы сравнивать внешний вид сайтов с известными сервисами — так подделки находились даже без обращения к внешним спискам. Подробнее рассказали в хабростатье.

Вот такие технологии из дохайповых времён. Делитесь в комментариях своими воспоминаниями об ML в 2016 году.

ML Underhood
9 975 просмотров · 63 реакций Открыть в Telegram · Открыть пост на сайте
Лучшие статьи 2025 года — выбор инженеров Яндекса

Мы уже обеими ногами в 2026-м, но неплохо и оглянуться назад. Тем более, что прошедший год подарил нам много отличных публикаций об ML. Каких именно? А об этом расскажут инженеры Яндекса.

CoDiCodec: Unifying Continuous and Discrete Compressed Representations of Audio

Очень интересный аудиокодек, для обучения которого используется всего один лосс. Он умеет восстанавливать двухканальное аудио в 44,1 кГц как из непрерывных эмбеддингов, так и из дискретных токенов. Кодек поддерживает авторегрессивное и параллельное декодирование.

VideoGLUE: Video General Understanding Evaluation of Foundation Models

Статья от DeepMind, которую представили на ICLR-2025. Авторы собрали большой бенчмарк для разносторонней оценки качества фундаментальных видеомоделей — VideoGLUE. Весь код доступен по ссылке.

В статье предлагают эффективный и наглядный формат сравнения и показывают, что текущие фундаментальные видеомодели сильно проигрывают специализированным подходам. Это говорит о том, что сейчас анализ видео — довольно перспективное и недоработанное направление с точки зрения исследований.

SAM Audio: Segment Anything in Audio

Вся линейка SAM кажется очень изобретательной, но о сегментации звука я даже и подумать не мог. А исследователи не только подумали, но и сделали очень красиво. Так же там довольно интересно собирают данные.

Об интересных статьях рассказали ❣ Николай Глазырин, Кирилл Никоров и Стас Лебедев

ML Underhood
2 712 просмотров · 18 реакций Открыть в Telegram · Открыть пост на сайте
🎄 Самые популярные посты 2025 года в канале

Праздники приближаются, а это значит, что пора суммировать всё прожитое за минувшие 12 месяцев. Выбрали пять самых популярных постов в нашем канале, на случай, если вы что-то пропустили. Приглашаем и вас суммировать впечатления от контента и рассказать, какие из постов понравились вам больше других.

Как в Яндексе заменили сложную разметку на LLM

Заголовок говорит сам за себя, но тут стоит отметить, что совсем от асессоров не отказались — им перепоручили более хитрые задачи и контроль над работой LLM. Результат — 105% качества и 60% экономии денег.

От PyTorch к MONAI: опыт команды Yandex Cloud и ШАДа в медицинском AI

Нейросети на страже здоровья. В этом посте — о том, как команда ML-инженеров из Школы анализа данных и Yandex Cloud переписали проект для распознавания редкой патологии spina bifida.

Как и зачем Алису учат понимать интонации

В 2025 году в Яндекс Станциях появились интонационные споттеры в дополнение к командным. А нужны они не только для того, чтобы колонки могли отличать обращение к ним от обращения к человеку по имени Алиса, но и чтобы сэкономить пользователю время на активационной фразе.

Как ML рассаживает деревья в Яндекс Картах

Минутка прекрасного — пост о том, как на картах появляются трёхмерные деревья. Модель не только определяет, где нужно «посадить» растение, но и то, какое именно: хвойное или лиственное.

Как LLM помогают анализировать ответы в опросах

Систематизировать ответы на открытые вопросы — то есть данные в свободной форме — непросто. Исследователями, которые проводят опросы, приходится тратить на это немало времени. К счастью, на помощь можно позвать модель. Или даже несколько.

Напоследок — несколько популярных текстов о релизах Яндекса: о YandexGPT 5 и Lite Instruct, документальном переводе и Alice AI VLM dev. Всё — жуть какое интересное.

В новом году нас ждёт ещё больше крутых проектов и, соответственно, увлекательных рассказов о них. Оставайтесь на связи и с праздниками!

ML Underhood
2 787 просмотров · 20 реакций Открыть в Telegram · Открыть пост на сайте
Что нового в Нейрометеуме — нейросети глобального прогноза от Яндекс Погоды

Новая нейросеть для глобального прогноза погоды рассчитывает 70 ключевых характеристик атмосферы на 10 суток вперёд с часовым шагом. В этом посте — немного «внутрянки» о том, что нового появилось в Нейрометеуме.

Во-первых, модель Яндекса сделали быстрой и автономной. Если численным методам нужны часы на расчёт, то эта нейросеть справляется за несколько минут. К тому же в расчёте нет зависимости от внешних данных метеорологических центров — всё рассчитывается самостоятельно, но пока что зависимость сохраняется в данных для старта.

Во-вторых, использовали инновационный подход к обучению модели. Архитектурно за основу взяли Aurora (Microsoft), а от Pangu Weather (Huawei) переняли идею обучать несколько моделей для разных временных горизонтов, а не одну. При этом смогли решить проблему несогласованности прогнозов благодаря авторегрессии в латентном пространстве. Эксперименты с гиперпараметрами (число блоков, «голов» и так далее) показали, что качество достигает насыщения. В итоге модель превзошла Aurora по числу параметров — у Нейрометеума их 1,5 млрд.

В-третьих, повысили точность прогноза осадков. В Яндекс Погоде придумали, как эффективнее работать с переменной «осадки» (zero-inflated distribution). Вот что для этого сделали:

— использовали нормировку/перемасштабирование (в основе — паттерн из MetNet от Google);
— применили специальную функцию активации;
— разработали новые функции потерь (MWAE и лосс на основе Центра Масс — CoM).

А вот и результаты:

— CSI по сильным осадкам вырос на 50% относительно бэйзлайна и более чем вдвое относительно общепринятого подхода;
— метрика bias снизилась в 10 раз и достигла уровня численных моделей;
— в сравнении с последней моделью Google (WeatherNext2) — модель показывает сопоставимое или более высокое качество прогноза осадков на ближайшие 12–18 часов.

Сейчас прогнозы Нейрометеума используют как входные данные для профильной модели осадков в Яндекс Погоде.

Подробнее о том, как устроена новая нейросеть глобального прогноза погоды, читайте на Хабре.
ML Underhood
2 339 просмотров · 46 реакций Открыть в Telegram · Открыть пост на сайте