Alice AI VLM dev на MWS Vision Bench: что конкретно изменилось в модели (и вокруг неё)

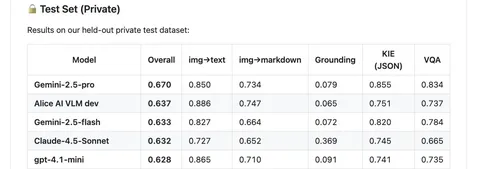
Сегодня наша базовая визуально-языковая модель Alice AI VLM dev появились на втором месте в MWS Vision Bench с результатами Overall private test: 0,637 (img→text: 0,886, img→markdown: 0,747, Grounding: 0,065, KIE (JSON): 0,751, VQA: 0,737). Alice AI VLM dev — часть большой Alice AI VLM. Расскажем, как всё обучалось.

Инженеры Яндекса сумели добиться хороших результатов благодаря обучению модели не только под пользовательские сценарии, но и под бизнесовые. Внутри компании используют VLM для автоматизации документооборота, разметок и многого другого. На этих доменах модель обучается как на стадии претрейна, так и на стадии алайнмента.

В сценарии «картинка + вопрос» качество упирается не только в генерацию ответа, но и в то, как модель видит изображение, читает текст на нём и следует инструкции. В продакшене Alice AI VLM работает в связке: «называтель» извлекает объекты и строит их иерархию с учётом текстового запроса, а VLM‑рефразер маршрутизирует запрос либо в основной VLM‑генератор, либо в специализированные ветки (например, «решатель»), либо в Alice AI LLM. Alice AI VLM dev (она же базовая VLM) — это та же модель, которая работает в продакшене как «генератор» и «решатель», но обрабатывающая запросы пользователя напрямую, без предыдущих этапов.

Обучение VLM двухэтапное: на претрейне мультимодальное next‑token-обучение на большом корпусе, а на алайнменте — SFT + RL, где модель доводят до «ассистентского» поведения.

Претрейн

Увеличили Image‑encoder и размер картинки на входе без деградации — с 896×896 до 1024×1024. Благодаря этому выросло качество работы с деталями, вроде формул, таблиц, этикеток и дорожных знаков.

Также переформатировали OCR‑данные. Раньше в датасете часто встречались пары «картинка + весь распознанный текст», что хорошо помогало учить модель непосредственно на чтение, но этого было недостаточно для некоторых других сценариев. Например для задач на понимание логической и пространственной связи между блоками текста.

Теперь обучают VLM отвечать в разных форматах на OCR-данных: выписывая весь текст самостоятельно, выписывая координаты текста вместе с ним, используя текст внешнего OCR или напрямую отвечая на вопрос пользователя. Такой grounded‑OCR улучшает извлечение таблиц и списков, а также выполнение задач на поиск контента.

Объём претрейна увеличился с 400 миллиардов до 600 миллиардов токенов, а максимальную длину контекста целенаправленно проучили до 32 тысяч. Это позволяет обрабатыватьдлинные документы и несколько изображений в одном запросе.

Алайнмент

Раньше фотоинпут получался через дообучение поверх базовой VLM Яндекса: это давало продуктовые фичи, но обновления базовой модели требовали пересборки датасетов, а по пути могли проседать базовые навыки (OCR, следование некоторым инструкциям).

В последнем релизе сделали «Алису из коробки»: та же базовая VLM стала Alice AI VLM — моделью, отвечающей пользователю. А датасеты и метрики алайнмента объединили так, чтобы одновременно контролировать показатели как «технической» мультимодальности, так и продуктовой.

Отдельно перенесли сетап RL из текстовой Alice AI LLM. Теперь оптимизируют не только правильность, но и полноту, полезность и проактивность ответа. На потоковой корзине SbS новая версия выигрывает у предыдущей в 63% случаев.

Подробнее об обучении нашей VLM — читайте в соответствующем разделе технического отчёта. Там же можно узнать и об изменениях в других моделях семейства.

ML Underhood
19 756 просмотров · 42 реакций Открыть в Telegram · Открыть пост на сайте
NeurIPS 2025: доклады и идеи, к которым хочется вернуться

Конференция завершилась, но интересного на ней было так много, что мы продолжаем рассказывать о работах и докладах, заслуживающих внимания. CTO Яндекс Поиска Екатерина Серажим тоже побывала на площадке в Сан-Диего и поделилась своим заметками.

The Oak Architecture: A Vision of SuperIntelligence from Experience

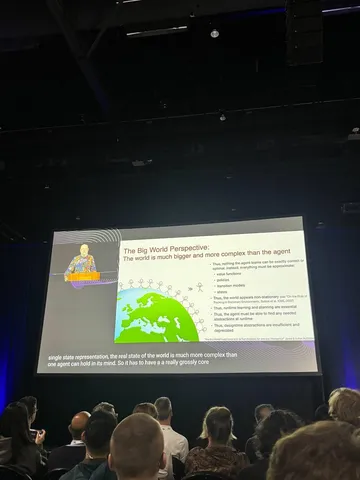
На первом фото — Сан-Диего, 8 утра. Все спешат на Invited Talk Ричарда Саттона :) Доклад рекомендую: Саттон говорит, нужно не запихивать знания в агентов, а строить их такими, чтобы они масштабируемо и непрерывно изучали мир. Предлагает концепцию того, как это может быть.

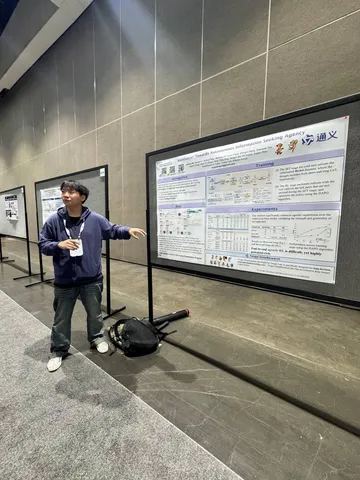
WebDancer: Towards Autonomous Information Seeking Agency

У команды есть целая серия работ про deep research: на NeurIPS попала эта статья, остальные планируют представить на ICLR 2026. Авторы хитро генерируют синтетические сложные запросы, которые требуют нескольких поисков: сначала с помощью ChatGPT и других моделей составляют цепочки поисковых шагов, затем отбирают запросы, где эти цепочки не слишком длинные и не короткие, и уже на них обучаются.

Я попросила одного из авторов посоветовать другие работы на ту же тему, которые кажутся ему стоящими, и делюсь списком:

— WebSailor;
— WebSailor v2;
— Tongyi Deep Research;
— WebThinker;
— Mind2Web;
— Mind2Web v2.

А ещё пригласила ребят к нам в Москву :)

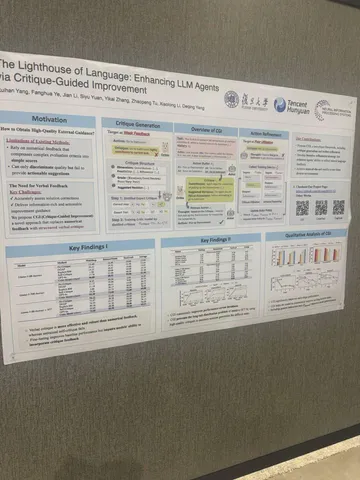
The Lighthouse of Language: Enhancing LLM Agents via Critique-Guided Improvement

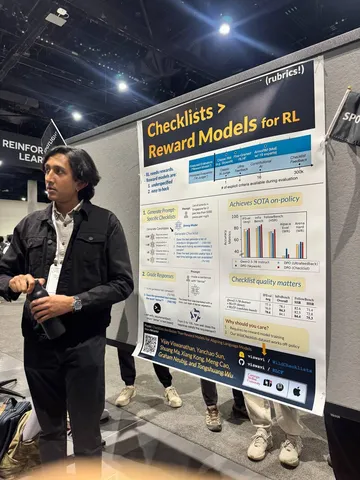
Checklists Are Better Than Reward Models For Aligning Language Models

Встретилось несколько интересных работ, где модели-генераторы улучшают с помощью моделей-критиков с текстовым фидбеком. Идея логичная: разбивать ответ на атомарные проблемы, просить модель их исправлять и учиться на этом.

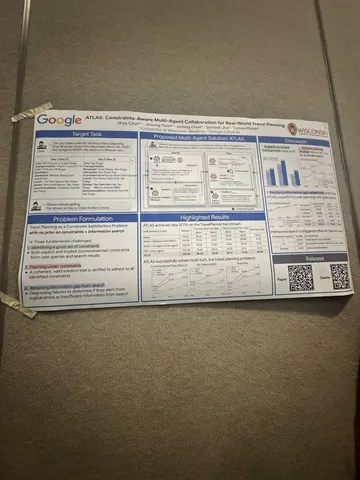
ATLAS: Constraints-Aware Multi-Agent Collaboration for Real-World Travel Planning

Ребята из Google Cloud создали агента-планировщика путешествий. Командам, которые делают нейропродукты, будет полезно посмотреть на используемые пайплайны и промпты.

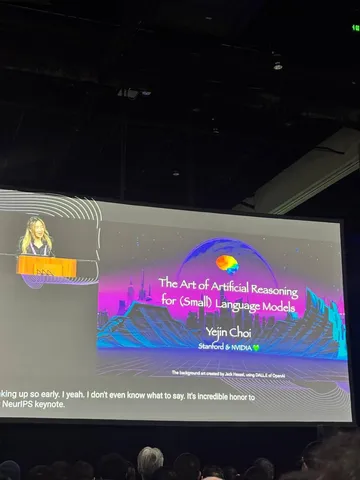
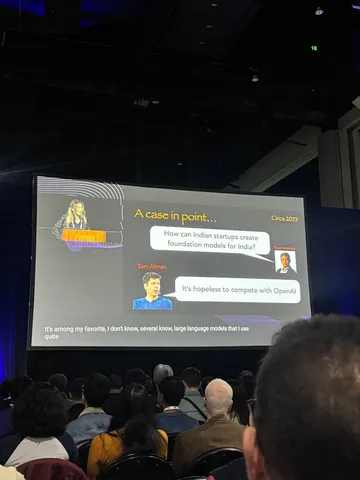
The Art of Artificial Reasoning for (Small) Language Models

Интересный кейноут Еджин Чой (Стэнфорд и NVIDIA) на тему маленьких языковых моделей. В докладе было не только визионерство, но и результаты. А ещё — мемы и трюки.


#YaNeurIPS25

ML Underhood
1 782 просмотров · 23 реакций Открыть в Telegram · Открыть пост на сайте
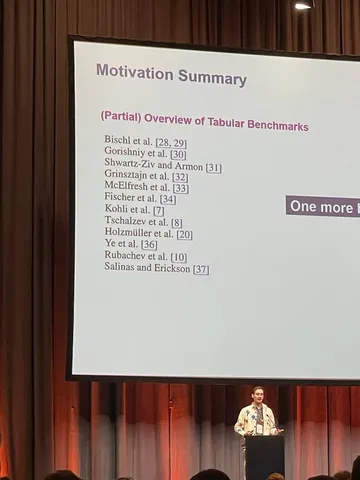
Впечатления от EurIPS в Копенгагене

Мы уже начали рассказывать о том, что в Европе в этом году впервые прошла конференция — почти как NeurIPS, только Eur. Вдогонку делимся ещё одной порцией заметок от исследователя Yandex Research Ивана Рубачёва.

— На конференции было около 2000 человек. Приехало много студентов и профессоров из Европы, но были и люди из Канады, например. Порадовал состав спикеров, как на воркшопах так и в main talks.

— Основные дни проходили в Bella Center. Но некоторые воркшопы, в том числе AI for Tabular Data, который был мне интересен, проводились в местных университетах: TU Copenhagen и South Campus U of Copenhagen.

— Sepp Hochreiter, один из авторов LSTM, а теперь и xLSTM, вместе со своими соавторами заметно форсил последнюю модель по всем направлениям. Правда, версию под табличные данные пока не показали.

— Gaël Varoquaux, один из руководителей группы SODA в Inria (люди, которые среди прочего стоят за sklearn), говорил про uncertainty estimation в эпоху LLM. Немного диссил тезис scale is all you need — в последнее время он действительно звучал отовсюду. Кстати, Gaël и его группа не остановились на sklearn и всё ещё занимаются табличными данными, исследователи из его команды были и на воркшопе.

— Мнения об основной программе заметно разнились. В целом конференция в этот раз ощущалась не такой масштабной: кому-то не хватало статей, а кому-то, наоборот, понравилось, что в основной программе больше «воркшопного» духа.

Первое фото взято из официального Twitter/X-аккаунта конференции.

#YaNeurIPS25

ML Underhood
1 939 просмотров · 28 реакций Открыть в Telegram · Открыть пост на сайте
Сегодня вышел техрепорт Alice AI

Ниже — краткий обзор ключевых технических решений и результатов, а подробнее обо всех деталях, экспериментах и выводах можно почитать в полной версии отчёта на Хабре.

Alice AI LLM
На этапе претрейна улучшили качество данных: фильтрация и аугментация повысили фактологичность ответов (+4–7% на внутреннем бенчмарке). Также собрали специализированные данные по школьным предметам, что дало прирост на образовательных задачах — модель обошла конкурентов по истории, литературе, математике и русскому языку. Усилили навыки программирования и математики за счёт алгоритмических и кодовых данных (+4,5 п.п. на LiveCodeBench). В alignment-фазе перешли к единому RLHF-пайплайну с мультиаспектным ревордом (полезность, фактологичность и др.) вместо одного «суперсигнала».


Alice AI LLM Search
Пайплайн объединяет планировщик поисковых запросов, фильтрацию и ранжирование результатов и генерацию ответа, а также поддерживает мультимодальные источники — тексты, изображения, видео и геоданные — для более полных ответов. Для обучения использовали RLHF с мультиаспектными ревордами вместо одной метрики, что упростило оценку сложных ответов. В RL-тренировке перешли к онлайн-методу GRPO, сократили этапы обучения, повысили эффективность GPU и в итоге улучшили полезность и актуальность ответов.


Alice AI ART
Обучающий датасет проанализировали с помощью Alice AI VLM, извлекли структурированные JSON-описания изображений и выявили дисбалансы в данных. На основе этого датасет для файнтюна переработали и дополнили недостающими категориями запросов, чтобы лучше соответствовать реальным пользовательским сценариям. Архитектура модели сделана двухступенчатой: на первом этапе формируется общая композиция изображения, на втором — прорабатываются высокочастотные детали. Дополнительно обучили отдельный «рефразер» — компактную LLM, которая преобразует сырые пользовательские промпты в детализированное описание сцены, сохраняя исходный смысл перед генерацией.


Alice AI VLM
Объём данных претрейна увеличили с 400 до 600 млрд токенов и расширили контекст до 32 тыс. Обновили OCR-датасет, улучшив качество чтения текста с изображений, включая рукописный, и описание визуального контента. VLM тесно интегрирован с текстовой LLM и обучается с теми же RLHF-подходами. Дополнительно в систему добавлен специализированный VLM-«решатель» для задач, требующих глубокой визуально-математической экспертизы.


Инфраструктура инференса
Инференс оптимизировали, повторно использовав KV-кэш для одинаковых частей промпта. Также помогла полная FP8-квантизация весов, активаций и KV-кэша. За счёт этого объём KV-кэша сократился почти вдвое. Дополнительно внедрили спекулятивное декодирование EAGLE-3, повысив пропускную способность генерации.
В результате новый инференс-стек обеспечивает около 5,8× ускорение по сравнению с BF16 и примерно 1,3× относительно лучших открытых решений, что позволило достичь целевых показателей скорости.


ML Underhood
19 878 просмотров · 84 реакций Открыть в Telegram · Открыть пост на сайте
NeurIPS 2025: топ-3 академических постера с площадки в Сан-Диего

Конференция подошла к концу — подводим итоги. Сегодня уже знакомый вам по обзору стендов об индустрии Максим Кузин делится личным топом научных постеров из США.

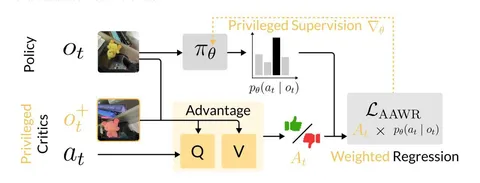
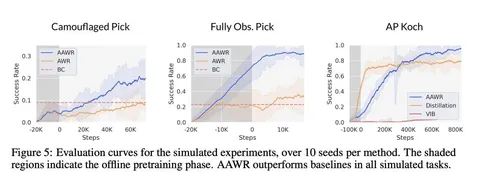
Real-World Reinforcement Learning of Active Perception Behaviors
Исследователи из University of Pennsylvania, University of Liège и UC Berkeley добавляют в RL награду за «уменьшение неопределённости» модели после обучения на сгенерированном примере. Агента заставляют действовать проактивно, самому делать нужные «обучающие» попытки. А на бенчах сильно уменьшают количество сэмплов для обучения.

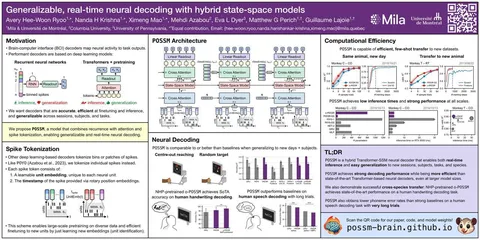
Generalizable, real-time neural decoding with hybrid state-space models
Команда учёных Mila — Quebec AI Institute, Université de Montréal, Columbia University, University of Pennsylvania и Canada CIFAR AI Chair обучают реалтайм-модель для предсказания сигналов. Трансформеры as is не подходят для случаев, когда важна скорость инференса. Поэтому авторы сделали быструю RNN и офлайн-компонент в виде трансформера с задержкой, который пересчитывается раз в некоторое время. Результат — по сравнению с онлайн-трансформером, качество практически не теряется.

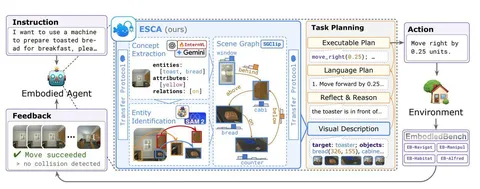
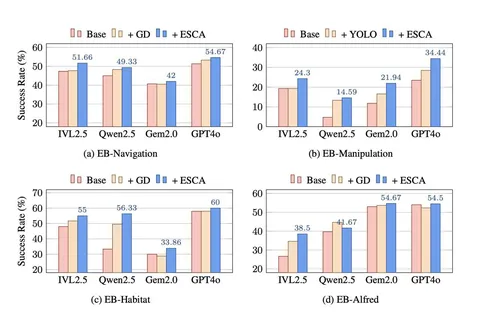
ESCA: Contextualizing Embodied Agents via Scene-Graph Generation
Исследователи University of Pennsylvania, University of Central Florida и Johns Hopkins University выделяют сущности для работы агента с камерой и строят граф отношений между ними (например, «тостер стоит на полке»). Этот граф остаётся в промпте и помогает моделям лучше ориентироваться в пространстве, видя саммари помещения, а не выделяя его явно из кадров в контексте. Хотя подходи простой, он даёт хороший прирост на бенчах.

#YaNeurIPS25

ML Underhood
1 328 просмотров · 14 реакций Открыть в Telegram · Открыть пост на сайте
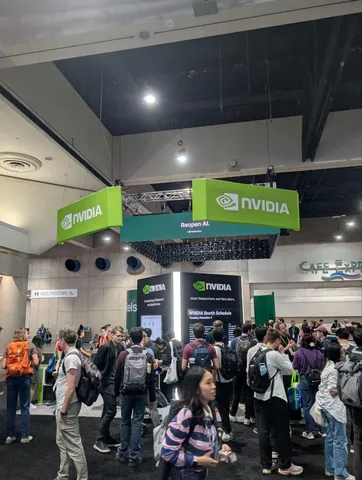
Что показали на своих стендах участники NeurIPS 2025

На конференцию в США приехали и международные гиганты, и крохотные компании. Наш коллега, руководитель качества рекламы Максим Кузин собрал для вас самое интересное:

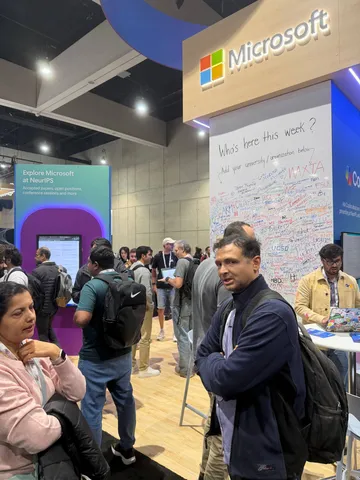
⚪Microsoft — большая часть стенда была посвящена их Copilot: показали новые функции и агентов.

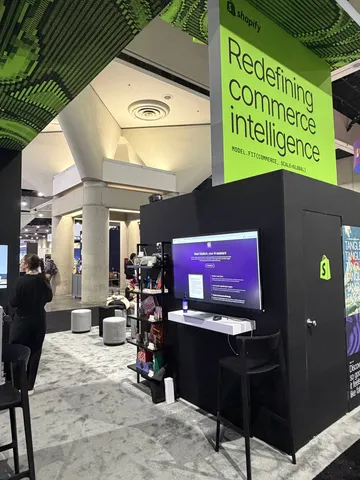
⚪Shopify — подробный технический стенд. На постерах схематично расписали все основные компоненты:

• как устроен поиск на их сайтах,
• как обучалась ecom-foundation-модель и что нужно, чтобы сделать на её основе рекомендации для сайтов клиентов,
• на чём и как учились агенты, которые определяют оптимальное разбиение товаров на категории.

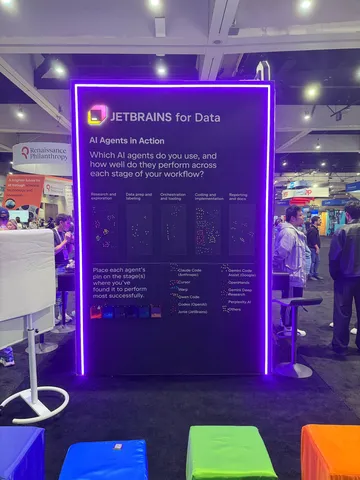
⚪JetBrains — тоже сделали акцент на своём Copilot. А ещё провели публичный опрос разработчиков с помощью канцелярских кнопок: используешь один из перечисленных инструментов? Проголосуй за него — воткни кнопку!

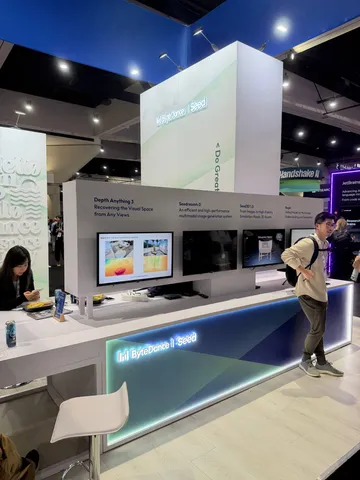
⚪ByteDance — показали демо генерации видео и 3D-моделей из текста, картинок, других видео и промптов.

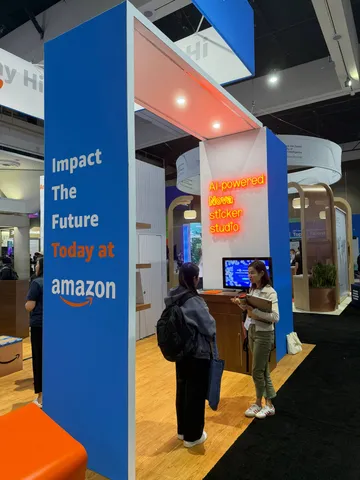
⚪Amazon — предлагали напромптить себе коллекцию генеративных стикеров и распечатать их.

⚪Sony — рассказали, как обучили агента управлять всеми машинами в Gran Turismo. Можно было даже взять джойстик и посоревноваться с ИИ!

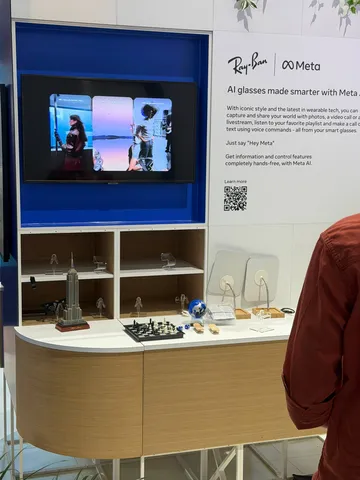
⚪Meta* — предлагали побеседовать о предметах на стенде со своим ИИ в очках RayBan.

⚪Tesla — в основном рассказывали про роботов и как делали реалистичные движения рук для Tesla Bot. Там же можно было посмотреть на самого робота, но двигает он только руками.

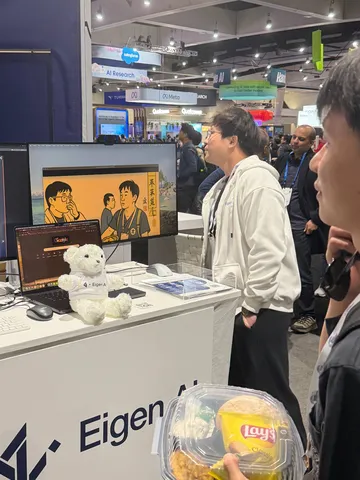
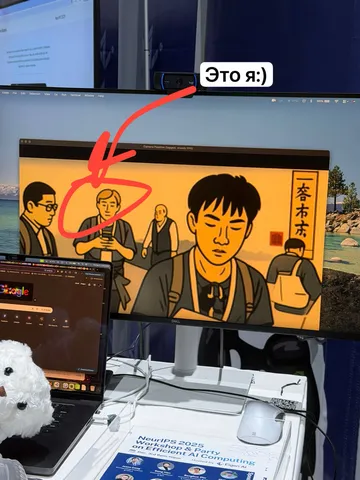
⚪Eigen AI — показывали сети, которые редактируют видео на лету: камера снимает прохожих и превращает их в плавные ролики в стиле аниме (я тоже попал в кадр!).


*Meta признана экстремистской организацией, а Facebook и Instagram запрещены на территории РФ

Больше интересного с NeurIPS ищите в наших каналах Душный NLP, 404 Driver Not Found и CV Time по хештегу #YaNeurIPS25.

ML Underhood
1 125 просмотров · 19 реакций Открыть в Telegram · Открыть пост на сайте
Это хет-трик! Мы собрали все три площадки NeurIPS 2025 (да, есть ещё одна)

Пока в США и Мексике гремела NeurIPS, в Дании проходила EurIPS. На месте событий в Копенгагене побывал исследователь Yandex Research Иван Рубачёв. Он приехал на воркшоп AI for Tabular Data со статьёй Talking Trees: Reasoning-Assisted Induction of Decision Trees for Tabular Data и делится впечатлениями от европейской версии NeurIPS.

Ещё в первый день основной программы EurIPS три человека написали мне про упоминания Yandex Research и наших работ на тему табличных данных. По моему абсолютно непредвзятому мнению, тема действительно одна из самых интересных на конференции (поэтому и прилетел я только на воркшоп).

Так сложилось, что сейчас больше всего исследований по табличным данным выходит в Евразии. Из университетов в Штатах, например, работ заметно меньше. Поэтому от воркшопа я изначально ждал многого: в таких местах обычно собираются люди ровно из той самой ниши, где сейчас происходит основная движуха. И часто воркшопы по уровню не слабее основной программы.


В следующих постах поделимся парой интересных историй с европейской конференции и расскажем подробнее о самом табличном воркшопе, ради которого Иван прилетел в Данию.

#YaNeurIPS25

ML Underhood
1 311 просмотров · 39 реакций Открыть в Telegram · Открыть пост на сайте
Немного хайпуем на постерной сессии в Сан-Диего

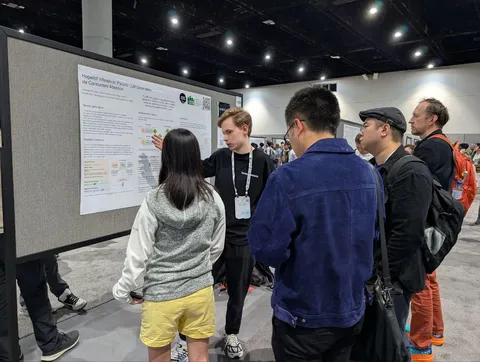
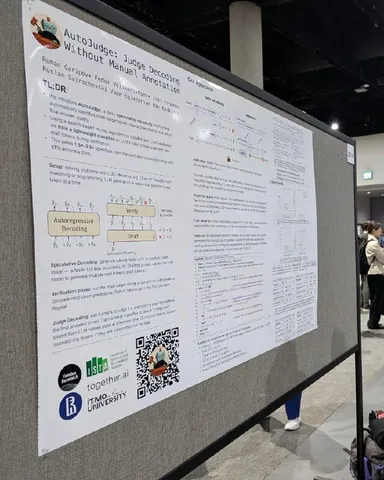
Команда Yandex Research активно участвует в постерных сессиях NeurIPS. На фото — Роман Гарипов и Людмила Прохоренкова отвечают на вопросы, поясняют нюансы и не упускают интересных обсуждений по следующим постерам:

🔴Hogwild! Inference: Parallel LLM Generation via Concurrent Attention —*️⃣наш spotlight-постер;

🔴GraphLand: Evaluating Graph Machine Learning Models on Diverse Industrial Data;

🔴AutoJudge: Judge Decoding Without Manual Annotation;

🔴Alchemist: Turning Public Text-to-Image Data into Generative Gold;

🔴Results of the Big ANN: NeurIPS’23 competition.

Если захотите глубже погрузиться в работы, рекомендуем обзор наших статей, принятых на конференцию в этом году.

Напоследок два бонуса.

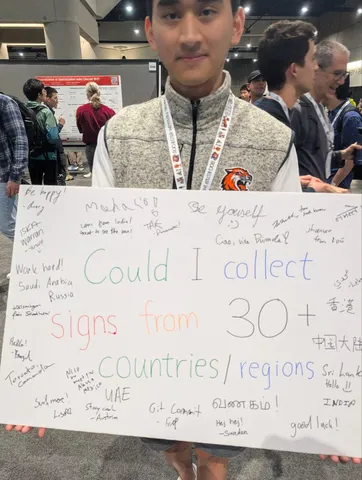
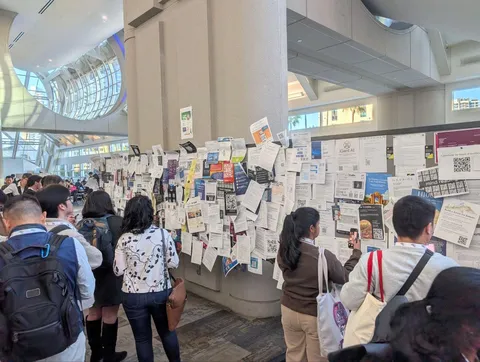
— Один из самых милых постеров сессии: участник собирал подписи и пожелания из 30+ стран. Похоже, план выполнен!

— Джоб-борд для нетворкинга: научные идеи не отходя от кассы превращаются в офферы.

#YaNeurIPS25

ML Underhood
1 472 просмотров · 27 реакций Открыть в Telegram · Открыть пост на сайте
🤖 Был бы ты человек, этот пост был бы не о тебе

Ну какая ML-конференция без крутых роботов? Вот и американскую NeurIPS 2025 они посетили. В программе:

🦾 Роботизированная рука Tesla, с которой не хочется соревноваться в армрестлинге.

🦾 Та же самая роботизированная рука Tesla, с которой по-прежнему не хочется соревноваться, но которая выглядит парадно.

🤖 Робот-бариста Turing Robot, которому хочется отдать все чаевые в мире.

🛰 Бонус: архитектурные излишества с кубриковским вайбом, который I'm sorry Dave, I'm afraid I can't do that.

#YaNeurIPS25

ML Underhood
1 388 просмотров · 27 реакций Открыть в Telegram · Открыть пост на сайте
Порция интересного с NeurIPS 2025

Конференция продолжает греметь в Сан-Диего — и в дело вступают постеры. Разные и любопытные.

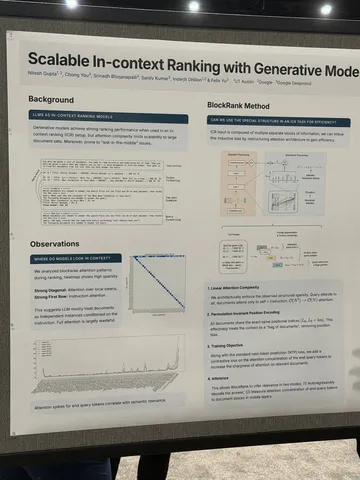
Scalable In-context Ranking with Generative Models

С развитием LLM всё чаще рассказывают об успешных подходах с использованием больших текстовых моделей для ранжирования документов под запрос или пользователя. У LLM уже хорошо сложена интуиция о том, какие документы подходят для решения пользовательской задачи по её описанию. Файнтюн помогает доучить модель под нужную область на небольшом наборе данных — это простой способ получить большую рекомендательную модель.

Авторы статьи изучили аттеншн-карты и увидели, что в таких задачах LLM обычно смотрит либо на промпт/контекст, либо на токены внутри документа. Взаимодействия между разными документами практически не происходит (или происходит внутри токенов контекста). Поэтому инженеры с помощью маски на файнтюне смогли оптимизировать аттеншн до линейной сложности без потери качества, не испортив претрейн.

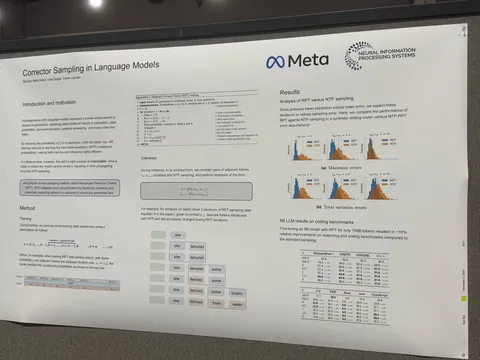
Corrector Sampling in Language Models

Очень простая в исполнении идея. Авторы утверждают, что увеличивают качество на сложных бенчмарках на 10%. В обычном NTP-инференсе модель всегда предсказывает следующий токен при учёте контекста. Обратного влияния не существует — если в будущем модель поймёт, что токен был неправильный, то исправить его не сможет.

В статье предлагают RPT (Resample-Previous-Tokens). Во время обучения с вероятностью q токен перемещается на k позиций вперёд. Обучив такую модель, во время инференса мы можем делать два предикта: обычный NTP и RPT (токен на позиции x от модели; показываем ей токены до и после и просим восстановить токен на позиции x). На каждой итерации модель может дописать новый токен и исправить предыдущий.

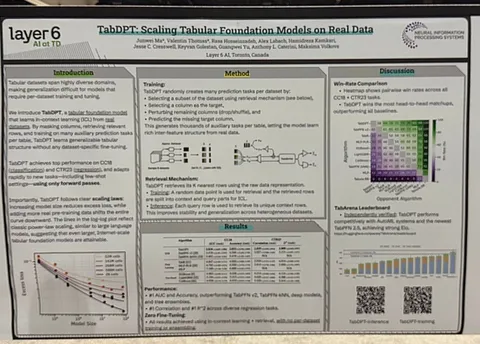
TabDPT: Scaling Tabular Foundation Models on Real Data

Авторы пробуют обучать tabular foundation model. Взяли много табличных задач, представили строку с фичами как последовательность и обучили трансформер на классические претрейн-задачи (восстановить фичу по другим, угадать таргет, ретривал на похожие строки и так далее). Утверждается, что такая модель хорошо скейлится по параметрам (качество растёт при увеличении модели) и легко адаптируется к новым задачам в few-shot-режиме без дообучения. Показывают высокие результаты на публичных лидербордах.

Интересное увидел ❣ Максим Кузин

*компания Meta признана экстремистской, её деятельность в России запрещена.

#YaNeurIPS25

ML Underhood
1 442 просмотров · 25 реакций Открыть в Telegram · Открыть пост на сайте
Как прошёл первый день NeurIPS 2025 в США

Пока все набираются сил перед новыми воркшопами и докладами, исследователь Yandex Research Роман Гарипов делится впечатлениями о том, как прошёл первый день конференции в Сан-Диего.

После очереди на регистрацию мы направились на туториал Human-AI Alignment: Foundations, Methods, Practice, and Challenges. Провёл его Yoshua Bengio, один из отцов Deep Learning.

Потом было ещё несколько интересных выступлений:

🔴 про бенчмарки для reasoning, которые требуют робастности к минимальному изменению промпта,
🔴 про алайнмент от людей из академии, frontier ai labs и Bengio,
🔴 туториал по scaling test time compute/parallel reasoning от Beidi Chen/Zhuoming Chen из CMU и других.

На стендах компаний и университетов я успел пообщатся с профессорами из Канады, в том числе Mila (research institute). Все они охотно включались в обсуждения и делились своим взглядом на область. Ещё было много трейдеров из крупных фондов.

Закончился день на вечеринке от Together AI. Там собрались коллеги из Nvidia, Сerebras Systems, Google DeepMind, Snapchat и других известных компаний. Понетворкались, приятно удивило, что в Together AI хорошо знают Яндекс и Высшую школу экономики.


Как дела в Мексике — на второй площадке NeurIPS 2025 — читайте в канале CV Time.

#YaNeurIPS25

ML Underhood
1 147 просмотров · 27 реакций Открыть в Telegram · Открыть пост на сайте
NeurIPS 2025 продолжается: старт в США

В этом году конференция проходит сразу в двух странах. Про Мексику мы уже рассказывали, теперь делимся новостями из американского города Сан-Диего, где недавно закончилось открытие.

На первый день конференции приехали более 18 тысяч человек. Шестеро из них — наши коллеги-яндексоиды.

На фото те, кто собирают для вас самое интересное, vs очередь, которую им пришлось преодолеть ради этого.

#YaNeurIPS25

ML Underhood
1 356 просмотров · 31 реакций Открыть в Telegram · Открыть пост на сайте
В Мехико жара — и это мы сейчас не о погоде, а о NeurIPS

Продолжаем рассказывать о том, что происходит на полях конференции. Руководитель группы AI-планирования робота доставки Дмитрий Быков посетил любопытный воркшоп NORA: The First Workshop on Knowledge Graphs & Agentic Systems Interplay и поделился впечатлениями.

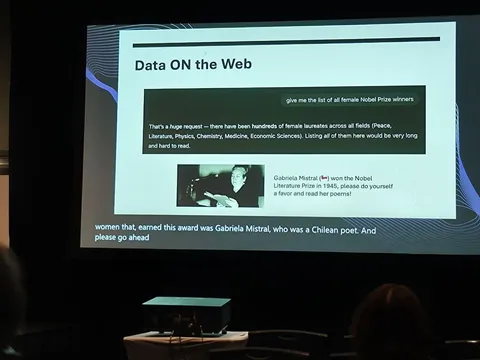
Авторы пытались решить проблему того, что способ запоминания знаний в языковых моделях через веса далеко не самый эффективный и создаёт много галлюцинаций. И даже поиск через интернет не спасает от артефактов — особенно на сложных запросах. Например, была проблема с вопросом обо всех женщинах Нобелевских лауреатах.

Разработали конкретные онтологии и способ извлечения знаний из них (graph ql и поиск по близости эмбеддингов). В целом, для конкретных даже сложных примеров это достаточно хорошо работало.

При этом проблема получения онтологий не из структурированных данных остаётся акутальной. Авторы возлагают большие надежды на обработку с помощью LLM, но пока так не делают.

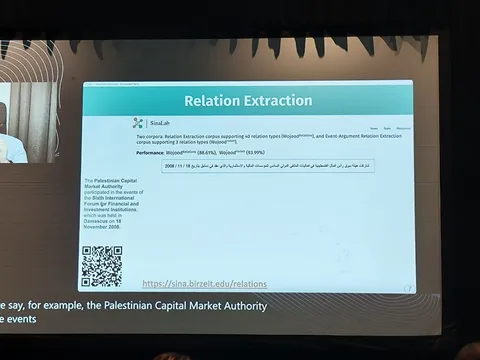
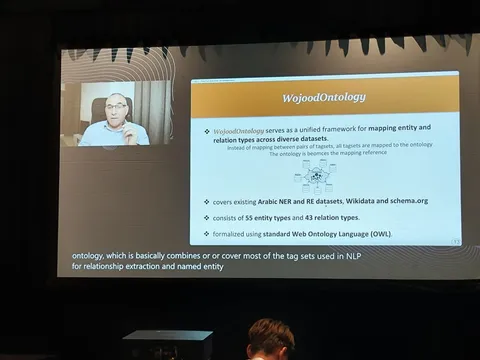
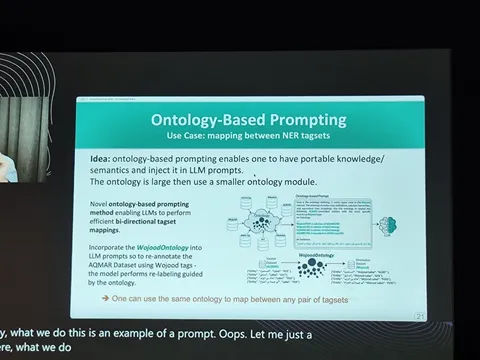
Ещё решил послушать второй доклад по схожей теме. Тут в основном всё было сосредоточено на арабском языке.

Рассказали, как собирали онтологию — по сути, обучили BERT на ner и entity linking. Имели порядка 50 возможных отношений между объектами, часть из которых могла быть достаточно похожей. В итоге так заполнили онтологию, докинули в промпт ChatGPT значения и получили прирост по метрикам.


#YaNeurIPS25

ML Underhood
2 527 просмотров · 18 реакций Открыть в Telegram · Открыть пост на сайте
Всего 38 часов лёту — и мы на NeurIPS в Мехико!

В этом году конференция проходит сразу в двух странах: США и Мексике. Мы будем вести репортажи из обеих, а начём с Мехико, где уже подошёл к концу первый день. Примечательное собрал Дмитрий Быков, руководитель группы AI-планирования робота доставки.

Лететь в Мексику через Китай оказалось очень необычным опытом :) Маршрут проходит через Аляску, и зимой это невероятно красиво: почти всю дорогу из окна был необычный вид на солнце (картинка 1). В отличие от заката, здесь видна другая часть спектра. Кажется, подобное можно увидеть разве что на Северном полюсе или вот так — из самолёта.

В первый день мы посетили большой воркшоп NeurIPS 2025 Workshop on Embodied and Safe-Assured Robotic Systems. Расскажу о том, что запомнилось с него и в целом.

Toward Efficient and Reliable VLMs
for Real-World Autonomous Systems

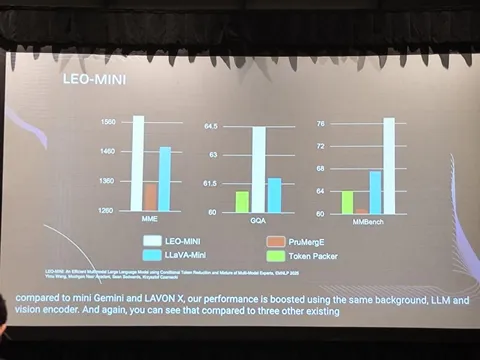
Работа на тему улучшения VLM. Изначальная идея авторов была максимально простой: часто для получения нужной информации используют несколько разных энкодеров и затем их фьюзят.

В модели LEO исследователи как раз отказались от фьюзинга и получили SOTA по метрикам — но столкнулись с очень долгим инференсом. Ну а в LEO-mini они попытались разобраться, в чём именно проблема фьюза. Оказалось, что если добавить текстовый запрос, модель может понимать, какая информация из каких энкодеров нужна для конкретной задачи.

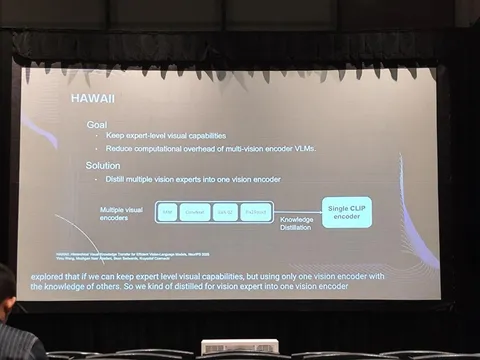
Однако моделей становилось много, и в работе над Hawaii авторы решили пойти дальше: с помощью CLIP дистиллировали выходы всех энкодеров в один CLIP-энкодер. В результате получилась одна модель с одним энкодером.

Systematizing the Unusual: A Taxonomy-Driven Dataset for Vision–Language Model Reasoning About Edge Cases in Traffic

Рассказ об эдж-кейсах в автономном вождении — причём самых разных типов и причин.

Кейсы авторы собирали вручную из интернета, и на их основе построили онтологию дорожных опасностей и ожидания корректного поведения модели.

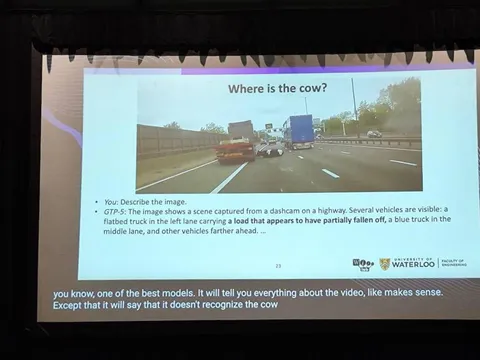
Забавно, что было сделано сравнение с GPT-5: в целом видно, что есть прогресс, но при этом текущие метрики проседают. Например, в кейсе с дорогой и коровой (картинка 2) GPT-5 не видит корову, даже если напрямую спросить о ней (при этом на кропе корову распознаёт).

Diversity-Guided Genetic Algorithm for Safety-Critical Scenario Generation in Autonomous Driving Testing

А вот это уже совсем необычная вещь — вызывающая у меня сомнения, но всё же любопытная.

Исследователи решили генерировать сложные сценарии с помощью генетических алгоритмов. У них был набор признаков, и они прямо генетическим алгоритмом смешивали эти признаки, «максимизируя разнообразие».

Имхо: о настоящем разнообразии здесь речи идти не может — потому что разнообразие в таких задачах — это редкие, неожиданные случаи, а не механическая генерация «разнообразных» сцен по шаблону.


Больше о том, что было интересного на тему безопасности и масштабируемости автономного транспорта, написали в канале @DriverNotFound.

#YaNeurIPS25

ML Underhood
1 280 просмотров · 27 реакций Открыть в Telegram · Открыть пост на сайте
Как прошла CIKM 2025: взгляд изнутри

Недавно в Сеуле закончилась международная конференция CIKM 2025. Своими впечатлениями о ней поделился Александр Михеев, руководитель группы разработки сервисов моделей.

Мне впервые довелось съездить на CIKM. Сеул порадовал и золотой тёплой осенью (днём температура поднималась до +19), и хорошо организованной конференцией в центре знаменитого района Гангнам.

Послушал много интересных докладов. Больше всего впечатлили работы от крупных китайских компаний: TikTok, Kuaishou, Alibaba, Meituan, NetEase. В частности, удалось подробно поговорить с коллегами из Kuaishou. Это вторая по популярности платформа для просмотра и загрузки коротких видео в Китае, которая в этом году наделала шума техническим отчётом об их end-to-end-генеративной системе рекомендаций OneRec. На CIKM они представили серию сильных работ, напрямую релевантных направлению развития рекомендательных систем в Яндексе.

Для меня, как представителя ML-инфраструктуры, самым интересным был доклад по статье MARM: Unlocking the Recommendation Cache Scaling-Law through Memory Augmentation and Scalable Complexity. В ней предлагается для трансформерных рекомендательных моделей перенести часть вычислений KV-матриц в офлайн, складывать их в отдельное хранилище и переиспользовать при инференсе в реалтайме. С инфраструктурной точки зрения схема нетривиальна: из-за большого размера KV-матриц возрастает нагрузка на пропускную способность отдельных компонентов — сети и шины памяти. Но при личном разговоре с докладчиком удалось узнать основные приёмы, которые помогают смягчить эти ограничения. Всё протестируем и вернёмся рассказать о них.

Из любопытных впечатлений. Я ехал на конференцию с ощущением, что буду тихо сидеть в углу и смотреть на тяжеловесов с передового края науки (индустриальной, прикладной, академической), до которых нам ещё далеко. А на деле, по многим направлениям уровень наших исследований и инфраструктуры рекомендательных систем не уступает крупным зарубежным компаниям. Мы можем чаще публиковать доклады о наших внедрениях на академических конференциях.

При этом огромная конкуренция в Китае стремительно продвигает индустрию рекомендательных систем вперёд. Поэтому расслабляться однозначно не стоит.


Продолжаем следить за индустрией и рассказывать о главных мировых ML-конференциях.

ML Underhood
1 545 просмотров · 21 реакций Открыть в Telegram · Открыть пост на сайте
Yandex Research везёт пять статей на NeurIPS 2025

Не за горами NeurIPS 2025 — одна из главных конференций в области машинного обучения. Рассказываем о принятых на неё работах исследователей Yandex Research (и не только).

Hogwild! Inference: Parallel LLM Generation via Concurrent Attention

Исследователи предлагают новый подход к ускорению LLM: несколько LLM-агентов запускаются параллельно с возможностью их синхронизации через совместно обновляемый KV-кэш. Реализуется с помощью механизма Hogwild! Inference. Все агенты мгновенно «видят» генерации друг друга и за счёт этого могут пробовать разные способы решения задач, распределять подзадачи между собой, корректировать ошибки друг друга.

Статья получила отметку spotlight — такой статус только у 3% работ, отправленных на NeurIPS.

AutoJudge: Judge Decoding Without Manual Annotation

В статье предложили алгоритм майнинга данных для выявления «важных» токенов, влияющих на качество ответа при использовании Speculative Decoding в генерации текста LLM. Метод не требует человеческой разметки и автоматически определяет токены, которые можно безопасно принять, ослабив критерий принятия токенов драфтовой модели, без ухудшения качества ответа.

Авторы обучают компактную модель-классификатор, использующую внутренние представления таргетной и драфтовой LLM для предсказания важности токенов.

Интеграция модели в vLLM повышает скорость генерации текста с использованием Speculative Decoding до 1,5 раз.

GraphLand: Evaluating Graph Machine Learning Models on Diverse Industrial Data

В ML на графах есть известная проблема с бенчмарками: существующие датасеты покрывают мало доменов, задачи далеки от практики, а в ряде датасетов были допущены ошибки при сборе данных.

Авторы делают шаг к решению этой проблемы: они предлагают GraphLand, бенчмарк из 14 графовых датасетов из различных индустриальных приложений. Некоторые датасеты подготовлены на основании открытых источников, а другие собраны специально для бенчмарка из данных нескольких сервисов Яндекса.

GraphLand позволяет сравнивать графовые модели на широком спектре задач. Графовые нейросети дают хорошие результаты и имеют большой потенциал для использования в индустриальных приложениях. В то же время, существующие графовые фундаментальные модели (Graph Foundation Models) показывают слабые результаты, то есть задача разработки таких моделей ещё далека от решения.

Alchemist: Turning Public Text-to-Image Data into Generative Gold

В статье представили новую методологию создания универсальных наборов данных для файнтюнинга (SFT) моделей преобразования текста в изображение (T2I).

Методология использует предварительно обученную генеративную модель YandexART для оценки эффективных обучающих примеров. С её помощью создали датасет Alchemist, содержащий 3350 пар «картинка-текст» и выложенный в открытый доступ.

Этот датасет значительно улучшает качество генерации пяти общедоступных T2I-моделей, сохраняя при этом разнообразие и следование промпту. Веса дообученных моделей также выложены в открытый доступ.

Подробнее о решении мы писали в телеграм канале CV Time.

Results of the Big ANN: NeurIPS'23 competition

Статья основана на результатах конкурса Big ANN Challenge, который прошёл в рамках NeurIPS 2023. Его цель — разработка методов векторного поиска (ANN-поиск) в востребованных практико-ориентированных сетапах.

Рассматривались следующие сценарии: векторный поиск с использованием метаданных; поиск, при котором распределения запросов отличается от распределения базы данных (text-to-image); сетап с регулярно обновляющимися базами данных; а также поиск по спарсовым эмбеддингам.

В публикации подробно описываются эти сетапы, наборы данных, метрики и подходы участников, которые показали значительное улучшение точности и эффективности поиска по сравнению с базовыми методами. Результаты дают представление о современных достижениях и направлениях развития в области ANN-поискa.

💫 По традиции инженеры и исследователи Яндекса поедут на конференцию и будут делиться самым интересным.

#YaNeurIPS25

ML Underhood
1 775 просмотров · 59 реакций Открыть в Telegram · Открыть пост на сайте
Моменты CIKM’25 (и не только)

Делимся яркими кадрами с конференции.

1 — Коля Савушкин допытывается о всех подробностях у авторов MARM.

2 — Что происходит с постером, когда нет внятного ТЗ.

3–4 — Кто хорошо поработал на конференции, того покормили.

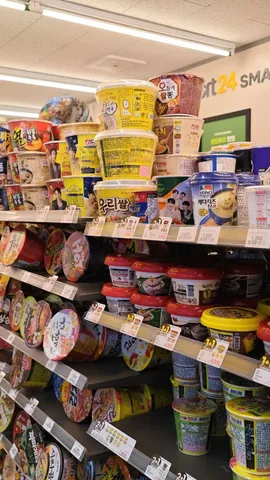
5 — Лапшу на уши на CIKM не вешали, пришлось пойти в сеульский супермаркет.

ML Underhood
1 981 просмотров · 31 реакций Открыть в Telegram · Открыть пост на сайте
CIKM’25 — горячий привет из Южной Кореи

С 10 по 14 ноября в Сеуле проходит CIKM 2025 — одна из крупнейших конференций на стыке ИИ, машинного обучения и баз данных.

Мы уже рассказывали в @RecSysChannel о ожидаемых темах этого года, а теперь делимся впечатлениями команды рекомендательных технологий Яндекса от второго дня конференции.

Сергей Лямаев:

Сегодня мне показались интересными две статьи от Kuaishou (Pantheon и MARM), InterFormer от Meta*, серия статей от Airbnb (Beyond Pairwise Learning-To-Rank At Airbnb; Learning to Comparison-Shop; Maps Ranking Optimization in Airbnb). На постерной сессии обменялись опытом с ребятами из ресёчерской команды Snapchat (их постер) про обучение семантических ID, они тоже пробуют имплементировать OneRec.

Николай Савушкин:

Понравилась статья Action is All You Need от Kuaishou (очень популярная платформа коротких видео в Китае). Удалось пообщаться после доклада с автором, уточнить детали, которых не было ни в статье, ни в докладе.

Также подошли к автору
MARM и расспросили подробности, которые нигде не были упомянуты.

Александр Михеев:

Посетил занимательный доклад по статье InstANNS от группы из Сеульского университета. Для задачи приближенного поиска ближайших соседей предлагают перенести часть фильтрующих вычислений в контроллер SSD при помощи хитрой NVMe-операции, чтобы гонять меньше данных в память и повысить пропускную способность диска.

Сама идея использования вычислительных ресурсов диска не является новой, и такой перенос нагрузки выглядит разумным и уместным. А забавный факт, к сожалению, в том, что эта хитрая NVMe-операция пока не существует и не поддержана ни одним из существующих SSD-дисков. Поэтому авторы её запрограммировали в специальном NVMe-симуляторе и зарепортили потенциальный профит :)


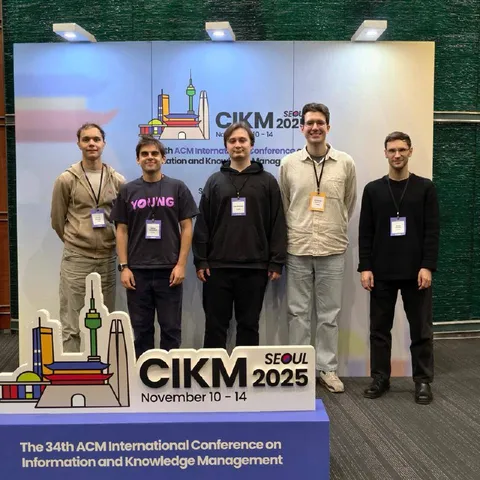
Кстати — на фото те самые ребята, которые принесли нам новые заметки с места событий.

ML Underhood


* Компания Meta признана экстремистской; её деятельность в России запрещена.
1 876 просмотров · 25 реакций Открыть в Telegram · Открыть пост на сайте
Яндексоиды на EMNLP 2025: нашли знакомые лица?

Продолжаем делиться новостями о ежегодной конференции Empirical Methods in Natural Language Processing. В Душном NLP рассказываем о статьях, которые запомнились коллегам. А здесь поговорим о работах, которые они привезли в Китай.

В этом году на конференцию приняли сразу две статьи из Яндекса. Обе — от команды машинного перевода.

1. Refined Assessment for Translation Evaluation: Rethinking Machine Translation Evaluation in the Era of Human-Level Systems

Соавторы исследования — ребята из Together AI.

Работа посвящена проблеме оценки качества машинного перевода. Несмотря на впечатляющий прогресс LLM, задача перевода ещё далека от того, чтобы считаться решённой: современные системы хорошо справляются с новостными и бытовыми текстами, но далеко не всегда — с переводом научных статей или художественной литературы.

Мы собрали новую экспертную разметку англо-русских переводов с WMT24 и показали, что проблема заключается не только в протоколах оценки, но и в низком качестве крауд-разметки. Наши эксперты — профессиональные лингвисты и переводчики — находят в среднем в семь раз больше ошибок (4,66 против 0,65 на сегмент), чем асессоры в официальной разметке WMT24.

Также мы предложили протокол RATE (Refined Assessment for Translation Evaluation), который объединяет выделение ошибок с оценкой по 100-балльной шкале ключевых характеристик перевода — точности сохранения смысла (accuracy) и естественности/читаемости текста (fluency). RATE использует упрощённую категоризацию ошибок и расширенную шкалу их критичности, что делает анализ систем более информативным, при этом результаты разметки можно конвертировать для сравнения с существующими стандартами MQM и ESA.

Результаты показывают, что современные модели действительно превосходят человека по точности передачи смысла, но заметно уступают в естественности и читаемости текста. При этом по нашей разметке системы разделяются статистически значимо, в отличие от официальных оценок WMT24, где большинство моделей оказывается в одном кластере. Более того, становится очевидно, что без экспертной разметки и продуманных протоколов невозможно развивать качество перевода: по формальным метрикам WMT24 можно сделать вывод, что задача перевода решена, однако наши данные показывают, что это далеко от реальности — количество ошибок на сегмент остаётся высоким даже у лучших систем.


2. Yandex Submission to the WMT25 General Translation Task

В этой работе описывается участие Яндекса в ежегодном соревновании по качеству перевода в рамках конференции WMT.

Мы работаем с направлением перевода с английского на русский, используя специализированную модель, построенную с помощью дообучения pretrain-версии YandexGPT. Процесс обучения состоит из нескольких стадий.

Сначала мы делаем дополнительное предобучение для адаптации к многоязычности и переводу (post-pretrain). Затем — стандартное обучение с учителем (SFT) на корпусе параллельных документов с использованием P-Tuning. Далее — применяем новую схему алайнмента в два этапа:

🔴обучение по методике curriculum learning с расписанием сложности,
🔴исправление ошибок модели с использованием в качестве положительных примеров постредактированных человеком текстов (активное обучение) и адаптация под универсальный формат тегов.


Об исследованиях рассказали их авторы Дмитрий Попов и Николай Карпачёв ❣ специально для ML Underhood
2 248 просмотров · 23 реакций Открыть в Telegram · Открыть пост на сайте
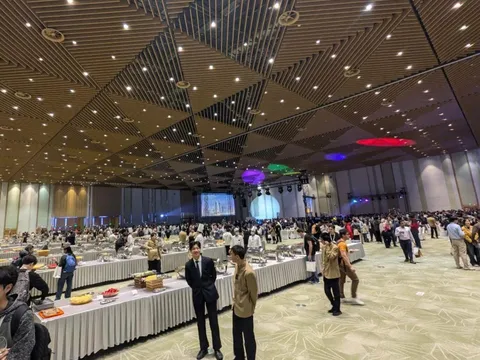
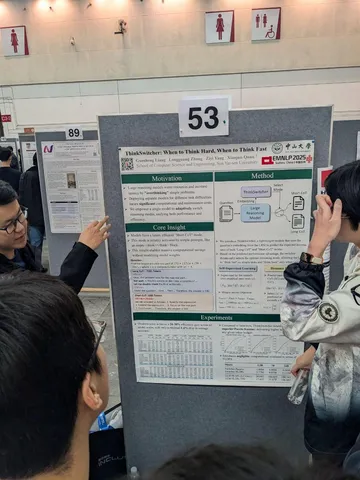
Это отложенное сообщение: читайте, как прошло открытие EMNLP 2025, пока мы отсыпаемся и готовимся к новому дню

В этом году Conference on Empirical Methods in Natural Language Processing (или просто EMNLP) проходит в Сучжоу.

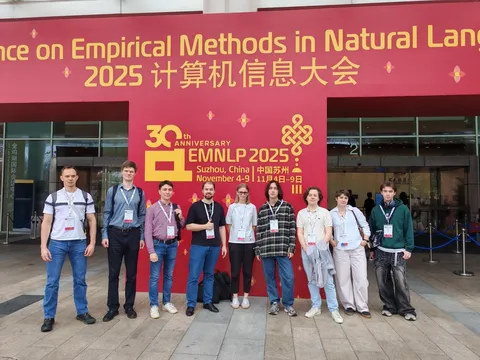
Скоро расскажем, какие статьи привезли в Китай наши коллеги и что интересного они узнали. А пока делимся несколькими кадрами с открытия и велком-ужина. В главных ролях: Екатерина Еникеева, Владислав Негодин, Николай Карпачёв, Александр Шишеня, плюшевая панда и постер #53.

ML Underhood
1 662 просмотров · 23 реакций Открыть в Telegram · Открыть пост на сайте
Как устроена первая Нейроредакция в Яндексе

В 2023 редакция ПромоСтраниц, выросшая из Дзена, начала эксперименты с LLM в написании лонгридов для клиентов. Первый нейротекст о пляжах Турции команда выпустила в апреле. Примерно тогда же команда собрала фреймворк «Барсук» — с промптами для каждого этапа работы от брифа до финальной версии.

Дальше редакция стала оптимизировать процесс:

— Сделали макрос на базе «Барсука», в который загружается бриф от клиента и тема, а дальше автоматически формируются нужные промпты.

— Добавили эмулятор действий пользователя. Один раз записываем, куда кликать, что вставлять и нажимать, а потом программа воспроизводит эти действия сколько угодно раз.

Теперь всё работает так: вставляем бриф и план, нажимаем кнопку — компьютер сам копирует промпты, отправляет их в нейросеть, получает ответы, а потом формирует чат. Из него копируем весь диалог в файл и передаём редактору, который очищает черновик от вспомогательных промптов. В итоге остаётся текст, который нужно немного дотюнить — примерно как от стажёра или джуна.


ИИ-редактор внутри кабинета

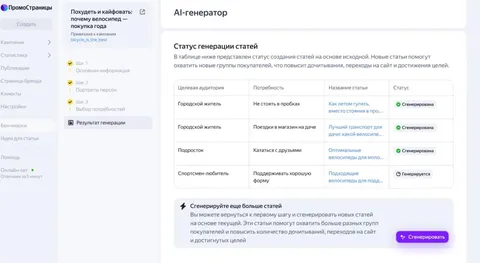
Дальше редакция захотела поделиться своими инструментами и наработанной экспертизой с клиентами. Для этого начали строить генератор текстов внутри клиентского кабинета в ПромоСтраницах. Сейчас там доступны два инструмента: «размножатор» и «улучшатор».

Размножатор. Рекламодатель или нейросеть создают описание продукта; выделяются аудитории, которым он может быть интересен и для каждого сегмента подбираются потребности, которые нужно обыграть в тексте. Пишется исходная статья, которая потом рерайтится под разные ЦА. Описание продукта остаётся тем же, но сценарии, акценты и подача меняются.

Улучшатор. Работает со стилистикой, помогает убрать воду, упростить, переформулировать заголовки, добавить конкретику, написать призыв к действию; можно применить как ко всему тексту, так и к фрагменту.

Кроме этого, команда разрабатывает генератор полного цикла, который сможет создавать тексты с нуля, под конкретные цели и продукты.

Результаты

За время существования Нейроредакция выпустила 1196 нейростатей, и многие из них показали метрики лучше человеческих. Ещё несколько цифр:

— 1–2 часа вместо 8 на производство текста;
— х2 текстов при том же бюджете;
— +80 млн рублей за счёт экспресс-запусков.

Благодаря росту производительности команда смогла не только сократить время на тексты, но и предложить новые форматы для партнёров, например, экспресс-пакеты для быстрого запуска кампаний.

Обычный флоу работы выглядит так:
— до 5 рабочих дней на темы и планы статей; до 8 рабочих дней на написание, в среднем пакет включает 5 текстов.
Дорогой пакет под экспресс-запуск:
— 10 текстов за 5 рабочих дней.

При этом недорогие пакеты также продолжают обслуживаться, но Нейроредакция успевает за то же время сделать чуть больше, чем обычные авторы или агентства.

ML Underhood
2 829 просмотров · 28 реакций Открыть в Telegram · Открыть пост на сайте
Как YandexGPT научили размечать тикеты и экономить время разработчиков

DutyGPT — классификатор на базе YandexGPT 5 Lite в Яндекс Облаке, который по тексту тикета в трекере предсказывает, какой команде его логичнее всего передать. Раньше разработчики читали каждый тикет, сверялись с таблицами зон ответственности и вручную проставляли компоненты. У одного человека на это уходило до 25 часов в месяц, без учёта времени на исправление ошибок маршрутизации.

Техлид разработки общих AI-решений в Райдтехе Василий Дмитриев рассказал об инструменте, который освободил сотрудников от рутинной задачи.

Всё работает в реальном времени: как только в трекере создаётся тикет, автоматический триггер отправляет его содержимое в DutyGPT. Текст уезжает в дообученную модель, и мы получаем предсказание — команду и вероятность. Модель сама пишет в карточке комментарий вида «предсказываю такую-то команду с такой-то вероятностью» и проставляет нужную компоненту.

Дальше включаются стандартные триггеры трекера: по компоненте вызывается дежурный соответствующей команды. Если модель ошиблась, дежурный перевешивает компоненту или пингует людей. Все такие исправления возвращаются к нам как новые размеченные примеры для следующего дообучения.

Как происходит обучение

Перед запуском рассматривался вариант обучения без файнтюна — условный zero/few-shot на «голом» LLM. Но в проде его не пробовали: чтобы это работало, модель нужно кормить подробными описаниями зон ответственности каждой команды, а это десятки сущностей (в одной группе — ~30, а, например, в Доставке — 50+). Нужна постоянная ручная поддержка актуальности. Поэтому пошли путём дообучения под нужные домены.

Данные для дообучения на задачу классификации собираются из реальных выборок тикетов от разных команд. Стартовали с небольшой выборки с точностью около 40% — никуда не выкатывали, просто наблюдали.

Дособрали данных — подскочили до 69% и задумались, много это или мало. Померили человеческую точность на этом же процессе и получили около 70%. Фактически модель уже размечала «как человек» — с этим результатом и решили выкатываться. Ну а дальше заработал автоматический сбор правильных и неправильных кейсов. Менее чем за год дошли до стабильных 75%+ по организациям, а в некоторых командах — до ~80%.

Важно понимать, что 100% никогда не будет, потому что у команд появляются новые зоны ответственности, и модель нужно постоянно переобучать. Но дойти до 85–90% — реальная цель (по всем командам).

У проекта есть отдельная доска для контроля качества разметки, и когда на ней видна деградация (модели без дообучения закономерно «плывут»), вручную запускается новый цикл обучения: собираются свежие тикеты по конкретным командам и обновляется датасет. Ближайший план — автоматизировать этот контур, чтобы переобучение происходило самостоятельно, примерно раз в месяц.

Результаты

С марта 2024 DutyGPT сэкономил ~1000 часов у разработчиков на разметке тикетов. С момента запуска к автоматической разметке присоединились порядка 89 команд.

ML Underhood
2 387 просмотров · 42 реакций Открыть в Telegram · Открыть пост на сайте
Третий день RecSys 2025: индустриальный трек

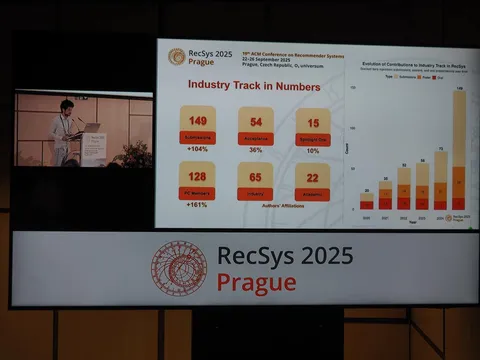
Конкуренция на индустриальном треке растёт: +104% сабмитов к предыдущему году. Всё, что выделил из этого многообразия работ Иван Романов, — читайте ниже.

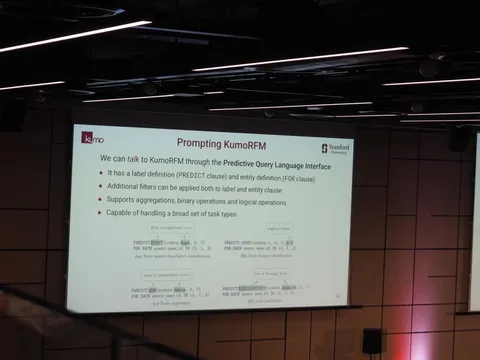
Всё чаще звучало слово latency. Даже keynote оказался практичным: Jure Leskovec (именитый профессор из Стэнфорда) прорекламировал свой стартап Kumo — AutoML на графовых нейросетях с SQL-подобным языком для fit-predict по таблицам. Мне запомнился «наброс», что существует опенсорс-решение (CARTE: Pretraining and Transfer for Tabular Learning), которое из коробки даёт аналогичные результаты.

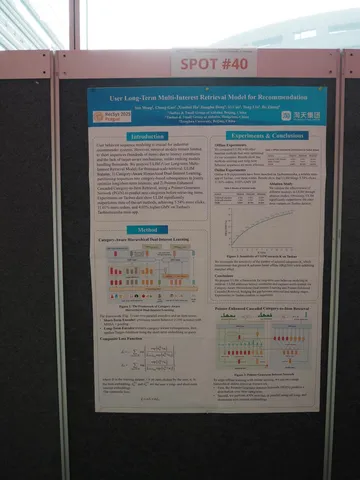
Следующая статья зацепила названием — User Long-Term Multi-Interest Retrieval Model for Recommendation. В качестве MLA-ментора предстоит «забустить» одну рексистему с помощью long-term-интересов. Явно разделяют долгосрочное и краткосрочное поведение пользователя и на вход долгосрочного энкодера передают в качестве query (как в encoder-decoder) выход краткосрочного. Обучают на два лосса. Кстати, заметен общий тренд: почти в каждой индустриальной статье используют несколько лоссов.

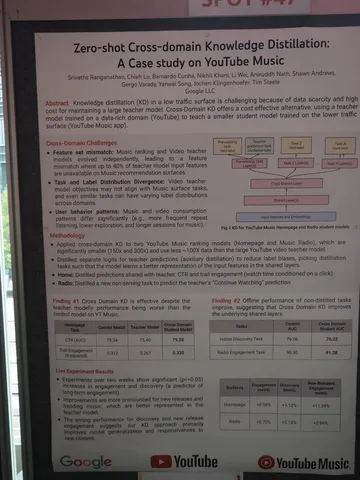
Не менее полезная статья — Zero-shot Cross-domain Knowledge Distillation: A Case Study on YouTube Music. Проблема: нужно запустить рексистему с нуля (YouTube Music), но уже есть готовая (на главной YouTube) с пересечением по фичам. Решение: переиспользовать веса, добавить спецтокены для новых фичей и дистиллировать артефакты от старой модели. Да, есть элемент overengineering, но главное — в индустрии начинают трогать cross-domain, и результаты уже позитивные.

Похожую проблему решают ребята из академии — LM-RecG: A Semantic Bias-Aware Framework for Zero-Shot Sequential Recommendation. Деталей в статье намного больше, но трудно сказать, что из этого работает (на академических датасетах буст настолько большой, что верится с трудом).

Было сразу три статьи, которые решают проблему использования контентных фичей в рекомендациях. Подходы разные, но суть одна: инициализировать lookup table через предобученную модель, а поверх запускать последовательную модель на айдишниках.

«Внебрачное дитя» европейских регуляций и Google — Cross-Batch Aggregation for Streaming Learning from Label Proportions in Industrial-Scale Recommendation Systems. Нельзя однозначно определить связь user-item, поэтому используют трюк из Learning from Label Proportions. Автор признал, что не знал о такой задаче до написания статьи, но был рад, что «поле уже немного пропахано».

Scaling Generative Recommendations with Context Parallelism on Hierarchical Sequential Transducers: инженерное ускорение HSTU (AllGather меняют на AllToAll, кастомные Triton-кернелы, jagged tensors — аналог NestedTensor из PyTorch в TorchRec). Около постера никого не было, визуализации классные, но темой вокруг особо не интересовались, хотя ускорение достойное — x5.

T2ARec: The Proposed Method — по метрикам отлично, но пугает SSM (state space model). Основное улучшение достигается через test-time alignment (во время теста модели выполняется градиентный спуск по двум вспомогательным задачам: сопоставление временных интервалов пользователей и сопоставление previous state с current state представления).


В конце дня был «званый ужин», на котором Иван успел посидеть за тремя русскоговорящими столами и вынести кое-какие инсайты:

— По ощущениям 2/3 участников используют GPT-интерфейс (VSCode, Cursor, либо разделённый экран: с одной стороны Jupyter Notebook, с другой — Perplexity/Gemini).

— У самого в квартальных целях — порешать эту проблему, так что, наверное, я biased, но повсюду говорят о холодном старте.

— С Сашей Петровым (gSASRec) обсуждали формулу хорошей статьи. Я уточнил, не обидится ли он на фидбек, что «читается просто». Его ответ порадовал: «Чем проще читается статья, тем сложнее её было писать».


ML Underhood
1 657 просмотров · 20 реакций Открыть в Telegram · Открыть пост на сайте
POV: вы пережили открытие RecSys 2025 и вернулись туда на следующий день

Продолжаем рассказывать, как проходит RecSys 2025 — девятая международная конференция о рекомендательных системах в Праге. В предыдущих сериях: TL;DR интересных статей и суммаризация воркшопов в Рекомендательной, а также таймлайн первого дня от Ивана Романова, нашего коллеги из Яндекс Вертикалей. Сегодня снова передадим слово Ивану: попросили его поделиться впечатлениями о втором дне конференции.

От второго дня конференции (он же первый «основной») у меня были заниженные ожидания: по опыту прошлых RecSys, сильнее всего запоминаются открывающий и закрывающий дни, когда в расписании есть воркшопы. Но всё оказалось лучше, чем я рассчитывал!

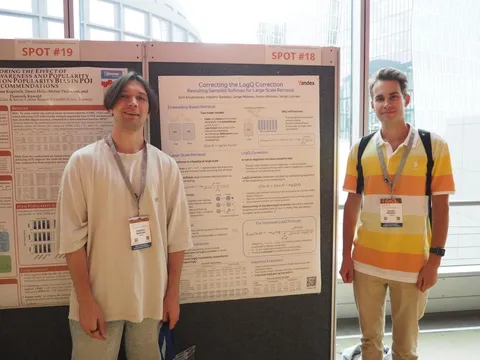
В аудитории с постерами постоянно бурлили интересные дискуссии. Мои коллеги, авторы работы Correcting the LogQ Correction, до последнего не снимали постер в ожидании Xinyang Yi, автора оригинальной статьи с LogQ. У меня тоже есть свои кумиры: повезло не только пообщаться с ребятами из Pinterest, но и задать вопросы одному из авторов статьи про PinFM.

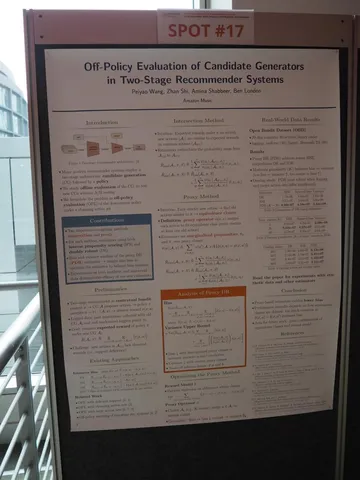
Абсолютным фаворитом этого дня для меня стал постер от Amazon Music: Off-Policy Evaluation of Candidate Generators in Two-Stage Recommender Systems. Если коротко, авторы попытались замерить качество кандидатогенерации. Делать это на текущих пользовательских логах, на которые воздействует текущий КГ, неправильно из-за sample bias. А держать бесконечный рандомный сбор даже на 1% трафика — дорого. На помощь приходит off-policy evaluation: оценка политики на основе данных, собранных другой политикой.

Чисто академическая статья, в которой, как мне кажется, есть интересное направление работы с diversity: D-RDW. Diversity-Driven Random Walks. Авторы показывают алгоритм, который случайно ходит по сети «читатели — новости», выбирает материалы и проверяет, чтобы итоговый набор новостей соответствовал некоторым правилам баланса. Если соответствия нет — он подбирает другой набор, пока не получится нужная комбинация. Алгоритм сравнивают с MMR, на пальцах звучит прикольно — планирую закопаться и проверить.

Масштаб RecSys в этом году поражает. Слушать доклады можно не отходя от буфета (поймал на фото одного из звукорежиссёров), появилась комната для детей. Русскоговорящих на конференции много: в одном только чатике уже около 60 человек. А я познакомился с профессором из University of Pittsburgh, который закончил МГУ больше 30 лет назад.

Несколько инсайтов напоследок:

🔴В Google первые скрипты трейнов LLM переподнимали вручную в случае инцидентов ночью (когда обучение уходило в NaN/стопалось и т.п.) — после приняли решение вознаградить за это всех неравнодушных.
🔴Очень сложно есть и говорить на английском одновременно, это какой-то отдельный скилл. Присоединился на обеде к ребятам из IKEA и Telegraph, приходилось очень часто их переспрашивать.
🔴В IKEA и Telegraph сейчас используют только implicit feedback, хотя explicit тоже есть и такие действия уже логируются. А ещё ребята были очень удивлены размером Yambda-датасета и тем, как мы справляемся с обработкой таких объёмов данных, да ещё и с доказательством целесообразности скейла.


ML Underhood
1 313 просмотров · 13 реакций Открыть в Telegram · Открыть пост на сайте
Впечатления от первого дня RecSys 2025

В Праге проходит конференция RecSys 2025 — и мы по традиции ведём репортаж с мероприятия. Первыми впечатлениями с нашим каналом поделился Иван Романов из Яндекс Путешествий. Слово Ивану:

Прошёл первый день RecSys, посвящённый в основном воркшопам. Первые доклады разочаровали: много воды в духе «за хорошие рекомендации против плохих». Хотел уйти, но попасть на CARS (Context-Aware RecSys) было сложно, поэтому остался на вторую часть — и не зря: стало интереснее.

Несмотря на, как мне кажется, индустриальное название самого воркшопа, большинство статей было академическими, и некоторые — сильно оторваны от реальности.

Одному человеку пришлось перейти от задачи с персонализацией — sasrec/argus-like арх-рой — к choice modeling, и он долгое время аудитории объяснял, зачем использовал что-то вроде feature tokenize transformer для своей задачи. И правда, зачем? Думаю, чтобы самому было интереснее — на графиках от скейла трансформера метрика не росла: layers=1, head=1, dim=16 давал по сути топовый результат.

Был обзор статьи KP4POI: файнтюнят LLM, промптируют посещённые места и после спецтокена ожидают новые POI (points of interest). Ничего особенного, просто отметить что LLM-based RecSys набирает обороты. В тайтле статьи есть «on Large-scale Datasets», но на одном из слайдов было что-то вроде про 5–10 тыс. пользователей.

Многие работают над своими агентами для построения маршрутов путешествий с персонализацией. Показали две демки, и ни в одной не было Чехии, что странно — можно же было всем посетителям конференции попиарить приложение. А другая демка (CityRiddler) была только по Вене, где до конференции я провёл чудесный день. Маршрут по городу и нескольким музеям мне составил ChatGPT, вот и у спикеров напросился вопрос: «А не работает ли уже это out of the box в ChatGPT и нужен ли продукт в целом, если это только промпт?»

Если не агентами богаты и LLM не тюним, то тогда RAG. Здесь, несмотря на скепсис, был очень классный слайд от одного из спикеров: «LLM as a judge» (можно оценивать не только релевантность ответа запросу, но и, например, вопросом «were retrieved chunks actually relevant» считать что-то вроде Precision). Не знаю, насколько рабочая конфигурация и не будет ли 100% корреляции скоров «судьи» под каждую из задач (recall, precision, faithfulness, answer relevancy).

А ещё среди докладов обнаружил вот такую интересную идею — взяли Mixup из image augmentation и применяют над пользовательскими векторами. Эффект есть, но метрики были странные.


ML Underhood
1 499 просмотров · 19 реакций Открыть в Telegram · Открыть пост на сайте
Self-rewarding Language Models

Сегодня разберём статью о том, как научить языковую модель самостоятельно оценивать качество своих ответов и итеративно улучшаться за счëт этого.

Direct Preference Optimization (DPO)

Раньше большие языковые модели учили примерно так:

1. Предобучение без учителя на огромном корпусе текстов;
2. SFT — supervised fine-tuning;
3. Создание датасета предпочтений (сравнение качества нескольких гипотез LLM между собой вручную);
4. Обучение reward-модели на датасете предпочтений.
5. RL — reinforcement learning.

Метод DPO (Direct Preference Optimization) предлагает заменить обучение reward-модели и RL на supervised fine-tuning LLM на датасете предпочтений с некоторой лосс-функцией (подробнее в оригинальной статье про DPO).

Метод авторов статьи

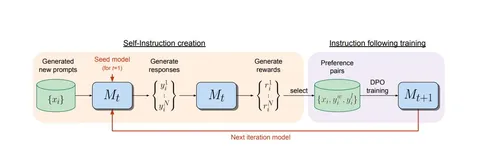
Авторы предлагают учить LLM не только отвечать на вопросы пользователя (instruction following), но и оценивать эти ответы с помощью механизма LMM-as-a-Judge. Благодаря этому можно автоматизировать создание датасета предпочтений.

Более подробно, взяв предобученную модель M₀, делают еë supervised fine-tuning на instruction following (IFT данные) + оценивание качества ответа (EFT данные) — и так получают модель M₁. Далее начинается итеративный процесс, при котором:

1. Модель Mᵢ сама генерирует датасет предпочтений (генерирует гипотезы и оценивает их) обозначаемый AEFT(Mᵢ);
2. Модель Mᵢ дообучается на AEFT(Mᵢ) с помощью DPO — так получаем новую модель Mᵢ₊₁.

Весь процесс выглядит так:

M₀ — предобученная LLM без fine-tuning.
M₁ — модель, инициализированная M₀, а после дообученная на IFT+EFT в режиме supervised fine-tuning.
M₂ — модель, инициализированная M₁ и дообученная на AEFT(M₁) в режиме DPO.
M₃ — модель, инициализированная M₂ и дообученная на AEFT(M₂) в режиме DPO.

Авторы утверждают, что метод не только помогает нейросетям лучше справляться с инструкциями, но и улучшает их способности к оцениванию ответов. Доработав Llama 2 70B на трёх итерациях этого подхода, они получили модель, которая превосходит многие существующие системы в таблице лидеров AlpacaEval 2.0: например, Claude 2, Gemini Pro и GPT-4 0613.

Более подробно итерации обучения, применяемые в подходе, описали в канале «Душный NLP».

Разбор подготовил ❣ Никита Фёдоров
ML Underhood
2 094 просмотров · 28 реакций Открыть в Telegram · Открыть пост на сайте
Теперь вы знаете, кому сказать спасибо за прямые включения с KDD 2025

В начале августа в Торонто прошла KDD 2025 — конференция о поиске знаний и анализе данных:

— Обзор свежих публикаций читайте в Рекомендательной.
— Главные цифры конференции и лучшие работы ищите в Душном NLP.

Запомнил и записал для вас всё самое интересное один из наших коллег — инженер Сергей Мить. Именно его портрет рисует роборука на видео выше.

Привёз вам новости ❣ Сергей Мить

ML Underhood
1 853 просмотров · 10 реакций Открыть в Telegram · Открыть пост на сайте
Возвращаемся на ICML 2025

Собрали ещё несколько интересных работ вдогонку прошедшей конференции. Сегодня — об оптимизации больших моделей, новых SGD-подходах и работе на тему conformal prediction.
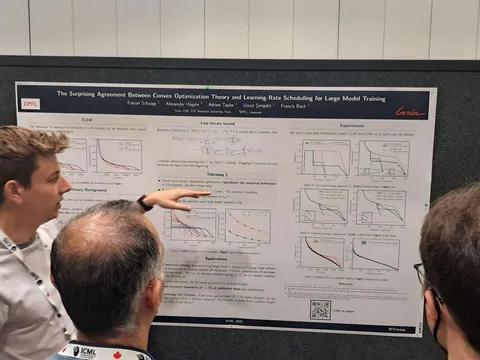
The Surprising Agreement Between Convex Optimization Theory and Learning-Rate Scheduling for Large Model Training

Крайне любопытная теоретическая статья, показывающая (без доказательства — прямо на постере: «we don't know why»), что график лоссов LLM-претрейна с cosine и WSD lr-шедулерами выглядит практически так же, как график теоретических верхних оценок расстояния финальной точки оптимизации от точки оптимума для выпуклых негладких задач при использовании SGD с cosine/WSD-шедулерами. Что ещё любопытнее — теоретические оценки выводятся для SGD, однако графики LLM-претрейна авторы запускали с Adam — использование адаптивных оптимизаторов ведёт к таким же результатам. Авторы также утверждают, что шедулер WSD удобнее для экспериментов со scaling law.
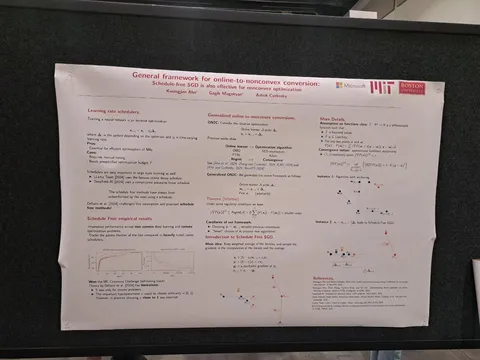
General framework for online-to-nonconvex conversion: Schedule-free SGD is also effective for nonconvex optimization

Статья берёт новый алгоритм оптимизации Schedule-Free из работы The Road Less Scheduled, демонстрировавшей лучшие на момент публикации результаты в бенчмарке методов оптимизации, и разрабатывает инструменты для теоретического анализа в невыпуклых случаях. Идея Schedule-Free в том, что большинство шедулеров на самом деле похожи на усреднение итераций — алгоритм выглядит схожим образом, как хитрое усреднение параметров итераций. Достоинство подхода — алгоритму не нужно наперёд знать число итераций T для задания расписания шедулера. Текущая статья — теоретическая работа, показывающая, как алгоритм ведёт себя в невыпуклых сценариях. Значительное количество статей по методам оптимизации доказываются для задачи онлайн-обучения в терминах regret — в данной статье авторы также решили воспользоваться достоинствами regret-формулировок для анализа.

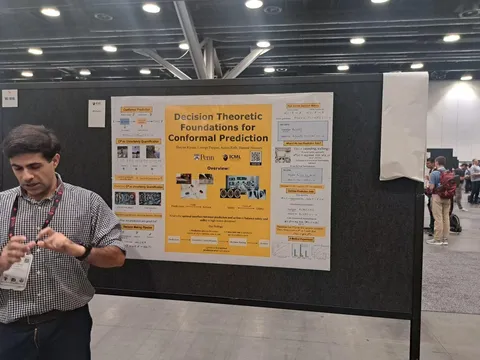
Decision Theoretic Foundations for Conformal Prediction: Optimal Uncertainty Quantification for Risk-Averse Agents

На конференции было как минимум 10 (а скорее — больше) статей на тему conformal prediction — её сейчас активно исследуют. Conformal prediction — когда модель предсказывает не один label, а множество, и нужно предсказать такое множество, которому с заданной уверенностью принадлежит правильный ответ. Мы пообщались с автором этой работы — он подробнее рассказал о подходе, математических идеях, а также о том, как эти идеи соотносятся с реальными задачами. Выглядит как хорошая точка входа, чтобы разобраться в теме.

Интересное отобрал ❣ Алексей Морозов

ML Underhood

#YaICML25
1 601 просмотров · 17 реакций Открыть в Telegram · Открыть пост на сайте