Как в Яндекс Погоде использовали фичу для таргета, чтобы улучшить точность предсказания осадков

Яндекс запустил новые модели краткосрочного прогноза осадков — подробнее о них можно почитать на Хабре. А специально для нашего канала ML-разработчик в Яндекс Погоде Дмитрий Стефеев рассказал о важной идее, которая позволила обойти возникшие в начале работы трудности.

Цель — создать модель регрессии для прогноза выпавших за час осадков (в мм). Основными фичами являются прогнозы глобальных численных моделей (NWP).

Главная проблема заключалась в том, что радарные данные, которые мы используем в качестве таргета для обучения, значительно отличаются от прогноза численных моделей на входе. Всё из-за сложности прогноза осадков. Очень легко промазать как по времени, так и пространству. Все функции потерь и их комбинации, которые мы пробовали, приводили к тому, что модель прогнозировала значительно меньше осадков, чем нужно, боясь промазать. Можно было бы попробовать перейти от регрессии к классификации и подбирать пороги, но их, скорее всего, пришлось бы подбирать для каждого шага прогноза (как делали, к примеру, в Metnet от Google) и, вероятно, они бы отличались для разных мест на Земле и разных сезонов. Это значительно усложнило бы поддержку модели и увеличило вероятность непредсказуемого поведения.

Тогда нам пришла идея использовать прогноз осадков одной из численных моделей в фичах в качестве второго таргета, помимо радаров. Получается, что модель начала частично обучаться к собственной фиче! Сначала мы пробовали выставлять фиксированные веса лоссов к радарному таргету и прогнозу численной модели. Стало значительно лучше, но местами проблема сохранялась. Тогда мы сделали предположение, что веса должны зависеть от согласованности прогноза численных моделей на входе отдельно в каждой точке прогноза: чем более согласованный прогноз дают численные модели, тем меньший вес мы используем для радарного лосса и больший — для лосса численной модели.

В ходе экспериментов мы пришли к простой формуле для весов. Сначала считаем медиану для прогнозов осадков всех численных моделей в каждой точке прогноза. Далее считаем среднюю абсолютную разность прогнозов численных моделей и медианы, а затем делим полученное значение на медиану, клипая результат по подобранным границам. Полученное значение W мы применяем для лосса к радарам, а для лосса к прогнозу численной модели используем вес 1 - W. И такой трюк позволяет полностью устранить проблему с уменьшением объёма осадков — по сути это можно считать регуляризацией выхода модели к численному прогнозу, так как мы привязываем прогноз к физической модели, не давая ему отойти слишком далеко.

Далее мы добавили домножение полученных весов на дополнительные веса, которые линейно зависят от шага прогноза, чтобы по мере увеличения шага снижать вес лосса к радарам и увеличивать к численному прогнозу до подобранного граничного значения.

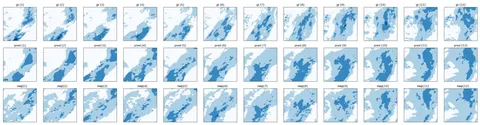
На изображении выше в первой строке показан пример радарного таргета по первым 12 часам прогноза. Ниже — прогноз нашей модели и прогноз численной модели в дополнительном таргете. Для удобства отображения значения мм приведены к трём классам осадков. Видно, что на первых шагах, прогноз модели больше похож на радары, а далее становится ближе к прогнозу численной модели, что позволяет улучшать качество прогноза на первых шагах за счёт исторических радарных данных, если они доступны на входе модели.

ML Underhood
2 064 просмотров · 15 реакций Открыть в Telegram · Открыть пост на сайте
Как проходит ACL 2025 👀

Продолжаем рассказывать, что увидели и услышали на конференции: листайте фото и видео!

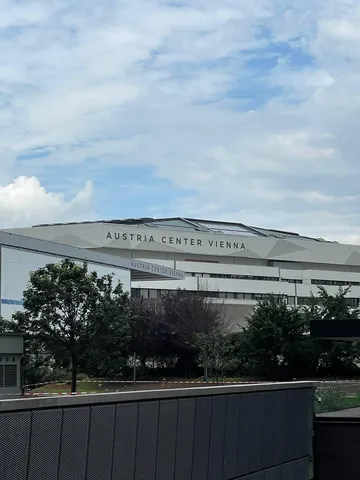
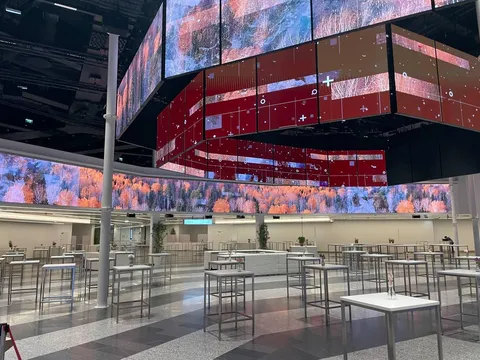
В этом году ACL состоялась в Austria Center Vienna — конференц-зале в центре Вены. Красиво не только внутри, но и снаружи. Иногда на докладах людно, иногда — не очень.

Поразило невероятное количество постеров: около 250 только в одном зале. Работы очень разные, от «денег нет, но вы держитесь» до лаконичных постеров на А4. Мы выбрали для вас самые интересные из них — о трендах и статьях читайте в Душном NLP:

В Вене проходит 63-я ежегодная конференция ассоциации компьютерной лингвистики — ACL 2025

Интересное с конференции ACL 2025

Кадры для вас сделали и отобрали ❣ Алексей Березникер и Александр Николайчик

#YaACL25

ML Underhood
1 919 просмотров · 18 реакций Открыть в Telegram · Открыть пост на сайте
Начинаем новую неделю с новой конференцией

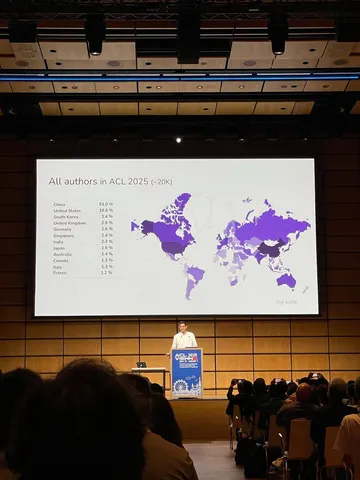
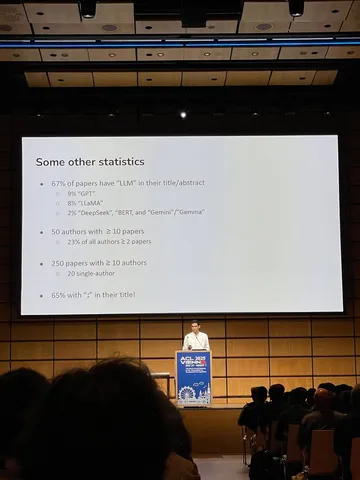
В Вене стартовала ACL 2025. В ближайшие дни мы будем рассказывать обо всём самом интересном, что увидим на мероприятии, а сейчас поделимся занимательной статистикой.

— Всего на конференцию зарегистрировались около 20 тысяч авторов.
— 51% авторов — из Китая, ещё 18,6% — из США.
— У 67% работ, поданных на ACL, в названии есть LLM.
— Почти так же часто, как LLM, в названиях встречается двоеточие — оно есть в 65% заголовков.

Рассказывайте в комментариях, о чём, связанном с ACL, вам интересно было бы почитать. А, может быть, вы сами на конференции? Тогда обязательно делитесь впечатлениями!

#YaACL25

ML Underhood
2 114 просмотров · 17 реакций Открыть в Telegram · Открыть пост на сайте
AQUA-KV: адаптивная квантизация KV-кэша

На ICML 2025 команда Yandex Research представила шесть статей (каких именно — читайте в одном из предыдущих постов) — среди них есть работа, посвящённая методу адаптивной квантизации KV-кэша. Один из авторов, исследователь Yandex Research Алина Шутова, рассказала нашему каналу, в чём суть предложенного в публикации способа.

Одна из ключевых проблем эксплуатации LLM — экспоненциальный рост потребления памяти графических процессоров при обработке длинных контекстов. Это связано с необходимостью хранения KV-кэша. Для современных моделей, таких как Llama 3.2 70B, и контекстов в 131 тысячу токенов, объём KV-кэша может достигать 42,9 ГБ на последовательность, что существенно ограничивает практическое применение и увеличивает стоимость вычислений. Традиционные методы сжатия, такие как примитивное квантование или прунинг, демонстрируют значительную деградацию качества генерации при агрессивных режимах сжатия, особенно в области 2–3 бит на значение.

Предложенный авторами статьи метод AQUA-KV (Adaptive QUAntization for Key-Value) представляет принципиально новый подход, основанный на фундаментальном наблюдении: векторы ключей и значений в соседних слоях трансформера обладают высокой степенью корреляции. Эта структурная избыточность позволяет прогнозировать значительную часть информации слоя k+1 на основе данных слоя k.

Вместо независимого квантования каждого слоя AQUA-KV использует обученные линейные предикторы. Один предиктор предсказывает ключи слоя k+1 на основе ключей слоя k, другой предсказывает значения слоя k+1 по комбинации предсказанных ключей этого слоя и значений слоя k. Обучение этих компактных адаптеров проводится в ходе одноразовой калибровки на целевой модели.

Критический шаг метода — переход от квантования векторов целиком к квантованию только остаточной информации, то есть разности между фактическими векторами слоя и их предсказаниями. Поскольку остаток содержит лишь ту информацию, которую нельзя получить из предыдущего слоя, его информационная энтропия существенно ниже. Эта остаточная компонента подвергается экстремальному квантованию (до 2–2,5 бит на элемент) с применением векторного квантования без данных (data-free VQ), адаптивно оптимизирующего распределение битов под дисперсию остатков. Для восстановления KV-векторов во время инференса используются те же предикторы и деквантованный остаток.

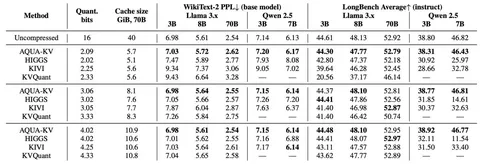
Эксперименты демонстрируют эффективность AQUA-KV. На моделях семейств Llama 3.2 и Qwen 2.5 применение метода с квантованием до 2 бит на значение привело к снижению объёма памяти KV-кэша в 16 раз (с ~43 ГБ до ~2,7 ГБ для контекста в 131K токенов) при сохранении практически исходного качества генерации. Относительное увеличение перплексии составило менее 1%, а деградация точности на задачах длинного контекста из бенчмарка LongBench не превысила 1%. AQUA-KV совместим с любыми методами квантизации, и, как продемонстрировано в работе, заметно улучшает качество всех рассмотренных методов. Метод демонстрирует совместимость с техниками прунинга, такими как H2O, обеспечивая дополнительную экономию памяти. Код AQUA-KV можно найти на GitHub.

ML Underhood

#YaICML25
2 231 просмотров · 25 реакций Открыть в Telegram · Открыть пост на сайте
Пятничное: немного атмосферы ICML 2025

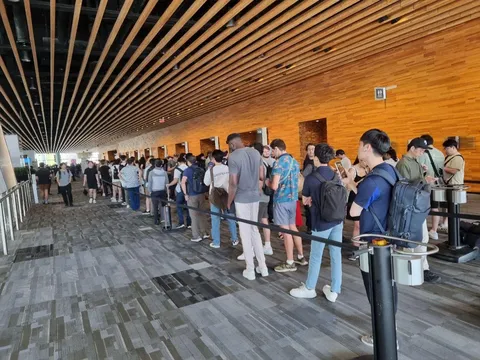
— Большие очереди на регистрацию и прекрасные виды снаружи Vancouver Convention Centre.

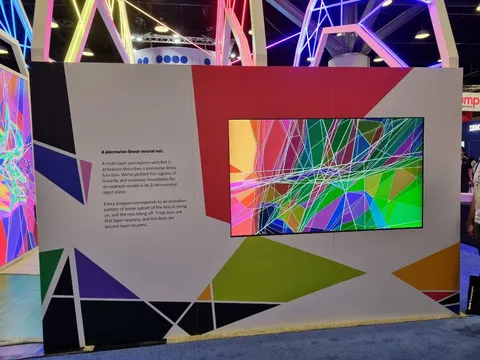
— Арт-галерея с визуализацией кусочно-линейных нейросетей на одном из стендов.

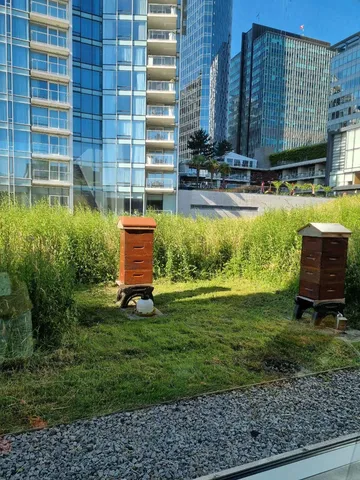
— Пасека на крыше здания, в котором проходит конференция.

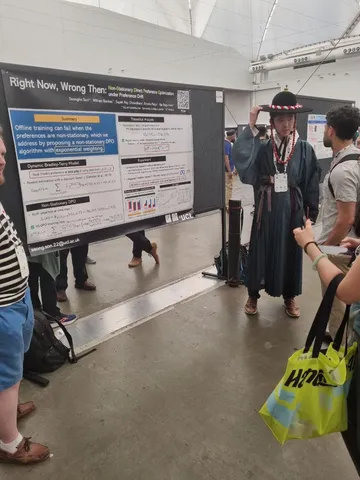
— Аутентичный корейский исследователь представляет свой постер.

ML Underhood

#YaICML25
1 825 просмотров · 16 реакций Открыть в Telegram · Открыть пост на сайте
Новая порция докладов с ICML 2025

Конференция в разгаре, а инженеры из Яндекса продолжают отмечать и комментировать любопытные работы. Делимся ими с вами.

AI's Models of the World, and Ours

Invited talk от Джона Кляйнберга — об отличиях в представлениях о мире у моделей и у человека. Мотивация примерно такая: после наступления сингулярности человеческий труд во многих областях станет не нужен, и это как минимум обидно, если не сказать страшно. Хочется, чтобы люди продолжали что-то делать. Чтобы представить эту ситуацию, можно обратиться к задаче, где она уже произошла: к игре в шахматы. Несмотря на то, что компьютеры давно играют в шахматы лучше людей, интерес к игре только вырос — в первую очередь, благодаря интернету. Люди играют в шахматы больше, чем когда-либо. Если сравнить шахматные партии с участием компьютера и партии между людьми, видно, что во вторых намного больше красивых комбинаций — эстетики, которая играла важную роль в шахматном образовании прошлого. Проще говоря, в человеческих партиях есть то, что принято называть «красивыми идеями», благодаря которым эта игра и получила такое распространение во всем мире.

Кляйнберг рассказал о проблеме обучения моделей, играющих как человек с рейтингом, например, 1100, 1200, 1600, 1800 или 2300, в надежде воспроизвести красивые человеческие партии. Это оказалось сложней, чем можно было ожидать. С человеческой точки зрения ходы моделей, которые пытаются имитировать игру человека, всё ещё выглядят неестественно, и лучшие попытки дают accuracy около 60%. Но результат оказался востребован — «с компьютером намного интереснее играть, когда он проигрывает» (с).

Во второй части выступления Кляйнберг упомянул старый результат: задача распознавания языка из счётно бесконечного множества неразрешима за конечное время, зато задача генерации предложений из неизвестного языка — решается. Но решить её можно тривиально: выбрать и генерировать удлиняемую простую конструкцию из языка — неинтересно. Результат группы Кляйнберга этого года — возможность делать это с константной плотностью, то есть так, чтобы выход модели покрывал ⅛ языка. С другой стороны, несложно доказать, что больше половины неизвестного произвольного языка сгенерировать теоретически невозможно.

Generative AI's Collision with Copyright Law

Доклад о том, как использовать защищённые авторским правом данные для обучения моделей. Ключевой вывод — ситуация сильно зависит от страны:

— В Израиле любое использование данных для обучения признаётся fair use.

— В ЕС данные можно использовать, если к ним есть легальный доступ; при этом его нельзя ограничивать для образовательных и культурных учреждений. У авторов есть право исключать свои произведения из датасетов, используемых в обучении. В Японии и Сингапуре ситуация в целом такая же.

— В США всё сложнее из-за прецедентного права, многое решается индивидуально в суде. Авторы (в отличие от правообладателей) не могут запретить использование своих работ для обучения. А если использование данных может повлиять на рынок правообладателя, скорее всего, это считается нарушением.

Riemannian Diffusion Adaptation for Distributed Optimization on Manifolds

Отдельный лайк авторам за задачу оптимизации в римановых многообразиях. Сюда входит задача глубокого обучения с ортогональными матрицами, а это то, что помогало стабилизировать асинхронное глубокое обучение в течение продолжительного времени. На древнем рекламном фреймворке глубокого обучения такие модели — с всегда ортогональными слоями — обучались стабильнее и показывали лучшее качество (при переходе на allreduce, к сожалению, ортогональные матрицы стали вести себя так же, как обычные, но медленнее). Авторы приписывают к достоинствам метода решение задач на любых многообразиях, но при этом не сравнивают себя со специализированными методами для разных задач. Вкладка экспериментов — скромная для метода, решающего любые задачи: в abstract — четыре примера, в экспериментах — всего два, и нет сравнения со специализированными под каждую задачу методами.

Работы заметили ❣ Алексей Поспелов и Алексей Морозов

ML Underhood

#YaICML25
1 401 просмотров · 13 реакций Открыть в Telegram · Открыть пост на сайте
ICML 2025: интересные доклады на тему ML — часть 2

When to Retrain Machine Learning Model

В работе исследуют проблему регулярного переобучения моделей в продакшн-системах: то, как часто нужно полностью обучать модель с нуля на новых данных. Приходят к выводу, что переобучать слишком часто — дорого и бесполезно, попробуют понять, в какие моменты времени это лучше делать. Получается временной ряд, который они аппроксимируют своими методами. Решение имеет смысл, только если есть возможность переобучать модель очень часто, но хочется делать это реже — без ущерба для качества. При этом, поскольку подход ориентирован именно на полное переобучение «с нуля», он не применяется к онлайн-обучению: там всегда предпочтительнее дообучать модель настолько часто, насколько это возможно.

How to set AdamW’s weight decay as you scale model and dataset size

Новый метод для подбора гиперпараметра регуляризации в AdamW. Авторы переписали формулы weight decay в виде, который начинает походить на экспоненциальное сглаживание (EWMA). Репараметризуют его новыми параметрами и говорят, что подбор одного нового параметра работает проще и сохраняет свойства при изменении размеров датасета, размера батча или размера архитектуры. То есть можно один раз подобрать и какое-то время о нём не вспоминать. Формула очень простая и её будет легко попробовать в боевых моделях.

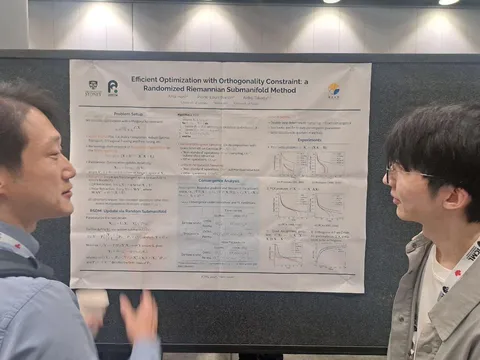
Efficient Optimization with Orthogonality Constraint: a Randomized Riemannian Submanifold Method

Ещё одна статья на тему оптимизации на римановых многообразиях для ортогональных матриц. Из интересного — оказывается, условия ортогональности используются сейчас не только в классических задачах вроде PCA, но и в некоторых задачах файнтюна. К сожалению, автор не читал статью Orthogonal Weight Normalization, где в 2017 году была предложена простая и вычислительно эффективная идея, хорошо зарекомендовавшая себя на практике. Было бы круто сравнить эти подходы на одной задаче.

Интересное отобрал ❣ Алексей Морозов

ML Underhood

#YaICML25
1 281 просмотров · 14 реакций Открыть в Telegram · Открыть пост на сайте
ICML 2025: интересные доклады на тему ML — часть 1

В эти дни в Ванкувере стартовала ICML 2025. Инженеры Яндекса делятся первой порцией любопытных работ прямо с места событий.

Efficient Distributed Optimization under Heavy-Tailed Noise

Авторы пытаются бороться с шумными апдейтами без дополнительной памяти. Вводят два гиперпараметра: «верхний порог» и «нижний порог», но при этом не просто обрезают градиенты по порогам, а делают это необычным способом, получая более качественную оптимизацию. Достоинство метода — в его stateless-сущности и экономии памяти, недостаток — в необходимость подбирать два новых гиперпараметра. Существующие методы, вроде AMSgrad, делают примерно то же самое: борются с взрывными апдейтами, но с использованием дополнительной памяти. Огорчает, что нет сравнения с AMSgrad — старый stateful-метод VS новый stateless-метод.

Online Conformal Prediction via Online Optimization

Несмотря на немного обескураживающее название, под капотом — онлайн-обучение квантильной регрессии (алгоритм оптимизации разработан специально для неё). На постере нет оценок на regret, однако авторы заверили, что их можно получить, поскольку это узкая задача из уже изученного более широкого семейства.

Lean and Mean Adaptive Optimization via Subset-Norm and Subspace-Momentum with Convergence Guarantees

Сугубо теоретическая статья, практические применения которой уже можно было видеть. AdaGrad, Adam, RMSprop — покоординатные адаптивные lr. Есть другая крайность — один нормализатор на все параметры (что делает метод фактически SGD, только чуть более простым в подборе гиперпараметров). Авторы исследуют нечто среднее: делят параметры на группы и для каждой вычисляют нормализатор из нормы вектора градиентов. Во‑первых, авторы выписали оценки сходимости для ряда задач, во‑вторых — провели эксперименты с трансформерами для выбора оптимальных групп параметров. Из личного разговора с исследователем удалось узнать, что лучше брать матрицы целиком — поколоночные и построчные группы работают хуже и покоординатного метода, и предложенного метода.

Global curvature for second-order optimization of neural networks

Метод второго порядка для оптимизации нейросетей. Смысл такой же, как в классических подходах: давайте будем считать произведение обратного квадратного корня гессиана на градиент как-нибудь побыстрее. Авторы статьи говорят: вычисление feed forward-архитектур устойчиво к некоторым перестановкам в матрицах весов линейных проекций — и некоторыми похожими свойствами обладает гессиан. Из этого свойства они получают вычислительно более эффективный метод. Разные методы оптимизации предлагают разные способы считать произведение обратного квадратного корня гессиана на градиент. Самые известные методы для large scale-задач — BFGS и L-BFGS. Пообщались с авторами статей — они заявляют, что их метод лучше для их архитектур, потому что он ищет среди точных решений (с учётом исследуемого ими свойства устойчивости к перестановкам), а семейства BFSG используют low-rank аппроксимацию, то есть не дают точного решения. Формулы выписаны только для tanh-активации. Пожелаем авторам удачи — хочется увидеть фундаментальный сдвиг в качестве методов оптимизации и асимптотике сходимости, а не очередной «Adam с рюшечками».

Интересное отобрал ❣ Алексей Морозов

ML Underhood

#YaICML25
1 543 просмотров · 16 реакций Открыть в Telegram · Открыть пост на сайте
Векторный поиск в YDB: зачем он нужен и как его используют в Алисе

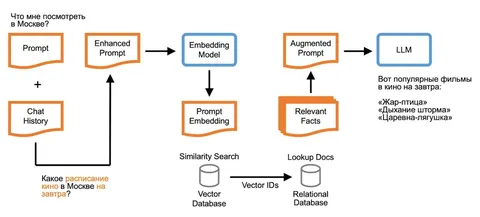
Сегодня команда Yandex B2B Tech представила новую версию системы управления базами данных YDB. Главная фича — векторный поиск. С ним можно за миллисекунды находить информацию в разнородных данных и формировать персональные ответы на запросы пользователей.

Технология основана на поиске семантически похожих данных в больших коллекциях. Разные типы данных — текст, изображения, аудио и видео — представляются в виде эмбеддингов, которые затем сохраняются в базу данных. После этого можно находить не только точные совпадения, но и близкие по смыслу объекты — даже если они записаны по-разному или вообще без описаний.

Векторный поиск улучшает качество и увеличивает скорость работы продуктов на базе ИИ: рекомендательных и поисковых систем, виртуальных ассистентов. Никита Зубков, руководитель отдела разработки диалоговой системы Алисы, рассказал, как технология помогает сделать общение пользователей с ассистентом более персонализированным:

С помощью векторного поиска мы находим наиболее релевантные диалогу сессии в прошлом и подставляем их в контекст. Благодаря этому ответы Алисы становятся персональными: она больше не забывает, как зовут вашего котика, когда вы последний раз ходили в спортзал или какой фильм вы недавно обсуждали с друзьями.

Например, раньше Алиса обнулялась и не помнила, есть ли у вас домашнее животное, какой оно породы и как его зовут. Но теперь, если сообщить ей эту информацию, а затем задать вопрос: «Как мне провести выходные?», она может предложить пойти в парк с собакой и даже напомнит взять любимый зелёный мячик питомца.


В YDB есть две версии векторного поиска: точный и приближённый. Первый гарантирует, что найденные результаты будут самыми похожими на использованный образец, но требует большой вычислительной сложности. Приближённый — позволяет искать по коллекциям из сотен миллионов векторов за десятки-сотни миллисекунд, даже если все вектора не помещаются в оперативную память.

База данных YDB доступна как опенсорс-проект и как коммерческая сборка с открытым ядром. Обе версии можно развернуть на своих серверах или воспользоваться managed-решением в Yandex Cloud. Больше технических деталей можно узнать из статьи на Хабре.

ML Underhood
1 966 просмотров · 43 реакций Открыть в Telegram · Открыть пост на сайте
Yandex Research везёт на ICML 2025 шесть статей

Шесть работ российских исследователей из Яндекса приняли на ICML (International Conference on Machine Learning) — одну из старейших и самых авторитетных в мире научных конференций по ИИ, которая входит в топ-3 согласно Google Scholar. Статьи посвящены различным аспектам машинного обучения — от алгоритмического мышления нейронных сетей и измерения разнообразия до оптимизации использования памяти при работе с большими языковыми моделями. Кратко рассказываем о каждой из них — подробнее можно почитать в блоге Yandex Research.

Discrete Neural Algorithmic Reasoning
Авторы исследуют причины, по которым нейросетевые модели плохо обобщаются при обучении на алгоритмические задачи, и предлагают архитектурные изменения, решающие эту проблему. В частности, вводят ограничение на представление состояний вычислений, что обеспечивает точное соответствие исходным алгоритмам. Этот подход позволил добиться чёткого выполнения нейросетью нескольких алгоритмов. Кроме того, предложенная архитектура даёт возможность строго доказывать корректность работы обученных моделей на любых входных данных.

Measuring Diversity: Axioms and Challenges
В работе анализируют метрики разнообразия и выделяют три свойства, которым должна удовлетворять хорошая метрика: монотонность, уникальность и непрерывность. Существующие метрики не удовлетворяют хотя бы одному из этих свойств. При этом в работе приведены примеры метрик, которые удовлетворяют всем, но их вычисление — NP-трудная задача. Вопрос о том, существуют ли эффективные метрики со всеми желаемыми свойствами, остаётся открытым.

Cache Me If You Must: Adaptive Key-Value Quantization for Large Language Models
LLM хранят ключи (K) и значения (V) внимания для каждого токена, что быстро расходует память. Авторы предлагают сжимать их не в исходном виде, а с учётом взаимной информации между слоями — кодировать только то, что нельзя предсказать по соседнему слою линейными предикторами. Это позволяет сжимать KV-вектора почти без потерь качества даже при экстремальном 2-битном квантовании.

FRUGAL: Memory-Efficient Optimization by Reducing State Overhead for Scalable Training
При увеличении размеров обучаемой модели для хранения статистик оптимизатора требуется огромное количество памяти. Предыдущие методы уменьшали эту нагрузку, проецируя градиент на малоранговое пространство, где и хранились статистики оптимизатора. Однако такой подход не использует всю информацию из градиента. Авторы FRUGAL предлагают решить эту проблему, разделяя градиент на две части, одна из которых используется для обновления в малоранговом подпространстве через Adam, а вторая — в оставшемся подпространстве с помощью оптимизатора без статистик, например SGD или signSGD. Метод стабильно превосходит другие подходы при ограниченных ресурсах, достигая лучших результатов в предобучении и дообучении при той же экономии памяти.

Inverse Bridge Matching Distillation
Авторы предлагают алгоритм дистилляции diffusion bridge-модели (DBM) для задачи image-to-image translation до одного шага. Метод работает как для условных, так и безусловных моделей, может применяться для широкого класса задач реконструкции и генерации изображений, а также ускоряет работу моделей в 4–100 раз. В некоторых задачах модель-ученик даёт результат лучше, чем модель-учитель.

EvoPress: Towards Optimal Dynamic Model Compression via Evolutionary Search
EvoPress — метод оптимального динамического сжатия больших языковых моделей, основанный на применении эволюционного алгоритма. Он учитывает сложную нелинейную взаимосвязь между разными слоями нейронной сети. Подход валидируют на семействах моделей Llama, Mistral и Phi, где EvoPress достигает более высокого качества по сравнению с однородным сжатием и конкурентными динамическими методами.

В этом году конференция будет проходить с 13 по 19 июля в Ванкувере, и её по традиции посетят ML-инженеры из Яндекса. Ну а мы будем рассказывать о самых интересных статьях и докладах.

ML Underhood

#YaICML25
2 186 просмотров · 50 реакций Открыть в Telegram · Открыть пост на сайте
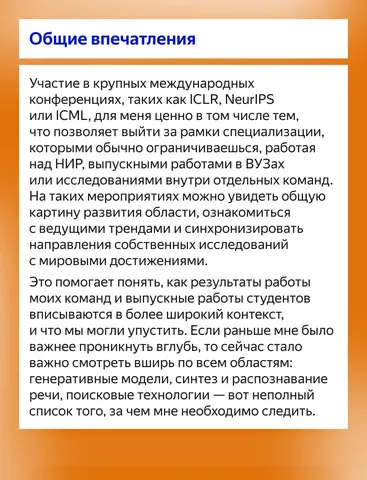
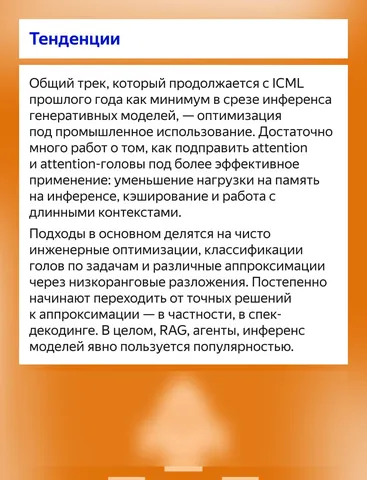
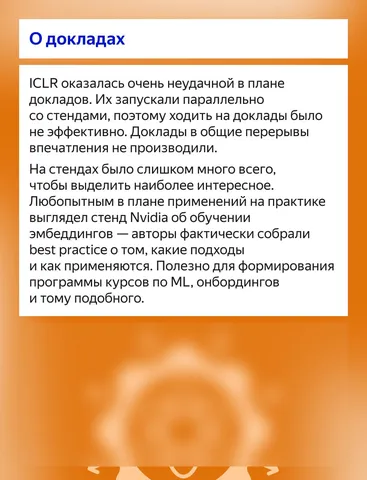
Впечатления от ICLR 2025

Подводим итоги конференции вместе с инженерами Яндекса. Сегодня о своих впечатлениях от ICLR в этих карточках и одной секретной поделится руководитель Cloud AI/ML Services Yandex Cloud Василий Ершов.

ML Underhood
5 788 просмотров · 19 реакций Открыть в Telegram · Открыть пост на сайте
Заметки с ICRA — главной конференции по робототехнике

В конце мая в США прошла ICRA — топ-1 по цитируемости конференция в области робототехники. На мероприятии побывала руководитель службы исследования алгоритмов нового поколения Мария Голицына. Она делится статьями на тему автономного транспорта, а ещё — фотографиями самых разных роботов. В разборе уместилось лишь несколько работ — полный список отобранных Марией статей можно увидеть по ссылке.

Mitigating Covariate Shift in Imitation Learning for Autonomous Vehicles Using Latent Space Generative World Models

Первым, с кем удалось поговорить на воркшопах, был Александр Попов — один из авторов статьи. Он работает в NVIDIA, где несколько сотен человек занимаются разработкой беспилотных автомобилей. В частности, команда развивает подход perception-to-trajectory: на входе — изображение с камеры, на выходе — траектория, по которой едет машина.

В работе обсуждается проблема covariate shift — отклонений от распределения, на котором модель обучалась. Это частая проблема в imitation learning: агент может оказаться в состояниях, которых не было в демонстрациях эксперта, и начинает совершать ошибки.

Авторы предлагают решение — использовать замкнутый цикл (closed-loop training) с генеративной моделью мира, работающей в латентном пространстве. В этой схеме берутся исторические данные с камер, затем система «закрывает глаза» и делает последовательность шагов вперёд в латентном пространстве — в статье это 12 шагов. На каждом шаге сравнивается действие эксперта и действие, предсказанное, чтобы выровнять распределения.

Дополнительно используется лосс, который приближает распределения латентных переходов модели к тем, что наблюдаются в обучающих данных. Это помогает агенту научиться возвращению к траектории даже в ситуациях, когда он ушёл далеко.

Completing Explicit 3D Reconstruction via View Extrapolation with Diffusion Priors

Другая работа — о 3D-реконструкции с помощью дополнения недостающих видов. Это идея, которая сейчас витает в воздухе: если у нас есть всего несколько ракурсов объекта, и их не хватает для точной реконструкции, можно дополнить недостающие изображения сгенерированными диффузионной моделью.

Авторы используют diffusion priors, чтобы «достроить» недостающие виды (view extrapolation), а затем делают реконструкцию по расширенному набору. Базовая модель — Foundation-модель MVDream, которая работает с несколькими изображениями на входе. Если подавать больше сгенерированных видов (например, 3 + 3, 3 + 6), качество итоговой реконструкции улучшается.

Правда, есть нюанс: диффузионка может выдать неконсистентные виды, и в этом случае качество ухудшается. Но по мере того как сами модели улучшаются, подход начинает работать всё стабильнее. В этом исследовании как раз демонстрируется, что сгенерированные виды действительно помогают улучшить результат. Таких работ на конференции было много — идея активно развивается.

Uncertainty-Guided Enhancement on Driving Perception System via Foundation Models

Одна из немногих работ на ICRA, где LLM используется в контексте вождения. Идея простая: если perception-система не уверена в своём предсказании, можно подстраховаться с помощью foundation-модели. То есть модель делает предсказание и оценивает его надёжность. Если уверенность высокая — используем результат. Если низкая — подключаем LLM, которая даёт своё предсказание, и берём то, что надёжнее.

LLM тут не участвует в обучении и не делает инференс постоянно — её подключают только по необходимости. Это скорее механизм уверенного доуточнения, чем полноценный модуль восприятия.

Подводя итог, можно сказать, что ICRA, как и многие крупные конференции, — ещё и отличная площадка для нетворкинга. Удалось поговорить и обменяться идеями с инженерами из Zoox, Waymo, Nuro, Motional, Loxo и других компаний, которые занимаются автономным транспортом.

ML Underhood
2 048 просмотров · 13 реакций Открыть в Telegram · Открыть пост на сайте
Как в Яндекс Картах находят редкие дорожные знаки среди миллионов изображений

Важная задача отдела картопроизводства — улучшать качество детекции дорожных знаков. Один из способов — находить знаки на панорамах, снятых с помощью телефонов или камер безопасности в такси. На момент старта проекта детектор знаков уже был, но он находил не все знаки и с недостаточной полнотой и точностью.

Сами по себе знаки можно взять хоть из Википедии — там есть список всех 300+ штук. Но модель не тренируется на списке — нужны десятки тысяч изображений с примерами каждого знака в реальных условиях. Вот тут и начинается основная работа.

Пайплайн, описанный ниже, служит для сужения огромного набора снимков (сотни миллионов) до относительно небольшого (сотни тысяч), на которых присутствует искомый нами знак.

1. Находим всё, что может быть знаком
На имеющемся датасете обучили RT-DETR на единственный класс «дорожный знак». Он «выкручен в полноту»: то есть в трейдофе полнота <-> точность, выбрана именно полнота. Так сделано, потому что предсказания этого детектора — кандидаты на проверку. На выходе из этого этапа получается много «кропов-кандидатов» — кусочков исходного снимка, на котором представлено что-то похожее на знак.

2. Классификация кропов
Дальше в дело вступает few-shot-классификатор на основе нашей картиночной тушки — большой свёрточной сети, которую разрабатывает Служба компьютерного зрения. Из неё взяты «эмбединги похожих» — представление изображений в векторном пространстве, где похожие изображения переходят в близкие вектора. Поверх этих эмбедингов обучены несколько линейных слоёв. В качестве примеров позитивного класса используются 20–30 примеров нужного нам знака. Примеров негативного класса в избытке — их берут из текущего датасета дорожных знаков. В результате получается блок, который умеет отвечать: похоже ли входное изображение (кроп-кандидат) на искомый нами знак.

3. Классификация снимков
Если хотя бы один кроп на снимке прошёл классификацию, мы сохраняем весь снимок. Так из сотен миллионов остаётся от сотни тысяч до миллиона в зависимости от знака. Из полученных кандидатов мы отбираем на разметку лишь малое количество: 2–5–10 тысяч картинок.

Дальше подключается трёхступенчатый пайплайн разметки с помощью людей в Яндекс Заданиях.

1. Проверка наличия знака
Асессор отвечает, есть ли на изображении нужный знак («да», «нет», «не загрузилась картинка»). Это быстрый и дешёвый способ отсеять ошибки предыдущих этапов, не тратя ресурсы на полную разметку ненужных картинок. Чтобы на выходе получить, например, 1200 знаков, на вход подаём с запасом — 2000–3000 изображений, иногда больше, если знак редкий.

2. Разметка всех знаков
На оставшихся изображениях люди размечают прямоугольники вокруг всех дорожных знаков — не только искомого. Это важно для обучения детектора: нужны как положительные примеры, так и фоны с другими знаками, чтобы избежать ложных срабатываний.

3. Классификация каждого знака
Каждый размеченный знак показывается отдельно, и асессор выбирает, что это за знак — из палетки с 300+ вариантов. Пробовали упрощать интерфейс (группировка по цвету, форме и прочему), но это всё равно остаётся самым трудоёмким этапом.

Что в итоге
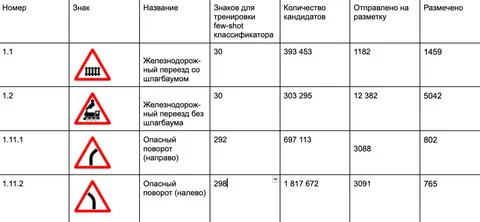
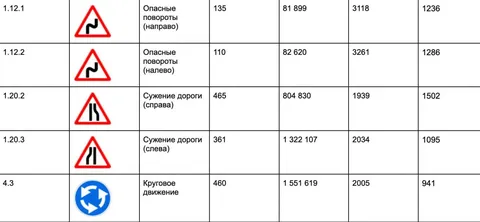
Сейчас весь пайплайн уже работает в проде. Для некоторых знаков, вроде «железнодорожный переезд», удалось собрать 5000 размеченных примеров — больше, чем требовалось. А вот со знаками поворота всё сложнее: классификатор часто путает «влево» и «вправо», из-за чего нужные картинки отсеиваются, и на выходе остаётся по 700–800 примеров. В ближайший месяц планируем дособрать все основные знаки по России и двинуться в сторону подготовки датасетов в межнаре.

ML Underhood
2 581 просмотров · 25 реакций Открыть в Telegram · Открыть пост на сайте
Как Яндекс Браузер извлекает контент веб-страниц для пересказа? Часть II

Продолжаем рассказ о суммаризации в Яндекс Браузере. В первой части речь шла об основной идее и её реализации, а во второй — заключительной — старший ML-разработчик в Яндекс Браузере Михаил Катунькин раскроет, как обучали модель.

Для сбора датасета мы пользовались двумя техниками: асессорскими разметками и синтетическими метками, полученными при помощи YandexGPT.

Асессору показывали веб-страницу, на которой он мог мышкой выделить блоки, соответствующие основному контенту. Таким образом собрали около 7 тысяч размеченных веб-страниц.

Размеченные данные мы разделили на две части. 2 тысячи примеров использовали в качестве тестового датасета. Оставшиеся 5 тысяч применили для дообучения YandexGPT для разметки веб-страниц.

При помощи YandexGPT разметили ещё 100 тысяч страниц, и уже на этих данных обучили Catboost. Последние 100 деревьев в Catboost обучались на 5 тысячах примеров, собранных асессорами.

Чтобы оценить качество извлечения контента, для каждой страницы считалась точность и полнота извлечения текста, а затем проводилось макроусреднение по всему датасету. Вариант без доразметки данных при помощи YandexGPT давал точность 88,8% и полноту в 96,3%. Доразметка подняла точность до 95,0% при той же полноте.

Наборы страниц для датасетов получали по следующему принципу: 50% — случайные страницы из интернета, прошедшие классификатор «суммаризируемости»; ещё 50% — случайный сэмпл страниц, на которых пользователи активировали пересказ в браузере. В каждой из выборок важно ограничить число страниц с одного домена, чтобы датасет был достаточно разнообразным.

Для того, чтобы размечать страницы при помощи YandexGPT, применили следующую технику. HTML-дерево делится на несколько пересекающихся деревьев меньшего размера, чтобы каждое из них попадало в контекст из 8192 токенов модели. Затем к выходным эмбеддингам YandexGPT, соответствующим определённому блоку текста, применяется бинарный классификатор. Для тех блоков, которые классифицировали несколько раз из-за перекрытия деревьев, берётся средняя метка. Бинарный классификатор, а также LoRA-адаптер к модели учатся на 5 тысячах страниц, размеченных асессорами.

Этот подход применим не только для суммаризации страниц. Так можно обучать классификаторы и детекторы и для других функций Браузера, используя то же самое пространство фичей.

ML Underhood
2 172 просмотров · 16 реакций Открыть в Telegram · Открыть пост на сайте
Исследователи Яндекса выложили в опенсорс Yambda — датасет на 5 млрд событий

В открытом доступе появился Yandex Music Billion-Interactions Dataset (Yambda) — один из крупнейших в мире датасетов в области рекомендательных систем. В этом посте рассказываем, зачем он нужен и какие у него ключевые особенности.

В последние годы рекомендации вышли на плато по сравнению с более быстро развивающимся областями, такими как LLM. Исследователям недоступны терабайты данных, которые нужны для развития рекомендательных систем, а коммерческие платформы редко делятся данными. Поэтому приходится использовать устаревшие и маленькие наборы. Модели, обученные на таких данных, теряют эффективность при масштабировании.

Существующие доступные датасеты, такие как MovieLens, Netflix Prize dataset, Amazon Reviews, Music4All-Onion, Steam и несколько других имеют ряд недостатков. Например, сравнительно небольшой размер делает их нерепрезентативным для коммерческих масштабов, а фокус на явных сигналах ограничивает полезность для моделирования реальных последовательных взаимодействий.

Чтобы решить эти проблемы и дать исследователям больше возможностей для разработки и тестирования новых гипотез в рекомендациях, исследователи Яндекса выложили в опенсорс свой датасет Yambda.

Ключевые особенности Yambda:

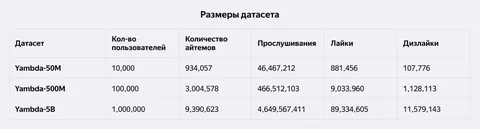
— Содержит 4,79 млрд обезличенных взаимодействий пользователей с музыкальными треками в Яндекс Музыке.
— Есть три версии: полная (5 млрд событий) и уменьшенные (500 млн и 50 млн
событий).
— Включает два основных типа взаимодействий: неявную обратную связь (прослушивания) и явную обратную связь (лайки, дизлайки, анлайки и андизлайки).
— Для большинства треков есть нейросетевые вектора, сгенерированные с помощью свёрточной нейронной сети (CNN), что позволяет учитывать некоторые характеристики музыкальных треков.
— Включены анонимизированные признаки метаданных треков, такие как длительность, содержание вложений, исполнитель и альбом.
— Каждое событие помечено флагом is_organic, который позволяет различать органические действия пользователей и действия, вызванные рекомендациями алгоритма.
— Все события имеют временные метки, что позволяет проводить анализ временных последовательностей и оценивать алгоритмы в условиях, приближённых к реальным.
— Данные распределены в формате Apache Parquet, что обеспечивает совместимость с распределёнными системами обработки данных (например, Hadoop, Spark) и современными аналитическими инструментами (например, Polars, Pandas).

Методы оценки

В отличие от метода Leave-One-Out (LOO), который исключает последнее положительное взаимодействие пользователя из обучающей выборки для предсказания, Yambda-5B использует глобальный временной сплит (Global Temporal Split, GTS). Преимущество GTS в том, что он сохраняет временную последовательность событий, предотвращая нарушение временных зависимостей между тренировочным и тестовым наборами данных. Это позволяет более точно оценить, как модель будет работать в реальных условиях, когда доступ к будущим данным ограничен или невозможен.

Вместе с датасетом представлены baseline-алгоритмы (MostPop, DecayPop, ItemKNN, iALS, BPR, SANSA, SASRec). Они служат отправной точкой для сравнения эффективности новых подходов в области рекомендательных систем.

Используются следующие метрики:

— NDCG@k (Normalized Discounted Cumulative Gain) — оценивает качество ранжирования рекомендаций.
— Recall@k — измеряет способность алгоритма генерировать релевантные рекомендации из общего набора возможных рекомендаций.
— Coverage@k — показывает, насколько широко представлен каталог элементов в рекомендации.

Датасет и код для оценочных бейзлайнов уже доступны на Hugging Face, а статья — на arXiv.

Статью подготовили ❣ Александр Плошкин, Владислав Тыцкий, Алексей Письменный, Владимир Байкалов, Евгений Тайчинов, Артём Пермяков, Даниил Бурлаков, Евгений Крофто, Николай Савушкин

@RecSysChannel
2 017 просмотров · 35 реакций Открыть в Telegram · Открыть пост на сайте
В опенсорсе появился датасет Yambda, который поможет исследователям и разработчикам по всему миру тестировать и совершенствовать новые алгоритмы рекомендаций. Все подробности читайте в посте.
1 715 просмотров · 10 реакций Открыть в Telegram · Открыть пост на сайте
Как Яндекс Браузер извлекает контент веб-страниц для пересказа? Часть I

Представьте, что вам нужно быстро проанализировать текст с десятка веб-страниц. На помощь придет функция краткого пересказа в Яндекс Браузере. Здесь — и не только здесь — работает суммаризация текста. Но возникает вопрос: что попадает в качестве входных данных в LLM, занимающуюся суммаризацией? На него в двух постах ответит Михаил Катунькин, старший ML-разработчик в Яндекс Браузере. В первой части речь пойдёт об общей идее и реализации, а во второй — об обучении модели.

Общая идея

Самое очевидное решение — взять HTML-код страницы. Его проблема в том, что верстка содержит в себе много лишней текстовой информации, которая «засорит» и сильно увеличит контекст модели: теги, скрипты, стили. Всё это приведёт к ухудшению качества пересказа, большему времени работы модели и удорожанию инференса.

Значит, следующий шаг — извлечь только текстовую информацию. Это улучшит ситуацию, но в контекст модели по-прежнему будет проникать много лишнего: реклама, меню, комментарии. А из-за того, что модель потеряет информацию о структуре страницы, в пересказ начнёт попадать, например, содержание статей из блока рекомендаций похожего контента.

Можно использовать разные эвристики, чтобы извлекать не весь текст страницы, а только полезный. Такой подход, например, используется в режиме чтения в браузере Однако из-за разнообразия верстки сайтов эта техника не является универсальной, нуждается в переподборе эвристик с течением времени, даёт плохое качество извлечения текста на определённых доменах.

Мы решили извлекать основной контент страницы при помощи ML-модели. А затем использовать информацию из HTML-кода для задания структуры текста: заголовков, подзаголовков, ссылок, выделений.

Важный нюанс: пересказ должен работать быстро даже при медленном интернете. Передавать тяжелые HTML-страницы целиком на серверы Яндекса было бы плохим решением. Поэтому модель следовало сделать легковесной, чтобы она работала непосредственно на устройстве пользователей.

Реализация

HTML представляет собой дерево тегов. Блоки с текстом на странице — это листья в дереве. Будем для каждого листа принимать решение: брать его или нет в конечный текст. В качестве бинарного классификатора возьмем Catboost.

Классификация осуществляется на основе множества статистик, посчитанных при обходе дерева: по тегам, атрибутам тегов, текстам. Существенное улучшение качества даёт следующий трюк: блоки с текстом классифицируется не независимо, а группами с одинаковым путём из тегов и атрибутов от блока до корня. При этом для хорошего качества извлечения текста модели достаточно информации о структуре разметки и базовых статистик по текстам.

Использование семантических вектор-признаков, посчитанных по текстам, заметного улучшения качества суммаризации не даёт. Поэтому в продакшен-версии от них решили отказаться ради скорости работы модели.

Было важно оптимизировать код подсчёта признаков для модели, из-за того, что деревья тегов могут содержать сотни тысяч узлов. В итоговой версии код реализовали на C++. Он работает 40 мс на одно извлечение в 90 перцентили. Для сравнения, код на JS с эвристиками из режима чтения в Mozilla работает 1,125 с в 90 перцентили. Для достижения этого результата, в частности, мы оптимизировали динамические выделения памяти, а также удалили из набора признаков сложные в вычислении, но не столь значимые.

Из HTML-дерева с проклассифицироваными листьями уже можно получить очищенный текст в формате markdown. Для этого по дереву идёт обход в глубину, собирающий текст из листьев, прошедших порог классификации, и учитывающий наличие тегов с заголовками, ссылками, выделениями и прочим.

ML Underhood
2 171 просмотров · 25 реакций Открыть в Telegram · Открыть пост на сайте
Как LLM помогают анализировать ответы в опросах

Вы когда-нибудь задумывались, как исследователи анализируют результаты опросов? С закрытыми вопросами, у которых есть несколько вариантов ответа, всё достаточно просто — алгоритмы суммаризации существуют давно. Но что насчёт анализа открытых вопросов, на которые респонденты отвечают в свободной форме? Это кропотливый и изнурительный труд, ведь приходится вручную обрабатывать сотни, а то и тысячи ответов.

К счастью, LLM может помочь и здесь. Ведущий исследователь интеграции ИИ и UX в Поиске Яндекса Алексей Шипулин рассказал нашему каналу о созданном им телеграм-боте, который помогает анализировать ответы на открытые вопросы и экономит массу времени.

«Под капотом» у бота сразу несколько моделей. Первая — помощнее — читает все ответы, ищет близкие по смыслу и составляет некоторое количество категорий. Дальше в дело вступает модель послабее, которая тоже знакомится с ответами и распределяет их по созданным ранее категориям. Чтобы процесс был прозрачнее для исследователя, модель комментирует каждый ответ, объясняя, почему он попал в ту или иную группу. Тут важно ещё и то, что LLM знают не только ответы, но и вопросы — это положительно сказывается на категоризации.

Казалось бы, на этом можно и заканчивать, но нет. Вторая модель может совершать ошибки, относя ответ не к той категории, где ему следует быть. Проверкой занимается третья LLM — она оценивает ответы на соответствие категории по трёхбалльной шкале. Те ответы, которые получили оценку «два» или ниже, снова проходят через второй этап и распределяются по другим категориям. Потом опять проверка и опять перераспределение, если нужно.

На финальном этапе ответы распределяются по частотности. Самые редкие алгоритм предлагает не относить в отдельные категории, чтобы не размывать статистику. А делать это или нет — решает исследователь.

Весь процесс, на который человек мог бы убить целый день, занимает не более трёх минут — и на выходе получается наглядный график и таблица с ответами. Всего же с момента запуска в октябре телеграм-бот сэкономил исследователям Яндекса уже 12 лет!

ML Underhood
3 267 просмотров · 26 реакций Открыть в Telegram · Открыть пост на сайте
Как LLM помогает быстрее находить товары на складе Маркета

Часто на складских полках рядом оказываются очень похожие товары. Это приводит к тому, что при сборке заказов товары приходится долго искать: сборщик берёт не то, смотрит, кладёт обратно, продолжает искать нужное. На таких «плохих» полках, где лежат визуально похожие товары (например, шторки одного цвета, но разных моделей) шанс вытащить искомое с первого раза не самый большой. В среднем на поиск нужной позиции теряется 4 секунды. А если таких операций полмиллиона в день, масштабы становятся внушительными.

Екатерина Трофимова, менеджер продуктов в команде логистики Маркета, рассказала, как с помощью LLM получилось оптимизировать хранение товаров на складе с учётом их похожести для более быстрого поиска.

До начала эксперимента у команды не было системного признака схожести товаров — их просто складывали, как придётся. Попробовали сформулировать фановую гипотезу: если системно понимать, какие товары похожи, можно оптимизировать процесс.

Мы применили технологию векторизации текста к названиям товаров, чтобы получить уникальный вектор, описывающий каждый товар. С её помощью считается и сравнивается похожесть того, что кладётся на полку, и того, что уже лежит на ней. Все наименования и метаданные товаров прогнали через YandexGPT и получили вектора, которые легко сравнить и посмотреть косинусную близость между ними. Если значение выше порогового — считаем, что товары слишком похожи и не даём класть их рядом. Если ниже — можно класть на одну полку.

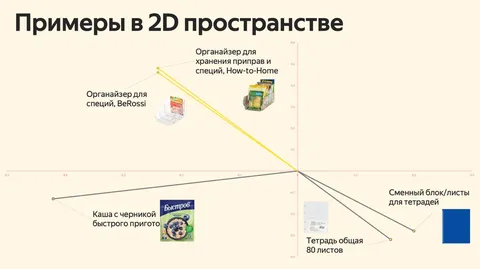
Пример на картинке. Органайзеры для специй разных производителей мы не дадим положить вместе, потому что их вектора очень близки друг к другу. Сменный блок и тетрадь можно положить рядом, потому что у них безопасное пороговое значение, хоть эти вектора тоже находятся относительно близко друг к другу. Каша с черникой могут отправиться как к органайзерам, так и к бумажной продукции.

Помимо LLM, пробовали использовать другие решения, например расстояние Левенштейна (метрика для измерения различий между двумя строками) — но это не сработало. В нашем случае названия товаров могут сильно различаться по форме, даже если они описывают один и тот же продукт, поэтому расстояние Левенштейна будет большим для схожих товаров. GPT справляется с задачей лучше: вектора для таких товаров близки, даже если названия выглядят совсем по-разному.

В среднем, новый подход даёт выигрыш в 2,5 секунды на поиск товара, что приводит к экономии около 2 миллионов рублей в месяц на масштабе всех фулфилментов Маркета. Точность применения метода мы субъективно оцениваем в 7 из 10 — можно было выиграть ещё 1,5 секунды, за счет более агрессивного значения схожести товаров, но чтобы не ловить упячки в духе «кастрюля схожа с вилкой, не клади их вместе», мы ограничились безопасным значением.

Проект работает в проде с июня 2024 года. Мы внедрили его на бэкенде WMS (системы управления складом), и в течение 30 дней после внедрения увидели, что эффект стабильно сохраняется.

Вся реализация решения от проверки гипотезы до внедрения в прод заняла один человеко-месяц разработки. Это подтверждает гипотезу, что не всегда нужно строить космолет — иногда можно сделать быстро, просто и полезно.

Можно сделать вывод, что LLM — это не только генерация, классификация и другие привычные задачи. Иногда стоит взглянуть на модель под другим углом — например, в этом случае её использовали как числовой преобразователь и нашли решение бизнес-задачи.

ML Underhood
2 673 просмотров · 36 реакций Открыть в Telegram · Открыть пост на сайте
Как Алиса видит мир

Недавно Алиса научилась распознавать объекты, показанные через камеру смартфона. В основе этой фичи лежит мультимодальная нейросеть (Visual Language Model, VLM), которая уже используется в Поиске по картинкам, Умной камере и Нейроэксперте. На Хабре вышла большая статья о том, как создавали эту модель, а здесь мы кратко расскажем главное.

VLM основана на семействе YandexGPT 5. Она состоит из LLM и картиночного энкодера. VLM получает на вход изображение и произвольную текстовую инструкцию и предсказывает текст — ответ на пользовательский запрос.

Датасет для претрейна мультимодальной модели состоял из документов, содержащих изображения, текстовых документов, пар «картинка-текст» и OCR-данных. Далее в обучении шла стадия SFT, а за ней — DPO.

VLM адаптировали в Алисы. Её зрение работает в двух режимах: можно загрузить изображение в чат, а можно включить камеру и показывать ассистенту то, что вы видите. Когда Алиса получает изображение и запрос, последний отправляется в рефразер, который адаптирует вопрос для поиска в интернете. Например, если пользователь просто показывает Алисе булгур и спрашивает «Сколько варить?», рефразер превращает вопрос в «сколько варить булгур».

Далее запрос отправляется в интернет. Модель собирает всю нужную информацию и выдаёт пользователю ответ (15 минут, если что).

А более подробно о том, как устроена VLM, а также об экспериментах и трудностях, которые возникали по ходу обучения, читайте на Хабре.

ML Underhood
2 621 просмотров · 17 реакций Открыть в Telegram · Открыть пост на сайте
Синхронный перевод видео в Яндекс Браузере

Перевод видео в Яндекс Браузере появился ещё в 2021 году. Сегодня компания представляет новую версию этой технологии, способную сохранять тембр и интонации оригинального голоса. А сам перевод стал точнее благодаря YandexGPT. В статье на Хабре вы можете почитать все подробности о том, как устроен инструмент, а здесь расскажем коротко.

В основе технологии синтеза речи лежит модифицированная опенсорс-модель Tortoise-TTS. Сама по себе она выдаёт результаты хорошего качества, почти неотличимые от человеческой речи. Однако есть несколько проблем, которые не позволяют использовать модель в продакшене.

Одна из них связана с качеством zero-shot-синтеза, то есть генерации аудио тем же голосом, что и в аудиопромпте. Результат может быть не похожим на исходник, а при переносе тембра с английского на русский появляется акцент.

Чтобы исправить это, в Яндексе использовали фонемное представление текста и создали общий алфавит для английских и русских фонем. Благодаря этому произношение модели стало более правильным. Для моделирования тембра голоса внедрили биометрические эмбеддинги и контролировали качество речи с помощью метрики UTMOS. А проблему акцента при переводе с английского на русский решили с помощью синтетического датасета, где голос одного и того же человека представлен на двух языках.

Ещё один недостаток Tortoise-TTS — низкая скорость инференса, из-за которой модель и получила своё название. В Яндексе оптимизировали её архитектуру, уменьшили количество итераций в диффузионной модели и применили технику дистилляции знаний. Благодаря этому, генерация ответа происходит в реальном времени.

SBS-тестирование показало, что новый перевод видео в Яндекс Браузере значительно превосходит решение ElevenLabs: 62% побед против 34%. Что касается исключительно озвучивания, то есть превращения текста в речь, то здесь система Яндекса также впереди: 46% против 42%.

Speech Info
2 126 просмотров · 20 реакций Открыть в Telegram · Открыть пост на сайте
Что-то кончается, что-то начинается

Так писал Анджей Сапковский. У нас заканчивается конференция ICLR и начинается — череда подробных обзоров по следам мероприятия. А сегодня — несколько вайбовых видео и все материалы, которые мы писали об ICLR 2025:

— Постеры, на которые стоит обратить внимание. Часть I.
— Постеры, на которые стоит обратить внимание. Часть II.
— Лучший постер второго дня с котиками.
— Пляшущие роботы и статьи от команды Yandex Research.

Оставайтесь с нами! А ещё больше материалов с ICLR вы найдёте в других наших каналах:

— Душный NLP
— Speech Info
— Рекомендательная
— CV Time

#YaICLR

ML Underhood
1 989 просмотров · 8 реакций Открыть в Telegram · Открыть пост на сайте
Подборка постеров с ICLR 2025

Продолжаем рассказывать о самых интересных статьях с конференции и показываем один весьма экстравагантный стенд.

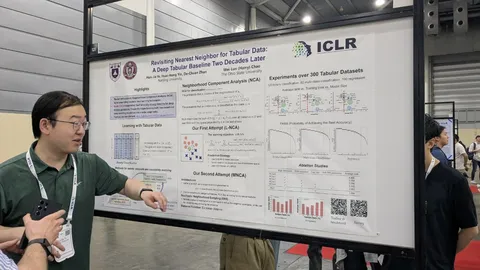
Revisiting Nearest Neighbor for Tabular Data: A Deep Tabular Baseline Two Decades Later

Авторы улучшили NCA (непараметрический метод на основе nearest neighbour) простыми нейросетями и обогнали бустинги и TabularDL на многих задачах.

Результаты:
— На наборе задач мульти-классификации их метод оказался лучшим на 20% задач, что на 7 процентных пункта больше, чем с Топ-2 подходом (у TabR 13%)
— Для бинарной классификации и регрессии результаты, скорее, сравнимы с текущими SOTA.
— Применялись на задачах с сотнями (но не тысячами) фичей.

Приёмы:
— Отказ от LBFGS в NCA в пользу SGD для обучения проектора.
— Стохастика и по батчам, и по соседям — сэмплируются случайные группы соседей одного класса/
— Заменили линейную проекцию из NCA на нелинейную. Используют простую нейросеть (2-3 слоя, BN, ReLU)/
— От предсказания жёстких меток класса перешли к вероятностям за счёт softmax, чтобы сгладить задачу оптимизации.

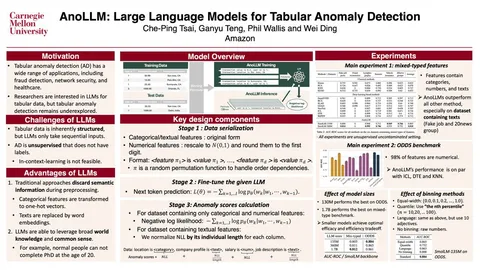
AnoLLM: Large Language Models for Tabular Anomaly Detection

Ищем аномалии в табличных данных.

— Составляем из данных корпус текстов вида «фича Х равна Y, ...».
— Файнтюним.
— Оцениваем вероятность встретить значение фичи при условии значений других фичей, считаем NLL.

Достаточно маленьких моделей (130М — 1,7B).

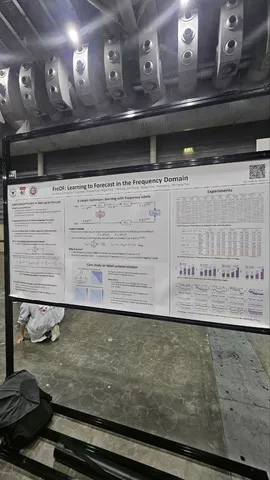
FreDF: Learning to Forecast in Frequency Domain

Для прогноза временных рядов авторы предлагают дополнительно к предсказанной и GT-последовательностям применять FFT и считать ещё один лосс между ними. Говорят, что получается неплохо.

А на последнем изображении тот самый экстравагантный стенд. Выглядит душевно!

Постеры заметили ❣ Кирилл Никоров, Пётр Вытовтов, Константин Бабалян

#YaICLR

ML Underhood
1 620 просмотров · 13 реакций Открыть в Telegram · Открыть пост на сайте
Танцуем в предвкушении, как этот милый робот-пёс

Уже завтра на полях ICLR два постера от команды Yandex Research!

C 10:00 по Сингапурскому времени можно будет ознакомиться со статьёй TabReD (Hall 3 + Hall 2B #348).

С 15:00 — пообщаться с авторами TabM (Hall 3 + Hall 2B #323).

Приходите посмотреть и познакомиться!
1 979 просмотров · 11 реакций Открыть в Telegram · Открыть пост на сайте
Крутые постеры с конференции ICLR 2025

Наши инженеры вовсю изучают постеры на мероприятии и делятся самыми любопытными статьями.

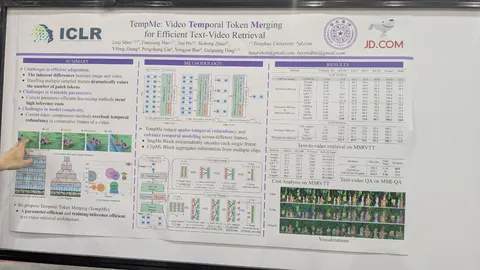
TempMe: Video Temporal Token Merging for Efficient Text-Video Retrieval

Авторы предлагают хитро дообучить Clip для ускорения поиска по видео. Результаты:

— в 1,5-3 раза снижается количество вычислений для инференса, в зависимости от базового метода;
— качество ранжирования в сером плюсе

Приёмы:

— Используется LoRA для дообучения энкодера.
— Применяется специальная процедура усреднения похожих токенов, как по временной, так и по пространственной размерностям.
— Для улучшения такого усреднения используются дополнительные позишн-эмбеды.
— За счёт этого снижается количество обрабатываемых токенов и возникают более явные зависимости между кадрами по времени.

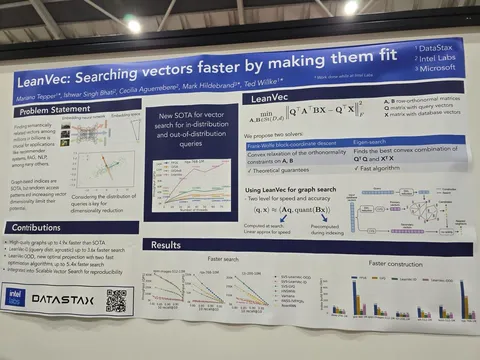
LeanVec: Searching vectors faster by making them fit

Авторы предлагают решение для ускорения процедуры поиска. Идея очень понятная и, возможно, много где реализована.

Собираем выборку запрос-документ, вычисляем матрицы A и B, преобразующие данные в меньшую размерность.
2. На этапе построения базы вычисляем Bx — получаем базу документов меньшей размерности и строим ANN (quant).
В процессе поиска делаем Aq, на основе которой из графа ищем ближайшие документы, а после уточняем кандидатов на этапе реранкинга по оригинальным векторам.

В статье приводят результаты экспериментов показывающие, что меньшая размерность может быть в 3-4 раза меньше исходной без значимой потери качества поиска. Плюс, полученное преобразование устойчиво к OOD.

Странно, что авторы не сравнили своё решение с подходом, использующимся при обучении многих SOTA-эмбеддингов: Matryoshka Representation Learning. В таком случае в модель уже встроены низкие размерности и не нужно ничего дополнительно обучать. По словам авторов, SOTA-библиотека от Intel, в которую они встроились, всё еще имеет всего 150 звезд на Github, так что теоретически идеи хорошие, а вот использовать ли их на практике — об этом стоит 10 раз подумать и самому оценить.

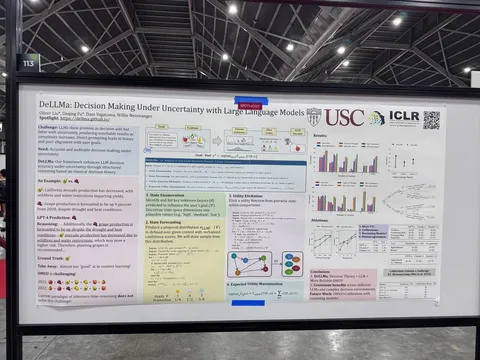
DeLLMa: Decision Making Under Uncertainty with Large Language Models

Авторы учат LLM принимать решения в условиях неопределённости. Они предлагают ввести лист состояний мира, который можно вывести из контекста и к которому, попарно для каждого state-action выводится функция полезности.

Постеры заметили ❣ Кирилл Никоров, Алексей Спасёнов, Александр Воронцов

#YaICLR

ML Underhood
3 030 просмотров · 9 реакций Открыть в Telegram · Открыть пост на сайте
От PyTorch к MONAI: опыт команды Yandex Cloud и ШАДа в медицинском AI

Разбираем интересный кейс из области медицины. В проекте по распознаванию редкой патологии spina bifida на УЗИ команда ML-инженеров из Школы анализа данных и Yandex Cloud приняла неожиданное решение. За неделю до релиза они полностью переписали пайплайн на MONAI — библиотеке для медицинского AI от NVIDIA. Дмитрий Сошников, выступивший ментором проектной команды, рассказал, почему стандартных инструментов PyTorch оказалось недостаточно, как MONAI упростила работу и какие модели команда планирует выложить в опенсорс.

Для обучения нейросети инженеры использовали датасет из 6 тысяч обезличенных УЗИ-снимков беременных женщин. Данные собрали и разметили специалисты НМИЦ имени Кулакова. Команда Yandex Cloud и студенты ШАДа построили архитектуру решения, включающую несколько нейросетей для поиска и классификации патологий. С помощью датасета студенты обучили модели и создали веб-интерфейс для врачей. Проект реализовали на платформе Yandex Cloud с использованием инструмента машинного обучения полного цикла Yandex DataSphere.

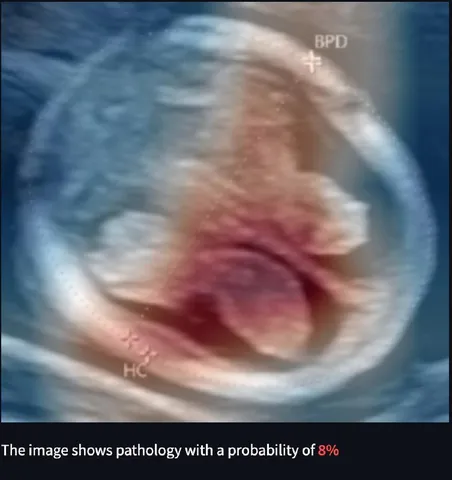
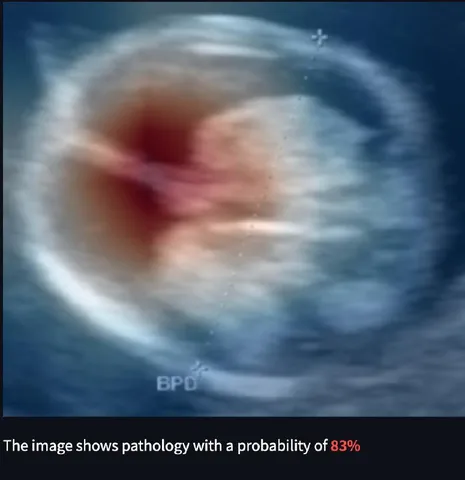
Выше можно сравнить два снимка (слева — без патологии, справа — с вероятностью патологии 83%) и получить представление о том, как сложно увидеть различия невооружённым глазом.


Изначально проект написали на «голом» PyTorch без специализированных медицинских библиотек. Пайплайн состоял из стандартных этапов:

— предобработки изображений;
— детекции области интереса с помощью нейросети YOLO;
— фильтрации снимков по качеству;
— поиска признаков патологии на хороших изображениях.

Подход работал, но оказался сложным для поддержки: разобраться в кастомных скриптах было непросто — особенно новым участникам команды или внешним специалистам. Поэтому когда стало ясно, что проект будет опубликован в опенсорсе и получит развитие, решили перейти на MONAI.

Переписывание всех частей пайплайна заняло неделю: сначала перенесли загрузку данных, затем — аугментации, потом — обучение и валидацию моделей. Особенно полезной оказалась аугментация для ухудшения качества снимков, которая имитировала реальные особенности УЗИ-аппаратов. Также пригодились готовые функции потерь для борьбы с дисбалансом классов и стандартные медицинские метрики. Кроме того, в MONAI есть встроенные инструменты интерпретации моделей, такие как Grad-CAM, что особенно важно для медицины: сегодня интерпретируемость моделей обязательна по этическим нормам.

Переход дал прирост сразу по нескольким направлениям. В первую очередь, улучшилось качество моделей — за счёт более разнообразных и реалистичных аугментаций. То же ухудшение изображений дало прирост точности на 2–3 процентных пункта. Также сократился объём кода и повысилась его читаемость: любые действия можно отследить через документацию MONAI, а не разбираться в кастомных скриптах.

Команда планирует выложить обученные модели в опенсорс в рамках MONAI Model Zoo — библиотеки предобученных моделей для медицины. Сейчас в разделе нет решений для ультразвука, и команда хочет закрыть этот пробел. Также разработчики готовят пайплайн для сбора новых данных, их разметки и дообучения моделей, чтобы специалисты НМИЦ Кулакова могли сами обновлять решение в будущем. Благодаря этому наработки можно будет использовать и в других медицинских задачах.

В заключение ещё раз напомним, что проект реализовывали выпускники ШАДа. Набор в Школу анализа данных Яндекса открыт до 5 мая. Если хочется своими руками создавать проекты, которые меняют индустрию и мир, — самое время подать заявку.

В подготовке поста участвовали: главный разработчик проекта Владимир Корсунов и руководитель проекта со стороны Yandex Cloud Евгений Попов.

ML Underhood
4 632 просмотров · 43 реакций Открыть в Telegram · Открыть пост на сайте
Как устроена модель исправления ошибок в нейроредакторе Яндекс Браузера — часть II

Продолжаем говорить о модели исправления ошибок, которая работает «под капотом» нейроредактора в Яндекс Браузере. В прошлой части ML-разработчик Никита Авдосев рассказал о качестве исправления и работы с промптом, а сегодня речь пойдёт о перфомансе.

Для ускорения генерации в компании прибегли к методу спекулятивного декодирования. Суть его заключается в использовании компактной «черновой» (draft) модели, которая предлагает варианты продолжения цепочек токенов. Основная модель проверяет их и выбирает одну с помощью стохастического алгоритма выборки.

Существует несколько подходов к спекулятивному декодированию, а в Яндексе остановились на одном из самых популярных — EAGLE. Он предполагает дообучение небольших голов поверх основой модели. Гипотезы при этом генерируются в виде дерева, а не списка, благодаря чему повышается точность принятия токенов.

В качестве эксперимента инженеры Яндекса решили попробовать метод на модели исправления грамматических ошибок в русскоязычных текстах. Выбор был сделан не случайно — это одна из самых широко используемых моделей в Браузере, ежедневно к ней обращаются более 50 тысяч человек.

Чтобы обучить EAGLE предсказывать токены быстрее, чем их придумает оригинальная модель, требуется много текстов. В Яндексе использовали 250 тысяч текстов из логов пользователей. Позже попробовали обучить на более чем миллионе текстов, но, к сожалению, это не улучшило результат.

Затем начали тестировать новую конфигурацию для инференса: подбирать количество предсказываемых токенов перебором. Остановились на предсказании четырёх токенов. Это золотая середина, после которой ускорения не происходило, а местами даже увеличивалась задержка.

Благодаря EAGLE время генерации текста сократилось более чем в два раза. Теперь она в среднем занимает меньше секунды, что в контексте LLM — почти моментально.
Для ускорения моделей, которые работают с промптами пользователей, применяли FP8-квантизацию. Её отличительная особенность — квантизация не в целые, а в вещественные числа. Подход позволил добиться ускорения на 15% по сравнению с методом SmoothQuant, использованным ранее.
ML Underhood
2 236 просмотров · 11 реакций Открыть в Telegram · Открыть пост на сайте