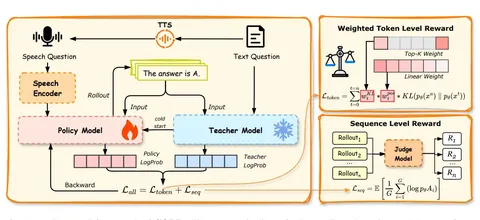
Is Text All You Need? Text as a Universal Information Bottleneck for Speech LLMs

Сегодня разбираем статью Microsoft Research о том, как подключать аудио к LLM.

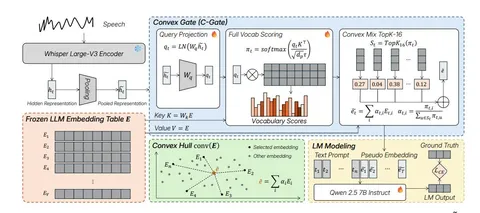
В стандартном подходе берут аудиоэнкодер, например предобученный ASR, обучают адаптер и через него подают аудиопредставления в LLM. Здесь предлагают не позволять адаптеру генерировать произвольные вектора, а собирать их только из тех эмбеддингов, которые уже есть в embedding table LLM. Для этого авторы предлагают Convex Gate (C-Gate) — представления из аудиоэнкодера преобразуются в точки внутри выпуклой оболочки эмбеддингов LLM.

Как всё работает

1) Звук прогоняют через Whisper Large-v3, забирают hidden states и делают mean pooling со stride 4.

2) Берут замороженную embedding table LLM. Аудиопредставления через Wq проецируются в queries, а эмбеддинги словаря через Wk в keys. При этом values остаются исходными эмбеддингами LLM без домножения на матрицу.

3) Дальше идёт классическое перемножение запросов на ключи, софтмакс, и получаются скоры для эмбеддингов из LLM.

4) Берут только топ-16 эмбедов по полученным скорам, нормализуют и собирают из них один вектор — он лежит в выпуклой оболочке исходных эмбеддингов LLM. И его и подставляют в LLM наряду с текстовыми токенами.

Аудиоэнкодер заморожен, но сама LLM не совсем: авторы дообучают self-attention в первых 24 слоях Qwen2.5-7B-Instruct. В итоге обучаемых параметров здесь довольно много — около 700М, из которых на сам C-Gate приходится всего 2,5M.

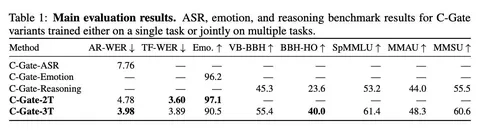
Учат модель сразу на трёх задачах: распознавание речи, классификацию эмоций и speech reasoning. Для мультитаска используют dynamic loss weighting и EMA smoothing. То есть веса лоссов разных задач меняются по ходу обучения в зависимости от того, насколько хорошо уже выучилась конкретная задача.

Почему это прикольно

Авторы говорят, что так мы не меняем базис пространства, с которым работает LLM. Обычные токены из embedding table и так после self-attention превращаются во взвешенные суммы эмбеддингов. Здесь почти то же самое: получаем взвешенную сумму известных эмбедов и остаемся внутри их выпуклой оболочки.

По замыслу это должно уменьшать дрифт базиса, но при этом не заставлять аудио превращаться в дискретные текстовые токены — тогда потерялись бы эмоции, просодия и другая паралингвистическая информация.

Ещё появляется некоторая интерпретируемость: можно посмотреть, какие top-16 токенов выбраны на каждом шаге.

Что получилось

Авторы показывают что на базовых задачах качество при обучении этим методом получается нормальное для их размеров моделей. При мультитаск-обучении на распознавании и эмоциях оба бенчмарка растут, а если добавить ризонинг-задачи, то и его качество улучшается относительно однозадачного обучения. Но не раз делают акцент на том, что на SOTA не претендуют и работа больше исследовательская.

Ещё в статье делают ряд дополнительных проверок, чтобы понять, что именно важно в полученной траектории эмбеддингов. Например, интересно, что веса топ-16 векторов, в которые проецируют аудиоэмбеды, часто близки к равномерному распределению.

В целом концепт занятный, но главный вопрос остаётся: насколько выигрыш даёт именно ограничение на convex hull, а насколько — просто дополнительное capacity? По сути, C-Gate всё равно остаётся адаптером, просто с очень специфической геометрией выхода. То есть очень не хватает эксперимента-сравнения с обычной схемой с адаптером с тем же числом обучаемых параметров. Забавно, что именно этот эксперимент сами авторы называют следующим шагом.

Даниил Волгин ❣ Специально для Speech Info
281 просмотров · 22 реакций Открыть в Telegram · Открыть пост на сайте
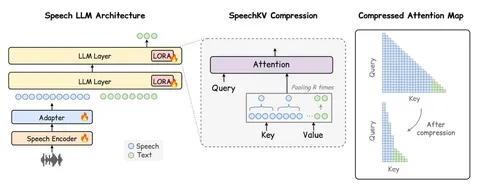
Compress the Cache, Not the Speech Embedding: KV Compression for Efficient Speech LLMs

Инференс в speech LLM часто обходится дорого — и во многом именно из-за длины аудиопоследовательностей. Разберём статью, предлагающую необычное решение этой проблемы.

Речь устроена более разреженно, чем текст. Так, 10 секунд аудио после speech-энкодера могут превратиться примерно в 125 аудиотокенов, хотя соответствующий текст займёт всего 30–40 токенов — разница примерно в четыре раза.

На этапе обучения это не критично, но во время авторегрессивного декодинга начинаются сложности. Даже если мы не пересчитываем аттеншн на каждом шаге для всего префикса, а берём сохраненные значения из кеша, каждый новый токен смотрит на все предыдущие keys и values. В результате для каждого нового токена приходится работать с длинной последовательностью аудио.

Для более эффективной работы мы хотим уменьшить количество speech positions. Делать это можно на разных уровнях. Например, в большинстве современных моделей в энкодере происходит downsampling, а в адаптере несколько соседних эмбеддингов можно объединить в один. Авторы SpeechKV предлагают другой вариант: уменьшать количество speech positions в KV-кеше LLM, сохраняя в энкодере и адаптере как можно больше информации.

Суть метода: начиная с некоторого слоя LLM авторы объединяют каждые R подряд идущих speech-позиций в KV-кеше с помощью обучаемого пулинга — линейный gate по key-векторам выдаёт softmax-веса внутри окна, и с этими весами усредняются и key-, и value-векторы. Окна не пересекаются, сжатие применяется только к speech-позициям, а текст, query-векторы и residual stream остаются в полном разрешении; при R=4, например, четыре соседних key- и value-вектора превращаются в один.

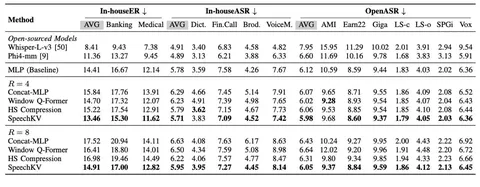
В экспериментах авторы взяли Qwen3-1.7B, обучили speech-энкодер, адаптер и LoRA при замороженных остальных весах LLM на 71 тыс. часов открытых ASR-данных. Оценивали модель на OpenASR, in-house ASR-сетах и отдельно — на entity recognition в банковском и медицинском доменах.

SpeechKV сравнили с бейзлайном без компрессии, с двумя методами, которые делают downsampling речи раньше — на уровне адаптера (Concat-MLP и Window Q-Former), и с альтернативой, сжимающей внутри LLM не KV, а весь hidden state. При R=4 на out-of-domain-сетах компрессия в адаптере просаживает качество, потому что, по предположению авторов, fine-grained-информация теряется слишком рано и LLM не может её восстановить.

В методе SpeechKV speech positions после сжатия с R=4 по гранулярности становятся ближе к текстовому, размер speech-части KV-кеша сокращаются примерно в 2,8 раза, а decoding в vLLM ускоряется в 1,5–2 раза. Чем длиннее аудио, тем заметнее выигрыш. Увеличение коэффициента сжатия до R=8 почти не даёт дополнительного ускорения: bottleneck постепенно смещается в FFN-слои и текстовую часть KV-кеша.

Сжимать KV начинают только с пятого слоя, потому что на первых слоях представления соседних speech-позиций сильно различаются, а дальше косинусная близость между ними выходит на плато, так что объединять их можно почти без потери информации. Аблейшены это подтверждают: старт с третьего или седьмого слоя даёт заметно худшие результаты на in-house-сетах.

Главное ограничение работы — пока неясно, насколько результаты переносятся на более крупные speech LLM, другие архитектуры и задачи за пределами ASR и entity recognition. Эксперименты проведены на небольшой Qwen3-1.7B и на данных, существенно меньших по масштабу, чем те, на которых обучают современные универсальные speech LLM. Поэтому SpeechKV стоит воспринимать не как подтверждённый универсальный рецепт, а как удачную демонстрацию того, что сжимать аудио необязательно на входе в LLM: часть избыточности можно убрать позднее, непосредственно в KV-кеше, сохранив полезные низкоуровневые детали речи.

Именно это делает направление интересным для дальнейшей проверки на больших моделях. Если эффект сохранится при масштабировании, KV-компрессия может стать относительно простым способом снизить стоимость long-audio inference без заметной деградации качества.

Екатерина Козлова ❣ Специально для Speech Info
479 просмотров · 31 реакций Открыть в Telegram · Открыть пост на сайте
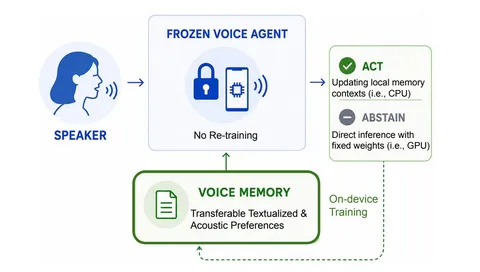
Voice Memory for Agentic Speech Recognition

Сегодня разбираем работу от NVIDIA о том, как улучшить распознавание речи, автоматически подстраивая инструкции LLM-корректора под конкретный домен. Веса моделей при этом остаются неизменными.

Один из способов улучшить ASR на инференсе — взять несколько его гипотез и отдать LLM с фиксированным промптом вида «ты корректор, исправь ошибки и выдай правильную гипотезу». Такой подход называется GER (Generative Error Correction).

Проблема в том, что на доменах, где WER и так низкий, LLM может начать исправлять несуществующие ошибки: менять написание чисел, перефразировать текст, заменять слова синонимами. В итоге расхождений с эталоном становится больше.

Voice Memory автоматически формирует доменные инструкции, которые помогают корректору решать, когда и как стоит исправлять текст. Для этого в контекст добавляют небольшой файл memory.md. Изначально память пустая, и корректор работает с обычным базовым промптом.

Дальше её формируют на данных с эталонными транскрипциями:

1. Корректор обрабатывает батч ASR-гипотез, а его ответы сравнивают с эталонами.

2. LLM-оптимизатор анализирует удачные и неудачные исправления и предлагает добавить, удалить или заменить несколько правил в инструкции корректора.

3. Новую версию проверяют на отдельной выборке. Если выбранная метрика улучшилась, изменения принимают.

4. Иначе оставляют прежнюю память, а отклонённый вариант учитывают при следующей попытке.

Данные для формирования правил, отбора лучшей версии и финального теста разделены. По умолчанию авторы используют четыре эпохи. В основном эксперименте одна и та же MiniMax-M3 выступает и корректором, и оптимизатором.

В памяти появляются конкретные инструкции: сохранять исходное написание слов, избегать лишней нормализации, записывать денежные суммы в принятом для домена формате и прочее.

На инференсе LLM читает пять гипотез Whisper и память, затем либо исправляет транскрипцию, либо возвращает top-1 без изменений. Решение воздержаться от правок принимает сама LLM, поэтому её вызов всё равно нужен. Под агентностью в этом случае авторы понимают сочетание выбора действий, постоянной внешней памяти и её автоматического обновления по обратной связи.

Для оценки используют WER, а также RIR (Recoverable Information Ratio) — долю разрыва между WER исходной top-1-гипотезы и Oracle WER, которую удалось закрыть корректору. Oracle выбирает лучшую готовую гипотезу для каждой фразы, зная эталон. Генеративный корректор может собрать текст точнее любой гипотезы, поэтому RIR бывает и больше единицы.

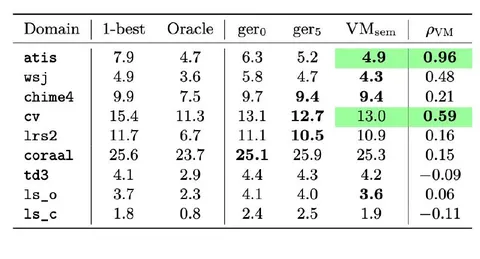
Заметный выигрыш Voice Memory даёт на запросах об авиаперелётах (ATIS) и финансовых новостях (WSJ). В основном эксперименте на ATIS исходный ASR показывает WER 7,9%, GER без примеров — 6,3%, а Voice Memory — 4,9%. На WSJ GER ухудшает исходные 4,9% до 5,8%, тогда как Voice Memory снижает WER до 4,3%.

На других доменах результаты смешанные. Относительно того же GER на CHiME-4, CommonVoice и LRS2 WER немного снижается, а на CORAAL растёт. На LS-Clean Voice Memory лучше GER — 1,9% против 2,4%, но исходный ASR всё ещё лучше — 1,8%. Память делает корректор осторожнее, но не гарантирует улучшения распознавания.

Есть любопытная деталь: новые версии памяти можно отбирать по смысловой близости ответа к эталону. В отдельной проверке на двух доменах этот критерий дал немного лучший итоговый WER, чем отбор непосредственно по WER.

Главная ценность Voice Memory — возможность автоматически настроить LLM-корректор под конкретный домен на небольшом объёме размеченных данных. Исправления при этом сохраняются в виде общих правил в читаемом файле, их можно проверить, отредактировать и попробовать с другой моделью. При желании память можно дополнить few-shot-примерами.

Веса модели не меняются, дополнительных вызовов LLM на инференсе нет. Расходы приходятся только на предварительную оптимизацию. При этом корректор учится не редактировать уже правильные гипотезы, что для него полезный навык.

Никита Боровко ❣ Специально для Speech Info
552 просмотров · 24 реакций Открыть в Telegram · Открыть пост на сайте
OmniVoice: Towards Omnilingual Zero-Shot Text-to-Speech with Diffusion Language Models

Сегодня разбираем OmniVoice — мультиязычную zero-shot TTS-модель на базе дискретной диффузии. Авторы заявляют поддержку 646 языков, но качество проверяли только на 102, поэтому для всех 646 оно не гарантируется.

Модель быстро набрала популярность, и появилось много пользовательских интеграций и демо. Авторы также показывают быстрый инференс и конкурентное качество синтеза.

Что происходит архитектурно.

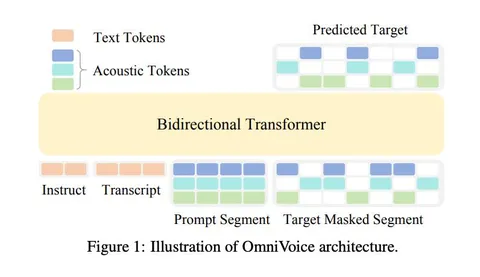
🔴OmniVoice — это single-stage-модель на уровне дискретных представлений. По тексту (а в режиме voice cloning — и по акустическому промпту), она сразу предсказывает токены аудиокодека — без промежуточной semantic-token-модели. Длину целевой последовательности при этом задают заранее, а готовые токены декодирует отдельный кодек.

🔴Transformer инициализируют весами Qwen3-0.6B. В абляции на английских и китайских тестах такая инициализация заметно снижает WER по сравнению со случайной. Хотя модель инициализируют весами авторегрессионной Qwen3, каузальную маску убирают. Transformer видит контекст с обеих сторон и совместно восстанавливает токены во всей целевой акустической матрице.

🔴Аудио представляют через Higgs Audio V2 в виде матрицы из восьми кодбуков. Эмбеддинги токенов со всех уровней суммируют и подают в Transformer, а после форварда восемь голов параллельно предсказывают токены для каждого уровня.

Обучение стандартное для masked diffusion. Часть токенов случайно заменяют на MASK-токены и учат модель восстанавливать исходные. Одно из ключевых нововведений — full-codebook random masking. Отдельные токены независимо маскируются по всей матрице восьми кодбуков, а loss считается сразу по всем замаскированным позициям.

На инференсе целевая матрица изначально заполнена MASK-токенами. На каждой итерации Transformer предсказывает значения для всех ещё закрытых ячеек. Значения токенов выбираются жадно из распределения с classifier-free guidance, а позиции для раскрытия семплируются через Gumbel-Top-k с учётом confidence и штрафа за глубину кодбука. Раскрытые токены больше не маскируются и на следующем форварде служат дополнительным акустическим контекстом. По умолчанию выполняется 32 итерации.

Обучалась модель на 581 тысяче часов аудио из опенсорса. После английского и китайского языков в данных идёт огромный длинный хвост, поэтому авторы используют language-level resampling, чтобы немного повысить вес редких языков.

Модель также умеет управлять характеристиками голоса, задавать паралингвистические теги и произношение отдельных слов. При этом voice design обучался преимущественно на китайских и английских данных и для низкоресурсных языков может работать нестабильно.

В итоге получилась простая диффузионная схема, которая масштабируется на сотни языков и показывает неплохое качество. Код и веса открыты — можно идти и пробовать.

Александр Плахин ❣ Специально для Speech Info
973 просмотров · 15 реакций Открыть в Telegram · Открыть пост на сайте
MOSS-TTS Technical Report

Разбираем техрепорт MOSS-TTS. В нём генерацию речи пытаются свести к конструкции, объединяющей хороший аудиотокенизатор и GPT, которая предсказывает его токены.

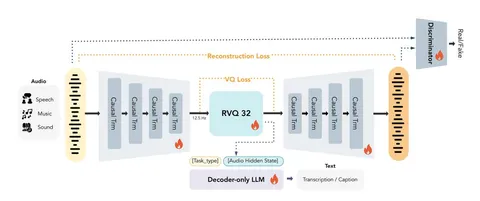
В основе MOSS-TTS собственный аудиотокенизатор авторов. Он принимает аудио 24 kHz и сжимает его до 12,5 временных фреймов в секунду с разным битрейтом в зависимости от количества используемых слоёв RVQ. Каждый фрейм содержит несколько RVQ-кодов — по одному на используемый слой. Аудиотокенизатор полностью построен на трансформерных блоках (без использования CNN) и обучается на универсальных аудиоданных — от речи до музыки и звуковых эффектов.

Сырой аудиосигнал режется на патчи, которые проходят через трансформер с causal sliding-window attention. RVQ с 32 слоями превращает непрерывные представления в дискретные токены. Во время обучения используется разное количество слоёв RVQ, поэтому один и тот же токенизатор умеет работать с разным битрейтом.

Если учить такой кодек просто восстанавливать аудио, RVQ-токены могут хорошо кодировать акустические признаки (тембр, интонацию и т.д.), но не содержать семантический смысл. Поэтому поверх выходов квантайзера навешивают 0.5B decoder-only LM и заставляют её решать текстовые задачи ASR, multi-speaker ASR и audio captioning. Градиент от этих задач течёт обратно в кодек и заставляет сами аудиотокены содержать семантическую информацию.

Параллельно токенизатор учится качественно восстанавливать звук. Для этого есть reconstruction loss, лоссы квантайзера и два GAN-дискриминатора. В итоге семантика, акустика и квантование учатся совместно. Правда, GAN-loss авторы подключают не сразу: первую часть обучения модель учится без них.

После того как хороший кодек получен, задача TTS превращается просто в предсказание его токенов. Пробуют две архитектуры с разным балансом качеств.

1) Delay Pattern. Поверх hidden states GPT накидывается несколько prediction heads, а разные уровни RVQ сдвигаются относительно друг друга. Это позволяет не растягивать генерацию в число RVQ-слоёв раз и быстро предсказывать токены. Минус в том, что увеличивается latency до первого звука.

2) Local Transformer. Основной трансформер работает по времени, а небольшой поверх него — в глубину RVQ-кодов и последовательно предсказывает все коды одного фрейма. Такой вариант позволяет быстрее начать стриминг и, по экспериментам авторов, лучше сохраняет идентичность спикера. В тестах на клонинг 1.7B Local Transformer получает более высокую speaker similarity, чем 8B-модель с Delay Pattern. Прямого сравнения двух подходов при одинаковом размере модели авторы не приводят, так что делать вывод, что Local Transformer во всём лучше, не очень хочется.

Много внимания уделяют данным. Миллионы часов аудио проходят ASR, diarization, фильтрацию по качеству, проверку согласованности языка аудио и текста, а также текста с длиной аудио. Более того, входной текст специально портят, убирая и добавляя знаки препинания, вставляя пробелы и переносы строк. Так модель пытаются сделать устойчивее к тому, что реально может прийти от пользователя.

Авторы репортят очень хорошее качество самого кодека при разных битрейтах: на речи он превосходит рассмотренные открытые кодеки, а на музыке и других типах аудио показывает конкурентные результаты. Local Transformer показывает более высокую speaker similarity, а Delay Pattern авторы используют для длинных генераций. На последней стадии претрейна максимальную последовательность увеличивают до 64k позиций, благодаря чему в демо модель способна за один проход сгенерировать непрерывную речь длиной в 45 минут. Правда, на очень длинных последовательностях similarity постепенно падает, модель начинает забывать голос из промпта.

Идея сводится к тому, что если сделать хороший аудиотокенизатор, который сохраняет семантику и акустику, то сам TTS можно свести к предсказанию дискретных токенов GPT-шкой. А дальше уже выбирать баланс: Delay Pattern для более длинной стабильной генерации или Local Transformer для более локального моделирования и лучшего сохранения идентичности спикера.

Денис Шувалов ❣ Специально для Speech Info
744 просмотров · 20 реакций Открыть в Telegram · Открыть пост на сайте
Как научить машину слышать «естественно»: GSRM и UniSRM  [2/2]

В SpeechJudge, которую мы уже разобрали главный риск был в том, что правильный вердикт Gemini ещё не гарантировал нормальный reasoning trace. GSRM и UniSRM подходят к проблеме с двух разных сторон. В GSRM считают, что омни-модель по умолчанию плохо извлекает тонкие признаки из сырого аудио. В UniSRM отдельно награждают не только финальный ответ, но и промежуточные оценки внутри рассуждения.

GSRM: Generative Speech Reward Model for Speech RLHF

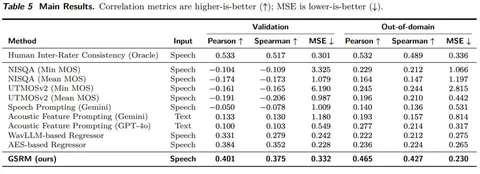
Сначала авторы оценили человеческий потолок. Аннотаторов разделили на две группы и посчитали корреляцию между их оценками: Pearson correlation составила всего 0,53.

Затем попробовали готовые аудиомодели без дообучения. При прямой оценке сырого аудио корреляция была слабоположительной или даже слабоотрицательной. Главный тезис GSRM: проблема не столько в ризонинге, сколько в восприятии. Модель может нормально рассуждать, но сначала ей нужно явно показать, что происходит в аудио.

Для каждой гласной считают набор DSP-признаков просодии, текстовая модель превращает их в evidence log, увязанный с ground-truth-оценкой. На этих логах учат Qwen2.5-Omni-7B выдавать такие же рассуждения и оценки уже по сырому аудио — DSP нужны только для синтеза обучающих данных.

На OOD-данных модель даёт PCC 0,465 — около 87% от человеческого потолка; помогает и test-time scaling, насыщение примерно к 16 семплам.

GSRM проверили и живым reward'ом: через GRPO на нём дообучили full-duplex speech LLM, она выигрывала у базовой в 82% сравнений по натуральности и в 60–74% по остальным измерениям. Код и модели не открыли.

UniSRM: A Unified Speech Reward Model for Reasoning-Based Fine-grained Assessment

UniSRM решает четыре задачи: парное сравнение аудио, детальный MOS-скоринг, соответствие речи сценарию и оценку реплики в контексте диалога. Три задачи pairwise, а MOS — pointwise (одно аудио оценивают по семи аспектам от 1 до 5).

После SFT идёт GRPO с составной наградой, где RCR — reasoning-consistent reward. Награда складывается из трёх частей:

1) Reward за формат: неправильный формат получает −1, правильный — 0.
2) Reward за вердикт: accuracy для pairwise-задач и соответствующая оценка для pointwise.
3) Reward за ризонинг: промежуточные оценки по отдельным аспектам сравниваются с эталоном.

В pairwise-задачах смотрят, на какой доле аспектов знак разницы между двумя аудио совпал с ground truth. В pointwise используют единицу минус среднюю нормированную ошибку по семи аспектам. Если награждать только финальный ответ, модель может угадать его на бессвязном ризонинге. Промежуточные проверки оставляют меньше пространства для такого трюка.

RCR-GRPO обошёл и чистый SFT, и GRPO с наградой только за вердикт — причём последний местами был хуже SFT. UniSRM сильнее сравниваемых моделей на всех четырёх задачах, но метки ставила LLM, люди верифицировали лишь часть — цифры смещены в её сторону. Внутри онлайн-RL судью не проверяли.

Что можно забрать из трёх работ

🔴Не использовать отдельные WER, UTMOS или speaker similarity как единственного арбитра.
🔴Сначала проверять reward model через best-of-N.
🔴Сначала делать SFT, который учит формат reasoning, и только потом RL на сложных метках.
Награждать не только вердикт, но и промежуточные оценки.
🔴Не ждать автоматического переноса на смежную задачу, так как судья тесно связан с данными и сетапом обучения.

Разметка при этом дорогая: 99 тысяч пар для SpeechJudge собирали два месяца и потратили около 70 тысяч долларов. Это хорошо показывает, какой ценой получают базовый human preference signal.

Василий Ерёмин ❣ Специально для Speech Info
613 просмотров · 9 реакций Открыть в Telegram · Открыть пост на сайте
Как научить машину слышать «естественно»: SpeechJudge [1/2]

Сегодня начинаем разбирать три работы о speech reward models — SpeechJudge, GSRM и UniSRM. Все они строят генеративного судью поверх Qwen2.5-Omni-7B и дистиллируют ризонинг у более сильной модели. Отличаются тем, что именно чинят — данные, восприятие или награду. SpeechJudge вкладывается в разметку: 99 тысяч пар от живых людей. GSRM меняет вход: рассуждение строится не по самому аудио, а по явно вытащенным DSP-признакам просодии. UniSRM меняет награду: на RL-стадии проверяется не только финальный вердикт, но и оценки по каждому измерению внутри рассуждения.

Начнём с того, зачем вообще нужна отдельная reward model для речи. Ответ — чтобы нормально заводить RL-алайнмент TTS. Обычные метрики когда-то были неплохим прокси, но постепенно насытились. Низкий WER уже мало говорит о натуральности, ведь если продолжать оптимизировать только его, можно получить очень разборчивую, но роботизированную речь. UTMOS и похожие оценщики тоже возвращают один скаляр, который сложно интерпретировать и легко начать оптимизировать не в ту сторону.

В базовом сетапе модель генерирует два аудио, человек выбирает лучшее, а reward model учится воспроизводить этот выбор. Скалярному судье можно просто прикрутить линейную голову и обучить по модели Брэдли-Терри. Генеративная модель дополнительно делает ризонинг, объясняя, что происходит с натуральностью, артикуляцией, темпом и просодией, а потом выбирает победителя. Такого судью можно сначала проверить через best-of-N, а затем использовать в DPO или онлайн-GRPO.

SpeechJudge

Авторы собрали 99 тысяч размеченных людьми пар аудио: шесть zero-shot TTS-моделей трёх архитектур, китайский, английский и code-switching, обычная и выразительная речь.

Неоднозначные пары отправляли дополнительным асессорам, в среднем получилось 2,49 оценки на пару. Затем отфильтровали спорные примеры и пары, где записи слишком расходились по WER — иначе разница в разборчивости забивает натуральность. Осталось 44 тысячи пар: 42 тысячи для обучения, по тысяче для dev- и SpeechJudge-бенчмарка.

Лучшим готовым судьёй на этом бенчмарке оказался Gemini 2.5 Flash, поэтому его взяли как учителя. Дальше обучение шло в две стадии. Для 25 тысяч пар, где вердикт Gemini совпал с человеческой меткой, сгенерированные reasoning traces использовали для SFT. Оставшиеся 17 тысяч пар отправили в RL. Правильная человеческая метка выступала verifiable reward, а модель пыталась сама достроить рассуждение, которое к ней приводит.

Но совпавший финальный ответ ещё не означает, что промежуточное рассуждение корректно. Gemini могла выбрать нужное аудио на мусорном reasoning trace, а затем этот trace попадал в SFT. В следующих работах как раз пытаются отдельно чинить восприятие аудио и проверять качество ризонинга.

И всё же постобучение помогло. Генеративный SpeechJudge обошёл Gemini 2.5 Flash и скалярный Bradley-Terry-бейзлайн, а голосование по нескольким запускам дало ещё небольшой прирост.

Авторы этой статьи — единственной из трёх, где судью применили к самой TTS-модели, — проверили, насколько ему можно доверять на практике. В best-of-100 он выбирал лучшее аудио, после чего человек сравнивал его со случайным семплом из той же сотни. Примерно в 30% случаев случайное аудио оказывалось лучше. На отдельном тесте «синтетическая речь против настоящей» SpeechJudge тоже просел: модель обучалась только на синтетических парах и выучила более узкую задачу, а deepfake-детекторы справились лучше.

То есть SpeechJudge показывает, что генеративную speech reward model действительно можно обучить поверх human preferences. Но хороший результат на собственном бенчмарке ещё не гарантирует, что судья не сломается на новом распределении или внутри RL. В следующей части разберём ещё две статьи о speech reward models.

Василий Ерёмин ❣ Специально для Speech Info
773 просмотров · 21 реакций Открыть в Telegram · Открыть пост на сайте
Interaction Models: A Scalable Approach to Human-AI Collaboration

Каскад из VAD, ASR, LLM и TTS всё ещё остаётся одним из самых понятных способов собрать голосового агента. Компоненты можно независимо улучшать и менять распознавание, языковую модель, поиск, инструменты, и, конечно же, синтез. Но за модульность приходится платить — задержки компонентов складываются, а взаимодействие обычно остаётся пошаговым: сначала говорит пользователь, затем отвечает модель. Согласитесь, это не то, как общаются люди.

Перебивания, паузы, короткие подтверждения и невербальные сигналы приходится обрабатывать через dialog manager, VAD и набор эвристик. Стриминговые же ASR и TTS могут уменьшить задержку, но фундаментально эту схему не меняют.

Альтернатива — полнодуплексные (full-duplex) speech-to-speech-модели. Например, Moshi от Kyutai одновременно слушает пользователя и генерирует собственный аудиопоток. Это позволяет естественнее обрабатывать перебивания и наложение реплик. Авторы заявляют потоковую задержку около 200 мс. Но такие full-duplex-модели в первую очередь оптимизировались под естественность разговора, а не под сложное рассуждение и instruction following. Поэтому они могут хорошо поддерживать беседу, но уступают крупным LLM в содержательных и агентных задачах.

Thinking Machines Lab в своем блогпосте предлагают подход под названием Interaction Models, который должен объединить интерактивность и возможности больших языковых моделей. Interaction Model не ждёт завершения пользовательской реплики, чтобы сгенерировать ответ. Вместо этого входной и выходной потоки делятся на фрагменты длиной около 200 мс:


input₀ → output₀ → input₁ → output₁ → input₂ → output₂ → ...{}


Каждый input содержит очередной фрагмент текста, аудио или видео (или всего вместе), а output — соответствующую часть ответа. Выходом может быть речь, текст или тишина, если модели «нечего сказать». Таким образом, паузы, перебивания и одновременная речь становятся частью моделируемой последовательности, а не отдельными событиями внешнего dialog manager.

Модель объединяет модальности на раннем этапе без тяжёлых специализированных энкодеров. Аудио представляется через dMel-представление, изображения разбиваются на патчи и обрабатываются небольшим hMLP, а за генерацию аудио отвечает Flow-голова. Все компоненты обучаются совместно с самим трансформером с нуля, end-to-end.

Во время инференса такая схема создаёт необычную нагрузку на inference server. Обычные LLM-серверы оптимизированы под крупный prefill и последующий длинный decode. Здесь же каждые 200 мс появляется новый небольшой фрагмент входа, поэтому приходится постоянно чередовать короткие prefill'ы и decode'ы.

Чтобы этого добиться, команда реализовала механизм streaming sessions. Клиент отправляет новые фрагменты отдельными запросами, но сервер сохраняет последовательность в GPU-памяти и продолжает её дописывать. Версию этого механизма авторы добавили и в SGLang. Для собственного же инференс-стека заявляют переход на MoE-ядра со стратегией gather + GEMV вместо grouped GEMM. По словам разработчиков, такой подход лучше подходит для небольших тензоров, возникающих при низколатентном bidirectional serving.

Но одних микротернов недостаточно, чтобы модель одновременно быстро реагировала и была достаточно умной. Поэтому к лёгкой отзывчивой модели добавляют тяжелую интеллектуальную. Получается эдакое разделение ролей. Interaction Model постоянно участвует в разговоре: слушает пользователя, отвечает на простые вопросы и обрабатывает паузы и перебивания. А Background Model асинхронно выполняет более сложные задачи: рассуждает, использует поиск и инструменты, а затем возвращает результаты Interaction Model, которая их озвучивает. По сути, авторы разделяют conversation latency и reasoning latency. При этом быстрая модель не такая уж маленькая. TML-Interaction-Small — это MoE-модель с 276 млрд параметров, из которых для каждого токена активны около 12 млрд.

На FD-bench v1.5, проверяющем перебивания, backchanneling и реакцию на фоновую речь, Thinking Machines сообщает результат 77,8 против примерно 39–54 у сравниваемых систем (Gemini Flash Live, ChatGPT Realtime). Средняя задержка между ходами на FD-bench v1 составила 0,4 секунды. К этим результатам стоит относиться осторожно. Часть тестов разработана или адаптирована самой командой, некоторые оценки проводятся с background agent, а независимого воспроизведения пока нет.

В целом Interaction Models выглядят как промежуточный вариант между классическим голосовым каскадом и полностью монолитной speech-to-speech-моделью. Главная идея здесь не только в микрочанках, но и в разделении двух задач: быстрая модель поддерживает естественный ритм разговора, а фоновая LLM отвечает за сложное рассуждение и работу с инструментами. Пока это только research preview. Насколько подход масштабируется на длинные разговоры, высокую нагрузку и реальные продукты, ещё предстоит проверить.

Иван Матвиенко ❣ Специально для Speech Info
1 477 просмотров · 35 реакций Открыть в Telegram · Открыть пост на сайте
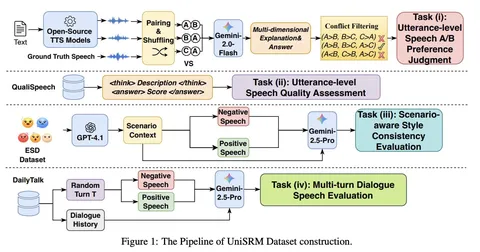
Mega-ASR: Towards In-the-wild^2 Speech Recognition via Scaling Up Real-world Acoustic Simulation

Разбираем статью со скромным названием Mega-ASR. Основной вклад работы — улучшение распознавания сложных аудио. Также авторы собрали и выложили свой датасет — VOICES-IN-THE-WILD-2M.

В реальных условиях, где есть разные шумы, ASR работает хуже. Так происходит, потому что шумов нет в данных. Кто-то пробует добавлять в данные отдельные шумы, но в обычно возникает не одна помеха, а целый комплекс.

Авторы ставят перед собой цель получить SotA-модель на данных с разными типами шумов, и при этом не просесть на чистых данных.

Выложенный датасет большой — на 11 тысяч часов. Состоит из синтетики с добавлением разных типов помех. Всего выделено семь «атомарных акустических эффектов»:

🔴Noise — аддитивный шум;
🔴Far-field — источник звука далеко;
🔴Obstructed — на пути звука есть препятствие;
🔴Echo & reverb — эхо и повторения звука;
🔴Recording Coloration — артефакты при записи или проигрывании;
🔴Electronic distortion — электронные искажения сигнала;
🔴Transmission dropout — пропадания при передаче.

При генерации датасета пытались имитировать реальные ситуации (скажем, эхо в церкви), чего нет в датасетах, на которых учатся SotA ASR. Для каждого эффекта есть гиперпараметры, которые настраивают, чтобы комбинировать шумы. Так пытаются избежать ситуации, когда один эффект гасит другой. Всего есть 54 комбинации шумов.

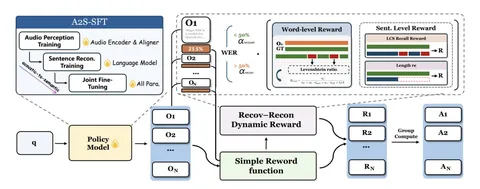
Авторы не делали для Mega-ASR свой претрейн, а использовали Qwen3-ASR c немного изменёнными SFT и RL, и обучали для него LoRA-адаптеры.

SFT интересна тем, что проходила в три этапа:

1) Acoustic warm-up. Учат только акустическую часть — энкодер и алайнер (адаптер, который переводит hidden encoder в hidden LLM). Данные подают не все сразу, а увеличивают их сложность в несколько этапов. Сложность определяют по WER распознавания Qwen. На первом этапе подают записи с WER < 30, далее расширяют до WER < 50 и в конце — WER < 70. Записи с WER > 70 выкидывают с целью сохранить стабильность тренировок.

2) Semantic adaptation. Энкодер и алайнер замораживают, учат только LLM, уже на всех данных.

3) Joint training. Учат всё сразу — и LLM, и энкодер, и адаптер.

RL хорошо работает там, где WER маленький. Тогда ошибки — это в основном word-level confusion, которые можно исправлять. Если WER большой, происходит развал, и обычный objective не помогает. Поэтому делают reward из двух частей:

Статический rule-based reward — по сути MWER со штрафом за повторения.

Динамический reward, состоящий из token-level refinement reward и sentence-level reconstruction reward.

Token-level refinement reward рассчитывается как WER с небольшим изменением: для ошибок substitution добавляется разделение на hard и soft errors — в зависимости от того, насколько сильно предсказанное слово отличается от оригинального. Soft errors в реворде идут с меньшим весом, который регулируется гиперпараметром.

Sentence-level reconstruction reward состоит из двух частей. Первая считается на базе LCS и оценивает, насколько хорошо восстанавливается структура предложения. Вторая часть штрафует за разницу в длине между гипотезой и таргетом.

Веса между пословной и семантической частями реворда зависят от WER. Если он маленький, больше вклад пословной части, если большой — то семантики. Итоговый лосс складывается из базового и динамического с подобранными коэффициентами.

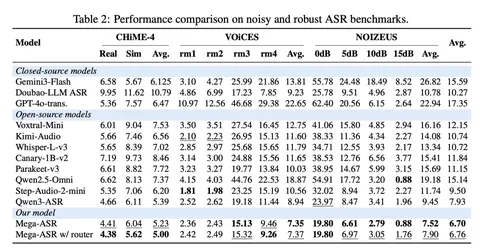
Сравниваются с большим количеством моделей. На более зашумлённых датасетах (CHiME-4, VOiCES, NOIZEUS) модель прилично побеждает. На более чистых (LibriSpeech, Fleurs) — проигрывает, но цифры приемлемые. На собственном бенче также уверенно побеждают.

С адаптивным роутингом, который позволяет использовать базовую тушку на чистых аудио, получили метрики, сравнимые с обычным Qwen, сохранив выигрыш на шумных примерах.

Кроме экспериментов с подбором гиперпараметров, авторы сделали аблейшн для своего динамического реворда и сравнили его с использованием Gemini в качестве LLM-judge на RL-стадии. Получили сравнимое качество, выиграв по скорости обучения в три раза.

Артур Яковлев ❣ Специально для Speech Info
1 662 просмотров · 36 реакций Открыть в Telegram · Открыть пост на сайте
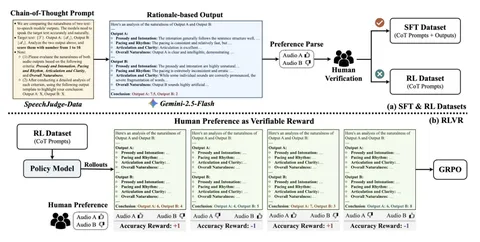
A review on subjective and objective evaluation of synthetic speech

Сегодня разбираем обзор 2024 года, авторы которого попытались охватить 40 с лишним лет эволюции оценки синтеза речи — с 80-х и до наших дней. При этом статья не такая уж большая: 27 страниц, 7 из которых — ссылки на множество упомянутых работ.

Первая часть, пожалуй, самая увлекательная — историческая справка о том, как оценивали синтез речи с самого зарождения. Вторая часть — о предсказателях MOS и моделях, которые это делают. Мы сегодня посмотрим на первую часть.

80-е: разборчивость как главная метрика


В этот период краудсорса ещё нет и всё делается в лабораториях, люди буквально от руки записывают, что услышали. Главная метрика — доля распознанных слов.

Используются тесты MRT (Modified Rhyme Test) и DRT (Diagnostic Rhyme Test), когда услышанное слово выбирают среди рифмованных вариантов. В DRT берутся пары, отличающиеся одним признаком, например «звонкий/глухой».

Также используют SUS (Semantically Unpredictable Sentences) — грамматически верные, но бессмысленные фразы. Тем самым хотят убрать контекст, чтобы мозг не достраивал «замамбленное» слово по смыслу.

Интересно, что датасеты собирали по фонетическим свойствам, таким как назальность, шипение, протяжность, плотность — такое хочется попробовать переиспользовать.

90-е–2000-е: фокус на натуральность

Появились unit-selection и HMM и сделали речь разборчивой. Главный вопрос сместился, и теперь во главе угла естественность (метрика, которая с нами уже 30 лет и никуда не делась).

В этот же период появился MOS (ITU-T P.800), пятибалльная шкала ACR, что становится стандартом индустрии. Следом появляется протокол P.85 — мульти-шкальная оценка, которая включает произношение, listening effort и даже приятность голоса (уже в 1996-м!).

Интересно проследить судьбу слайдерных шкал. В 90-е их захейтили как смещённые и нерепрезентативные, а уже в следующее десятилетие начали использовать очень активно.

Другая веха — Blizzard Challenge, который с 2005 года зафиксировал ещё один индустриальный стандарт, включающий MOS + транскрипцию обычных предложений и SUS + слова из MRT/DRT-категорий.

2010-е и сейчас: MOS упёрся в потолок

Системы стали почти неотличимы от записи, и MOS перестал различать близкие модели. Стали нужны более чувствительные тесты. Возвращается непрерывная шкала — это MUSHRA со скрытым референсом и якорями для нормировки (если в среднем ставишь чуть выше, твои значения нормируются).

Благодаря краудсорсингу (CrowdMOS) оценка, наконец, выбирается за пределы лабораторий. Также появляется DMOS (differential MOS) — оценка пары «референс-тест». Pairwise и side-by-side окончательно приживаются. А в 2007-м в шкалы добавляют человечность: эмоции, манеру, tone of voice.

Несколько идей, которые хочется попробовать

🔴Для надёжных MOS-результатов (Blizzard 2013) требуется от 30 слушателей. Если использовать меньше, оценка может быть слишком субъективной.
🔴Лейблы MOS нелинейные. Расстояния между категориями неравномерны, и вместо равномерных весов в аспектном замере можно взять веса из исследований.
🔴Слушателю полезно давать не голый текст, а контекст и задачу — это заметно меняет оценки.
🔴Неожиданностью стало, что более детальная инструкция не всегда улучшает согласованность, иногда люди следуют своему мнению более согласованно, чем подробным правилам.
🔴Таксономия фонетических ошибок из 80-х (назальность, шипение, протяжность, плотность) может пригодиться, чтобы классифицировать проблемы синтеза, а не описывать их разрозненными «мамблит» и «путает з-с».

Ольга Архипова ❣️ Специально для Speech Info
814 просмотров · 27 реакций Открыть в Telegram · Открыть пост на сайте
Работы о голосовых технологиях на ICML 2026 [2/2]

Продолжаем подборку работ от Максима Борисова. В первой части — общие впечатления о конференции и несколько интересных статей.

CoCoEmo: Composable and Controllable Emotional TTS via Activation Steering

Эмоция в речи часто состоит из нескольких, порой противоречивых оттенков, которые могут не совпадать с текстом, но TTS обычно навязывают одну эмоцию на всё высказывание, теряя эту вариативность. Activation steering выглядит подходящим инструментом для решения проблемы, но неясно, линейно ли вообще управляются эмоции в TTS, куда именно в гибридной архитектуре подавать steering и как это оценивать.

Авторы делают первый систематический анализ activation steering для эмоций в гибридных TTS: количественный фреймворк steering и multi-rater-протоколы для composable mixed-emotion и text-emotion mismatch-синтеза. Главный вывод: эмоциональная просодия и выразительность в основном рождаются в language-модуле TTS, а не во flow-matching-модуле — и именно туда нужно подавать steering.

Evaluating and Rewarding LALMs for Expressive Role-Play TTS via MCLP

LALM научились в интерактивный role-play TTS, но плохо держат стилистическую консистентность с профилем персонажа и сценой в multi-turn-диалогах. Ключевая проблема — нет объективных метрик стиля речи.

Авторы предлагают Mean Continuation Log-Probability (MCLP). Используют in-context learning предобученного LALM и считают правдоподобие ground-truth речевых токенов при условии контекста из транскрипта, сгенерированной речи и повторного транскрипта — это работает как прокси стилистической непрерывности. MCLP хорошо согласуется с человеческими оценками стиля и, что важнее, используется как reward в RL для улучшения RP-TTS. Под задачу собрали большой RP-TTS датасет с богатой разметкой сцен и персонажей; эксперименты дают консистентный прирост и по объективным, и по субъективным метрикам.

Sparse Autoencoders for Interpretable Emotion Control in TTS

Интеграция LLM в TTS улучшила выразительность, но интерпретируемый контроль эмоций всё ещё остается проблемой. Обычно всё сводится к внешнему кондишенингу или глобальному activation steering, из которого непонятно, что происходит внутри. Авторы применяют sparse autoencoders к скрытым состояниям LLM-based TTS и находят разреженные латентные фичи, отвечающие за эмоции.

Оказалось, что эмоциональная вариация размазана по нескольким sparse-фичам, но воздействовать достаточно на маленькое подмножество. На этом строят точечные вмешательства в отдельные фичи, которые позволяют как усиливать, так и подавлять эмоции — без изменения весов модели. Отдельные латентные фичи связаны с конкретными акустическими параметрами (например, pitch) — то есть эмоция это не единый глобальный сдвиг, а координированный вклад нескольких латентов. По качеству steering сравним или превосходит глобальные подходы и TTS-бейзлайны.

AgentSteerTTS: Multi-Agent Closed-Loop Framework для Composite-Instruction TTS

В TTS сложно управлять составными инструкциями из-за структурного разрыва между текстовыми интентами и непрерывной акустикой. Авторы вдохновляются человеческим когнитивным разделением и делают AgentSteerTTS — мульти-агентную систему с обратной связью.

Внутри три компонента: 1) adversarial disentanglement agent разделяет identity- и emotion-prosody-подпространства, чтобы убрать утечку спикера в эмоцию; 2) Dual-Stream Anchoring Controller через Retrieval Agent достаёт экспрессивные якоря из большого набора акустических прототипов, а Synthesis Agent сливает их в непрерывные control-векторы через gated attention; 3) Fast-Slow Feedback Agent через latent gradient correction подкручивает интенсивность и через high-level perceptual critique чинит семантико-акустические рассинхроны. На composite-instruction-бенчмарке и публичных тестах стабильно бьёт бейзлайны.

#YaICML2026

Максим Борисов ❣ Специально для Speech Info
646 просмотров · 27 реакций Открыть в Telegram · Открыть пост на сайте
Работы о голосовых технологиях на ICML 2026 [1/2]

С 6 по 11 июля в Сеуле проходила International Conference on Machine Learning, на которой побывал наш коллега Максим Борисов. Он поделился впечатлениями и подборкой работ на тему Speech.

По спичу представленность была довольно ограниченной — большинство релевантных работ можно было найти на постерах, а не в основных треках и oral-докладах. Зато именно постерные сессии зашли больше всего: можно было час стоять у постера и разбирать детали прямо с авторами — что реально сработало, а что нет, какие были фейлы при воспроизведении, куда двигаться дальше.

Набрал много полезных идей, которые можно применить в нашей TTS-команде — практически по всему пайплайну: новые подходы к аудиокодекам, идеи для TTS-претрейна, нюансы SFT-стадии (особенно по промптингу), и отдельно интересные вещи по RL для TTS.


Two-Dimensional Quantization for Geometry-Aware Audio Coding


В нейронных аудиокодеках квантизацию обычно делают через RVQ, VQ или FSQ. Авторы обращают внимание, что эти схемы жёстко задают геометрию латентного пространства и плохо ловят корреляции между фичами — из-за этого страдает codebook utilization и token rate.

В Q2D2 фичи проецируют парами на структурированные 2D-сетки (гексагональная, ромбическая, прямоугольная) и квантизуют в ближайший узел сетки. Кодбук получается неявный — как произведение уровней сетки, но по размеру сопоставим с обычными подходами. В итоге у авторов низкий token rate, высокая утилизация кодбука и SOTA-качество реконструкции на speech, audio и music одновременно.

Scaling Transformers for End-to-End Discrete Audio Tokenization

Большинство существующих аудиотокенизаторов опираются на предобученные энкодеры, semantic distillation или гетерогенные CNN-архитектуры. Авторы утверждают, что все эти фиксированные inductive biases ограничивают качество реконструкции и мешают нормально масштабироваться.

Их решение — TAC: полностью end-to-end-трансформерный токенизатор из однородных causal-блоков, где энкодер, квантизатор и декодер учатся с нуля совместно. Получают предсказуемое улучшение с масштабом и обгоняют предыдущие кодеки на широком диапазоне битрейтов. На токенах TAC они собрали первый чисто авторегрессионный TTS, который бьёт non-AR и каскадные системы, и получили конкурентный ASR вообще без вспомогательных энкодеров.

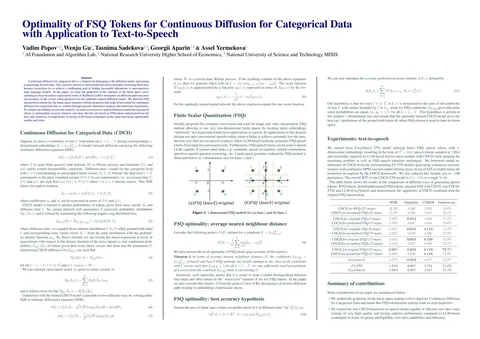
Optimality of FSQ Tokens for Continuous Diffusion for Categorical Data

Continuous diffusion для дискретных данных — альтернатива авторегрессионным LLM. Вопрос в том, какая схема токенизации оптимальна для такой диффузии. Авторы изучают структуру латентного пространства через два свойства: 1) KL-дивергенцию между forward- и reverse-траекториями диффузии, 2) точность предсказания правильного токена оптимально обученной диффузионной моделью.

Теоретически и на численных экспериментах показывают, что именно FSQ-токены лучше всего ложатся на continuous diffusion. Проверили в TTS: обучили несколько диффузионных TTS с речевыми токенами как промежуточные акустические фичи, и FSQ-вариант обошёл сильный LLM-based-бейзлайн, при этом оказавшись заметно меньше и быстрее.

Unlocking Speech–Text Compositional Powers: Instruction-Following Speech Language Models without Instruction Tuning

Instruction tuning для речевых LLM тяжелее, чем для текстовых: новая модальность, специфичные инструкции для речи и намного более длинные последовательности, чем в тексте. Обычно это решают синтезом огромных речевых претрейн+SFT-датасетов, что плохо масштабируется.

Авторы предлагают обойтись без instruction tuning вообще. Берут текстовый LLM- претрейн, делают один раунд continual-претрейна на 30k часах речи, а затем просто прибавляют к весам разницу (instruction-tuned text LLM − base text LLM). Такое сложение весов сохраняет знания и умения текстовой модели и переносит их в речевой домен — фактически, это новая парадигма обучения спичёвых LM без гигантских речевых датасетов инструкций.

Продолжение — во второй части.

#YaICML2026

Максим Борисов ❣ Специально для Speech Info
887 просмотров · 23 реакций Открыть в Telegram · Открыть пост на сайте
Voxtral Realtime

Разбираем статью о модели Voxtral Realtime, в которой предложили ещё один способ, как стримить speech-to-text.

Авторы утверждают, что у них получилось сделать модель, в которой можно контролировать латенси и которая при задержке в полсекунды имеет паритет по качеству с Whisper. Если увеличить задержку до секунды, то модель начинает превосходить Whisper, ещё больше — например, 2,5 секунды, — качество уже сравнивается с офлайновой Voxtral Mini Transcribe V2.

На Open ASR Leaderboard модель занимает место примерно в середине таблицы. Тот же офлайновый Voxtral располагается выше (но он и значительно больше).

Есть несложный способ превратить модель для офлайн-распознавания в стриминговую: делать инференс по чанкам, то есть разбивать приходящий поток аудио на кусочки фиксированной длины и подавать их в модель. У подхода есть недостатки, которые можно обобщить как мисалайнмент между обучением и инференсом. Чтобы этого избежать, имеет смысл закладывать стриминг уже на этапе обучения.

Чтобы сделать нативную стриминговую модель, нужно иметь алайнмент между аудио и текстом, а также архитектуру, которая поддерживает постепенную обработку приходящего аудио. Например, распространенный подход — RNN-T со стриминговым энкодером (такой часто используют в Nvidia). Другой, менее известный подход, — DSM (Delayed Streams Modeling). И Voxtral Realtime — это как раз и есть DSM-ка.

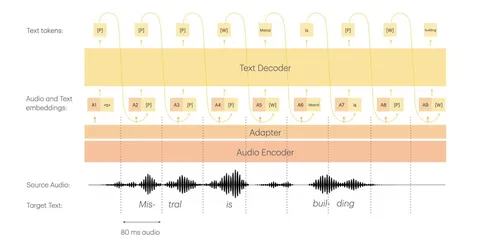
Состоит модель из трёх частей: аудиоэнкодера, адаптера и текстового декодера. Фичи аудио прогоняют через энкодер, потом с помощью адаптера приводят в одно пространство с текстовыми эмбедингами. Они суммируются, подаются на вход в декодер — и предсказывается следующий токен.

Чуть подробнее о каждой части.

Трансформер-энкодер — базовая архитектура с уже привычными RMSNorm, SwiGLU, RoPE и прочим. В качестве аудио фичей, которые подаются на вход, используется log-Mel-спектрограмма. Фичи проходят через две каузальные свертки, что приводит к даунсемплингу в два раза. В итоге энкодер выдаёт фичи каждые 20 миллисекунд. Тут также используется sliding window self-attention с окном в 15 секунд, то есть 750 фреймов.

Адаптер, который представляет из себя простой MLP-слой. С помощью него дополнительно даунсемплим аудио ещё в четыре раза. В итоге фичи идут с шагом 80 миллисекунд.

Трансформер-декодер работает поверх этих фичей и предсказывает следующий токен.

Из интересного — здесь есть не только текстовые токены, но ещё два служебных: padding [P] (аналог blank-токена в RNN-T) и word [W] (означает, что буквально «сейчас начнётся предсказание слова»). В отличии от RNN-T, где мы можем на один эмбеддинг энкодера предсказать несколько текстовых токенов, здесь предсказываем ровно один токен.

Чтобы обучать такую модель, авторы собирают данные в виде набора (аудио, текст, word-level алайнмент). Таргеты для обучения на next-token prediction формируются примерно так:

🔴На тех фреймах, где произносится слово + некоторый дилэй после конца слова, мы должны предсказать токен [P].
🔴После этого идёт токен [W], за которым следуют токены соответствующего слова.
🔴Всё остальное заполняем токеном [P].

Одно из нововведений — использование механизма Ada RMS-Norm в декодере — пожалуй, самое интересное в архитектуре. С ним можно во время обучения использовать разную задержку, чтобы модель могла адаптироваться под разную скорость, а во время инференса буквально за счёт изменения одного параметра контролировать то, с какой задержкой ASR выдаёт текст.

В аблейшенах сравнивают Ada RMS-Norm с другими способами контроля латенси, среди которых он показывает лучший результат. Также оказалось полезно не разделять токеном [W] слова, которые произносятся почти одновременно.

Александр Палаевич ❣ Специально для Speech Info
873 просмотров · 20 реакций Открыть в Telegram · Открыть пост на сайте
UALM: Unified Audio Language Model for Understanding, Generation and Reasoning

В более ранних статьях аудиопонимание и генерация традиционно шли параллельно и не пересекались. Но, если задуматься, человек, решая задачу в области аудио, одновременно мыслит словами и воспринимает звук, постоянно переключая в голове эти модальности — например, так происходит, когда композитор пишет музыку.

Объединить аудиопонимание, генерацию и рассуждения в одной модели — масштабная задача, которую и пытаются решить в статье UALM.

Авторы выделяют две основные проблемы. Первая — аудиопонимание обычно строят на авторегрессионных языковых моделях, а генерацию звука — на диффузионных. Нужно придумать, как объединить эти подходы. Вторая — большинство ризонинг-моделей работают только с текстом, и почти никто не рассматривает аудио как часть процесса рассуждений.

Для решения предлагают генерировать аудио тоже через авторегрессионную модель, используя для этого:

🔴Кратно больше аудиоданных, чтобы модель могла сойтись в то же качество.
🔴Classifier free guidance, который, по заявлениям авторов, сильно улучшает финальное качество генерации.
🔴Более универсальный кодек, который не требует больших вычислений, но умеет сохранять достаточно информации.
🔴Delay pattern — технику, которую используют в ряде последних статей для генерации аудио через токены.
🔴Self-adaptation-стадии через DPO.

С помощью этих составляющих собирают модель UALM-Gen на базе Qwen2.5-1.5B, которая, по словам авторов, достигает качества диффузионных моделей. Правда, за это надо платить большим объёмом данных: около 80 тысяч часов аудио против нескольких тысяч часов у диффузионок.

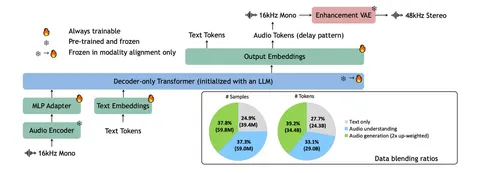
В плане архитектуры верхнеуровнево UALM — это аудиоэнкодер + адаптер + Qwen2.5-7B (для основной модели). Аудио переводится в общее с текстом пространство представлений, после чего единая языковая модель занимается пониманием, ризонингом и генерацией аудио.

UALM-Gen решает только задачу генерации. Следующий шаг — объединить в модели задачи аудиопонимания и генерации. Для этого модифицируют DataMix, увеличивая долю генерационных задач, и вводят стадию Modality Alignment для согласования аудио- и текстовых представлений.

Последняя часть — мультимодальный ризонинг. Здесь используют Rich Captions — подробные текстовые планы будущего аудио, которые служат промежуточным представлением между запросом пользователя и генерацией. Также добавляют «самокритицизм», чтобы модель сама понимала, что можно улучшить, и могла итеративно прийти к лучшему результату.

Чтобы добавить ризонинг, модель обучают трём вещам:

🔴Enrichment — дополнять слишком краткие или расплывчатые запросы пользователя.
🔴Dialogue — задавать уточняющие вопросы перед генерацией.
🔴Self-reflection — анализировать собственный результат, находить расхождения с исходным планом и улучшать следующую версию.

В итоге можно сказать, что UALM — сильная текстовая модель, которая при этом показывает хорошие результаты в аудиопонимании и получает выигрыш от ризонинга при генерации аудио. По словам авторов, модель лучше конкурентов соблюдает пользовательские инструкции и точнее воспроизводит сложные звуковые сцены.

Можно посмотреть код и демо, а вот веса пока не выложены.

Александр Шаршавин ❣ Специально для Speech Info
3 261 просмотров · 22 реакций Открыть в Telegram · Открыть пост на сайте
Ускорили перевод видео в Яндекс Браузере — задистиллировали диффузионный декодер TTS

Сегодня делимся свежей хабростатьёй о том, как ускорили синтез речи при переводе видео в Яндекс Браузере.

С чего стартовали

Внутри TTS — каскад из трёх частей:
🔴языковая модель предсказывает аудиотокены по тексту;
🔴диффузионный декодер восстанавливает мел-спектрограмму из латентов;
🔴вокодер превращает её в звуковую волну.

После того как оптимизировали языковую модель (она долго была самой тяжёлой), узким местом стал декодер латентов: его forward pass запускается на каждом шаге семплинга, а шагов — десятки. Его и взялись ускорять.

Что сделали с аттеншном

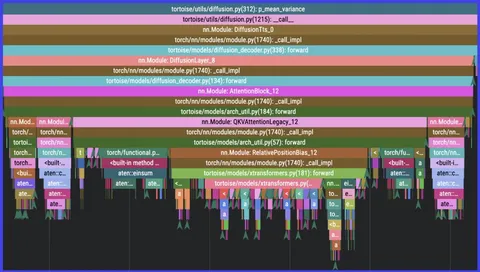
Прогнали инференс через torch.profiler и увидели, что время съедают рукописный QKVAttention и пересчёт RelativePositionBias на каждой итерации. Дальше — по нарастающей:
🔴перевели self-attention на SDPA (memory-efficient) и закешировали bias → 2,5× на уровне QKVAttention и почти вдвое меньше GPU-памяти, всё без переобучения;
🔴проверили гипотезу RoPE + FlashAttention — и честно её похоронили, так как на наших размерах тензоров она не обогнала кешированный бейзлайн. Зато получили полезный отрицательный результат;
🔴как более сильную архитектуру посмотрели DiT (на него уже перешли F5-TTS, CosyVoice3): качество выше, латенси сопоставимое.

Главный буст — дистилляция флоуматчинга

Самое интересное — поверх флоуматчинг-декодера навесили две дистилляции:
🔴CFG-distill: вместо двух forward pass'ов на шаг (conditional + unconditional) student воспроизводит guided-предсказание за один проход;
🔴progressive distillation: student учится за один шаг делать то, что teacher делает за два, и число шагов итеративно уменьшается вдвое.

Вместе это срезало число шагов семплинга с ~20 до 3 при паритете качества по SBS (наивное снижение шагов так не умеет — звук заметно проседает). Бонус progressive distillation — почти не пришлось трогать прод-код инференса, поменяли число шагов в конфиге.

Итог

Эти ускорения вместе дали примерно 1,5× ускорения всего TTS-пайплайна целиком. На практике это позволило на четверть сократить использование GPU в TTS-компоненте.

Цырен-Доржо Цыбиков ❣ Специально для Speech Info
889 просмотров · 37 реакций Открыть в Telegram · Открыть пост на сайте
Chunk-wise Attention Transducers for Fast and Accurate Streaming Speech-to-Text

В NVIDIA есть несколько сотрудников, которые стабильно пишут интересные статьи об ASR в целом и RNN-T в частности. Примеры таких работ — FastConformer, TDT, WIND. Сегодня расскажем о CHAT, суть которого также в улучшении RNN-T. Но сначала вспомним, что это такое.

Recurrent Neural Network Transducer — архитектура для распознавания и перевода речи (а в одной статье внезапно предлагают использовать её и для синтеза), состоящая из энкодера, prediction network и joint network. Работает следующим образом:

1. Энкодер принимает на вход звук, чтобы выдать последовательность эмбеддингов.

2. Prediction Network, используя уже имеющийся контекст транскрипции или перевода, предсказывает эмбеддинг для следующего токена транскрипции или перевода.

3. Joint Network использует эмбеддинг от Prediction Network и один из эмбеддингов от энкодера, чтобы предсказать следующий токен.

4. Полученный токен подаём назад в Prediction Network, чтобы получить новый эмбеддинг. Если же был предсказан специальный токен <BLANK>, то оставляем эмбеддинг от Prediction Network в покое и берём уже следующий по порядку эмбеддинг от энкодера.

5. Повторяем шаги 3 и 4, пока не кончатся эмбеддинги от энкодера или пока Joint Network не предскажет <EOS>.

Сегодняшняя статья строится на двух логичных и справедливых утверждениях:

1. В реальных системах распознавания речи звук поступает чанками, а не отдельными токенами.

2. Для предсказания следующего токена в Joint Network можно и полезно использовать более одного эмбеддинга от энкодера за раз.

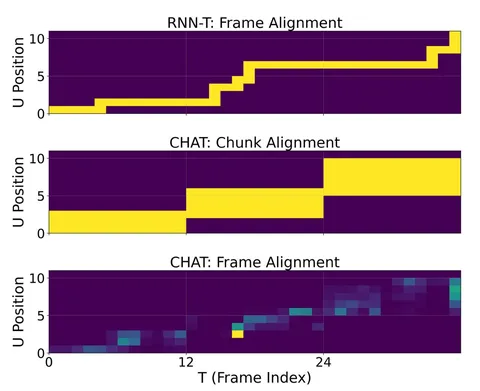
Руководствуясь первым, авторы предлагают использовать не стандартную для LLM треугольную каузальную маску, а блочно-треугольную. С неё, помимо возможности смотреть назад, токены в рамках блока (чанка) могут смотреть друг на друга. Сама идея не тянет на новаторскую, но она ощутимо подкрепляет следующую.

Нововведение статьи основано на втором утверждении. Обычно Joint Network незамысловатый: сумма, конкатенация или линейный слой с нелинейностью для агрегации эмбеддингов и голова для предсказания следующего токена. Авторы для агрегации решили использовать cross-attention, где эмбеддинг от Prediction Network становится Q, а чанк (!) эмбеддингов от энкодера становится K и V (к этому чанку также конкатенируется токен из нулей чтобы модель могла использовать его для генерации токена <BLANK>). Таким образом мы получаем чанк, токены которого смотрели друг на друга на протяжении всего энкодера и который используется в Joint Network целиком.

Это даёт победу сразу по нескольким направлениям:

🔴Обучение RNN-T требует построения решетки из всех пар эмбеддингов от энкодера и от Prediction Network, чтобы считать лосс по всем возможным траекториям. Метод уменьшил «энкодерную» сторону этой решётки в число раз, равное размеру чанка (в статье — 12).

🔴Пиковое использование GPU-памяти уменьшилось почти в два раза и обучение ускорилось на 36%.

🔴Инференс также ускорился на 69%, потому что мы используем чанки целиком и достаточно проставить 1 <BLANK> для всего чанка вместо каждого эмбеддинга от энкодера.

🔴ASR WER уменьшился на 6,3% и AST BLEU вырос на 18% относительно аналогичных классических RNN-T. Авторы объясняют это тем, что возможность использовать более одного эмбеддинга от энкодера за раз даёт необходимый (особенно для перевода) контекст, позволяющий решать задачу более качественно. Я (автор обзора) считаю, что также благодаря использованию чанка целиком, модели не нужно паковать всю полезную контекстную информацию в каждый токен и она может извлечь и упаковать больше информации в чанк.

Бонус: на недавно прошедшей ICASSP нашему человеку повезло столкнуться с авторами этой статьи. На вопросы «Действительно ли необходимо добавлять токен чисто из нулей для предсказания <BLANK>? Как вы это поняли?» один из авторов ответил: «Inspiration, I had a kind of feeling I should add zeros», — и дальше не углублялся.


Николай Коновальчук ❣ Специально для Speech Info
1 058 просмотров · 37 реакций Открыть в Telegram · Открыть пост на сайте
Как устроена голосовая активация в Яндекс Дропс

Недавно Яндекс запустил свои первые ИИ-наушники — Яндекс Дропс. В числе прочего они умеют распознавать обращение «Алиса», а отвечает за эту способность компонент, который мы внутри называем «споттером» (чуть подробнее писали о споттерах тут). И если с голосовой активацией в колонках всё плюс-минус понятно, то перенести её в наушники — это челлендж.

О том, что было сложного в этом процессе и как в итоге выкрутились, рассказал на Хабре Григорий Афанасенко из команды голосовых технологий. А мы пересказываем самое интересное.

Для начала следовало выбрать чип, который позволил бы споттеру работать непрерывно и постоянно искать обращение в окружающем шуме. Большинству CPU такое не под силу — поэтому взяли чип с NPU (Neural Processing Unit). Решение казалось практически беспроигрышным — но ещё подкинуло сложностей в процессе.

Даже с NPU надо было придумать, как оптимизировать потребление энергии. Решили сделать два этапа — и тем самым уменьшили нагрузку в пять раз:

1. Лёгкая модель VAD (Voice Activity Detector) отделяет голос от фонового шума.

2. Когда VAD услышал голос, включается споттер и разбирается, «Алиса» это или нет.

Также была проблема с тем, что модели из умных колонок в наушники никак бы не влезли. Надо было ужать модель под NPU, сохранив качество распознавания. Провели ряд оптимизаций (разбили подсчёт зависимостей на два шага с помощью Depthwise‑separable convolution, добавили дистилляцию знаний и квантование в 8 бит) — и уместили модель в 200 КБ.

А теперь возвращаемся к той самой проблеме в NPU. Выяснилось, что SDK производителя чипа накладывает жёсткие ограничения на архитектуру: размер ядра свёртки — до 15 фреймов для обычных свёрток и до 11 фреймов для depthwise.

Пришлось сделать сеть глубже, чтобы набрать нужный контекст, а вместо Hardswish выбрать ReLU, которая хорошо ведёт себя после квантования. Но тут получили затухание градиента, из-за которого нижние слои почти не обучались. Помог переход на residual‑архитектуру.

А ещё, после долгих экспериментов с SDK, разобрались, как использовать для наших моделей стриминг, — и увеличили модель в два раза.

Качество споттера оценивали по числу ложных срабатываний в час и доле пропущенных верных активаций. Лучший баланс, разумеется, в тихой комнате. На улице качество чуть ухудшается, а в транспорте система почти не срабатывает ложно, но цена за это — высокий уровень пропусков. Ещё один сложный сценарий — разговор на фоне: доля пропусков небольшая, а вот число ложных активаций возрастает ощутимо.

Подробнее о том, как собирали данные для обучения и почему решили отказаться от модели для быстрых команд, рассказали в хабростатье. Там же — о дальнейших планах по развитию технологии.

Григорий Афанасенко ❣ Специально для Speech Info
1 639 просмотров · 39 реакций Открыть в Telegram · Открыть пост на сайте
Reward-Driven Interaction: Enhancing Proactive Dialogue Agents through User Satisfaction Prediction

Разбираем статью об улучшении диалоговых агентов с помощью «проактивности». Речь о способности системы в нужный момент задать уточняющий вопрос, если она понимает, что пользователь, скорее всего, останется недоволен ответом.

Применяют обычный для голосового ассистента каскадный пайплайн: отдельный ASR, переформулировка запроса при необходимости, определение интента (намерения пользователя) и домена, формирование ответа-кандидата, TTS. Поверх этого работает диалог-менеджер, который решает, отдавать ответ сразу или сначала уточнить запрос. Для этого он пытается предсказать, будет ли пользователь недоволен на текущем шаге.

Модель диалог-менеджера состоит из трёх веток, чьи представления конкатенируются и подаются в MLP-голову предсказания недовольства.

Query-side. На вход: ASR-вывод, n-best гипотез и rewritten query. Для n-best гипотез считается attention pooling, чтобы собрать их в одно агрегированное представление. Эта ветка должна уловить расхождения между вариантами одного и того же запроса и тем самым помочь выявить возможные ASR-ошибки.

Response-side. На вход: финальный запрос, ответ-кандидат и связанные с ним признаки. Эта ветка моделирует, насколько согласованы между собой пользовательский запрос и тот результат, который система собирается вернуть.

Session-side. На вход: история взаимодействия и время отклика. Эта ветка извлекает признаки на уровне сессии — то есть паттерны, связанные с пользовательской неудовлетворенностью в ходе диалога.

Проблема в том, что такой диалог-менеджер часто ошибается в обе стороны. Если он не задаёт уточняющий вопрос, где это нужно, пользователь получает плохой ответ. Если задаёт лишний — начинает раздражать. Когда модель выкатили в прод и посмотрели на реальные сессии, оказалось, что она хуже всего работает именно там, где обучающий сигнал слабее всего:

1) На ошибках ASR — распознавание часто даёт странные или редкие формулировки, которых мало в обучении, и диалог-менеджер плохо на них обобщается;

2) Редкие домены — на частых сценариях система работает лучше, а в QA и других long-tail-случаях заметно проседает. Авторы связывают это с тем, что здесь используются слабые метки, извлечённые из последующего поведения пользователя, а редких кейсов мало, чтобы основной сигнал сам научил модель устойчивым представлениям.

Архитектуру авторы не меняют. Вместо этого усиливают обучение с помощью двух дополнительных задач.

Первая — contrastive self-supervised learning. Схема, близка к SimCSE: один и тот же запрос дважды пропускается через энкодер с разным dropout, после чего полученные представления сближаются как positive pair, а остальные примеры в батче используются как negatives. За счёт этого модель становится устойчивее к ASR-шуму, редким вариантам запроса и вообще лучше переносит «кривые» формулировки.

Вторая — классификация домена и интента. Для этого авторы берут сессионное представление, построенное по истории диалога, и учат отдельную голову предсказывать, к какому домену относится текущий запрос и какой у него интент. Эта задача нужна не сама по себе, а как дополнительный обучающий сигнал, заставляя модель лучше структурировать редкие сценарии и тем самым повышая качество в long-tail-доменах.

В итоге всё обучается совместно: основной лосс на предсказание недовольства и два вспомогательных лосса с весами. Отдельный претрейн не требуется.

Основной прирост возникает там, где у базовой модели были проблемы: в редких доменах и шумных запросах. В офлайне это особенно заметно в домене universal QA, где CLA растёт с 0,045 до 0,058. Онлайн-замер это подтверждает: в разборе тысячи сессий новая модель лучше выявляет ошибки ASR (38/119 против 30/119) и NLU (10/61 против 5/61).

По сути, статья показывает практичный ход: если основной обучающий сигнал шумный и плохо покрывает редкие случаи, можно не усложнять архитектуру, а добавить вспомогательные задачи, которые делают представления устойчивее к ASR-ошибкам и полезнее для long-tail-доменов.

Никита Боровко ❣ Специально для Speech Info
3 167 просмотров · 25 реакций Открыть в Telegram · Открыть пост на сайте
Три работы о том, как сделать речь полноценной модальностью для LLM

В сегодняшней подборке — три любопытные идеи: от генерации голосового ответа с ризонингом без лишней задержки до более компактных речевых представлений и подготовки аудиоданных для мультимодального претрейна.

STITCH: Simultaneous Thinking and Talking with Chunked Reasoning for Spoken Language Models

Статья Microsoft о том, как добавить ризонинг в speech или audio LLM, не увеличивая задержку ответа. Предлагают генерировать ризонинг-токены параллельно с аудиоответом. Модель чередует генерацию аудиотокенов и текстовых thinking-токенов: сначала выдаёт звуковой фрагмент, потом — кусок ризонинга, снова продолжает аудиоответ и так далее. В результате ризонинг интерливится с генерацией речи.

Идея строится на том, что модель генерирует аудиотокены быстрее, чем пользователь успевает их прослушать. Например, за 0,5 секунды она может нагенерить аудио, которое будет звучать примерно 2 секунды. Остаётся свободное время, в которое модель может генерировать ризонинг-токены, почти не увеличивая задержку ответа.

Авторы сравнивают несколько режимов: бейзлайн без ризонинга, который даёт минимальную задержку; режим с ризонингом перед аудиоответом, где качество выше, но latency сильно растет; и STITCH — предложенный подход, в котором ризонинг встраивается прямо в генерацию речи. STITCH сохраняет задержку почти на уровне бейзлайна, при этом даёт качество, близкое к режиму с предварительным ризонингом.

Latent Speech-Text Transformer

Аудио обычно менее компактно, чем текст. Условно, модель видит три текстовых токена в секунду, но при этом — десятки аудиотокенов. Из-за этого сложно нормально связать их семантические составляющие.

Авторы пытаются сделать аудио компактнее и понятнее для LLM. Для этого используют идею патчинга из CV: несколько аудиотокенов объединяют в один latent patch. Но делают это не фиксированным сжатием по типу «каждые четыре токена в один», а так, чтобы патч покрывал осмысленный фрагмент речи — например, слово целиком, — чтобы внутри сохранялась цельная семантика.

Для этого обучают отдельный patch encoder в несколько этапов — авторы называют это curriculum patching. Сначала границы патчей задаются довольно жёстко через force alignment: модель получает подсказку, какие аудиотокены соответствуют словам. Затем эти границы постепенно делают менее строгими, чтобы encoder учился не просто повторять разметку, а находить более гибкие группировки. На финальной стадии модель уже самостоятельно решает, как объединять аудиотокены в латентные патчи.

Data-Centric Lessons To Improve Speech-Language Pretraining

Работа от Apple о том, как добавлять аудиоданные в текстовые LLM. Предлагают interleaved-обучать модель на цепочках, где последовательности текста и аудио чередуются.

Данные чистят, делают диаризацию, режут длинные записи на небольшие чанки и стараются оставлять фрагменты с одним спикером. Экспериментируют с размером чанков и делают вывод, что маленькие работают лучше. Скорее всего, когда текст и аудио тесно переплетены, модель лучше связывает модальности между собой.

Также данные пытаются балансировать по доменам: используют отдельную модель, которая классифицирует тематики и подмешивают аудиоданные так, чтобы распределение было похоже на текстовый претрейн.

Авторы показывают улучшения даже на текстовых метриках после аудиопретрейна. Правда, модель довольно маленькая (3.8B), внутренняя и, возможно, просто недоучена.

Ярослав Ведерников ❣ Специально для Speech Info
779 просмотров · 31 реакций Открыть в Telegram · Открыть пост на сайте
Qwen3-TTS Technical Report [2/2]

Продолжаем обсуждать новинку от команды Alibaba. В предыдущем посте разобрали архитектуру Qwen3-TTS, в этом рассмотрим, как и на чём его обучали.

Для обучения используют сначала 5M+ часов многоязычной речи, затем continual pretraining на более качественных данных, чтобы снизить галлюцинации и улучшить качество, затем long-context stage, где увеличивают контекст с 8K до 32K токенов и апсэмплят длинные аудио.

Post-training состоит из трёх этапов: DPO на human preference pairs, затем GSPO с rule-based rewards для стабильности, затем lightweight speaker fine-tuning под конкретные голоса. Для voice design авторы добавляют probabilistically activated thinking pattern – модель иногда учится «думать» над сложным описанием голоса, чтобы лучше следовать инструкциям.

На zero-shot voice cloning Qwen3-TTS-12Hz-1.7B показывает WER = 0,77 на китайском и 1,24 на английском Seed-TTS test set. Это сильнее большинства бейзлайнов, включая F5-TTS, FireRedTTS 2, MiniMax-Speech и CosyVoice 3 на английском. Интересно, что 12Hz здесь стабильно лучше 25Hz по WER, судя по всему, более грубое временное разрешение упрощает авторегрессионную генерацию.

В multilingual speech generation модель поддерживает 10 языков. По WER она выигрывает у MiniMax и ElevenLabs в 6 из 10 языков, включая русский. По speaker similarity Qwen3-TTS побеждает во всех 10 языках.

В cross-lingual voice cloning тоже достойные результаты. Например, в zh-to-ko 12Hz-1.7B получает error rate = 4,82 против 14,4 у CosyVoice3.

На InstructTTSEval модель в режиме voice design становится лучшей среди опенсорс-решений и обходит Hume, VoiceSculptor, Parler-TTS и PromptTTS по метрикам соответствия описанию. В target speaker editing Qwen3-TTS сильно обгоняет GPT-4o-mini-tts, хотя Gemini всё ещё остаётся чемпионом.

Самый интересный результат — long speech generation. На текстах до 2000 слов и аудио больше 10 минут выигрывает уже версия 25 Гц: Qwen3-TTS-25Hz-1.7B-CustomVoice получает WER = 1,517 на китайском и 1,225 на английском, лучше Higgs-Audio-v2, VibeVoice и VoxCPM. Получается, семантические токены лучше держат контент на длинных последовательностях.

В итоге Qwen3-TTS — сильный опенсорс-бейзлайн для авторегрессионных LLM-TTS. Авторам удалось оценить доминирующие подходы к токенизации аудио и выяснить, что акустический вариант с 12 Гц лучше подходит для streaming и низкой задержки, а версия кодека с 25 Гц — для семантики и стабильности длинной генерации. Познакомиться с моделями по лицензии Apache 2.0 можно на GitHub авторов.

Владимир Гогорян ❣ Специально для Speech Info
865 просмотров · 21 реакций Открыть в Telegram · Открыть пост на сайте
Qwen3-TTS Technical Report [1/2]

Команда Alibaba представила Qwen3-TTS — семейство моделей для синтеза речи, которым под силу voice cloning и voice design по текстовому описанию, а также fine-grained control голоса. Сегодня разберём, как они устроены с точки зрения архитектуры, а в следующем посте подробнее остановимся на их обучении.

Все модели работают на дискретных токенах с авторегрессионной LLM. Но в Qwen3-TTS авторы делают не один токенайзер, а сразу два.

На схеме слева — Qwen-TTS-Tokenizer-25Hz. Подход похож на CosyVoice: это 25 Гц single-codebook-токенайзер, построенный поверх Qwen-2-Audio. Его обучают в два этапа. Сначала продолжают претрейн Qwen2-Audio на ASR-задаче и вставляют VQ-слой, чтобы получить семантические токены. Затем добавляют свёрточный декодер и дообучают модель на восстановление мел-спектрограмм, чтобы подмешать акустическую информацию. Видимо, чисто семантических токенов не всегда хватает для выразительного TTS. На полученных токенах обучают стриминговый блочный DiT с flow-matching, чтобы предсказывать мел-спектрограмму. Для восстановления аудио используют модифицированный BigVGAN.

На схеме справа — Qwen-TTS-Tokenizer-12Hz. Это уже 12,5 Гц токенайзер со Split-VQ и суммарно 16 уровнями квантизации. Первый его кодбук отвечает за семантику, остальные 15 — добавляют акустические детали через RVQ. Есть дистилляция в семантический кодбук эмбеддингов WavLM. Подход сильно вдохновлён Mimi, но Qwen переделали декодер, где использовали ConvNeXt-блоки и Snake-активации.

Архитектурно Qwen3-TTS базируется на семействе Qwen3 LM. Входная последовательность конкатенирует текстовые и речевые токены по channel axis. Для контроля спикера используется обучаемый speaker-encoder.

Для кодека с 12 Гц основной backbone transformer предсказывает нулевой семантический codebook, а затем MTP-модуль достраивает оставшиеся уровни с акустическими деталями. Для 25 Гц версии используется стандартный AR-трансформер, предсказанные токены которого декодирует DiT.

Владимир Гогорян ❣ Специально для Speech Info
977 просмотров · 22 реакций Открыть в Telegram · Открыть пост на сайте
AudioSAE: Towards Understanding of Audio-Processing Models with Sparse AutoEncoders

Сегодня разбираем статью — в которой концепт интерпретируемости из NLP попытались связать с аудиомоделями.

Мотивация

Трансформеры полисемантичны: нейроны активируются на множество несвязанных концептов, что делает модель неинтерпретируемой. Гипотеза суперпозиции объясняет это тем, что модели кодируют больше признаков, чем размерность пространства, представляя их как линейные комбинации направлений в активациях. Sparse-автоэнкодеры (SAE) — это автоэнкодеры с разреженной активацией во внутреннем слое. В AudioSAE их применяют к аудиомоделям, чтобы выучить моносемантические направления в активациях и представить признаки модели как комбинации небольшого числа интерпретируемых компонент.

Архитектура и экспериментальный сетап

Линейный слой увеличивает размерность входа, затем применяется функция активации (Jump-ReLU, Top-k или Batch-Top-k), в итоге выбирают Batch-Top-k. Обучение происходит через реконструкцию активаций. Размерность увеличивают примерно в восемь раз, число ненулевых компонент — около 50.

Эксперименты проводят на Whisper-small и HuBERT-base. Активации каждого слоя нормализуются и подаются в автоэнкодер. Используются речь, музыка и звуки в пропорции 40/45/15 с аугментациями, всего около 2800 часов данных.

Оценка и результаты

Оценка SAE включает reconstruction quality, robustness, interpretability и disentanglement. Робастность измеряют через intersection over union и coverage — долю совпадающих фичей при разных инициализациях, слоях и моделях.

Внутри одной архитектуры фичи достаточно робастны (coverage > 50%). Между Whisper и HuBERT соответствия почти нет. Кроме того, в аудиомоделях меньше redundant (избыточных) признаков, чем в текстовых моделях.

Что именно кодируют фичи

Верхнеуровневое устройство признаков анализируется путём классификации фичей на три домена: речь, музыка и environmental-звуки (смех, шёпот, чириканье птиц, начало и конец речи). Фича считается специфичной для домена, если частота её активации значительно выше внутри домена, чем вне его. Частота активации оценивается на двух уровнях для каждого домена: на frame-уровне как пропорция фреймов с ненулевой активацией фичи, и на аудиоуровне как пропорция аудио, где фича активируется хотя бы раз.

Особенно сильно аудиоуровневые доменные признаки у Whisper проявляются на средних слоях: music-фичи достигают доли в 20–28%, тогда как speech-фичи составляют ~13%. На frame-уровне специализация для речи достигает максимума позже: пропорция speech-фичей продолжает расти, это предполагает, что некоторые слои кодируют речевую информацию более локально (frame-level), даже когда глобальные (audio-level) фичи активируются реже.

Интерпретируемость проверяют через логистическую регрессию на SAE-фичах. Небольшого числа признаков (10–150 из 6000) хватает для бинарных задач (чистая/шумная речь), а для мультиклассовых (классификация акцентов) нужно 500–3000. При этом выбор top-k (по коэффициентам регрессии) фичей даёт лучшее обучение и забывание, чем случайный выбор.

Удалять информацию из модели сложнее — так, чтобы «забыть» концепт, нужно убрать сотни или тысячи фичей, ведь акустические признаки распределены и зависят от фонем, интонации и пауз.

Практическое применение

Авторы пишут о применении AudioSAE для борьбы с галлюцинациями Whisper. На SAE-активациях обучают логистическую регрессию, по её коэффициентам выделяют связанные с галлюцинациями фичи. На их основе строится вектор, который добавляется к активациям через steering, при этом получается снизить false positive rate без сильной просадки качества.

Однако при слишком сильном steering модель начинает терять качество и может перестать что-либо предсказывать.

В работе показано успешное применение SAE для аудиодомена, но масштабируемость подхода на большие модели требует проверки. Кроме того, аудиопризнаки всё ещё сильно перемешаны и управлять ими точечно сложно.

Екатерина Козлова ❣ Специально для Speech Info
978 просмотров · 42 реакций Открыть в Telegram · Открыть пост на сайте
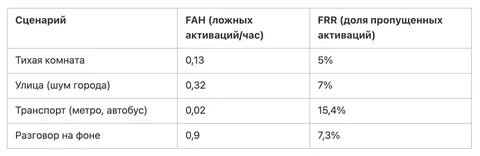
SpeechJudge: Towards Human-Level Judgment for Speech Naturalness

TTS-модели становятся всё лучше, но как это измерить? Стандарт в речевой индустрии — субъективная оценка MOS. Автоматические метрики удобны, но плохо коррелируют с тем, что реально слышит человек. Сегодня разберём работу, которая стала первой серьёзной попыткой закрыть пробел в оценке естественности речи с помощью LLM-as-a-judge.

Авторы представляют три сущности:

- SpeechJudge-Data. Большой аннотированный датасет для обучения — 99K сэмплов.
- SpeechJudge-Eval. Бенчмарк для оценки естественности речи, в который вошли сэмплы из SpeechJudge-Data.
- SpeechJudge-GRM. Генеративная reward-модель: получает на вход пару аудио, выбирает более естественное и объясняет свой вердикт.

Начнём с того, как собирали SpeechJudge-Data. Датасет состоит из триплетов (текст + аудио-1 + аудио-2). Для генерации аудио авторы взяли SoTA-модели трёх разных парадигм: авторегрессию (CosyVoice2), flow-matching (F5-TTS) и маскированную генерацию (MaskGCT). TTS-модель генерировала аудио-1 и аудио-2 на основе текста и аудиореференса.

Сами аудиореференсы собирали двух типов: простые regular из датасета Emilia-Large и expressive с проявлением эмоций из Paraspeech, L2-Arctic, KeSpeech и даже Genshin Impact. Языки тоже варьировали: китайский, английский и code-switching.

Полученный датасет аннотировали вручную: оценивали разборчивость речи и её естественность.

Из собранного корпуса авторы выделили SpeechJudge-Eval — 1000 сэмплов, где разметчики пришли к полному согласию с однозначным предпочтением одного из аудио. Затем на новом датасете проверили целый зоопарк моделей: WER, FAD, MOS-предикторы, deepfake-детекторы и AudioLLM. Результаты оказались удручающими — лучшая модель из коробки, Gemini-2.5-Flash, набрала лишь 69,1% совпадения с человеческими оценками. Большинство метрик и вовсе работают на уровне случайного угадывания.

Для решения этой проблемы авторы обучили свою модель SpeechJudge-GRM. В качестве основы взяли Qwen2.5-Omni-7B. Модель тренировали в два этапа:

1) SFT — дистилляция CoT-рассуждений от Gemini-2.5-Flash на тех сэмплах, где Gemini угадывала правильно.
2) RL (GRPO) — дообучение на сложных сэмплах, где Gemini ошибалась; человеческая аннотация служит верифицируемой наградой.

Получилось 77,2% точности против 72,7% у классической модели Брэдли–Терри. При majority voting из 10 результатов точность вырастает до 79,4%. Авторы также использовали GRM как reward-функцию для post-training TTS-моделей, что улучшило метрики разборчивости и естественности. Кажется, мы на шаг ближе к тому, чтобы обходиться без субъективной разметки, когда нужно сравнивать модели синтеза речи.

Владимир Гогорян ❣ Специально для Speech Info
1 180 просмотров · 23 реакций Открыть в Telegram · Открыть пост на сайте
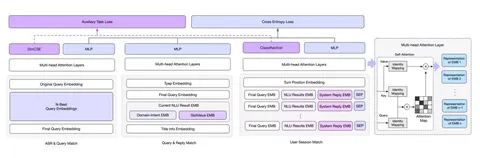
ACE-Step: A Step Towards Music Generation Foundation Model

У популярных методов генерации музыки две основных проблемы:

- Модели на основе LLM (например, Yue и SongGen) отлично справляются с согласованием текста песни, но медленно работают и часто выдают артефакты.

- Диффузионные модели (такие как DiffRhythm) генерируют гораздо быстрее, но уступают в качестве структурной согласованности треков.

Сегодня разберём статью о фундаментальной опенсорс-модели ACE-Step. Её авторы утверждают, что смогли преодолеть все эти проблемы, объединив лучшее из LLM и диффузионных моделей.

Архитектура не нова. Внутри ACE-Step — две модели:

- Энкодер-декодер. Преобразует спектрограмму в латентное представление и обратно, сжимая её при этом в 64 раза.

- Flow-matching. Генерирует аудиозапись в латентном пространстве. Бэкбон этой модели состоит из 24 diffusion-transforme-блоков.

Главный импакт этой статьи — обуславливание моделей на множество разных кондишнингов. Секрет в кросс-аттеншне, который добавили в середину каждого diffusion-transformer-блока.

Чтобы генерировать аудио с нужным контентом, модели нужны три вещи:

1) Тэги, описывающие аудио на натуральном языке. Например, «an energetic pop-rock anthem with distortion guitar».
2) Текст песни, закодированный BPE-токенами.
3) Эмбеддинг спикера, полученный из предобученной биометрической модели.

Для того чтобы хорошо и разнообразно генерировать текст, аккорды, ритм и прочие музыкальные фичи, авторы добавили Semantic Alignment Loss. Аудио пропускали через две SSL-модели:

- МЕRT. По сути BERT, для музыки, который хорошо энкодит гармонию, аккорды и ритм,
- mHuBERT. Тоже специализированный BERT для музыки, но с фокусом на текст.

Потом на эмбеддинги в середине диффузионного трансформера (авторы выбрали восьмой из 24 слоёв) повесили cosine similarity c эмбеддингами SSL-моделей. Это позволяет модели лучше кодировать внутри себя информацию, связанную с гармонией, ритмом и текстом — а значит, лучше генерировать её.

ACE-Step обучали на 100 тысячах часах аудио на 19 разных языках — около 1,8 миллионов музыкальных треков. Для того чтобы разметить этот датасет тегами, использовали Qwen-Omni, Whisper в ASR, детектор BPM и универсальный классификатор для сегментации.

В результате ACE-Step синтезирует до 4 минут музыки всего за 20 секунд на GPU A100 — в 15 раз быстрее, чем базовые LLM-модели. А оценить результаты её работы и изучить код можно на сайте авторов — такое не стыдно добавить в свой плейлист.

Роман Кайль ❣ Специально для Speech Info
1 079 просмотров · 20 реакций Открыть в Telegram · Открыть пост на сайте
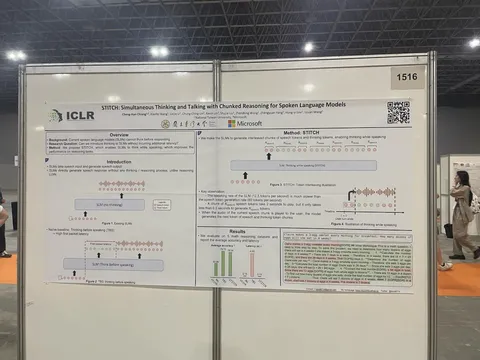
Новая порция постеров с ICLR 2026

Продолжаем делиться интересными работами на тему голосовых технологий. На этот раз в подборке: новые подходы к TTS, масштабирование аудиокодеков и устойчивые к шуму токенизаторы.

Continuous Audio Language Models

Раньше мы предсказывали мел-спектрограммы с помощью Tacotron 2, сейчас генерируем токены аудиокодеков через LLM — и снова возвращаемся к истокам. Авторы из kyutai предлагают для задачи TTS предсказывать continuous-признаки выученного VAE через каузальный трансформер. Добавляют диффузионные головы с consistency models, чтобы семплировать за меньшее количество шагов. Чтобы это работало для музыки, добавляют небольшой контекст из предыдущих фреймов. В конце дистиллируют модель с 313M до версии на 100M параметров, которая умеет в синтез и клонинг и при этом быстро работает на CPU.

Scaling Speech Tokenizers with Diffusion Autoencoders

Авторы из Meta* вдохновились статьёй StableCodec (лид у работ один и тот же) и сделали диффузионный кодек на 1.6B параметров с частотой 12.5 Hz и одним уровнем VQ. Работает он на мел-спектрограммах, где соседние фреймы стакаются и усредняются для уменьшения frame rate. Чтобы адекватно проучилась семантика, добавляют CTC decoder из латентных векторов после квантизации и считают по ним CTC loss. Также есть диффузионный лосс, без MSE/L1 на пикселях — говорят, так лучше учится и выше метрики на downstream-задачах.

Данных было 2 миллиона часов. Чтобы семплировать диффузионным декодером за меньшее количество шагов, используют Shortcut Finetuning. В статье много подробных аблейшнов, но удивительно, что работа получила accept без субъективных замеров на TTS с предложенным токенизатором.

StableToken: A Noise-Robust Semantic Speech Tokenizer for Resilient SpeechLLMs

У семантических аудиокодеков есть неприятная проблема: небольшой шум может сильно менять последовательность токенов, хотя смысл сказанного остаётся прежним. В итоге аудио-LLM обучаются поверх представлений, которые скачут от несущественных изменений во входе.

StableToken чинит это через более устойчивую квантизацию. Делают несколько LFQ-веток квантизации и собирают итоговый token id с помощью majority vote по битам. Плюс обучают это через Noise-Aware Consensus Training: часть веток видит чистую запись, часть — зашумлённую, а consensus loss заставляет их сходиться к похожим pre-quantization представлениям. В итоге токены становятся заметно стабильнее к шуму, при этом качество реконструкции и downstream SpeechLLM performance не проседают, а наоборот улучшаются.

#YaICLR26

Владимир Гогорян ❣ Специально для Speech Info

__
Компания Meta признана экстремистской; её деятельность в России запрещена.
682 просмотров · 36 реакций Открыть в Telegram · Открыть пост на сайте
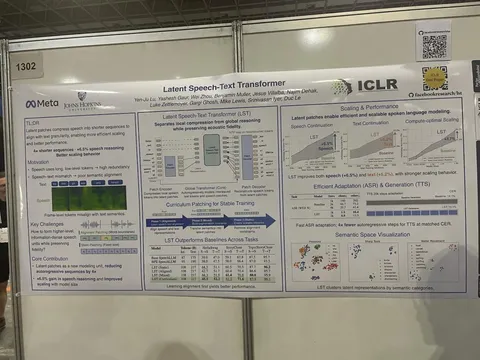
VibeVoice: Expressive Podcast Generation with Next-Token Diffusion

TTS хорошо работает на коротких фразах, но плохо масштабируется до длинной генерации вроде подкастов, где нужны стабильные голоса, паузы, turn-taking. VibeVoice предлагает решение этой проблемы.

Работа наконец превратилась из краткого техрепорта в полноценную статью. Главная идея — уйти от дискретных аудиотокенов к сжатому continuous-представлению. Учат hybrid tokenizer на 7,5 Hz, отдельно acoustic σ-VAE для тембра и качества, отдельно — semantic tokenizer через ASR для семантики.

Поверх этого обучают LLM, где генерируют латенты VAE через маленькую diffusion head. Получается next-token diffusion: трансформер выдаёт conditioning на токен, diffusion head итеративно генерирует acoustic latent, acoustic decoder превращает его в аудио.

Берут именно σ-VAE, потому что у стандартного VAE variance может схлопнуться почти в ноль, и latent space становится хрупким: авторегрессия промахивается на каждом шаге, ошибки накапливаются, генерация разваливается. В σ-VAE variance фиксируют через prior, создавая вокруг latent’ов tolerance zone. Diffusion head может не идеально попасть в latent, а decoder всё ещё восстанавливает стабильную речь.

Два токенизатора выбраны не просто так. Если оставить только acoustic, голос сохраняется, но семантика начинает плыть, особенно при нескольких спикерах. Hybrid tokenizer снижает WER при приемлемом SIM-O. То есть для подкастов сложно хранить «что сказано» и «как сказано» в одном латенте — модель начинает путаться.

Заявляют zero-shot-генерацию до 90 минут и до четырёх спикеров. По замерам VibeVoice-7B обходит Gemini 2.5 Pro TTS и ElevenLabs v3 alpha, а на long-form держит низкий WER и высокую speaker similarity, в то время как некоторые модели и вовсе разваливаются.

#YaICLR26

Владимир Гогорян ❣ Специально для Speech Info
808 просмотров · 26 реакций Открыть в Telegram · Открыть пост на сайте
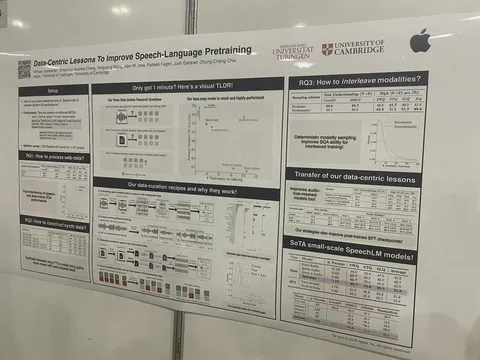
Продолжаем делиться статьями с ICLR 2026

Сегодня у нас на очереди две работы: о новом методе выравнивании речи и текста и общем эмбеддинг-пространстве для мультимодальных LLM. В одном разборе даже удалось получить комментарий от автора.

Closing the Gap Between Text and Speech Understanding in LLMs

Одна из самых интересных работ по аудио, да ещё и с приятным автором. Важная проблема ALM (Audio Language Model) — разрыв между модальностями. Если задать один и тот же вопрос голосом и текстом, зачастую можно получить разные ответы.

Авторы анализируют причины этого разрыва (в виде различий в распределениях текстовых и аудоданных) и предлагают SALAD — метод, который выравнивает речевую модель с текстовой LLM через кросс-модальную дистилляцию и умный отбор синтетических речевых данных.

Главное преимущество подхода — он требует значительно меньше речевых данных, но заметно сокращает разрыв между текстовым и речевым пониманием.

WAVE: Learning Unified & Versatile Audio-Visual Embeddings with Multimodal LLM

В работе предлагают использовать мультимодальную LLM как основу для единого эмбеддинг-пространства, где можно сопоставлять текстовые, аудио-, видео- и аудиовизуальные данные. Модель обучается так, чтобы представление зависело не только от входной модальности, но и от текстовой инструкции к задаче.

Авторы извлекают репрезентации из нескольких верхних слоёв модели, потому что разные уровни могут кодировать разную информацию. Затем эти представления объединяются через небольшой fusion-модуль, который формирует итоговый эмбеддинг для retrieval/QA-задач.

Такие унифицированные представления полезны, например, когда важно одновременно учитывать, что происходит в кадре и что слышно в аудио. Показывают хорошие результаты на retrieval и multimodal QA.

Спросил у автора, может ли такой эмбеддер стать унифицированным энкодером для больших мультимодальных LLM. По его интуиции, подход особенно хорош именно для задач, где действительно нужна joint representation. Но для больших мультимодальных моделей в целом независимые энкодеры под конкретные цели всё ещё могут быть более практичным и чистым решением.


#YaICLR26

Ярослав Ведерников ❣ Специально для Speech Info
700 просмотров · 31 реакций Открыть в Telegram · Открыть пост на сайте
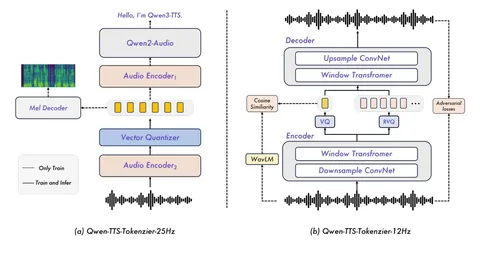
В Рио — жара! Освежаемся статьями с ICLR

Как и полагается на старте, в первый день конференции не все постеры оказались на законных местах и не все спикеры — у своих стендов. Но кое-что интересное нам удалось раздобыть.

TASTE: Text-Aligned Speech Tokenization and Embedding for Spoken Language Modeling

Речевые токенизаторы обычно работают в дискретизации намного выше текстовой — это 12.5Hz и выше против ~3Hz у текста. При попытке делать текстово-речевые модели (Spoken Language Models) приходится придумывать способы выравнивания последовательностей, как в Moshi, например.

Авторы предлагают выучить токенизатор, который выдаёт по одному речевому токену на каждый текстовый, чтобы синхронизировать эти последовательности. Делают это через фичи Whisper Encoder, которые используют как key и value для кросс-аттеншна, а query — оригинальный текст входного аудио. Это позволяет сократить frame-rate аудиотокенов до ~3Hz, прямо как у текста. На таком токенизаторе авторам удаётся обучать text-speech SLM с более высоким качеством по сравнению с другими подходами.

Can Speech LLMs Think while Listening?

Работа о добавлении Chain-of-Thought в Speech LLM и снижении latency, которую CoT обычно добавляет в голосовых агентах. В режиме “thinking while listening” модель начинает текстовое CoT-рассуждение ещё до того, как пользователь закончил говорить. Для этого с каждым новым словом оценивается, насколько текущий префикс вопроса уже достаточен, чтобы получить те же размышления и ответ, что и по полному вопросу. Когда вопрос становится достаточно «полным», модель может начать ризонинг раньше.

Сначала модель дообучают на таких early-CoT-примерах, а затем применяют DPO — генерируют несколько вариантов рассуждения с ранним стартом и выбирают более правильные и/или короткие цепочки рассуждений.

Echo: Towards Advanced Audio Comprehension via Audio-Interleaved Reasoning

И ещё о ризонинге. Обычные аудиоязыковые модели (ALM) кодируют звук один раз вначале — и дальнейший процесс рассуждения происходит только текстом. Echo предлагает использовать аудио прямо внутри рассуждений и дать модели возможность вставлять его определённый отрезок внутрь текстового ризонинга. Это позволяет модели лучше обуславливаться на аудио, особенно в длинных генерациях, а также хорошо растит результаты на бенчмарках.

На последнем фото — мудрость от организаторов: статьи на тему голосовых технологий лучше не читать, а слушать.

Интересным поделились ❣ Владимир Гогорян, Варвара Фурик и Ярослав Ведерников

#YaICLR26

Speech Info
688 просмотров · 42 реакций Открыть в Telegram · Открыть пост на сайте
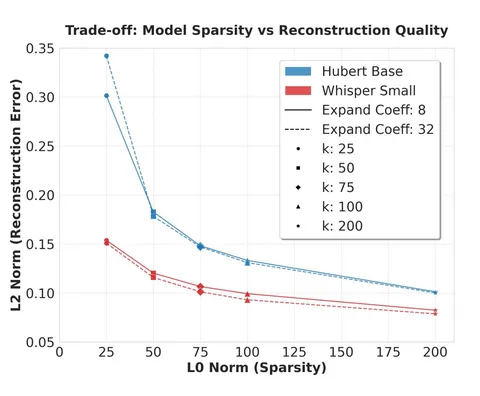
CORD: Bridging the Audio–Text Reasoning Gap via Weighted On-policy Cross-modal Distillation

Сегодня разбираем работу о важной проблеме в Audio Language Models. Если дать модели один и тот же запрос в текстовом и аудиоформате, качество ответа на аудио обычно заметно хуже. Это видно на бенчмарках: аудиодомен почти всегда проседает относительно текстового.

Большие аудиоязыковые модели обычно строятся поверх текстовых LLM: к ним добавляют аудиоэнкодер и модуль выравнивания между модальностями. Предполагается, что этого достаточно, чтобы аудио и текст оказались в одном семантическом пространстве. Но на практике это работает неидеально: при одинаковом смысле входа модель рассуждает по аудио хуже, чем по тексту.

В этой работе авторы хотят передать в аудиомодальность текстовые reasoning-способности и сделать так, чтобы при аудиовходе модель рассуждала как можно ближе к тому, как она рассуждает при текстовом.
Для этого берут один и тот же вопрос, получают его текстовую и аудиоверсию, прогоняют через модель и сравнивают распределения. Это нужно, чтобы генерация при аудиовходе была максимально похожа на генерацию при текстовом.

Важно, что всё происходит on-policy. Для аудиовхода модель сначала сэмплирует ответ, а дальше сравнение идёт именно по этой траектории. Эти же префиксы подаются в модель с текстовым входом, чтобы посмотреть, как она продолжила бы ту же последовательность.

То есть здесь не идут по «правильной» текстовой траектории учителя, а обучают модель на тех состояниях, в которые она реально попадает при генерации по аудио. За счёт этого можно исправлять ошибки, которые возникают именно в аудиорежиме.
Для сравнения распределений используют reverse KL, а именно KL(p_audio || p_text).

Такой лосс особенно наказывает случаи, когда аудиоветвь даёт высокую вероятность токенам, которые текстовая ветвь считает маловероятными. Модель в первую очередь отучают генерировать продолжения, которые сильно расходятся с текстовым поведением.

Авторы также показывают, что расхождения между модальностями возникают неравномерно. Основные ошибки появляются в начале генерации, а затем тянутся по всей последовательности. Кроме того, сильный вклад дают не все токены, а лишь небольшое число наиболее важных шагов.

Из этого рождается основной трюк работы — взвешивание token-level loss. Во-первых, усиливают вклад токенов с наибольшим расхождением между аудио- и текстовым распределениями: берут top-K токенов, в работе K = 20. Во-вторых, больший вес дают ранним токенам, потому что ошибка в начале рассуждения чаще всего ломает всю дальнейшую траекторию. В итоге reverse KL взвешивается и по важности токена, и по его позиции.

Но этого авторам кажется недостаточно, потому что токенного уровня может не хватить, так как модель всё равно способна прийти к неправильному ответу в целом. Поэтому добавляется sequence-level.
Здесь генерируются ответы для аудио, и judge-модель проверяет, совпадают ли они семантически с текстовым ответом. Этот сигнал превращается в reward, и дальше обучение идёт через GRPO. В итоге комбинируются два сигнала: по токенам и по всей последовательности, а финальный objective — это их сумма.

По экспериментам видно, что подход стабильно уменьшает разрыв между аудио и текстом и делает аудиоответы ближе к текстовым. Обучаются только на математическом датасете, но улучшения переносятся и на general knowledge задачи.

По сравнению с обычной дистилляцией метод меньше ломает дополнительные аудиоспособности модели, то есть не ухудшает понимание звуков, музыки и прочего.

Ярослав Ведерников ❣ Специально для Speech Info
894 просмотров · 29 реакций Открыть в Telegram · Открыть пост на сайте