Физика языковых моделей: серия статей от FAIR

В прошлом году не успели поделиться с вами разбором полезной работы от исследователя лаборатории FAIR (Facebook AI Research) Цзэюань Аллен-Чжу. Исправляемся! В двухчасовом докладе и серии статей описаны свойства языковых моделей и приведено множество инсайтов.

Самые интересные идеи:

— LLM способна выучивать графы причинно-следственных связей для решения сложных задач. (Пример задачи: «В школе 10 аудиторий, в каждой по 15 парт, за каждой партой — два стула. Сколько всего стульев в школе?»). Если задача более запутанная, со сложным графом зависимостей, модель может использовать топологическую сортировку, чтобы понять порядок вычислений. Для повышения точности этого процесса предлагается обучать модель на дополнительных синтетических задачах. Описанный подход называется Level-1 reasoning.

— Перед генерацией первого токена LLM заранее просчитывает все промежуточные данные для построения ответа. Иногда модель допускает ошибки: вычисляет лишние данные или пытается оперировать тем, что ещё не вычислено. Этот процесс называется Level-2 reasoning.

— LLM способна определить, где произошла ошибка при генерации ответа. Для этого можно обучить Linear Probe, который с вероятностью около 99% предскажет место ошибки. Автор также предлагает добавить в обучающую выборку примеры Сhain-of-Thought, где модель не только ошибается, но и исправляет свои ошибки. Чем больше таких данных, тем выше становится качество модели.

— Ещё одна синтетическая задача для обучения модели — определение принадлежности последовательности грамматике Хомского. Задача формулируется так: даны правила раскрытия токенов (например: 5 → 43, 4 → 22, 3 → 11), и нужно понять, можно ли с их помощью сгенерировать последовательность 1122 (можно) или 1212 (нельзя). Оказалось, GPT не только успешно обучается на такую задачу, но и умеет определять, из каких нетерминальных токенов были сгенерированы подпоследовательности. При этом BERT, хотя и справляется с задачей, не оперирует понятием нетерминальных токенов.

Дополнительные инсайты:

— Претрейн должен содержать QA и другие задачи извлечения знаний (Knowledge Extraction, NE). Если только файнтюн содержит NE, модель будет плохо обобщаться на подобные задачи.
— Ошибки в данных на претрейне снижают качество, и стадия файнтюнинга не исправляет ситуацию.
— Аугментации заметно улучшают обобщающую способность модели. Это неудивительно, ведь они работают с перестановкой предложений, переформулировкой, стилистикой, переводами.
— Модели типа BERT работают хуже, чем GPT-архитектуры. Это объясняется авторегрессионной природой вторых, которая позволяет эффективнее генерировать и предсказывать последовательности (см. пункт о грамматике Хомского).
— Использование Сhain-of-Thought улучшает точность модели.
— GatedFFN работает хуже, чем обычный FFN.
— Универсальный закон: эффективность хранения информации (выученной из тренировочного датасета) в хорошо обученной LLM равна двум битам на один параметр модели. Этот закон действует для широкого диапазона размеров LLM.

Разбор подготовил ❣ Александр Шишеня

Душный NLP
—
Meta признана экстремистской организацией, а Facebook и Instagram запрещены на территории РФ
5 504 просмотров · 53 реакций Открыть в Telegram · Открыть пост на сайте
Теория игр в RLHF

Врываемся в новый 2025-й с новым разбором. Сегодня рассмотрим, как использование теории игр помогает в RLHF. Авторы статьи назвали свой метод General Preference Modeling (GPM). Он подходит для RLHF, но всё сказанное в статье применимо и к RL общего назначения с моделью предпочтений.

RLHF-обучение состоит из двух шагов: получение модели предпочтений и обучение генеративной модели. Авторы сосредоточились на улучшении модели предпочтений.

Традиционно такая модель учится как модель Брэдли-Терри. В ней каждому возможному ответу LLM присваивается некоторый скаляр, отражающий его качество. Утверждается, что пользователь предпочитает ответы с более высоким качеством. При этом подходе ответы получаются линейно упорядоченными и всегда можно найти лучший, что несомненный плюс.

Из недостатков — модель предполагает, что функция предпочтений человека всегда описывается достаточно простой моделью Брэдли-Терри, в которой всегда есть лучшие и худшие ответы. На практике же несколько ответов могут образовывать нетранзитивный цикл. Скажем, при игре в «Камень-ножницы-бумага» нет лучшего действия, однако модель всё равно попытается их упорядочить.

Чтобы решить эту проблему, авторы обращаются к теории игр. На самом деле эта идея не нова. Скажем, были уже модели попарных сравнений, которые работали не от оценки одного ответа, а от сравнения двух вариантов. У такого подхода тоже есть существенные недостатки — это удар по производительности и отсутствие гарантии антисимметричности. То есть попарная модель должна оценивать, насколько первый ответ лучше второго противоположным числом оценки превосходства второго ответа над первым.

Свой подход авторы статьи строят на основе эмбеддингов. В отличие от модели Брэдли Терри, где каждому ответу приписывается скаляр, здесь приписывается некоторый эмбеддинг. После этого с помощью любой антисимметричной билинейной формы от эмбедингов двух ответов происходит проверка факта, что один из них лучше другого. В такой модели по построению выполняется свойство антисимметричности. Также авторы предлагают конкретный вид для билинейной формы, обеспечивающий простоту вычисления.

В случае, если эмбеддинг состоит из двух скаляров, авторы предлагают в качестве антисимметричного билинейного оператора использовать матрицу поворота на 90 градусов в двухмерном пространстве. А для случаев с большей размерностью эмбеддингов — строить блочно-диагональные матрицы с вышеописанными матрицами поворота на диагонали (вторая картинка выше). Такой оператор способен моделировать циклы в предпочтениях пользователей, располагая эмбеддинги на окружности.

Далее оптимизация языковой модели в соответствии с предпочтениями пользователя представляется в виде матричной игры, где разные LLM играют друг с другом. Выигрыш считается в соответствии с полученной ранее моделью предпочтений как среднее значение предложенной билинейной формы от эмбэддингов ответов двух соревнующихся моделей. Равновесием по Нэшу для такой игры будет модель, которая в среднем обыгрывает все остальные. Эту модель и предлагают искать авторы статьи, для чего адаптируют итеративный алгоритм из теории игр.

Оказывается, что шаг полученного алгоритма эквивалентен запуску классического RL-обучения. Здесь reward для конкретного ответа считается как среднее значение билинейной формы предпочтений для первого ответа и ответа, сгенерированного моделью с предыдущего шага этого алгоритма. К сожалению, на практике среднее значение билинейной формы не берётся из-за необходимости сэмплировать ответы из модели с предыдущего шага. Поэтому авторы в своём алгоритме используют Монте-Карло оценку этого среднего.

Тестирование показало, что обобщённая модель предпочтений даёт большую точность на циклических датасетах, но на стандартных результат сопоставим с тем, который показывают классические методы. Однако при использовании новой reward-функции в RL качество генеративной модели значительно улучшается.

Разбор подготовил ❣ Федор Лебедь

Душный NLP
4 851 просмотров · 43 реакций Открыть в Telegram · Открыть пост на сайте
🏆 Лучшее за год в Душном NLP

Конец года — время подводить итоги и рассказывать о достижениях. Спасибо, что подписывались, читали, комментировали и ставили реакции на посты. О самых популярных из них мы сейчас и расскажем. Хороший способ вспомнить интересное или наверстать упущенное.

Масштабирование и параметризация

Разбор сразу двух статей о сохранении стабильности гиперпараметров при масштабировании модели. Авторы одной работы предлагают озаботиться правильным масштабированием инициализаций и послойных LR, либо напрямую спектральной нормализацией матриц весов и их обновлений в процессе обучения. Авторы другой статьи считают, что обновления весов в градиентном спуске имеют низкий ранг и хорошо согласуются с векторами активаций.

SpecExec: cпекулятивное декодирование для запуска больших моделей на потребительских GPU

Метод SpecExec позволяет генерировать до 20 токенов за итерацию и достигает ускорения x15 при офлодинге. Производительность достигается за счёт использования высокой пиковости распределений вероятностей токенов в современных LLM.

ReMax как альтернатива PPO

Авторы статьи предлагают замену алгоритму Proximal Policy Optimization (PPO). В отличие от последнего, в ReMax в качестве бейзлайна не используется отдельная value-модель. Благодаря этому снижение потребления GPU-памяти составляет до 46%.

Ограничения Instruction Tuning и как их преодолеть

Авторы рассматривают то, как LoRA (Low-Rank Adaptation) может помочь нивелировать недостатки SFT. Эксперименты показывают, что LoRA-модель действительно даёт более точные ответы, при этом метод остаётся эффективным даже на небольших датасетах.

TDPO — потокенный DPO или просто регуляризация?

Разбор статьи, авторы которой предложили метод потокеннного DPO. На деле всё оказывается не так просто. Результаты действительно улучшились, но, похоже, что авторы просто добавили регуляризацию.

Mixture-of-Agents — простой способ улучшения ответов LLM

Суть метода Mixture-of-Agents заключается в использовании нескольких LLM на разных слоях для генерации ответов на один и тот же вопрос. Результат превосходит по качеству то, что выдавала бы одна модель.

Что такое дистилляция и как она применяется в LLM

Дистилляция — это передача знаний от тяжёлой модели более лёгкой. В посте рассказали, как появилась дистилляция и какие методы в ней используют, например, применение датасета reward-модели и расширение набора данных с помощью генерации с разными параметрами.

DeepSeek-V2 — MoE-модель с технологией MLA

DeepSeek-V2 — модель на 236 миллиардов параметров. Модифицированный attention MLA (Multi-Head Latent Attention) позволяет ей значительно снизить объём ресурсов, необходимых для работы.

Карточки с интересными статьями с ICLR и два поста с занимательными статьями с ICML

А ещё в этом году мы побывали на конференциях ICLR и ICML — и увидели там очень много интересных статей. Обо всех них мы рассказывали в серии постов.

Душный NLP
5 309 просмотров · 55 реакций Открыть в Telegram · Открыть пост на сайте
Технический отчёт Qwen2.5

Создатели линейки языковых моделей Qwen2.5 представили технический отчёт. Вот что мы из него узнали.

Претрейн

На претрейне использовали датасет объёмом 18 триллионов токенов против 7 триллионов у Qwen 2. В частности, были данные, применявшиеся для обучения Qwen2.5-Math и Qwen2.5-Coder, что позволило улучшить результаты модели в вопросах, связанных с математикой и программированием. Также применяли синтетические данные, сгенерированные Qwen2. Scaling laws использовали для предсказания оптимальных гиперпараметров — например, для learning rate или вычисления размера батча.

Во время первой фазы претрейна длина контекста составляла 4096 токенов, а на второй и финальной — 32 768 токенов для всех моделей семейства, кроме Qwen2.5-Turbo. В её случае претрейн проходил в четыре этапа, начинаясь с 32 768 токенов и заканчивая 262 144 токенами. В каждой фазе претрейна Qwen2.5-Turbo максимального значения достигали только 40% данных, а остальные были короче. По словам авторов, это позволило модели плавно адаптироваться к новой длине контекста.

Благодаря стратегиям YaRN и Dual Chunk Attention удалось увеличить максимальную длину обрабатываемой на инференсе последовательности в четыре раза: до миллиона токенов у Qwen2.5-Turbo и до 131 072 токенов у других версий.

Алаймент

SFT-датасет состоял из более чем миллиона примеров. Длина выхода Qwen2.5 — 8192 токена, в то время как обычно она составляет менее 2000. Улучшения удалось добиться благодаря наборам данных для длинных ответов. Разработчики использовали back-translation, чтобы генерировать запросы на основе данных для предварительного обучения, ограничивали длину выхода и отфильтровывали низкокачественные пары с помощью Qwen2.

Для задач, связанных с математикой, использовали CoT-данные из Qwen2.5-Math. Кроме того, применяли rejection sampling вместе с размеченными данными и моделью награды для пошагового рассуждения. Что касается генерации кода, то здесь было несколько агентов и пары инструкций на примерно 40 языках программирования.

В части instruction following модели генерировали инструкции, проверочные коды и юнит-тесты для перекрёстной проверки. Это позволило LLM лучше следовать промптам. А благодаря внедрению цепочек рассуждений в ответы, Qwen2.5 стала лучше извлекать информацию из структурированных данных — например, таблиц.

Использовали также модель перевода инструкций с высокоресурсных на низкоресурсные языки. Каждый полученный ответ проходил оценку на семантическое соответствие оригиналу, что позволило сохранить логическую структуру и стилистику текста.

Разработчики создали сотни системных промптов, чтобы обеспечить согласованность между ними и диалогами. Для оценки качества ответов применяли несколько методов автоматической аннотации, включая специализированную модель-критика и систему коллективной оценки с участием нескольких агентов. Сохраняли только те ответы, которые все системы оценки посчитали безупречными.

На этапе DPO в качестве позитивных примеров использовали хорошие ответы с SFT. Те же, которые не прошли проверку на SFT, стали негативными примерами.

Для создания датасета задействовали как автоматические, так и ручные методы оценки. В итоге получился набор данных из 150 тысяч пар. Qwen2.5 обучалась на нём в течение одной эпохи с применением Online Merging Optimizer c learning rate 7 × 10⁻⁷.

Reward-модель тренировали на двух наборах данных: общедоступном и проприетарном, содержащем запросы со сложной структурой. Ответы генерировались с чекпоинтов Qwen-моделей, прошедших файнтюнинг разными методами (SFT, DPO, RL), и при разных температурах. В качестве алгоритма для онлайн RL использовали Group Relative Policy Optimization (GRPO). Набор запросов для обучения reward-модели был идентичен тому, что применялся на этапе обучения с подкреплением. Для каждого запроса отбирали по 8 ответов.

Душный NLP
6 757 просмотров · 64 реакций Открыть в Telegram · Открыть пост на сайте
Интересные статьи с NeurIPS 2024

DEVBENCH: A multimodal developmental benchmark for language learning

Одна из многих работ о бенчмарках. Здесь авторы предлагают мультимодальный бенчмарк с информацией о том, как себя на нём проявляют люди разных возрастов. Создатели стремятся проверить: правда ли модели учатся и растут примерно как дети. Ответ положительный, однако люди лучше показывают себя в неоднозначных ситуациях, потому что понимают контекст. По словам авторов, их работа может давать представление о возможных путях развития языковых моделей.

LLM Evaluators Recognize and Favor Their Own Generations

Модели всё чаще используют для оценки их же ответов. Такой метод называют Self-evaluation, однако у него есть потенциальные проблемы. В частности, из-за самопредпочтения (self-preference) — LLM может оценивать собственные ответы выше остальных. Авторы статьи проверяют, влияет ли способность модели узнавать свои тексты на предпочтения. Выясняется, что да — особенно у GPT-4 и Llama 2. Таким образом, чтобы использовать модель вместо ассесора для разметки, нужно выяснить, в чём она предвзята. Выводы статьи могут быть полезны для определения сгенерированных текстов и нахождения схожести между моделями.

LINGOLY: A Benchmark of Olympiad-Level Linguistic Reasoning Puzzles in Low-Resource and Extinct Languages

Ещё один текст о бенчмарке — на этот раз для оценки способностей к рассуждению. Он состоит из задач о низкоресурсных — то есть таких, о которых мало данных для обучения — языках из олимпиад по лингвистике. Всего в бенчмарке 1133 задачи по 90 языкам. LINGOLY получился сложным — лучше всего себя показала Claude Opus, но и она набрала менее 20%.

Not All Tokens Are What You Need for Pretraining

Авторы выдвигают гипотезу: не все токены на претрейне одинаково важны. Чтобы доказать это, создают модель RHO-1. С помощью неё считают перплексию для всего претрейна. А затем обучают модель на самых значимых токенах. На ряде бенчмарков действительно получили прирост в 20-30 процентных пунктов. Бенчмарки были в основном математические и научные.

Интересное увидела ❣ Анастасия Беззубцева

#YaNeurIPS

Душный NLP
3 787 просмотров · 34 реакций Открыть в Telegram · Открыть пост на сайте
ToolkenGPT и Toolken+: расширение возможностей языковых моделей за счёт интеграции инструментов

Сегодня разбираем две статьи. Первая описывает парадигму обучения инструментов ToolkenGPT. Вторая представляет развитие этой концепции, предложенное Константином Яковлевым, Сергеем Николенко и Андреем Бутом из Яндекса.

ToolkenGPT: как научить модель напрямую вызывать внешние функции
В первой работе исследователи предложили представить каждый внешний инструмент в виде токена — toolken (represents each tool as a token) — и выучивать его эмбеддинг. Модель обучается работать с такими токенами так же, как с обычными текстовыми.

В результате работу модели можно условно разделить на две стадии:

1) режим “reasoning” — генерация происходит, как обычно, с той лишь разницей, что добавленные toolken тоже рассматриваются в качестве вероятных токенов на каждом шаге генерации;
2) режим “tool” — когда следующим предсказанным токеном оказался toolken. В этом случае вызывается соответствующий инструмент в режиме “few-shot”. После того как вызов осуществляется внешним инструментом, модель возвращает ответ и переходит обратно в режим “reasoning”.

Авторы показали применимость подхода для математических операций на GSM8K-XL и FuncQA. Также рассмотрели задачи knowledge-based QA и генерации плана.

Toolken+: ранжирование инструментов и отказ от неподходящих функций
Концепция Toolken+ решает две проблемы ToolkenGPT. Во-первых, ранее модель не учитывала документацию по инструментам и часто выбирала неподходящий инструмент. Во-вторых, модель иногда стремилась использовать инструмент там, где это не требовалось.

Toolken+ добавляет два улучшения:

1) Переранжирование нескольких выбранных инструментов. Модель сначала предлагает k вариантов, потом повторно оценивает и выбирает оптимальный.
2) Опцию “reject” для отказа от вызова инструмента. Модель может явно указать, что сейчас не стоит применять никакой инструмент, если вероятность подходящего вызова невысока.

Эти изменения позволяют минимизировать как ошибки ложноположительных срабатываний при вызове инструментов, так и ошибки неправильной классификации инструментов для ToolkenGPT, что позволяет улучшить робастность модели.

Результаты
Исследователи проверяли Toolken+ на математическом бенчмарке GSM8K, на бенчмарках VirtualHome и MetaTool. Они показали, что добавление переранжирования и опции "reject" улучшает качество конечных ответов. При этом в MetaTool требуется только одна функция для заданного запроса, поэтому опция "reject" не нужна — таким образом, замер служит как аблейшн реранжирования гипотез.

Расскажите в комментариях, что думаете о подходах ToolkenGPT и Toolken+.

Разбор подготовил
❣ Андрей Бут
Душный NLP
3 448 просмотров · 31 реакций Открыть в Telegram · Открыть пост на сайте
PRISM — датасет с информацией о пользователе

Интересное с NeurIPS по мнению Анастасии Беззубцевой, руководителя группы аналитики в Яндексе: доклад о датасете The PRISM учитывает социодемографические характеристики вроде места проживания, этнической принадлежности, уровня дохода, вероисповедания и так далее. Для сбора данных привлекли 1,5 тысячи человек из 75 стран. Участники, которых искали с помощью сервиса Prolific, провели более 8 тысяч диалогов с 21 языковой моделью.

Анализ данных показал, что разные группы людей ведут разные разговоры с LLM. Так, пожилые респонденты чаще молодых поднимали тему выборов, а чернокожие реже белых говорили об изменении климата. При ранжировании моделей индивидуальные характеристики пользователя оказываются очень важны. Например, Zephyr-7b хорошо показывает себя в обсуждении чувствительных тем, а mistral-7b больше других понравилась респондентам из Африки.

На постер-сессии Анастасия пообщалась с докладчицей Ханной Роуз, которая получает PhD в Оксфорде и имеет экономический бэкграунд.

Я задала ей свой любимый вопрос о качестве данных, полученных краудом. Роуз сказала, что проверка участников была минимальной. Исполнителям настолько нравилось задание — просто поболтать с LLM на заданную тему, — что на датасет потратили вдвое меньше денег, чем планировали, а результат авторов более чем устраивает.


#YaNeurIPS

Душный NLP
4 349 просмотров · 28 реакций Открыть в Telegram · Открыть пост на сайте
Впечатления от туториала об оценке моделей на NeurIPS

На повестке — туториал Evaluating Large Language Models — Principles, Approaches, and Applications. Он был посвящён оценке больших языковых моделей (LLMs). Руководитель группы аналитики в Яндексе Анастасия Беззубцева посетила туториал и рассказала, что интересного отметила для себя.

Первую часть представляла продакт-менеджер Google Ирина Сиглер. Она ввела общие понятия и объяснила базовые моменты. Например, о важности валидации на датасете, который репрезентативен реальной бизнес-задаче. Есть три способа собрать валидационное множество заданий для оценки модели:

— Manual — написание промптов вручную;
— Synthetic — генерация промптов с помощью LLM;
— Traffic — использовать продуктовый поток.

По словам Сиглер, важно оценивать систему полностью, а не только LLM под капотом. Сама модель — это всего лишь один кирпичик в общей структуре.

Со второй частью выступала исследовательница и член консультативного совета Центра инноваций в области искусственного интеллекта (CAII) в университете Иллинойса Бо Ли. Она выделила три метода оценки:

— Computation — расчёт схожести между данным ответом и референсным;
— Human — оценка человеком;
— LLM-as-Judge или AutoRater — оценка с помощью модели.

Ли Бо рассказала, что автоматические методы оценки не слишком хорошо коррелируют с человеческими суждениями. Модели могут ошибаться, отдавая предпочтение, например, собственным или самым длинным ответам. Однако использование LLM для оценки становится всё более частым явлением — главное, чтобы полученные результаты валидировали люди. Чтобы нивелировать недостатки способа, на туториале предлагали переставлять опции и искать консенсус между несколькими ответами одной модели или ответами разных.

Этим туториал не ограничился — были еще практическая часть и часть, посвященная соответствию этическим нормам. С презентацией туториала вы можете ознакомиться по этой ссылке.

#YaNeurIPS

Душный NLP
4 232 просмотров · 31 реакций Открыть в Telegram · Открыть пост на сайте
Астрологи объявили неделю NeurIPS 2024

В Ванкувере стартовала одна из крупнейших конференций по машинному обучению. А это значит, что в ближайшие дни мы будем делиться с вами самыми интересными статьями и яркими впечатлениями прямо с полей.

В этом году на конференции:

⚪ 4497 статей, из которых 460 — по датасетам и бенчмаркам;
⚪ 13640 ревьюеров;
⚪ 56 воркшопов;
⚪ 14 туториалов.

В числе прочего, представят восемь статей исследовательского подразделения Яндекса, Yandex Research. Мы рассказывали о каждой из них в канале ML Underhood — подписывайтесь!

С роботами знакомилась ❣ Анастасия Беззубцева

#YaNeurIPS

Душный NLP
3 852 просмотров · 37 реакций Открыть в Telegram · Открыть пост на сайте
Как избавиться от Value-функции в PPO

Сегодня — о двух методах стабилизации PPO. Один вытекает из другого и каждому посвящена отдельная статья.

О PPO подробнее мы уже рассказывали в другом нашем канале — ML Underhood. Здесь же сосредоточимся на частностях. Традиционно в PPO считается некоторый advantage. Он вычисляется для пары префикса и ответа и показывает, на сколько конкретный ответ лучше среднего. Чтобы определить advantage нужно из суммарной награды префикса и ответа (Q в первой формуле выше) вычесть среднюю награду (V), которую генератор набрал бы, если бы стартовал с этого префикса.

Value-функцию принято обучать отдельной моделью на прогнозирование средних наград. Однако с V-моделью есть некоторые сложности. Во-первых, она большая и сопоставима по размерам с генератором. Во-вторых, её нужно инферить, на что требуются вычислительные ресурсы. А в-третьих, она обычно выдает не очень хорошие результаты. Поэтому было бы круто придумать способ избавиться от V-модели в PPO, ведь она нужна только для снижения дисперсии оценки лосса. Авторы обеих статей поставили перед собой именно эту задачу.

Авторы статьи DeepSeekMath предлагают метод, который называется Group Relative Policy Optimization (GRPO). В его рамках две модификации:

1. Не обучать V-модель. Вместо этого оценить значение средней награды методом Монте-Карло. Ничего сложного: вместо генерации одного ответа на запрос сгенерировать несколько ответов, а среднюю награду, полученную за эти ответы на запрос, использовать как V. При подсчете advantage из награды каждого ответа вычитается эта средняя награда. Таким образом, от V-модели избавляются с помощью увеличения количества генераций (схема на втором изображении).

2. В PPO используется KL-штраф за отклонение от SFT-модели. Обычно этот штраф вычитают из награды, чтобы PPO одновременно наращивал награду и не отходил далеко от SFT. Авторы предлагают добавлять штраф прямо к лоссу — это лишает нас каких-то интересных теоретических свойств алгоритма, но делает процедуру оптимизации намного легче (третье изображение с формулой).

Авторы второй статьи — VinePPO — опираются на DeepSeekMath и развивают GRPO в контексте математических задач. В GRPO, в отличие от классического PPO, V-функция для всех токенов ответа получается одинаковой. Так устроен алгоритм, ведь туда записана просто средняя награда за несколько ответов.

Для ответов, в которых есть цепочки рассуждений, это может быть не очень репрезентативно: при решении математических задач, удачный ход в рассуждении должен значимо повышать ожидаемую награду за ответ, тогда как ошибка в рассуждениях — наоборот, понижать.

Авторы предлагают разбивать ответ на смысловые блоки — по переносам строки. точкам или запятым, которые находятся вне формул — и для каждого из них оценивать V-функцию так же, как это делается в GRPO. То есть генерировать по несколько продолжений из частично готового ответа.

Хоть идея и проста, эффективно её реализовать довольно трудно. А ещё этот метод требует существенно большего числа генераций во время обучения. Авторы честно признаются, что их метод медленнее обычного PPO, но показывает неплохие результаты.

Разбор подготовил ❣ Павел Темирчев

Душный NLP
4 586 просмотров · 40 реакций Открыть в Telegram · Открыть пост на сайте
ReDrafter — быстрый метод спекулятивного декодирования

Сегодняшняя статья посвящена Recurrent Drafter (ReDrafter) — новому подходу к спекулятивному декодированию. Авторы заявляют, что он позволяет значительно увеличить скорость моделей.

Само спекулятивное декодирование основано на использовании дополнительной «черновой» модели, которая предлагает варианты продолжения цепочек токенов. Основная модель проверяет эти варианты, выбирая один с помощью специальной процедуры верификации. Качество генераций остаётся таким же, как и без использования спекулятивного декодирования, потому что окончательное решение о принятии тех или иных токенов лежит на основной модели.

В ReDrafter в качестве черновой модели используется RNN. Благодаря рекуррентной структуре, учитывается зависимость между черновыми токенами. Кроме того, RNN, помимо последнего токена, также видит и скрытое состояние из последнего слоя LLM, что даёт ей возможность лучше следовать генерациям основной модели.

С помощью алгоритма динамического древа внимания (dynamic tree attention algorithm), в сгенерированных RNN кандидатах убираются повторяющиеся префиксы. Таким образом, в основную модель попадает меньше вариантов, а значит затраты вычислительных ресурсов становятся меньше. Далее основная модель оценивает предложенные варианты (при этом, сразу несколько), выбирает лучший и процесс повторяется снова.

RNN обучается с помощью дистилляции из основной модели. Это позволяет RNN предсказывать токены с вероятностями, максимально приближенными к ожиданиям LLM. Таким образом, «черновая» модель реже предлагает токены, которые будут отклонены.

Авторы отмечают, что использование дистилляции дает лучшие результаты, чем обучение «черновой» модели на исходном датасете, на котором тренировали LLM. Так, скорость генерации и число принятых токенов за один шаг на Vicuna 7B выросли примерно на 10%.

ReDrafter показал лучшие результаты по сравнению с методами Medusa и EAGLE на бенчмарках MT-Bench и AlpacaEval. При этом, по сравнению с жадной генерацией, генерация семплированием показывает ещё большее ускорение, чего обычно не показывают другие методы спекулятивного декодирования.

Разбор подготовил ❣ Алексей Гликин

Душный NLP
4 487 просмотров · 45 реакций Открыть в Telegram · Открыть пост на сайте
WARM — метод улучшения reward-моделей

Сегодняшняя статья — о методе усреднения весов reward-модели для устранения проблем, связанных с RL-обучением. Но для начала напомним, как работает Reward-модель.

На вход она принимает промпты и ответы, а на выход выдаёт скаляры. По ним возможно ранжировать ответы от лучшего к худшему. Всё это делается с помощью обучения на минимизацию лосса, который вытекает из модели Брэдли-Терри. Как правило, reward-модели обучаются на датасете из преференсных данных — то есть таких, в которых ответы уже размечены асессорами или другой моделью.

Есть ряд проблем, с которыми можно столкнуться во время обучения reward-модели. Во-первых, разметка может оказаться достаточно шумной — например, при расхождениях в оценках одного и того же ответа разными асессорами. Кроме того, в некоторых случаях политика может генерировать OOD-ответы для выбранной reward-модели.

Наконец, возможно и такое, что reward-модель выучится на какой-то черте данных — например, особенностях оформления. При этом на файнтюнинге модель научится генерировать те ответы, которые будут давать высокий скор именно из-за этой особенности, а не из-за качества самих ответов. Скажем, будет отдавать приоритет хорошо оформленным, а не правильным ответам.

Существует несколько методов, призванных справится с вышеописанными проблемами. Например, можно обучить много абсолютно разных reward-моделей и усреднить их логиты. Этот метод называется prediction ensembling (ENS), а его главный недостаток заключается в необходимости инферить сразу несколько моделей, что не очень экономично в условиях файнтюнинга.

Авторы статьи, в свою очередь, предлагают обучать reward-модель с помощью одного датасета с преференсными данными, но с разными гиперпараметрами, а также с разных чекпоинтов SFT-обучения. В результате получается несколько моделей с одинаковой архитектурой. Их веса следует усреднить в одну модель — Weight Average Reward-Model (WARM), которая поступает как reward-функция в RL. Проведенный авторами анализ показал, что WARM — это аппроксимация ENS.

Почему это должно работать? Известно, что существует линейная связь в моделях, обученных из одного претрейна. Она позволяет усреднять веса, не теряя при этом в качестве. Однако это справедливо только для одного претрейна.

Проверки c использованием датасета TL;DR summarization показали, что WARM запоминает меньше испорченных или некорректных данных разметки в датасете, чем ENS. То же самое касается работы с OOD-примернами. Однако на «чистом» фрагменте датасета, где разметка без ошибок, ENS выдаёт лучшие результаты.

Авторы заявляют, что преимущество их метода заключается в использовании всего одной модели в ходе файнтюнинга — это позволяет экономить время и вычислительные ресурсы. Кроме того, WARM решает некоторые проблемы, связанные с «грязными» данными. Однако есть и ограничения. Например, необходимость обучаться из одного претрейна и невозможность использовать разные архитектуры.

Разбор подготовил ❣ Илья Черемушкин

Душный NLP
4 855 просмотров · 41 реакций Открыть в Telegram · Открыть пост на сайте
TDPO — потокенный DPO или просто регуляризация?

Авторы сегодняшней статьи предлагают метод потокенного Direct Preference Optimization (DPO), который на бумаге должен исправить некоторые проблемы оффлайн-обучения с подкреплением. Но на деле все оказывается не так просто.

DPO — метод обучения, не полагающийся на reward-модель. Здесь применяют датасет с размеченными парами запросов и ответов, чтобы натренировать генератор на контрастный лосс.

Проблема в том, что в случае с DPO мы работаем с вероятностями последовательностей целиком. Метод ограниченно контролирует поведение модели на уровне отдельных токенов. Это приводит к тому, что модель может ошибочно сильно повышать или понижать вероятность отдельных токенов значительно после совершенных ошибок.

Эту проблему можно нивелировать, если сделать DPO потокенным. Авторы статьи пытаются добиться этого.

Для начала они предлагают ввести необычное ограничение — сделать так, чтобы сумма наград всех токенов-продолжений для произвольного префикса была равна 0. Это довольно сильное допущение: например, если мы решаем задачу копирования какого-то куска текста, то будем сильно штрафовать модель за любое отклонение. Как результат — награда за правильный токен окажется очень большой. В этом случае, если при выборе между длинной и короткой строкой, модель будет склоняться к длинной строке.

Такое ограничение позволило авторам в их расчётах лосса избавиться от нормировочной константы вероятностного распределения. Чтобы ее вычислить, нужно суммировать награду по всем возможным ответам, а это невозможно, поэтому от константы при расчётах избавляются. В DPO нормировочная константа одинакова для победившего и проигравшего ответов, поэтому она сокращается в лоссе, но авторы статьи сделали это несколько иначе.

Из их математической модели выводится функция, которая очень похожа на DPO. Но в отличие от DPO, авторы вычитают из неё разницу между SeqKL проигравшего и победившего ответа. Этот метод, названный Token-level Direct Preference Optimization (TDPO), обеспечил незначительное улучшение по сравнению с обычным DPO. На датасете Anthropic HH точность увеличилась всего на 0,65%.

Далее авторы предлагают умножить на дополнительный коэффициент разницу SeqKL и не пропускать градиенты для победившего варианта. Это можно трактовать так: при росте SeqKL проигравшего ответа всегда увеличивается лосс, в то время, как при росте SeqKL победившего — лосс уменьшается. Получается, что добавка к DPO, после остановки градиента для её части, по сути работает, как регуляризация.

С ней метод получил название TDPO2 и он действительно неплохо улучшает показатели. На том же Anthropic HH прирост по сравнению с DPO составил уже не 0,65%, а 7,9%.

Авторы действительно предложили лучшее решение. Но возникает вопрос: насколько здесь велик вклад выведенной математической модели. По факту, авторы сильно меняют основные моменты в этой модели, а то, что остается, очень похоже на простую потокенную регуляризацию. Но её идея не нова: часто к DPO добавляют negative log likelihood loss — например, при DPO-обучении Llama 3.1, — что тоже является вариантом потокенной регуляризации. Мы склоняемся к тому, что научный вклад этой статьи невелик, а ключевые выводы — ошибочны.

Разбор подготовил ❣ Михаил Хрущев

Душный NLP
14 434 просмотров · 35 реакций Открыть в Telegram · Открыть пост на сайте
Инфраструктура LLaMA 3.1

Продолжаем серию постов о модели Meta* рассказом об инфраструктуре. На чём же училась LLaMA?

Претрейн 405B-модели осуществлялся на 16 тысячах H100, с потреблением электроэнергии в 700 Вт каждая. Использовалась кастомная платформа с Liquid Cooling-хостами.

У Meta есть general-purpose-хранилище на основе TectonicFS. Изначально его использовали и для обучения ИИ, и для других процессов и клиентов. Однако создание чекпоинтов оказывало очень большую нагрузку на хранилище. Поэтому инженеры создали отдельное хранилище исключительно для тренировок модели.

Что касается сети, то в Meta сделали сразу два кластера: с RoCE для большой модели и с Infiniband для моделей поменьше. В каждой стойке по два хоста, а каждом хосте — по восемь GPU. Всего в кластере 24 тысячи GPU, из которых 16 отведены под обучение.

Внутри каждого из восьми модулей на 3072 GPU максимальная пропускная способность сети. А между модулями — она в семь раз меньше. Планировщик распределяет задачи по хостам, тем самым минимизируя сетевые коммуникации между модулями. Также используется NCCLX — кастомная версия библиотеки для коммуникаций NCCL.

Как показатель эффективности использовали Model FLOPS Utilization (MFU) — это коэффициент отношения наблюдаемого числа обработанных токенов к теоретическому максимальному числу. Он достигает от 38% до 43% — в зависимости от сетапа. Подробнее — в таблице выше.

О надежности. За 54 дня претрейна случилось 419 непредвиденных остановок — то есть примерно по 8 в день. Из строя ежедневно выходило 0,3-0,4% оборудования. Статистику по падениям можно посмотреть во второй таблице. Боролись с неполадками и предотвращали их с помощью частых чекпоинтов, быстрых рестартов, инструментов для диагностики проблем. Кроме того, инженеры — не прерывая обучение — могли менять настройки и уровень логирования.

Напоминаем, что у нас есть и другие посты о LLaMA 3.1:
— о претрейн-датасете;
— архитектуре модели;
— алайменте.

А в канале CV Time вы найдёте пост о том, как LLaMA 3.1 работает с изображениями, а также много других интересных разборов и репортажи с профильных конференций. Подписывайтесь!

Душный NLP
—
Meta признана экстремистской организацией, а Facebook и Instagram запрещены на территории РФ
5 174 просмотров · 49 реакций Открыть в Telegram · Открыть пост на сайте
Алаймент LlaMA 3.1

Возвращаемся к LlaMA 3.1 и продолжаем разбираться, как она устроена. В этот раз речь пойдёт об алайменте модели.

По сравнению с LLaMA 2 у третьей версии изменилась разметка пар. Помимо стандартных chosen и rejected добавилась ещё метка edited. Она ставится в тех случаях, когда победивший объект не слишком хорош и его переписывают. Ответы оцениваются по семибалльной шкале.

SFT происходит в шесть раундов. Если в LLaMA 2 использовался PPO, то в LlaMA 3 — DPO. Разработчики отмечают, что это связано с тем, что PPO требует больше вычислительных ресурсов, а качество выходит хуже.

Ещё одно важное отличие — это специализация. На претрейне модель доучивают для решения специальных задач. Потом делают отдельный алаймент, полученную специализированную модель используют для генерации новых обучающих данных стадии алайнмента, а также мержат веса нескольких специализированных модель в единую модель.

Reward-модель обучается над претрейном. Margin term, который был в Llama 2, в третьей версии отсутствует, так как, по словам разработчиков, он не даёт никакого прироста в качестве. Как и в DPO, оставляют только те ответы, которые помечены как «сильно лучше» и «лучше». Кроме того, в reward-модели есть отдельные награды для полезности и безопасности.

За один раунд SFT 405B-модель суммарно проходит 576 тысяч сэмплов. В DPO используют сэмплы от моделей с последних раундов (а в reward-модели — все). Служебные токены, такие как EOS или токены для вызовов функций, маскируют для стабилизации обучения. Кроме того, к DPO добавляют NLL (CE) с коэффициентом 0,2. Это нужно, чтобы повысить вероятность chosen-ответов. Промпты для обучения пишут люди, а ответы — модели. На один промпт выбирают лучший ответ из 10-30 поступивших.

В LlaMA 3.1 есть четыре уровня фильтрации данных:

1. Rule-based — удаляет дисклеймеры, смайлики и восклицания;

2. Quality — качественными считаются 25% ответов с наибольшим скором. Кроме того, используется LLM-as-judge. Ответы оцениваются по трём критериям для обычных данных и двум — для кодинга. Ответ считается качественным, если все критерии выполнены. Сэмпл попадает в обучение, если хотя бы один из методов показал, что ответ качественный;

3. Difficulty — оценивается по числу интентов в запросе: чем их больше, тем сложнее запрос. Также модель оценивает сложность по трёхбальной шкале;

4. SemDedup — этот метод используется для удаления похожих данных, при отборе отдается предпочтение семплам с максимальным значением quality * difficulty.

Алаймент для каждой из функциональных возможностей (Capabilities) LLaMA 3.1 имеет свои особенности. Например, в коде есть много синтетических данных, используется execution feedback и перевод на редкие языки программирования. А для математики берут тексты из претрейна и уже к ним генерируют инстракты.

Что касается фактологичности, то разработчики не добавляют новых знаний поверх претрейна. Для этого модель обучают отвечать только на те вопросы, на которые она может выдать ответ, согласованный с документом из претрейна. А для чувствительных тем, по которым в датасете много некорректной информации, используют ручную разметку.

Разбор подготовил ❣ Алексей Зотов

Душный NLP
5 409 просмотров · 60 реакций Открыть в Telegram · Открыть пост на сайте
Ограничения Instruction Tuning и как их преодолеть

Supervised Full Fine-tuning (SFT) — распространённая практика, но он не лишён недостатков. Авторы сегодняшней статьи задаются вопросом: а может ли LoRA (Low-Rank Adaptation) исправить недочёты?

При использовании Full Fine-tuning возникает две проблемы: у моделей часто возникают сложности с извлечением новых знаний из SFT-датасета, могут участиться галлюцинации. Исследование показало, что модели, обученные с использованием Full Fine-tuning, могут генерировать неверные ответы, если берут слишком много токенов из SFT-датасетов. Эффект особенно заметен, если модель пытается отвечать на вопросы, требующие глубокой экспертизы.

Например, на вопрос «Какие основные работы Эйнштейн сделал после того, как в 1915 году открыл Общую теорию относительности?» модель начинала выдавать не соответствующие действительности ответы — скажем, о «квантовой теории атома трития».

Одним из возможных решений может быть LoRA — это метод, который позволяет обучать модели с гораздо меньшими ресурсами, модифицируя лишь небольшую часть параметров. Вместо полного тюнинга всех параметров LoRA использует специальные низкоранговые матрицы, что приводит к изменениям только определённых аспектов, таких как стиль ответа или инициирование фраз. При этом основная часть весов предобученной модели остаётся неизменной.

Первые несколько процентов токенов, сгенерированных LoRA-моделью, могут быть изменены (по сравнению с ответом предобученной модели), чтобы правильно начать ответ. Но большая часть предложения остаётся такой же, как у предобученной модели. Это позволяет уменьшить количество галлюцинаций. Эксперименты показали, что LoRA даёт более точные ответы.

LoRA эффективен даже при малом объёме датасета. Например, модель с LoRA, обученная на наборе данных из 1000 инструкций, может превосходить модели с SFT на датасетах по срезам фактологичености и полезности, содержащих 52 000 или даже 326 000 инструкций. В экспериментах использовались различные открытые и домен-специфичные датасеты, включая MedInstruct и Alpaca. Модели с LoRA демонстрировали лучшее соответствие фактам и были менее подвержены галлюцинациям.

Разбор подготовил
❣ Алексей Шимко

Душный NLP
12 270 просмотров · 57 реакций Открыть в Telegram · Открыть пост на сайте
Архитектура LLaMA 3.1

Продолжаем разбирать LLaMA 3.1. В прошлый раз речь шла о претрейн-датасете, а в этот раз — об архитектуре модели.

Llama 3 использует стандартную архитектуру трансформера, которая не сильно отличается от того, что было в LLaMA и LLaMA 2. Однако отличия есть. Скажем, если в LLaMA 2 Grouped Query Attention (GQA) с восемью ключевыми головами внимания использовались только в моделях на 34B+, то здесь GQA применяется для всех моделей LLaMA 3.1. Это позволило повысить скорость вывода и уменьшить объём данных, необходимых для кеширования во время декодирования.

Ещё одно важное изменение — увеличение контекстного окна до 128 тысяч токенов. Это стало возможным благодаря увеличению гиперпараметра базовой частоты RoPE до 500 тысяч. Такой подход позволяет модели эффективно решать задачи, связанные с большими объёмами текстов. Модель также использует словарь на 128 тысяч токенов.

Разработчики внедрили четырёхмерный параллелизм (4D Parallelism), который включает тензорный, пайплайновый, контекстный и параллелизм данных. Этот подход позволяет значительно улучшить утилизацию ресурсов при обучении на тысячах GPU. Например, для обучения модели с 405 миллиардами параметров использовалось до 16 тысяч GPU, а средняя утилизация вычислительных ресурсов составила около 41%​.

Контекстный параллелизм позволяет разбивать длинные строки на части. В отличие от классических методов, такой параллелизм синхронизирует только ключи и значения в attention-слое, что минимизирует задержки при обработке длинных последовательностей.

Помимо этого, в архитектуре LLaMA 3.1 активно используется FP8-квантизация, которая значительно ускоряет вычисления без значительных потерь в точности. Это позволяет экономить до 50% времени на вычисления по сравнению с традиционными методами, что критично для моделей с миллиардами параметров. FP8-квантизация используется не для всех слоев, потому что она может вызвать ошибки при вычислении в attention-слоях. Подход доказал свою эффективность при решении большинства задач​.

Разбор подготовил ❣ Михаил Хрущев

Душный NLP
5 577 просмотров · 81 реакций Открыть в Telegram · Открыть пост на сайте
О претрейн-датасете LLaMA 3.1

Сегодня расскажем о том, как устроен претрейн-датасет для LLaMA 3.1. Разработчики этой LLM поделились множеством подробностей, поэтому будет интересно.

Одна из важнейших характеристик LLaMA 3.1 — объём данных, на которых она обучалась. Для этой модели использовался претрейн-датасет из 15 триллионов токенов. Это один из самых больших наборов данных для языковых моделей, превосходящий, например, LLaMA 2 с её 2 триллионами токенов. Модель также включает специальный набор данных для длинных контекстов.

Сбор данных для LLaMA 3.1 построен на стандартном пайплайне для обработки текста из HTML. Один из его ключевых аспектов — это фильтрация данных на ранних стадиях. Она включает как дедупликацию данных, так и использование эвристических методов для удаления нежелательных токенов.

Кроме того, команда разработчиков использовала кастомные парсеры для специфических доменов, таких как математика и программирование. Это позволило улучшить качество обработки данных для узкоспециализированных задач. Кастомный парсер способен сохранить точное форматирование математических формул, тогда как обычные парсеры теряют важную информацию.

LLaMA 3.1 демонстрирует хорошие результаты благодаря специальным пайплайнам для математических задач и задач, связанных с программированием. Объем данных по коду и математике в датасете LLaMA 3.1 превосходит весь датасет оригинальной LLaMA.

Для оценки качества данных использовались различные классификаторы, полученные дистилляцией LLaMA 2. Другие классификаторы отбирали документы, опираясь на вероятность их принадлежности к определённому домену. Один из интересных моментов — использование классификаторов для оценки доменов с целью дальнейшего перевзвешивания различных частей датасета. Например, данные из области искусства и развлечений могут быть уменьшены в весе по сравнению с математикой.

Фильтрация включает несколько уровней дедупликации. Во-первых, стандартная дедупликация с использованием метода MinHash. Есть также локальная дедупликация — метод, при котором данные разбиваются на блоки, и дубликаты удаляются только внутри этих блоков.

Ещё одной важной частью фильтрации данных стала проверка на безопасность. Разработчики LLaMA 3.1 реализовали специальные фильтры для удаления вредоносного или небезопасного контента. Эти фильтры основаны на классификаторах и могут удалять не только нежелательные токены, но и данные с персональной информацией.

LLaMA 3.1 также выделяется своими экспериментами в области Data Mixer — процесса, в котором данные разделяются по доменам, а затем перевзвешиваются для оптимальной работы модели.

Важным этапом оптимизации стал так называемое «сведение». Это метод, при котором на последних этапах обучения модель дообучается на малом наборе данных, включающем специфичные задачи. Это позволяет значительно повысить качество ответов модели на конечных тестах. В ходе экспериментов установили, что даже небольшой объём высококачественных данных может существенно улучшить результаты.

Разбор подготовил ❣ Дмитрий Мокеев

Душный NLP
6 179 просмотров · 63 реакций Открыть в Telegram · Открыть пост на сайте
ReMax как альтернатива PPO

Сегодняшняя статья — об интересном методе обучения с подкреплением, который называется ReMax. Авторы предлагают его как замену популярному алгоритму Proximal Policy Optimization (PPO).

ReMax основывается на алгоритме обучения с подкреплением, который называется REINFORCE — отсюда и приставка Re. В REINFORCE, в отличие от PPO, нет value-модели. Она выступает в роли бейзлайна для снижения дисперсии оценки градиента и представляет собой среднюю награду, которую наберёт генератор, если будет отвечать на конкретный запрос.

Вместо отдельной value-модели в ReMax предлагают использовать другой бейзлайн — то, сколько награды набирает greedy-генерация обучаемой моделью на запросе. Отсюда окончание Max. Такой бейзлайн тоже отлично подходит с точки зрения теории, и не требует хранения дополнительной модели в памяти — авторы сообщают, что снижение потребления GPU-памяти составляет 46%. А поскольку число моделей, необходимых алгоритму алайнмента, уменьшилось, то уменьшилось и число гиперпараметров, которые нужно подобрать.

Использование ReMax для обучения модели Mistral-7B показало значительные улучшения. Модель достигла 94,78% успеха на leaderboard AlpacaEval и установила новый стандарт для моделей с 7 миллиардами параметров. Эти результаты демонстрируют, что ReMax может стать отличной альтернативой PPO для RLHF-задач, значительно сокращая вычислительные затраты и повышая эффективность обучения крупных языковых моделей.

Разбор подготовил ❣ Павел Темирчев

Душный NLP
12 848 просмотров · 60 реакций Открыть в Telegram · Открыть пост на сайте
Self-Rewarding Language Models

В сегодняшней статье — концепция Self-Rewarding Language Models. Они не только генерируют ответы, но и оценивают их качество в процессе обучения.

Традиционные подходы к обучению, такие как обучение с подкреплением на основе обратной связи от людей (RLHF), ограничены качеством и объемом человеческих данных. Авторы статьи предлагают модель, которая сама создает инструкции, генерирует ответы и оценивает их качество, используя технику LLM-as-a-Judge.

Обучение проводится через итерации, каждая из которых состоит из следующих этапов:

1. Генерация ответов на основе текущего датасета. На первой итерации — созданного человеком.
2. Оценка ответов — модель сама оценивает качество ответов по определённым критериям, таким как релевантность, полезность, чёткость и уровень экспертизы.
3. Создание самоинструкций для следующего шага — модель создает новые инструкции на основе исходного набора данных.
4. Следующая итерация — дообученные модели используются для последующих итераций обучения. Это ведёт к улучшению качества как генерации ответов, так и их оценки.

В экспериментах использовали Llama 2-70B, обученную на датасете Open Assistant. Модель прошла через три итерации обучения с самосозданными данными.

— Первичная модель, файнтюненная на IFT (Instruction Fine-Tuning) и EFT (Evaluation Fine-Tuning)-данных с помощью SFT, показала результаты, сопоставимые с базовой моделью.
— Вторая итерация, обученная на AIFT (AI Feedback Training) c помощью DPO, выдавала лучший ответ в 55,5% случаев, а в 32,8% — того же качества.
— Третья итерация в 47,7% случаев выдавала лучший ответ, а в 39,8% — того же качества.

Модель, прошедшая три итерации обучения, продемонстрировала улучшения в тестах AlpacaEval 2.0, превзойдя модели Claude 2, Gemini Pro и GPT-4 0613. Модель третьей итерации показала 20,44% выигрышей в тестах, что значительно выше предыдущих итераций (9,94% для первой и 15,38% для второй).

Разбор подготовил ❣ Валентин Шубин

Душный NLP
6 294 просмотров · 53 реакций Открыть в Telegram · Открыть пост на сайте
REST — метод ускорения генерации токенов

Сегодняшняя статья посвящена методу Retrieval-Based Speculative Decoding (REST). По словам авторов, он позволяет ускорить генерацию токенов более чем в два раза. А в основе подхода лежит спекулятивное декодирование. О нём сперва коротко и расскажем.

Спекулятивное декодирование (Speculative Decoding) — это метод, который направлен на ускорение генерации за счёт использования дополнительной, более компактной и быстрой модели. Она предлагает варианты продолжения цепочек токенов, которые затем проверяются основной моделью. Если предсказания обеих моделей совпадают, токены принимаются, в противном случае — отбрасываются.

Однако у этого метода есть ограничения и недостатки. Необходимо найти такую вспомогательную модель, которая обладала бы высокой точностью, но при этом не тратила слишком много вычислительных ресурсов. Кроме того, малые модели требуют дополнительного обучения.

Авторы статьи предлагают использовать вместо меньшей модели базу данных, построенную на суффиксном массиве и включающую корпусы кодов и текстов — например, диалогов UltraChat. Из базы извлекаются:

Контексты (contexts) — последовательности токенов, которые служат отправной точкой для поиска продолжений.
Продолжения (continuations) — следующие за контекстом токены, представляющие возможные варианты развития текста или кода.

Подходящие продолжения организуются в древовидную Trie-структуру, где каждый узел — это токен. Далее выбираются те последовательности токенов, которые повторяются чаще всего. Их называют кандидатами (candidates).

Кандидаты проверяются с помощью маски Tree Attention. Её особенность состоит в том, что всё осуществляется всего за один проход трансформера. Оптимизация достигается за счёт того, что у многих продолжений одинаковые префиксы.

Модель принимает все токены, которые успешно прошли проверку с самого начала, а то, что следует за первой ошибкой — отбрасывает. После этого процесс начинается снова для оставшихся токенов.

Результаты тестов на CodeLlama и Vicuna показали прирост в скорости генерации токенов с использованием REST в 1,62–2,36 раза. Однако методу ещё есть, куда развиваться. Так, авторы отмечают, что результат сильно зависит от полноты и качества базы данных, и рекомендуют собирать её, используя LLM. Кроме того, возникают трудности с пониманием контекста — например, при генерации персонализированных названий переменных в программировании.

Рассказывайте в комментариях, а что вы думаете о REST?

Разбор подготовил ❣ Дмитрий Васильев

Душный NLP
5 637 просмотров · 52 реакций Открыть в Telegram · Открыть пост на сайте
Branch-Train-MiX — метод создания MoE-моделей

Сегодня рассмотрим статью, в которой предложен метод получения MoE-модели (Mixture-of-Experts) из обычной, dense-модели. Авторы назвали его Branch-Train-MiX (BTX).

Для начала напомним, что такое MoE. Это архитектурный подход, который предполагает использование в трансформенных слоях нескольких FNN-блоков — экспертов. У каждого из них предположительно есть собственная узкая специализация, поэтому над решением поставленной модели задачи они работают не одновременно. Роутер выбирает, какие эксперты лучше подходят для обработки токенов на каждом конкретном этапе.

Во время инференса модели, построенные на архитектуре MoE, задействуют меньше параметров, чем их dense-аналоги — и без сильной потери качества. Кроме того, они прекрасно масштабируются. Поэтому понятно стремление превратить обычную модель в MoE.

В основе идеи авторов лежит метод BTM (Branch-Train-Merge). Суть его заключается в том, чтобы взять несколько одинаковых LLM, параллельно обучить их на разных датасетах, а затем агрегировать предсказания каждой модели во время инференса.

Рассматриваемая статья предлагает после обучения слить все модели в MoE, чтобы FNN каждой базовой модели стал экспертом в соответствующем слое, и добавить роутер. Веса аттеншена при этом следует усреднить и дообучить.

Авторы взяли три копии Llama-2 7B и дообучили каждую на своём домене: математика (на тех же данных, что и Llemma), программирование (на тех же данных, что CodeLlama) и общие знания (на «Википедии»). К финальной модели добавили оригинальную Llama-2 7B, не дообученную на чём-то конкретном. Получившуюся MoE-модель файнтюнили на источниках, которые применялись для обучения всех четырёх экспертов. В результате модель не сильно уступает тем же Llemma и CodeLlama в вопросах математики и программирования.

Интересно и то, что BTX-модели обретают интерпретируемость. Авторы показывают, что в эксперта, обученного на определённом домене, попадают токены из сэмпла этого же домена.

Рассказывайте в комментариях, что думаете про BTX!

Разбор подготовил ❣ Александр Пацация

Душный NLP
5 291 просмотров · 42 реакций Открыть в Telegram · Открыть пост на сайте
ICML 2024 — ещё интересные статьи

Соскучились? Специально для Душного NLP Роман Горб из команды ускорения инференса YandexGPT поделился релевантными его рабочей области статьями с ICML 2024.

Towards Efficient Generative Large Language Model Serving

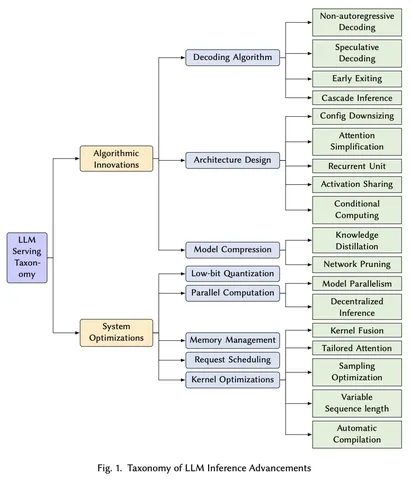
Отлично структурированная статья и рассказ об LLM Serving — о челленджах, их причинах и решениях. Сначала описывается генеративный сценарий и его природа. Авторы отмечают, что корпорации вкладываются в LLM, размеры моделей растут и появляются новые семейства. Но есть и платформы, на которых модели хочется деплоить, что требует инженерных усилий. Где-то между находится LLM Serving. Задача области — поиск компромисса между качеством и скоростью (compute budget), о чём и рассказывает статья.

На первой картинке — 2 подкласса методов: алгоритмические и системные. С подробностями предлагаю ознакомиться самостоятельно, но выделю часть из них.

Speculative Decoding

Базово для этого метода нужны 2 модели: draft и verifier. Первая быстро и дёшево генерирует гипотезы; вторая — выбирает из них валидное продолжение так, чтобы генерация происходила из распределения verifier-модели. Чем больше токенов «угадывает» draft-модель, тем выше ускорение. В продвинутых версиях растёт утилизация ресурсов GPU.

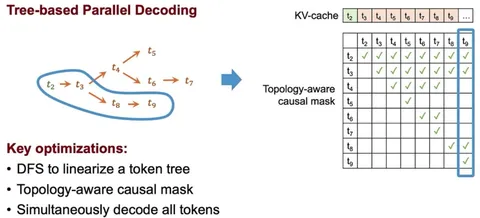
Свежие работы (EAGLE и MEDUSA) предлагают уменьшить draft-модель для большего ускорения при сохранении качества. Авторы дообучают небольшие головы поверх verifier-модели, что снижает оверхэд и ускоряет процесс даже в сложных сценариях с высоким throughput токенов. Draft-головы генерируют гипотезы в виде дерева, а не списка (см. картинку 2), что повышает точность принятия токенов.

Архитектурная Оптимизация

В MobileLLM и Rethinking Optimization and Architecture for Tiny Language Models исследуют вопрос оптимальной архитектуры моделей до 1B для мобильных устройств. Авторы за тот же compute получили значительные + 4 пп качества на бенчмарках с помощью SwiGLU-активаций, глубоких, а не широких сети, shared-эмбеддингов, Grouped Query Attention, init из весов более крупных моделей и прунинга.

Душный NLP
12 406 просмотров · 39 реакций Открыть в Telegram · Открыть пост на сайте
Впечатления от ICML 2024 и несколько интересных статей

Отгремела конференция ICML, но делиться впечатлениями от мероприятия никогда не поздно. Руководитель команды YandexGPT Alignment Андрей Бут рассказал нашему каналу, чем ему запомнилось событие и на какие статьи стоит обратить внимание.

Первое и главное впечатление — LLM добрались и до ICML. Им была посвящена примерно треть работ. Ну что же, о времена, о нравы.

С другой стороны, большой плюс конференции в том, что организаторы смогли поддержать разнообразие работ по всем темам. Можно было найти и «хардкорную математику» и обзорные position-статьи. Приятно порадовали работы по RL — причём за счёт того, что работы по RLHF были вперемешку со «взрослым RL», можно было оценить применимость к области LLM.

Несмотря на рост числа работ, по-прежнему остаётся опция пообщаться за постером (привет, NeurIPS). Хотя охватить все интересные статьи — скорее невозможная задача.


Интересные статьи

A Closer Look at the Limitations of Instruction Tuning

В этой работе авторы задаются вопросом: какие есть минусы у Supervised Finetuning (SFT) и может ли обучение с LoRA побороть их? Исследователи опираются на тот факт, что при SFT модель чаще галлюцинирует и подстраивается под SFT-датасет. Проводятся различные эксперименты, чтобы доказать эту гипотезу. В статье показано, что LoRA выдаёт лучший результат на нескольких общепризнанных датасетах — например, SFT-Alpaca-52k, SFT-Wizard-LM и других.

Self-Rewarding Language Models

В этой работе исследователи задаются вопросом: можно ли отказаться от дорогой preference-разметки? Авторы предлагают подход, в котором исходная модель используется для генерации новых инструкций и ответов, а также для их оценки! За три итерации такой метод выдаёт сильные результаты, превосходящие Claude 2, Gemini Pro и GPT-4 0613.

Is DPO Superior to PPO for LLM Alignment? A Comprehensive Study

Авторы этой публикации рассматривают преимущества двух популярных алгоритмов для RLHF: DPO и PPO. В работе есть как интересные теоретические находки (область решений PPO строго вложена в область решений DPO), так и практические советы о том, как добиться лучших результатов для каждого из подходов. Своими замерами авторы демонстрируют, что при правильном «приготовлении» PPO превосходит DPO.

Душный NLP
6 163 просмотров · 52 реакций Открыть в Telegram · Открыть пост на сайте
Масштабирование и параметризация

Сохранение стабильности гиперпараметров при масштабировании модели позволяет подбирать гиперпараметры вроде LR или масштаба инициализации на маленьких моделях, не тратя ресурсы на дорогое обучение больших моделей. Это важная задача, решению которой посвящены две сегодняшних публикации.

Авторы статьи Tensor Programs V предлагают использовать Maximal Update Parametrization (µP) — перенос параметров с маленькой модели на большую без дополнительной настройки.

Традиционные методы параметризации приводят к изменению оптимальных гиперпараметров при увеличении масштаба сетей. Впрочем, существуют способы избежать этого.

Чтобы достичь стабильности гиперпараметров, нужно правильно масштабировать спектральную норму матриц весов — показатель максимально возможного растяжения или сжатия вектора при его умножении на матрицу. Авторы статьи отмечают, что добиться стабильности можно двумя способами: правильным масштабированием инициализаций и послойных LR, либо напрямую спектральной нормализацией матриц весов и их обновлений в процессе обучения.

Благодаря такому решению масштаб признаков и их изменений на каждом шаге сохраняется при увеличении размера сети — этого оказывается достаточно для стабильности гиперпараметров. В статье A Spectral Condition for Feature Learning предполагается, что обновления весов в градиентном спуске имеют низкий ранг и хорошо согласуются с векторами активаций. Однако предположение о такой согласованности на самом деле выполняется не всегда, поэтому в более свежей статье Scaling Exponents Across Parameterizations and Optimizers авторы предлагают дальнейшее улучшение метода с поправкой на это.

Расскажите в комментариях, что думаете по поводу этих методов!

Разбор подготовил ❣ Дмитрий Лунин

Душный NLP
14 875 просмотров · 31 реакций Открыть в Telegram · Открыть пост на сайте
DeepSeek-V2 — MoE-модель с технологией MLA

Компания DeepSeek представила MoE-модель DeepSeek-V2 на 236 миллиардов параметров. Сегодня мы разберём статью, которая рассказывает об особенностях этой модели.

Модель состоит из 236 миллиардов параметров, однако на каждый токен активно используется лишь 27 миллиардов. Это позволило значительно увеличить длину контекста до 128 тысяч токенов.

Для сравнения и оценки результатов в DeepSeek использовали dense-модель на 67b. Авторы смогли существенно снизить стоимость обучения и уменьшить размер KV-кэша, что позволило увеличить скорость генерации токенов почти в 8 раз. Эти достижения обеспечили модели преимущество в производительности.

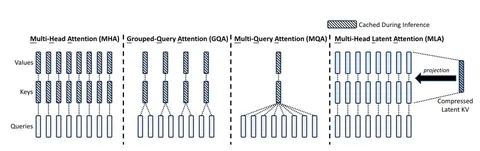
В DeepSeek-V2 внедрён модифицированный attention, который получил название MLA (Multi-Head Latent Attention). Этот механизм позволяет кэшировать уменьшенный вектор с последующим его восстановлением, что значительно снижает объём ресурсов, необходимый для работы модели. Как устроен MLA в сравнении с MHA, GQA и MQA, вы можете увидеть на изображении выше.

При таком подходе нельзя напрямую использовать RoPE (Rotary Position Embedding) — в противном случае матрица RoPE становится неразделимой с остальными операциями, что значительно снижает эффективность вывода. В DeepSeek предложили стратегию так называемого «развязанного RoPE» (decoupled RoPE), в которой дополнительные ключи несут позиционную информацию.

Модель показала хорошие результаты в бенчмарках. В MMLU она добилась показателя в 78,3%, а в тестах на китайском языке, таких как CLUEWSC, C-Eval и CMMLU, DeepSeek-V2 показала лучшие результаты среди всех открытых моделей.

Разбор подготовил ❣ Сергей Горбунов

Душный NLP
7 614 просмотров · 53 реакций Открыть в Telegram · Открыть пост на сайте
Как устроена Nemotron-4 340b

Компания NVIDIA выпустила одну из самых крупных и качественных open source моделей — Nemotron-4 340B. Сегодня разберём сразу две статьи, в которых рассказывается об её устройстве.

На этапе претрейна NVIDIA использовала классические эвристики для дедупликации и отбора лучших текстов, что позволило создать качественный корпус данных. Основная его часть составлена из источников на английском, однако есть тексты и на других языках.

Вопреки современным трендам, NVIDIA использовала функцию активации squared ReLU, но при этом отказалась от гейта. Параметризация layer-norm также нестандартна: вместо инициализации единицами применяется инициализация нулями с добавлением единицы на каждом форварде.

В датасетах alignment NVIDIA использовала небольшое количество человеческой разметки. Датасет обучения reward-модели включает в себя всего лишь 10 тысяч пар ответов, размеченных по пяти параметрам: от общей пользы до связности и сложности.

SFT также включал лишь 10 тысяч написанных человеком примеров. При этом суммарно в SFT-датасетах вышло порядка миллиона примеров, из которых почти все были сгенерированы. Интересно, что сгенерированы были и сами промты — для этого NVIDIA использовала Mixtral 8x7B.

По итогу получилось два SFT-датасета и два раунда обучения. Сперва модель обучали Code SFT на 800 тысячах примеров. А затем ту же модель — дообучали General SFT ещё на 200 тысячах примеров.

Далее следовал один раунд DPO и три раунда собственного метода NVIDIA — RPO (Reward-aware Preference Optimization). Для обучения стандартного DPO используется только порядок внутри пары: оптимальная политика максимизирует расстояние между наградой за выбранный и отклонённый ответ. Такой подход может приводить к переобучению, поэтому в RPO авторы предложили аппроксимировать саму разницу между наградами, которые считают Reward-моделью.

После всех этапов обучения и тестирования модель Nemotron показала хорошие результаты на бенчмарках вроде MMLU. Интересно, что модель почти не росла после раунда DPO, но последующие RPO способствовали улучшению.

Nematron опережает большинство других open source-решений и тягается почти на равных с закрытыми. Скажем, в Arena Hard модель NVIDIA показала результат 54,2, что выше чем у Claude 3 Sonnet (46,8) и Qwen2 72b (48,1).

В сравнении, проведённом людьми, у Nemotron практически паритет c GPT-4 по всем задачам, исключая переписывание текста. Здесь модель NVIDIA справлялась лишь в 3,03% случаев. Однако стоит учитывать, что «живые» замеры проводилось на небольшом количестве примеров — их было всего 136.

Рассказывайте в комментариях, что думаете о Nemotron-4?

Разбор подготовил ❣ Руслан Васильев

Душный NLP
6 313 просмотров · 44 реакций Открыть в Telegram · Открыть пост на сайте
Mixture-of-Agents — простой способ улучшения ответов LLM

Сегодня рассмотрим статью, которая описывает метод улучшения результатов LLM на разных бенчмарках без дообучения. Он называется Mixture-of-Agents (MoA).

Суть метода заключается в использовании нескольких LLM для генерации ответов. Авторы статьи создали многослойную структуру с несколькими агентами — собственно, моделями — на каждом слое. На вход подавали один вопрос. Каждый из агентов давал ответ. Затем полученные данные агрегировались и вместе с промптом передавались на следующий слой, где процесс запускался заново.

В итоге получался ответ, который превосходит по качеству все предыдущие. Интересно то, что модели показывают лучшие результаты, когда имеют доступ к выходным данным других LLM — даже если ответы последних не слишком качественные. Этот феномен авторы назвали «коллаборативностью LLM» (Сollaborativeness of LLMs).

Эксперименты показали, что использование разных LLM на разных слоях улучшает результаты. Агрегаторы тоже играют важную роль — если пропоузеры могут быть относительно простыми и легкими, то агрегаторы требуют значительных вычислительных ресурсов.

Бенчмарки подтвердили, что MoA — эффективный метод. Скажем, на AlpacaEval 2.0 и MT-Bench применение такой архитектуры дало прирост производительности до 8% по сравнению с GPT-4 Omni.

Впрочем, MoA есть куда расти. Например, в области уменьшения времени до первого токена. Из-за итеративной агрегации конечному пользователю приходится долго ждать ответа на вопрос. Авторы статьи намерены бороться с этим недостатком.

Рассказывайте в комментариях, что думаете о MoA?

Разбор подготовил ❣ Никита Шевченко

Душный NLP
10 457 просмотров · 85 реакций Открыть в Telegram · Открыть пост на сайте
Mamba и трансформеры

SSM вроде Mamba — неплохая альтернатива трансформерам, но с ними всё не так просто. Сегодняшняя статья об этом.

Трансформеры, такие как BERT и GPT, показывают отличные результаты в NLP-задачах, но испытывают сложности при работе с большими контекстами —при увеличении длины входного текста качество начинает деградировать. Причина в росте вычислительных затрат и сложности поддержания высоких скоростей обучения и инференса.

Решают проблему разными оптимизациями: линейными аттеншн-механизмами, структурированными масками токенов. Однако у этих способов есть ограничения. Более удачная альтернатива — Mamba и Mamba 2. О ней мы уже писали в этом посте.

Mamba и Mamba 2 используют иной подход к обработке длинных текстов, основываясь на структурированных состояниях. В отличие от трансформеров, они не требуют обработки всех токенов одновременно.

Авторы статьи сравнили Mamba, Mamba 2 и классический трансформер на нескольких задачах. В некоторых результаты Mamba были сопоставимы с результатами трансформеров, но Mamba тоже испытывает трудности при работе с большими контекстами.

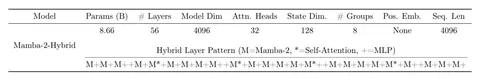
Для решения проблемы авторы предложили гибридную модель — смесь Mamba 2, селф-атеншн и MLP-слоёв. У первой модели было 130М параметров с 24 слоями. Доля селф-аттеншн и MLP среди них менялась. Наименьшей потери валидации удалось достичь при 8% селф-аттеншн слоёв. Эти данные подтвердили эксперименты и с моделью на 840М параметров. При этом доля MLP достигала около 50%, что позволило ускорить инференс на 20%.

Авторы натренировали 8B-модель Mamba-2-Hybrid. Она сравнялась по качеству с трансформерами. Благодаря замене слоёв аттеншена SSM-слоями в теории можно добиться ускорения x7. Также есть гипотеза, что уменьшение кэша key-value позволит модели использовать более крупные батчи, чем трансформерам, и ещё сильнее ускорить инференс.

Как вам такой подход? Делитесь впечатлениями в комментариях!

Разбор подготовил ❣ Никита Шаповалов

Душный NLP
6 062 просмотров · 58 реакций Открыть в Telegram · Открыть пост на сайте
О файнтюнинге после квантизации

Сжатие языковых моделей трансформеров, таких как LLaMA, OPT и GPT — важно для повышения их эффективности и скорости работы. Этому аспекту посвящена статья, которую мы сегодня разберём. Результаты в этой публикации оказались лучше, чем в январской статье Extreme Compression of Large Language Models via Additive Quantization благодаря улучшению шага файнтюнинга после основной квантизации.

Наиболее популярный и эффективный метод сжатия — квантизация. Это уменьшение количества бит, используемых для представления весов модели, что позволяет снизить размер LLM и ускорить её работу. При этом важно поддерживать баланс между степенью сжатия и качеством, поскольку экстремальное сжатие (например, до двух или одного бита) может значительно ухудшить качество.

Квантизация без файнтюнинга часто приводит к снижению качества. Поэтому после квантизации модель следует дообучать для приближения к результатам неквантизованной модели. Это особенно важно при экстремальных уровнях сжатия — до одного или полутора бит.

Популярная техника файнюнинга квантизированных весов — straight-through estimation. Однако в её рамках улучшение может идти непредсказуемо плохими градиентами.

Авторы статьи предлагают другой способ. Достаточно обновлять лишь небольшую долю весов в рамках одного шага — те, у которых самый большой градиент. Эти весы нужно обучить, а остальные — «заморозить». Затем следует пройтись большими шагами между «выжившими» весами. Таким образом, обновятся все или почти все веса.

Этот метод позволяет достичь оптимума по Парето, например, для моделей семейства LLaMA-2 при 2 битах. А для моделей сжатых до 1-1,5 бита на параметр результаты оказались лучше чем у аналогов.

Рассказывайте в комментариях, что вы думаете об этом методе и делитесь опытом!

Разбор подготовил ❣ Владимир Малиновский

Душный NLP
6 384 просмотров · 73 реакций Открыть в Telegram · Открыть пост на сайте