Технический отчёт Command A

Компания Cohere выпустила технический отчёт своей опенсорс-модели Command A. Рассказываем главное, что мы из него узнали.

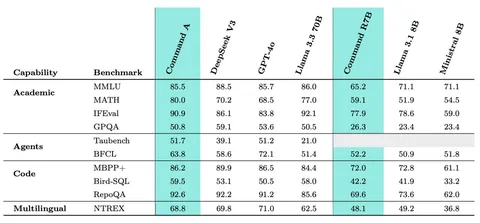
Command A — это dense-модель на 111 миллиардов параметров. Всего она поддерживает 23 языка, а на английском по качеству не уступает DeepSeek-V3. Создатели заявляют, что скорость инференса — до 156 токенов в секунду на всего одной H100 (вероятно, с квантизацией модели в тип пониженной точности). Это в 1,75 раза выше, чем у GPT-4o и в 2,4 раза выше, чем у DeepSeek-V3.

В архитектуре модели, помимо GQA и SwiGLU, применяли чередующиеся аттеншен-слои (Interleaved attention layers). Чередовали три блока со скользящим окном и RoPE и один фулл-аттеншен-блок без позиционных эмбеддингов (NoPE). Благодаря этому аттеншен становится быстрее и, вероятно, лучше работает с длинным контекстом. Похожая архитектура применяется в Llama 4.

Авторы использовали µP и µTransfer для настройки гиперпараметров — параметры подбирались на маленьких моделях, а затем без дополнительного обучения (zero-shot) переносились в большую. Также прибегали к Data Parallel, Fully Sharded Data Parallel, Sequence Parallel и Tensor Parallel.

Веса модели перед вычислениями преобразовывали в FP8. Чувствительные операции, такие как экспоненты, софтмакс, нормализация слоёв и выходные эмбеддинги, оставляли в FP32, а вычисления аттеншена выполняли в BF16. При обучении полностью в FP8 авторы не замечали нестабильности, но обнаруживали деградацию на бенчмарках. Чтобы справиться с ней, первые шаги обучали в BF16, а уже после этого переходили на FP8.

Обучение происходило с постепенным расширением контекста: первые 30 тысяч шагов с контекстным окном 8 тысяч токенов, далее — 32 тысячи токенов, потом — 128 тысяч и 256 тысяч. Многие данные для длинного контекста были синтетическими.

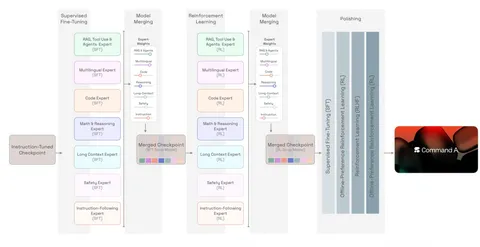
Посттрейн проходил в шесть стадий. На каждой обучали несколько независимых моделей, которые после этого сливались в одну с помощью техники мержинга. Авторы отмечают, что такой подход позволил работать над разными доменами (код, математика, безопасность и так далее) отдельным командам и использовать наиболее подходящий задаче набор RL-алгоритмов, наград и данных.

— Instruct-модель. Обучали начальную Instruct-модель с помощью supervised learning на основе базовой модели.
— SFT-экспертные модели. Обучали шесть SFT-экспертов (для кода, математики, длинного контекста и так далее) поверх чекпойнта Instruct-модели с использованием специализированных наборов данных, чтобы максимально повысить производительность в конкретных задачах.
— SFT Soup-модель. Объединяли шесть экспертных моделей в одну soup-модель, чтобы получить единую агрегированную SFT-модель.
— RL-экспертные модели. Обучали шесть RL-экспертов поверх чекпойнта SFT soup-модели.
— RL Soup-модель. Объединяли шесть RL-экспертов в RL soup-модель, чтобы получить единую агрегированную RL-модель.
— Polished-модель. Чередовали методы best-of-N, оффлайн- и онлайн-RL-алгоритмы.

Разбор подготовил ❣ Владислав Савинов

Душный NLP
4 153 просмотров · 43 реакций Открыть в Telegram · Открыть пост на сайте
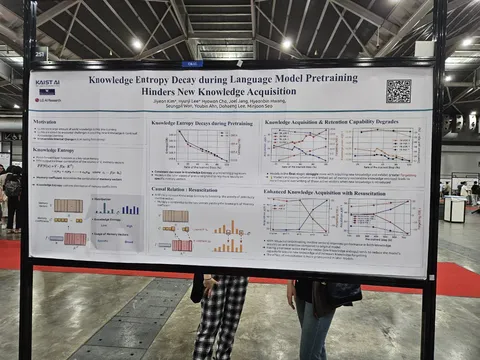
Соскучились по постерам с ICLR? Их есть у нас!

Свежая подборка интересных статей, чтобы скрасить вечер понедельника.

Knowledge Entropy Decay during Language Model Pretraining Hinders New Knowledge Acquisition

Интересная статья о забывании фактов. Известно, что факты хранятся в FF, но авторы посмотрели на динамику распределения весов в виде векторов, чтобы понять, почему плохо усваиваются знания после самого претрейна. Оказывается, всё распределение лежит в маленьком проценте векторов, и они сильно портятся от дообучения.

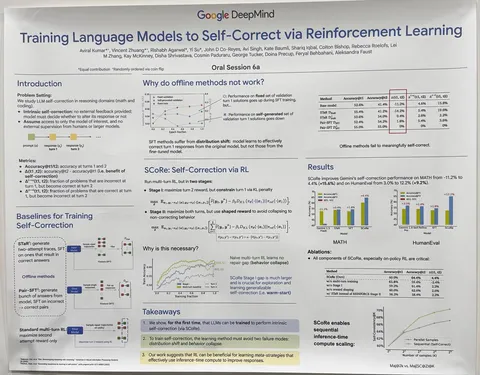
Training Language Models to Self-Correct via Reinforcement Learning

Вместо промптинга, файнтюнинга и использования отдельной модели авторы пытаются встроить self-correction в модель. Существующие решения либо требуют отдельных моделей для верификации, либо используют более крупные модели-учителя, либо страдают от проблем «смещения распределения» (модель исправляет чужие ошибки, но не свои) и «схлопывание поведения» (модель делает одинаковые попытки без реальной коррекции).

Авторы предлагают двустадийное решение задачи, где вторая попытка пытается исправлять ошибки первой.

Детали успеха:

— на первом этапе создается хорошая инициализация для RL c принуждением первой попытки быть близкой к базовой модели (KL-регуляризация);

— on-policy RL;

— модифицированный реворд, сравнивающий прогресс между попытками.

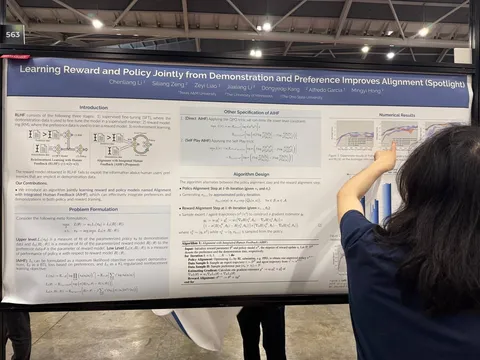
Learning Reward and Policy Jointly from Demonstration and Preference Improves Alignment

Статья о совместном обученим RL+SFT+RM. Всё в онлайне. Реворд учится не только преференсам, но ещё и поощрять экспертные демонстрации из SFT-датасета.
Лоссы довольно понятным образом можно вывести

В цикле:

— шаг обучения RM;
— несколько шагов PPO.

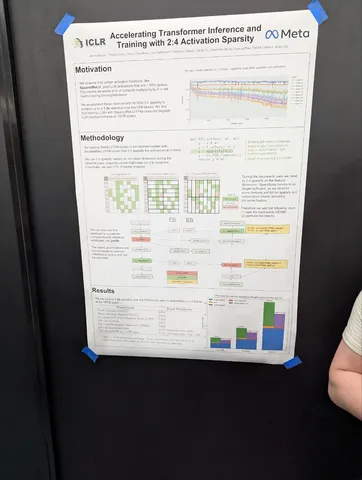
Accelerating Transformer Inference and Training with 2:4 Activation Sparsity

Авторы придумали как использовать sparse kernel в тренировке. Заменяют SwiGLU на Squared ReLU (утверждается, что без потери качества), и замечают, что после этого во втором матричном умножении появляется много нулей в активациях. Используют 2:4 sparse kernels для того, чтобы ускорить это умножение (зануляя активации, которые ломают 2:4 картинку).

На backward из-за того, что матрица транспонируется, приходится использовать пару трюков:

— разбивать матрицу на две части — «очень плотные строки (5%)» и «разреженные строки (95%)» — и делать два отдельных гемма;
— чтобы бороться с явлением «соседние токены часто либо одновременно нули, либо одновременно не нули» шафлят токены перед FFN, а потом шалят обратно;
— используют row-wise-квантизацию;
— получают x1.3 ускорение на FFN-блоках.

В статье почему-то описывают только 1.5B-перплексию, но говорят, что на 7B и downstream-задачах вроде тоже работает неплохо.

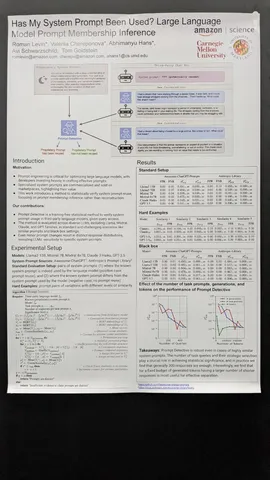
Has My System Prompt Been Used? Large Language Model Prompt Membership Inference

Инженеры Amazon предлагают довольно простую процедуру расчёта стат.теста для проверки, использует ли LLM новые вводные из системного промпта. Тест основывается на средних значениях бертовых эмбеддингов того текста, который сгенерировала LLM. По словам авторов, для статистической значимости даже на незначительных изменениях достаточно прогнать около 300 примеров для каждого промпта.

*Компания Meta признана экстремистской организацией в России.

Интересные постеры увидели
❣ Екатерина Редина, Константин Бабалян, Павел Темирчев, Степан Каргальцев, Кирилл Никоров

#YaICLR

Душный NLP
3 424 просмотров · 20 реакций Открыть в Telegram · Открыть пост на сайте
Что мы делали в тени на ICLR 2025

Конференция завершается. Почти все доклады прочитаны, почти все постеры отсмотрены, а участники и гости скоро вернутся домой. Домой вернётся и команда ML-инженеров Яндекса, которая последние дни рассказывала — и показывала, — что происходит на ICLR. Осталось совсем чуть-чуть, и самое время подвести итоги, собрав все наши материалы с мероприятия в одном посте.

— Первый день запомнился большой очередью на регистрацию, а также любопытными постерами о борьбе с эффектом «прайминга» и методе обучения реворд-модели.
— Второй день, в числе прочего, подарил нам статьи о системных промптах и подробный теоретический анализ SFT и DPO.
— Третий день принёс статьи о Q-Learning и добавке к софтмаксу.

И пусть конференция заканчивается, мы продолжаем работу. Впереди — разборы самых ярких статей и впечатления из первых уст. Оставайтесь с нами! А если вы хотите больше узнать о том, что происходило на ICLR 2025, подписывайтесь на наши каналы-побратимы (все об ML):

— ML Underhood
— Speech Info
— Рекомендательная
— CV Time

#YaICLR

Душный NLP
3 399 просмотров · 29 реакций Открыть в Telegram · Открыть пост на сайте
Свежая подборка постеров с ICLR 2025

Продолжаем рассказывать о самых ярких постерах конференции, которые сумели заметить.

Selective Attention Improves Transformer

Инженеры из Google придумали дешёвую добавку к софтмаксу в аттеншене, которая позволяет трансформеру легче забывать токены. Это стабильно улучшает итоговое качество, как перплексию, так и downstream tasks. Проверяли на размерах модели до 1В и контекстах до 2К. Прирост в качестве как будто бы не снижается с увеличением размера модели и контекста.

Говорят, что, поскольку модель теперь нативно выучивает более sparse-аттеншн, то можно выкидывать токены из kv-кэша по некоторому трешхолду, уменьшая потребление памяти или ускоряя инференс. Например, можно получить такую же перплексию, как у бейзлайна, но при kv-cache в восемь раз меньше. А если ещё и немного поменять лосс, чтобы заставить модель более активно выкидывать токены, то kv-cache можно сократить в 47 раз.

Scaling FP8 training to trillion-token LLMs

Тренируют Llama 7B в FP8 (матричные умножения, и форвард, и бэквард). После 200B токенов видят расхождение, которого прежде нет, и утверждают, что это из-за того, что ветки SwiGLU становятся скоррелированными, и появляются outlier при их перемножении

Чтобы решить эту проблему, предлагают дополнительно скейлить одну из веток (а после третьего линейного слоя возвращать обратно). Это стабилизирует обучение с минимальными потерями в скорости. Из дополнительных трюков — квантизируют моменты адама в FP8 (e4m3 для первого и e5m2 для второго), чтобы сэкономить память.

На маленьких моделях такого не наблюдали, но там использовали обычный GPT, без SwiGLU. Сейчас авторы экспериментируют с nvfp4/mxfp4, говорят, что там нужен претрейн и посттрейн в BF16 с вормапами.

ReGenesis: LLMs can Grow into Reasoning Generalists via Self-Improvement

Интересная статья о том, как модель сама себе итеративно генерирует цепочку рассуждений — сначала общими словами, потом более конкретно под задачу. Затем на эти финальные цепочки мы делаем SFT. Получается лучше star и с хорошей генерализуемостью.

Q-SFT: Q-Learning for Language Models via Supervised Fine-Tuning

Авторы решают одну проблему алгоритма Q-Learning для языковых моделей — не нужно обучать огромную голову (по q-значению на каждый токен) с нуля. Они берут дебедер и дообучают его на q-значения с помощью кросс-энтропийного лосса. Есть предположение, что в LLM из-за детерминированных переходов среды это теоретически корректно.

Strong Model Collapse

В статье утверждается, что синтетические данные ломают классические скейлинг лоу. Причём ломает уже сильно, если доля синтетики просто фиксирована относительно обычных данных в претрейне. Более качественная синтетика просто двигает вправо размер модели и количество данных, на котором произойдёт поломка.

Решение — итеративное обучение, с постепенным снижением доли синтетики в 0. Ну или не использовать её вовсе.

ThinK: Thinner Key Cache by Query-Driven Pruning

В отличие от других статей о сжатии kv-кэша, в этой авторы смотрят не на размерность seq_len, а делают в рантайме уменьшение размерности channel для Q/K-матриц проекций с помощью поиска аутлаеров. В аттеншоне именно такие аутлаеры важны — остальные 40% можно убирать.

Из-за того, что делают динамически для каждого префикса, на prefill, то FTT увеличивается примерно на 10% (реализуется, кстати, относительно просто). Но без потери качества ускоряется декодирование — как по занимаемой памяти, так и по латенси/фрупуту.

Более того, метод хорошо комбинируется с другими методами компрессии кэша по размерности seq_len и даёт ортогональное ускорение в 1,2 раза.

Интересные постеры увидели ❣ Степан Каргальцев, Павел Темирчев, Андрей Акшонов, Николай Скачков, Роман Горб

#YaICLR

Душный NLP
2 586 просмотров · 20 реакций Открыть в Telegram · Открыть пост на сайте
Ещё крутые постеры с ICLR 2025

Продолжаем рассказывать о любопытных постерах проходящей прямо сейчас конференции.

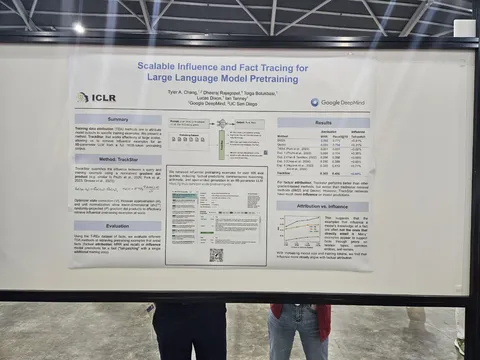
Scalable Influence and Fact Tracing for Large Language Model Pretraining

DeepMind предлагает новый метод дебага того, какие примеры влияют на ответы фактовых вопросов. Говорят, что лучше всех градиентных методов определяют именно влияние документа из трейна на генерацию. Ещё из интересного — показывают график, по которому видно, что модели небольшого размера очень часто опираются не на примеры, содержащие факт, а с ростом капасити разница падает.

Авторы отмечают, что их метод подходит даже для мультихопов и ризонингов, несмотря на один градиентный шаг. Ещё сказали, что общались с группой, которая писала статьи о динамики обучения фактам, и они работают в эту сторону. И добавили, что метод полезен для файнтюнов.

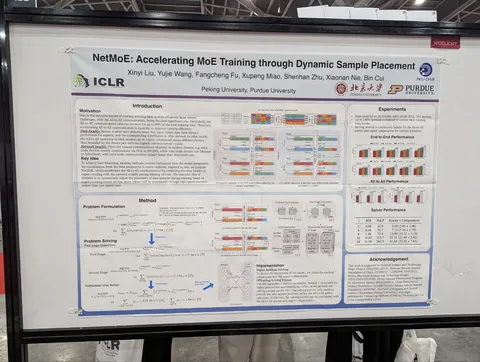
NetMoE: Accelerating MoE Training through Dynamic Sample Placement

Авторы предлагают хитрую оптимизацию тренировки Мixture-of-Agents. Во время dispatch + ffn они решают (с помощью аппроксимации integer linear programming), а не выгоднее ли оставить эксперта там, где он сейчас? Возможно, в этом случае combine будет быстрее, из-за использования не дорогих inter-node-пересылок, а дешёвых intra-node или даже in-device. В результате Получают ускорение в 1.67х для простого all-to-all, но ничего не мешает пробовать это же для более умных пересылок.

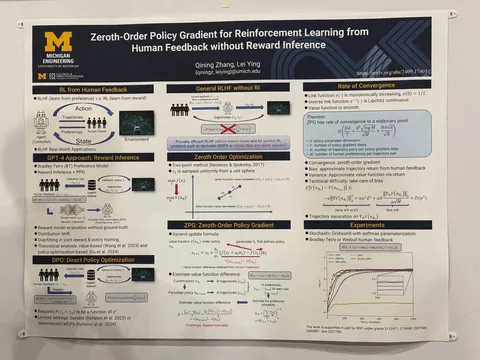
Zeroth-Order Policy Gradient for Reinforcement Learning from Human Feedback without Reward Inference

Авторы делают оптимизацию нулевого порядка для RL. Идейно похоже на evolution strategies, но «под капотом» тут другой оптимизатор. В статье также предлагают отказаться от RM и заменить её на людей или хотя бы на preference model. Мотивация, зачем так делать, осталась непрозрачной. Рискуем предположить, что это будет медленнее градиентных методов.

Learning from negative feedback, or positive feedback or both

Статья от DeepMind, в которой предлагают обучать на
a log(p(positive) - (1-a) log (negative) - b KL(p_ref(negative) || p(negative))

Таким образом, становятся не нужны контрастные пары — достаточно положительных и отрицательных примеров. У авторов результаты получаются сравнимыми с DPO или лучше.

Self-Improving Robust Preference Optimization

Статья от Сohere. Авторы замешали Nash preference learning в алгоритм вроде DPO/IPO. По формулам выглядит так, будто учат две конкурирующие модели: генератор и улучшатор ответов (на вход получает запрос и предыдущий ответ).
Но по факту это одна модель, просто улучшатору дают подводку вида «вот прошлый ответ, попробуй улучшить» Online не пробовали, но рассказали, что можно вытащить реворд из их формул.

Learning Dynamics of LLM Finetuning

Доклад с теоретическим анализом SFT и DPO, который обосновывает галлюцинации в первом и падение победителя во втором. Выводы: просадка победителя может быть связана с тем, что мы пытаемся уменьшать вероятности для проигравшего, когда они уже и так низкие.

Интересные постеры увидели ❣ Екатерина Редина, Степан Каргальцев, Павел Темирчев, Дмитрий Ульянов

#YaICLR

Душный NLP
2 651 просмотров · 25 реакций Открыть в Telegram · Открыть пост на сайте
Постеры второго дня ICLR 2025

Возвращаемся с полей конференции и несем новую порцию постеров.

SPaR: Self-Play with Tree-Search Refinement to Improve Instruction-Following in Large Language Models

Статья о DPO в self-play-цикле. Есть обучаемая на лету llm-as-judge, которая здесь называется Refiner. Модель генерирует ответ на запрос, и если он неправильный, то исправляем его, стараясь сделать наименьшее число изменений. Исправляем с помощью Refiner и поиска по дереву. На таких парах учим DPO.

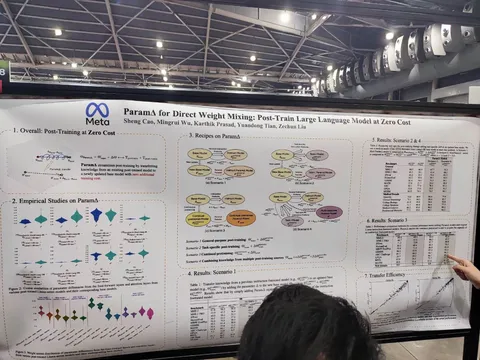
ParamΔ for Direct Mixing: Post-Train Large Language Model At Zero Cost

Авторы предлагают не учить посттрейны, а прибавлять к новому претрейну дельту. Или линейную комбинацию дельт. Получаются смеси доменно адаптированных моделей или просто дешёвый быстрый алайнмент нового претрейна (с несильным ухудшением качества).

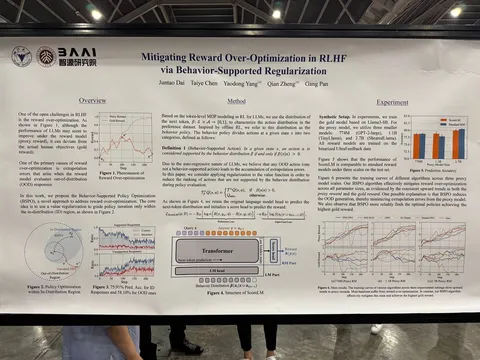
Mitigating Reward Over-Optimization in RLHF via Behavior-Supported Regularization

В статье предлагают приделать к RM авторегрессионную голову и учить её на SFT. Логиты при этом предлагается использовать внутри RL-алгоритма — занижать реворды ответам с низким правдоподобием по мнению этой авторегрессионной головы. Таким образом, реворд не будет расти в OOD для RM-примерах, а мы будем меньше страдать от доменного сдвига.

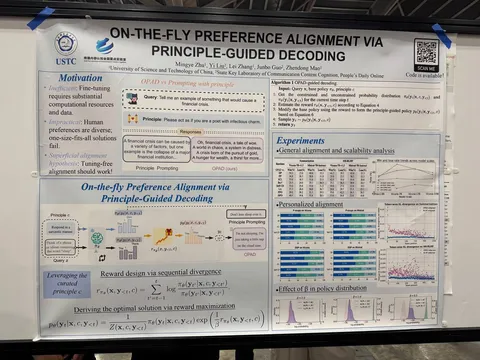
On-the-fly Preference Alignment via Principle-Guided Decoding

Авторы рассказывают, как заставить модель исполнять системный промпт не подкладыванием его в промпт, а с помощью модификации процедуры инференса. Системный промпт здесь называют принципом.

Идея похожа на classier-free guidance:
— считаем вероятности всех токенов на шаге t с системным промптом и без него (два форварда);
— считаем реворд по формуле (логарифм соотношения вероятностей);
— находим оптимальное распределение для такого реворда по аналитической формуле;
— поскольку реворд тут жадный и распределение над токенами (а не над траекториями как в DPO) аналитическое решение явно считается.

На этом всё. Дальше просто семплируем из этого распределения токен для шага t и повторяем. Говорят, это лучше, чем положить системный промпт в подводку.

Интересные постеры увидели ❣ Павел Темирчев и Николай Скачков

#YaICLR

Душный NLP
6 341 просмотров · 21 реакций Открыть в Telegram · Открыть пост на сайте
Интересные постеры первого дня ICLR 2025

Конференция в самом разгаре — доклады и постеры сыпятся на нас как из рога изобилия. А мы выбираем самые любопытные и рассказываем вам.

Earlier Tokens Contribute More: Learning Direct Preference Optimization From Temporal Decay Perspective

Статья посвящена решению проблемы, при которой модель после DPO генерирует ответы длиннее, чем референсная модель. Это связано с тем, DPO отдаёт предпочтение последним токенам, а не первым. Чтобы исправить проблему, авторы предлагают добавить множитель \gamma \in (0, 1) в лосс. Лосс для токена в позиции t умножается на \gamma^t. Аналогия с классическим RL ясна, хотя нужно понимать, что это не discount factor, а просто что-то похожее по смыслу. Такая политика мало отличается от оптимальной, а задача выбора гаммы выпуклая (около 0,99 будет достаточно, но лучше подобрать для каждого случая отдельно).

Progressive Mixed-Precision Decoding for Efficient LLM Inference

Квантизация, отмечают авторы, хороший способ снизить требования LLM к вычислительным мощностям. Однако применение низкой точности (2-3 бита) ведёт к сильному ухудшению качества. Авторы предлагают новый фазо-ориентированный метод, который избирательно распределяет точность между различными фазами инференса и вводят технику, позволяющую постепенно снижать точность по мере углубления в сгенерированную последовательность.

По сути для каждого токена выбирается битность. У авторов есть обучаемый шедулер, который предсказывает, когда надо переключаться на меньшую битность. Он очень чувствителен к гиперпараметрам, датасету и обучению. В будущем его хотят интегрировать внутрь самой LLM. А саму квантизацию наследуют из статьи Any-precision LLM. В ней префикс веса нужной битности — это ключ в lookup-таблице весов, что позволяет не использовать дополнительную память под разные битности.

What is Wrong with Perplexity for Long-context Language Modeling?

Очень простая идея для длинного контекста — считать лосс в основном на key-токенах, где лосс, обусловленный на длинный контекст, сильно отличается от короткого. На long-бенче у авторов получилась значительная корреляция со скором по сравнению с обычной ppl, что немного смущает, и улучшения от такого тюна.

RRM: Robust Reward Model Training Mitigates Reward Hacking

Авторы заявляют, что современные реворд-модели не способны эффективно различать контекстуальные сигналы и нерелевантные артефакты при определении предпочтений. В статье предлагается обучать предпочтения, независимые от подобных артефактов, а также новая техника аугментации данных, специально разработанную для их устранения.

Авторы делают случайную перестановку датасета и расширяют его всеми возможными комбинациями i оригинальной тройки и sigma_i — тройки на позиции i после перестановки. Всего комбинаций 16 штук.

Победитель в полученных парах определяется так:

— если в паре один ответ на этот запрос, а второй от другого запроса, то побеждает всегда тот, который отвечает на «свой» запрос;
— если оба ответа от другого запроса, то это ничья.

Получается огромный датасет, в котором много тривиальных пар, где плохой ответ явно не от того запроса. Авторы фильтруют этот датасет с помощью предыдущей версии RM, оставляя только негативы и неуверенные.

How new data permeates LLM knowledge and how to dilute it

Авторы показывают, что при усвоении новой информации LLM проявляют эффект «прайминга»: изучение нового факта может привести к тому, что модель начнёт некорректно применять это знание в несвязанных контекстах. Чтобы это исправить, предлагают игнорировать самые большие градиенты — то есть не обновлять тот процент весов, который получил бы самый большой градиентный апдейт.

Интересные постеры увидели ❣ Павел Темирчев, Екатерина Редина, Роман Горб, Степан Каргалицев

#YaICLR
5 926 просмотров · 27 реакций Открыть в Telegram · Открыть пост на сайте
Нет, это не футуристическая оранжерея, а аэропорт Чанги в Сингапуре, где завтра стартует конференция ICLR 2025. Наша команда уже на месте и скоро начнёт рассказывать о том, что происходит на мероприятии. Будет интересно и солнечно!
3 111 просмотров · 64 реакций Открыть в Telegram · Открыть пост на сайте
Large Language Diffusion Models. Часть 2/2

Продолжаем разбирать, что внутри у китайской модели LLaDA (начинали вот тут).

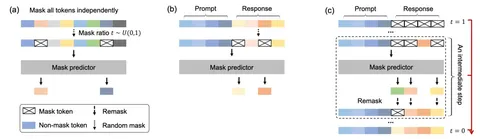
Обучение (иллюстрации (a) и (b))

Диффузия, как известно, учится восстанавливать объекты из шума. И LLaDA — не исключение. Для каждого батча обучения она сперва генерирует долю токенов t (от 0 до 1), которые хотим зашумить. А затем маскирует токены в батче с этой вероятностью.

Далее модель обучается восстанавливать замаскированные токены. Стадия предобучения и SFT отличаются лишь тем, что в SFT зашумляется только ответ, но не запрос. Чтобы модель умела восстанавливать последовательности разной длины, в обучение специально подкладывается 1% текстов с длинами от 1 до 4096 токенов.

Генерация (иллюстрация (c))

Модель начинает генерацию ответа с запроса и полностью замаскированного ответа — такое состояние соответствует моменту времени t = 1 (начальной стадии восстановления текста). На каждом шаге генерации все замаскированные токены восстанавливаются одним проходом модели (токены выбираются жадно). А затем часть предсказанных токенов вновь маскируется с вероятностью t.

t постепенно уменьшается до тех пор, пока не дойдёт до 0. Итеративный подход предсказал — зашумил позволяет модели лучше обдумать, что именно она собирается генерировать.

Также авторы хорошо отзываются о подходе, где маскирование предсказанных токенов происходит не случайно, с какой-то вероятностью, а детерминировано — маскируется доля t токенов, в которых модель наименее уверена. Этот подход к генерации также совместим с classifier-free guidance, что не может не радовать.

LLaDA — далеко не первая модель, основанная на Masked Language Modelling. Хотя авторы и не предложили миру радикально новый подход, простота и изящность идеи позволила им догнать и перегнать весьма сильные авторегрессионные бейзлайны: LLaMA 2 и 3.

Разбор подготовил ❣ Cydoroga

Душный NLP
3 798 просмотров · 28 реакций Открыть в Telegram · Открыть пост на сайте
Large Language Diffusion Models. Часть 1/2

Сегодня разберём статью о новой диффузионной модели от китайских коллег. Модель относится к классу так называемых дискретных диффузий и очень похожа на BERT в режиме Masked Language Modelling.

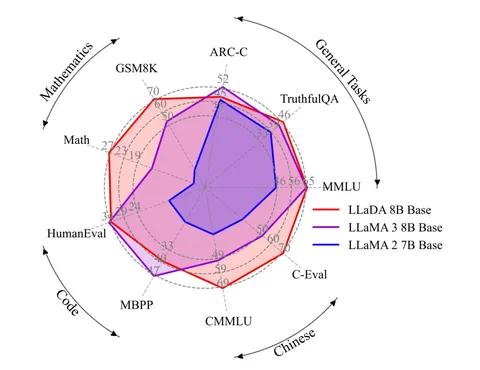
Авторы называют свою разработку LLaDA. На графике — диаграмма сравнения новой модели (красная кривая) с LLaMA 3 8B (фиолетовая кривая) и LLaMA 2 7B (синяя кривая). К скейлу осей есть вопросы:

∙ там, где LLaDA показывает лучшие результаты — разница выглядит значительной;
∙ там, где LLaDA хуже, — различия выглядят несущественными.

Возможно, на площади под кривыми смотреть бессмысленно и график не очень репрезентативный. Но с долей критики по нему вполне можно ориентироваться в сильных и слабых сторонах новой модели.

В языковом моделировании уже давно правит бал классическая авторегрессия, где каждый последующий токен моделируется вероятностным распределением и обусловлен на контекст. Но такой подход не лишён недостатков: если первый токен, который породила модель, оказался не самым удачным, исправить ошибку уже не получится — модель продолжит генерировать следующие токены, оглядываясь на первый, и испортит весь ответ.

Бороться с этой проблемой можно, например, с помощью chain-of-thoughts. Но существует и ортогональное решение — использовать диффузионный подход с некаузальной маской аттеншна.

Как? Читайте в следующей части разбора.

Разбор подготовил ❣ Cydoroga

Душный NLP
4 397 просмотров · 47 реакций Открыть в Telegram · Открыть пост на сайте
InfAlign: алайнмент языковых моделей с учётом процедуры инференса

Метод RLHF (Reinforcement Learning from Human Feedback) доказал эффективность в задаче алайнмента языковых моделей. Однако у него есть существенный недостаток: на практике возникает расхождение между процессом обучения и реальным использованием модели.

Например, после RLHF модель обычно старается избегать неверных ответов. Но при использовании стратегии генерации Best-of-N (выбор лучшего из нескольких сгенерированных ответов) такое жёсткое ограничение становится неоптимальным — модель могла бы давать лучшие ответы, разреши мы ей экспериментировать более агрессивно за счёт небольшой доли неверных ответов.

Для решения этого несоответствия авторы статьи разработали метод InfAlign, адаптирующий процесс обучения к конкретным процедурам генерации, используемым на практике.

Рассмотрим проблему детальнее. Классический подход RLHF с учётом KL-регуляризации гарантирует оптимальность модели по средней награде, если ответы генерируются сэмплированием. На практике, однако, нам интересна не столько средняя награда, сколько доля запросов, на которых новая модель лучше старой. И уже для такой метрики (при фиксированной модели, по отношению к которой мы считаем винрейт) RLHF даёт субоптимальные результаты даже для простого сэмплирования — что уж говорить о более продвинутых методах.

К счастью, авторам статьи удалось доказать, что оптимизация винрейта для некоторых процедур генерации, включая Best-of-N, Worst-of-N и сэмплирование, эквивалентна применению RLHF с модифицированной функцией награды.

Предложенный подход состоит из трёх основных этапов.

1. Калибровка награды. На этом этапе исходные награды преобразуются в значения от 0 до 1 таким образом, чтобы распределение наград ответов модели стало равномерным на каждом запросе. Это эквивалентно применению обусловленной на запрос функции распределения награды к самой награде. Забавно, что в первой версии статьи авторы предложили использовать медианную аппроксимацию функции распределения, однако спустя месяц удалили все упоминания об этом методе и перешли к использованию эмпирической функции распределения.

2. Трансформация награды. На следующем этапе откалиброванная награда адаптируется под конкретную процедуру генерации. Например, для стратегии Best-of-N применяется экспоненциальное преобразование, усиливающее различия между отличными и посредственными ответами, а для сэмплирования — логарифм, штрафующий за плохие ответы. Заметим, что на самом деле логарифм и экспонента — это лишь хорошие приближения оптимального преобразования. Но, как показывают эксперименты, погрешностью можно пренебречь ради простоты реализации.

3. Обучение с модифицированной наградой. Модель обучается при помощи классического RLHF, используя модифицированную награду, адаптированную под конкретную процедуру генерации.

Проведённые авторами эксперименты показали, что предложенный подход демонстрирует значительное улучшение качества генерации с точки зрения винрейта даже для процедуры сэмплирования.

Отметим, что сейчас метод InfAlign применим к весьма ограниченному набору реально используемых процедур генерации, таких как Best-of-N, Worst-of-N и сэмплирования.

Разбор подготовил ❣ Федор Лебедь

Душный NLP
4 318 просмотров · 32 реакций Открыть в Telegram · Открыть пост на сайте
YandexGPT 5 Lite Instruct теперь в опенсорсе 🎉

В феврале в открытый доступ вышла Pretrain-версия, а сейчас очередь дошла и до YandexGPT 5 Lite Instruct. Это модель на 8 миллиардов параметров с размером контекстного окна в 32К токенов.

О претрейне мы уже писали вот тут, а алайнмент аналогичен тому, через который проходит YandexGPT 5 Pro. На этапе SFT концентрировались на сложных запросах, а также методах фильтрации и ранжирования данных. В рамках RLHF комбинировали RL-подходы, которые дают лучшие результаты: DPO, LogDPO и PPO. Подробнее об этом читайте на Хабре.

По результатам внутреннего слепого попарного сравнения (side-by-side) новая модель YandexGPT 5 Lite превосходит Qwen-2.5-7B-instruct в 62% случаев и не уступает GPT-4o mini в решении стандартных задач сервисов Яндекса. Показатели бенчмарков можно посмотреть в таблице.

А ещё обновили лицензию: теперь можно использовать модель не только в некоммерческих целях, но и в коммерческих до 10 миллионов выходных токенов в месяц. Если ваши объёмы выше, напишите на почту, указанную в тексте лицензии.

Модель доступна на Hugging Face. Там же есть и квантизованная версия с поддержкой GGUF. YandexGPT 5 Lite Instruct совместима с llama.cpp и Ollama.

ML Underhood
3 225 просмотров · 48 реакций Открыть в Telegram · Открыть пост на сайте
Метод борьбы с likelihood displacement в DPO

Датасет для Direct Preference Optimization (DPO) состоит из инструкции, а также двух ответов: негативного — его хотим разучить — и позитивного, который мы хотим чаще получать. Likelihood displacement — это явление, при котором модель разучивает оба варианта. О методе преодоления этой проблемы сегодняшняя статья.

В своей работе авторы использовали датасет Persona, промпты в котором сформулированны как вопросы вида «Мог бы ты сказать следующее:...» (“Is the following statement something you would say? [STATEMENT]”). То есть модели нужно было согласиться или не согласиться с утверждением, ответив «да», «нет», «никогда» или «возможно». Эксперименты показали, что при попытках научить модель отвечать отрицательно, но не категорично («никогда» считался негативным вариантом на DPO, а «нет» — позитивным), вероятность токена «да» становится больше вероятности «нет». Подобное происходит только тогда, когда оба типа ответов похожи (изображение 1).

Авторы считают, что likelihood displacement происходит из-за анэмбеддинг-геометрии токенов. Анэмбеддинг-матрица позитивного и негативного токенов — разница между Wy+ и Wy- — содержит в себе большую компоненту, ортогональную позитивному ответу, по которой можно выучить даже противоположный ответ.

Справиться с этой проблемой авторы предлагают с помощью метрики для оценки похожих ответов. Чтобы её вывести, нужно взять суммы эмбеддингов всех токенов в позитивном ответе и негативном ответе, посчитать их скалярное произведение, а затем вычесть норму позитивного ответа. Эта метрика зависит от длины ответов, поэтому авторы предлагают делить скалярное произведение на произведение длин позитивных и негативных ответов, а норму — на квадрат длины позитивных ответов (изображение 2).

С помощью метрики, которую назвали centered hidden embedding similarity (CHES), отфильтровали выборку ответов из датасета. Для эксперимента использовали SORRY-bench, призванный научить модель отказывать пользователю в исполнении неэтичных, токсичных или преступных запросов. Использование CHES показало хорошие результаты (голубой столбец на графике), однако после фильтрации в выборке осталось всего 5% сэмплов. Кроме того, модели в сравнении обучались не одинаковое количество шагов, что могло повлиять на результаты тестов.

Разбор подготовил ❣ Карим Галлямов

Душный NLP
3 563 просмотров · 26 реакций Открыть в Telegram · Открыть пост на сайте
Механизм аттеншена NSA

Native Sparse Attention (NSA) — механизм разреженного аттеншена от инженеров из DeepSeek. Утверждается, что NSA имеет качество, сопоставимое с обычным аттеншном на маленьких контекстах, и значительно опережает его на больших — в статье сравнение производится на 64K токенов.

Вместо того чтобы каждый новый query обращался ко всем предыдущим key и value, как это делается в традиционном аттеншне, авторы предлагают сжимать предыдущие ключи и значения в dense-представления. За счёт этого длина последовательности, над которой работает attention, уменьшается, что позволяет работать с контекстом в 64K токенов так, будто их всего 4K. В отличие от предыдущих sparse-методов аттеншна (например, Quest), NSA применяется как при обучении, так и при инференсе.

В статье предлагают три функции для сжатия представления: token compression, token selection и sliding window. Для каждой из них считается аттеншен, а результаты складываются с коэффициентами от MLP-блока.

Token compression предполагает покрытие последовательностей ключей и значений блоками длины 32 с перекрытием по 16 токенов с последующим сжатием каждого блока в «один токен» с помощью MLP с внутриблочным позиционным энкодингом.

На стадии token selection тоже происходит покрытие ключей и значений блоками, но теперь для каждого из них считается скор полезности. После чего выбираются top-16 блоков с максимальным скором. На оставшиеся блоки аттеншн не смотрит, а в выбранных внимание обращается на все ключи и значения.

Авторы отмечают, что в начале обучения сильно доминировали локальные паттерны. Поэтому selection и compression больше фокусировались на последовательностях ближе к текущему токену. В конце, на длинных контекстах, возникали сложности с аттеншеном на начало последовательности. Чтобы решить эту проблему, предлагается дополнительно использовать sliding window для аттеншена на ближайшие 512 токенов.

Метод проверяли на MoE-модели на 27B параметров, из которых 3B — активные. У модели было 30 слоёв аттеншена и 64 головы с разной размерностью. Число экспертов — 72, из них общих — 2. Обучение происходило на 270B токенов с размером контекстного окна в 8K токенов. Далее был SFT с использованием техники YaRN.

Результаты тестов показали, что на бенчмарках, где длинный контекст не так важен — например, MMLU или HumanEval — деградации качества от использования NSA не происходит. На LongBench же NSA показывает качество в среднем на 10% лучше, чем Full Attention. Например, на LCC, где требуется дополнить сниппет кода на основе очень длинного контекста, NSA побеждает 0,232 на 0,163.

Кроме того, есть ощутимый прирост в скорости — вплоть до 9 раз на форварде и 6 раз на бекварде при сравнении с FlashAttention 2. Это стало возможно за счёт эффективного Triton-кернела, кодом которого разработчики не делятся, но в open source уже началась работа по его воспроизведению.

Разбор подготовил ❣ Владислав Савинов

Душный NLP
4 484 просмотров · 48 реакций Открыть в Telegram · Открыть пост на сайте
GenARM — метод потокенного реворда

Сегодня разберём простую, но интересную статью. Авторы сделали потокенный реворд, чтобы использовать его в тест-тайме для генерации ответов.

Попыток использовать реворд для генерации ответов предпринималось немало. Скажем, можно использовать обученный на полных ответах реворд на частях генерации. А можно считать награду, генерируя полный ответ для каждого следующего токена. У таких подходов есть минусы. В первом случае при генерации могут возникать неточности из-за того, что реворд обучался только на полных ответах, во втором случае — существенно возрастает «стоимость» инференса.

Решением проблем, по мнению авторов, могло бы стать использование суммы авторегрессионного RM-скоринга для каждого токена-кандидата и LLM-скоринга. На основе полученных результатов и должен выбираться ответ. Инженеры задались целью создать именно такой реворд.

Авторы взяли SFT-модель и данные предпочтений (preference data) в виде пар. Это инструкция и два ответа — победный и проигрышный, — размеченные людьми. Реворд-модель обучается на этих парах с использованием негативного лосса.

Идея авторов статьи заключается в том, чтобы представить итоговый реворд как сумму потокенных вероятностей для каждого токена. То есть каждый следующий токен получает какую-то оценку, эти оценки складываются для получения итоговой награды. Эту параметризацию подставляют в лосс, чтобы обучить реворд-модель.

В тест-тайме авторы получают скоры для каждого токена по формуле, которая учитывает предсказания базовой и реворд-моделей. Это намного эффективнее, чем генерировать целые тексты и прогонять их через реворд.

Можно также использовать несколько ревордов — например, когда ответ должен быть одновременно и полезным, и этичным, или когда нужно склонить генерацию в какую-либо сторону. Для обоих показателей нужно натренировать отдельную реворд-модель.

Эксперименты показали, что метод, предложенный авторами, оказывается лучше, чем другие известные бейзлайны — например, ARGS и Transfer Q — по качеству и скорости инференса. Однако он уступает DPO, который намного более сложен и дорог в исполнении, чем GenARM.

Ещё из интересного: авторы заметили, что маленькие модели могут выступать хорошим ревордом у крупных при использовании GenARM. Эксперименты проводили на Tulu2 с числом параметров 7B, 12B и 70B. И в этом случае метод из статьи превзошёл всё, кроме DPO.

Разбор подготовил ❣ Илья Черемушкин

Душный NLP
5 669 просмотров · 22 реакций Открыть в Telegram · Открыть пост на сайте
SpinQuant: LLM quantization with learned rotations. Часть 2/2

Продолжаем рассказывать о SpinQuant — SOTA-результате w4a4kv4-квантизации, который показывает очень хороший перфоманс даже на «макбуках».

Убедиться в том, что вращение работает, авторы предлагают двумя способами:

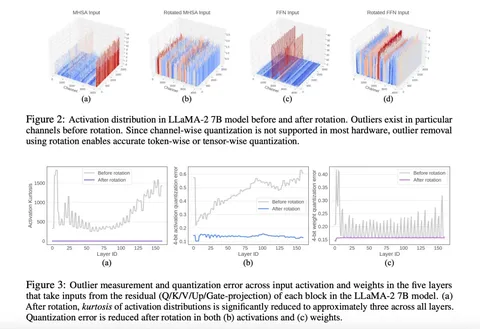
— Визуально. Попарное сравнение тензоров до и после вращения — верхний ряд иллюстраций.

— Статистически. В качестве метрики количества выбросов авторы выбрали эксцесс (или 𝛋), который оценивают по моментным статистикам распределений — нижний ряд иллюстраций. После вращения метрика становится стабильнее по всем слоям, а её величина уменьшается.

По словам авторов, метод не отстаёт в производительности от других современных решений и уже внедрён разработчиками. E2E-измерение скорости модели LLaMA-3 8B с конфигурациями W16A16 и W4A8 на процессоре MacBook M1 Pro показало, что 4-битное квантование дает примерно трёхкратный прирост скорости по сравнению с 16-битной моделью.

Похожего ускорения можно (и нужно) добиться и на GPU, но есть важный нюанс: видеокарта должна поддерживать быстрое вычисление 4-битного GeMM на тензорных ядрах. Однако NVIDIA не предоставляет такую функциональность на архитектуре Hopper, хотя на всех остальных архитектурах она есть.

Разбор подготовил ❣ Роман Горб

Душный NLP
4 590 просмотров · 23 реакций Открыть в Telegram · Открыть пост на сайте
SpinQuant: LLM quantization with learned rotations. Часть 1/2

Решение из сегодняшней статьи от Meta* — конкурент другой разработки по квантизации в низкую битность, QuaRot. Но в SpinQuant, кроме весов и активаций, квантуется ещё и KV-кэш. Иными словами, это SOTA-результат w4a4kv4-квантизации, который показывает очень хороший перфоманс даже на «макбуках».

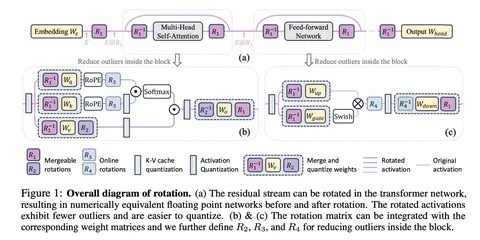
Главная идея — победить проблемы выбросов (поканальных отклонений в активациях attention), добавив матрицы поворота до и после каждого линейного слоя модели. После этого квантизация проводится как обычно, но без потери качества — спасибо обучаемым, а не случайным, как в QuaRot, матрицам вращения (розовые R₁ на рисунке).

Но ничего не бывает бесплатно: умножение — отдельная операция, которая требует дополнительных ресурсов. Чтобы сэкономить в момент инференса, матрицы вращения R₁ вмёрживаются в матрицы весов W умножением. Но так получается сделать не для всех вращений: например, матрицы R₃ и R₄ вставляют в слой отдельной операцией и, как в статье QuaRot, — используют случайные матрицы Адамара.

*Компания Meta признана экстремистской организацией в России.

Разбор подготовил ❣ Роман Горб

Душный NLP
4 591 просмотров · 35 реакций Открыть в Telegram · Открыть пост на сайте
Технический отчёт Qwen2.5-Coder

Qwen2.5-Coder — семейство моделей, предназначенных для генерации кода. Его технический отчёт вышел ещё в прошлом году, но там много интересного, что стоит разобрать. Этим и займёмся.

Модель учили работать как с отдельными файлами, так и с целыми репозиториями. Что касается токенизации, то авторы взяли словарь Qwen2.5 на 151,646 токенов, но добавили к нему спецтокены. Например, для обучения в режиме Fill-in-the-Middle (FIM).

В датасете для допретрейна было пять типов данных:

— код на 92 языках программирования — примеры брали с GitHub до февраля 2024 года. Использовали фильтры на эвристиках, чтобы отсеять некачественные данные;
— text-code grounding data — уже не только код, но и документация, руководства. Использовали итеративную иерархическую фильтрацию: сперва брали большой массив данных, но с каждым шагом фильтрации их становилось всё меньше;
— синтетические данные — их генерировали с помощью CodeQwen1.5. Оставляли только выполнявшийся код;
— математические данные — использовали претрейн-датасет Qwen2.5-Math;
— текст — использовали данные из претрейна Qwen2.5, но без кода. Авторы хотели, чтобы модель получилась достаточно универсальной и умела решать различные задачи, а не только связанные с программированием. По результатам бенчмарков, лучше всего себя показала пропорция кода, математики и текста — 7:2:1.

Сперва был допретрейн на уровне файлов. Контекстное окно тут составляло не более 8 тысяч токенов. Здесь как раз и использовали FIM. Следом шло обучение на уровне репозиториев с контекстным окном до 32 тысяч токенов за счёт увеличения параметра RoPE base до миллиона. Для экстраполяции до 128 тысяч применяли технику YARN.

На посттрейне обучили модель CodeBERT, чтобы классифицировать документы по примерно сотне языков программирования. При этом авторы сохраняли все найденные документы на популярных языках, а те, которые написаны на редких — частично удаляли. Кроме того, убирали все примеры без кода, потому что на этапе инструктивного обучения они ухудшали показатели на бенчмарках.

Для репозиториев на GitHub генерировали инструкции неназванной в отчёте LLM, а с помощью другой модели — тоже неназванной — создавали ответы. Третья LLM занималась фильтрацией полученных пар. Для повышения точности использовали фьюшот на опенсорсных инстракт-датасетах — например, McEval-Instruct.

Для формирования мультиязычного SFT-датасета использовали языкоспецефичных агентов, у каждого из которых, как заявляют авторы, был свой банк памяти с историей генераций. В целом, в техническом отчёте не хватает конкретики по SFT-датасету. Оценка получившихся пар примеров производилась по чеклисту из 9 параметров. Среди них: соответствие ответа вопросу, сложность, наличие кода, его правильность и ясность.

Самый трудный с точки зрения разработки элемент — это мультиязычная «песочница». Нужно было обеспечить поддержку каждого из 92 языков программирования, собрать репозиторий эталонного кода, создать генераторы юнит-тестов, движки выполнения и анализаторы результатов. «Песочница» — вещь итеративная, которая нуждается в постоянной поддержке. Для этого разработчики привлекли экспертов, что делает «песочницу» особенно ресурсозатратной.

SFT сперва осуществлялся на нескольких десятках миллионов не слишком качественных, но разнообразных примеров. Затем с помощью rejection sampling выборка снижалась до нескольких миллионов лучших сэмплов.

Чтобы на этапе SFT модель не разучилась работать с длинным контекстом, авторы использовали короткие инстракт-сэмплы с FIM. При этом добавленный контекст — синтаксис — получался с помощью парсинга библиотекой Tree-sitter-languages. Примеров, обогащённых контекстом, было меньше, чем обычных SFT-данных.

В рамках DPO использовали RLEF для сигналов о том, что код работает, а также юнит-тесты для некоторых примеров. Были и примеры без кода, чтобы модель могла решать задачи, не связанные с программированием. В качестве LLM-as-a-judge выступала 4о.

Разбор подготовил ❣ Алексей Малафеев

Душный NLP
6 274 просмотров · 38 реакций Открыть в Telegram · Открыть пост на сайте
YandexGPT 5 уже в опенсорсе и Алисе

Сегодня Яндекс показал миру новое поколение больших языковых моделей — YandexGPT 5. Старшая модель YandexGPT 5 Pro доступна в чате с Алисой и Yandex Cloud через API. Ну а претрейн-версия младшей модели YandexGPT 5 Lite Pretrain — уже лежит на Hugging Face.

Все подробности о процессе обучения можно прочитать в статье на Хабре. А в этом посте — главные факты о свежей опенсорсной модели Яндекса.

YandexGPT 5 Lite Pretrain — модель на 8 миллиардов параметров с длиной контекста 32 тысячи токенов. Претрейн проходил в два этапа: сначала модель обучили на 15 триллионах токенов текста на русском и английском языках, а потом использовали 320 миллиардов токенов высококачественных данных, включая образовательный контент.

На первом этапе датасет больше чем на половину состоял из веб-документов, остальное — код, математика и специфичные данные. Под последними подразумеваются синтетика (сгенерированные YandexGPT 4 вопросы на основе проверенных источников) и внутренние наработки компании (например, внутренняя база Яндекса Fact Snippet и новый корпус данных Переводчика).

На втором этапе датасет на четверть состоял из веб-страниц и почти в равных пропорциях содержал математику, код и образовательные данные. Также была небольшая часть аугментаций фактовых документов, другой синтетики и датасетов сервисов.

По сравнению с моделью предыдущего поколения, YandexGPT 4 Lite Pretrain, новая модель показывает ощутимый рост качества в решении математических задач и написании кода. А в сравнении с зарубежными аналогами, такими как LLaMa3.1-8B и Qwen-2.5-7B-base, она лидирует почти во всех типах задач.

Ещё раз приглашаем пощупать модель, почитать статью на Хабре с деталями обучения и не забыть поделиться впечатлениями в комментариях!


ML Underhood
3 670 просмотров · 52 реакций Открыть в Telegram · Открыть пост на сайте
Яндекс выпустила новое поколение LLM — YandexGPT 5. Модели можно опробовать в облаке, Алисе и открытом доступе. Делимся подробностями обучения и результатами бенчмарков.
2 913 просмотров · 15 реакций Открыть в Telegram · Открыть пост на сайте
Документный LLM-переводчик в Яндексе

Яндекс запустил новую модель для документного перевода на основе YandexGPT. Она уже работает в Поиске, Умной камере и Нейропереводчике Яндекс Браузера, а также заняла первое место в бенчмарке DiBiMT по переводу с английского на русский. Обо всех нюансах работы переводчика и о том, как его создавали, на Хабре рассказал руководитель группы базового качества перевода Николай Карпачёв. А здесь — кратко о главном.

Документный перевод предполагает адаптацию на другой язык не каждого отдельного предложения, а всего текста. Почему это важно? Причин несколько. Например, английское «you» может означать как «ты», так и «вы», но без контекста модель не понимает, какой вариант выбрать. Термины и стилистика могут «прыгать» внутри текста, а пропущенные элементы, понятные носителю языка, в переводе превращаются в бессмысленный набор слов. Люди воспринимают текст иначе: мы читаем книги, статьи, субтитры — всё целиком. Значит, и машинный перевод должен работать так же.

Инженеры Яндекса попробовали перевести тексты LLM-моделью «из коробки», без дообучения, но столкнулись с типичными ошибками: пропущенные фрагменты, лишние добавления, галлюцинации. Чтобы этого избежать, модель пришлось адаптировать. На первом этапе подготовили данные, включая не только классические парные предложения, но и переводы документов, полученные автоматическим выравниванием и с помощью синтетики. Дообучение проходило в форматах LoRA и P-Tuning.

На следующем этапе модель дообучалась с помощью технологии alignment. Разные варианты переводов сравнивались редакторами-профессионалами. Полученные оценки использовали для оптимизации методом Contrastive Preference Optimization (CPO). На этой стадии происходит исправление существующих ошибок и проблем LLM-модели, найденных редакторами. Это позволило минимизировать ошибки, связанные с потерей информации и несогласованностью.

В итоге по метрике MQM новая модель переводит тексты почти так же хорошо, как человек. Количество грубых ошибок сократилось в два раза по сравнению с предыдущей версией, а финальный результат оказался даже лучше GPT-4o.

ML Underhood
3 862 просмотров · 45 реакций Открыть в Telegram · Открыть пост на сайте
А в нашем канале ML Underhood (подписывайтесь, если ещё не!) — краткий обзор большой статьи о новом LLM-переводчике Яндекса. Отличный текст, чтобы с пользой провести пятничный вечер.
3 230 просмотров · 0 реакций Открыть в Telegram · Открыть пост на сайте
Сбалансированный метод семплирования Min-p

Min-p — метод семплирования, который, по словам его создателей, позволяет найти баланс между креативностью и связностью ответов. Сегодня разберём статью с описанием этого подхода.

При использовании отсекающего семплирования вроде top-p или top-k, на каждом шаге генерации после отсечения может всё ещё оставаться ненужный нам «хвост» из маловероятных токенов. Это приводит к тому, что вероятность допустить ошибку на следующем шаге генерации — не нулевая. А токен — не воробей, вылетит — не поймаешь. Из-за этого может пострадать весь ответ.

Это происходит потому что top-p и top-k предполагают применение жёсткого порога отсечения, который никак не зависит от шага генерации и уверенности модели в следующем токене. А подобрать универсальный порог на все случаи жизни невозможно.

Метод Min-p пытается решить эту проблему с помощью динамической настройки порога в зависимости от токена с самой высокой вероятностью. Если модель уверена в токене, то порог обрезки будет высокий. Если сомневается — то из распределения возьмётся больше токенов.

Как это работает:

1. выбирается токен с наибольшей вероятностью — Pmax;

2. гиперпараметр метода — базовый порог вероятности, Pbase (авторы рекомендуют выбирать между 0,05 и 0,1) — умножается на Pmax, и получается порог отсечки — Pscaled. По нему отсекаются токены, всё, что ниже, выкидывается;

3.формируется пул для семплирования из оставшихся токенов;

4. вероятности нормализуются.

Получается, что на каждом шаге генерации порог отсечки может меняться. При этом ресурсозатраты метода не намного выше, чем у Top-p.

Преимущество Min-p в том, что этот метод подходит для разных температур — даже при высоком значении в 3-5. Важный момент: температура должна применяться после Min-p. Авторы не рекомендуют использовать Min-p с другими методами семплирования, хотя они и могут сочетаться.

Авторы тестировали метод на Mistral 7B в трёх бенчмарках: GPQA Main, GSM8K CoT — которые проверяют конкретные знания — и AlpacaEval Creative Writing. На первых двух бенчмарках Min-p может показывать результаты чуть хуже, чем Top-p при низких температурах. Зато в AlpacaEval Creative Writing, где осуществляется SbS-сравнение на креативных задачах, он строго лучше.

Разбор подготовил ❣ Алексей Малафеев

Душный NLP
4 597 просмотров · 36 реакций Открыть в Telegram · Открыть пост на сайте
Технический отчёт DeepSeek-R1

DeepSeek-R1 — опенсорсная модель, которая на равных конкурирует с o1 от OpenAI. Сегодня разберём технический отчёт её разработчиков.

Компания DeepSeek сделала ставку на RL. В качестве инита взяли DeepSeek-V3-Base и применили метод Group Relative Policy Optimization (GRPO). Система наград включала в себя две составляющие: accuracy reward и format reward. В задачах, связанных с математикой и программированием, получившаяся модель DeepSeek-R1-Zero выдаёт ответы, по качеству на бенчмарках сопоставимые с ответами OpenAI-01-0912.

Однако из-за accuracy reward модель стала тратить больше времени на раздумья. Кроме того, у DeepSeek-R1-Zero возникли способности к рефлексии (reflection) и саморазвитию (self-evolution). Это значит, что модель учится переосмыслять свои генерации и самостоятельно обнаруживать в них ошибки. Разработчики отмечают, что сами не ожидали такого.

Проблема DeepSeek-R1-Zero заключалась в том, что её ответы были трудночитаемыми — модель могла перескакивать с языка на язык в рамках одной генерации. К тому же, они могли быть очень большими — до 10 тысяч токенов. Плюс из отчёта не очень понятно, как модель показывает себя в задачах, не связанных с математикой и кодом.

Весь пайплайн создания финальной версии DeepSeek-R1 разделили на четыре этапа. Первый — Cold Start. В его рамках делали SFT, чтобы повысить читаемость (readability) генераций. В SFT-датасет входили в том числе ответы R1-Zero, исправленные людьми — как отметили в DeepSeek, это дало прирост качества по сравнению с R1-Zero.

Второй этап был аналогичен тому, как обучали R1-Zero, однако здесь к accuracy reward и format reward добавили language consistency reward, чтобы генерации были на одном языке. Качество ответов немного снизилось, однако они больше нравились людям-оценщикам.

Третий этап — Rejection Fine-Tuning. Авторы генерировали ответы на тщательно отобранный набор инструкций и отбирали лучшие, пользуясь, помимо прочего, генеративными наградами на основе DeepSeek-V3. Отсеивались ответы на нескольких языках, слишком длинные генерации и генерации, содержащие код. В итоге получилось 600 тысяч reasoning-примеров. SFT-датасет DeepSeek-V3 использовали как основу для не-reasoning данных, а для ответов на некоторые инструкции генерировали CoT и добавляли его перед ответом. Всего получилось 200 тысяч non-reasoning-примеров.

Последний этап — RLHF. Для reasoning-данных применялся тот же алгоритм, что и в R1-Zero. А для общих данных — стандартные reward-модели, которые оценивали полезность по краткому решению задачи и финальному ответу. А для оценки безвредности рассматривали весь ответ, включая процесс рассуждения.

Получившаяся версия DeepSeek-R1 выигрывает у o1-1217 в пяти из бенчмарках из 11 — в том числе, во всех математических (первая таблица).

В DeepSeek также взяли SFT с V3, сгенерировали ответы с помощью R1 и дистиллировали полученные данные в открытые модели. RL на них не производился. В результате, например, Qwen-7B стала сопоставима по качеству с GPT-4o-0513 (вторая таблица). Однако стоит учесть, что авторы статьи сообщают только о показателях в математических бенчмарках и бенчмарках, проверяющих способность к генерации кода.

В целом, исследование показало, что дистилляция даёт лучшие результаты, чем RL (третья таблица). Но и тут есть оговорка, потому что сравнивали дистилляцию из R1, а RL осуществляли методом, как у R1-Zero.

Авторам статьи не удалось извлечь пользу из метода Process Reward Model (PRM) на этапе обучения. Это было связано со сложностью определения шагов рассуждения их корректности, а также с проблемой «взлома наград».

Также в DeepSeek безуспешно пробовали использовать в обучении Monte Carlo Tree Search (MCTS), как в AlphaGo и AlphaZero. Здесь препятствием стало огромное пространство поиска, которое несравнимо больше, чем в случае с шахматами. Ограничение по top-k при этом приводит к локальному оптимуму. Кроме того, возникают сложности с обучением Value-модели. Тем не менее MCTS способен повысить качество на инференсе.

Разбор подготовил ❣ Дмитрий Мокеев

Душный NLP
4 268 просмотров · 45 реакций Открыть в Telegram · Открыть пост на сайте
Лучшие публикации 2024-го по мнению инженеров Яндекса

В 2024 году вышло так много статей по ML, что читать — не перечитать. Руководитель команды YandexGPT Alignment Андрей Бут поделился с нами работами, которые запомнились именно ему. Есть, чем заняться на досуге! А в комментариях рассказывайте, какие публикации ушедшего года запомнились вам и почему.

Статьи, которые упоминает Андрей:

— Is DPO Superior to PPO for LLM Alignment? A Comprehensive Study
— O1 Replication Journey: A Strategic Progress Report
— O1 Replication Journey — Part 2
— Техотчёт Llama 3
— Техотчёт Qwen2.5
— Техотчёт DeepSeek-V3

Душный NLP
4 821 просмотров · 65 реакций Открыть в Telegram · Открыть пост на сайте
Интересные решения из технического отчёта DeepSeek-V3 — часть II

Продолжаем разбираться, как устроена DeepSeek-V3, изучая технический отчёт её создателей. В первой части речь шла о MLA и MoE, а сегодня поговорим о предсказании токенов и квантизации. Ну и, наконец, коснёмся результатов на бенчмарках

MTP

Метод Multi-Token Prediction (MTP) предполагает предсказание сразу нескольких токенов на этапе претрейна. В MTP эмбеддинг после всех трансформерных слоёв и перед выходной головой отправляется в дополнительный трансформерный блок (первое изображение).

Через линейную проекцию формируется новое представление, которое затем обрабатывается этим дополнительным блоком, эквивалентным по архитектуре стандартным слоям трансформера. Итоговое представление используется для предсказания сразу нескольких токенов.

Pipeline parallelism

Pipeline parallelism — это метод распределения работы модели, при котором разные слои исполняются на разных устройствах. Такой подход позволяет увеличивать количество шагов аккумуляции градиентов, уменьшая суммарное число коммуникаций. Однако при pipeline parallelism образуются «пузыри» — это периоды времени, когда устройства простаивают в ожидании данных от других устройств.

В решении этой проблемы создатели DeepSeek-V3 ссылаются на статью Zero Bubble. Её идея состоит в разбивании backward на два шага: на ту часть, которая считает сквозные градиенты, и отдельно градиенты на веса. Это полностью решает проблему «пузырей» в случаях, если количество шагов аккумуляции градиента в два раза больше пайплайна. Однако остаётся проблема коммуникаций — простои могут возникать, например, когда одно устройство передаёт другому активации со слоя на слой. Кроме того, в этом методе нужно хранить достаточно много промежуточных градиентов для вычисления градиента по весам.

В DeepSeek изобрели метод DualPipe (второе изображение). Каждый фрагмент forward и backward делится на четыре части: attention, all-to-all dispatch, MLP и all-to-all combine. Кроме того, вводится компонент коммуникации в рамках pipeline parallelism (PP communication). Создатели меняют местами эти части и вручную регулируют, сколько ресурсов GPU выделять на коммуникации и вычисления. Микробатчи при этом подаются с обоих концов пайплайна одновременно. Всё это позволяет минимизировать задержки, перекрывая коммуникации с вычислениями. «Пузыри» всё равно остаются, но, как отмечают в DeepSeek, они несущественны.

FP8-квантизация

FP8-квантизация не очень подходит для больших моделей из-за широкого диапазона весов, активаций и градиентов. Использование FP8-квантизации в таких условиях может приводить к выбросам, а следовательно, и потере качества.

Чтобы справиться с выбросами, создатели DeepSeek-V3 применяли блочную квантизацию. Для весов брались блоки 128x128 — и для каждого такого блока вычислялся свой скейл. А для активаций размер блока составлял 1x128, чтобы выбросы, если они происходят, затрагивали лишь небольшую часть активаций.

Разработчики также выяснили, что GEMM, реализованная на H800, аккумулирует результаты матричного умножения во что-то близкое к 14 битам, хотя должно быть 32 бита. Из-за этого одно матричное умножение может приводить к ошибке в 2%. Нехватку точности вручную добавляли к обычному FP32-регистру.

Итог

Благодаря всем сделанным разработчиками трюкам DeepSeek-V3 показывает отличные результаты в бенчмарках (третье изображение). На MMLU модель получает 88,5 процентных пункта, проигрывая лишь Llama 3.1 на 405B с 88,6 пп. На математических задачах (MATH-500, AIME 2024, CNMO 2024) DeepSeek — абсолютный лидер. В части программирования модель незначительно уступает Claude-3.5. Таким образом, DeepSeek-V3 — это одна из лучших опенсорсных моделей прямо сейчас.

Разбор подготовил ❣ Михаил Хрущев

Душный NLP
4 279 просмотров · 63 реакций Открыть в Telegram · Открыть пост на сайте
Интересные решения из технического отчёта DeepSeek-V3 — часть I

В конце прошлого года вышел технический отчёт модели DeepSeek-V3. У неё 671 миллиардов параметров, из которых активные — 37 миллиардов (то есть меньше 1/16). Обучение длилось два месяца на 2 тысячах GPU H800. Впервые в истории LLM обучали на FP8 и с высокой степенью разреженности (sparsity). Полученная модель вошла в топ-10 на Chatbot Arena. Кроме того, DeepSeek-V3 хорошо показывала себя в бенчмарках.

Изучили технический отчёт и рассказываем, какие необычные и даже новаторские решения в нём есть. Обзор получился объёмным, поэтому мы поделили его на два поста.

MLA

Метод, который называется Multi-head Latent Attention (MLA), используют как альтернативу Grouped Query Attention (GQA) для снижения объёма KV-кэша. Этот подход апробировали ещё в июне 2024 года в DeepSeek-V2. Как утверждают разработчики, по качеству MLA превосходит GQA и Multi-Query Attention и сопоставим с Multi-Head Attention.

Суть MLA заключается в сжатии скрытого представления в латентные вектора и хранении их на продакшене вместо Key Value. Во время генерации токенов KV восстанавливается из латентных векторов, что требует отдельных, но не слишком затратных вычислений.

Такой подход позволяет здорово экономить память, однако лишает возможности применять Rotary Position Embedding (RoPE) — способ несовместим с низкоранговым сжатием KV. Чтобы обойти проблему, в DeepSeek прибегли к методу Decoupled Rotary Position Embedding. Он предполагает добавление к каждой голове вектора с RoPE.

В результате не происходит деградации качества из-за того, что для большей части каждой головы позиционные эмбеддинги не обрабатываются. При этом модель сохраняет способность учитывать очень длинные контексты, так как её производительность не ухудшается даже при значительном удалении токенов от начальной позиции.

После претрейна разработчики расширили контекст, используя YaRN-подход (Yet another RoPE extension) — c 4 тысяч токенов до 128 тысяч. В тесте Needle In A Haystack, по условиям которого нужно найти ответ на вопрос в контексте на 128 тысяч токенов, DeepSeek-V3 в 100% случаев справлялась с задачей. Сама по себе она несложная, но демонстрирует умение модели работать с большими контекстами.

MoE

По сравнению с DeepSeek-V2 изменился подход к Mixture-of-Experts. Здесь есть общие эксперты (Shared experts), которые применяются ко всем входным токенам, и маршрутизируемые эксперты (Routed experts), среди которых выбираются лучшие для решения конкретной задачи.

Специальный лосс для контроля загруженности экспертов не используется. Вместо этого для каждого эксперта вводится определённый bias, через который и осуществляется балансировка. Если эксперт вызывается слишком часто, то bias уменьшается, слишком редко — увеличивается. Благодаря этому обучение получается более стабильным, чем при использовании лоссов.

Однако разработчикам всё-таки пришлось ввести балансировочный лосс. Описанный выше способ приводит к тому, что эксперты становятся домен-специфичными. Дополнительный лосс позволяет избежать этого, создавая разнообразие в выдаче. Благодаря хорошей балансировке нагрузки в процессе обучения DeepSeek-V3 не отбрасывает ни одного токена.

Для снижения затрат на коммуникации использовали метод Node-Limited Routing. Он вводит ограничение на число хостов, куда может быть направлен токен. Сперва выбираются хосты, которые содержат необходимых экспертов, а затем среди них с помощью алгоритма top-K routing выбираются лучшие для конкретного токена.

Во второй части расскажем о FP8-квантизации, результатах на бенчмарках и не только. Не переключайтесь!

Разбор подготовил ❣ Михаил Хрущев

Душный NLP
4 703 просмотров · 103 реакций Открыть в Telegram · Открыть пост на сайте