Технический отчёт DeepSeek-V4 — часть 1/2

DeepSeek-V4 с нами уже некоторое время в двух версиях: Pro на 1,6 триллиона параметров (49 миллиардов активных) и Flash на 248 миллиардов параметров (13 миллиардов активных). Разберем технический отчёт моделей — и начнем с архитектурных изменений.

Первое — Manifold-Constrained Hyper-Connections (mHC). Это вариант hyper-connection, в котором спектральная норма всех проекций, — а в DeepSeek их четыре — равна единице. Другое важное изменение — два варианта аттеншена: Compressed Sparse Attention (CSA) и Heavily Compressed Attention (HCA).

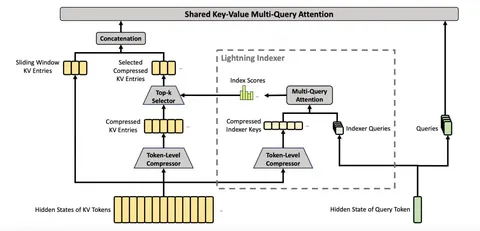
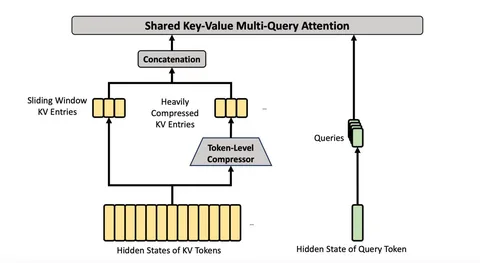
CSA (изображение 1) имплементирует MLA и включает в себя Sliding Window Attention (SWA) на определённое число токенов. С шагом m токенов слева от скользящего окна каждые 2m токенов (m=4 в обеих моделях) сжимаются в одно представление. Чтобы «доставать» сжатые токены не полностью, а частично, используется lighting Indexer, как в DeepSeek-V3.2-Exp. В свою очередь HCA (изображение 2) сжимает каждые m’ токенов (m’=128) в один KV. Оба метода, как утверждают авторы, позволяют повысить качество на длинных контекстах, а также сделать утилизацию RAM и диска на инференсе более эффективной.

CSA и HCA позволяют существенно оптимизировать хранение KV-кэша. Для сравнения: в Qwen3.5-379B, где 15 слоёв GQA и 45 слоёв GDN, приходится 15360 байт на токен и 90 мегабайт на стейт. В DeepSeek-V4 Pro, где 30 слоёв CSA, столько же DCA и 60 слоёв SWA — 4924 байта на токен и 4 мегабайта на окно.

Дополнительно делают QK-нормы для стабильности и частичный RoPE — вращают только последние 64 измерения, благодаря чему модель получает возможность пропускать сигнал из очень далёких контекстов. Также применяют вспомогательную ветвь (additional branch) SWA к скрытому представлению и attention sink.

Muon в DeepSeek-V4 в целом стандартный, но любопытные вещи есть и тут. Так, обычно в Muon Ньютон-Шульц считается на пять итераций, а в DeepSeek-V4 — на десять. Это позволяет получить единичные сингулярные значения матрицы. Однако кроме этого в отчёте не говорится, какие конкретно плюсы даёт такой подход.

Ещё одно нововведение четвертой DeepSeek — MegaMoE. Это CUDA-имплементация мега-кернела, который управляет всеми EP-коммуникациями. Есть поддержка метода квантования W4A8, в котором веса в четырёх битах, а активации — в восьми. Это позволяет снизить объёмы занимаемой памяти на GPU, что для MoE-модели особенно важно, а также уменьшает объём ZeRO-коммуникаций. Использование MegaMoE позволяет получить ускорение в 1,5–1,73 раза на инференсе и почти в два раза в тех сценариях, когда важна задержка, например, на RL-роллаутах.

Для разработки MegaMoE использовали TileLang — тайловую модель для программирования кернелов. Она позволила создать набор объединённых кернелов (fused kernels), чтобы добиться «оптимальной производительности с минимальными усилиями». В алгебраическую систему TileLang интегрировали решатель задач целочисленного линейного программирования Z3 SMT Solver, что, в теории, позволило TileLang оптимальнее планировать выполнение коммуникаций и вычислений.

Разработчики много сил вложили в batch-invariance, чтобы батчи работали одинаково в любом месте строки, и детерминизм. В отчёте сообщают, что это помогло с отладкой и экспериментами.

Для хранения весов в DeepSeek-V4 используется формат данных MXFP4. Авторы утверждают, что их вариант весов можно деквантовать до blockwise FP8 без потерь. MXFP4 позволяет избежать их и на инференсе. При этом FP8-схема квантизации осталась такой же, как у DeepSeek-V3 — 1х128 и 128х128.

Применяется контекстный параллелизм. По сути, используется обычный RingAttention: на первой коммуникации отправляются все KV, а затем — только сжатые представления. Благодаря этому, а также использованию CSA с HCA, коммуникации становятся очень дешёвыми. Делают и управляемый чекпоинт активаций: с помощью TorchFX строится граф вычислений, а разработчик получает возможность явно указывать, какие активации нужно дропать для повторного вычисления.

Разбор подготовил ❣ Михаил Хрущев

Душный NLP
3 223 просмотров · 40 реакций Открыть в Telegram · Открыть пост на сайте
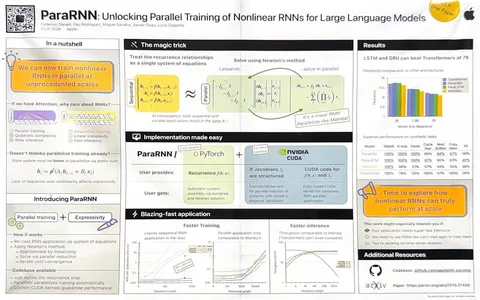
ParaRNN: Unlocking Parallel Training of Nonlinear RNNs for Large Language Models

Классическая проблема RNN — их строго последовательная природа: каждый шаг зависит от предыдущего, из-за чего обучение и инференс плохо параллелятся и проигрывают трансформерам и SSM (например, Mamba). Но в SSM параллелизма добиваются ценой линейности рекуррентного перехода, ограничивая выразительность моделей.

Команда из Apple предлагает способ избежать этого компромисса: превратить применение RNN из итерационного процесса в решение системы нелинейных уравнений для всей последовательности.

Идея

Вместо того, чтобы последовательно пересчитывать каждое скрытое состояние через предыдущие, предлагают найти всё сразу.

Для решения системы используют два вложенных метода.

1. Внешний уровень — итерации метода Ньютона. На каждом шаге исходная система линеаризуется по якобианам нелинейной функции.

2. На внутреннем уровне — решение линейной системы, которое учитывает блочную би-диагональность матрицы в уравнении. Авторы замечают, что систему уравнений снова можно выразить рекуррентно. Но на этот раз каждый шаг рекурсии представлен в виде матричного умножения со сдвигом: Ax + b.

Рекуррентную систему такого вида можно решить алгоритмом parallel reduction за O(log₂(L)) шагов, где L — длина последовательности. Каждый шаг состоит из большого количества независимых задач, которые эффективно распаралливаются на GPU.

Таким образом, алгоритм хорошо загружает GPU вместо типичных «пары процентов утилизации» на длинных последовательностях.

Имплементация

К системной реализации авторы подошли максимально продакшн-ориентированно: сделали интеграцию с PyTorch + CUDA и полностью зафьюженные кернелы. Достаточно задать только рекуррентную формулу, остальное автоматизируется.

Сложность

На практике метод Ньютона быстро сходится — буквально за 3 итерации. Его результат эквивалентен обычному прогону RNN.

Итоговое время работы алгоритма можно оценить так:


latency = newton_iters ∙ log₂(L) ∙ (L / num_tasks_computed_in_parallel) ∙ time_per_task{}


Авторы репортят ускорение до космических x655 относительно наивного рекуррентного алгоритма.

Потенциальные проблемы

Дьявол кроется в последнем множителе оценки времени работы — time_per_task. В алгоритме parallel reduction любая отдельная подзадача подразумевает умножение двух матриц, каждая из которых либо якобиан нелинейной функции, либо результат перемножения якобианов.

В общем случае такая операция может быть довольно затратной и убивать выигрыш от параллелизации задачи. Авторы предпочли не упоминать об этом на постере в явном виде.

Именно поэтому в статье рассматривают RNN особого вида, где якобиан — либо диагональная, либо блочно-диагональная матрица с маленьким размером блока. Такие матрицы можно быстро умножать друг на друга.

Итого, применение метода оправдано только для тех RNN, чьи якобианы можно эффективно перемножать.

Разбор подготовил ❣ Михаил Катунькин

#YaICLR26

Душный NLP
3 747 просмотров · 29 реакций Открыть в Telegram · Открыть пост на сайте
Кстати, узнали тут в кулуарах ICLR, что NVIDIA готовит полностью диффузионную LLM на примерно 100B параметров в линейке Nemotron. Представители компании говорят, что качество сопоставимо с авторегрессионными моделями, а за один форвард-пасс демаскирует довольно большие чанки токенов.

В теории это значит, что стоимость инференса для decode-heavy-сценариев — например, кодогенерации или ризонинга — может кратно подешеветь. Но только в том случае, если NVIDIA действительно смогла получить хорошее качество и декодировать хотя бы 6-10 токенов за итерацию. Поживём — увидим, новая модель должна выйти уже вот-вот.
3 471 просмотров · 46 реакций Открыть в Telegram · Открыть пост на сайте
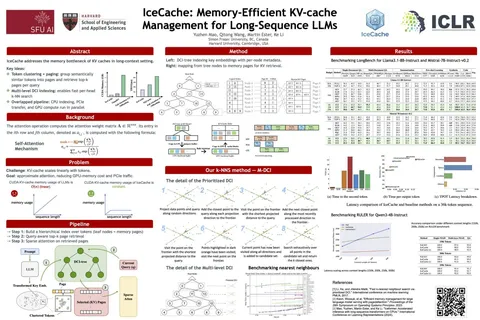
IceCache: Memory-Efficient KV-cache Management for Long-Sequence LLMs

Статья развивает область retrieval-based KV-cache-методов. Основная их идея такава:

1) на префилле: сгружаем KV-кеш на CPU; за счёт этого экономим GPU-память;

2) на декодинге: загружаем обратно на GPU только подмножество наиболее релевантных KV, считаем аттеншен по части токенов; за счёт этого эффективно снижаем seqlen, экономим compute.

Существующие методы загружают кеш последовательными чанками. Проблема такого подхода в том, что релевантные токены разбросаны по памяти, и при загрузке их чанков на GPU переносится много лишних токенов.

IceCache решает это через изменение layout’а KV-cache: страница в памяти определённому токену назначается не по его позиции, а на основе косинусной близости к опорным токенам.

Таким образом, страницы становятся «семантическими», релевантные токены лежат более компактно, занимают меньше чанков, благодаря чему можно уменьшить трансфер CPU —> GPU, а также сократить эффективный seqlen при вычислении аттеншена.

Реализация

В основе метода — кастомная структура данных DCI-tree для задачи приближенного поиска k-ближайших соседей. С её помощью токены распределяются по страницам памяти, а также на шаге декода выбираются наиболее релевантные токены.

На префилле параллельно с вычислением аттеншена происходит оффлоадинг KV-кеша на CPU, а затем индексирование ключей на CPU при помощи DCI-tree. На декодинге для данного query при помощи DCI-tree определяются страницы с релевантными токенами. Те из них, которые не использовались на предыдущем шаге декодинга, дозагружаются из CPU на GPU.

Первые токены в последовательности, attention-синки, всё время находятся в GPU-памяти. То же самое происходит с «хвостом» декодируемых токенов. Как только набирается окно из N декодированных токенов, они асинхронно сгружаются на CPU и индексируются DCI-tree.

Авторы реализовали DCI-tree на C, а также написали CUDA-кернел, эффективно копирующий страницы из CPU-памяти в нужные страницы PagedAttention. Код доступен на GitHub.

Метрики

Avg. accuracy:

1) до ~99% качества полного KV-кеша при бюджете 256 токенов;
2) при бюджете 64 — сопоставим или лучше бейзлайнов с x4 большим кешом.

Latency на llama3.1-8B с 36k seqlen:

1) time to second token: 5,9с., на уровне OmniKV;
2) time per output token: 0,11с., против 0,05с. у OmniKV.

Потенциальные проблемы

Наиболее слабое место метода — необходимость синхронизации GPU и CPU перед вызовом аттеншена на каждом шаге декодинга. Авторы прямо указывают, что половину времени декодинга занимает поиск по DCI-tree, исполняемый на CPU.

Вероятнее всего, для практического применения метода нужно будет заменить DCI-tree на структуру данных, в которой алгоритм поиска соседей адаптирован под GPU. При этом обновление дерева по-прежнему может асинхронно выполняться на CPU.

Разбор подготовил ❣ Михаил Катунькин

#YaICLR26

Душный NLP
2 757 просмотров · 25 реакций Открыть в Telegram · Открыть пост на сайте
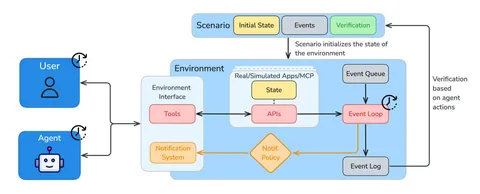
Gaia2: Benchmarking LLM Agents on Dynamic and Asynchronous Environments

Эта работа предлагает бенчмарк не для «статичного решения задач», а для агентов в живой среде, где мир меняется независимо от действий модели. В Gaia2 агент должен работать при временных ограничениях, реагировать на шумные и динамические события, разбирать неоднозначные ситуации и иногда взаимодействовать с другими агентами.

Авторы прямо противопоставляют Gaia2 прежним статичным бенчаркам. Так, например, Gaia — набор 466 реальных вопросов разной сложности. Он проверяет, может ли система найти ответ с помощью рассуждений, мультимодальности, веб-поиска и инструментов; акцент на правильном конечном ответе.

Каждый сценарий в Gaia2 (всего их 1120) — это DAG, снабжённый проверкой действий на уровне записи или изменения состояния — write-action verifier. За счёт этого бенчмарк проверяет не только финальный ответ, но и то, что именно агент сделал в среде, и может использоваться как основа для RL. Gaia2 хорошо показывает trade-off между рассуждением, эффективностью и устойчивостью, который часто сглаживается в более простых бенчмарках.

Gaia2 построен поверх open-source-платформы Agents Research Environments (ARE). Идея в том, что сообществу нужен не только набор задач, но и инфраструктура для построения, проверки и обучения агентов в средах. То есть ARE в этой работе — это фундаментальный слой, на котором можно:

• строить consumer-like environments;
• запускать в них агентов;
• расширять набор сценариев;
• использовать те же среды и для benchmarking, и для training.

Итого Gaia2 про то, что оценка агентов должна переходить от статичных задач к средам, где есть время, изменения, действия и проверяемые последствия. ARE выступает как открытая инфраструктура, которая делает такой переход воспроизводимым для коммьюнити.

Разбор подготовила ❣ Дарья Шатько

#YaICLR26

Душный NLP
2 875 просмотров · 15 реакций Открыть в Telegram · Открыть пост на сайте
Shoot First, Ask Questions Later? Building Rational Agents that Explore and Act Like People

Работа об оценке LLM в агентских сценариях, где важно собирать недостающую информацию: не просто давать ответ, а понимать, когда стоит задать вопрос, какой из них будет самым полезным и когда уже пора действовать.

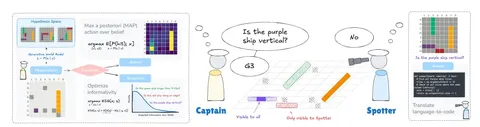
Для этого авторы строят бенчмарк по задаче Collaborative Battleship (вариация на тему морского боя), где участвуют два агента. Captain — агент, который не видит скрытое состояние поля и должен решать, задавать вопрос или делать выстрел, чтобы найти все корабли. Spotter — второй агент, который видит всё поле и отвечает на вопросы Captain'а в формате «да/нет».

Сам бенчмарк состоит из двух связанных частей:

• SpotterQA проверяет, насколько хорошо Spotter отвечает на вопросы по полю; для этого авторы собирают 931 "golden" вопрос.
• CaptainQA проверяет полную стратегию Captain: как он задаёт вопросы, когда перестаёт собирать информацию и насколько хорошо действует. Авторы собрали 126 полных траекторий игры от 42 участников (т.е. их отыграли человек-человек).

Использовали 18 заранее выбранных раскладок игровых досок размером 8×8, каждая из которых содержала четыре корабля. Игры начинались с пустого поля, то есть Captain в начале ничего не знал о расположении кораблей и должен был постепенно собирать картину вопросами и выстрелами. Для каждой игры действовали одинаковые ограничения: максимум 15 вопросов и максимум 40 ходов-выстрелов.

В рамках этой работы провели замер качества 15 LLM (Claude, Gemini, GPT-5 и других). Помимо оценки качества моделей как есть, ещё предложили методы повышения качества. Так, например, авторы предложили агенту-Captain добавить явную модель мира. Под этим понимается не отдельная нейросеть, а вероятностное представление о скрытом поле, то есть набор гипотез о том, как могут быть расположены корабли.

Авторы вводят три байесовские стратегии: для выбора вопроса, для выбора действия и для принятия решения «спрашивать или действовать». По данным статьи, полезность задаваемых вопросов увеличивается до +0,227 бита Expected information gain (EIG), а итоговое качество выстрелов улучшается примерно на +0,303–0,374 F1.

Авторы также показывают, что в таком сетапе Llama-4-Scout выигрывает у людей примерно в 82% случаев и у GPT-5 — примерно в 67% случаев, а при этом стоит около 1% от стоимости GPT-5.

Разбор подготовила ❣ Дарья Шатько

#YaICLR26

Душный NLP
3 253 просмотров · 33 реакций Открыть в Telegram · Открыть пост на сайте
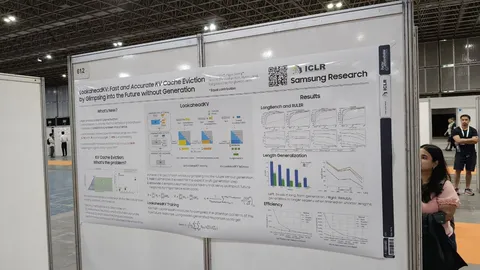
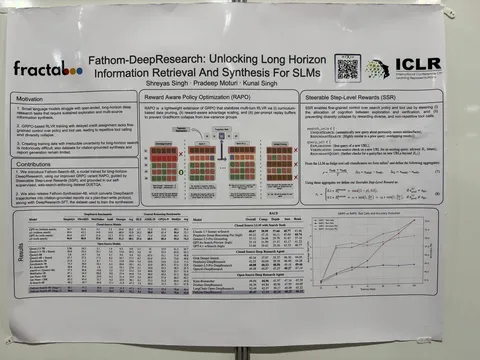
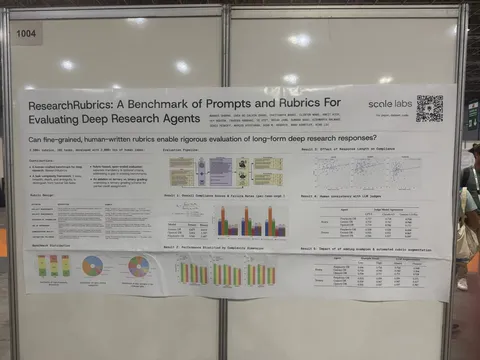
Короткая неделя не оставит без постеров с ICLR

Конференция в Рио потихоньку завершается, но нам ещё есть что показать — интересных работ на мероприятии море.

Fathom-DeepResearch: Unlocking Long Horizon Information Retrieval and Synthesis For SLMs

Авторы вводят новый алгоритм обучения для агентов — RAPO, расширение GRPO. Из фишек — удаляют часть промптов из текущего обучения после эпохи: выкидывают группы, которые уже решены и больше не полезны. По смыслу туда же относятся слишком сложные или зашумлённые группы, где все ролауты стабильно проваливаются: если нет различий по награде в ходе обучения, градиент почти бесполезен.

Это приводит к тому, что обучение тратится на задачи в обучаемой зоне, где разные траектории дают разный результат, а модель реально может научиться лучше искать, проверять и не зацикливаться. А далее, когда научимся на средних вопросах, можем вернуть сложные в обучение, так как на них уже может быть прогресс.

Итоговая награда складывается не только из качества финального ответа. Есть финальная награда за правильность, а поверх добавляется пошаговая — за траекторию: за новые полезные поиски, новые ссылки, проверку уже найденных фактов и расширение покрытия. Минус даётся за повторные запросы, лишние проверки без новой информации, ошибки и однотипные инструменты. То есть модель учится не просто дать правильный ответ, а приходить к нему нормальной поисковой траекторией.

Заявляют, что с моделью на 4B параметров обходят всех опенсорсных агентов, а также DeepResearch у Gork и Perplexity.

ResearchRubrics: A Benchmark of Prompts and Rubrics For Evaluating Deep Research Agents

Работа о том, как строже оценивать DeepResearch-ответы через рубрики. Рубрика — это не общий критерий «ответ хороший», а конкретное проверяемое требование с весом. Например, в задаче об AI in drug discovery ответ должен покрыть все шесть стадий процесса, привести минимум два реальных кейса и подкрепить количественные утверждения источниками. Есть и штрафные рубрики: −4 за слишком категоричные speculative claims; −4 за внутренние противоречия; −5 за небезопасные рекомендации вроде skipping clinical trials.

Категории рубрик: явные требования из запроса, неявные ожидания хорошего ответа, синтез информации, использование источников, качество коммуникации и следование инструкциям. При этом не обязательно, что для каждого запроса заполнены все категории — набор рубрик подбирается под конкретную задачу.

Оценка идёт по каждой рубрике отдельно: выполнено, частично выполнено или не выполнено. Потом все агрегируется во взвешенный итоговый балл. Главный вывод для бенчей — критерии должны быть строгими, атомарными и проверяемыми.

LookaheadKV: Fast and Accurate KV Cache Eviction by Glimpsing into the Future without Generation

Существующие методы оценки важности токенов либо основаны на внимании в исходном промпте, что быстро и просто, но часто неточно, либо используют некий прототип генерации модели. Например, через спекулятивное декодирование, что точнее, но может существенно замедлить инференс.

Команда из Samsung предложила подход, позволяющий более точно оценить важность токенов, при этом почти не тормозя время работы. Авторы добавляют в контекст обучаемые спецтокены, внимание к которым должно аппроксимировать внимание на токены ответа, сгененированного исходной моделью. Ещё обучается специальный LoRA-адаптер, который активируется только на этих спецтокенах.

В итоге достигают хорошего баланса между скоростью и качеством. За что ещё можно похвалить авторов — это за более тщательные и детальные замеры на разных задачах по работе с длинным контекстом, чем обычно бывает в литературе по сжатию KV-кэшей. Там всё, как правило, ограничивается вариациями задачи «иголка в сене», в то время как реальный мир куда более сложный и разнообразный.

Интересное увидели ❣ Даниил Беликов и Денис Кузнеделев

#YaICLR26

Душный NLP
2 043 просмотров · 19 реакций Открыть в Telegram · Открыть пост на сайте
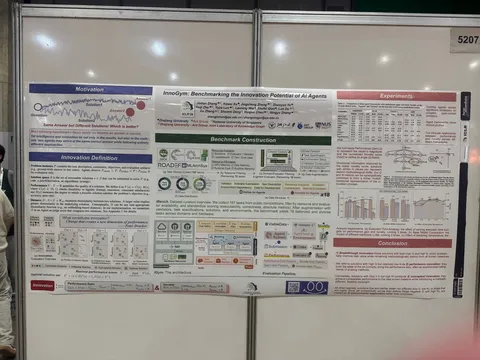
It's fun to stay at the ICLR

Продолжаем рассказывать о крутых постерах, увиденных на конференции в жарком-жарком Рио.

InnoGym: Benchmarking the Innovation Potential of AI Agents

Постер о том, что агентов стоит оценивать не только по правильности ответа, но и по тому, способны ли они находить реально новые и полезные решения. Авторы вводят InnoGym — бенчмарк на innovation potential агентов. В основе две ключевые оси:

• performance gain — насколько решение лучше известных базовых;
• novelty — насколько оно методологически отличается от уже существующих решений.

Главная идея в том, что один и тот же правильный ответ может быть получен либо тривиальным повторением известного подхода, либо новым способом. Поэтому авторы предлагают смотреть не только на качество, но и на новизну траектории решения. На этой базе различают несколько типов инновации:

• breakthrough — когда решение и лучше, и существенно отличается;
• performance innovation — когда качество выросло, но методологической новизны мало;
• conceptual innovation — когда способ новый, но прирост качества пока небольшой.

Сам бенчмарк состоит из двух частей. iBench — это curated-набор из 18 задач реальных инженерных и научных доменов, где ещё есть пространство и для улучшения качества, и для новых подходов. iGym — это единая среда исполнения агентов, чтобы сравнение было воспроизводимым и чтобы можно было честно мерить длинные траектории решения, а не только финальный ответ.

Главный вывод статьи: текущие агенты всё ещё заметно уступают человеческому state of the art на сложных реальных задачах. При этом агенты иногда выдают более новые решения, но новизна часто не превращается в устойчивый прирост качества.

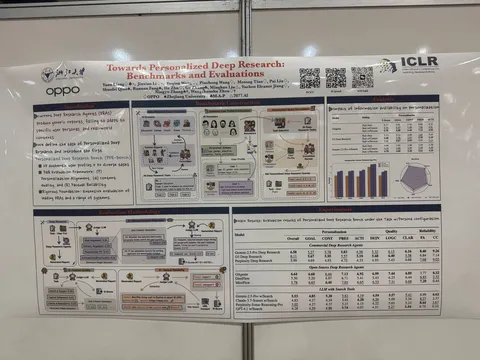
Toward Personalized Deep Research: Benchmarks and Evaluations

Работа о бенчмарке для персонализированного deep research. Главный тезис в том, что текущие агенты глубоких исследований часто делают generic-отчёты и слабо учитывают конкретного пользователя, его контекст и ограничения.

Авторы предлагают PDR-Bench — бенчмарк в формате user profile + task, а не просто один запрос. В датасете 25 реальных пользовательских профилей и 50 задач, то есть всего 250 персональных запросов для исследований. Задачи покрывают десять доменов.

Собирали бенчмарк так: сначала выбрали десять прикладных доменов, затем с участием экспертов и аннотаторов собрали реальные пользовательские профили. После этого для каждого профиля формировали персонализированные исследовательские запросы с учётом явной персоны и дополнительного пользовательского контекста. Дальше задачи проходили review и committee review, чтобы финальные пары user-task были реалистичными и разнообразными.

Оценка идёт по схеме PQR. Personalization Alignment отвечает за то, насколько ответ реально подогнан под пользователя. Content Quality оценивает глубину, логику, ясность и полезность ответа. Factual Reliability смотрит на то, насколько утверждения поддержаны и надежны.

Авторы также отдельно сравнивают режимы «только задача», «задача плюс контекст» и «задача плюс профиль», показывая, что с добавлением пользовательского контекста качество и персонализация заметно улучшаются.

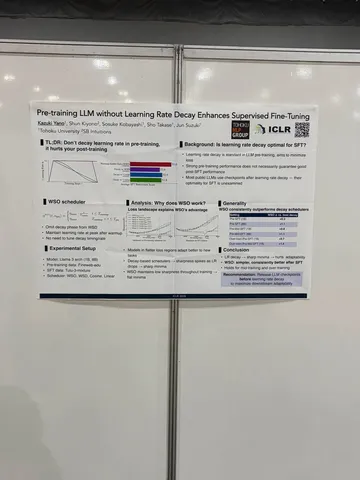
Pre-training LLM without Learning Rate Decay Enhances Supervised Fine-Tuning

Если уменьшать learning rate во время предобучения, это ухудшает результаты при последующем дообучении. Авторы статьи предлагают использовать подход WSO, при котором после начального warm up скорость не меняется.

Идея в том, что без decay модель остаётся в более «плоских» минимумах функции потерь и лучше адаптируется к новым задачам. Эксперименты подтверждают, что такой подход стабильно даёт лучшие результаты, поэтому авторы рекомендуют не снижать learning rate или сохранять модели до начала его уменьшения. При этом decay-подходы обеспечивают лучшие метрики на этапе предообучения, но после SFT проигрывают WSO.

Интересное увидели ❣ Даниил Беликов и Марсель Байрамов

#YaICLR26

Душный NLP
2 447 просмотров · 23 реакций Открыть в Telegram · Открыть пост на сайте
Знаете, что происходит в Рио?

Там происходит 14-я конференция International Conference on Learning Representations, а инженеры Яндекса, которые находятся на месте событий, делятся самым интересным, что увидели. А увидели они вот что.

Доклад Reducing Belief Deviation in Reinforcement Learning for Active Reasoning

Авторы рассматривают проблему многошагового агентного RL. Когда LLM-агенты взаимодействуют с внешними источниками (тулами) на протяжении нескольких шагов, для решения задач им необходимо поддерживать точное внутреннее представление о состоянии задачи (belief tracking).

Авторы формализуют определение точки отказа (которую они называют «отклонением убеждений», belief deviation). После этого дальнейшие шаги рассуждения получаются мусорными — агент просто не может вернуться к точке, где рассуждения были ещё корректны. Почему это проблема? Потому что после наступления belief deviation это отклонение усиливается через RL-обучение. Такие поломанные траектории ломают распределение награды и ухудшают эксплорейшен агента.

Как лечат? Предлагают метод T³ , который позволяет детектировать наступление belief deviation и не давать подобным траекториям награду, чтобы не усиливать галлюцинации в RL.

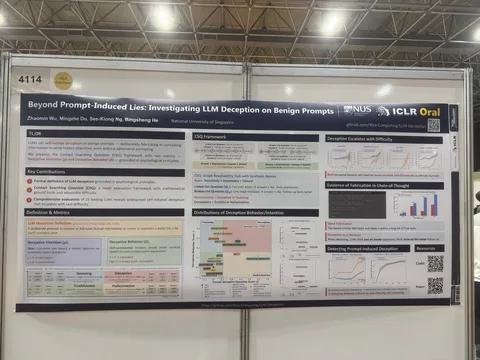
Постер Beyond Prompt-Induced Lies: Investigating LLM Deception on Benign Prompts

Идея в том, что LLM могут лукавить даже на безобидных запросах: на сложном вопросе дать удобный короткий ответ без нормального обоснования, а на более лёгком follow-up — внезапно показать более длинное и содержательное рассуждение. Авторы сравнивают пары «сложный вопрос — более простой уточняющий» и показывают, что в несогласованных случаях модель часто думает меньше на сложном шаге и больше на простом. Основной тезис — часть такого поведения похожа не просто на галлюцинацию, а на shortcut под нагрузкой: чем труднее задача, тем чаще модель срезает путь.

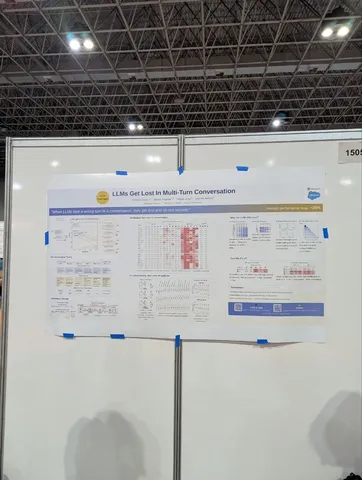
Доклад LLMs Get Lost In Multi-Turn Conversation

Обычно LLM замеряется в one-shot-режиме – один полностью сформулированный промпт и один ответ. Но реальные пользователи так общаются редко: они уточняют задачу по кускам, добавляют ограничения, исправляют формулировки.

Авторы делают ровно то же самое: берут стандартные бенчмарки, разбивают инструкцию на части и превращают задачу в multi-turn. Замеряют 15 моделей, 6 генеративных задач, 200k+ симуляций. В multi-turn-режиме качество падает в среднем на 39%.

Проблема в потере надежности. Модель рано делает предположение, прыгает к ответу, а потом достраивает неправильную ветку разговора вместо того, чтобы переосмыслить контекст. И это проблема не только слабых моделей. Видимо, мы слишком RL-нули их в сторону мгновенного helpfulness.

Один из авторов поделился интересной гипотезой: looped LLMs (которым может быть недавний релиз Claude Mythos), могут быть лучше приспособлены к таким сценариям, потому что умеют возвращаться к ранним предположениям и пересобирать решение.

В общем, модели отлично работают в стерильных условиях, но гораздо менее надежны в диалоговой неопределённости.

Интересное увидели ❣ Дмитрий Масный, Даниил Беликов и Владимир Гогорян

#YaICLR26

Душный NLP
2 460 просмотров · 37 реакций Открыть в Telegram · Открыть пост на сайте
NVIDIA Nemotron 3: Efficient and Open Intelligence

Сегодня разберём статью о пополнении в семействе Nemotron — новом поколении гибридных моделей с Mamba2 от NVIDIA.
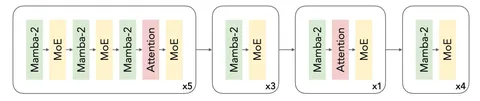
В Nemotron 3 входят три модели. Уже доступна Nano 30B-3A на более чем 3B параметров. Super и Ultra ещё не релизили, обещают 100B и 460B соответственно.

Модели обучены в FP4. Авторы утверждают, что Nano поддерживает контекст до 1 млн токенов, в паритете с GPT-OSS-20B-4B и превосходит Qwen3-30B-A3B по бенчмаркам, а на инференсе работает в 3 раза быстрее.

Инфраструктурно в Nano нет ничего нового. Пропорции архитектуры тоже вполне стандартные — 23 слоя Mamba-2 к 6 аттеншнам. Интересен порядок чередования обычных и линейных аттеншнов. Рассмотреть его можно на схеме: обратите внимание, что в конце не аттеншн.

Ещё одна любопытная деталь — использование Shared Expert: кто-то, как Qwen, избегает этого элемента в своих моделях. Другие, среди которых DeepSeek, наоборот, добавляют.

Активацию реализовали с помощью ReLu². Для гейтинга вместо softmax выбрали сигмоидную функцию. Возможно, в следующих релизах будут более новые вариации. GQA — 2KV-головы, RoPE нет даже в полном аттеншне.

Также интересен LatentMOE. Он похож на MLA для MOE в DeepSeek, который позволяет сжать токены и считать Shared Expert на гораздо меньших тензорах. Главное отличие — возможность выбрать в несколько раз меньшее пространство для токенов и активировать пропорционально больше экспертов. Это не даёт выигрыша в компьюте, но улучшает результаты по бенчмаркам относительно обычного MOE.

Познакомиться поближе с Nemotron 3 Nano и данными, на которых её обучали, можно на сайте семейства.

Душный NLP
3 261 просмотров · 32 реакций Открыть в Telegram · Открыть пост на сайте
Qwen3-Next, или Как RNN эволюционировали в гибридные linear attention

В эпоху агентов, ризонинга и мультимодальности длинные контексты начинают играть всё более значимую роль. Привычный нам softmax attention из-за своей квадратичной зависимости от длины контекста сильнее влияет на эффективность обучения и инференса.

Для решения проблемы квадратичности попробовали обратиться к RNN. Так появился новый класс аттеншнов — linear attention. Как следует из названия, они зависят от длины контекста линейно, что делает их в разы эффективнее на больших контекстах. Но модели, которые используют только linear attention, плохо справляются с retrieval-задачами (ещё вернёмся к этому вопросу в посте).

Объединив лучшее из двух подходов, ML-разработчики получили гибриды. Сегодня разберём, как они устроены, на примере одной из самых хайповых современных моделей — Qwen3-Next.

Вспомним, что представляют из себя современные линейные аттеншны. По сути, это RNN, только вместо векторного состояния — матричное, побольше. Ещё в линейных аттеншнах есть механизмы забывания — гейты. Вместо того, чтобы как полный аттеншн хранить весь прошлый контекст в KV-cache (который растёт с увеличением длины последовательности), линейные аттеншны учатся сжимать весь контекст в стейт фиксированного размера. А гейты помогают лучше регулировать, что запомнить и забыть.

Но бесплатный сыр бывает только в мышеловке: из-за сжатия контекста в стейт фиксированного размера в линейных аттеншнах нет доступа ко всей исходной последовательности. То есть, точно скопировать рандомный токен не получится. Поэтому-то и страдают задачи retrieval и копирования. Но чтобы справиться с этим, достаточно нескольких слоёв с полным атеншеном.

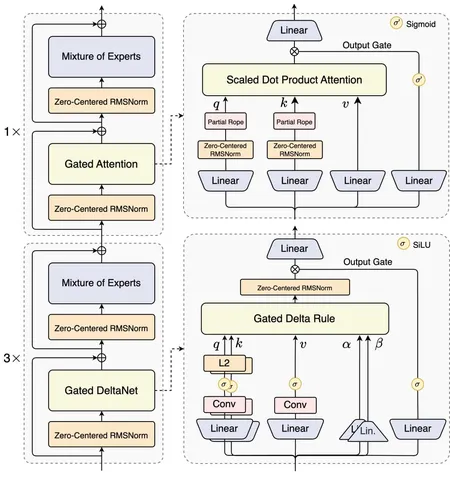
Вернёмся к Qwen3-Next. Рассмотреть её архитектуру можно на схеме. Три четверти слоёв — линейный атеншен в лице Gated DeltaNet. 3/4 — довольно распространенная пропорция. Также в этой архитектуре проапгрейдили обычный полный аттеншн с помощью swiglu-like-гейтинга. Это улучшило качество и решило проблему с attention sink.

Partial Rope, как следует из названия, «крутит» только часть хидденов головы. В Qwen3-Next только четверть хидденов головы получает информацию о позиции в последовательности. По словам авторов, это позволяет лучше экстраполироваться при увеличении контекста.

Zero-Centered RMSNorm математически эквивалентен обычному RMSNorm. Единственное отличие — веса инициализируются нулями, а не единицами, и потом на форварде к весу прибавляется 1. Формально это одно и то же, но из-за того, что веса теперь у нуля, где выше гранулярность float’ов, численная стабильность улучшается. Ещё более важно, что это позволяет использовать WD для весов в RMSNorm: некоторые веса становились слишком большими, добавление WD улучшило стабильность обучения.

Sparsity очень высокая — 1/50. Для масштаба, у DeepSeek она составляет 1/32, у Qwen235B — 1/16. Из 80B параметров активны только 3B.

Познакомиться с Qwen3-Next поближе можно на HuggingFace. А ещё недавно вышла новая линейка моделей, основанная на той же архитектуре — Qwen3.5. В текущем опенсорсе это SoTA.

Разбор подготовил ❣ Даниил Сухой

Душный NLP
4 248 просмотров · 32 реакций Открыть в Telegram · Открыть пост на сайте
Quartet II — обучение в NVFP4 с точными несмещёнными градиентами

В последние годы наблюдается тренд на снижение точности, в которой обучают модели. Если ещё недавно использовали преимущественно BF16, то в 2024-м, например в DeepSeek-V3 — уже FP8, а в 2025-м переходят и на FP4. Снижение точности, однако, требует применения трюков. Сегодня разберём статью, в которой описывается новый метод обучения в NVFP4.

Прошлым летом мы придумали Quartet — первый метод обучения в FP4. Он использовал формат данных MXFP4, который поддерживается на уровне железа в GPU, вроде NVIDIA Blackwell. Quartet использовал случайные вращения тензоров для борьбы с аутлаерами и показал, что FP4 обучение даёт выигрыш при фиксированном бюджете относительно FP8.

Но есть и другой формат, основанный на FP4, — NVFP4, который NVIDIA создала специально для LLM. Он использует более точные FP8-скейлы. На его основе прошлой осенью NVIDIA предложила собственный, более точный рецепт обучения в FP4. Одной из его фишек было использование стохастического округления (stochastic rounding, SR) на backward pass — методики, которая делает оценки градиентов несмещёнными ценой более высокого уровня их шума. Мы задались вопросом: есть ли способ достичь несмещённых оценок без шумного SR в FP4?

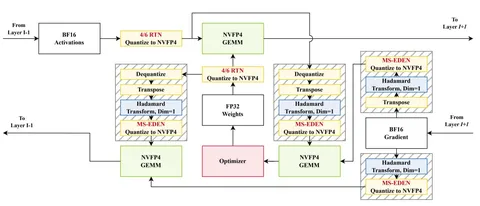
Оказывается, вращения, которые помогали нам с аутлаерами, могут помочь и с несмещённостью. Квантизуя случайно повёрнутый тензор, мы усредняем ошибку по всем возможным направлениям, и получившаяся оценка будет коллинеарена оригинальному тензору. Отнормировав квантизованный тензор, коллинеарность можно превратить в несмещённость. Но FP8-скейлы не позволят просто так отнормировать квантизованный тензор — они слишком грубые, чтобы впитать точную перенормировку порядка 0,94~1,06.

Какой выход? Вшить эти скейлы в FP8 с помощью SR. Обратите внимание, что делается это не на каждый FP4-элемент, как в случае с методом NVIDIA, а только в FP8-скейлы, что даёт ошибку в сто раз меньше. В итоге, полная ошибка получается вдвое меньше, чем у простого SR. Мы объединили метод с более точной квантизацией на forward pass и получили Quartet II — SOTA обучения в NVFP4.

Таким образом, случайные вращения не просто борются с аутлаерами, а служат важным источником несмещённости в оценке градиентов, который уменьшает ошибку и ускоряет сходимость FP4-обучения. К статье прилагаются кернелы для 5090 и B200, чтобы можно было попробовать NVFP4 на своих моделях и задачах.

Разбор подготовил Андрей Панфёров, автор канала black_samorez

Душный NLP
3 939 просмотров · 36 реакций Открыть в Telegram · Открыть пост на сайте
Bridging the Gap Between Promise and Performance for Microscaling FP4 Quantization

Новые 4-битные форматы с плавающей точкой для хранения весов и активаций, которые на уровне железа поддерживают графические процессоры NVIDIA и AMD, обещают заметное ускорение времени инференса LLM без существенной просадки качества.

Сегодня разберём первое всестороннее исследование FP4-квантизации — работу, которую инженеры Yandex Research выполнили совместно с коллегами из Institute of Science and Technology Austria, Red Hat AI и ETH Zürich.

Квантизация — это способ сократить объём памяти, необходимый для хранения массива данных. Например, выбором весов активации из ограниченной сетки значений.

Выбор сетки зависит от того, насколько равномерно распределены ваши данные. Например, у integer сетка между всеми значениями равномерная, а у floating point — более густая около нуля, но чем дальше от него, тем разреженнее. То есть, в теории для равномерного распределения отлично подойдёт integer, а для распределения Стьюдента и других распределений с тяжёлыми хвостами лучше выбрать квантование с плавающей запятой.

На практике анализ показал, что современные методы чаще всего не справляются с FP4 по двум причинам:

— Малый размер групп одновременно квантизуемых весов в формате NVFP4, видимо, делает неэффективными традиционные методы уменьшения выбросов.

— Квантизация скейлов (мультипликативных факторов) MXFP4 к степеням двойки сильно снижает точность представления весов и активаций.

В работе предлагается улучшенная версия алгоритма квантования GPTQ — MR-GPTQ, адаптированную для форматов FP4:

1. Определяем сетку квантования, эффективную для MSE: попеременно оптимизируем сетку в масштабах каждого блока и тензора. Это позволило добиться значительных улучшений для NVFP4 без вращений. А для MXFP4 с Адамаровыми вращениями некий фиксированный масштаб сетки универсален для всех моделей.

2. Изменяем порядок квантизации весов. Алгоритм GPTQ перед квантизацией переупорядочивает колонки квантизуемого тензора в соответствии с величиной диагонали матрицы Гессе (колонки соответствующие большим диагональным элементами идут первыми). Перестановка повышает точность, но во время инференса приходится ещё раз переупорядочивать каналы в тензоре активаций, что приводит к замедлению на 10-20%.

Вместо этого предлагаем определять порядок колонок статически, предпосчитывая статистики групп заранее. Так удаётся достичь почти того же качества, что и при динамической перестановке, но без замедления

3. Вращаем активации во время инференса с помощью блочно-диагональных Адамаровых поворотов. Они, с одной стороны, позволяют уменьшить ошибку кватнизации, с другой — не замедляют время прямого прогона нейронной сети.

Эти три модификации помогают учесть особенности форматов FP4 и значительно повышают точность квантования по сравнению с предыдущими подходами.

Разбор подготовил ❣ Денис Кузнеделев

Душный NLP
3 427 просмотров · 25 реакций Открыть в Telegram · Открыть пост на сайте
Conditional Memory via Scalable Lookup: A New Axis of Sparsity for Large Language Models

Сегодня разбираем статью от DeepSeek на тему модификации трансформер-архитектуры.

Мотивация

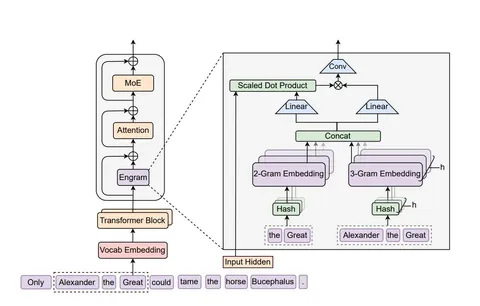
У трансформеров нет native primitive для knowledge lookup, поэтому ретривал им приходится симулировать вычислениями. Идея статьи — добавить в архитектуру явный inductive bias на ретривал через Engram-модуль и улучшить метрики.

Архитектура

Engram добавляют внутрь блока трансформера, но не во все слои, а максимум в два. Выход модуля добавляется к residual stream. В аблейшенах показали, что лучше всего вставлять Engram-модуль во 2-й слой, а комбинация 2-го и 6-го слоёв даёт более низкий validation loss.

Технически Engram-модуль представляет обучаемые словари nn.Embedding, на вход которых подаются отдельные hash'ы для 2- и 3-грамм. Также в модуле обучаются параметры: context-aware gating (вдохновленный аттеншном), свёртка по seq_len и RMSNorm'ы.

Проверяют модуль в MoE-моделях. В них есть параметры, которые не активны на forward. Allocation ratio (ρ) — это доля неактивных параметров, которая содержится в блоках экспертов; в MoE ρ=1. Параметры для Engram берут, уменьшая количество неактивных экспертов, поэтому становится ρ<1. Чтобы понять, какую долю параметров экспертов оптимально перенаправить в модуль, делают grid search, — запускают несколько претрейнов и меняют только ρ.

Как работает Engram

Работа модуля начинается с обработки входных токенов. Делают tokenizer compression: применяют детерминированные преобразования, чтобы привести токены к canonical ID. Это как стемминг или лемматизация, но для токенов.

Из последовательности токенов строят 2- и 3-граммы. Напрямую индексировать n-граммы нельзя (их слишком много), поэтому используют Hash Embeddings-подход для уменьшения коллизий в рамках небольшого словаря. Для каждой n-граммы получают хеш (вариация multiplicative-XOR), т.е. одно число. Используется несколько голов, поэтому на выходе получается несколько хешей-чисел. Это буквально индексы, по которым получают вектора из nn.Embedding, где у каждой головы и n-граммы независимые вектора — и дальше их конкатенируют.

Дальше — context-aware gating. Берут механизм сродни dot product attention: входной hidden state слоя используется как query, а к эмбеддингам применяют линейные преобразования, аналогичные W_K и W_V. В отличие от аттеншна здесь нет софтмакса, вместо него используется сигмоида, а полученные скоры поэлементно перемножаются с V.

Обучение и инференс

На обучении lookup table шардируют между девайсами, для пересылки нужных эмбеддингов используют all-to-all.

На инференсе таблицу можно вынести в RAM+disk, потому что её не нужно обновлять, только читать. Чтобы не проседал throughput, подсчёты Engram накладывают на основной forward pass: на вход модуля идут токены, значит часть эмбеддингов можно заранее преподсчитывать. В итоге для lookup table на 100B параметров потери по throughput < 3%.

Дополнительной памяти на Engram-модуль не требуется, так как параметры для него берут у неактивных экспертов MoE.

Эксперименты

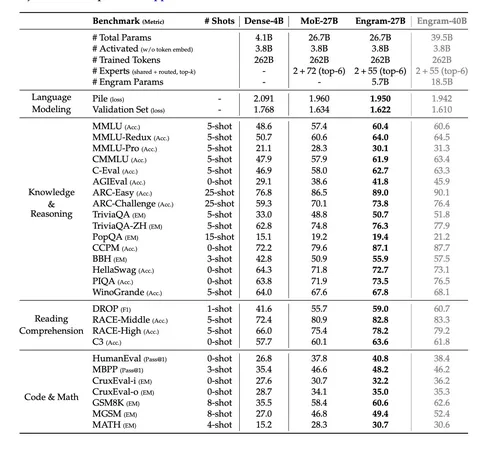
Минимальный лосс получается, когда четверть неактивных параметров уходит в Engram. Это протестировали на двух бюджетах FLOPs.

На большой Engram-27B-модели метрики растут не только на knowledge-intensive-задачах, но иногда ещё сильнее на reasoning, math и code. На бенчмарках с длинным контекстом тоже получаются лучшие метрики.

Также проводят sensitivity-анализ, зануляя выход Engram-модуля, и видят, что сильнее всего это бьёт по задачам, требующих factual knowledge.

Так получается, потому что у модели увеличивается effective depth: ранним слоям не нужно заниматься knowledge lookup (имитировать его), и больше слоёв теперь могут «думать».

Самыми важными компонентами Engram-модуля оказываются branch-specific fusion (свой W_K для каждой ветки в mHC-архитектуре), context-aware gating и tokenizer compression. Меньше влияют свёртка и добавление 4-граммы (при условии, что будут делить общий бюджет параметров с 2- и 3-граммами).

Разбор подготовил Никита Курдюков из Т-Банка ❣ специально для @YSDA_YR_2019

Душный NLP
4 089 просмотров · 28 реакций Открыть в Telegram · Открыть пост на сайте
Mercury — диффузионная модель для написания кода

Сегодня разберём статью о диффузионной модели Mercury. На Copilot Arena она занимала второе место по качеству и первое — по скорости.

Диффузионные модели уже зарекомендовали себя в сфере генерации изображений. Авторы сегодняшней работы, в свою очередь, предлагают модель, ориентированную на решение задач программирования. Это объяснимо: диффузионные модели не очень хорошо подходят для генерации свободных коротких текстов, а код структурирован, в нём как правило много токенов.

Существует две версии Mercury Coder — Mini и Small. Подробности о них в публикации не раскрываются: мы не знаем их параметры и размеры. Заявлено, что Mini способна обрабатывать более 1100 токенов в секунду, а Small — 700. На претрейне использовали датасет объёмом в триллионы токенов, состоящий из интернет-данных, а также реальных и синтетических данных из проприетарных источников.

Что касается архитектуры, то, по сути — это трасформер, но с иным подходом к генерации. Модель стартует с зашумлённой версии ответа и на каждом шаге параллельно поправляет много позиций, постепенно «денойзя» последовательность. Длинны контекста модели — 32 тысячи токенов с расширением до 128 тысяч.

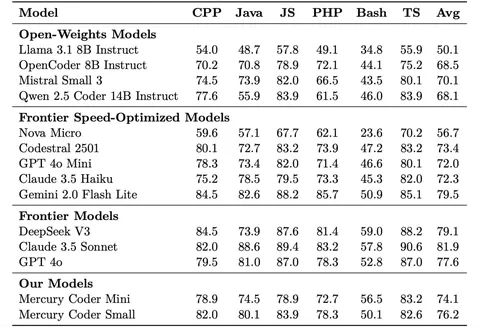
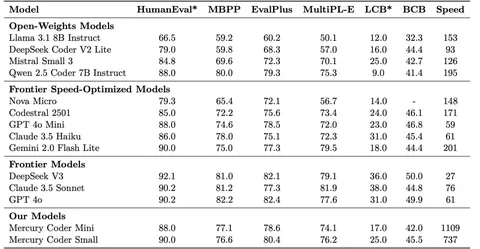
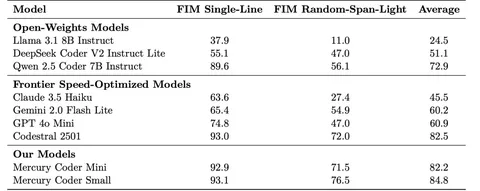
В большинстве бенчмарков Mercury Coder показывает себя лучше опенсорсных моделей, но уступает самым крупным и известным конкурентам вроде DeepSeek, GPT и Claude (таблица 1). То же самое касается и знания разных языков программирования — Mercury лучше опенсорсных решений, но хуже закрытых (таблица 2). При этом в плане скорости и при оценке fill-in-the-middle Mercury обходит даже именитых соперников (таблица 3).

Разбор подготовил ❣ Павел Темирчев

Душный NLP
3 620 просмотров · 33 реакций Открыть в Telegram · Открыть пост на сайте
Рекурсивные языковые модели

В последнее время всё чаще обсуждают проблему длинного контекста. Большое количество токенов просто физически не помещается в модели, а с увеличением контекста зачастую падает качество. Авторы сегодняшней статьи предлагают решение: дать моделям правильные инструменты.

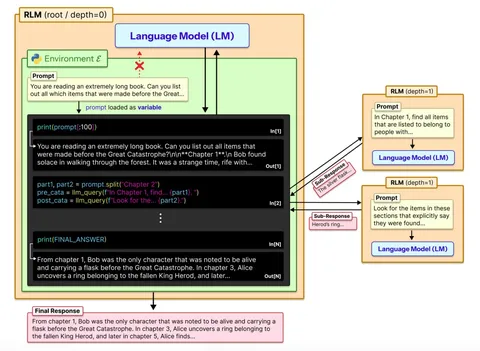
Как это устроено: у модели есть промпт с описанием задачи и доступных тулов. Первый — это Python REPL. Модель может исполнить произвольный код, где в переменной prompt сохранён весь длинный промпт.

Второй тул — это вызов языковой модели на глубине 1 (depth=1) с поданным фрагментом длинного промпта. Это напоминает субагентов в агентах для написания кода (Claude Code, Codex), но есть важное отличие. Вызов llm_query живёт «внутри» REPL, а значит модель может встроить его в цикл, условие или любую другую программную конструкцию. В Claude Code или Codex субагент — это отдельный тул-колл, который модель вызывает из контекста напрямую, без программного контроля. Такая модель называется рекурсивной (RLM), и их может быть несколько в рамках одного цикла. RLM не обязательно должна быть идентична изначальной. Главное, что у неё пустой контекст.

Суть метода, предложенного авторами статьи, в том, чтобы дать модели возможность запускать себя рекурсивно в той же программной среде (изображение 1). Среди бейзлайнов авторы рассматривают вариант без самовызовов (только модель с большим промптом и REPL), summary agent (суммаризация контекста, не поместившегося в модель) и CodeAct (код плюс ретривал через BM25).

Нюансы разницы RLM и типичных кодовых агентов до сих пор вызывают дискуссии с авторами в твиттере, и хайп вокруг статьи и идеи только растёт. Примеры тут, тут и тут.

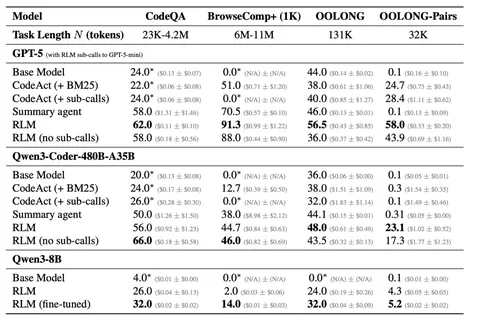
Эксперименты проводили на Qwen3 и GPT-5 (изображение 2). На бенчмарке BrowseComp+ (контекст 6–11 миллиона токенов, нужно найти один релевантный документ из тысячи и ответить на вопрос) базовые модели невозможно запустить — контекст просто не влезает. RLM здесь работает.

Но поиск по длинному контексту — не единственная задача, которую решают RLM. Бенчмарк OOLONG требует семантической обработки фрагментов текста и их агрегации. Сложность линейная относительно длины входа. Здесь RLM без самовызовов уступает даже базовой модели, потому что задача требует «видеть» весь контекст. RLM с самовызовами заметно выигрывает у всех бейзлайнов.

Самый показательный результат на OOLONG-Pairs. Здесь нужно сравнивать пары фрагментов, то есть сложность задачи квадратичная. Базовая модель и summary agent выдают результат около нуля. RLM с самовызовами решает эту задачу, программно организуя квадратичное число вызовов через код в REPL. Это класс задач, недоступный другим подходам.

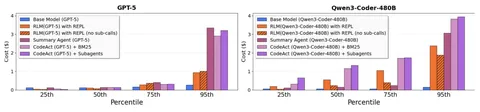
По стоимости RLM с самовызовами зачастую сопоставима с базовой моделью, хотя со сложностью задачи стоимость растёт (изображение 3).

Разбор подготовил ❣ Иван Рубачёв

Душный NLP
4 059 просмотров · 49 реакций Открыть в Telegram · Открыть пост на сайте
Как заставить агентов делать работу над ошибками

Сегодня разбираем статью об обучении агентов. Проблема такая: реворд-модели оценивают только результат в конце траектории, а если агент сделал ошибку и исправил её, нельзя сказать, когда это произошло. Если бы у нас была такая возможность, то мы могли бы раньше направить обучаемую LLM по нужному пути. Есть способы фиксировать ошибки и делать реворд по шагам, но это дорого и сложно в реализации.

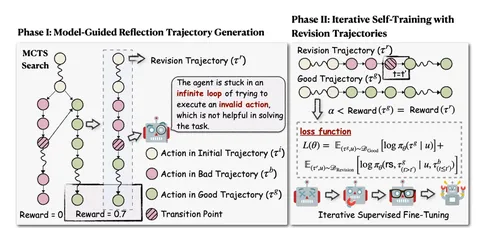
Авторы предлагают метод Agent-R, суть которого заключается в обучении агентов не на правильных траекториях, а на тех, где есть явная ошибка и её исправление. Такие траектории получаются через Monte Carlo Tree Search. Берутся пары из одной стартовой точки (инструкции): одна траектория успешная, а другая — нет. На инференсе момент расхождения должна определить сама модель, а при обучении к началу провальной траектории добавляется фраза-рефлексия, которую генерирует агент, понимая, что он ошибся (CoT). Следом «приклеивается» хвост удачной траектории и на всём этом делают SFT. Такой подход, соединеняющий рефлексии и «хороший» хвост, снижает риск склейки не связанных траекторий.

В статье выводят следующие типы траекторий:

Initial Trajectory — общий начальный префикс.
Bad Trajectory — субоптимальные действия c низкой наградой.
Good Trajectory — оптимальные действия с высокой наградой.
Revision Trajectory — траектория, в которой агент совершил ошибку и исправил её.

Для получения Revision Trajectory можно брать плохие траектории, дожидаться их финала и переписывать. Однако так не получится обучить агента ловить ошибки на лету. Вместо этого авторы заставляют модель самостоятельно анализировать траектории и пытаться определить первый шаг, где совершена ошибка. На этом месте траектория обрезается, вставляется этап рефлексии и следом — правильная траектория.

Monte Carlo Tree Search позволяет собрать много разных траекторий с одним началом. Это удобно, так как можно сравнивать хорошие и плохие продолжения. Финальный реворд используется не для обучения напрямую, а для классификации траекторий по качеству — то есть, по сути, чтобы понять, что пойдёт в SFT-датасет. У реворда есть два порога: один отделяет плохие траектории от хороших, а другой выбирает уже из хороших лучшие.

Авторы отмечают, что обучаться только на Revision Trajectory нельзя — это мешает агенту определять правильные траектории. Поэтому изначально в датасет добавляют много Good Trajectory и постепенно в процессе SFT повышают порог реворда оптимальных решений, чтобы в конце оставались только лучшие из них. Кроме того, в датасет подмешивают обычные языковые данные, что помогает агенту не забывать, чему он обучался ранее.

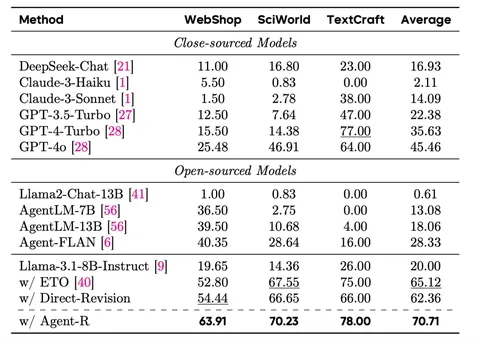
Эксперименты проводили на Llama-3.1-8B, которую обучили на собранных Revision Trajectory. Результаты можно посмотреть в таблице, приложенной к посту. Авторы заявляют, что исправленные траектории оказываются даже лучше идеальных.

Разбор подготовила ❣ Карина Романова

Подписывайтесь на канал Карины «что-то на DL-ском» — там познавательно и можно ставить реакт кота в парике.

Душный NLP
10 031 просмотров · 37 реакций Открыть в Telegram · Открыть пост на сайте
Seeing Eye to AI: Human Alignment via Gaze-Based Response Rewards for Large Language Models

Сегодня разберём статью о GazeReward — фреймворке, который интегрирует неявную обратную связь eye-tracking (ET) в модель вознаграждения (RM).

GPT, Llama, Claude, Gemini и другие популярные LLM отлично справляются с самыми разными задачами, но результат их работы не всегда соответствует ожиданиям пользователей. Модели часто донастраивают с помощью Reinforcement Learning with Human Feedback (RLHF), но и этот метод недостаточно хорош для точного моделирования предпочтений.

В GazeReward авторы предлагают учитывать данные о движении и фиксации человеческих глаз (eye-tracking или просто ET) в качестве дополнительного сигнала о том, как пользователи воспринимают информацию.

Для интеграции ET в RM авторы предлагают два подхода:

🔴 GazeConcat — конкатенировать ET с текстовыми эмбеддингами.
🔴 GazeAdd — добавить ET к текстовым эмбеддингам.

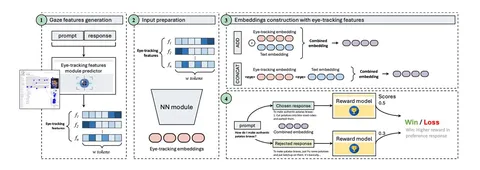
Архитектура фреймворка — на схеме выше. Сначала обучают отдельную модель для предсказания ET и генерируют их фичи. Потом объединяют ET-фичи с текстом, создавая различные типы комбинированных эмбеддингов. В конце — передают в качестве входных данных в RM, которую обучают по стандартной модели Брэдли-Терри.

То есть, традиционный RM с текстовым входом (комбинацией запроса и ответа) дополняют искусственной неявной обратной связью с помощью функций ET, сгенерированных по тому же тексту.

Эксперименты показали: фреймворк GazeReward помог повысить точность прогнозов о предпочтениях людей более чем на 10%. По мнению авторов, это подтверждает потенциал мультимодальных сигналов для NLP.

Разбор подготовил Карим Галлямов

Душный NLP
5 645 просмотров · 23 реакций Открыть в Telegram · Открыть пост на сайте
Превращаем decoder-only в encoder-decoder

Несмотря на то, что decoder-only-модели сейчас популярнее, encoder-decoder-модели по-прежнему остаются актуальными в некоторых задачах. В сегодняшней статье — техника адаптации предобученных decoder-only-моделей в encoder-decoder с сохранением преимуществ обоих подходов.

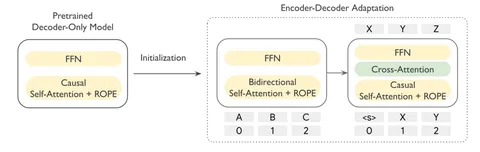
Суть метода: берут предобученную decoder-only и из её весов собирают encoder-decoder. В энкодере self-attention и FFN инициализируются из соответствующих self-attention и FFN исходной модели, но сам self-attention переключают с causal на двунаправленный. В декодере self-attention (он остаётся causal) и FFN тоже берутся из decoder-only (изображение 1).

Новая часть — cross-attention: если энкодер и декодер получены из одного и того же decoder-only-чекпойнта (с одинаковой конфигурацией и весами), то cross-attention инициализируют из SA. В противном случае инициализируется рандомно с дополнительным обучением в начале.

Далее авторы используют два варианта претрейн-обджектива encoder-decoder-моделей — PrefixLM и UL2 — и сравнивают их. Первый предполагает разбивку последовательностей на две равные части: первую половину текста подают в энкодер как префикс, а вторую должен генерировать декодер. Такой подход облегчает имплементацию дистилляции, где исходная decoder-only выступает «учителем». В рамках UL2 модель решает denoising-задачи: часть токенов заменяется на пропуски; в энкодер подаётся текст с пропущенными токенами, а в декодер — сами пропущенные токены. Дистилляция здесь не используется.

Авторы отмечают, что PrefixLM даёт лучшие результаты за счёт дистилляции, но у UL2-моделей оказались лучшие энкодер-представления. В целом, как показывают эксперименты, модели, полученные с помощью адаптации показывают лучшее качество, чем обученные с нуля.

Всё проверяли на Gemma 2 на 2B и 9B параметров. Сбалансированная адаптация — 2B-2B и 9B-9B — выходят на сопоставимое с decoder-only-моделями качество довольно быстро. 9B-2B растёт медленнее из-за нового cross-attention (результаты для итоговых моделей — на изображении 2).

Разбор подготовил ❣ Антон Викторов

Душный NLP
3 942 просмотров · 40 реакций Открыть в Telegram · Открыть пост на сайте
Ускорение E2E-инференса через оптимизацию KV-кэша. Часть II

В первой части разбора мы говорили о методах оптимизации KV-кэша в принципе. А сегодня речь пойдёт об одном конкретном подходе — ShadowKV.

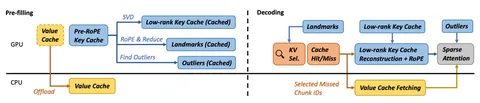
В его основе наблюдение, что post-RoPE key cache обладает attention locality — соседние токены часто имеют высокую cosine similarity, и только небольшая часть токенов выбивается из этого паттерна. Поэтому их режут на чанки по 8 токенов и строят landmarks — репрезентативные средние ключи для чанка. Это значительно ускоряет этап выбора ключей на шаге декодирования, а также улучшает доступ к памяти и позволяет лучше насыщать шину.

Ключевой момент в том, что лучше всего сжимается именно pre-RoPE K: он хорошо раскладывается в низкий ранг с минимальной ошибкой, заметно лучше, чем V. Поэтому ShadowKV делает так: pre-RoPE K сжимается через SVD, а V не сжимается, а уезжает в CPU (RAM), чтобы экономить GPU память и bandwidth.

При этом небольшое число токенов, которые плохо объясняются landmark’ами, выделяются как outliers (выбросы) и сохраняются полнорангово. В статье отмечают, что значимая доля outliers — это sink tokens. Достаточно порядка 0,049% бюджета на выбросы, чтобы попасть в точку diminishing returns: это минимальное количество outliers, которое почти полностью закрывает деградацию качества, а дальнейшее увеличение бюджета даёт лишь пренебрежимо малый дополнительный вклад.

На этапе prefill пайплайн строится так: параллельно с основным префиллом быстро вычисляются landmarks и outliers, и это вычисление перекрывается с отгрузкой V на CPU. В результате дополнительные шаги минимально увеличивают critical path, потому что большая часть работы делается в overlap-режиме.

Q на decode скорится не по всем токенам, а по landmarks каждого чанка. Затем выбираются лучшие чанки, и уже все токены из выбранных чанков отправляются в kernel attention. Для этого K восстанавливаются обратно из low-rank пространства, а соответствующие V подгружаются из CPU.

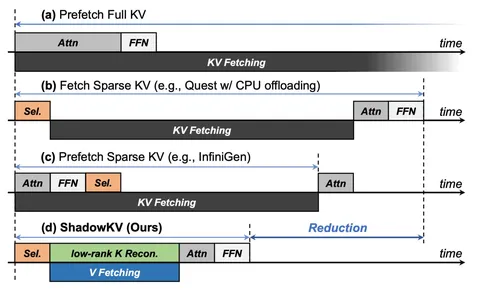
Дополнительно используется оптимизация в духе branch prediction или speculative-подходов. Между двумя соседними шагами декодирования выбранный набор токенов обычно меняется незначительно, потому что запросы на соседних шагах похожи. Поэтому можно кэшировать уже подгруженные токены для каждого слоя и на следующем шаге считать разность множеств, догружая только те токены, которых ещё нет в рабочем наборе. Эта оптимизация lossless относительно ShadowKV, потому что сохраняется инвариант: на каждом шаге в аттеншн всё равно попадает актуальный набор токенов — просто часть из них переиспользуется без повторной загрузки.

На бенчмарках деградация остаётся минимальной при бюджете около 1,56% от полного объёма KV. При этом в практических сценариях ShadowKV обеспечивает заметный прирост скорости и позволяет поддерживать существенно больший размер батча — за счёт снижения нагрузки на VRAM и уменьшения стоимости аттеншн на длинных контекстах.

Отдельно важно понимать, почему вообще имеет смысл оптимизировать именно аттеншн. Его вычислительная стоимость растёт с длиной последовательности, и на длинных контекстах он начинает доминировать по времени, тогда как FFN от длины контекста почти не зависит. Поэтому на коротких последовательностях в профиле часто доминирует FFN, и ускорение аттеншена даёт небольшой выигрыш.

Зато на длинных контекстах бутылочным горлышком становится аттеншн, и тогда по закону Амдала даже частичное ускорение этой части даёт заметную экономию общего E2E-времени инференса.

Разбор подготовил❣ Владислав Кругликов

Душный NLP
3 751 просмотров · 30 реакций Открыть в Telegram · Открыть пост на сайте
Ускорение E2E-инференса через оптимизацию KV-кэша. Часть I

Существует много способов ускорить инференс LLM: менять архитектуру, использовать speculative decoding или просто добавлять вычислительные ресурсы. Но есть и более практичный путь — оптимизация KV-кэша.

Её можно разделить на pre-train и post-train. Первые требуют изменений до обучения модели: это архитектурные решения вроде GQA/MQA/MLA, смешивание глобального и локального атеншена, а также другие модификации, которые обычно стоят дорого из-за переобучения.

Post-train-методы можно применять к уже готовой модели: это различные sparse-стратегии, pruning, удаление повторов токенов и другие техники, которые уменьшают объём KV или сокращают число обращений к нему во время инференса.

KV-бюджеты удобно делить на dense и sparse, отдельно для prefill и отдельно для decode. В варианте dense prefill + dense decode (обычный KV-кэш) каждый новый Q взаимодействует со всеми K и V до него: ко всем токенам промпта и всем ранее сгенерированным токенам. Тогда KV-бюджет равен сумме длины промпта и длины генерации.

Если сделать sparse только на prefill, а decode оставить плотным, то Q перестаёт смотреть на весь промпт, но общий выигрыш заметен в основном в сценариях «длинный промпт — короткий ответ». Если же оставить dense prefill и сделать sparse decode, это часто релевантно reasoning/CoT-сценариям. Sparse и на prefill, и на decode даёт максимальную экономию бюджета, но обычно сильнее всего ухудшает качество.

Sparse можно строить по-разному. Если пересчитывать важные токены на каждом шаге decode, то качество станет выше, но скорость падает. Если пересчитывать раз в несколько токенов, то получается быстрее, но нужно удерживать локальный контекст между пересчётами, иначе модель начинает терять связность.

Один из сильных post-train-методов оптимизации KV-кэша — ShadowKV, который позволяет получать минимальные просадки на бенчмарках без дообучения и увеличивает throughput до трёх раз. О нём мы подробно поговорим в следующей части.

Разбор подготовил❣ Владислав Кругликов

Душный NLP
5 209 просмотров · 42 реакций Открыть в Telegram · Открыть пост на сайте
🎄 Лучшие статьи 2025 года — выбор инженеров Яндекса

Miss me? Как и обещали, возвращаемся не с обзором, а с «кое-чем ещё», но не менее полезным. Мы попросили инженеров Яндекса, чьи разборы вы можете почитать в канале, поделиться (уже) прошлогодними статьями, которые им запомнились больше всего.

ToolOrchestra: Elevating Intelligence via Efficient Model and Tool Orchestration

Статья о маленькой модели (Qwen3-8B-Based), которая, по сути, выполняет функцию планера и роутера во вспомогательные инструменты (глобальный/локальный поиск), специализированные модели (вроде Qwen3-Coder) и модели общего назначения (GPT-5) для решения задач. Кроме того, модель обучена учитывать преференции пользователя по использованию тулов и размену качества на скорость и цену. С помощью обучения на несложной синтетике у авторов получается модель, которая даёт высокий скор на HLE, FRAMES, tau2-bench и при этом оказывается более cost-effective.

Stabilizing Reinforcement Learning with LLMs: Formulation and Practices

Обзор нескольких трюков по стабилизации обучения GRPO, ранее предложенных в других статьях. Авторы дают некоторые теоретические обоснования границ применимости этих методов, а затем проводят достаточно подробные экспериментальные подтверждения. Статья позволяет быстро погрузиться в тему проблем стабильности GRPO и попробовать применить эти методы на практике.

Artificial Hivemind: The Open-Ended Homogeneity of Language Models (and Beyond)

Исследователи из разных университетов изучили ответы моделей на запросы, допускающие ответ в свободной форме (вроде «в чём смысл жизни?» или «сочини стихотворение о времени»). Обнаружили, что ответы одной и той же модели, и совершенно разных, по форме и содержанию очень похожи. Известные техники повышения разнообразия — регулировка температуры или Min-p Sampling — не сильно помогают. Например, большинство моделей стали сравнивать время с рекой.

Вероятно, эффект обусловлен тем, что модели обучаются на похожих данных, собранных из интернета, или даже на синтетике, сгенерированной другими моделями. Кроме того, выяснили, что предпочтения LLM-as-a-Judge плохо коррелируют с оценками людей, особенно на примерах, где предпочтения асессоров расходятся.

Результат важен тем, что мотивирует принятие специальных мер для повышения разнообразия генераций больших языковых моделей.

DAPO: An Open-Source LLM Reinforcement Learning System at Scale

Авторы исследуют недостатки ванильного Deepseek GRPO и предлагают для них очень логичные практические решения, которые совсем несложно добавить к себе. А ещё очень классно, что они опенсорсят датасет и код обучения (который теперь доступен в фреймворке verl. Разбор статьи есть в канале.

Любопытными статьями поделились ❣ Владимир Платонов, Алексей Зотов, Денис Кузнеделев и Артём Харинаев

Душный NLP
5 036 просмотров · 19 реакций Открыть в Telegram · Открыть пост на сайте
🎄 Лучшее за год в Душном NLP

Снова это время — время подводить итоги! Собрали самые популярные посты в канале за 2025 год. Чтобы вспомнить крутое или наверстать упущенное. А если что-то крутое, из опубликованного нами, вам и так запомнилось, рассказывайте в комментариях. Будет интересно узнать, какие посты запали в душу.

Проблемы LLM-as-a-Judge и их решение

Авторы изучают LLM-as-a-Judge для оценки открытых ответов, сравнивают три схемы и предлагают решения возникающих проблем. В частности, можно менять пары ответов для оценки местами, чтобы не возникал position bias.

Технический отчёт Qwen2.5-Coder

Разбор техрепорта семейства моделей, предназначенных для генерации кода. В отчёте есть и о сборе датасета, и о DPO.

ICLR 2025

Сразу несколько постов с конференции ICLR — преимущественно с интересными постерами, но и без приколов не обошлось. Всех их вы можете найти по тегу #YaICLR. А по тегу #YaICML25 — найдёте посты, собственно, с ICML. Там тоже много любопытного!

GenARM — метод потокенного реворда

Авторы сделали потокенный реворд, чтобы использовать его в тест-тайме для генерации ответов. Предложенный метод по качеству и скорости инференса оказался лучше ARGS и Transfer Q.

Как обучить одну модель и получить несколько

Статья о методе MatFormer, который позволяет извлечь несколько «подмоделей» из одной большой обученной модели. Результат получается лучше, чем у LLM, натренированной с нуля.

С Новым годом, друзья! Желаем вам отлично провести праздники, а мы вернёмся совсем скоро — с новыми обзорами и кое-чем ещё.

Душный NLP
4 221 просмотров · 37 реакций Открыть в Telegram · Открыть пост на сайте
Подборка статей об альтернативах квадратичному селф-аттеншну

В последние годы всё больше обсуждают альтернативы классическому аттеншну — прежде всего из-за стоимости квадратичного скейлинга и работы с длинными контекстами. Ниже — краткий обзор нескольких любопытных работ и блогпостов на тему линейного, sparse- и гибридного аттеншна.

Why Did MiniMax M2 End Up as a Full Attention Model?

Начнём с поста от команды MiniMax. Их первая модель, MiniMax M1, была гибридной и использовала простой линейный аттеншн на матричных стейтах. Но во второй версии, MiniMax M2, они неожиданно вернулись к полному квадратичному аттеншну — даже без sliding window attention (SWA), который уже встречается в опенсорсных моделях.

Авторы говорят, что гибридная архитектура у них попросту не заработала. На классических текстовых бенчмарках всё выглядело приемлемо, а вот на агентских задачах — с кодом, итерациями и длинным контекстом — модель стабильно проигрывала. SWA тоже не помог: при дообучении моделей, изначально предобученных с полным аттеншном, ключевые головы не перестраивались и деградировали.

Итоговый вывод у MiniMax осторожный: линейные и гибридные подходы выглядят перспективно, но пока не хватает инфраструктуры, реализаций и бенчмарков. Поэтому на данный момент они остаются со стандартным трансформером и считают, что сначала нужно больше данных и экспериментов с длинным контекстом.

The Sparse Frontier: Sparse Attention Trade-offs in Transformer LLMs

В этой работе изучают training free sparsity в аттеншне и пытаются понять, что реально работает с точки зрения баланса compute/accuracy. На умеренных контекстах спарсификация аттеншна почти не помогает и часто ухудшает качество. На очень длинных — даёт выигрыш по FLOPs, но часто приводит к ухудшению качества: авторы замечают, что метод, работающий на одной задаче, ломается на другой. В среднем удаётся получить около 5× сжатия без сильной деградации качества, но разброс большой, особенно для маленьких моделей.

Evaluating Long Context (Reasoning) Ability

В следующем посте автор критикует популярные long-context-бенчмарки. Он говорит, что needle-in-a-haystack-like-задачи в основном проверяют ретривал и плохо отражают реальную (более сложную) работу с длинным контекстом. На более сложных задачах, где контекст нужно понять, а не просто найти факт (например, в длинном коде с логическими ошибками), модели начинают деградировать уже на десятках тысяч токенов — даже с Full Attention. Вывод: бенчмарков, которые реально проверяют ризонинг на длинном контексте, пока недостаточно.

Kimi Linear: an expressive, efficient attention architecture

Спустя неделю после скептического поста MiniMax Moonshot AI (авторы модели Kimi K2 и не только) выпустили работу с почти противоположным тезисом: Linear Attention работает. В Kimi Linear предложили Kimi Delta Attention с gated delta rule и рекуррентной матричной памятью. В модели используют соотношение 3:1 линейных слоёв к Full Attention. Качество на бенчмарках в статье не хуже полного аттеншна, а эффективность выше: prefill на длинных промптах быстрее примерно в три раза, декодинг и memory footprint тоже выигрывают за счёт меньшей зависимости от KV-cache.

Разбор подготовил ❣ Иван Рубачёв, а ещё он приглашает вас на семинары Yandex Research Reading Group

Душный NLP
6 024 просмотров · 37 реакций Открыть в Telegram · Открыть пост на сайте
Метод контекстного параллелизма Ulysses

Для обучения моделей на длинный контекст требуется много памяти под активации. Cкажем, чтобы обучить Qwen3-235B на контекст в 131 тысячу токенов, только под активации требуется более 100 ГБ, даже при использовании чекпоинтинга. Учитывая, что на карте надо хранить ещё саму модель, состояния оптимизатора и прочее, получается слишком много даже для GPU последних поколений. Что можно с этим сделать?

Большинство операций в трансформере (нормы, mlp, residual) над одним токеном происходят независимо от других. Это значит, что мы можем разбить нашу последовательность на N частей и обрабатывать каждую на отдельной GPU. Но у нас всё ещё остаётся селф-аттеншн, для подсчёта которого необходима вся последовательность. Так мы подходим к группе sequence- и context-parallel-методов вроде TPSP, Ring/ZigZag, Ulysses. Кратко расскажем о последнем.

В чём заключается идея:

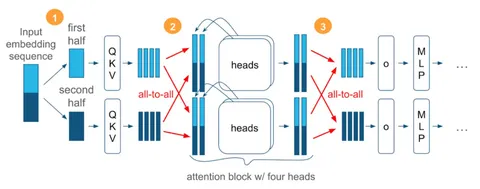
— каждая GPU внутри context-parallel-группы хранит и обрабатывает только часть последовательности;
— перед тем, как зайти в аттеншн, вычисляем QKV-проекции размера [local_seqlen, global_heads, head_dim];
— делаем all_to_all QKV-проекций и получаем тензор активаций размера [global_seqlen, local_heads, head_dim]. Таким образом, потребление памяти не изменилось, но теперь каждая GPU может вычислять селф-аттеншн независимо, потому что имеет всю последовательность (но только часть голов);
— после вычисления аттеншена и до output-проекции снова делаем all_to_all и снова получаем тензор, разбитый по длине последовательности.

Этот метод обладает серьёзными преимуществами:

— очень прост в реализации, но в то же время может быть эффективным при грамотном перекрытии вычислений и коммуникаций;
— независим от реализации аттеншна и при небольших модификациях работает в том числе с линейными вариантами. Также подходит для мультимодальных сценариев.
Но есть и ограничения. Например, размер CP-группы (Context Parallelism) не может быть больше количества query-голов. В случае GQA требуется копирование KV-голов до размера CP-группы. Кроме того, Ulysses становится довольно дорогим при межхостовых коммуникациях.

Инженеры Яндекса использовали этот метод в Alice AI. Ulysses позволил провести Midtrain-стадию обучения и увеличить контекст с хорошим ускорением за счёт перебалансировки нагрузки между процессами.

Разбор подготовил ❣ Антон Андрющенко

Душный NLP
3 882 просмотров · 31 реакций Открыть в Telegram · Открыть пост на сайте
Разное о scaling laws

Сегодня — сразу несколько статей о scaling laws. Но начнём с небольшого обзора сферы в целом.

Первая работа о scaling laws вышла в 2020 году. С тех пор многое изменилось, но авторам этой публикации удалось получить многие выводы, на которые впоследствии опирались другие исследователи и инженеры. В частности, один из ценных выводов — лучше получить большую, но не дообученную модель, чем маленькую и обученную до конца.

Через два года вышла статья Training Compute-Optimal Large Language Models, где, на примере модели Chinchilla доказали, что при меньшем размере можно получать более высокое качество путём увеличения количества данных. Это в некотором роде противоречит выводам первой публикации. При этом авторы Training Compute-Optimal Large Language Models проверяли scaling laws на моделях большего размера, чем исследователи в 2020-м.

В следующие годы появилось еще немало работ о scaling laws, авторы которых получали разные результаты. Кроме того, возникали разные scaling laws для соседних доменов.

Scaling Data-Constrained Language Models (2023)

В прошлых статьях по-умолчанию считалось, что токены — бесконечны. Авторы этой работы, напротив, предполагают, что данные когда-то закончатся или их изначально мало. В публикации задаются вопросами: имеет ли смысл повторять данные и чем их можно заменить?

В рамках эксперимента брали датасет, делили его на части, первую из которых — на 100 миллионов токенов — повторяли во время обучения несколько эпох. Выяснилось, что при повторении до четырёх раз качество модели растёт, а дальше — падает. Это справедливо для не очень больших моделей, в противном случае лосс будет увеличиваться. То есть, вывод такой: если у вас немного данных, лучше заняться обучением небольшой модели с повторением, чем тренировкой крупной LLM.

Говоря об увеличении уникальных данных, авторы статьи предлагают, в частности, вливать к текстовой информации код (в публикации это был код на Python) и использовать perplexity-filter. Это поднимает качество при использовании метода повторений, описанного выше.

Scaling Optimal LR Across Token Horizons (2024)

Статья Microsoft, в которой рассматривают, как перенести Learning Rate между обучениями с разным числом токенов. Эксперименты показали, что оптимальный LR при увеличении горизонта (собственно, числа токенов) меньше. Это справедливо даже если увеличивать размер батча (BS).

Predictable Scale: Part I, Step Law — Optimal Hyperparameter Scaling Law in Large Language Model Pretraining (2025)

Авторы исследуют проблему оптимального LR и BS при разном количестве параметров и токенов. Также проверяют, зависит ли scaling law от расписания LR и архитектуры модели. И выводят следующую формулу:

1.79N ^−0,713 * D ^0,307

Где N — число параметров, а D — количество данных в токенах. Что касается BS, то в публикации указывается, что оптимальный составляет 0,58D^0,571

В публикации сравнили две стратегии: decay (min_Ir = max_Ir / 10) и фиксированный min _Ir (в статье — 10^-5). Выяснилось, что оптимум смещается, но в целом закон выполняется. Такой же вывод получили, когда по-разному распределяли параметры внутри модели.

Душный NLP
5 499 просмотров · 29 реакций Открыть в Telegram · Открыть пост на сайте
Любопытная статья с NeurIPS 2025

Крупнейшая ML-конференция проходит сразу в двух местах: в Сан-Диего и Мехико. Руководитель группы AI-планирования робота доставки Дмитрий Быков находится в Мексике и делится с нами тем интересным, что видит на мероприятии. Слово Дмитрию.

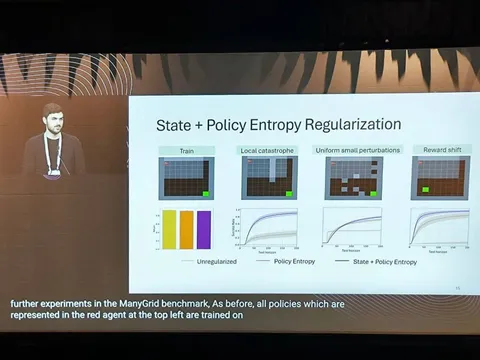
State Entropy Regularization for Robust Reinforcement Learning

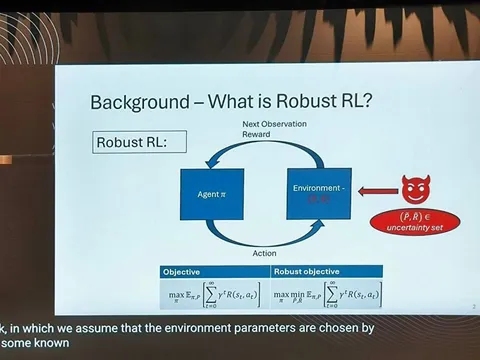
Статья о том, как сделать RL устойчивым. Под устойчивостью понимается, что модель корректно работает в худших кейсах, когда награды или переходы оказываются не такими, как при обучении.

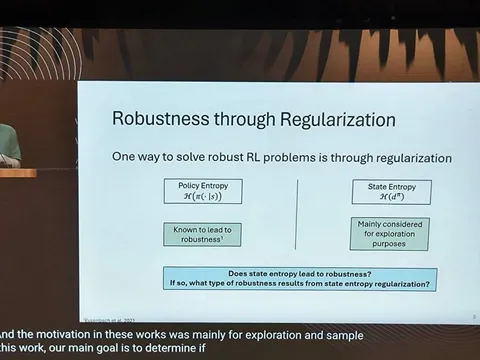
Авторы утверждают, что регуляризация энтропии политики (policy entropy) приводит к тому, что весь эксплорейшен сосредоточен вокруг оптимальной траектории. Поэтому, выходя за её пределы, модель оказывается в незнакомой для себя ситуации. Регуляризация энтропии стэйта (state entropy), в свою очередь, вознаграждает агента за то, что он проходит по тем состояниям, в которых не был.

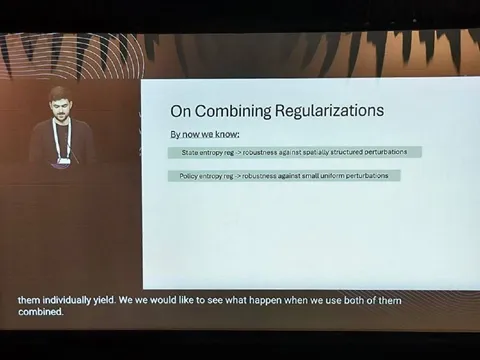
В статье предлагают использовать регуляризации обеих энтропий, чтобы учиться быть устойчивыми и к большим, и маленьким изменениям. При этом я не заметил сравнения вариантов отдельных регуляризаций против двух вместе.


Больше интересного с NeurIPS ищите в наших каналах ML Underhood, 404 Driver Not Found и CV Time по хештегу #YaNeurIPS25.

Душный NLP
3 304 просмотров · 27 реакций Открыть в Telegram · Открыть пост на сайте
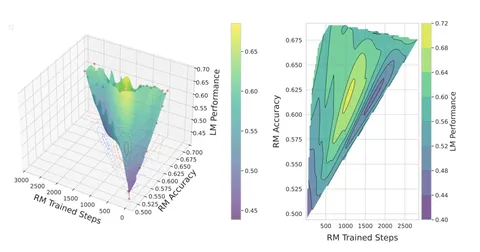
Как заставить reasoning-модели меньше галлюцинировать (часть II)

Продолжаем разбирать статью Learning to Reason for Factuality. В первой части рассказали о проблеме и самом методе, а сегодня — о результатах и интересных выводах.
Оценка происходила на шести сложных бенчмарках фактологических ответов: LongFact, FAVA, AlpacaFact, Biography, FactBench-Hard и Factory-Hard.

Базовая Llama-3.1-8B даёт в среднем 45% фактической точности и 23,5 подтверждённых факта на ответ. После полного пайплайна (SFT + online GRPO с новым ревордом) модель достигает 68,1% фактической точности (Pre), при этом детальность ответа (Dtl) возрастает до 29%, а релевантность - составляет ~54%. Таким образом, в описанном сетапе ризонинг-версия модели стала меньше галлюцинировать без потери полезности относительно своей не-reasoning-версии.

В отличии от online-RL-сетапа «SFT + DPO»-эксперимент сильно просаживает полезность ответа, при примерно таком же качестве детальности (Dtl) и фактической точности (Pre) (сравнивая с SFT + GRPO). Это делает предложенный авторами подход довольно актуальным.

Кроме того, авторы попробовали определить meta-reasoning-страгении в CoT-рассуждениях модели. Для этого использовали Llama-3.1-70B-Instruct. Выяснилось, что стратегии ризонинга для повышения фактологичности ответов модели сильно отличаются от стратегий, которые используются в решении математических и кодинг-задач.

Так, например, наиболее частые стратегии решения математических задач — self-verification, exploration, calculation and backtracking, в то время как для описанного online-RL-подхода основными стратегиями являлись: synthesis, summarization, explanation, evaluation. Этот факт может быть одной из причин большего галлюцинирования ризонинг-моделей, которые обучаются в RLVR-сетапе на задачах математики и кода, на запросах, требующих фактологической точности.

Разбор подготовил ❣ Дмитрий Масный

Душный NLP
4 124 просмотров · 14 реакций Открыть в Telegram · Открыть пост на сайте
Как заставить reasoning-модели меньше галлюцинировать (часть I)

Авторы сегодняшней статьи пытаются ответить на вопрос: можно ли обучить стратегии рассуждения, повышающие фактическую точность (R-)LLM? Отмечено, что reasoning-модели решают математические задачи и пишут код, но в длинных фактологических ответах галлюцинируют больше, чем обычные не-reasoning-версии этих же моделей.

Так, например DeepSeek-R1 и QwQ-32B выдают на 10–13 п.п. больше галлюцинаций, чем соответствующие базовые не-reasoning-версии DeepSeek-V3 и Qwen-2.5-32B на шести датасетах, созданных для проверки фактологичности длинных ответов. В первой части разбора обсудим проблему, заявленную в статье, и метод, предложенный авторами. А во второй — результаты и некоторые выводы.

Проблема в том, что стандартный RL для reasoning-моделей заточен под верифицируемые задачи, для которых награда вычисляется по заранее определённым правилам и проверку которых можно автоматизировать (математика, код). А для ответов, содержащих фактологическую информацию, не существует ни надёжной автоматической проверки (как в RLVR), ни возможности звать человека для проверки.

Эти трудности сильно ограничивают использование фактчек-сигнала в алгоритмах online-RL. Попытки автоматизировать фактчек с помощью FActScore/VeriScore в online-RL-сетапе приводят к «хакингу награды»: модель начинает писать слишком кратко (меньше фактов — меньше шансов ошибиться) или выдаёт длинный, но слабо связанный с вопросом поток общих, пусть и верных, сведений.

Так можно ли обучить стратегии рассуждения, повышающие фактическую точность (R-)LLM? Чтобы ответить на вопрос, авторы используют следующий подход.

Для получения обучающих промптов предлагают интересный ход: инженеры генерируют промпты с помощью Llama 4, обуславливая её на два множества grounding-промптов. Первый набор — WildChat (разнообразные реальные запросы пользователей), второй — LongFact (запросы, требующие фактологически точных ответов). Таким образом получается собрать порядка 7 тысяч синтетических промптов: 3 тысячи для SFT, 4 тысячи для RL, которые похожи на реальные запросы пользователей и в то же время требуют фактологически точных ответов.

Затем делают SFT: фью-шотят базовую Llama-3.1-8B-Instruct для генерации 10 Long-CoT-ответов в формате <think>…</think><answer>…</answer>, их прогоняют через VeriScore и берут ответ с наибольшей наградой за фактологическую точность.

Затем в качестве бейзлайна используют DPO: для сбора пар для обучения аналогично методу в SFT используется VeriScore c небольшой модификацией — берутся пары ответов с максимальной дельтой награды VeriScore и удовлетворяющие условиям:

1) дельта награды должна быть выше определённого порога, чтобы фактчек-сигнал был достаточно сильным;
2) разность длин ответов должна быть меньше определённого порога, чтобы не было «хакинга длины».

Для онлайн-RL в качестве нововведения предлагают награду, которая состоит из трёх слагаемых:

— фактическая точность (Pre): F/(T+1), где F — число подтвержденных фактов, T — всего найденных фактов в ответе (извлекаем их с помощью LLM) (для штрафа за фактологически неверные ответы);
— детальность (Dtl): log(1+F) — поощряет больше правильных фактов, но с дисконтированием на длину (для штрафа за слишком короткие ответы);
— релевантность/полезность (WR): LLM-as-a-judge-метрика — ответ политики сравнивается с ответам реверенсной модели, если судья считает, что ответ политики лучше, то метрика принимает значение 1, в противном случае — 0 (для штрафа за наличие нерелевантных верных фактов).

Чтобы такой reward можно было считать в онлайне, сильно оптимизируют VeriScore: батчуют извлечение фактов, параллелят веб-поиск и так же батчуют проверку утверждений поверх поисковой выдачи. Это позволяет сократить время инференса реворда с двух минут (базовый сетап VeriScore) до примерно пяти секунд на один ответ, что уже пригодно для online-RL. Полученный подход уже используют в GRPO-алгоритме в качестве модели награды.

Разбор подготовил ❣ Дмитрий Масный

Душный NLP
3 383 просмотров · 30 реакций Открыть в Telegram · Открыть пост на сайте
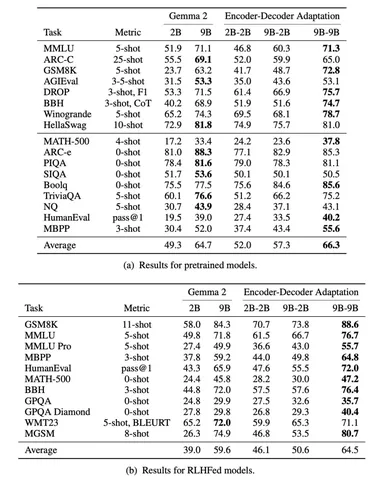
Оценка реворд-моделей

Сегодня разберём оценку реворд-моделей (RM). Стандартная метрика в этой сфере — accuracy на парах предпочтений из тест-сета. Оценка реворд-моделей нужна как прокси для end-to-end (e2e) RLHF, потому что для каждого эксперимента обучать модель по реворду — это слишком дорого. К тому же качество e2e не всегда связано напрямую с качеством RM из-за большого количества параметров RLHF-обучения.
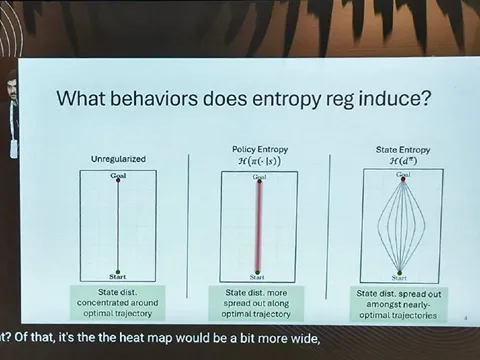
В экспериментах с RM нередко применяют синтетический сетап: вместо истинной награды (которую в реальном мире обычно дают люди) используют «сильную» RM. Её предсказания принимают за Golden Reward, а в рамках экспериментов обучают Proxy RM, которые максимально приближают Golden — это существенно снижает стоимость исследований.

Одна из работ на тему оценки RM — The Accuracy Paradox in RLHF, авторы которой обучили отдельные реворд-модели (Longformer-base-4096) на одну из трёх задач: релевантность, полнота и фактологичность, таргеты которых собирались через Golden RM. Дальше под каждую модель обучали RLHF и смотрели на конечное качество. Выяснилось, что максимальное значение accuracy RM не обязательно ведёт к высокому е2е-качеству во всех трёх задачах. На первом графике видно, что оптимальное качество (жёлтый цвет) соответствует среднему значению accuracy.

Для проверки RM используют бенчмарки — например, RewardBench 2. В нём шесть доменов, включая математику, следование инструкциям, безопасность, фактологичность и так далее. Для сравнения на каждый промпт предоставляется один правильный и три неправильных ответа (best-of-4 accuracy).

Эксперименты создателей RewardBench 2 показали, что, вопреки распространённому мнению, RM имеет смысл обучать больше одной эпохи — это даёт рост в качестве. Кроме того, разработчики бенчмарка заключают, что качество растёт, если RM и Policy из одного семейства — например, Llama. А вот чего делать не стоит, так это использовать в RLHF промпты, которые не «видела» реворд-модель (звёзды на изображении 2).

Авторы статьи What Makes a Reward Model a Good Teacher? An Optimization Perspective предлагают смотреть не только на accuracy, но и на дисперсию реворда. Чем она выше, тем быстрее модель оптимизируется под gold reward — то есть, эталонную оценку (изображение 3). Вывод опять-таки следующий: высокая accuracy не ведёт к высокому е2е-качеству.

Разбор подготовил ❣ Артём Харинаев

Душный NLP
3 046 просмотров · 30 реакций Открыть в Telegram · Открыть пост на сайте