Технический отчёт DeepSeek-V4.1-Flash — часть 2/2

Продолжаем разбирать техрепорт DeepSeek-V4.1-Flash. Сегодня поговорим об архитектуре, а ещё речь пойдёт об обучении. 

В SWA прогоняется не весь контекст, а только последние 128 токенов для построения начального SWA KV. Это не сильно влияет на качество, но позволяет уменьшать общий размер кеша в восемь раз по сравнению с тем, что было у DeepSeek-V4-Flash.

Также в версии 4.1 используется Single-Pass mHC. mHC — Manifold-Constrained Hyper-Connections — вариант hyper-connection, в котором спектральная норма всех проекций равна единице. В варианте Single-Pass матрица смешивания вычисляется по прошлому слою и не зависит от текущих активаций. Благодаря этому, её можно зафьюзить в один кернел и получить ускорение, а также снизить трафик активаций. 

Engram со 196 миллиардами параметров «лежит» в энкодере на первом и 14-м слоях, поделённый поровну. Для хранения N-грам используются восемь независимых кеш-голов, в каждой из которых примерно 16 миллионов записей. При этом «нагрузка» распределена неравномерно — чтобы уменьшить коллизии берутся простые числа, близкие к 16 миллионам. Сами N-грамы хранят в FP8. Из исходного Engram убрали каузальную свёртку, потому что она осложняла инференс. 

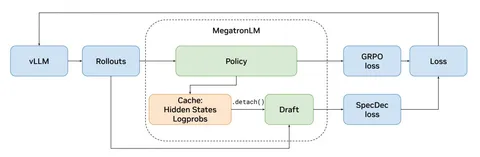
В DeepSeek-V4.1-Flash вместо MTP используют DSpark. Он внедряется на этапе генерации роллаутов, и DSpark динамически обновляется под меняющуюся политику. KV-кеш хранят в формате NVFP4. Кеш квантуется после RoPE, потому что так удобнее инферить и это избавляет от необходимости накладывать RoPE на квантизованный кеш. Для SWA KV кеш делают в FP8, но он достаточно лёгкий, поэтому не сказывается на скорости работы. 

Что касается инфраструктуры, то зрительный энкодер запускается отдельно, чтобы не тормозить языковой конвейер. Батчи накладывают так, чтобы они распределялись равномерно по числу токенов, ведь на входе могут быть изображения как высокого, так и низкого разрешения. 

Декодирование почти не дорожает с ростом контекста — подорожание с 4К токенов до 1М составляет примерно 25%. 

При сборе данных для обучения отфильтровывали слабый синтетический машинный перевод и старую информацию — старались брать свежие данные. В мультимодальный набор вошли пары изображения-текст и документы. В итоге вышло примерно семь токенов текста на один мультимодальный. 

На претрейне было 45 триллионов мультимодальных токенов. Батч составлял 100,6 миллиона токенов, а контекст увеличивали с 64 тысяч до миллиона, снижая LR. По качеству рассуждений и выполнению задач, связанных с программированием, после претрейна 4.1-Flash сопоставим с V4-Pro-Base.

На посттрейне — стандартный SFT, объемный RL с большим числом сред и синтетическими задачами. Для тренировки агентского поведения брали агентские задачи из открытых источников, а также генерировали синтетические — имитации корпоративных систем, их ошибок. Большее число RL-шагов позволило получить лучшие результаты в стандартных бенчмарках на кодинг вроде SWE-Bench Pro и DeepSWE.

Сам RL — асинхронный. Роллауты генерируются независимо и подаются в модель по готовности. Токены с чрезмерной давностью маскируются в лоссе, чтобы избежать off-policy. 

В финале посттрейна проводят On-policy-дистилляцию. Здесь более 40 моделей-учителей, каждая из которых отдельно проходила этап посттрейна. Учителя асинхронно генерируют траектории. Данные ученику подаются динамически от разных учителей, что позволяет получить лучшее качество. 

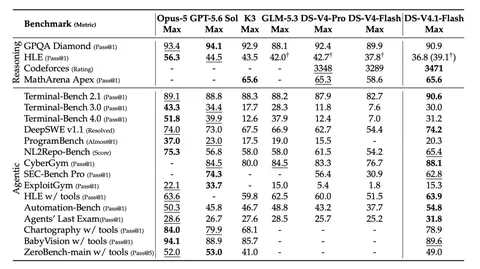
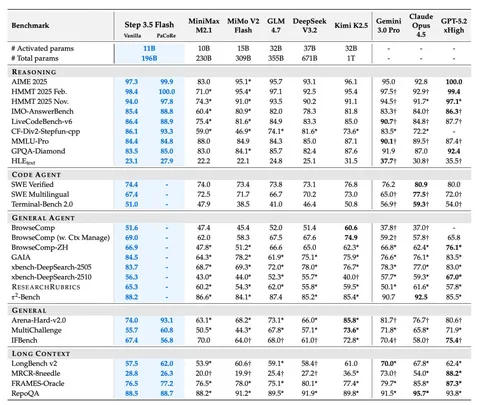
По бенчмаркам DeepSeek-V4.1-Flash на агентских задачах примерно равен Opus-5. Однако авторы отмечают уязвимости сред оценки и сообщают, что модели могли произвести reward hacking. Результаты можно посмотреть в таблице выше. 

Разбор подготовил ❣ Денис Кузнеделев

Душный NLP
1 158 просмотров · 16 реакций Открыть в Telegram · Открыть пост на сайте
Технический отчёт DeepSeek-V4.1-Flash — часть 1/2

Разберём технический отчёт DeepSeek-V4.1-Flash. В первой части обсудим архитектуру модели. Главное достижение авторов — экстремальное сжатие KV-кеша. При стандартном для frontier-моделей максимальном контексте в миллион токенов глобальный KV-кеш на один токен составляет 890 байт, что делает инференс даже максимального числа токенов почти бесплатным (менее одного гигабайта в сумме). 

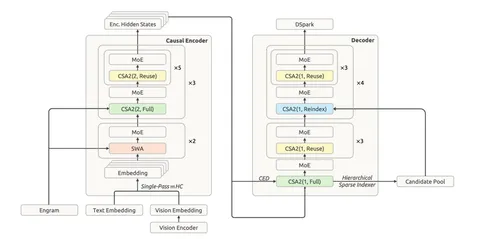
В архитектуре DeepSeek-V4.1-Flash каузальные энкодер и декодер, у каждого по 20 слоёв. Энкодер-декодер-архитектура выбрана не случайно: это помогает экономить вычисления. Нижняя половина слоёв формирует глубокое представление префикса, на которое затем аттендится декодер. В случае короткого промпта это позволяет в среднем в два раза сократить стоимость вычислений. 

DeepSeek-V4.1-Flash — MoE-модель на 552 миллиарда параметров, плюс 196 миллиардов в Engram. На префилле активируются 8 миллиардов параметров, а на декоде — 16 миллиардов. Размер скрытого представления — 5120; количество аттеншн-голов — 64. Есть sliding window attention, один shared-эксперт и 384 маршрутизируемых. На один токен активируются шесть экспертов. 

Кроме того, с самого начала обучения использовались изображения, так что модель — нативно мультимодальная. Изображение проходит через DeepSeek-ViT (32 слоя, 2D-RoPE), далее применяется pixel unshuffle 3х3, MLP-проектор, и всё это перегоняется в текстовый эмбеддинг. Вместо привычной свёртки для отображения пикселей в токены применяется линейный слой, что даёт возможность использовать Muon. 

Как работает каждый из компонентов. На префилле энкодер делает полный проход по префиксу. На декоде глобальный KV-кеш проецируется из скрытого представления последнего, двадцатого слоя энкодера. Хидден подаётся не напрямую, а отображается layer-specific-проекциями. Это позволяет экономить на кеше в декодере.

Ещё одна важная особенность модели — Compressed Sparse Attention 2 (CSA2) в нескольких режимах, против CSA и Heavily Compressed Attention (HSA) в базовой DeepSeek-V4-Flash. О том, что такое CSA и HSA, мы писали вот тут, а в этом разборе сосредоточимся на режимах CSA2. Всего их три: 

— Full Mode — вычисляем полный KV-кеш и делаем полный аттеншн, но оставляем возможность определять важные и неважные токены, имея некие индексы. На части хороших кандидатов аттендимся сразу, а часть — 16 тысяч — передаём дальше. 
— Reindex Mode — аттендимся на KV-кеш из Full Mode, выбираем из переданного пула хороших токенов своих кандидатов.
— Reuse Mode — переиспользуем Top-K-индексы от Full Mode. Самый частый блок: 15 из 20 и на префилле, и на декоде. 

Во второй части продолжим разговор об архитектуре, а также затронем претрейн и посттрейн.

Разбор подготовил ❣ Денис Кузнеделев

Душный NLP
2 184 просмотров · 26 реакций Открыть в Telegram · Открыть пост на сайте
Дистилляция DeepSeek-R1

Сегодня разберём, как DeepSeek-R1 на 671B параметров дистиллировали в модель на 32 миллиарда параметров. Зачем вообще это нужно? Вышедшая в сентябре 2024 года o1 доказала, что test-time scaling работает — если дать модели подумать, то она даст более качественный ответ. Однако тогда пользователю не показывали сырую цепочку рассуждений, а особенности метода не раскрывали. Было непонятно, как это работает, хотя догадки имелись: например, использование process-reward-модели и поиск по дереву. 

Но эксперименты DeepSeek показали, что дело совсем не в них. Компания выложила технический отчёт, в котором раскрыла секрет. В работе рассматривают три модели: R1-Zero, R1 и R1-Distill. О первых двух мы подробно писали вот тут, а сегодня речь пойдёт о третьей модели. 

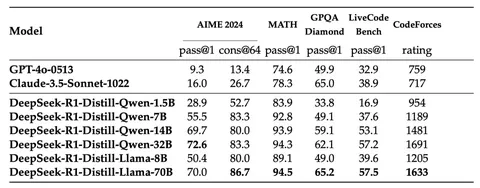
Всего выложили шесть моделей — от 1,5В до 70В параметров на базе Qwen2,5 и Llama3. Все они без RL, использовали только SFT, две-три эпохи по 800К примеров. Контекст составил 32К токенов, а архитектуру моделей не трогали вообще. Ключевая идея авторов в том, что самое дорогое в ризонинг-моделях — не веса, а траектории рассуждений. Их достаточно один раз добыть с помощью RL на большой модели и скопировать в «ученика». 

Авторы взяли промпты в четырёх основных — математика, код, STEM, логика — и одном общем домене, куда вошли перевод, письмо и так далее. Далее сгенерировали примеры с помощью R1, но не финальной, а с чекпоинта после cold-start SFT и первой стадии RL. Потом сделали rejection sampling, отобрав верные ответы, а затем отфильтровали, выбросив цепочки рассуждений со смешением языков или длинными абзацами. Следом — SFT. 

У всех моделей-учеников был один и тот же рецепт, но разные стартовые LR — чем больше LLM, тем он меньше. Обратите внимание, что значительную часть датасета составляли математика и код (76%), поэтому дистиллированные модели лучше всего показывают себя в этих доменах. Отметим также, что в основе учеников на 1,5В и 7В параметров лежала Qwen2.5-Math, которая уже хорошо работает с математикой. 

В итоге DeepSeek-R1-Distill-Qwen-32B удаётся обходить о1 практически по всем бенчмаркам. Также модель соответствует учителю примерно на 91% — и это при 20-кратном сжатии числа параметров, а также переходе от MoE-архитектуры к dense. 

Авторы делают вывод, что дистилляция мощной модели в маленькую даёт неплохие результаты, однако превзойти учителя ученик как ни крути не сможет. Дистилляция не даёт модели генерировать собственные траектории лучшего качества. И хотя тренировать учителя дорого — финальный прогон R1 у DeepSeek стоил 247 тысяч долларов, — стоимость каждого ученика вполне разумная, ведь требуется только две-три эпохи на готовом датасете. 

Разбор подготовил ❣ Алексей Петраков

Душный NLP
2 933 просмотров · 31 реакций Открыть в Telegram · Открыть пост на сайте
Loop the Loopies!

Сегодня обсудим статью, которая посвящена моделям Loopies, построенным на шеринге параметров между разными слоями. 

Обычно у трансформерных моделей и свёрточных нейросетей отдельные параметры на каждом блоке, благодаря чему объём вычислений и число параметров масштабируются с глубиной. Это даёт гибкость — каждый блок может выполнять специфические задачи. Но при этом с ростом числа слоёв растёт и количество параметров, а значит, модель становится дороже хранить. 

Выходом из этой ситуации может стать переиспользование весов по несколько раз за форвард — шеринг параметров. Так не нужно хранить много параметров, однако блок может принимать распределение данных с разной глубины, что усложняет задачу оптимизации. 

Перспективность шеринга первым доказал метод ALBERT. В нём было два механизма: факторизация матрицы эмбеддингов и переиспользование одного трансформенного блока несколько раз. На этом принципе работают looped-модели — hidden state в них прогоняется R раз через один и тот же блок. Число параметров становится меньше, а количество вычислений не меняется. 

Рекуррентность имеет и другие преимущества: hidden state проходит несколько шагов улучшения, эффективная глубина растёт без увеличения размера модели. В перспективе число шагов можно адаптировать под сложность запроса — если он простой, то прогонять один раз, а если сложный, то больше. Рекуррентность хорошо показывает себя на алгебраических задачах и задачах, связанных с пазлами.

Однако сравнения looped-моделей с не-looped-аналогами были не совсем честными. При том же размере модели делаются R прогонов, а, следовательно, в R раза больше вычислений. Соответственно, и обучать такую модель дольше. В плане оптимальности компьюта looped-модели уступали обычным трансформерам. 

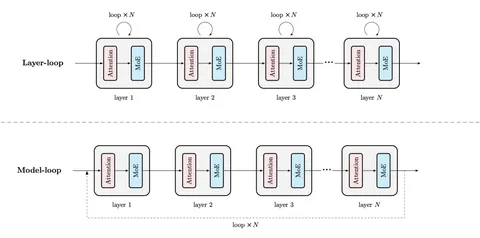
Авторы серии Loopie предлагают две модели: Loopie-20B-A2B и Loopie-6B-A0.6B. Архитектурно это Qwen3. В отличие от решений прошлого, здесь не вся модель прогоняется несколько раз, а каждый слой (верхняя схема на изображении 1). В пределах одного блока активации меняются не так сильно, к тому же это проще для чекпоинтинга. Также такой метод даёт потенциально большую гибкость: можно делать разное количество проходов на каждом слое. 

Подход layer-loop проще для распределённого обучения, потому что повторения слоя остаются в одном pipeline stage, а параметры градиента могут использоваться локально. В то же время model-loop требует, чтобы вычисления синхронизировались внутри всей модели а первый блок должен уметь обрабатывать один или несколько полных проходов через модель. 

Претрейн состоял из двух стадий. Сперва используют датасет Nemotron-CC-v2-HQ, а дальше дообучают на более качественных данных, делая упор на синтетику, STEM, код, математические рассуждения и веб-данные. Так получается базовая Loopie. На неё делают Supervised Pre-Training (SPT). Это похоже на SFT, лосс считается только по target-токенам, однако масштаб — как у претрейна: 2Т токенов. Контекст увеличивают и обучают довольно большими батчами примерно по 128М токенов. SPT, как отмечают авторы, улучшает способность модели к рассуждению. 

На RL сначала делают математику, а потом программирование. Используют GSPO, ассиметричный клиппинг и динамическую фильтрацию промптов. Роллаут увеличивают с 32К до 64К. 

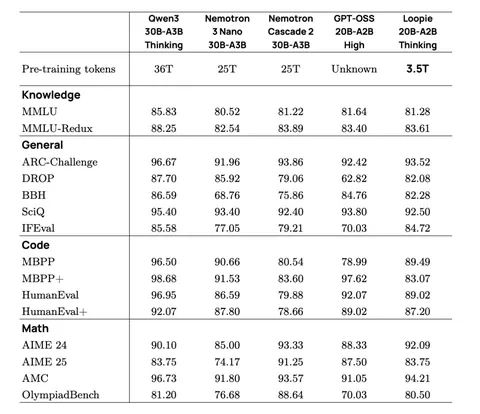
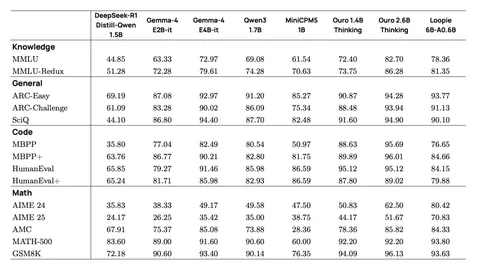
По бенчам Loopie-20B примерно сопоставима с моделями вроде Qwen3, Nemotron 3 Nano и GPT-OSS (изображение 2). Казалось бы, не слишком большое достижение для 2026 года, однако стоит помнить, что у Loopie намного меньше параметров. Loopie-6B в своей «весовой категории» также показывает себя достойно — особенно в задачах, связанных с математикой (изображение 3).

Разбор подготовил ❣ Денис Кузнеделев

Душный NLP
2 476 просмотров · 28 реакций Открыть в Telegram · Открыть пост на сайте
Context-1 — поисковый агент, который умеет избавляться от лишнего. Часть 2/2

Продолжаем изучать агент Context-1. В первой части мы рассмотрели, что это вообще такое и какие задачи перед собой ставили авторы. А в этой части поговорим о метриках и обучении.

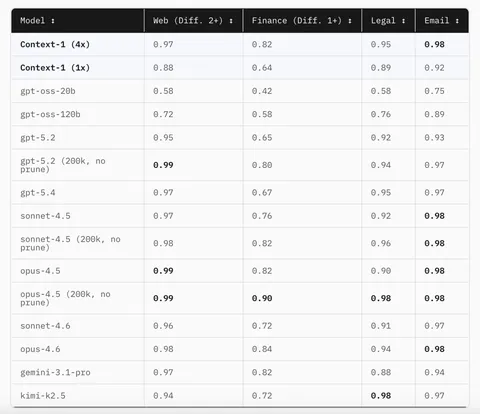
Для оценки качества ответа авторы предлагают использовать четыре метрики: Final answer found (смогла ли модель найти документ с правильным ответом в выдаче), Recall (доля релевантных документов, которые выбрала модель, от общего числа релевантных документов), Precision (число релевантных документов, которые модель отвергла) и FB (среднее гармоническое Recall и Precision; идея авторов в том, чтобы штрафовать модель за отбор нерелевантных документов только под конец обучения). Также предлагают рассматривать Trajectory recall, оценивая качество траекторий и поощряя модель за отбор нужных документов и не награждая чрезмерно за случайное нахождение верного ответа. 

На SFT авторы генерировали некоторое количество траекторий с помощью Kimi K2.5. Дальше заводили RLVR на модели gpt-oss-20b с LoRA. Вместо GRPO применяют CISPO — модификацию, которая позволяет лучше бороться с энтропийным коллапсом. Что касается реворда, то здесь на модель накладываются два штрафа: за уменьшение контекста несколько раз подряд и за количество шагов (если их больше 64).

В результате модель научилась чаще работать с параллельным вызовом инструментов и лучшему прунингу в сравнении с базовой gpt-oss-20b. А число шагов в траекториях сократилось. С результатами по четырём доменам — веб, финансы, юридическая информация и электронная почта — можно ознакомиться в первой таблице. 

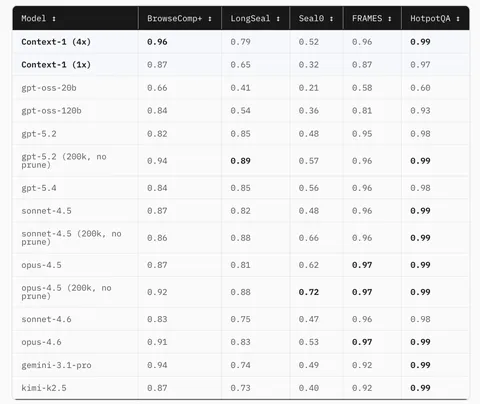
Обратите внимание, что Context-1(4x) — это конфигурация, на которой запущено сразу четыре агента, а результаты их выдачи объединены с помощью метода Reciprocal Rank Fusion. Авторы отмечают, что даже в таком случае требуется меньше ресурсов, чем на запуск крупных моделей. Что же касается опенсорсных бенчмарков (таблица 2), то тут оценивалось, есть ли финальный ответ в документах, которые выбрала модель. 

В финале авторы отмечают, что им не хватает разнообразия задач — все они представляют собой таски вида «найди что-то в ворохе документов». Также в работе говорится, что потенциально к используемым инструментам можно добавить и тулы для написания кода, и оркестратор. Наконец, предлагается поработать над менеджментом контекста: например, сохранять какое-то минимальное количество информации из выкинутых документов или суммаризировать большие страницы. 

Разбор подготовил ❣ Владислав Пыж

Душный NLP
3 173 просмотров · 15 реакций Открыть в Telegram · Открыть пост на сайте
Context-1 — поисковый агент, который умеет избавляться от лишнего. Часть 1/2

Авторы сегодняшней статьи заявляют следующую проблему. Когда агент ищет что-то в поиске, то нерелевантные страницы, выданные браузером, всё равно остаются в контексте агента. Чтобы справиться с этим, контекст можно обрезать или суммировать.

Ещё одно весьма перспективное направление в этой области — self-editing context, при котором модель сама определяет, что ей нужно для решения задачи и может отбрасывать бесполезные документы. Этот подход авторы статьи и берут за основу своего субагента Context-1, построенного на модели в 20B параметров.

В его арсенале есть четыре инструмента. Первый, search_corpus(query), позволяет оценивать релевантность документа: отбирается 50 документов, ранжируются, самые подходящие отправляются модели в рамках доступного бюджета токенов. Инструмент grep_corpus(pattern) проводит поиск с помощью регулярных выражений, read_document(doc_id) нужен, чтобы прочитать документ.

Самый интересный из инструментов — prune_chunks(chunk_ids), который даёт модели возможность убрать какие-то фрагменты из контекста с сохранением траектории. После каждого шага модели сообщается, сколько токенов у неё осталось. Когда контекст заполнен наполовину, модель советуют освободить его, — но только на обучении, не на инференсе.

После преодоления какого-то порога по токенам, модель начинает получать отбивку о необходимости почистить контекст на каждый запрос вызова инструментов для получения новых документов. В этом случае модель либо должна выдать ответ, либо запустить prune_chunks(chunk_ids).

Авторы придумали, как генерировать синтетические данные для RL с возрастанием по сложности. Генерация происходит в пять стадий:

Gather supporting documents — сбор сопутствующих документов, которые содержат уникальные факты на основе заданного сида. В статье приводится пример с сидом «Синагоги в Брюсселе», по которому модель собрала факты вроде «Синагоги выполнены в романо-византийском стиле».

Generate clues (obfuscated references to facts) — собранные на первом этапе факты встраиваются в одну задачу, загадку, где разные сущности заменены фактами. Так, вместо, собственно, «синагога» в этом тексте будет сказано «религиозные сооружения в романо-византийском стиле».

Verify that the task is valid — этап проверки, что в сопутствующих документах есть подсказки, ведущие к ответу. То есть в каком-то из документов должно быть прямо сказано, что «синагога — это религиозное сооружение в романо-византийском стиле». Проверка осуществляется не с помощью LLM, а просто кодом на Python.

Optionally, collect distractors — опциональное добавление в базу документов-дистракторов. Важно, чтобы они не только вели модель по ложному пути, но и случайно не содержали правильных ответов.

Optionally, recursively chain — опциональная генерация задач, которые связаны с прошлыми задачами. Так получается синта, которую нужно решать в несколько шагов.

Во второй части поговорим об обучении и результатах.

Разбор подготовил ❣ Владислав Пыж

Душный NLP
3 278 просмотров · 15 реакций Открыть в Telegram · Открыть пост на сайте
Как агенты оценивают собственный успех

Представим ситуацию: инженеру нужно починить баг в сервисе аутентификации с помощью кодового агента. До начала работ агент сообщает, что вероятность успеха — 72%. По ходу работы меняет мнение на 78%, после всех изменений — 92%, а какой-нибудь AI-ревьюер пророчит положительный результат с вероятностью 85%. Однако по итогу патч, сделанный агентом, не работает — то есть прогнозы оказались неверны. Сегодняшняя статья о попытках избежать подобного.

Авторы вводят понятие agentic uncertainty — это оценка агентом вероятности, что другой агент на той же самой модели решит задачу. С этим понятием рука об руку идёт ещё одно — probability that I succeed (P(IS)), которое включает умения и знания, необходимые для решения задачи. Это целая траектория, так что P(IS) нельзя заложить в веса модели.

В работе ставили эксперименты на 100 задачах из SWE-bench Pro. Агенту давали репозиторий и описание проблемы. «Испытуемый» писал патч, дальше следовали тесты. Сравнивали три модели: GPT-5.2-Codex, Gemini 3 Pro и Claude Opus 4.5. Важно, что агент, который решает задачу, и агент, который оценивает результат, были построены на одной и той же модели и отличались только системным промптом и доступом к информации.

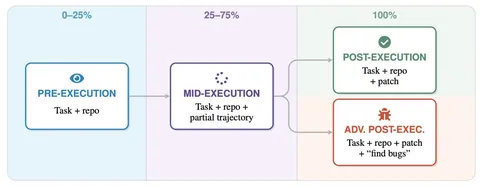
У оценщика было четыре режима опроса:

Pre-execution — только описание задачи и репозиторий на чтение. Запускать код и править файлы нельзя.

Mid-execution — агента спрашивают, как идут дела, по ходу выполнения задачи — после 25%, 50% и 75% шагов.

Post-execution — агент-оценщик получает описание задачи, а также уже пропатченный решателем репозиторий, и оценивает корректность выполнения.

Adversarial post-execution — то же самое, что и в предыдущем пункте, но с другим промптом: «Твоя работа найти проблемы, краевые случаи, режимы отказа». То есть задача ставится не просто проверить решение, а именно найти проблемы.

Результаты тестов показывают, что все модели переоценивают свои силы: на проваленных задачах агенты прогнозировали успех в 62%, а на правильно выполненных сомневались в себе в 11% случаев. То есть агенты в 5,5 раза чаще уверены, что у них всё получится.

Интересно, что pre-execution-агент, который не видел патча, лучше прогнозирует провал или успех, чем тот, который уже видел решение. Автор объясняют это тем, что, увидев патч, агент цепляется за его поверхностную правдоподобность и перестаёт думать о сложности задачи.

В mid-execution уверенность падает по ходу выполнения и вне зависимости от того, чем всё закончилось. Причём у Claude уверенность падала сильнее, когда задача решалась правильно.

Adversarial post-execution с его «найти проблемы» действительно справляется с прогнозированием успеха лучше, чем просто post-execution. Доля самоуверенных оценок с adversarial падает с 72% до 45%. Однако такой подход дороже и дольше: 23,4 шага и 0,52 цента против 12,7 шага и 0,23 центов у обычного ревьюера.

Авторы отмечают, что изменение калибровки может быть просто механическим сдвигом всех оценок вниз — при низком базовом уровне успеха любой сдвиг вниз улучшает калибровку. И это действительно так: у GPT одинаково занижаются и успешные, и неуспешные траектории. Для Claude и Gemini, впрочем, сигнал оказался настоящим.

Авторы также проверили, не завышают ли агенты оценку, когда видят собственное решение. Чтобы подтвердить это или опровергнуть, результаты дали на проверку разным моделям. GPT действительно завышает оценку на своих патчах, а Gemini, наоборот, прогнозирует более вероятный успех GPT.

Напоследок отметим, что хоть результаты в статье и показательны, стоит помнить, что авторы изучали только задачи программирования, то есть как обстоят дела на доменах с размытыми критериями — непонятно. Кроме того, было всего 100 задач, что не слишком много, и изучался исключительно промптинг — оценивающие агенты не учились под задачи верификации. Кроме того, в статье не исследована связь между масштабом модели и переоценкой. Авторы так и пишут, что нужно всё подтверждать на большем масштабе.

Разбор подготовил ❣ Алексей Петраков

Душный NLP
3 524 просмотров · 21 реакций Открыть в Telegram · Открыть пост на сайте
AgentFold — метод управления контекстом для агентов на длинных задачах

На длинных сценариях поиска и анализа веб-агенты либо хранят слишком много сырой информации, либо слишком часто её суммаризируют, что забивает контекст. Авторы сегодняшней статьи предлагают метод AgentFold (GitHub), призванный решить эту проблему, сделав память агента динамической и управляемой самим агентом.

Сейчас в веб-поиске используются два подхода. Первый — это ReAct, при котором все действия и решения конкатенируются в конец контекста. Благодаря этому ничего не теряется, но и контекстное окно забивается очень быстро. Второй подход — суммаризация на каждом шаге, однако при этом какая-то часть информации неизменно теряется.

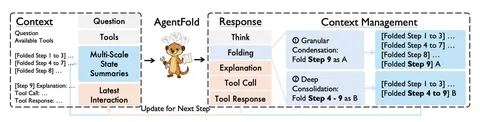
Ключевая идея AgentFold — создание активного и динамически пересчитываемого контекста для каждого следующего шага. То есть агент самостоятельно выбирает, что нужно запомнить точно, а что можно суммаризовать. Авторы отмечают, что они вдохновлялись человеческой способностью к осмыслению собственного опыта.

В статье предлагается модифицировать и контекст, и то, в каком формате выдается ответ. Контекст должен состоять из следующих элементов:

• Question — исходный вопрос;
• Tools — доступные инструменты;
• Multi-Scale State Summaries — свёрнутые блоки прошлых шагов. Например, шаги с первого по третий представлены одним блоком. При этом свёрнутым может быть и один шаг;
• Latest Interaction — последний полный шаг.

Суть в том, что все предыдущие действия хранятся в сжатом виде, а последнее — в подробном. Это позволяет меньше загружать контекст.

Что касается ответа, то тут модель должна сперва размышлять, а потом делать фолдинг шагов. Он может быть гранулярным (granular) или глубоким (deep). В первом случае схлопывается только последний шаг, а во втором — целая ветка (например, «шаги с четвёртого по девятый»). После фолдинга идёт этап, на котором модель объясняет, почему объединила шаги именно так, как объединила. Наконец, вызываются инструменты и совершаются какие-либо действия.

Для обучения всему вышеописанному, авторы брали вопросы из WebSailor и отправляли их во внешние опенсорсные модели (GLM-4.5 и DeepSeek-V3.1), чтобы построить контекст конкретного шага. При этом о том, как генерируются данные, не сообщается.

Далее авторы генерировали ответ, выполняли действие, получали ответ от среды и собирали следующий шаг траектории. Проблема в том, что LLM сами не умеют сжимать контекст, что ведёт к ошибкам, галлюцинациям и тому подобному. Неправильные решения авторы отбрасывали, но как — в статье не описывается.

Итоговый датасет представляет собой не набор пар «вопрос-ответ», а выборочный набор пар взаимодействия (intersection pairs), удовлетворяющих определённым условиям. На эти пары делается SFT.

Согласно результатам замеров, AgentFold помогает снизить нагрузку на контекст к сотому шагу на 91% по сравнению с ReAct. При этом с увеличением числа шагов точность, как сообщают авторы, только растёт.

Разбор подготовил ❣ Антон Гырдымов

Душный NLP
3 220 просмотров · 24 реакций Открыть в Telegram · Открыть пост на сайте
Asynchronous Reasoning: Training-Free Interactive Thinking LLMs

Сегодня поговорим о статье, в написании которой принимали участие инженеры Яндекса. Публикация посвящена асинхронному ризонингу, а в её основе лежит метод, описанный в работе Hogwild! Inference: Parallel LLM Generation via Concurrent Attention, поэтому сперва — кратко о ней.

Это тоже статья от Yandex Research, а также от HSE и IST Austria. Авторы поставили перед собой задачу ускорить инференс с помощью параллельной генерации. Для этого ввели понятие Cash Blocks. Есть блок common cash, где находится общий промпт (например, решить какое-либо уравнение), и есть блоки «рабочих» (workers) — других потоков генерации той же LLM, которые выполняют задачу, синхронизируясь через KV-кэш. В статье эти блоки называются Алиса и Боб.

Для генерации токена Алисы нужно, чтобы блоки стояли в порядке common-Bob-Alice, а для Боба — common-Alice-Bob. Так каждый «рабочий» может генерировать свои токены, «видя» чужие генерации, и они могут в реальном времени общаться между собой. Для генерации нового токена блоки KV-кэша упорядочиваются по-разному для каждого «рабочего». Сдвиг осуществляется не над всем блоком, а над query-токенами, что снижает вычислительные издержки. Это суть метода, а подробнее о Hogwild! мы писали в этом посте.

Идея асинхронного ризонинга немного иная. В Hogwild! разбивали большую цепочку ризонинга на параллельные фрагменты для обработки двумя «рабочими», чтобы добиться некоторого ускорения. При этом Алиса и Боб — почти симметричны, лишь немного отличаются промптами. Однако сами кэш-блоки в теории могут отличаться: один, например, может быть обёрнут в ризонинг-токены, а другой нет. Также не обязательно генерировать по одному токену для каждого «рабочего» за форвард, как это сделано в Hogwild! Из этих предпосылок и рождается идея AsyncReasoning.

Суть такова: есть также два потока одной LLM — writer и thinker. Первый генерирует выходные токены, а второй — ризонинг-токены. Благодаря этому появляется возможность генерировать ответ раньше, чем завершился ризонинг. С точки зрения thinker, токены writer — это предыдущий шаг генерации, а writer «живёт» в рамках одной непрерывной генерации.

Чтобы сделать этот сетап более интерактивным, — скажем, в случаях, когда thinker надо подольше подумать — используют переключение режимов (mode switching). По сути, это отдельный view, от которого модели задаётся вопрос «Достаточно ли моих текущих измышлений, чтобы написать следующий параграф или формулу?» (Wait, are my current thoughts enough to write the next paragraph or formula?) В зависимости от ответа — да или нет — writer либо включается, либо ждёт дальше. Вопрос задаётся каждые 20 шагов.

Замеры в основном проводились на математических датасетах. Кроме того, замеряли delay — суммарную длительность пауз, которые происходят при переводе ответа модели в звук. Благодаря mode switching writer генерирует токены не на каждом форварде, а перевод ответа в звуковое представление позволяет лучше зафиксировать те самые паузы между генерациями. Также измерялось time to first token. Как показали эксперименты, ещё AsyncReasoning помогает повысить безопасность модели.

Разбор подготовил ❣ Георгий Якушев

Душный NLP
2 897 просмотров · 18 реакций Открыть в Telegram · Открыть пост на сайте
Тренды из мира бенчмарков на ICML 2026 [2/2]

SWE-rebench V2: Language-Agnostic SWE Task Collection at Scale

Ребята из Nebius расширили свой SWE-rebench на новые языки: сфокусировались на масштабируемости и пригодности для сбора RL-лёрна. Две ключевые части пайплайна: сборка окружения под каждый репозиторий и отбор задач для тестов.

Окружение собирают собственным интерактивным агентом. Он читает README или конфиги репозиториев, пробует ставить зависимости и запускать тесты, а потом чинится по логам ошибок. Завершить цикл удалось только для 20% проектов.

Для отбора задач весь набор тестов несколько раз прогоняли на версии до фикса (тесты падают) и после патча-решения (проходят). Оставили только те, где хотя бы один тест уверенно перешёл из fail в pass.

Кроме этого, ребята разобрали траектории фронтир-моделей на 300 задачах. По фейлам составили таксономию типичных проблем, связанных с заданиями. Например, когда тесты цепляют посторонние модули или ждут имён, которых нет в постановке.

Потом моделью протегировали все задания, чтобы можно было самостоятельно фильтровать более грязные таски. В итоге пайплайн, оценивая точность, оставил от стартового набора в 30 млн пул-реквестов только 32 тысячи задач. Зато помогает собрать окружение полностью автоматически.

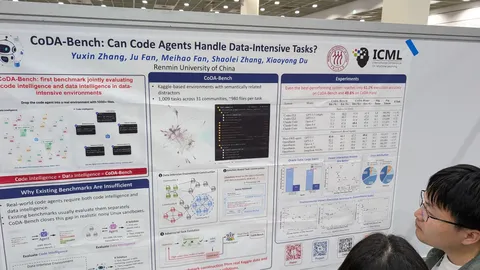
CoDA-Bench: Can Code Agents Handle Data-Intensive Tasks?

Агентский бенч пытается закрыть навык на связку двух умений: найти нужные данные и проанализировать их.

Для этого:

1. Отобрали файлы из датасетов Kaggle и построили графы их встречаемости в одном ноутбуке. Из этого сформировали «сообщества» и сложили их вместе. Так модели пришлось искать нужный файл не просто так, а среди связанных или близких.
2. От Kaggle ноутбуков перешли в ячейки, где подсчитывались конкретные числа. По этим ячейкам синтезировали вопрос.
3. Итеративно усложняли задачи так, чтобы топовые модели плохо справлялись. Поверх проверяли их работу экспертами-людьми.

В итоге собрали 1000 задач и почти 1000 файлов. Лучшая связка Codex + GPT5.5 выбивает 60,5%. Отдельно проверили, что если сразу подсунуть нужный файл, то справляемость с задачей вырастает на 20+%. То есть, бенч по-настоящему задействует оба навыка: и поиск релевантного файла, и манипуляции с ним.

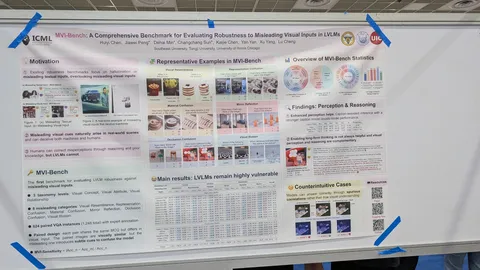
MVI-Bench: Robustness to Misleading Visual Inputs in LVLMs

Бенчмарк на устойчивость VLM к визуальным иллюзиям. Среди изображений для проверки — жёлтые зонтики, стоят так, что выглядит картошкой фри, фигурки с многозеркальными отражениями, муляжи печений вперемешку с настоящими.

Всего оценивали 6 классов: окклюзию, понимание материалов, намеренную визуальную похожесть объектов, разницу между настоящими объектами и их 2D-изображениями, зеркала, иллюзии.

Чтобы оценить именно устойчивость и понимание визуальных иллюзий в отрыве от сложности самого задания, бенч сформировали парами. Например, одна и та же сцена с обманкой и без неё или картинки с одинаковым вопросом и одинаковым правильным ответом.

600+ заданий в перекрытии проверили люди. Бенч получился довольно контрастным, с огромной разницей между нейросетевыми и человеческими оценками. Qwen2.5-VL (72B) — 57%, GPT-5 Chat — 64%, человек — 98%

Implicit Intelligence — Evaluating Agents on What Users Don't Say

Этот бенчмарк помогает отследить, выполняют ли нейросети требования, которые пользователь считает очевидными и не проговаривает явно.

Пример с постера: «я иду спать, выключи свет». Вместо того, чтобы просто выключить свет во всем доме, надо посмотреть на состояние среды (одна спальня занята кем-то, в календаре есть movie night) и оставить свет включенным в медиа-комнате и в занятой спальне.

Всего в бенч вошли 200+ сценариев на 300+ реальных действиях из Apple Shortcuts. Мир описан одним YAML-файлом и симулируется моделью. Агенту не прописывают явным образом правила мира, он должен читать контекст и понимать, что именно нужно сделать.

Лучший результат показал Claude Opus 4.6 — 53,2%. Интересно, что extended thinking оказался неоднозначным улучшением: Claude помогает, а GPT, скорее, портит.

Исследовала для вас бенчмарки ❣ Ирина Барская

#YaICML2026

Душный NLP
3 798 просмотров · 27 реакций Открыть в Telegram · Открыть пост на сайте
Тренды из мира бенчмарков на ICML 2026 [1/2]

Работ о бенчмарках на ICML традиционно много. По сравнению с прошлым годом, в 2026 стало заметно больше бенчей для агентов. А ещё начали чаще встречаться работы из академии.

Объяснение простое. Корпорации вкладывают много сил во внутренние бенчи: делают сами, покупают их у data-labeling-компаний (например, Surge, Mercor, Handshake AI, Toloka) — и, как следствие, такие бенчи редко опенсорсят.

Остальные бенчмарки часто делаются ощутимо меньшими ресурсами. И, как следствие, страдают от типичных проблем:

• мало человеческой верификации данных,
• качество judge'ей-верификаторов редко полноценно исследуется,
• плохо оценивается качество пар запрос + ground-truth-ответ, сгенерированных LLM,
• редко проверяется контаминация, хотя бенчи собираются из открытых источников.

Авторы постеров, вошедших в подборку, отметили, что подготовка одного бенча занимает в среднем 3–4 месяца фултайм-работы.

τ²-Bench: Evaluating Conversational Agents in a Dual-Control Environment

Команда τ-бенча продолжает свою работу. В этот раз получили spotlight. Предыдущие версии были single-control: то есть, тулы были доступны только агенту, а пользователь пассивно выдавал текстовый фидбек. В реальном мире пользователь, конечно, взаимодействует со средой.

Новый бенчмарк сделали на примере телекома: у агента и у симулированного юзера свои БД и инструменты в общем мире. Валидация — не LLM-судьями, а ассертами на состояние мира.

Получившийся бенч заметно сложнее предыдущих версий: Сlaude-3.7 выбивает только 49%. Авторы используют абляцию, когда всё управление переходит агенту или если агенту дают подробный план, как надо поступать. Один из тейков: для агента важен скилл координации с пользователем, который обычные специализированные бенчи не измеряют вообще.

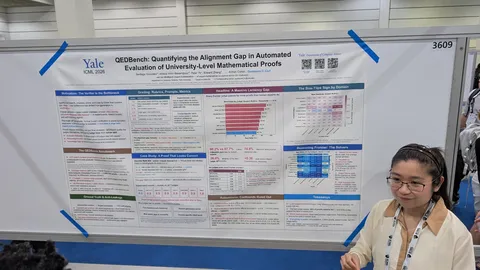
QEDBench: Quantifying the Alignment Gap in Automated Evaluation of University-Level Math Proofs

Этот бенч фокусируется в первую очередь на оценке надёжности самих судей: насколько LLM judge вообще способен оценивать математические доказательства примерно институтской сложности.

Авторы попросили экспертов переписать экзаменационные задачи из 10 математических дисциплин так, чтобы избежать контаминации. Также дополнили бенчмарк примерами из экзаменационных задач своего университета. Ответы фронтир-моделей оценивали:

• кандидаты математических наук по заданной шкале,
• LLM-судьи по рубрикам, заранее описанным людьми.

Всего авторы собрали 1300+ доказательств и 1000 часов разметки. Ожидаемо, судьи пропускают заметно больше неправильных решений: 38% показал самый лучший judge на GPT-5.2 Pro.

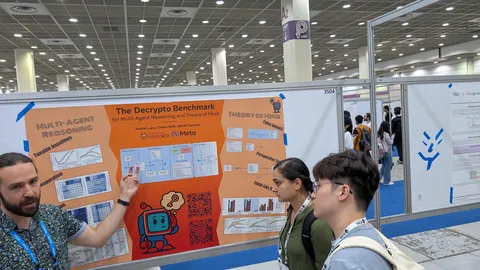
The Decrypto Benchmark for Multi-Agent Reasoning and Theory of Mind

Бенчмарк на Theory of Mind, собранный на основе настолки Decrypto. Alice даёт словесные подсказки к четырём секретным словам так, чтобы код угадал её партнёр Bob, но не угадал перехватчик Eve.

Сложность в том, чтобы подсказка была достаточно прозрачной для своего и непонятной для чужого — то есть, требует явно моделировать так, чтобы понял один и не распознал другой. Pass — исход игры.

Преимущество по сравнению со старыми статическими ТоМ-бенчами в том, что можно менять ключевые слова и собирать их в миллиарды комбинаций, избегая переобучения. Авторы проделали довольно подробную работу: предлагают промпты-правила и методики валидации, а также провели валидационные игры между людьми и моделями.

С игрой плохо справляются даже фронтир-модели: дают примитивные ассоциации (fire → flame, hat → cap), которые легко перехватить. С помощью отдельных тестов из области детской психологии, замерили representational change — понимает ли агент, что его собственное представление изменилось, когда пришла новая информация и изучили false belief — умение приписать ложное убеждение участнику дискуссии. Оба показателя составили менее 10%. Ризонинг не помогает: Llama 3.1-70B обходит и Claude 3.7, и o1.

Исследовала для вас бенчмарки ❣ Ирина Барская

#YaICML2026

Душный NLP
1 708 просмотров · 15 реакций Открыть в Telegram · Открыть пост на сайте
ICML 2026 — личные впечатления

Конференция закончилась, но говорить о ней можно ещё долго. Сегодня личными впечатлениями с нашим каналом поделился старший разработчик команды инфраструктуры обучения Alice AI Владислав Тыцкий.

Конференция ощущалась очень масштабной: много людей, огромные залы для докладов, плотное расписание и буквально бесконечное количество постеров. Иногда возникало ощущение, что между интересными работами нужно не ходить, а почти бегать.

Для себя я в основном смотрел темы вокруг pretraining, scaling, MoE, efficient training и разных попыток лучше понять динамику обучения LLM. В этом смысле конференция оказалась очень насыщенной: почти в каждой постерной сессии находилось несколько работ, которые хотелось разобрать подробнее.

Постерный формат показался мне самым полезным. На докладах — особенно в больших залах — немного теряется камерность: масштаб впечатляет, но вовлечённость аудитории ощущается слабее. У постера проще быстро понять основную идею, задать автору вопрос и уйти либо с хорошим инсайтом, либо с пониманием, что работа тебе не очень релевантна.

Отдельно понравилась инфраструктура конференции. У ICML очень удобные сайт и приложение: можно собирать расписание, смотреть материалы онлайн, возвращаться к записям и в целом не чувствовать, что ты полностью пропустил материал, если не успел попасть на доклад. Плюс Gangnam оказался приятным районом для такой конференции: вокруг много кофеен, мест для еды и просто красивый бизнес-квартал, по которому интересно гулять между сессиями.

ICML большая, шумная и местами немного перегруженная, но при этом очень полезная. Особенно если заранее понимать, какие темы тебе интересны, и не пытаться посмотреть вообще всё.


Владислав также рассказал о некоторых запомнившихся постерах.

Variational Routing: A Scalable Bayesian Framework for Calibrated Mixture-of-Experts Transformers

Статья об uncertainty-aware routing в MoE. Идея в том, чтобы добавить неопределённость именно в router — место, где MoE и так принимает важное и довольно хрупкое решение. Практически интересно, что такой слой можно дообучать уже поверх обученных моделей. В экспериментах это улучшает калибровку и устойчивость роутера к шуму при небольшом дополнительном компьюте.

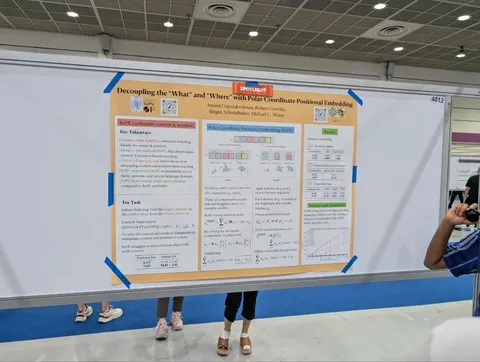
Decoupling the “What” and “Where” With Polar Coordinate Positional Embeddings

Работа о позиционных эмбеддингах и RoPE. Авторы обсуждают, что в RoPE могут смешиваться content- и position-информация, и предлагают PoPE — способ лучше развести «что» и «где». Не уверен, что это прямо новый дефолт вместо RoPE, но сама идея про content phase и positional phase показалась интересной.

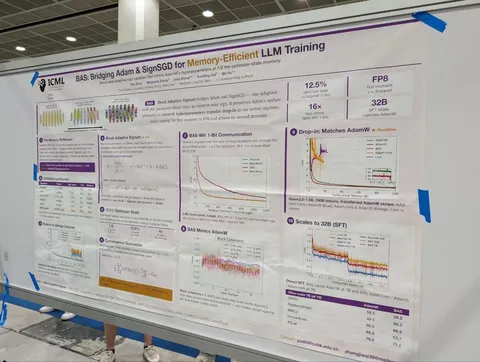
BAS: Bridging Adam and SignSGD for Memory-Efficient LLM Training

Постер о memory-efficient-оптимизации. Авторы пытаются приблизиться к Adam-like динамике, но снизить память за счёт block-wise статистик. Плюс используют трюк с sign update, что делает работу интересной не только с точки зрения оптимизации, но и с точки зрения практических ограничений больших обучений.

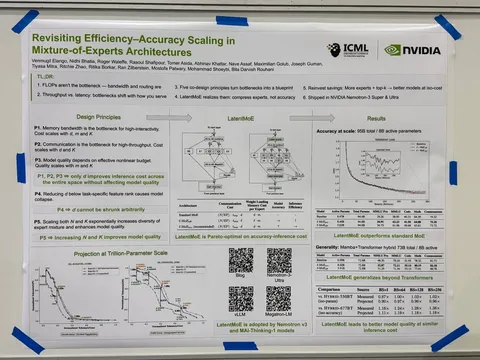
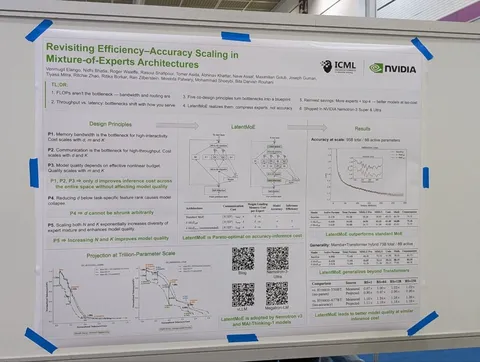
Revisiting Efficiency–Accuracy Scaling in Mixture-of-Experts Architectures

Hardware-aware-работа о трейд-оффе между качеством и стоимостью MoE. Авторы предлагают LatentMoE: скоры роутера считаются в исходном пространстве, после чего токены — перед отправкой к экспертам — проецируются в пространство меньшей размерности. Это уменьшает объём all-to-all и стоимость вычисления экспертов. Сэкономленный бюджет можно вложить в большее число экспертов и больший top-k.

#YaICML2026

Душный NLP
1 614 просмотров · 26 реакций Открыть в Telegram · Открыть пост на сайте
Подборка об RL и ризонинге

Рассказываем об улучшении RL для сложных задач, оптимизация в RLVR одной строкой кода (!) и обучении компактной модели для дипресёрча.

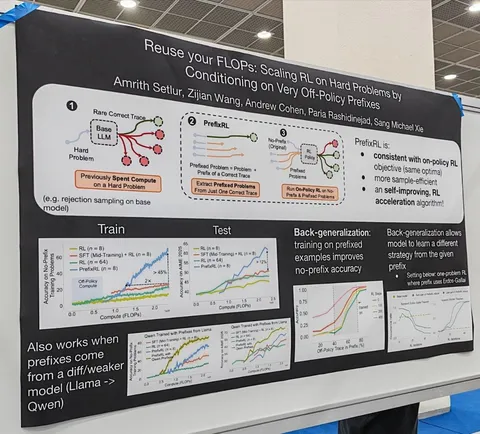
Reuse your FLOPs: Scaling RL on Hard Problems by Conditioning on Very Off-Policy Prefixes

При обучении RL на сложных задачах есть две основные проблемы:

1. Большинство роллаутов — wrong, поэтому положительные примеры для основной части задач не появляются.
2. Сложно дообучать модель, когда так мало положительного сигнала. Улучшение происходит скорее за счёт роста общей «умности» модели на более простых тасках.

Авторы предлагают метод Prefix-RL, который как раз направлен на решение сложных задач:
🔴Для них семплируются ответы, и из всех семплов выбирается правильный ответ.
🔴Собираются prefixed problems: промпт + префиксы правильного ответа.
🔴На обучении модель видит исходную задачу и набор prefixed problems и учится продолжать хорошую цепочку.

Получается метод, который консистентен с on-policy RL, обладает высоким sample efficiency и может ускорять self-improvement.

По замерам авторов, Prefix-RL в сравнении с mid-training SFT + GRPO прокрашивает AIME 2025 больше чем на 12 пунктов при том же компьюте на обучении.

Проводят аблейшен на Llama, добавляя в prefixed problems генерации Qwen. Это даёт около +5% при том же компьюте относительно Prefix-RL на prefixed problems инит-модели. Получается что-то похожее на эффективную дистилляцию во время RL.

Back-generalization — один из важных выводов статьи. Обучение на цепочках с префиксами улучшает решение задач без них, то есть модель при обучении не попадает в зависимость от подсказок. При этом back-generalization позволяет модели писать начало ответа не той стратегией, что была в префиксах на обучении.

Хотя автор сказал, что в агентском обучении аналогичный метод они не пробовали, он хорошо обобщается на агентский сетап: в роли префикса выступает часть траектории.

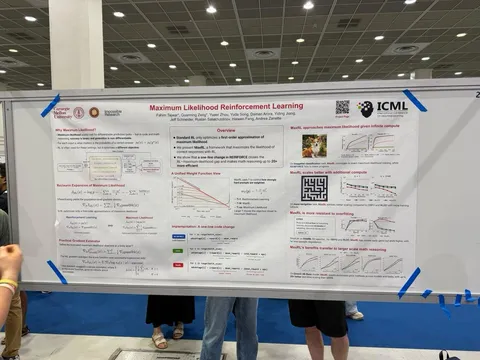
Maximum Likelihood Reinforcement Learning

Кликбейт: поменяйте строчку в расчёте advantage, замените std в нормировке на mean в своём RLVR — и всё полетит.

Проблема в целом стандартная: GRPO учит модель максимизировать среднюю награду (pass@1), а не вероятность успеха. Из-за этого он «залипает» на лёгких задачах и почти не учится на сложных.

В RLVR средний reward — это аппроксимация вероятности правильного ответа (так как награда 0/1). Предлагают взять log p (логарифм вероятности правильного ответа) и разложить его в ряд Маклорена по pass@k — вероятности получить «хотя бы один верный из k независимых семплов». Получается бесконечная сумма вкладов от одной, двух, трёх попыток и так далее с весами 1/k. MaxRL берёт усечение этого ряда до вычислительного бюджета g, то есть размера группы в GRPO.

Чем больше семплов N на инференсе, тем выше truncation T ряда и тем ближе к точному ML. Если на пальцах, метод даёт меньше внимания группам, где решаемость уже высокая, и больше смотрит на сложные.

MaxRL даёт до 20× прирост эффективности test-time scaling относительно GRPO, Pareto-доминирование по pass@1 и pass@k и лучше масштабируется с данными и вычислениям.

Попробовать метод можно дёшево: если уже есть RLVR, достаточно поменять одну строчку в расчёте advantage. Но работ, которые пытаются решить эту проблему, много, и пока непонятно, какая идея окажется лучшей.

DR Tulu: Reinforcement Learning with Evolving Rubrics for Deep Research

Популярный постер на конференции. Ребята смогли получить лёгкую модель дипресёрча с крутым качеством за счёт генерации и обновления рубрик.

Изначально при обучении модели давали небольшое количество хорошо написанных рубрик. После каждой итерации обучения смотрели на изменения в ответах, для них генерировали дополнительные рубрики и джаджем оценивали их качество. При этом генерация рубрик и оценка тоже выполнялись лёгкой моделью. За счёт этого цикла получилось обучить модель собирать больше полезной информации и не галлюцинировать.

В итоге сделали лёгкую модель (8B), которая по качеству сравнима с топовыми моделями дипресёрча.

Увидели интересное ❣ Даниил Кириллов, Тимофей Смирнов, Иван Дёгтев

#YaICML2026

Душный NLP
1 640 просмотров · 23 реакций Открыть в Telegram · Открыть пост на сайте
Ещё больше классных постеров из Сеула — по следам ICML 2026

RE-TRAC: REcursive TRAjectory Compression for Deep Search Agents

Сейчас очень много агентов работает в ReAct парадигме (последовательные reasoning + acting). Авторы считают, что такой подход с длинными линейными цепочками плохо подходит для сложных задач, потому что deep search больше похож на дерево гипотез: модель может наметить несколько веток, но потом забыть часть из них, застрять в локальном направлении или зациклиться.

Re-Trac отличается от ReAct: после каждой траектории собирают compressed_state, в котором хранят лучший ответ на текущий момент, список проверенных фактов, логические выводы и список того, что осталось неизвестным. На следующих траекториях авторы стартуют с этого состояния. Благодаря этому авторы получили 53 пункта на BrowseComp с 8 rollout’ами.

Прочитав статью, я нашёл подвох: init для sft — это Tongyi-DeepResearch 3A30B, у которого и так 43 пункта на BrowseComp, а замера pass@8 — бейзлайна за схожий compute — для него нет. То есть идея интересная, но реальный эффект Re-Trac для лучшей модели из статьи не указан.

Training-Trajectory-Aware Token Selection

Исследователи изучают дистилляцию ризонящих моделей. Обычно SFT или дистилляция на reasoning-траекториях не улучшает модель, а иногда даже ухудшает её. Во время обучения loss монотонно падает, а реальные метрики сначала резко проседают (Imitation Shock), но затем постепенно восстанавливаются, при этом не всегда до конца. Авторы заметили расслоение токенов во время обучения на две группы, «полезные» и «вредные», причем одни подавляются другими. Поэтому стандартная дистилляция тратит ранние градиенты на токены, которые мешают обучению более полезных токенов.

Как решили проблему: замаскировали «вредные» токены и не добавляют их в loss. Чтобы понять, какие токены маскировать, придумали алгоритм T3S — Training-Trajectory-Aware Token Selection. Сначала модель проходит короткую фазу дистилляции, по ней находят Imitation Shock и затем сравнивают влияние токенов между началом и на чекпоинте, где всё взорвалось.

Least-Loaded Expert Parallelism: Load Balancing An Imbalanced Mixture-of-Experts

В MoE-модели каждый токен не проходит через весь FFN-блок, вместо этого роутер выбирает для него несколько экспертов. В Expert Parallelism эксперты распределены по GPU: условно, GPU-0 хранит экспертов 0–3, GPU-1 хранит 4–7 и так далее. Проблема возникает, когда роутер выбирает экспертов неравномерно. Например, на math/code данных один эксперт может стать очень популярным, потому что он специализировался на таких токенах. Тогда GPU, на которой лежит этот эксперт, получает слишком много токенов, считает дольше всех и определяет latency всего MoE-слоя.

LLEP решает это не изменением роутера, а изменением исполнения. Перед MoE-слоем система смотрит, сколько токенов попало в каждого эксперта и насколько загружена каждая GPU. Если дисбаланс маленький, используется обычный Expert Parallelism. Если дисбаланс большой, LLEP выбирает наименее загруженные GPU и отправляет туда не только токены, как в EP, но и веса перегруженного эксперта.

Smaller Models are Natural Explorers for Policy-Level Diversity in GRPO

Авторы говорят, что GRPO живёт за счёт разнообразных rollout’ов, но по ходу обучения они становятся однородными, advantage-сигнал слабеет, а прогресс встаёт. Вывели инсайт: GRPO нужно policy-level diversity — когда целые траектории структурно разные, но при этом логически связаны.

Обнаружили, что меньшие модели из этого же семейства дают гораздо больше policy-level разнообразия и предложили на ранней стадии обучения часть rollout’ов для большой модели генерировать маленькой замороженной моделью — так можно получить структурно разнообразные траектории на старте. Затем долю маленькой модели постепенно снижали, плавно возвращаясь к стабильному on-policy режиму большой модели. Результаты: на AIME24/25 получили выигрыш 23.8/22.5 против GRPO-базы 15.0/12.1.

Увидели и записали полезное для вас ❣ Даниил Кириллов, Иван Сапожков, Аркадий Альшан и Кристина Гуртова

#YaICML2026

Душный NLP
1 642 просмотров · 25 реакций Открыть в Telegram · Открыть пост на сайте
LLMs Develop Novel Social Biases Through Adaptive Exploration

Даже если полностью вычистить bias'ы из данных, модель в агентском цикле решение → фидбек вырастит новые с нуля. Даже о группах, которых не существует — из случайного шума. Чем новее модель, тем сильнее эффект, а промптом это не лечится, нужно менять целевую функцию.

Ребята из Принстонского университета привезли на ICML 2026 доклад, в котором утверждают, что вычищать существующие стереотипы из LLM недостаточно — модель успешно вырабатывает новые сама, в рантайме.

В подробностях разобрался наш коллега Александр Краснов.

Сетап эксперимента из психологии: модель играет роль рекрутера и 40 раундов распределяет кандидатов из четырёх выдуманных этносов (Tufa, Aima, Reku, Weki) по профессиям. После каждого найма выносит вердикт: успех или провал.

Хитрость в том, что вероятность успеха у всех одинаковая — группы идентичны, и любые различия между ними модель может только выдумать. По сути, contextual bandit с шумным фидбеком.

Модель слишком мало исследует варианты и ранний случайный исход (например, «представитель Aima провалился на профессии учителя») закрепляется как впечатление обо всей группе, и к концу игры этносы разложены по своим профессиям. Вся история при этом есть в контексте, т.е. модель декларативно знает, что n=1 — не выборка, но действует при этом жадно.

По итогу эксперимента (стратификацию меряют через Stratification Index, т.е. насколько каждая группа загнана в узкий набор профессий):

• Все frontier-модели стратифицируют сильнее людей из оригинального эксперимента. У людей SI=0,84, у моделей в среднем 1,39, у o3 и Claude Sonnet — под 1,8.

• Чем новее модель, тем хуже дела: скор на классическом bias-бенчмарке BBQ обратно коррелирует с сегрегацией в итеративной игре. Сильный in-context learner увереннее делает вывод из трёх наблюдений, и эта уверенность подавляет исследование.

• В каждом прогоне bias'ы разные: паттерн рождается из шума внутри запуска, а не из претрейна. Single-turn-бенчмарки такое не ловят в принципе.

Промпт «будь справедливым» ничего не меняет. Работает только изменение самой цели. К успеху найма добавляют измеримый бонус за разнообразие, и стратификация падает ниже уровня людей и даже случайного распределения.

Хорошо, но как эта информация поможет обычному пользователю LLM?

На самом деле это касается не только «социальных» задач. Механизм срабатывает в любой длинной сессии, где модель принимает серию решений и видит исходы. Группой может быть что угодно. Агент один раз обжёгся на гипотезе «проблема в конфиге» и потом перестаёт рассматривать конфиг как класс причин. Вызов либы падает по случайной сетевой причине «библиотека не работает», дальше — костыли до конца сессии. И чем умнее модель, тем увереннее фиксация.

На практике абстрактное «будь объективным» не поможет, а сработает конкретика, встроенная в критерий успеха агента: «рассмотри минимум три гипотезы», «не отбрасывай вариант после одного провала», гейт в хуке, который не пропускает вывод без перепроверки альтернатив. По сути, мы вручную делаем исследование вариантов условием выигрыша (сам по себе агент не мотивирован). И если сессия накопила уверенные выводы из пары наблюдений, дешевле открыть свежий контекст, чем переубеждать залипшую модель.

Итого: bias — свойство не только данных, но и самого процесса принятия решений. Защищаться нужно на уровне целевой функции агента, а не датасета.


#YaICML2026

Душный NLP
15 237 просмотров · 38 реакций Открыть в Telegram · Открыть пост на сайте
ICML 2026: как агенты справляются с контекстом

Об агентах и агентских системах в этом году говорили примерно все — тема стала одним из фокусов конференции. Главные тренды и новости собрала наша коллега Кристина Гуртова.

Было много работ о бенчмарках и диагностике агентов — пожалуй, самый крупный кластер. Пользовались популярностью мультиагентные системы и их обучение, agentic RL и tool use. Отдельное активное направление — safety. Общий тренд: рассматривать агента как инженерную систему, где каждый компонент (среда, обучение, оценка или память) становится отдельным объектом оптимизации.

А я углублюсь в актуальную проблему агентов: как не захлебнуться в собственном контексте. Сжимать его, сворачивать или выносить во вне?

Путь 1. Агент сам решает, что исключить из истории

Раньше агент линейно накапливал всю историю в один растущий контекст. Теперь — он ей управляет.

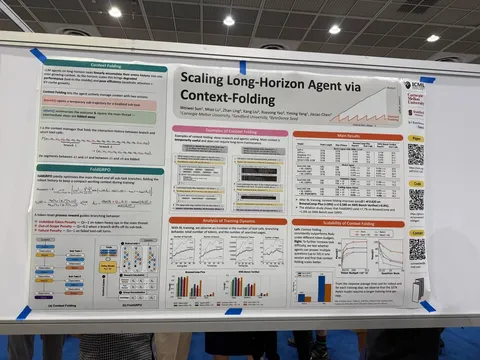
В Context-Folding (CMU, Stanford, ByteDance) агент разветвляет подзадачи с помощью двух тулколов: branch() создаёт подзадачу, return() возвращает итог этой подзадачи. Промежуточные шаги не попадают в основной контекст.

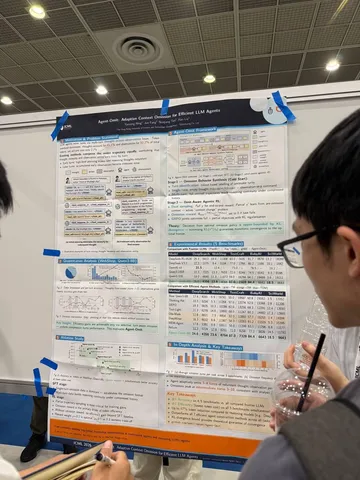
В Agent-Omit (HKUST) авторы посчитали, что размышления съедают около 45% токенов, наблюдения — 52%, а действия — всего 3%, поэтому их статья сфокусирована на сокращении ризонинга. Агент выборочно опускает свои мысли и наблюдения.

Conversational Inertia (ZJU, Ant) описывает отдельный побочный эффект длинной истории — «инерцию». Агент начинает имитировать собственные прошлые ответы как few-shot и перестаёт исследовать. Проблема лечится периодической очисткой истории.

Путь 2. Сжатие контекста — оптимизируемый навык, а не фиксированное правило

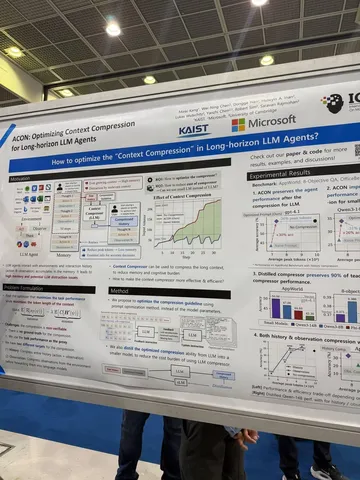
ACON (KAIST, Microsoft) оптимизирует не веса, а промпт для сжатия. Авторы собирают трейсы с полной и сжатой историей, сравнивают их с помощью LLM-критика и дополняют этим промпт. Затем дистиллирует такой навык компрессии в маленькую модель и используют его.

Путь 3. Внешняя память и переиспользование опыта

Ещё один вариант — не выбрасывать, а сохранять надолго.

EAM держит память как граф знаний, где узлы — это состояния системы, а рёбра — действия для перехода между ними.

Darwinian Memory — training-free память, где записи конкурируют за «выживание». Полезные переиспользуются, устаревшие и ненадёжные удаляются.

SE-GA хранит три вида памяти: эпизодическую, семантическую и экспериенциальную. Агент достаёт малую часть из каждой из них, добавляя к себе в контекст.

UMEM (Xiamen, Alibaba) обучают внешнюю модель работать с банком памяти. Для этого они замораживают модель-агента и обучают отдельный оптимизатор, что записать, обновить и удалить.

Отдельно — как это честно мерить. AMA-Bench проверяет память в реальных агентных траекториях, а не на сырых диалогах, и дополнительно показывает, что многие memory-системы пока проигрывают простому long-context.


#YaICML2026

Душный NLP
2 008 просмотров · 25 реакций Открыть в Telegram · Открыть пост на сайте
Оптимизируют MoE, стабилизируют RLVR, колдуют над кэшем и очень активно обсуждают GRPO: продолжаем рассказывать, что в тренде ICML 2026

Но обо всём по порядку. Читайте TL;DR от наших коллег и листайте фото с постерами!

Stable Asynchrony: Variance-Controlled Off-Policy RL for LLMs

Классная статья про стабилизацию RLVR. Авторы предлагают метрику, которая лучше всех предыдущих детектит потенциальный взрыв — effective sample size. По сути, это нормированная сумма important weight между движками актора и роллаута. Мы в Яндексе тоже её используем — работает!

Дальше авторы рассматривают два пути решения. Первый — простой (мы тоже его пробуем). Если метрика начинает стрелять, надо понижать лёрнинг рейт адаптивно.

Второй путь — умный потокенный решейпинг — чинит все проблемы сразу. RL учится 1000 степов и не разваливается, даже на специально усложнённом сетапе со staleness 12. Имплементировать, судя по описанию, должно быть легко.

TVCACHE: A Tool-Value Cache for Post-Training LLM Agents

В этой работе кэшируют последовательные цепочки туллколов в агентских роллаутах. Получается приличный кэшхит в десятки процентов. Применяют хаки типа прогрева кэша перед роллаутом. Кэш шарят по всему по времени обучения, поэтому кэшхит к концу может расти.

Tackling Length Inflation Without Trade-offs: Group Relative Reward Rescaling for Reinforcement Learning

Говорят, что научились заставлять GRPO растить reward, не удлиняясь относительно инита. В GRPO вместо reward'а на R делают R • s, где s — нормализующий коэффициент, функция от относительной длины ответов в группе.

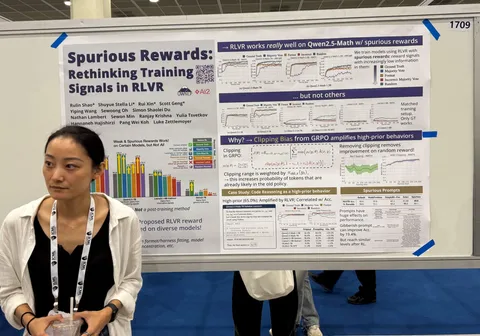
Spurious Rewards: Rethinking Training Signals in RLVR

Обучают GRPO на шумные сигналы, доходя до обучения на случайный шум. Обнаружили парадокс: в некоторых моделях Qwen обучение даже на такой «сигнал» даёт профит. Объясняют тем, что виноват клиппинг в GRPO — он чаще срабатывает на маловероятных траекториях, вероятности высоковероятных, наоборот, растут. Проверяют это, отключив клиппинг: действительно, модель перестает учиться на «испорченные» сигналы.

Revisiting Efficiency–Accuracy Scaling in Mixture-of-Experts Architectures

NVIDIA оптимизируют MoE. Обычно инференс таких архитектур упирается в пропускную способность памяти: либо перекачиваем туда-обратно экспертов на каждом токене, либо при большом батче упираемся в all-to-all.

Авторы сделали архитектуру LatentMoE — временно проецируют представления токенов в низкоразмерное латентное пространство перед маршрутизацией. Весь тяжелый сетевой трафик all-to-all и чтение экспертов из памяти происходят в сжатом формате. А на выходе из MoE-слоя данные возвращаются к исходному размеру.

Экономию при зеродифф-костах реинвестируют в увеличение числа экспертов и количество активируемых. Качество растёт — говорят, что уже используют это в Nemotron.

Why Tree-Style Branching Matters for Thought Advantage Estimation in GRPO

В GRPO при обучении ризонинг-модели на reward-сигнал генерации итогового ответа могут отличаться друг от друга, получая разную награду. В работе показывают, что часть бюджета выгодно потратить на генерации нескольких ответов при фиксированном CoT, чтобы разделить награду конкретного ответа от ожидаемой награды для цепочки (T4A4 > T16A1). На практике при правильном использовании это также экономит компьют, так как ризонинг цепочки обычно занимают бóльшую часть генерации.

Поделились впечатлениями ❣ Даниил Кириллов, Тимофей Смирнов, Даниил Гусев, Дмитрий Калашников, Алексей Зотов

#YaICML2026

Душный NLP
1 590 просмотров · 18 реакций Открыть в Telegram · Открыть пост на сайте
На ICML 2026 только и разговоров, что о GRPO

Что ещё привезли на конференцию авторы постерных докладов, рассказываем в новом обзоре!

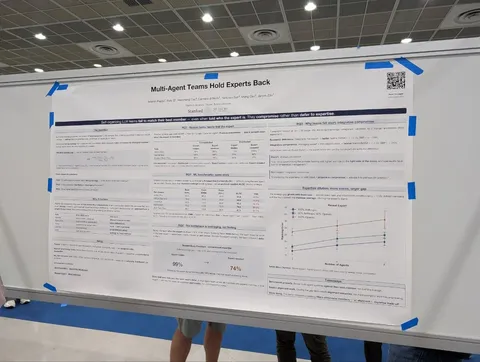
Multi-Agent Teams Hold Experts Back

Забавная статья: авторы утверждают, что мультиагентная команда может портить результаты одного эксперта. Агенты скорее ищут компромисс, а не лучший ответ, и не слушаются эксперта, даже если обозначить его в промпте. Люди тоже склонны к такому поведению, но не так сильно, как LLM.

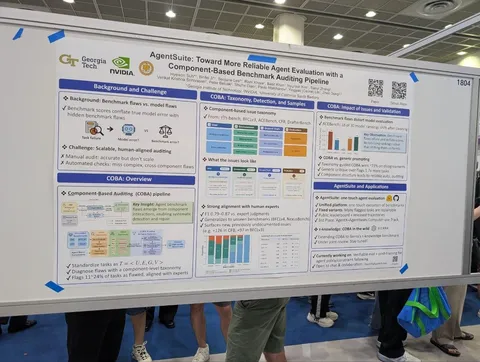
AgentSuite: Toward More Reliable Agent Evaluation with a Component-Based Benchmark Auditing Pipeline

Пайплайн для очистки и правки агентских бенчей. Сделали хорошую таксономию ошибок, подобрали judge'eй для поиска и исправления. Хорошо согласовано с людьми, находило много ошибок в первых версиях τ-бенча. Подходит для проверки запуска агентских бенчей и фильтрации траекторий.

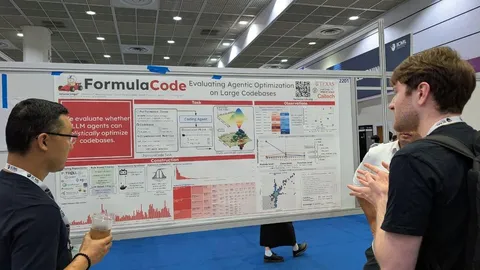
FormulaCode: Evaluating Agentic Optimization on Large Codebases

Намайнили 900 задач на оптимизацию скорости из 245K пул-реквестов в 70+ научных Python-репозиториях. Фильтровали эвристиками, LLM, а потом и людьми.

Для каждой задачи сделали снэпшот репозитория, экспертный патч и кучу нагрузочных ворклоадов. Модель должна ускорять код, не сломав корректность (по юниттестам). Условно, ей задают какие из 50+ метрик можно замерять или ускорять, а она должна решить, что оптимизирует.

Скор — Δ% против человеческого патча, то есть, многокритерийные градации вместо бинарного вердикта. Даже топовым моделям тяжеловато его проходить.

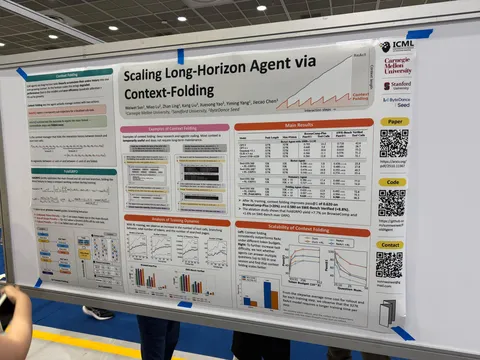
Scaling Long-Horizon LLM Agent via Context-Folding

Ресёрчеры из ByteDance и Стэнфорда решают проблему контекста в задачах deepsearch.

Предлагают сделать что-то вроде селф-субагента, который называют Context Folding. Модели для этого дают два тула: Branch и return. Модель может уйти в ветку, дёргать тулы, потом вернуться из бранча и сбросить сделанный там контекст. Это позволяет неявно хендлить модели миллионы токенов и не переполняться. Все бенчи растут, +8 на BrowseCompPlus. При этом решение имплементируется гораздо легче, чем субагенты.

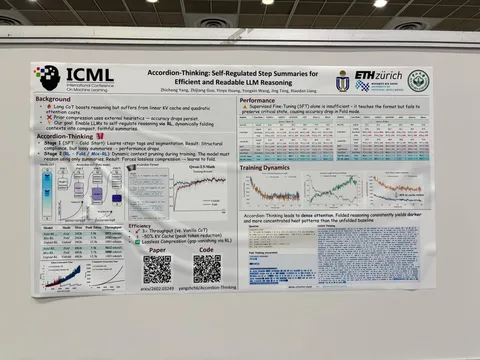
Accordion-Thinking: Self-Regulated Step Summaries for Efficient and Readable LLM Reasoning

Авторы снижают затраты на инференс ризонящих моделей за счёт периодической суммаризации рассуждений. Модель генерирует кусок ризонинга в обычном режиме, пишет к нему короткое саммари с выводами, затем исходный ризонинг выкидывается, и дальше модель ризонит, опираясь только на саммари.

Замерялись на математических бенчах, так как в таких задачах ризонинг хорошо разбивается на отдельные логические блоки.

Для сбора SFT-датасета брали OpenR1-Math-220k и переписывали рассуждения DeepSeek так, чтобы они были разбиты на блоки с саммари.

Репортят ускорение в 3–4 раза относительно аналогичной модели с unfold-ризонингом без просадки pass@1.

Передали фото и впечатления ❣ Иван Дёгтев, Ирина Барская, Тимофей Смирнов, Михаил Коновалов

#YaICML2026

Душный NLP
1 699 просмотров · 29 реакций Открыть в Telegram · Открыть пост на сайте
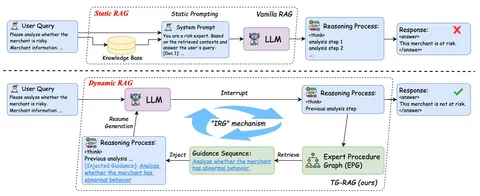
TG-RAG: A Retrieval-Augmented Framework for Reasoning Guidance in Specialized Domains

Продолжаем рассказывать об интересных работах с ICML 2026. Сегодня наш коллега, Сергей Юдин, разберёт статью об идее, как можно справляться с когнитивным дрейфом больших моделей в узких областях: таких как финансы, медицина и юриспруденция. Этот подход может быть релевантен Нейроюристу.

Большие рассуждающие модели (Deepseek-R1, Qwen3) хорошо думают «в общем», но буксуют в областях, где нужно строго следовать регламенту или стандартной операционной процедуре (SOP). Проблема в том, что на длинных цепочках рассуждений модель «сползает»: пропускает шаги, придумывает свои, отвлекается. Авторы называют это Cognitive Drift («когнитивный дрейф»).

Обычные способы лечить этот дрейф работают плохо. Если запихнуть инструкцию в промпт, то модель следует ей только на первых шагах, но по ходу длинного рассуждения эффект уменьшается. Дообучать модель дорого и негибко, а знания быстро устаревают. Даже классический RAG подкидывает регламент как «справочный текст рядом» — то есть, как совет, который модель вольна проигнорировать.

Идея авторов TG-RAG (Thought Guidance-Retrieval Augmented Generation) — не советовать что-то модели, а встраивать нужный шаг прямо в поток рассуждения в момент, когда это нужно.

Работает на двух компонентах:

1. EPG (Expert Procedure Graph). Регламент формализуют в граф с топологией Chain-of-Trees (цепочка стадий + деревья решений на развилках). В каждом узле разделены директива (что делать) и знание (чем подкрепить) — это изолирует ошибки и позволяет обновлять факты, не трогая логику. Строится полуавтоматом: модель парсит документы, эксперт лишь проверяет ветки (около 30 минут на домен).

2. Механизм IRG (Interrupt-Retrieve-Generate). Генерацию прерывают на границе шага → модель по своему же анализу выбирает следующую ветку графа → директиву впрыскивают в поток рассуждения, а факты — в контекст. И так до конца задачи. Директива становится более жёстким ограничением, от которого модели трудно отклониться.


#YaICML2026

Душный NLP
2 384 просмотров · 26 реакций Открыть в Telegram · Открыть пост на сайте
Подборка методов улучшения LLM

На этот раз собрали несколько статей на тему обучения и инференса LLM. Ожидаемо, эта область на ICML 2026 — самая популярная и обсуждаемая.

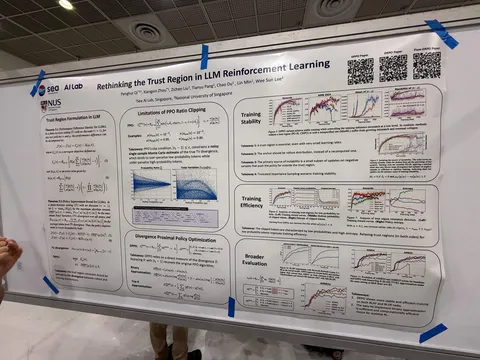
Rethinking the Trust Region in LLM Reinforcement Learning

Сингапурские учёные рассматривают проблему нестабильности GRPO-like-алгоритмов. Авторы связывают её с асимметричностью применяемого клиппинга относительно абсолютного значения правдоподобия сгенерированной траектории. Разброс значений IS (очень шумной оценки trust region в PPO) снижается с ростом вероятности, вследствие чего клиппинг чаще срабатывает на высокоэнтропийных генерациях.

Эту проблему уже частично лечили в DAPO, повышая правую границу клиппинга. Здесь же предлагают перейти к более точным оценкам trust region: через KL-отклонение по полному словарю, по top-K или через альтернативную, но более подходящую односемпловую оценку.

В экспериментах показывают более стабильное обучение. Кроме того, в статье много аблейшнов и интересных выводов.

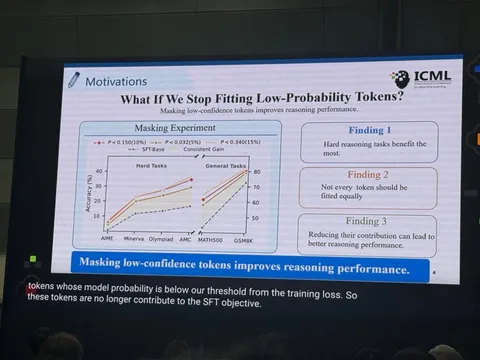
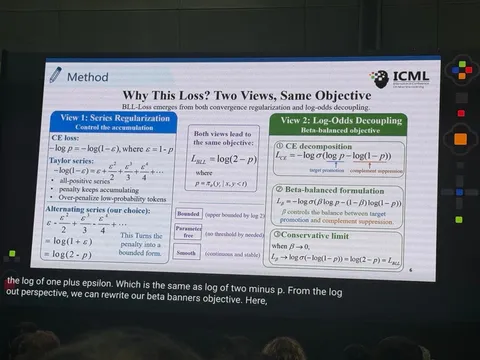
Don't Force the Fit: Bounded Log-Likelihood Loss for Enhanced Reasoning in Large Language Models

Очный доклад о модификации SFT-лосса для обучения на ризонинг-задачах. Предлагают перейти от классической кросс-энтропии L = - log p к ограниченной в нуле: L = log (2 - p). На высоковероятных токенах градиент нового лосса приближается к классическому CE, а вот на низковероятных — не улетает в бесконечность, а ограничен небольшим значением.

Мотивация такого подхода в том, что в ризонинг-цепочках есть множество высокоэнтропийных токенов, которые отвечают скорее за «стиль» рассуждения, но не влияют на его качество. При этом они отбирают значимую часть обучения, не давая как следует обучиться действительно важным токенам.

Приросты на графиках выглядят неправдоподобно большими.

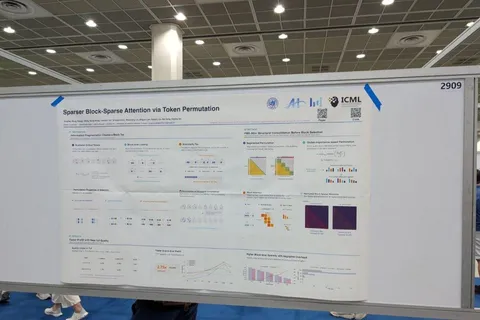
Sparser Block-Sparse Attention via Token Permutation

Ресёрчеры решают проблему long-context-префилла: full attention дорогой, а обычный block-sparse attention не всегда хорошо работает, потому что важные key-токены размазаны по разным блокам.

Идея PBS-Attn: перед block-sparse attention переставить K/V-токены так, чтобы важные токены оказались рядом. Аттеншн не меняется при одинаковой перестановке K/V, зато sparse-блоки становятся более плотными и полезными.

Из-за каузальной маски нельзя перемешивать всё подряд, поэтому авторы делают перестановку внутри сегментов. Это сохраняет авторегрессивность, но всё ещё позволяет «дефрагментировать» матрицу аттеншна.

Плюс в том, что это не новая архитектура. Можно взять предобученную модель, добавить permutation и block-sparse-кернел и ускорить long-context-инференс.

На LongBench качество почти такое же, как у full attention, и лучше, чем у других бейзлайнов. По скорости заявляют до 2,75× ускорения на long-context-префилле.

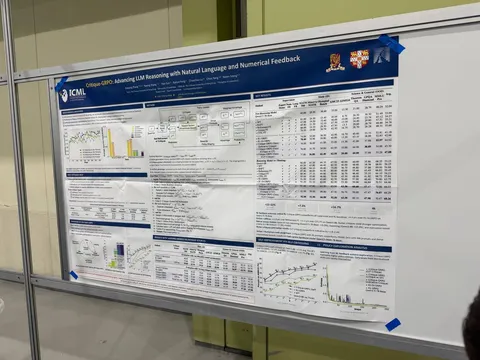
Critique-GRPO: Advancing LLM Reasoning with Natural Language and Numerical Feedback

Ещё один подход к тому, как делать критику в GRPO.

На сложных бенчах обучение в какой-то момент начинает стагнировать. Авторы предлагают добавить reward-модель, которая будет писать критику ответа актора. Затем эта критика подаётся модели вместе со старым ответом, и модель пишет ответ лучше. После этого даунсемплят такие аугментированные примеры и конкатят их с обычными.

На сете семплов с критикой модель учат сразу на улучшенный ответ — без промежуточной критики и первого ответа, как будто это изначально была такая генерация.

На математических и научных бенчах (AIME, MATH, GPQA) получают приросты от 7 до 12 пунктов.

Спросил автора, как бы он внедрял это в агентный RL. Он сказал, что, по его мнению, у модели должна быть тула «покритикуй мою текущую траекторию». Интересный подход.

Личное мнение: непонятно, насколько вообще критика в RL полезна. Как будто правильнее решать проблемы, которые она пытается закрыть, другими способами.

Увидели интересное ❣ Алексей Зотов, Влад Тыцкий и Тимофей Смирнов

#YaICML2026

Душный NLP
1 610 просмотров · 32 реакций Открыть в Telegram · Открыть пост на сайте
Как агенты и люди работают с документами, в которых нужно найти ответ на вопрос? Выясняют на ICML 2026

Продолжаем делиться работами с конференции. А о том, что мы сами привезли на ICML, читайте в канале ML Underhood.

Strategic Navigation or Stochastic Search? How Agents and Humans Reason Over Document Collections

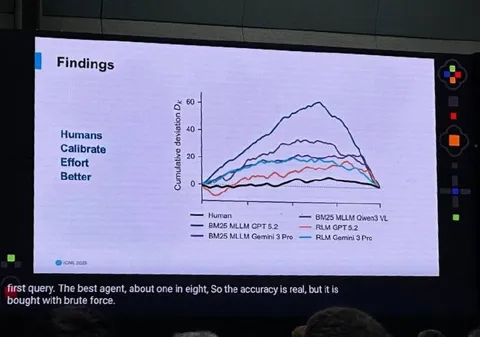
Авторы задали людям и агентам 2250 вопросов, ответы на которые спрятаны внутри 800 разных PDF и документов. В ходе нового теста MADQA записывали не только финальный ответ, но и весь путь поиска.

В результате:

• Лучшие агенты уже догнали людей по точности (около 82%), но берут грубой силой, а не умом.

• Человек находит ответ с первой попытки в 50% случаев, лучший агент (Gemini 3 Pro) — только в 12%.

• Агенты не умеют останавливаться: если задача не по зубам, крутятся по кругу и жгут ресурсы.

• Увеличение объёма вычислений не спасает. Один агент потратил 270 млн токенов и 850 долларов, но проиграл более дешёвому и аккуратному.

• Около 20% вопросов не осилил никто: ни люди, ни агенты.

Новизна работы в том, что в обычных тестах оценивают только корректность ответа. Здесь впервые измеряли, насколько эффективно система к нему пришла, считая каждый шаг поиска.

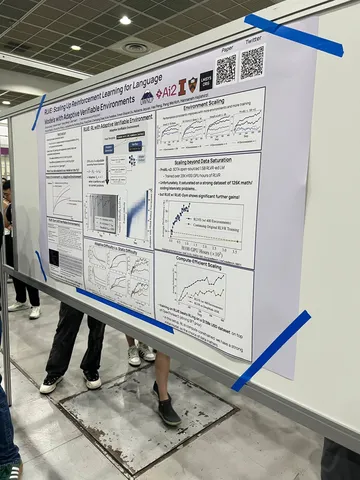
RLVE: Scaling Up Reinforcement Learning for Language Models with Adaptive Verifiable Environments

В этой работе предлагают обучаться на верифицируемых средах, сложность которых растёт динамически.

Авторы собрали RLVE-Gym из 400 verifiable-задачек. Когда модель начинает хорошо справляться с текущими задачами, уровень их сложности растёт. Получается своего рода curriculum, который не только ускоряет сходимость, но и бустит общее качество.

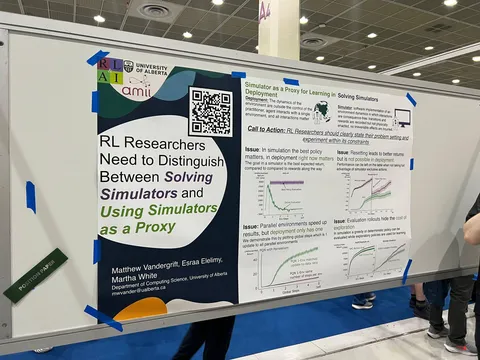
Position: RL Researchers Need to Distinguish Between Solving Simulators and Using Simulators as a Proxy

Ресёрчеры из Университета Альберты неожиданно выдают базу в position-статье: оказывается, что если геймить среду, то агент будет плохо работать в онлайне 🤷‍♂️

Нашёл для вас эти статьи ❣ Андрей Соколов

#YaICML2026

Душный NLP
1 752 просмотров · 18 реакций Открыть в Telegram · Открыть пост на сайте
Diffusion Language Models на ICML 2026

Собрали несколько работ о дифффузионных моделях и побеседовали с их авторами.

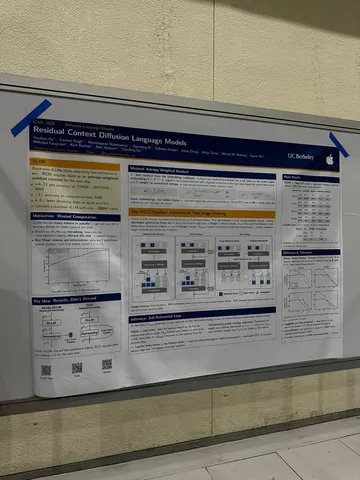
Residual Context Diffusion Language Models

Известная статья на тему masked diffusion. Суть в том, чтобы уменьшить потерю подсчитанной информации, которая обычно выбрасывается при низких вероятностях демаскируемых токенов.

Как работает masked diffusion. На каждом шаге генерации выделяется фрагмент последовательности (блок), который будет демаскироваться одновременно (что и должно приводить к ускорению). Но если сразу размаскировать все токены, качество будет плохим. Поэтому размаскируем только те из них внутри блока, предсказанные вероятности которых высоки. Вероятности других — низкие —выбрасываем и перегенерируем их заново, обуславливаясь на все размаскированные до текущего шага токены.

Для решения проблемы отброшенных вычислений вероятности непринятых токенов подают на следующий слой через дополнительный residual-вход. Чтобы дообучить модель работать с новым входом, предлагают использовать простую замороженную модель, которая предоставит не очень качественные вероятности.

Часть о том, что надо обучаться с dummy-моделью, а инфериться на хорошей, — ограничение метода. Автор считает, что его можно минимизировать рекурсивным дообучением, но сдвиг между распределениями никогда не будет нулевым. В целом необходимость делать такие трюки кажется ему фундаментальным ограничением дискретной диффузии, и он верит в скейлинг непрерывных подходов для генерации текстов.

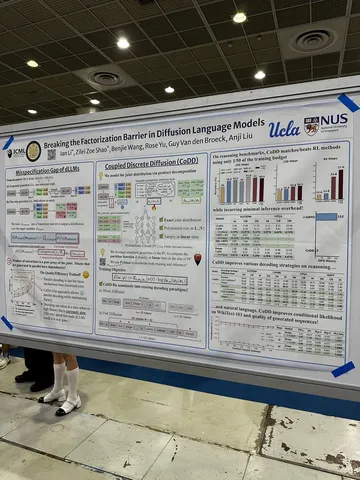
Breaking the Factorization Barrier in Diffusion Language Models

Работа об увеличении репрезентативности masked diffusion. Проблема в том, что помимо самих текстовых знаний модель должна выучить ещё и все возможные комбинации паттернов размаскирования. Это непростая задача, хочется уменьшить комбинаторную сложность в ней.

Предлагается учить peft-like-добавку определённой структуры, специально направленную на понимание паттернов семплирования. На инференсе будем параллельно вычислять эту добавку и основные веса для получения вероятности размаскирования токенов.

Использовать метод можно для двух целей. Основная, которую показывают в статье, — увеличение качества при фиксированной скорости. Дополнительная — увеличение скорости (количество размаскируемых токенов за форвард) при сохранении качества.

Метод поскейлили до LLaDA 8B и показали буст качества относительно LoRA-добавок — правда, померить на этом скейле смогли только ген-перплексию.

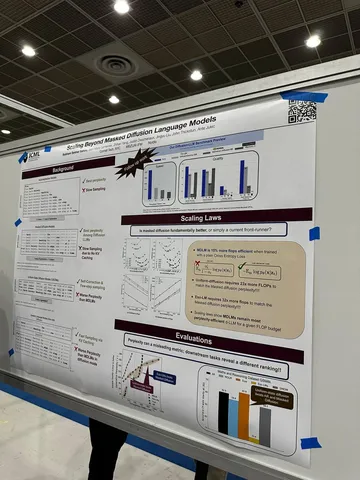
Scaling Beyond Masked Diffusion Language Models

Есть несколько конкурирующих подходов к тому, как делать диффузию для текстов. Самый популярный — masked diffusion. Так получилось, потому что на низких масштабах компьюта и размеров моделей было показано, что у этого класса моделей теоретически лучший баланс эффективности и качества в терминах ген-перплексии (что не слишком надёжно).

Авторы делают честное сравнение разных диффузионных подходов (и авторегрессии как бейзлайна), но теперь скейлят модели до 2B параметров и показывают, что uniform state diffusion — на деле лучший подход.

На постере и в беседе автор тизерит свою следующую работу, в которой для uniform state diffusion сделали алайн и победили Nemotron 8B и Diffusion Gemma 26B по скорости и качеству на агентских бенчах.

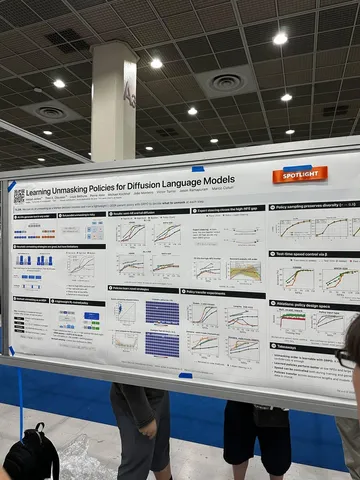
Learning Unmasking Policies for Diffusion Language Models

Также удалось пообщаться с автором. Идея — в обучении небольшой полиси-головы поверх замороженной диффузионной тушки. Сама полиси-сетка очевидно выучивает статистики из домен-специфичных данных потому что, по словам автора, для хорошего качества им приходилось учить отдельные политики для кода и математики.

Также есть параллельная работа, в которой тушку размораживают и дообучают голову вместе с ней. Это дороже, но перспективнее в плане качества.

Фишка метода из статьи — из-за отдельного обучения головы можно смотреть, какие домен-специфичные паттерны выучиваются. Так, для математики политика выучивает больше всего токенов семплить на последних блоках, что не сработало бы для кода.

Увидел интересное ❣ Сергей Кастрюлин

#YaICML2026

Душный NLP
1 737 просмотров · 34 реакций Открыть в Telegram · Открыть пост на сайте
Агентские системы на ICML 2026 Oral Session

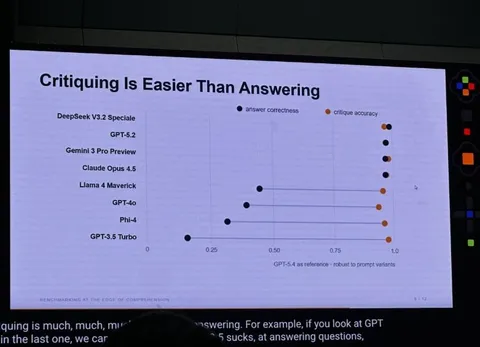
Benchmarking at the Edge of Comprehension

Авторы предложили процедуру бенчмаркинга с участием двух моделей: модель-бенчмаркер (Alice) и тестируемая модель (Bob). Alice генерирует вопрос q на заданную тему и ответ a_A, после чего сгенерированный пример проходит верификацию Bob'ом. Если вопрос после нескольких попыток генерации остаётся некорректным, процедура возвращает NULL.

Затем Bob генерирует ответ a_B, а Alice критикует его, указывая на конкретное место, где в рассуждении содержится ошибка (если она есть). Найденные «ошибки» эскалируются на моделей-судей, а при отсутствии единогласия — на асессоров-людей. Если ошибки действительно есть, процедура возвращает ALICE WINS. В противном случае — BOB WINS.

Исследователи утверждают, что с работой Alice-судьи справляются даже лёгкие модели вроде GPT 3.5: ответы всех моделей высоко коррелируют с людьми. Правда нас оставили без ответа насколько вопросы, сгенерированные GPT 3.5, являются сложными сами по себе.

Бенчмарк оказался довольно простым для фронтир-моделей: например, Bob на GPT 5.2 побеждает в 100% случаев против всех моделей за исключением одной. Из этого можно сделать вывод, что вопросы получились не очень сложными, и Alice как problem creator со своей работой не справилась. Также в работе не было оценки целых диалогов, что является немаловажным ограничением.

daVinci-Dev: Agent-native Mid-training for Software Engineering

Стандартный пайплайн обучения агентских моделей выглядит так: тушка -> SFT -> RL (например, GRPO). Авторы доклада о мид-трейнинге добавили дополнительный шаг перед SFT: они обучают модель на идеальных агентских трейсах на задачу Next Token Prediction и благодаря этому получают SOTA-результат среди открытых моделей на SWE-Bench Verified. Исследователи утверждают, что потратили существенно меньше компьюта, чем предыдущая SOTA, но получилось всё равно много: около 70b токенов на 32b/72b модели.

Strategic Navigation or Stochastic Search? How agents and humans reason over document collections

Исследователи разработали бенчмарк, который замеряет, насколько эффективно агенты решают задачу поиска по большой коллекции документов для ответа на вопросы. Неожиданно лучшая модель достигает всего 82% качества! При этом оказалось, что агентские пайплайны без ограничений тратят на порядки больше денег, чем пайплайны с разумными ограничениями ($850 против ~$40), и дают более слабый результат.

Ещё один любопытный факт: даже лучшие пайплайны тратят в 5 раз больше действий, чем человек, снабжённый теми же инструментами. Также авторы отмечают, что лучшие агентские пайплайны и люди дают примерно одинаковое качество ответов (~80%), но ошибаются по-разному: люди торопятся с неверными решениями, а модели, наоборот, «закапываются» там, где в этом нет необходимости.

Увидел интересное ❣ Юрий Яровиков

#YaICML2026

Душный NLP
1 806 просмотров · 32 реакций Открыть в Telegram · Открыть пост на сайте
ICML 2026: что обсуждают в Сеуле

В этом году крупнейшая конференция о машинном обучении проходит в Южной Корее. По традиции будем рассказывать о самом интересном — открываем серию обзоров от инженеров и исследователей Яндекса.

Немного инсайтов о Xiaomi

Ребята тоже используют On-policy Distillation для мержа своих экспертных моделей. Вайб доклада: как мы сделали топ-1-опенсорс-модель по ИИ-индексу, с миллионным контекстом и 1000 токенов в секунду без регистрации и СМС супердёшево.

Public report'а нет, про обучение не рассказали, но в докладе можно было подсмотреть трюки по оптимизации. Например, гибридные SWA-слои, которые реюзают KV-кэш от полного аттеншна перед ними, помогают в 7 раз уменьшить объём кэша, не потеряв в качестве.

Xiaomi MiMo-V2.5-Pro

TL;DR: Context length и Inference speed. Новая опенсорсная модель на 1 триллион параметров может работать с контекстом объёмом до 1 миллиона токенов в 10 раз быстрее (до 1000 TPS).

Претрейн — sparse-аттеншн и shared KV-кэш. На основе HSWA авторы предложили гибридный HySparse, чтобы увеличить sparsity. Это позволило в 10 раз сэкономить на объёме кэша и получить почти линейный аттеншн.

MiMo-V2.5-Pro обучали в QAT-формате, MXFP4. Пост-трейн — Multi-Teacher On-Policy distillation с top-k, а не top-1. По метрикам MOPD показал себя значительно лучше и стабильнее остальных подходов, подобных Cascade RL.

MoE RL оказался нестабилен, так как выбирается только 10% экспертов. В качестве решения прибегли к R3: Rollout Routing Replay.

Инференс Mimo-V2.5 Pro UltraSpeed — это FP4 (mxfp4) + DFlash Speculative decoding + TileRT inference engine. Для ускорения делают бакетинг по задачам (например, чат/код).

vLLM Hook v0: A Plug-in for Programming Model Internals on vLLM

IBM Research привезли инструмент, с помощью которого можно модифицировать логику в движке инференса vLLM и строить кастомные пайплайны.

Мотивация: несмотря на свою эффективность, движок vLLM не может похвастаться богатым функционалом. Авторы попробовали исправить это. Код — на GitHub.

Model Optimization Flywheel: Continuously Self-Improving LLMs in Production

Работа команды Shopify. Ребята отмечают важность голденсетов (ground truth set), потому что это потолок качества моделей, — и рассказывают, как собирают такие сеты.

Информацию получают от менеджеров. Если каппа Коэна низкая, то переписывают рубрику или инструкцию. Для подбора промпта judge пользуются GEPA и ACE. В датасет попадает и брак, и кейсы плохого срабатывания моделей. Некорректные ответы правят люди и judge.

Ещё больше о конференции читайте в канале ML Underhood: уже рассказали о работах основного трека, Spotlight-статье и первом дне. А если вы тоже на ICML, приходите пообщаться к любому из наших постеров.

Уже на конференции
❣ Иван Дёгтев, Даниил Кириллов, Тимофей Смирнов, Артём Миронов, Федор Великонивцев

#YaICML2026

Душный NLP
1 964 просмотров · 29 реакций Открыть в Telegram · Открыть пост на сайте
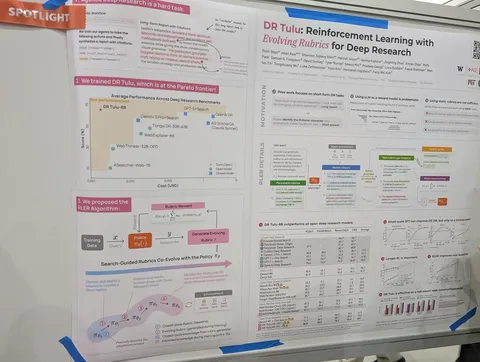
Ускорение генерации роллаутов с помощью спекулятивного декодинга

Самая времязатратная часть в GRPO — это генерация траекторий модели, на которую приходится около 72% всего процесса. Поэтому хочется ускорить генерацию роллаутов — и в сегодняшней статье NVIDIA рассказано, как это можно сделать.

По большому счёту, генерация роллаутов — это обычный инференс модели. При наивном инференсе видеокарты используются не на полную. Помочь решить эту проблему способен спекулятивный декодинг. Его суть заключается в том, что маленькая драфт-модель, учится предсказывать, какие токены сгенерирует основная модель. Последней остаётся лишь верифицировать, правильную ли гипотезу выдала драфт-модель. В режиме спекулятивного декодинга разрыв между компьютом и трансфером памяти сокращается.

Авторы проверяли свою гипотезу на небольшой модели — Qwen3-8B. Обучали её на математическом датасете DAPO-Math-17K, а валидировали — на AIME-2024. При этом других наборов данных не использовали, что немного подозрительно. Возможно, именно из-за такого выбора сетапа получились хорошие результаты. Кроме того, замеры проводили на Qwen3-235B, но в симуляции, из-за чего полученные результаты могут отличаться от реальных.

Модель обучали в двух режимах. Первый, RL-Think, предполагает простое обучение после SFT (или продолжение RL-стадии поверх уже ризонящей модели), а второй, RL-Zero, — RL сразу поверх претрейн-модели. Во втором случае спекулятивные модели вроде EAGLE дают лучший acceptance.

Касательно самого предсказания: авторы пришли к выводу, что наибольшее ускорение получается при трёх спекулируемых токенах. Интересно, что при предсказании уже пяти токенов генерация, напротив, замедляется.

В RL-Zero ускорение генерации — 1,77x против 1,54x в RL-Think: драфтеру проще предсказывать распределение менее обученной политики. На общем времени GRPO-шага разрыв уменьшается, потому что спекулятивный декодинг ускоряет только генерацию, а пересчёт log-prob и шаг оптимизатора занимают примерно то же время, что и без него. В симуляции с Qwen3-235B ускорение составило 2,5х. Но, опять же, в реальных рабочих сценариях прирост может быть скромнее.

В дополнение авторы предлагают доучивать драфт-модель во время GRPO, чтобы она не отставала от меняющейся политики основной модели. Делается это так: берутся скрытые представления основной модели, на них навешивается .detach() , после чего они отправляются в драфтер. Такая система позволяет обучать драфтера вместе с основной моделью, не оказывая на неё влияния (схема на приложенном изображении).

Разбор подготовил ❣ Павел Васильев

Душный NLP
5 482 просмотров · 40 реакций Открыть в Telegram · Открыть пост на сайте
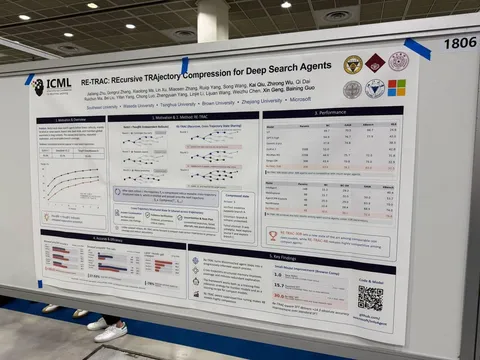
Задача credit assignment и подходы к её решению

Когда модель успешно выполняет задачу, неплохо бы понимать, какие именно действия привели к положительному результату. Выяснить это — задача credit assignment, о чём существует немало статей. Есть несколько основных подходов к проблеме:

• Temporal-difference (TD) — вклад текущего шага оценивается как разница оценки награды на текущем шаге и дисконтированной оценки на следующем.
• Beginning/tail — предполагает апдейт только токенов в начале и конце роллаутов.
• Энтропийный — предполагает использование в RL токенов с высокой энтропией и низкой вероятностью.

Это не все подходы, но сегодня кратко поговорим о них и статьях, в которых они реализуются.

Exploiting Tree Structure for Credit Assignment in RL Training of LLMs

В статье предложили temporal-difference-метод TEMPO. Для группы роллаутов строится префиксное дерево, в котором для каждого префикса оценивается средняя награда V(s). Авторы модифицируют GRPO-advantage, добавляя TD=V(s+1)-V(s). TD отлична от нуля только в точках ветвления, которые составляют незначительную часть токенов. Улучшение на математических бенчмарках составляет от 2 до 7 пп.

Token-Efficient RL for LLM Reasoning

В статье реализуется аналогичный подход с TD. Авторы предлагают два метода. Первый — S-GRPO, в рамках которого обновляются только префиксы роллаутов и семплируются K токенов из продолжения, но последнее можно рассматривать как регуляризацию. Второй метод из статьи — T-SPMO. Он аналогичен TEMPO, но апдейт делается только в точках ветвления префиксного дерева.

Подходы показывают хорошие приросты качества на бенчмарках с умножением трёхзначных чисел и задачах вербальной арифметики.

Well Begun, Half Done: Reinforcement Learning with Prefix Optimization for LLM Reasoning

Авторы отмечают, что старт генерации определяет итоговое качество. Поэтому предлагают оптимизировать только префикс, постепенно увеличивая его длину. Для снижения дисперсии для каждого префикса семплируют несколько продолжений, а затем усредняют по ним награду.

Подход выигрывает у обычного GRPO на AIME на 8–16% в зависимости от модели. Эксперименты проводили на разных версиях Qwen3.

GRPO-λ: Credit Assignment improves LLM Reasoning


Предлагают умножать advantage на вес, зависящий от позиции в тексте. В статье рассматривают два варианта веса: both, при котором обновляются и начало, и конец роллаута; и recent, где с экспоненциальным затуханием обновляется только конец. Подход позволяет получить прибавку 3–4 пп по сравнению с обычным GRPO.

Beyond High-Entropy Exploration: Correctness-Aware Low-Entropy Segment-Based Advantage Shaping for Reasoning LLMs

Авторы делят роллауты на сегменты трёх типов: токены с высокой энтропией, короткие сегменты с низкой и длинные с низкой. Показана польза от оптимизации не только высокоэнтропийных токенов, но и низкоэнтропийных сегментов, стабильно встречающихся в положительных роллаутах. Метод даёт значительный прирост поверх GRPO на трёх математических бенчмарках.

Разбор подготовил ❣ Георгий Иванов

Душный NLP
5 233 просмотров · 31 реакций Открыть в Telegram · Открыть пост на сайте
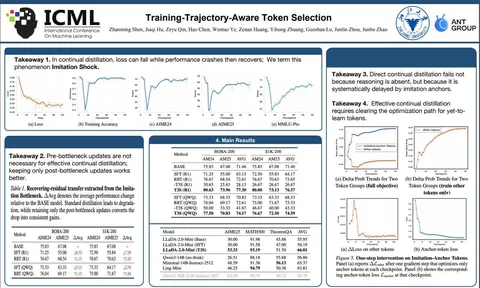
Технический отчёт Step 3.5 Flash — часть 2/2

Продолжаем разбирать техрепорт Step 3.5 Flash. В прошлый раз говорили об архитектуре, в этот — об обучении.

Предварительное обучение состояло из нескольких этапов: pretrain на базовые способности (14,6T токенов, 4K контекст). Сведение (annealing) для усиления рассуждений, кодовых и научных знаний (3T токенов, расширение конекста с 4K до 32K). Первая стадия мидтрейна для навыков SWE и использования тулов (386B токенов, 21% pretrain tokens replay, 32k контекст) и вторая стадия мидтрейна для обучения работе с длинным контекстом и агентскими сценариями (364B токенов, 128K контекст).

Для посттрейна готовят SFT-базу для экспертов в два этапа. Первый — стандартный; включает общие знания, следование инструкциям, математику, код, использование инструментов и так далее. Второй — настройка на узкие темы: экспертная химия и синтетическая арифметика. Финальный датасет состоит из 7,23B токенов, из которых 38,8% — это код. С помощью экспертов генерируют решения на промпты из SFT и заново обучают SFT, но с генерациями экспертов.

После дистилляции экспертов в SFT идёт RL. Авторы долго стремились стабилизировать обучение. Среди причин нестабильности — длинные цепочки ризонинг-генераций с отложенной наградой, возможные «скачки» градиентов при ошибке даже в одном токене и шум, возникающий, если на генерации и обучении вероятности токенов считаются по-разному.

Для стабилизации применяют Metropolized Independent Sampling — выбрасывают из обучения токены со слишком высокой или низкой активностью, а также траектории с геометрическим средним активаций выше или ниже порога. Для обрезанных по длине генераций вместо нулевого реворда берут выход value-модели как оценку возможной награды незавершённых рассуждений. Так даже при 20% оборванных генераций стабильность обучения сохраняется.

Награда считается отдельно для RLVR и RLHF. В первом случае есть две части: rule-based (для каждого среза подобран отдельный verifier) и model-based для STEM-дисциплин на основе OSS-120B со сложным промптом. В RLHF применяется генеративная награда в режиме pairwise, генерации сравниваются с использованием критерия Бредли-Терри, что позволяет уйти от абсолютных значений наград и оптимизироваться на ранжирование ответов модели.

В качестве эталона предположительно используется Replay Buffer. Для улучшения стабильности генерациям с лишним переключением языков, чрезмерной уверенностью и выдуманными цитатами присваивается награда 0. Используется мета-ревард-модель (MetaRM), которая даёт прирост на бенчмарках 0,5–3%. Для обучения реворд-модели используется дополнительный этап SFT, RL не раскрывается. Награда для агентных задач — rubric-based LLM с тернарными суждениями. Выходы ассиметрично проецируются в бинарную награду.

Данные для обучения использованию инструментов не синтезированы внешней LLM. Авторы строят жёсткий граф логики вызова инструментов: например, позволяют редактировать файл только после его открытия. Дальше генерируют данные в цикле Sample-Execute-Verify: модель вызывает инструмент, работает с ним, результаты оцениваются, фильтруются траектории с ошибками. Получается около 100K сценариев на миллиарды токенов с вызовом инструментов и без ошибок.

Для кодовых агентов модель учат генерировать среды в собственном пайплайне на основе SWE-factory. Получают 50 тысяч сред на 20 языках. Также добавляют опенсорные среды вроде SWE-smith и R2E-Gym. Что касается ресёрча и поисковых агентских сценариев, тут интересен метод отбора данных. Step 3.5 обучали только на задачах, которые DeepSeek-R1 не может решить без инструментов. Процесс гарантирует, что для решения задачи необходимо использование поиска.

Модель показывает хорошие результаты в математических бенчах. В других доменах есть просадки,но стоит помнить, что Step 3.5 Flash — значительно меньше многих конкурентов, с которыми сравнивается. В конце мая StepFun выпустила Step 3.7 Flash. Она превосходит версию 3.5 во всех бенчмарках, а в SimpleVQA обходит даже GPT-5.5.

Разбор подготовил ❣ Антон Селиванов

Душный NLP
3 295 просмотров · 21 реакций Открыть в Telegram · Открыть пост на сайте
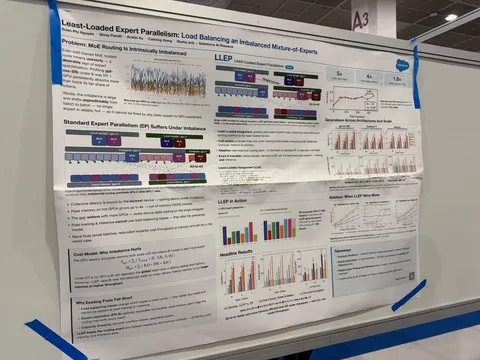
BigCodeArena: Unveiling More Reliable Human Preferences in Code Generation via Execution

Сделать хороший Code Side-by-Side силами краудсорсинга довольно сложно: сессия оценивается не целиком, вместо полного кода — ошмётки, иногда из совершенно незнакомой оценивающим области. Сегодня разберём статью о новой платформе, которая должна решить эту проблему.

В отличие от популярной Chatbot Arena, BigCodeArena позволяет исполнять код, сгенерированный LLM, и взаимодействовать с ним и его результатами. Авторы отмечают: зачастую системы оценки слишком сосредоточены на том, чтобы код был корректным, но закрывают глаза на другие его аспекты. Например, во многих областях код рисует визуал, и этот визуал должен быть приятным.
Для этого:

• Оценивают сессию целиком с самой первой реплики — весь диалог с LLM часто бывает похож на вайб-кодинг.
• Самое главное — настроили execution sandbox, чтобы оценивающие могли увидеть результаты выполнения кода.
• Добавили возможность редактировать и запускать оцениваемый код, чтобы тестить его устойчивость.

За полгода на BigCodeArena разметили 14 тысяч сырых диалогов с LLM. 4,7 тысячи диалогов, где было больше одной реплики и происходило исполнение кода, собрали в отдельный датасет. Там всё по-честному: кроме выбора, кто лучше ответил, авторы попросили пользователей платформы оценивать корректность, эффективность, читаемость, удобство поддержки и UI/UX-кода. Собранные диалоги помогли объективно оценить, какие из моделей лучше работает ассистентами в разных областях и отдельно сравнить их как оценщиков кода.

Оценщиков кода в дальнейшем используют для того, чтобы масштабировать ту самую тяжёлую краудсорсинговую разметку. Из исследования видно, что добавление исполнения кода в контекст позволяет оценщикам точнее сравнивать два диалога-сессии.

В рейтинге моделей, лучше всего справляющихся с оценкой кода, нет ничего неожиданного: победили сильнейшие. Их никак не файнтьюнили, всё работает на обычных промптах.

Платформа BigCodeArena доступна на GitHub, датасет — на HuggingFace.

Разбор подготовил ❣ Иван Каргапольцев

Душный NLP
3 114 просмотров · 20 реакций Открыть в Telegram · Открыть пост на сайте
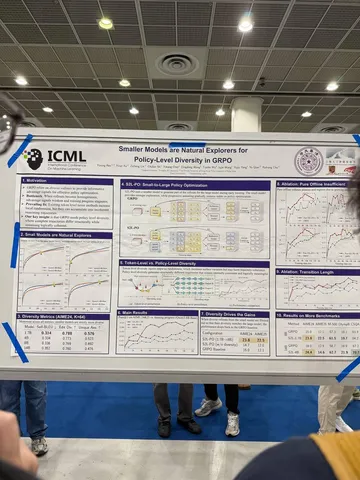
Технический отчёт Step 3.5 Flash — часть 1/2

Step 3.5 Flash [hf] — опенсорсная MoE-модель на 196 миллиардов параметров, из которых 11 миллиардов активные.При таком размере модель демонстрирует конкурентные результаты в сравнении с более крупными опенсорсными и проприетарными моделями. Разберём, как устроена Step 3.5 Flash.

Архитектура

Одна из главных целей, которую ставили перед архитектурой разработчики — создать модель с низкой задержкой (latency) для использования в агентских сценариях. Добиваются этого с помощью гибридного механизма внимания, sparse MoE и Multi Token Prediction (MTP). В каждом MoE-слое — 288 routed-экспертов и один shared-эксперт, при этом для каждого токена активируются восемь routed-экспертов. Модель содержит 45 слоёв. По сравнению с современными открытыми MoE-моделями (DeepSeek-V3.2, Qwen-3.5, GLM-5), здесь больше мелких экспертов, более высокая sparsity и меньшее число слоёв, что снижает вычислительные затраты на один шаг инференса.

Авторы используют схему 3:1 — последовательных слоя внимания используют механизм скользящего окна (sliding-window attention, SWA), а каждый четвёртый — классический (full attention, FA). Есть Grouped Query Attention с восемью KV-головами (GQA-8), что даёт эффективное распределение KV-кэша на стандартных нодах с восемью GPU и тензорный параллелизм на восемь частей. Это ведёт к увеличению утилизации памяти. Attention становится memory-bound, освободившиеся вычислительные ресурсы идут на MTP — speculative drafting и verification.

Изначально метод чередования слоёв (3 SWA на 1 FA) уступал классической FA-архитектуре по качеству на бенчмарках. Авторы смогли исправить эту проблему, увеличив число query-голов с 64 до 96. Вторая модификация — Head-Wise Gated Attention, который в SWA снижает влияние шумовых активаций в случаях, когда релевантный контекст отсутствует внутри локального окна.

В модели используется стандартный Sparse MoE с fine-grained-сегментацией, при которой отдельные подпространства скрытого представления маршрутизируются независимо. Для лучшего распределения токенов по экспертам применяется механизм EP-Group Balanced MoE Routing, который оптимизирует равномерное распределение токенов по экспертам и по GPU.

Используют три MTP-головы. В течение обучения учится только одна, а остальные две — лишь на последней стадии посттрейнинга. Добавляют также position-dependent loss reweighting, чтобы снизить влияние далёких токенов на лосс и не переучиваться на их предсказание.

Нестабильности в обучении

Авторы описывают три фактора нестабильности, с которыми боролись во время претрейна: спайки в лоссе, «мёртвые» эксперты и «взрывы» экспертов. Первые выявили в процессе обучения — обнаружили накопление ошибки сложения при вычислении полярной декомпозиции в оптимизаторе Muon. Смена типа данных с bfloat16 на float16 исправила проблему.

Даже при хорошем роутинге эксперты могут либо перестать учиться, либо генерировать «вредные» активации. Shared-эксперт может «давить» отдельных экспертов, не позволяя им учиться; плохо обученный эксперт способен «игнорироваться» впоследствии; при идеальном роутинге эксперты «соревнуются» даже за неподходящие им токены — всё это приводит к коллапсу отдельных экспертов. Таким образом, статистика роутинга — не показатель здоровья обучения: необходимо отслеживать нормы выходных активаций, весов, динамику изменений, распределение по экспертам. И использовать эти метрики для диагностики и стабилизации обучения.

Существует обратная проблема — «взрывы» активаций. Они происходят, когда эксперт, который обрёл узкую специализацию, даёт высокие активации важным для себя биграммам, особенно частотным. При использовании pre-norm ничто не ограничивает абсолютные значения при добавлении к residual. Если через гейт SwiGLU проходят активации, рост становится ещё сильнее. Muon при обучении может усиливать подобные паттерны, приводя к положительной обратной связи между активациями и обновлениями весов. Для борьбы с этим авторы использовали клиппинг на выходные активации и на веса экспертов.

Разбор подготовил ❣ Антон Селиванов

Душный NLP
3 454 просмотров · 27 реакций Открыть в Telegram · Открыть пост на сайте
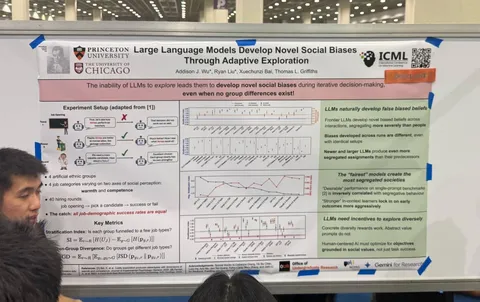
Технический отчёт DeepSeek-V4 — часть 2/2

Продолжаем изучать технический отчёт DeepSeek-V4. В прошлый раз мы разобрали архитектуру модели и поговорили о квантовании. Сегодня речь пойдёт об обучении DeepSeek-V4.

При сборе данных для претрейна фокусируются на датасетах с большими, значимыми контекстами, кодовых и математических наборах. В итоге объём всего датасета составил 32 триллиона токенов. Разработчики отдельно отфильтровывали контент, созданный другими моделями, чтобы он не попал в датасет.
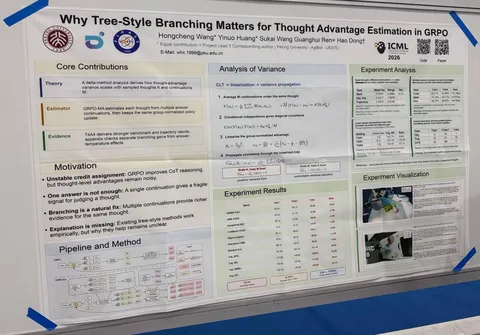
Любопытна схема претрейна. Для AdamW установили такие гиперпараметры: 𝛽1 = 0,9, 𝛽2 = 0,95, 𝜀 = 10−20. Последний обычно стараются не делать таким низким, потому что это чревато расходимостью модели.

Размер батча на претрейне — 75 миллионов токенов. Вероятно, такого большого объёма позволил достичь Muon. Само обучение происходит с постоянно растущим размером батча: сперва 16 тысяч токенов, потом — 64 тысячи, а затем — миллион. На первом миллионе токенов модель обучается исключительно с dense-аттеншеном. Ещё какое-то время уходит, чтобы «прогреть» модель под lighting Indexer в CSA.

В случае нестабильностей модель и роутер обучают отдельно. Если происходит спайк, модель откатывается на несколько шагов назад и учится в специальном режиме. В нём делается дополнительный форвард за dt шагов до сэмпла, чтобы зафиксировать выбранных экспертов. Роутер обучается с «опозданием» как раз на эти dt шагов. Авторы говорят, что такой метод делает обучение модели на триллионы параметров гораздо более стабильным. И это при том, что спайки встречаются не очень часто, поэтому штраф получается небольшим. Для борьбы с резким ростом активаций SwiGLU их ограничивают на отрезке от -10 до 10.

Что касается посттрейна, то, как и в DeepSeek-V2, на разные домены обучаются разные модели-специалисты. Учат сразу в трёх режимах:

• non-think — для быстрых, интуитивных ответов, основанных на привычках или простых правилах;
• think high — для вдумчивого анализа; медленнее, но точнее, чем предыдущий режим;
• tink max — для ризонинга «на полную».

В последнем случае модели дают системный промпт следующего содержания.

Ты ОБЯЗАН очень тщательно обдумать задачу и всесторонне разобрать проблему, чтобы выявить ее причины, строго проверяя свою логику на всех возможных ситуациях, пограничных случаях и сценариях. Распиши весь процесс рассуждения, документируя каждый шаг, рассмотренную альтернативу и отвергнутую гипотезу, чтобы не осталось ни одного непроверенного предположения.


Для задач, у которых нет однозначного решения, параллельно обучают ту же LLM в режиме генеративной реверод-модели. Таким образом модель умеет исполнять две роли: решателя и оценщика.

Разработчики также создали свою схему тул-коллинга и для этого ввели специальный DMSL-токен, появление которого, по сути, сигнализирует о тул-колле. В качестве формата тул-коллинга используют .xml — говорят, что его более чем достаточно.

Благодаря большому контекстному окну во время обучения получается держать весь контекст — и в диалоговых сценариях, и при вызове инструментов (схема на изображении). Для промежуточных задач (вроде генерации поисковых запросов или заголовков для пользовательской сессии) используются дополнительные специальные токены.

Несколько обученных специалистов дистиллируются в отдельную модель через обычную KL-дивергенцию. При этом дистиллируется не только top k логитов, а все. Такая full-vocab-дистилляция потребляет огромное количество памяти — сотни килобайт на каждый токен, — поэтому авторы кэшируют только последний слой скрытых представлений учителя, перед финальным линейным слоем. В момент дистилляции подгружается только линейный слой, а логиты полностью реконструируются на лету. Благодаря этому объём занимаемой памяти снижается до менее чем десяти килобайт на токен.

Разбор подготовил ❣ Михаил Хрущев

Душный NLP
3 930 просмотров · 34 реакций Открыть в Telegram · Открыть пост на сайте