Тематическая подборка статей: дискриминативные модели

Свежая подборка статей о методах улучшения взаимодействия текста и изображений в мультимодальных моделях. В центре внимания — файнтюн CLIP для понимания отрицаний, новые подходы к retrieval, оптимизации архитектур Vision Transformer и многое другое.

Дообучение CLIP-моделей

TNG-CLIP: Training-Time Negation Data Generation for Negation Awareness of CLIP

Предлагают пайплайн файнтюна текстовой части CLIP на понимание отрицаний: на лету для батча генерируют новые тексты, содержащие отрицания, используя тексты с похожих картинок для усложнения задачи. Также показывают, что можно подменить текстовый энкодер в предобученной диффузионной модели, и генерации с отрицаниями в промпте тоже станут лучше.

Visualized Text-to-Image Retrieval

Авторы говорят, что вместо text-to-image retrieval можно сначала сгенерировать картинку по текстовому запросу, а потом уже делать image-to-image retrieval чисто по картиночным фичам. Тестируются на специфических постановках задач типа RAG, но идея интересная.

Hard Negative Contrastive Learning for Fine-Grained Geometric Understanding in Large Multimodal Models

Доливают в обучение CLIP датасет с геометрией и используют полученную модель как энкодер в VLM. Геометрические датасеты добавляют и в другие стадии обучения VLM, но основная новизна в том, как сделать файнтюн на геометрию в CLIP-постановке.

Distill CLIP (DCLIP): Enhancing Image-Text Retrieval via Cross-Modal Transformer Distillation

Для дообучения CLIP собирают модель-учитель, которая извлекает картиночные фичи по выделенным через YOLO областям и агрегирует их через cross-attention с текстовыми фичами; затем этот учитель используется для дистилляции. С ростом качества на retrieval-задачах метод просаживает точность zero-shot-классификации.

Vision Transformers with Self-Distilled Registers

Изучают проблему токенов-аутлаеров в трансформерных моделях, описанную в статье Vision Transformers Need Registers. В ней предложили на вход модели подавать токены-регистры. Также авторы пишут, что такие токены можно добавлять в уже обученную модель и файнтюнить её так, чтобы аутлаеры «перетекали» в добавленные токены.

Архитектура дискриминативных моделей

Taming Transformer Without Using Learning Rate Warmup

Связывают нестабильность в обучении трансформеров с тем, что матрица аттеншена становится низкоранговой и разреженной. Предлагают добавить в Adam ограничение на learning rate для апдейтов, которые имеют высокую спектральную норму по сравнению с текущей матрицей. Показывают, что в этом случае возможно обучение без lr-warmup'а.

RePaViT: Scalable Vision Transformer Acceleration via Structural Reparameterization on Feedforward Network Layers

Применяют идеи из ShuffleNet к ViT: в FFN-блоке делают нелинейность только для части нейронов промежуточного слоя — вторую часть можно после обучения вмерджить в одну линейную операцию. Также заменяют LayerNorm на BatchNorm и его тоже вмердживают после обучения. Но тестируют всё это только на ImageNet, есть подозрение, что на более сложных датасетах профита не будет.

TextRegion: Text-Aligned Region Tokens from Frozen Image-Text Models

Решают zero-shot-сегментацию и смежные задачи, предлагают пайплайн, в котором объединяют SAM и CLIP-модель: через SAM находят области с объектами, и в CLIP-модели модифицируют аттеншен последнего слоя, чтобы он смотрел на каждую область по отдельности — таким образом получают токены для областей, которые уже можно сопоставлять с текстовыми представлениями класса и делать сегментацию.

REN: Fast and Efficient Region Encodings from Patch-Based Image Encoders

Отличие от предыдущей статьи в том, что теперь область интереса на картинке кодируем координатами точки. Имея предобученный бэкбон, добавляем к нему голову, которая по координатам точки смотрит на карту признаков и возвращает эмбеддинг соответствующего ей объекта; SAM теперь используется только на этапе обучения.

Подборку подготовил ❣ Артём Конев
CV Time
2 157 просмотров · 27 реакций Открыть в Telegram · Открыть пост на сайте
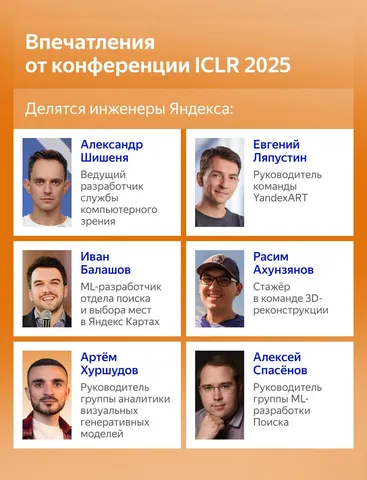
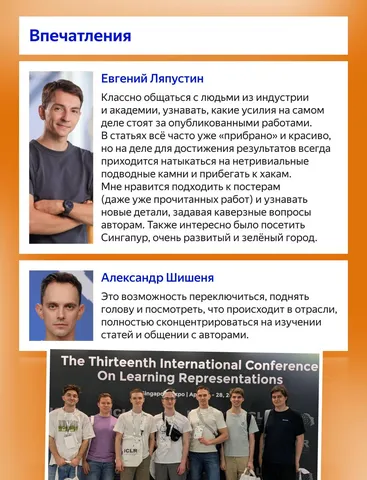
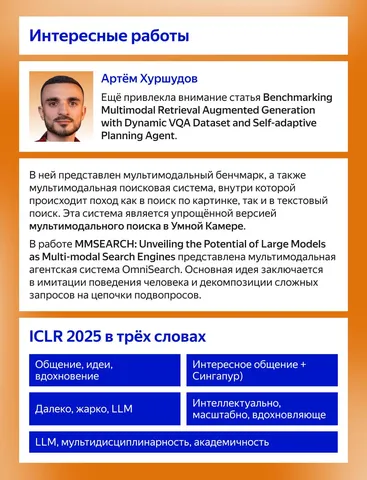
Впечатления от конференции ICLR 2025

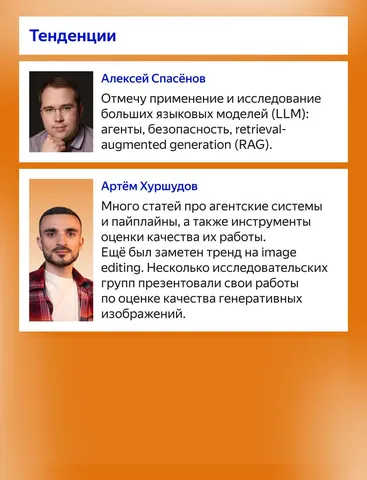
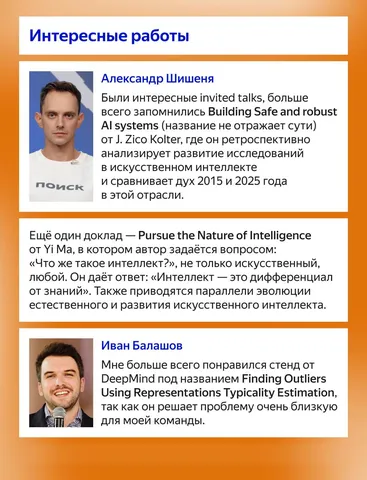
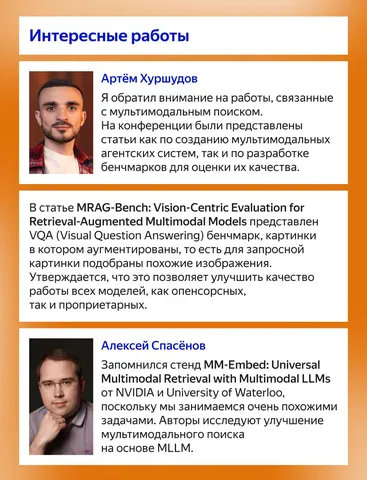
ICLR 2025 принесла много полезных работ на тему CV. Мы попросили инженеров Яндекса подвести личные итоги конференции и рассказать, чем она запомнилась. О трендах в индустрии, интересных статьях и многом другом — в наших карточках.

Работы, которые упоминаются в посте:
— Building Safe and Robust AI Systems
— Pursue the Nature of Intelligence
— Adam: A Method for Stochastic Optimization
— Neural Machine Translation by Jointly Learning to Align and Translate
— Finding Outliers Using Representations Typicality Estimation
— MRAG-Bench: Vision-Centric Evaluation for Retrieval-Augmented Multimodal Models
— Benchmarking Multimodal Retrieval Augmented Generation with Dynamic VQA Dataset and Self-adaptive Planning Agent
— MMSEARCH: Unveiling the Potential of Large Models as Multi-modal Search Engines
— MM-Embed: Universal Multimodal Retrieval with Multimodal LLMs
— VLM в Нейро: как мы создавали мультимодальную нейросеть для поиска по картинкам

CV Time

#YaICLR
1 945 просмотров · 21 реакций Открыть в Telegram · Открыть пост на сайте
ICLR 2025: полезные статьи на тему CV

Конференция прошла, а интересные статьи, которые мы не успели упомянуть в наших подборках, — остались. Александр Шишеня, ведущий разработчик службы компьютерного зрения, отобрал и прокомментировал несколько работ, заслуживающих внимания.

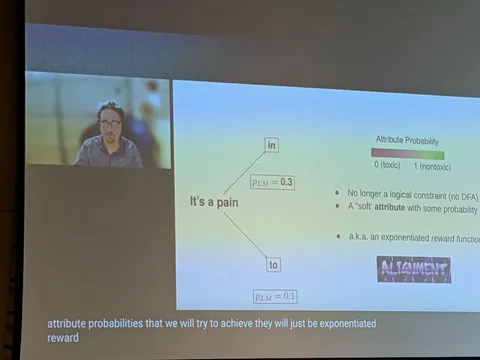
Symbolic reasoning about LLMs

- Подход Ctrl-G позволяет модели генерировать ответ, который подчиняется жёстким условиям (например, валидный JSON). Основан на использовании детерминистического конечного автомата и скрытой марковской цепи в дополнение к обученной LLM.
- Можно навешивать мягкие ограничения в виде дополнительной LLM, заточенной на сдвиг генерации в нужное направление (например, убирать токсичность).

Neural Networks as Graphs

Используют графовую нейросеть для генерации апдейтов весов сети при обучении. Лучший результат получается, если чередовать такие нейросетевые апдейты с итерациями Adam. Один из авторов работы — Борис Князев.

Training Language Models in Academia: Challenge or Calling?

У академии на несколько порядков меньше ресурсов, чем у индустрии. Какую же роль в таком случае может играть академия в современном DL? Автор даёт свой ответ: возможностей академии хватает, чтобы делать полезный ресерч, а жёсткие ограничения диктуют направление развития — это оптимизация ресурсов и поиск подходов по ускорению обучения. В качестве доказательства приводится список работ Best Paper Awards ICML 2025, где большинство работ выполнено академией. Сомнительное доказательство — ведь можно предположить, что индустрии просто не так важно публиковаться, да и коммерческую тайну никто не отменял.

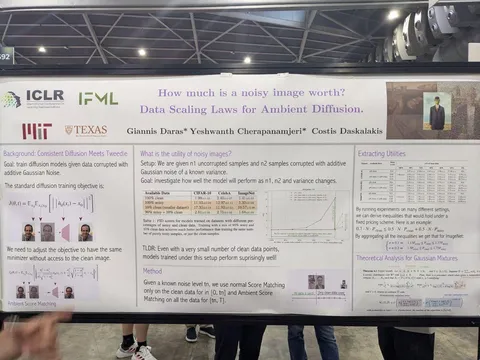
How much is a noisy image worth? Data Scaling Laws for Ambient Diffusion

Эффективно используются шумные данные для обучения диффузии. Выведен специальный лосс, который применяется к шумным сэмплам, а для чистых данных используется обычный лосс.

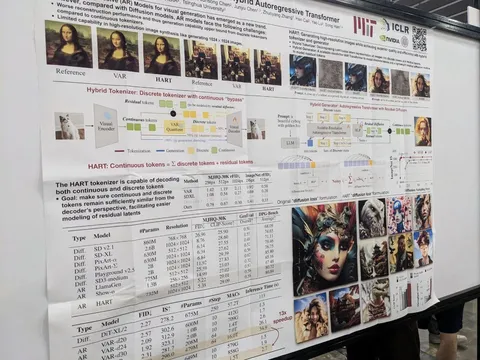
HART: Efficient Visual Generation with Hybrid Autoregressive Transformer

Статья от MIT и NVIDIA. Предлагается картиночный токенизатор, который генерирует дискретные токены и непрерывные поправки к ним. Далее дискретные токены предсказываются авторегрессионной моделью, а непрерывные — легковесной диффузионной моделью.

Zigzag Diffusion Sampling: Diffusion Models Can Self-Improve via Self-Reflection

Улучшают качество генерации изображений, чередуя прямую генерацию с высоким гайденсом и обратную генерацию с низким гайденсом.

GoodDrag: Towards Good Practices for Drag Editing with Diffusion Models

Редактирование изображений с помощью варпа. Фишка в том, что итерации варпа и денойзинга применяются попеременно — это позволяет достичь лучшего качества, чем последовательное применение сначала полного варпа, а потом расшумления.

Test-time Alignment of Diffusion Models without Reward Over-optimization

Элайнмент диффузионной модели на этапе сэмплирования. RL-Objective можно явно оптимизировать и выразить целевую плотность вероятности через плотность вероятности претренированной модели и реворд-функцию. Дальше сэмплируются сразу несколько траекторий, попутно отсеивая траектории с низким ревордом, добавляя новые и постепенно уменьшая силу гайденса.

CV Time

#YaICLR
1 814 просмотров · 19 реакций Открыть в Telegram · Открыть пост на сайте
Что читает команда распознавания текста в VLM: подборка актуальных статей

Инженеры VLM-команды Яндекса поделились статьями, которые они в последнее время читали и обсуждали. В сегодняшней подборке: новые подходы к генерации инфографики, свежие бенчмарки для мультимодальных моделей, работающие пайплайны генерации кода по графику и попытки добавить зрение в диффузионки.

ChartGalaxy: A Dataset for Infographic Chart Understanding and Generation
Статья о том, как сгенерировать около миллиона инфографик. Авторы подробно описали каждую стадию процесса: сбор шаблонов, индексирование описаний, иконок и других элементов для заполнения шаблонов, фильтрацию и проверку качества.

InfoChartQA: A Benchmark for Multimodal Question Answering on Infographic Charts
Авторы собрали новый бенчмарк позволяющий проверить, как VLM-модели понимают инфографику. Для каждой инфографики сделали упрощённую версию в виде обычного графика с теми же данными — модели справляются с таким заметно лучше, чем с визуально перегруженным оригиналом. Также добавили новый тип вопросов по отдельным кропам из изображения инфографики — на понимание мелких визуальных деталей.

ChartCoder: Advancing Multimodal Large Language Model for Chart-to-Code Generation
Авторы обучили модель понимать графики: она получает изображение и возвращает код на Python (Matplotlib), чтобы построить такой же график. Для этого использовали стратегию Snippet-of-Thoughts (SoT) — пошаговое рассуждение перед финальной генерацией кода. Взяли LLM, способную писать код, собрали датасет под задачу (160 тысяч картинок, на каждую — один вопрос и ответ). Кратко описали пайплайн его создания. Модель показывает лучшие результаты среди аналогов такого же размера (включая почти самые свежие Qwen и InternVL). В ablation-экспериментах дообучили Qwen на своём датасете — получили прирост; 384 px + Anyres почти хватает для большинства графиков.

Relation-Rich Visual Document Generator for Visual Information Extraction
Статья с CVPR 2025 о генерации синтетических text-rich-документов с логической структурой (таких, как формы). Пайплайн генерации любопытен тем, что в нём сначала генерируют текст с помощью ChatGPT, а уже потом — структуру документа (laytout). Чаще встречается обратный вариант, когда структуру документа заполняют текстом. Авторы показывают, что обучение Qwen2-VL и Llava-NexT-mistral на таких данных улучшает метрики распознавания текста и извлечения информации на публичных бенчмарках.

LLaDA-V: Large Language Diffusion Models with Visual Instruction Tuning
Авторы попытались расширить предобученную текстовую диффузию LLaDA на мультимодальность, добавив визуальный вход через SigLIP2 и MLP-проекцию в языковое пространство. Итоговая модель зафайнтюнена на визуальных и reasoning-focused-инструкциях MAmmoTH-VL и VisualWebInstruct и бьёт автогрессионные и диффузионные бейзлайны по ряду мультидисциплинарных и визуально-математических бенчмарков.

SFT Memorizes, RL Generalizes: A Comparative Study of Foundation Model Post-training
Интересная статья, авторы которой подтверждают тезис из названия: SFT хорошо запоминает жёсткие форматы и правила, но плохо справляется с out-of-distribution-задачами. В то же время RL реально улучшает генерализацию и показывает заметный прирост на OOD-случаях. Но SFT всё равно нужен, чтобы RL вообще завёлся. В противном случае модель не умеет нормально реагировать на инструкции или генерирует неконтролируемый выход. RL-обучение не получает положительного сигнала. Это справедливо как для LLM, так и для VLM.

Подборку подготовила ❣ Команда распознавания текста в VLM
CV Time
4 271 просмотров · 40 реакций Открыть в Telegram · Открыть пост на сайте
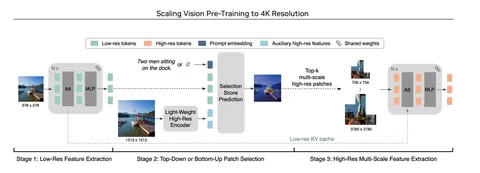
Scaling Vision Pre-Training to 4K Resolution

Большинство доступных визуальных энкодеров предобучено на изображениях низкого разрешения: например, на 378✕378, как SigLIP. Это становится серьёзной проблемой, если вы хотите обрабатывать изображения высокого разрешения с мелкими деталями. Дорожный знак STOP будет неразличим, если сжать кадры записи видеорегистратора до 378✕378. То же касается распознавания текста, где много мелких деталей.

Авторы сегодняшней статьи отмечают, что в индустрии уже борются с этой проблемой. Методом AnyRes режут большое изображение на части поменьше — тайлы без пересечений. Или, как в S2, одновременно ресайзят изображение до нужного размера и делят его оригинал на тайлы, чтобы добавить каналы для описания одних и тех же участков изображения в более высоком разрешении. Но эти методы кодируют картинку заранее — не учитывая запрос пользователя. Логично предположить, что для вопроса, например, про одежду человека, не нужно кодировать автомобили и здания.

Новое решение, которое предлагают авторы сегодняшней статьи, учитывает промпты пользователя. Они предлагают подбирать куски изображения, которые подходят под запрос, и подмешивать их в инпут. Сделать это можно в два шага:

1. предобучить энкодер PS3, который сможет угадывать подходящие области изображения;
2. обучить VLM отвечать на запросы пользователя вместе c энкодером PS3.

А если промпта нет и top-down-selection невозможен, можно подключить bottom-up-selection: попросить нейросеть самостоятельно выбрать интересные области. «Интересность» при этом определяется данными, на которых обучалась модель.

Архитектура PS3 изображена на схеме. На входе — предобученный SigLIP. Энкодим им изображение и получаем low-res-фичи. Из-за ресайза теряются все высокоуровневые фичи. Авторы предлагают исправить это с помощью дополнительного так называемого light-weight-high-res-энкодера (обучаемая урезанная CNN). Третьей фичой будет либо эмбеддинг текста, чтобы выбрать интересный образ, либо обучаемый эмбеддинг, который заменит промпт. По этой тройке для каждой позиции предсказывается вероятность её релевантности: вырезают топ-K областей и энкодят через SigLIP (несколько раз в разных разрешениях).

Итоговые фичи картинки — исходные low-res и вырезанные топ-K областей. Чтобы подключить PS3 к VLM, понадобится LLM: достаточно передать последний токен из запроса к ней в PS3. Отобрав топ выученных с энкодом позиционных эмбеддов, можно переходить к тренировке language modeling.

Для эффективного обучения VLM вместе с PS3 нужно дотюнить выбор региона, чтобы подмена не ощущалась. А дальше можно тренировать модель как обычно.

Модель, которая получилась после подключения PS3 к мультимодальной LLM, авторы назвали VILA-HD. По их замерам, она значительно превосходит по качеству AnyRes и S2, используя при этом в 4,3 раза меньше токенов.

Разбор подготовил ❣ Егор Шестопалов

CV Time
2 047 просмотров · 24 реакций Открыть в Telegram · Открыть пост на сайте
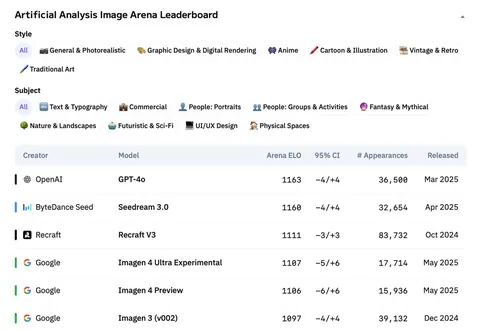
Seedream 3.0 Technical Report

Сегодняшняя статья — описание модели Seedream 3.0, которая генерирует изображения по текстовым запросам. Был момент, когда по замерам Artificial Analysis Arena она обогнала все существующие модели, сейчас — топ-2 модель, уступающая только OpenAI. Правда, с нестатзначимой разницей.

Кажется, что создатели третьей версии Seedream проделали огромную техническую работу и потратили очень много человекочасов, разрабатывая свои модели. Статья вышла всего лишь через месяц после Seedream 2.0, так что её можно воспринимать как набор доработок к прошлой модели, уже неплохо показавшей себя.

Обучая Seedream 3.0, авторы уделили много внимания специфике китайского языка — у многих моделей-конкурентов проблемы с рисованием иероглифов. В частности, обучающие датасеты Seedream обогатили набором объектов китайской культуры. Ещё одна интересная деталь: после первой стадии обучения на изображениях размером 256 пикселей, модель обучается уже на целом диапазоне разрешений — от 512 до 2048 пикселей. А чтобы выкидывать из обучающего датасета меньше картинок с дефектами и вотермарками, авторы просто маскируют в лоссе проблемные области.

В статье упоминается, что авторы обучили собственный VAE, но деталей, к сожалению, нет. Диффузионный трансформер принимает на вход картинку и закодированный текст, но токены для них обрабатываются отдельными MLP. Собственная разработка авторов — расширение 2D RoPE, которое они назвали Scaling RoPE, позволяет генерировать изображения с размером, отличным от того, на чём обучали модель. Стабильность обучения обеспечивает QK-Norm.

Текстовый энкодер дофайнтьюнили из LLM, тренируя её на парах текст-изображение. Так LLM лучше мэтчится с доменом картинок. Закодированные текстовые энкодеры она передаёт в диффузионный трансформер.

Тексты, которые нужно зарендерить на картинке, обрабатывает ByT5 — модель работает на уровне Unicode. Не делит тексты на токены по несколько символов, а кодирует их как последовательность кодов Unicode, чтобы генерировать текст было проще.

Кроме того, в Seedream 3.0 авторы использовали новую парадигму ускорения. Используя разнообразные техники, такие как квантование, консистентное зашумление и семплирование временных шагов с ранжированием по важности, они достигли существенного ускорения при сохранении качества изображения. А встроенный вывод изображений в высоком разрешении (до 2K), делает новую модель ещё более удобной и практичной.

Разбор подготовил ❣ Артём Конев
CV Time
1 969 просмотров · 19 реакций Открыть в Telegram · Открыть пост на сайте
Kimi-VL technical report

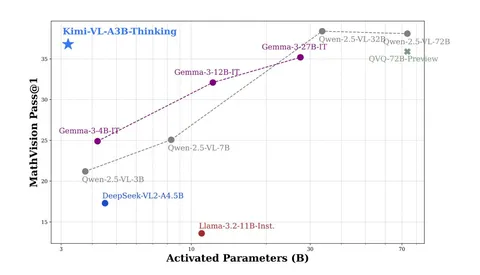
Сегодня разбираем статью про Kimi-VL — yet another VLM, интересная тем, что умеет понимать очень длинные контексты, активируя всего 2,8B параметров. Это не мешает ей получать результаты лучше, чем Qwen2.5-VL-7B, and Gemma-3-12B-IT и даже GPT-4o-mini на некоторых тасках.

Kimi-VL под силу контексты размером в 128K токенов и работа с изображениями разного разрешения — для этого у неё под капотом специальный визуальный энкодер. Авторы говорят, что они разработали две версии нейросети: обычную и thinking, которая кроме всего вышеперечисленного справляется с reasoning — длинными рассуждениями. На картинке — сравнение Kimi-VL с другими популярными нейросетями: сколько параметров активируется на бенчмарке MathVision.

Авторы считают, что будущее — за MoE и CoT (как у DeepSeek и других LLM), а плотная архитектура, которую использует большинство опенсорс-VLM (например, Qwen2.5-VL и Gemma-3), устарела.

Kimi-VL, по их словам, догоняет по способностям LLM. На основе SigLIP-SO-400M они создали собственный визуальный энкодер — MoonViT. Он может обрабатывать картинки разного разрешения: по аналогии с текстовыми последовательностями разбирает их на батчи, вытягивает и превращает в 1D-векторы. Чем выше разрешение — тем больше векторов в последовательности. Каждый батч локализуют по ширине и по высоте. Энкодер и LLM соединяет двухслойный MLP.

Для претрейна используется много текстовых данных: судя по всему, именно это позволяет активировать меньше параметров для её работы. Само обучение состоит из нескольких частей:

1. Предобучение энкодера ViT (2T + 0,1T токенов): MoonViT обучается работать с картинками на парах изображение+текст.
2. Joint Pre-training (1,4T токенов). Модель тренируется обрабатывать запросы на чисто текстовых данных.
3. Joint Cooldown (0,6T токенов). Оптимизация производительности модели: обучение на высококачественных языковых и мультимодальных наборах данных.
4. Joint Long-context (0,3T токенов). Увеличение длины контекста модели с 8K до 128K. Чтобы модель лучше понимала длинный контекст и одновременно хорошо работала с коротким, на каждом подэтапе этой стадии обучения авторы фильтруют и увеличивают соотношение длинных данных до 25%.

Хотя текущая модель эффективно справляется со многими стандартными задачами, она всё ещё слишком мала для решения узкоспециализированных задач. Возможности рассуждений Kimi-VL ещё не достигли теоретического максимума, особенно для сложных задач, требующих многоступенчатых выводов или более глубокого контекстного понимания. Путь к преодолению этих сложностей — масштабирование модели и совершенствование алгоритмов обучения (в том числе обогащение и увеличение тренировочных датасетов).

Разбор подготовила ❣ Дарья Виноградова
CV Time
2 106 просмотров · 33 реакций Открыть в Telegram · Открыть пост на сайте
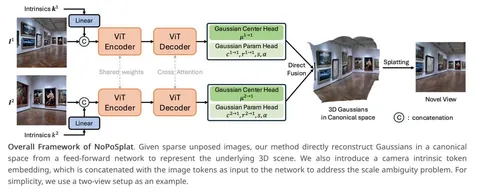
No Pose, No Problem: Surprisingly Simple 3D Gaussian Splats from Sparse Unposed Images

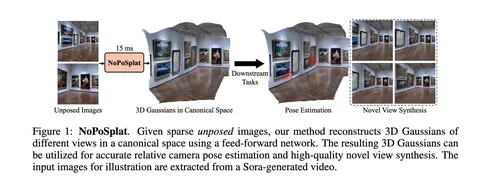
Сегодня коротко разбираем работу NoPoSplat, в которой предлагается метод 3D-реконструкции по RGB-изображениям без информации об их позах. Модель NoPoSplat выдаёт 3D Gaussian Splatting (3DGS) облако, которое можно рендерить (novel view synthesis, NVS) и использовать для оценки относительного положения камер (relative pose estimation).

Ключевое достижение статьи — демонстрация того, что простая архитектура, основанная на трансформерах (ViT, DPT), обученная исключительно с использованием фотометрических функций потерь, может решать задачи реконструкции за один прямой проход. Метод полагается на наличие внутренних параметров (intrinsics) камеры, однако обычно получить их легче, чем внешние (extrinsics).

Это интересно потому, что традиционные методы 3D-реконструкции и синтеза изображений часто требуют большого числа изображений, информации о параметрах камер и полагаются на многоэтапные structure from motion-пайплайны. Если количество входных изображений ограничено — так называемый sparse view — возникает проблема плохого перекрытия контента. Методы, которые полагаются на геометрические прайоры, например, cost volumes (например, MVSplat) или epipolar geometry (например, PixelSplat), перестают работать. Знание поз камер — существенное ограничение для in-the-wild приложений, например, обработки user generated content.

Архитектура модели «многобашенная» и состоит из трёх основных компонентов: ViT энкодера и декодера и DPT-голов, предсказывающих параметры 3DGS-облака, и повторяет широко известные DUSt3R и MASt3R. Веса энкодеров общие, а в декодерах применяется cross view attention.

У модели две головы. Первая предсказывает центроиды гауссиан, а вторая — оставшиеся параметры: поворот, масштаб, цвет. Чтобы лучше предсказывать цвет, в модели есть RGB shortcut — вместе с токенами из декодера в голову через свёртку пробрасывается патч из входного изображения. В качестве канонического пространства фиксируется система координат относительно первого входного изображения, и головы выдают параметры гауссиан в этой единой системе координат.

Для решения проблемы неоднозначности масштаба NoPoSplat делают camera intrinsic embedding. Интринсики преобразуются в токен и конкатенируются в энкодере с токенами картиночных патчей. В статье рассматривается ещё два способа добавления интринсиков в модель, но они оказались немного хуже.

Если описывать метод одним предложением, то можно сказать, что это MASt3R c примочками для предсказания 3DGS-облака.

Обучение модели проводится с использованием MSE- и LPIPS-лоссов, то есть для супервизии используют только RGB-изображения. Обучаемая модель предсказывает параметры 3DGS по входным изображениям. Затем 3DGS отрисовывается дифференцируемым рендером в нескольких новых известных позах из обучающего датасета и рендеры сравниваются с GT-изображениями. Groundtruth-позы используются только для рендеринга в процессе обучения. Обучают на датасетах RealEstate10k, ACID и DL3DV. Они включают RGB-изображения, а положения камер оценены с помощью COLMAP.

Модель может быть инициализирована случайно, но поскольку архитектура повторяет CroCoV2, DUSt3R и MASt3R, попробовали частично инициализировать веса из них и это дало лучшие результаты. Поскольку MASt3R был обучен на данных с GT-информацией о глубине, то нельзя сказать, что лучшая модель NoPoSplat обучена только на RGB-данных.

Для решения задачи оценки относительной позы между входными изображениями сначала находят приближение с использованием PnP + RANSAC, затем её уточняют, используя SSIM loss относительно предсказанного 3DGS-облака.

Качество NVS зависит от количества картинок на входе и степени их взаимного пересечения, PSNR варьируется от 22 до 27. С одной стороны, не так уж много, а с другой — удивительно хорошо при такой постановке задачи.

Разбор подготовил ❣ Расим Ахунзянов
CV Time

#YaICLR
2 116 просмотров · 29 реакций Открыть в Telegram · Открыть пост на сайте
Improving the Diffusability of Autoencoders

Сегодня разбираем статью, в которой обсуждается то, что авторы называют diffusability латентного пространства: насколько легко диффузионной модели учиться на латентах автоэнкодера.

В латентных диффузионных моделях (например, Stable Diffusion) генерация происходит не в пикселях, а в сжатом представлении. Это ускоряет обучение, но вводит зависимость от свойств автоэнкодера. Обычно смотрят только на качество реконструкции: насколько хорошо декодер восстанавливает изображение. Но есть вторая характеристика — diffusability, и именно её авторы рассматривают в этой работе.

Что такое diffusability и почему это важно

Если латенты имеют сложное распределение или содержат неинформативные шумовые компоненты, диффузии приходится подстраиваться под это распределение — обучаться дольше и потенциально упираться в потолок качества. Поэтому автоэнкодер задаёт не только качество реконструкции, но и удобство обучения вместе с последующей генерацией.

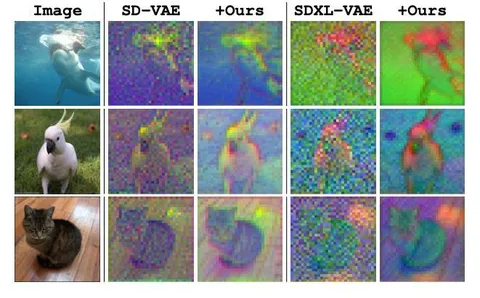
Авторы смотрят на латенты от обычных автоэнкодеров и замечают, что они визуально шумные: в них много высокочастотных деталей, особенно в фоне. Чтобы разобраться, применяют дискретное косинусное преобразование (DCT), как в JPEG. Разбивают картинку или латент на блоки 8×8, считают DCT по каждому из них, усредняют спектры и строят частотный профиль.

Выясняется, что латенты содержат больше высокочастотных компонентов, чем изображения, и это особенно заметно при увеличении числа каналов. Даже если латент визуально похож на картинку, его частотный профиль сильно отличается. А если обнулить высокие частоты и попробовать восстановить изображение, латент теряет качество гораздо сильнее, чем обычное изображение — там такие потери почти незаметны. Это говорит о том, что латенты слишком зависят от высокочастотной части и не обладают масштабной эквивариантностью.

Тогда авторы добавляют к лоссу автоэнкодера простую компоненту: берут исходное изображение и соответствующий латент, уменьшают их разрешение (в 2 или 4 раза), затем реконструируют картинку из сжатого латента и считают дополнительный лосс между даунскейленным изображением и полученной реконструкцией.

Таким образом они обеспечивают соблюдения свойства масштабной инвариантности (потому что лосс буквально это и делает), что, в свою очередь, регуляризует латенты, убирая из них лишние высокие частоты.

Результат — латенты становятся менее шумными, частотные профили ближе к тем, что у изображений. И, что важно, визуально структура латента сохраняется. Согласно метрикам, качество реконструкции почти не падает.

Эксперименты

Метод протестировали на ImageNet-1K (изображения) и Kinetics-700 (видео). Сравнивали обучение диффузионной модели на обычных и исправленных латентах.

В статье diffusability измеряют через скорость обучения: берут автоэнкодер, обучают на нём диффузионную модель и смотрят, насколько быстро растёт метрика качества (например, FID для изображений и FVD для видео). Сравнивались базовые модели и те же архитектуры, но обученные на автоэнкодерах с исходным и улучшенным diffusability. Оказалось, что последние учатся быстрее и дают лучшее финальное качество.

Результаты:
— генерация изображений: FID улучшился на 19%;
— генерация видео: FVD улучшился на 44%;
— модели обучаются быстрее;
— PSNR немного растёт (за счёт блюра), но визуально картинки выглядят нормально.

Визуализация того, как выглядят латенты до и после (см. картинку), взята из другой работы, посвященной этой же теме: шум действительно уходит, но структура остаётся. Частотные кривые тоже приближаются к тем, что у изображений.

В целом статья посвящена довольно локальной проблеме, но в ней есть понятная идея и измеримый эффект.

Разбор подготовил ❣ Сергей Кастрюлин
CV Time
5 909 просмотров · 37 реакций Открыть в Telegram · Открыть пост на сайте
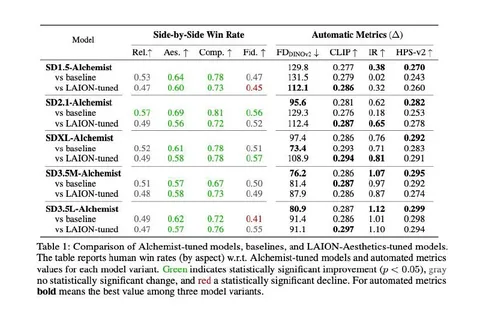
Yandex Alchemist: открытый датасет для буста text-to-image генерации

Раньше T2I-модели обучали в один этап — претрейн на большом, довольно грязном датасете интернет-данных. В 2023 году Meta в техрепорте EMU предложили делать файнтюн на маленьком датасете исключительного качества и за счёт этого существенно бустить результат генерации. Правда, они ничего не сказали о том, как такой датасет собрать.

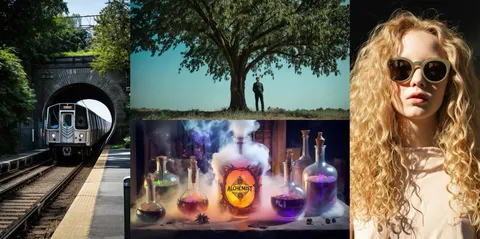
Команда YandexART тоже занималась этой задачей, и сегодня мы делимся результатами своей работы — датасетом Alchemist. Он состоит из 3 350 пар «картинка-текст» и имеет лицензию Apache 2.0, пользуйтесь.

Alchemist сокращает дистанцию между крутыми потюненными закрытыми моделями и открытыми, для которых такой тюнинг недоступен. Ранее сообществу был доступен только пофильтрованный на эстетичность кусочек LAION и файнтюн-датасеты под узкий домен, например аниме или живопись. LAION часто не давал существенного прироста качества, а файнтюны под узкий домен ограничивали возможности генерации за его пределами.

Ниже мы подробно рассказываем, как получить датасет уровня Alchemist, имея лишь сырой набор интернет-данных. Отметим, что весь пайплайн — про картинки. Мы считаем, что так правильно: тексты потом лучше сгенерировать синтетические.

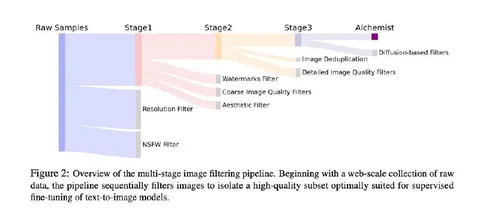
Итак, стартуя с датасета на 10 млрд примеров, мы выбрали картинки высокого разрешения без NSFW-контента и удалили те, что содержали вотермарки, имели низкое качество и были неэстетичны. Когда осталось примерно 300 млн изображений, дальнейшее выкручивание порогов фильтрации не помогало: модели недостаточно чувствительны, чтобы отделять хорошие картинки от великолепных. Выбирать руками лучшее из такого большого набора — тоже сомнительная затея.

На этом этапе мы предположили, что предобученная диффузионка может сама знать, какие картинки хорошие, а какие — не очень. Пробовали подходы из области dataset pruning, например, пропускать картинки через модель и смотреть на значение лосса. Оказалось, что так отбираются только самые простые изображения — абстрактные иллюстрации, вроде обоев на рабочий стол. В них немного деталей и их легко моделировать, но на файнтюне от них мало толку.

В итоге нам пришлось придумать свой метод, суть которого в следующем.

1. Возьмём 1000 картинок из наших 300 млн и разметим на условно плохие (LQ) и хорошие (HQ). Хорошими будем считать те, у которых высокие эстетичность и техническое качество, умеренная наполненность контентом.
2. Смастерим общий промт, который будет содержать перечисление желаемых характеристик: “aesthetic”, “high quality” и т. д.
3. Дальше будем брать LQ- и HQ-картинки, зашумлять их до какого-то t, подавать в нашу предобученую диффузионку вместе с промтом и смотреть, что происходит со значениями в cross-attention.

Оказывается, что на основе нашей небольшой и грубой разметки можно выделить комбинации активаций в cross-attn и токенов, которые будут хорошо отделять изображения с нужными нам свойствами. Если просуммировать эти значения, получим скаляр, который и будет нашим скором качества изображения. Проскорив таким образом 300 млн картинок, мы выбрали топ-3350 — это картинки из нашего датасета.

Дальше осталось сделать тексты — исходные из интернета могут быть ошибочны, содержать лишнюю или упускать нужную информацию. Наше наблюдение: лучше всего работают умеренно подробные промты, похожие на те, которые пишет скорее увлечённый пользователь, чем профессиональный промпт-инженер. YandexVLM как раз умеет подстраиваться под нужный формат. С её помощью мы сгенерировали тексты для каждой картинки, получив датасет Alchemist.

Чтобы убедиться в обобщаемости датасета и метода, мы сделали и выложили файнтюны SD 1.5, SD 2.1, SDXL-base 1.0, SD 3.5 Medium и Large. У всех файнтюнов растёт эстетичность и наполненность генераций, которую мы называем “image complexity”. Подробнее о методике и экспериментах читайте в препринте.

Статью подготовили ❣ Валерий Старцев, Александр Устюжанин, Алексей Кириллов, Дмитрий Баранчук, Сергей Кастрюлин

CV Time
___
Meta признана экстремистской организацией, а Facebook и Instagram запрещены на территории РФ
13 097 просмотров · 66 реакций Открыть в Telegram · Открыть пост на сайте
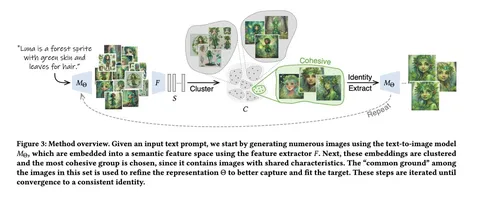
The Chosen One: Consistent Characters in Text-to-Image Diffusion Models

Сегодня разбираем статью, которая предлагает не самый практичный, но достаточно любопытный способ заставить генеративную модель выдавать одного и того же персонажа при разных промптах. Например, это важно для сторителлинга и комиксов, где герой должен сохранять идентичность во всех сценах.

Основная идея статьи — добиться того, чтобы по одному текстовому промпту всегда генерировался один и тот же персонаж. При стандартной генерации «ёжика-альбиноса с фиолетовыми иголками» без подготовки получаются разные ёжики: похожие, но отличающиеся в деталях. Обычно задачу решают через DreamBooth или текстовую инверсию на одной картинке, но это ведёт к жесткому переобучению и потере вариативности окружения.

Авторы предлагают другой путь. Они не используют исходное изображение и работают только с текстом. Сначала генерируют 128 картинок по одному промпту (SDXL), затем извлекают эмбеддинги через DINOv2 и выполняют кластеризацию. Выбирают самый крупный и плотный кластер — там образ героя выглядит максимально однородно. На этом подмножестве проводят fine-tune модели с помощью LoRA и текстовой инверсии, после чего повторяют цикл генерации, кластеризации и обучения ещё четыре–пять раз. Процедура занимает около 24 минут на одной GPU.

Так удаётся зафиксировать ключевые черты персонажа — цвет кожи, форму глаз, аксессуары и даже позу, хотя фон при этом остаётся неизменным. При смене промпта обучение придётся повторить: метод жёстко привязан к тексту.

Сравнение с базовыми методами:

- Vanilla Textual Inversion — образы слишком разнородны;
- DreamBooth full fine-tuning — модель переобучается на фон и перестаёт менять окружение;
- текстовая инверсия через LoRA: недообучается, даёт слабую консистентность.

В итоге этот метод («Sauce») позволяет получить баланс между соответствием промту и стабильностью образа. Auto-метрика CLIP-Score и оценки на Amazon MTurk подтвердили, что согласованность растёт без серьёзных потерь в точности при сохранении разнообразия фонов и поз.

Абляционный анализ показывает, что без кластеризации модели не сохраняют образ. Одна итерация обучения даёт малозаметный эффект, а при реинициализации весов каждую итерацию результаты ухудшаются.

Метод совместим с другими техниками: при генерации истории из четырёх промптов герой остаётся постоянным; с ControlNet можно задать новую позу, сохранив лицо, а сочетание с DreamBooth и LoRA улучшает детализацию.

Основные ограничения связаны с тем, что кластер может захватить фон или часто встречающиеся детали — котик может «прилипнуть» к листикам, а позы и окружение мешают выделить только лицо героя. Авторы предлагают предоставить пользователю выбор из нескольких кластеров.

В перспективе авторы хотят расширить подход для работы с реальными фотографиями: сначала получить текстовое описание через captioning, затем применить тот же цикл генерации, кластеризации и дообучения.

Немного технических деталей: 128 изображений, 500 шагов обучения с AdamW, порог плотности кластера — 0,8 от медианной дистанции с адаптивным подбором на первой итерации.

В заключение можно подметить, что метод хоть и интересный, но на практике требует много времени и ресурсов, а результат всё же далёк от идеала. Но сама идея итеративной кластеризации и дообучения модели заслуживает внимания.

Разбор подготовил ❣ Григорий Лившиц
CV Time
2 242 просмотров · 22 реакций Открыть в Telegram · Открыть пост на сайте
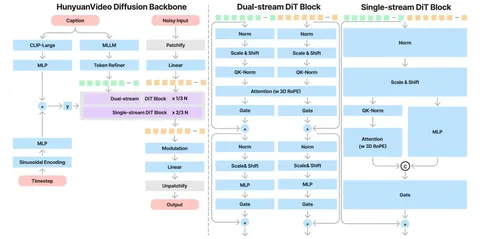
HunyuanVideo: A Systematic Framework For Large Video Generative Models

Сегодня разбираем статью от команды Tencent о HunyuanVideo — большой генеративной модели для видео. Работа во многом напоминает MovieGen, но есть некоторые важные отличия. А главное — веса модели выложены в открытый доступ, что редкость для видеомоделей.

Обучение начинается с картинок 256×256, потом разрешение повышают до 512×512. При этом 256×256 всё ещё поддерживается — чтобы не терять навык генерации на этом уровне. Сначала учат только на изображениях, потом добавляют видео.

Генерация стартует с нормального распределения, стандартного для диффузионок. Но вместо линейно-квадратичного расписания шагов из MovieGen, здесь применяется «сдвинутое» специальным образом расписание. Авторы говорят, что такой сдвиг даёт лучшее качество, чем квадратичное расписание, особенно при уменьшении количества шагов инференса.

Видео для обучения берут из датасета WebVid. Чтобы сбалансировать данные, авторы находят 10 000 центроид и сэмплируют из них так, чтобы равномерно распределить количество примеров между центроидами. Если в одну центроиду попадает слишком много данных, часть отбрасывают. Так датасет получается разнообразнее.

У модели несколько видов параллелизма: тензорный (делят слои и FF-блоки между GPU), контекстный (делят токены между процессами) и параллелизм по данным. Это помогает обрабатывать длинные последовательности, возникающие при генерации в высоком разрешении.

Также модель поддерживает CFG и guidance distillation — учитель и ученик, как обычно. Ученик учится повторять учителя по результатам генерации. Для переписывания промптов используют Hunyuan Large Language Model — особенно если исходный текст слишком технический.

Есть отдельная аудиомодель, которая по сгенерённому видео создаёт музыку. Она учится на спектрограммах и работает в духе AudioGen.

Ещё есть возможности персонализации: можно подать референс-картинку и получить видео. Модель справляется с аватарами, движущимися портретами и анимацией объектов.

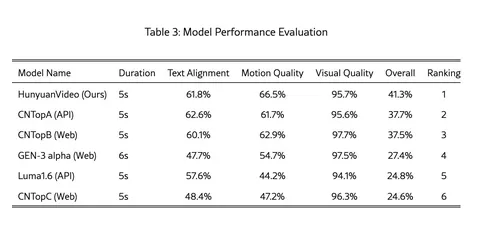
Авторы собрали свой бенчмарк из 1533 промптов и сравнились с пятью сильными бейзлайнами. Публикуют не всё: выкладывают 600 промптов. Смотрят на соответствие тексту, движение, визуальное качество и общее впечатление. Их модель лидирует, но не с гигантским отрывом. Оценки FLOPs — без подробностей, так что сравнивать с другими моделями сложно.

Разбор подготовил ❣ Денис Кузнеделев
CV Time
2 280 просмотров · 18 реакций Открыть в Telegram · Открыть пост на сайте
Ещё немного этих мягких французских постеров с ICLR

Наши инженеры и исследователи продолжают делиться своими находками на тему CV — а мы несём их вам, чтобы обеспечить полезным чтением в короткую праздничную неделю.

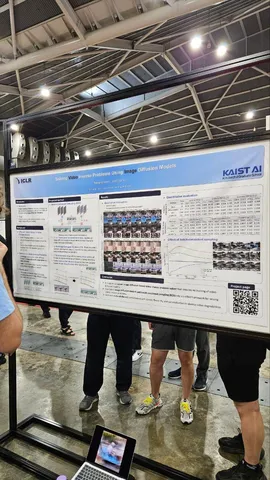
Solving Video Inverse Problems Using Image Diffusion Models

Авторы предлагают разбить генерацию видео с помощью диффузионных моделей на этапы: сначала покадровая генерация, затем синхронизация кадров по времени. Говорят, что получается быстрее и с хорошим качеством.

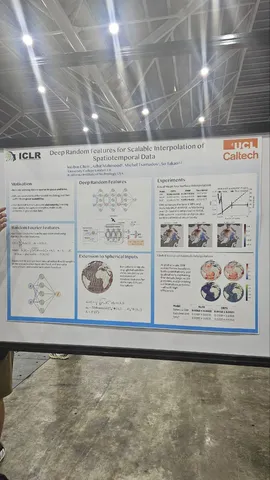
Deep Random Features for Scalable Interpolation of Spatiotemporal Data

Работа напоминает NeRF, но для remote sensing данных. Орбитальные спутники не дают плотную картинку по пространству и времени, поэтому авторы предлагают научиться генерации по координатам «пространство-время», которые измерил бы спутник в этот момент.

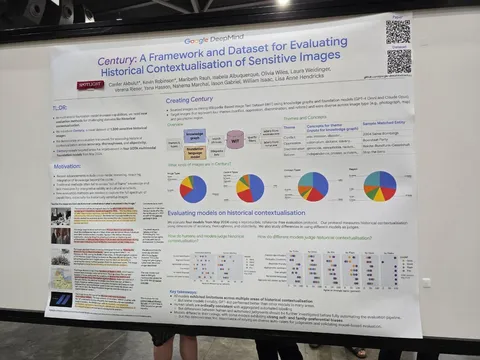
Century: A Framework and Dataset for Evaluating Ethical Contextualisation of Sensitive Images

Исследователи из DeepMind предлагают новый бенчмарк для оценки понимания моделями разных исторических событий, стратифицированных по типам связанных сущностей (люди, места и прочее) и по типу входных данных.

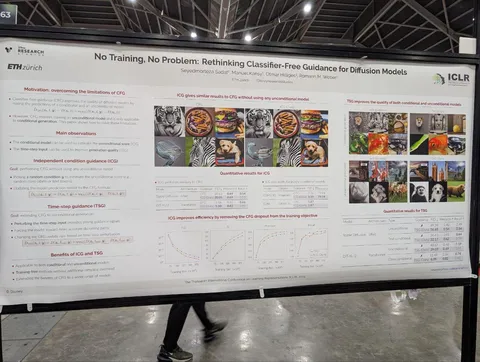
No Training, No Problem: Rethinking Classifier-Free Guidance for Diffusion Models

Пара годных хаков для улучшения Classifier-Free Guidance (CFG):
- unconditional-эмбеддинги можно заменить на рандомные текстовые токены;
- можно делать negative guidance на рандомные таймстемпы.

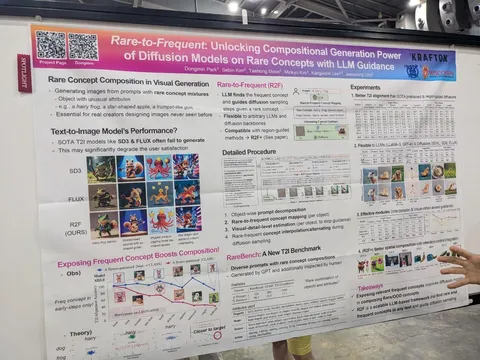
Rare-to-Frequent: Unlocking Compositional Generation Power of Diffusion Models on Rare Concepts with LLM Guidance

В этой работе помогают диффузионной модели лучше генерировать редкие концепты. Для этого с помощью LLM находят похожий, но более частый концепт и во время генерации используют информацию от обоих: редкого и частого.

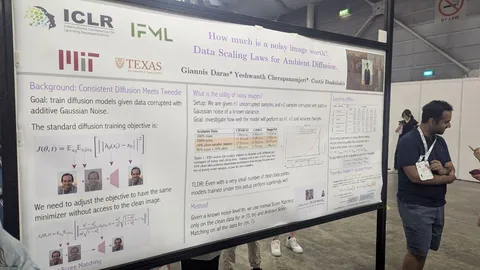
How much is a noisy image worth? Data Scaling Laws for Ambient Diffusion

Авторы переформулируют лосс для зашумлённых изображений в диффузии, чтобы не отбрасывать данные и использовать их для обучения. Сейчас они готовят продолжение работы с разбором гиперпараметров.

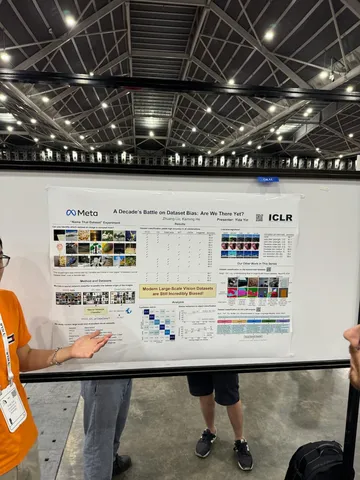
A Decade’s Battle on Dataset Bias: Are We There Yet?

Забавный факт: имея классификатор с 7 тысячами параметров, можно с высокой точностью определить, к какому датасету принадлежит фотография. Размер базы — более 3 миллиардов изображений.

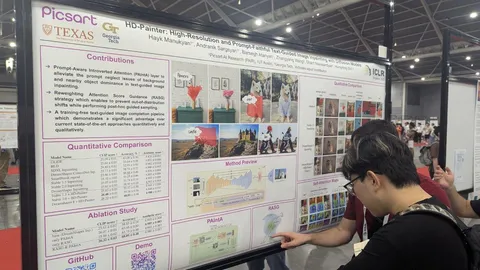
HD-Painter: High-Resolution and Prompt-Faithful Text-Guided Image Inpainting with Diffusion Models

Работа от PicsArt с улучшением инпеинтинга. Решают проблему того, что диффузионка сильнее опирается на картинку, чем на промпт. Для этого «перевешивают» аттеншн-мапы в селф-аттеншн по аттеншн-мапам из кросс-аттеншна. Говорят, работает очень робастно.

Работы отобрали и прокомментировали ❣ Пётр Вытовтов, Алексей Спасёнов, Сергей Овчаренко, Александр Шишеня, Евгений Ляпустин, Иван Балашов

CV Time

#YaICLR
1 744 просмотров · 16 реакций Открыть в Telegram · Открыть пост на сайте
ICLR 2025 выходит на финишную прямую!

Мы внимательно следили за работами на конференции и собрали в одном посте все наши обзоры:

- Приветственный пост от ребят из CV-команды
-
Подборка интересных работ. Часть 1
- Репортаж с первого Invited Talk
- Немного атмосферных фото и видео
- Подборка интересных работ. Часть 2
- Подборка интересных работ. Часть 3

Оставайтесь с нами, впереди более подробные разборы. А на видео — ещё немного Сингапура.

Больше разборов, интересных постеров, фото и видео с ICLR вы найдёте в наших других каналах: @RecSysChannel, @MLunderhood, @stuffyNLP, @speechinfo.

CV Time

#YaICLR
1 766 просмотров · 21 реакций Открыть в Telegram · Открыть пост на сайте
Подборка интересных постеров и статей с ICLR 2025. Часть 3

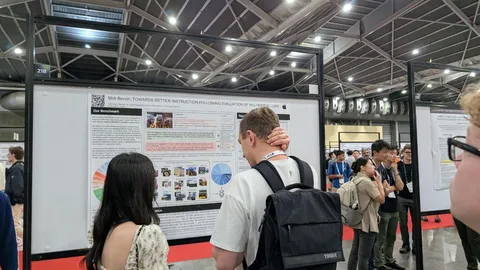
MIA-Bench: Towards Better Instruction Following Evaluation of Multimodal LLMs

Неплохой бенчмарк на следование инструкциям, но уже достаточно простой для топ-моделей. Автор говорит, что команда старалась сделать его не субъективным, и утверждает, что на небольшом семпле LLM работает с точностью выше 90%.

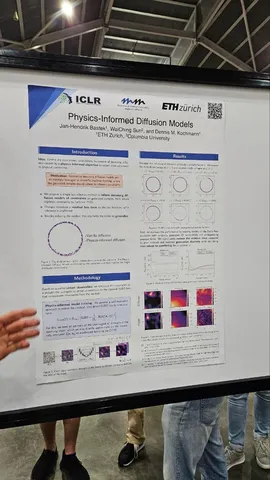
Physics-Informed Diffusion Models

Авторы говорят, что раз PINN'ы до сих пор нормально не работают, можно попробовать добавить физические ограничения в диффузионки. На простых примерах выглядит хорошо (но и PINN'ы были неплохими), а как будет на сложных — пока непонятно.

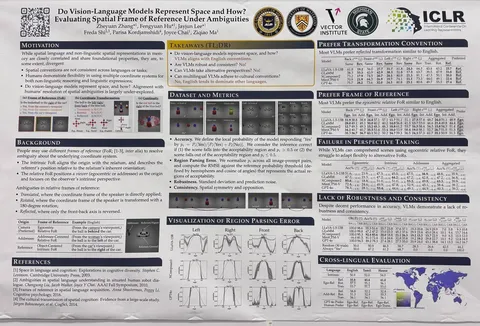
Do Vision-Language Models Represent Space and How? Evaluating Spatial Frame of Reference Under Ambiguities

Статья об изучении пространственных bias’ов в VLM. Оказывается, они плохо отвечают на вопросы про расположение с чьей-то перспективы (например, если рассматривать расположение относительно камеры или другого объекта в кадре). При этом в разных языках такое описание взаимного расположения объектов может строиться по-разному. И VLM, конечно же, смещены в сторону того, как это работает в английском, даже если они мультилингвальные (что потенциально ведет к проблемам с языками с другой системой описаний).

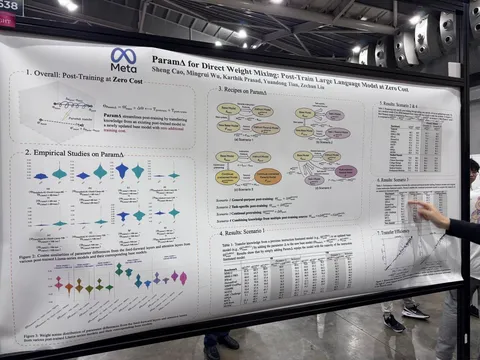
Param∆ for Direct Weight Mixing: Post-Train Large Language Model at Zero Cost

При обновлении бейзлайна LLM (например, с v1 на v2, если у них не изменилась архитектура) можно не переобучать его под задачу, а вычесть веса старого бейзлайна (v1), добавить веса нового (v2) и радоваться жизни с таким «бесплатным» обучением. Работает хуже дообучения на новом бейзлайне, но лучше, чем отсутствие дообучения. Авторы экспериментировали только с Llama 3, Llama 3.1 и полным файнтьюном модели под задачу.

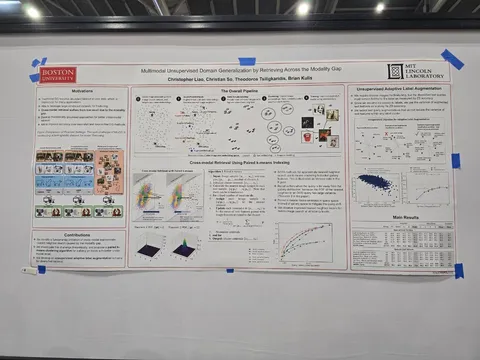
Multimodal Unsupervised Domain Generalization by Retrieving Across the Modality Gap

Улучшают ANN через уточнённые эмбеддинги объектов на основе аугментации текстов, описывающих интересующие классы. Центроиды картинок смещаются к их усреднённым положениям относительно эмбеддингов аугментированных запросов.

Работы отобрали и прокомментировали ❣ Екатерина Глазкова, Ирина Барская, Пётр Вытовтов, Алексей Спасёнов

CV Time

#YaICLR
1 579 просмотров · 14 реакций Открыть в Telegram · Открыть пост на сайте
Подборка интересных постеров и статей с ICLR 2025. Часть 2

ICLR пока не думает заканчиваться — посему несём вам новую (большую) порцию избранных работ. Во многих случаях нашим инженерам удалось поговорить с авторами, поэтому идеи буквально из первых рук.

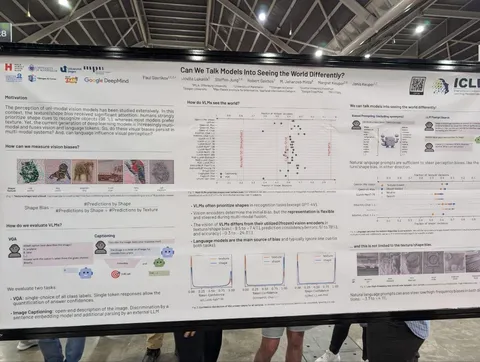
Can We Talk Models Into Seeing the World Differently

Любопытная работа, изучающая робастность VLM к текстурным bias'ам: получается лучше, чем при обучении на Imagenet, но пока хуже, чем у людей. Непонятно, дело в данных, в другом методе обучения или в том, что большинство картиночных энкодеров — CLIP-like.

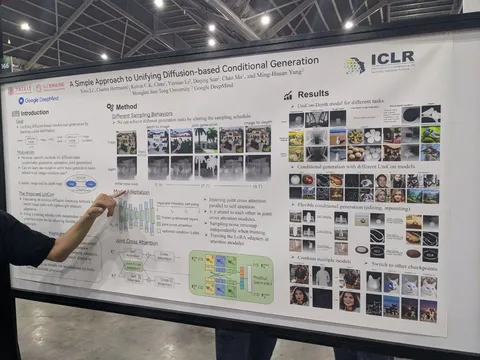
A Simple Approach to Unifying Diffusion-based Conditional Generation

Параллельно учат две диффузионки, связанные кросс-аттеншнами: одну — для картинок, другую — для карты глубины. Таймстемпы семплируются независимо. На инференсе можно генерировать любую из модальностей, независимо или одновременно. Модель без дообучения обобщается на большее число веток, позволяя выполнять редактирование изображений.

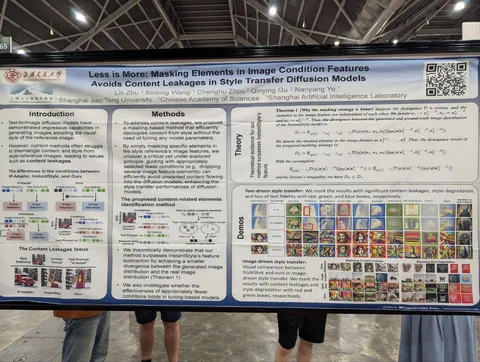
Less is More: Masking Elements in Image Condition Features Avoids Content Leakages in Style Transfer Diffusion Models

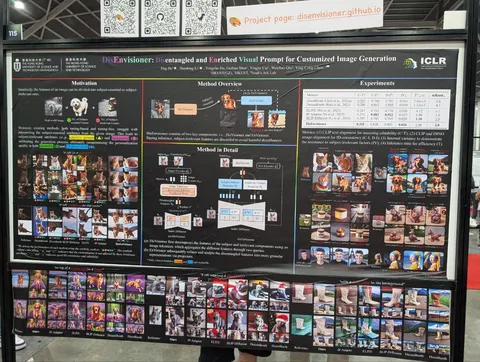
DisEnvisioner: Disentangled and Enriched Visual Prompt for Customized Image Generation

Пара работ по улучшению стилизации и персонализации. Идеи довольно похожие: в первой — в пространстве CLIP'a понимают, какие картиночные фичи соответствуют концепту, и маскируют их. Во второй — учат адаптер с двумя токенами (релевантные и нерелевантные эмбеды) — выкидывая вторые на инференсе.

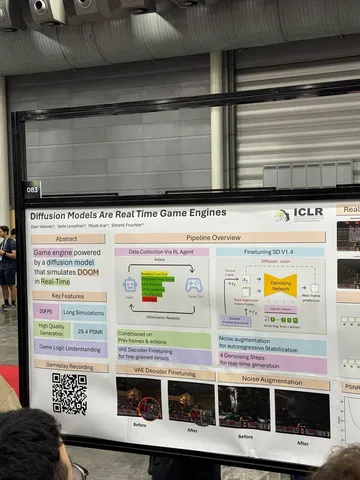
Diffusion Models Are Real Time Game Engines

Doom запустили на диффузионках. Демо впечатляет тем, что модель запоминает локации. Кажется, что это большой прогресс.

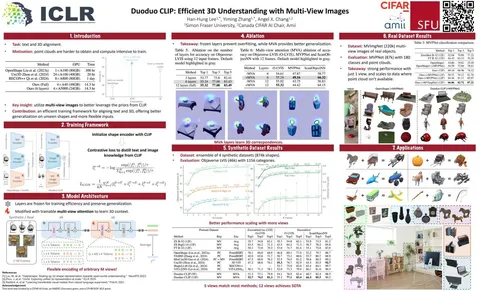
Duoduo CLIP: Efficient 3D Understanding with Multi-View Images

Незатейливо вставляют и дообучают в CLIP multi-view attention слои, чтобы получить multi-view-модель. Её эмбеддинги можно использовать взаимозаменяемо с CLIP-эмбедами в поиске по базам данных с ростом качества.

Работы отобрали и прокомментировали ❣ Александр Шишеня, Сергей Овчаренко, Иван Балашов, Расим Ахунзянов

CV Time

#YaICLR
1 358 просмотров · 17 реакций Открыть в Telegram · Открыть пост на сайте
Трушный конф-виб ICLR 2025

- наша CV-команда в сборе;
- авторы статьи «Adam: A Method for Stochastic Optimization», получившей на ICLR 2025 Test-of-Time Award;
- фото избушки, в которой была написана одна из статей;
- и, конечно же, роботы, куда без них.

CV Time

#YaICLR
1 517 просмотров · 26 реакций Открыть в Telegram · Открыть пост на сайте
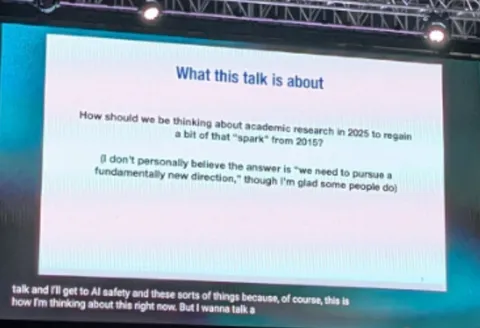
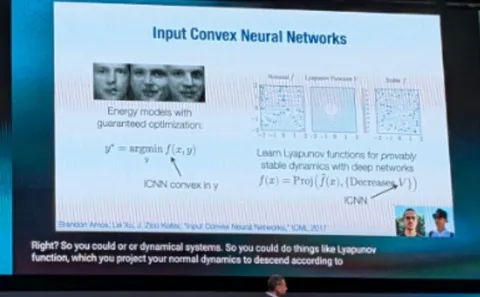
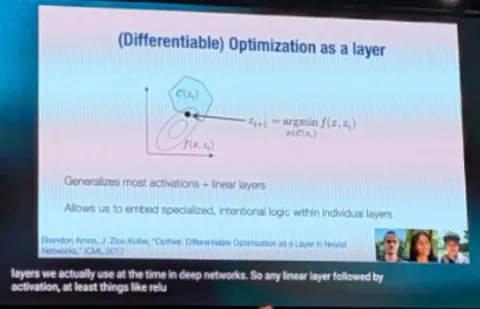
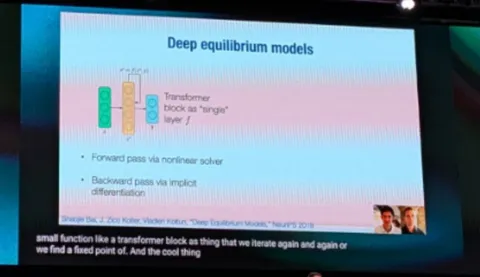
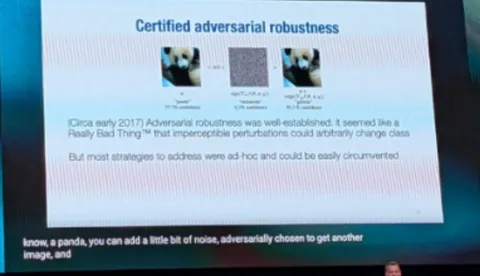
Building Safe and Robust AI Systems — первый Invited Talk

Хоть название и указывает на AI Safety, поначалу речь шла совсем о другом. Докладчик вспоминал, какими разнообразными и смелыми были идеи в исследованиях прошлых лет — и констатировал некоторый застой в академическом ресёрче. Подробнее об идеях из старых статей:

— Input Convex Neural Networks: построение выпуклой нейросети, которую можно использовать как energy-based модель.

— Optimization as a Layer: слой сети внутри себя решает задачу оптимизации.

— Deep Equilibrium Models: по сути, RNN, но в итоге это направление заглохло, потому что на практике вычислительно сложные модели с малым количеством параметров уступают перепараметризованным.

— Fighting Adversarial Samples: подходы так и не прижились, потому что все методы заметно ухудшают качество, при этом не гарантируют полное избавление от adversarial samples.

Просим прощения — фото слайдов немного не в фокусе. Но так даже вайбовее и в духе старых статей.

Послушал презентацию и записал тезисы ❣ Александр Шишеня
CV Time

#YaICLR
1 531 просмотров · 13 реакций Открыть в Telegram · Открыть пост на сайте
Подборка интересных постеров и статей с ICLR 2025. Часть 1

Наши корреспонденты уже принесли обзоры работ первого дня конференции, 24 апреля. Пишите в комментариях, какие идеи зацепили и о чём ещё хотите узнать.

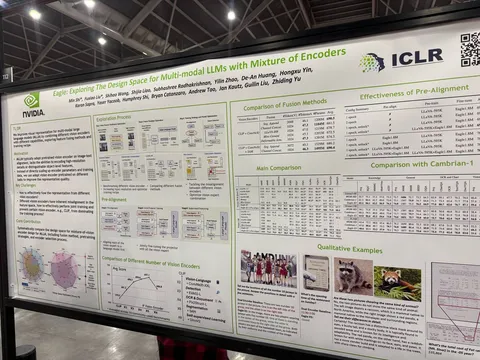
Eagle: Exploring The Design Space for Multi-modal LLMs with Mixture of Encoders
Авторы из NVIDIA исследуют, как использование нескольких предобученных vision-энкодеров помогает моделям лучше справляться со сложными визуальными задачами, такими как OCR и анализ документов. Каждый энкодер обучали отдельно с зафриженной 7B моделью Vicuna. На заключительных этапах объединяли все экодеры и обучали финальную модель.

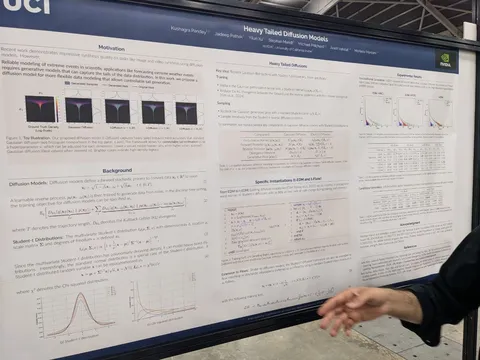
Heavy Tailed Diffusion Models
У распределения картинок тяжёлый хвост, у нормального — лёгкий. Есть теоретическое обоснование, что из-за липшицевости нейросети диффузионка не может генерировать из распределения с лёгким хвостом распределение с тяжёлым.

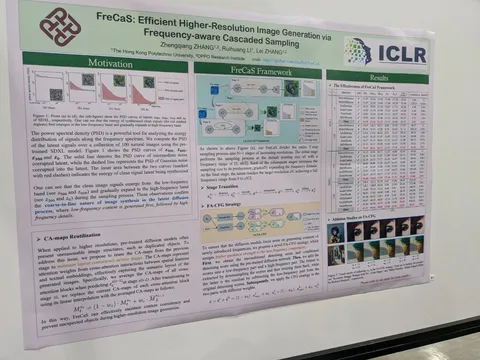
FreCaS: Efficient Higher-Resolution Image Generation via Frequency-aware Cascaded Sampling
Генерируют картинки 2048 на основе модели, предобученной для 1024. На каждой стадии используется одна и та же модель, на ood-разрешениях подменяются аттеншн-мапы.

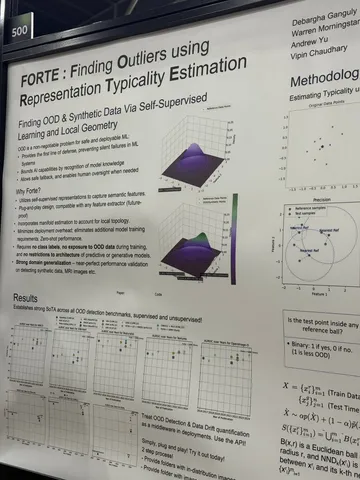
FORTE: Finding Outliers using Representation Typicality Estimation
Сделали фреймворк для автоматического нахождения аутлайеров в данных. Достаточно дать данные и несколько референсных точек, и можно будет получить оценку аутлайерности. Может быть полезно, например, для нахождения фото в карточках организации, которые к организации не имеют отношения.

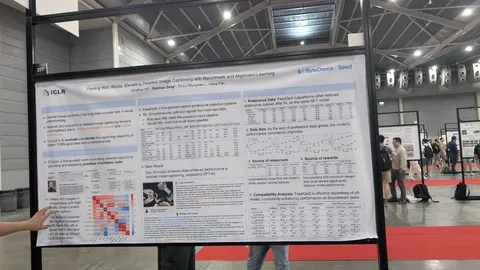
Painting With Words: Elevating Detailed Image Captioning with Benchmark and Alignment Learning
Валидируют image captions, разбивая на крошечные утверждения и валидируя GPT (точность 85+), потом собирают два реворда на полноту и точность — пыщ-пыщ — профит.

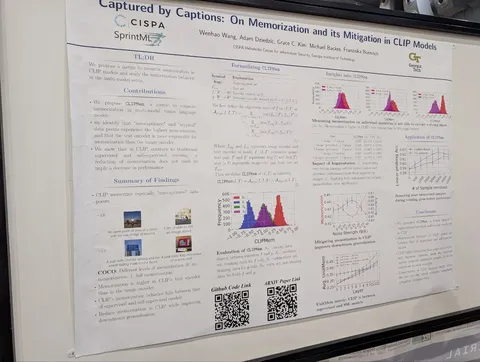
Captured by Captions: On Memorization and its Mitigation in CLIP Models
Разработали метрику для выявления неправильно аннотированных текстов для обучения clip'a. Утверждают, что хороший буст качества даёт группировка мисанноипованных (неправильно аннотированных) картинок в один батч.

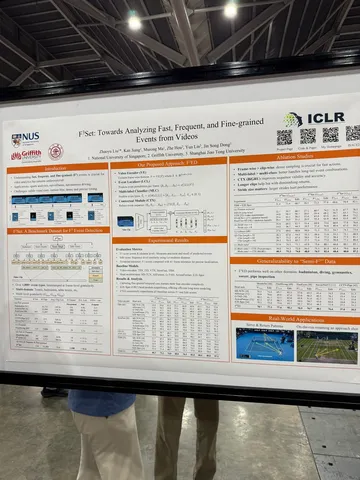
F³Set: Towards Analyzing Fast, Frequent, and Fine-grained Events from Videos
Находят события на сложных видео с блюром и быстрыми изменениями, например спортивных трансляциях. Архитектура: детектор ивента, классификатор ивента, блендим и в GRU. Может быть полезно, чтобы найти красивый кадр на превью пользовательских видео.

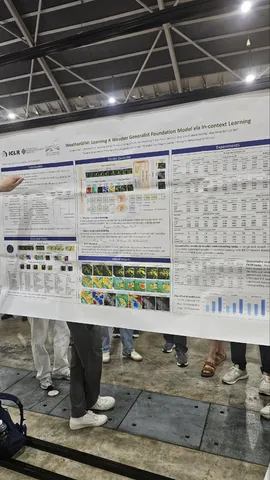
WeatherGFM: Learning A Weather Generalist Foundation Model via In-context Learning
Предлагают учить одну модельку под все погодные задачи. И при этом задавать визуальным промптом, что именно модели необходимо сделать: наукаст, сегментацию спутника и прочее. На первый взгляд, выглядит прикольно, но из погодных моделей сравниваются только с IFS и ClimaX.

High-Dynamic Radar Sequence Prediction for Weather Nowcasting Using Spatiotemporal Coherent Gaussian Representation
Идея статьи в том, чтобы представить 3D-информацию об осадках с помощью набора гауссиан, а потом их преобразовывать, чтобы получить наукастовый прогноз. Потом из новых гауссиан восстанавливается финальное поле осадков. Правда extreme-ивенты авторы не рассматривают.

Интересные постеры увидели ❣ Александр Шишеня, Пётр Вытовтов, Иван Балашов, Сергей Овчаренко, Денис Асонов
CV Time

#YaICLR
2 122 просмотров · 21 реакций Открыть в Telegram · Открыть пост на сайте
Lost and Found: Overcoming Detector Failures in Online Multi-Object Tracking

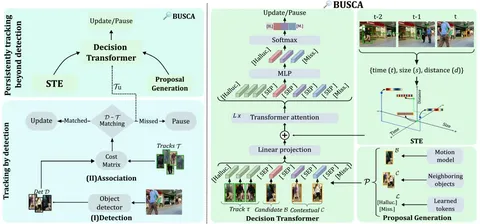
Сегодня разбираем статью с ECCV’24, в которой предложили метод улучшения онлайн-трекинга BUSCA. Это надстройка над любыми современными трекерами в парадигме Tracking-by-Detection (TbD), помогающая не терять треки при пропуске объектов детектором.

В подходах TbD объекты сначала детектируют, затем соотносят с существующими треками. Проблема в том, что даже лучшие детекторы периодически теряют объекты, особенно при их низкой видимости. Из-за этого треки прерываются. BUSCA решает эту проблему, продолжая треки даже без детекций.

Архитектура BUSCA

В основе метода — Decision Transformer, работающий полностью в онлайн-режиме (без изменения прошлых результатов или доступа к будущим кадрам).

После стандартного сопоставления детекций с треками, несматченные треки обрабатываются BUSCA, которая анализирует:

— Candidate proposal B: прогнозируемую позицию объекта с помощью фильтра Калмана;

— Contextual proposals C: Q=4 ближайших объекта из успешно отслеживаемых треков на текущем кадре (для учёта окружения);

— Learned tokens L: специальные токены [Halluc.] для обнаружения искажённых треков и [Miss.], когда объект покинул сцену или все предложения неподходящие.

Обработка токенов различается:

- Трековые наблюдения (несколько последних наблюдений из несматченного трека), Candidate и Contextual proposals проходят через ResNet-50 для извлечения 512-мерных визуальных признаков;
- Learned tokens и разделительный токен [SEP] инициализируются случайно и обучаются совместно с остальной архитектурой.

Все токены получают специальное пространственно-временное кодирование (STE), отражающее относительные время, размеры и расстояние до последнего наблюдения трека.

Затем Decision Transformer обрабатывает все токены вместе. Полученные представления предложений проходят через MLP-слой для генерации их вероятностей. Если выбирается candidate B — трек продолжается с обновлёнными координатами, в остальных случаях — ставится на паузу.

Эксперименты

BUSCA особенно эффективна для объектов с низкой видимостью и увеличивает среднюю длину треков. Метод обучался только на синтетических данных (MOTSynth) и работает со скоростью около 45 мс на кадр на NVIDIA RTX GPU.

BUSCA протестирована на пяти трекерах (ByteTrack, StrongSORT, GHOST, TransCenter, CenterTrack) и улучшила все ключевые метрики на MOT16, MOT17 и MOT20.

Разбор подготовила ❣ Мария Поклонская
CV Time
1 995 просмотров · 19 реакций Открыть в Telegram · Открыть пост на сайте
Личный опыт инженеров Яндекса — Дмитрий Баранчук

Продолжаем рассказывать об ML-инженерах и исследователях в Яндексе. Сегодня о своих задачах, успехах и профессиональных ожиданиях рассказал руководитель команды исследователей по генеративному CV в Yandex Research.

Работы, о которых Дима говорит в карточках:

— Switti: Designing Scale-Wise Transformers for Text-to-Image Synthesis;
— Invertible consistency distillation for text-guided image editing in around 7 steps.

Больше карточек — по хештэгу #YaMLpeople.

CV Time
1 896 просмотров · 29 реакций Открыть в Telegram · Открыть пост на сайте
PartEdit: Fine-Grained Image Editing using Pre-Trained Diffusion Models

Сегодня разбираем статью о редактировании изображений. Авторы показывают, как с помощью предобученной диффузионной модели SDXL можно детально изменять заданные сегменты на изображении.

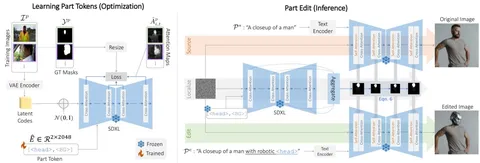
Предложенный метод требует обучения токенов частей картинки на датасете, где для каждой картинки и целевого токена есть маска, соответствующая области, которую нужно изменить. В промпт подаются два токена, например: <head> (токен головы) и <BG> (бэкграунд для головы). Причём токен бэкграунда (<BG>) уникален для каждого целевого токена.

Дальше токены обучаются так, чтобы маски аттеншна в SDXL давали маски сегментации нужной части картинки. При этом сама диффузионная модель остается замороженной, обучаются только токены.

Авторы отдельно изучают, в каком диапазоне (от 0 до 50, где 0 — почти чистое изображение, а 50 — максимально зашумлённое) лучше брать усреднение. При обучении на таймстемпах [50, 40] маски получаются некачественные. В диапазоне [30, 20] результат лучше. При [10, 0] — чуть хуже, чем на среднем.

Когда эмбеддинги выучены, происходит редактирование. В случае с синтетическими изображениями используются три ветки:

1. Генерация исходного синтетического изображения. Например, по промпту "A closeup of a man" в качестве промпта подаётся, например, "A closeup of a man", где мы хотим заменить голову человека на голову робота. SDXL генерирует изображение и при этом сохраняется траектория — промежуточные латенты для каждого таймстемпа.

2. Средняя часть архитектуры работает как сегментатор: в SDXL подаются только два выученных эмбеддинга: части, которую нужно отредактировать и бэкграунда. В нашем примере это будет <head> и <BG>.

Для каждого таймстемпа собираются все маски аттеншна со всех слоёв (предварительно приводятся к одному размеру и агрегируются). Затем применяется алгоритм OTSU, который вычисляет локальный порог: если значение больше порога — это единица, если меньше — ноль, а в промежутке от 1/2K до 3/2K маска просто сохраняется.

3. Генерация отредактированного изображения: через SDXL прогоняются выученные эмбеддинги того, что нужно заменить (например, чтобы получить "A closeup of a man with robotic <head>").

На этапе редактирования фичемапы с исходного и редактирующего прогона блендятся с помощью предобработанных масок аттеншна из второй ветки. В конце прогона получается отредактированное изображение: нужная часть изменена, остальное — как в оригинале.

Решение применимо не только к синтетическим, но и к реальным изображениям: с помощью методов инверсии LEDIT++ и EF-DDPM получают латенты, а с помощью BLIP2 — промпт-описание исходной картинки.

В сравнениях с другими подходами в качестве метрики используется Alpha-CLIP: по маске определяется область редактирования, а с помощью CLIP считается, насколько результат соответствует заданному промпту. Как водится — по всем метрикам результаты превосходят конкурентов.


Разбор подготовил ❣ Александр Шишеня
CV Time
2 035 просмотров · 15 реакций Открыть в Telegram · Открыть пост на сайте
Тематическая подборка статей: генерация

Подобрали свежие статьи о генеративных моделях. В этот раз — обсуждают, как улучшить токенизацию для диффузионных моделей, дистиллировать CFG и оптимизировать обучение генератора. А ещё есть работа о том, как интерпретировать внимание в Diffusion Transformers и использовать его для сегментации.

Автоэнкодеры

Reconstruction vs. Generation: Taming Optimization Dilemma in Latent Diffusion Models
Авторы говорят, что увеличение числа каналов в автоэнкодере улучшает реконструкцию (что логично), но делает задачу для генератора более сложной, приводя к ухудшению генераций. Предлагают дополнительным лоссом предсказывать признаки от бэкбона (dino/mae/etc) — это делает фичи автоэнкодера более «простыми» для генератора и улучшает его сходимость.

Masked Autoencoders Are Effective Tokenizers for Diffusion Models
Развитие предыдущей работы: связали улучшение качества представления автоэнкодера с уменьшением числа мод в mixture of gaussian модели, и переделали архитектуру автоэнкодера в MAE-трансформер.

Эдитинг

REALEDIT: Reddit Edits As a Large-scale Empirical Dataset for Image Transformations
В статье предлагают парсить Reddit для сбора датасета по эдитингу картинок: брать треды, где пользователи просят отфотошопить их картинки. Отбирают посты до 2021 года, чтобы в них не было применения AI.

Ускорение

DICE: Distilling Classifier-Free Guidance into Text Embeddings
Авторы говорят, что можно дистиллировать Classifier-Free Guidance (CFG), включая negative prompt, в небольшую нейронку поверх текстовых эмбеддов.

Visual Generation Without Guidance
В статье предлагают алгоритм обучения генератора, для которого потом не нужно делать CFG. Заявляют, что это работает лучше, чем дистилляция.

RL

Calibrated Multi-Preference Optimization for Aligning Diffusion Models
Исследователи из Google предлагают метод, который, по их утверждению, лучше, чем Direct Preference Optimization (DPO), благодаря аккуратному выбору пар для обучения и более хитрой функции потерь.

Diffusion Model as a Noise-Aware Latent Reward Model for Step-Level Preference Optimization
Предлагают делать RL непосредственно в латентном пространстве — для этого нужна reward-модель, способная в нём работать. Говорят, что идеально подходит предобученная диффузионная модель, которую можно дообучить на предсказание reward’а. Утверждают, что это упрощает пайплайн обучения и улучшает финальное качество.

Другое

ConceptAttention: Diffusion Transformers Learn Highly Interpretable Features
Авторы говорят, что можно использовать предобученную диффузионную модель для получения SOTA сегментационных масок в zero-shot-режиме. Для этого делают надстройку над аттеншн-слоями в DiT'е.

Подборку подготовил ❣ Артём Конев
CV Time
5 277 просмотров · 22 реакций Открыть в Telegram · Открыть пост на сайте
FoundationStereo: Zero-Shot Stereo Matching

Сегодня разбираем статью от NVIDIA. Исследователи решают задачу определения глубины по двум изображениям, снятым с близко расположенных камер, то есть со стереопары. Камеры смотрят в одном направлении, поэтому каждая 3D-точка попадает приблизительно на одну строку в обеих картинках, но в разных местах. Это позволяет искать соответствия между пикселями одной и той же строки двух изображений, и, используя эти соответствия, восстанавливать глубину сцены.

Определив соответствия между точками на двух изображениях, можно вычислить диспаритет — сдвиг координат пикселя на одной картинке относительно другой. Зная диспаритет, фокусное расстояние и расстояние между оптическими центрами камер, можно пересчитать его в глубину.

Исследователи из NVIDIA говорят, что сейчас нет модели стерео-матчинга, которая бы показывала хорошую zero-shot-генерализацию. Текущие лучшие решения предлагается дообучать на целевой домен.

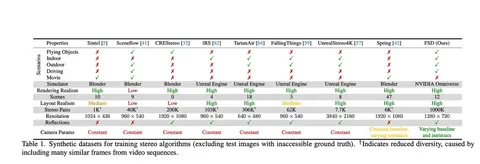
В других задачах проблему генерализации уже удалось решить за счёт больших данных. Например, Segment Anything обучили на огромном датасете, и модель успешно работает без дообучения. NVIDIA попробовала применить этот же подход к стерео-матчингу. Они собрали фотореалистичный синтетический датасет FSD (картинка 2) из миллиона стереопар, превосходя по объёму и многообразию другие открытые датасеты. Датасет выложен в открытый доступ.

Детали архитектуры

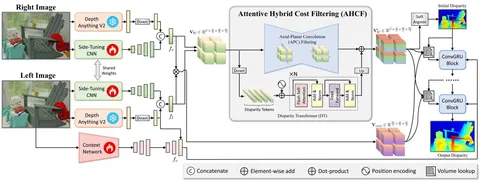
Из левого и правого изображений (картинка 1) извлекаются фичи из Depth Anything, конкатенируются с фичами из отдельной обучаемой свёрточной сети. Из этой пары создаётся feature cost volume — объём фичей, где каждая описывает похожесть пикселя на левой картинке на пиксели в той же строке на правой картинке и корреляционный cost volume, где похожесть пикселей описывается единственным числом.

Такие cost volume’ы уже можно использовать для поиска диспаритета, но в них недостаёт глобального контекста картинок. Чтобы его добавить, применяется операция AHCF (Attentive Hybrid Cost Filtering), особенность которой — использование информации из всего cost volume для получения значений в финальном пикселе выходного тензора; это делается с помощью глобального внимания в transformer-ветви AHCF и с помощью аналога separable-свёрток в свёрточной ветви AHCF. Изменение по ablation даёт 10% улучшения по метрике BP-2: доля пикселей, где ошибка диспаритета больше 2 пикселей (0.221 → 0.197).

Дальше процесс похож на описанный в RAFT-Stereo, но с некоторыми отличиями. В RAFT-Stereo сеть получает на вход hidden state и срез из correlation cost volume. В Foundation Stereo получает срезы из correlation cost volume и feature cost volume.

Таким образом, вход в GRU включает:

— срез cost volume в соответствии с текущей оценкой диспаритета;
— фичи левой картинки из отдельно обучаемой контекстной сети (так делалось и в RAFT-Stereo);
— саму текущую оценку диспаритета.
GRU обновляет внутреннее состояние и предсказывает поправку, итеративно уточняя диспаритет.

Детали обучения

Модель обучается на смеси FSD-датасета и других датасетов с smoothed L1-лоссом и экспоненциально затухающими L1-добавками для оценок на диспаритет с разных итераций GRU-юнита.

Данные из FSD дополнительно фильтруют по BP-2, используя эту же модель, обученную на полном FSD-датасете, а затем обучают ёще раз.

Интересное из ablation study:

— использование Depth Anything фичей как входов в feature cost volume не работает совсем (по метрике BP-2);
— в separable-свертках для фильтрации feature cost volume используется ядро размера 17(!) по размерности диспаритета (но 1 по spatial-размерности);
— добавление FSD-датасета в обучение даёт BP-2 на датасете Middlebury в два раза лучше, чем без него.

Разбор подготовил ❣ Леонид Штанько

CV Time
7 097 просмотров · 27 реакций Открыть в Telegram · Открыть пост на сайте
Яндекс выпустил диффузионную модель YandexART 2.5

Сегодня мы зарелизили нашу лучшую модель text-to-image генерации YandexART 2.5. Дополнительно приятно, что некоторые её создатели были авторами разборов в этом канале.

Как удалось добиться нужного качества:

— Увеличили размер латентного пространства. Теперь автокодировщик VAE работает с 16 каналами (вместо четырёх, как раньше).

— Применили технологию «супирования». Когда независимо файнтюним несколько моделей и усредняем их веса.

— Улучшили датасет для обучения, который включает пары «текст-картинка». Теперь для каждой картинки разными моделями генерируется несколько описаний, а также берётся текст, описывающий это изображение в интернете. Метамодель выбирает лучший из предложенных текстов — именно он идёт в обучение.

— Увеличили и сам датасет. Теперь его размер приблизился к 1 млрд пар картинок и описаний к ним.

— Ускорили модель с помощью multistep consistency distillation. Благодаря этому подходу генерация стала в 9 раз быстрее.

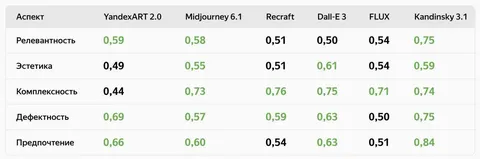
Всё это и многое другое позволило переиграть Midjourney 6.1 и некоторые SOTA-модели. В таблице показана доля побед YandexART 2.5 Pro, а зелёным отмечены победы нашей модели в сравнении с другими.

Модель уже в Шедевруме — пробуйте первыми, делитесь впечатлениями и результатами.

CV Time
2 285 просмотров · 37 реакций Открыть в Telegram · Открыть пост на сайте
VideoLLaMA 3: Frontier Multimodal Foundation Models for Image and Video Understanding

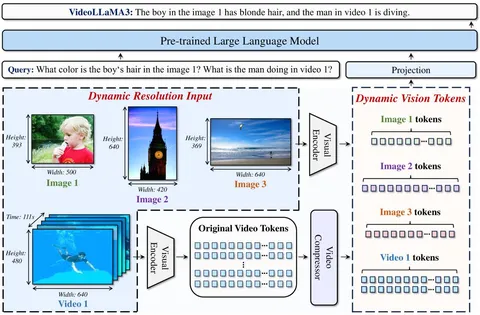
Сегодня разбираем статью о VideoLLaMA 3. По сути — это «yet another VLM» со стандартной архитектурой, описанной на многим знакомой схеме, но есть интересные детали.

Авторы называют свою модель вижнцентричной (vision-centric) — она умеет работать и с видео, и с картинками. В решении используется визуальный энкодер, который обрабатывает изображения покадрово. Картинки передаются в динамическом разрешении и проходят через визуальный трансформер в исходном размере.

С видео можно поступить так же, но это приводит к взрывному росту числа токенов, который выходит за пределы контекста опенсорсных моделей. Чтобы решить эту проблему, авторы вводят компонент под названием Video Compressor.

С его помощью видео разбивают на патчи и оценивают разницу между кадрами. В каждом новом кадре считается только разница с патчами предыдущего кадра. Все кадры кодируются, и каждое изображение превращается в несколько визуальных токенов. Затем видеокомпрессор удаляет те, что содержат дублирующуюся информацию. Патч считается дублирующим, если разница между соответствующими патчами двух соседних кадров меньше заданного значения.

Такой подход авторы называют Differential Frame Pruner. Он позволяет обрабатывать видео, сохраняя единый визуальный энкодер для картинок и видео.

Обучение проходит в четыре стадии:

1. Vision Encoder Adaptation
— обучают только визуальный энкодер и проекционный слой. Используют SigLIP, который работает с фиксированными разрешениями, и адаптируют его под произвольные. Процесс идёт в VLM-сетапе: визуально-языковая модель заморожена, а SigLIP и проекция — разморожены. Обучение проводят на кэпшенах, документах и Scene Text (BLIP3-OCR-Recap), охватывая разные домены.

2. Vision-Language Alignment — аналог претрейна: вся сеть разморожена, обучают на максимальном объёме данных.

3. Multi-task Fine-tuning — используют более качественные данные. Хотя их объём почти совпадает с претрейном, здесь больше детализированных срезов.

4. Video-centric Fine-tuning — основной упор на видео и текст, изображений в обучающей выборке меньше.

Интересен первый этап, где визуальный энкодер адаптируют к произвольному разрешению в VLM-сетапе. Дальше обучение идёт по стандартному сценарию.

Детали реализации

Авторы используют опенсорсные датасеты для кэпшенов (COYO 700M, VL3-Syn7M) и предлагают свой способ перекэпшенивания картинок.

Сначала делают базовую фильтрацию по Aspect Ratio и Aesthetic Score. Затем применяют подход Text-Image Similarity Calculation: генерируют кэпшен через BLIP2, вычисляют CLIP-скор между ним и картинкой. Если скор низкий, картинку считают сложной, плохой или нерелевантной — и отбрасывают. Выбор BLIP2 неочевиден, поскольку он генерирует слабые кэпшены, но для фильтрации сложных изображений метод выглядит рабочим.

Дальше кластеризуют фичи через CLIP и выбирают изображения из каждого кластера в равных пропорциях. Затем перекэпшенивают их с помощью InternVL2-26B и получают набор синтетических кэпшенов, которые считают качественными.

Отдельно интересен способ подачи видео — Timestep Token. Видео позиционно кодируют текстом, добавляя текстовые токены в соответствии с длительностью фрейма. Влияет ли это на качество, неясно, ablation-экспериментов нет. Другие работы, например Qwen, используют отдельные позиционные эмбеддинги с темпоральным измерением, а здесь просто прописывают время текстом.

Тесты проводились на мультимодальных бенчмарках и показали, что модель стабильно опережает Qwen2.5-VL, но подробного сравнения нет. В целом главная проблема статьи — отсутствие полноценных ablation-экспериментов.

Также интересно, что несмотря на название VideoLLaMA3, Llama здесь нет: в качестве языковой модели используют Qwen2.5-2B, в качестве визуальной — SigLIP.

Обзор подготовил ❣ Андрей Чернов

CV Time
2 077 просмотров · 21 реакций Открыть в Telegram · Открыть пост на сайте
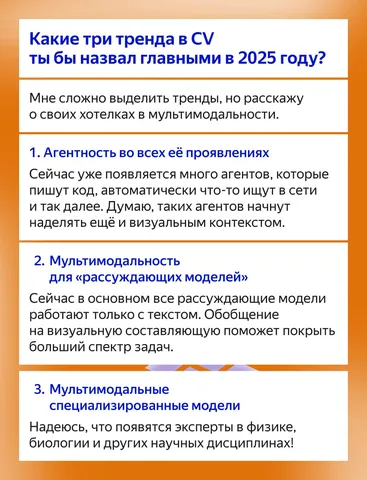
Личный опыт инженеров Яндекса — Антон Клочков

Продолжаем рассказывать об ML`щиках в Яндексе, их успехах и трендах, на которые они делают ставку. Сегодня наш герой — руководитель подгруппы распознавания текста в VLM Антон Клочков.

Больше карточек — по хештэгу #YaMLpeople.

CV Time
4 044 просмотров · 20 реакций Открыть в Telegram · Открыть пост на сайте
Тематическая подборка статей за февраль: картиночные модели

Спешим со свежей подборкой интересных статей. В этот раз — о моделях для работы с изображениями. CLIP остаётся в центре внимания исследователей, но вопросы к его фичам не исчезают. Также делимся несколькими работами по архитектуре нейросетей и оптимизации для мобильных устройств.

Image-to-Text

Cross the Gap: Exposing the Intra-modal Misalignment in CLIP via Modality Inversion
Статья подтверждает наше наблюдение, что фичи CLIP плохо подходят для image-to-image retrieval. Авторы углубляются в проблему, используя текстовую и картиночную инверсию, но практических решений не предлагают.

CLIP Behaves like a Bag-of-Words Model Cross-modally but not Uni-modally
Исследователи показывают, что фичи CLIP ведут себя как «мешок слов» только при взаимодействии между доменами картинок и текстов, а внутри одного домена сохраняют структуру. Например, «синий куб и красный шар» ≠ «красный шар и синий куб» — то же верно и для изображений. Это значит, что проблема может быть не в самих эмбеддингах, а в их междоменном взаимодействии. Авторы предлагают обучить линейный слой с negative-текстами поверх текстовой модели — на синтетическом датасете этот подход показывает неплохие результаты.

Disentangling CLIP Features for Enhanced Localized Understanding
В статье предлагают дополнительные лоссы, которые помогают «распутать» фичи CLIP. Авторы дообучают головы поверх текстовой и визуальной частей. Метод выглядит специфично, но к некоторым идеям стоит присмотреться.

CLIP-UP: A Simple and Efficient Mixture-of-Experts CLIP Training Recipe with Sparse Upcycling
Модель инициализируется из обычного CLIP, но в каждом втором MLP-блоке заменяют слои на смесь из восьми экспертов, из которых активируются два. Для обучения предлагают использовать комбинацию из шести лоссов.

Архитектура

Scaling Laws in Patchification: An Image Is Worth 50,176 Tokens And More
В статье утверждают, что уменьшение размера патча в трансформерах с 16×16 до 1×1 улучшает качество модели. При этом для моделей, у которых уменьшен размер входного патча, не нужна сложная архитектура головы при адаптации под dense-задачи (например, сегментация и оценка глубины).

iFormer: Integrating ConvNet and Transformer for Mobile Application
В статье описана архитектура со свёртками и аттеншном, заточенная под инференс на iPhone. Основой служит ConvNeXt, который дорабатывают, чтобы сделать сеть более лёгкой. Помимо этого, предлагают использовать слои аттешна с одной головой для модуляции карт признаков — было бы интересно сравнить это с более простым и популярным блоком «squeeze and excitation».

Подборку подготовил ❣ Артём Конев
CV Time
2 535 просмотров · 19 реакций Открыть в Telegram · Открыть пост на сайте
Эволюция диффузионок: главные вехи последних лет

Вчера на Хабре вышла большая и захватывающая статья исследователя Yandex Research Сергея Кастрюлина об истории развития диффузионных моделей. Среди прочего в ней рассказано о борьбе каскадной и латентной парадигм, дилемме между свёрточными моделями и трансформерами, дистилляции как решении проблемы медленной генерации и многом другом. В этом посте мы уместили краткий обзор части работ, которые упоминаются в статье, — очень советуем прочитать полную версию.
Simple diffusion: End-to-end diffusion for high resolution images
Один из трендов начала 2023 года — противостояние каскадной и латентной диффузии. Обе парадигмы ставят задачей уменьшить размерность пространства, в котором происходит генерация объектов, поскольку считается, что генерация в высоком разрешении — слишком сложная задача. В своей работе авторы из Google Brain показывают, что диффузионную модель можно обучить сразу генерировать изображения в высоком разрешении без усложнений в виде каскадных схем и автокодировщиков. В статье на Хабре рассказано, с помощью каких приёмов это было достигнуто.

SDXL: Improving Latent Diffusion Models for High-Resolution Image Synthesis
Ещё одна громкая публикация, на этот раз от Stability.ai. Описанная в ней модель SDXL — первая по-настоящему большая опенсорс-модель с 2,8 миллиарда параметров (что немало и сегодня). Механизм, при котором конкатятся текстовые эмбеддинги из нескольких энкодеров, популярен до сих пор. Кроме этого, SDXL остаётся сильным бейзлайном по качеству генерации.

Emu: Enhancing Image Generation Models Using Photogenic Needles in a Haystack
EMU — первая text-to-image модель от Meta*. Авторы показывают, что для SFT важнее качество данных, а не их объём. В полной статье можно подробнее прочитать главное о разделении обучения на pretraining и SFT. А ещё именно в EMU впервые предложили использовать VAE, в которых было больше четырёх каналов — сейчас таким уже никого не удивишь.

Improving Image Captioning with Better Use of Captions
Релиз обновлённой DALL-E — событие, которое вышло далеко за рамки ML. Модель выгодно отличалась на фоне современников. Во многом OpenAI удалось достигнуть этого благодаря новому подходу к обучению: 95% пар «картинка — текст» заменили на правильную синтетику.

PixArt-α: Fast Training of Diffusion Transformer for Photorealistic Text-to-Image Synthesis
Трансформерную архитектуру DiT для диффузионных моделей предложили ещё в конце 2022 года. В PixArt-α её доработали, добавив возможность использовать тексты в качестве условия для генерации. Совместив это с изменениями в данных и обучении, авторы добились высоких результатов при минимальных вычислительных затратах.

Adversarial Diffusion Distillation
Статья, которую первоначально захейтили и отклонили рецензенты. Именно в ней Stability.ai предложила первый метод дистилляции для решения проблемы долгого инференса. Его использовали в модели SDXL‑Turbo и смогли генерировать изображения, сопоставимые по качеству с генерациями исходной модели, но на порядок быстрее. ADD до сих пор остаётся популярным методом дистилляции.

SANA, Kolors, FLUX и другие современные модели
Вторая часть статьи посвящена обзору более свежих разработок. Летом 2024-го вышел масштабный техрепорт Kolors — таким китайские исследователи балуют нечасто. В нём они, среди прочего, говорят об использовании GLM, мультиязычной генеративной модели, в качестве текстового энкодера. В ноябре того же года Nvidia представила модель SANA с возможностью без дополнительных Super‑Resolution‑моделей генерировать изображения в 4К. А в последнее время фокус сместился в сторону закрытых моделей, таких как Ideogram, Recraft, MidJourney и FLUX, о которых известно не так много.

Кроме более полного экскурса в эволюцию диффузионок за последние два года, в статье упоминают CV Week, бесплатный интенсив ШАДа о диффузионных моделях. О нём у нас был пост с комментариями спикеров — будет полезно, если захочется пробежаться по ключевым тезисам.

CV Time

___
Meta признана экстремистской организацией, а Facebook и Instagram запрещены на территории РФ
2 444 просмотров · 31 реакций Открыть в Telegram · Открыть пост на сайте