NeurIPS в Мехико: продолжаем делиться интересным

Червёртый день конференции в Мексике получился насыщенным. Было выступление Ричарда Саттона о его видении SuperIntelligence, две сессии со статьями и две — с постерами.

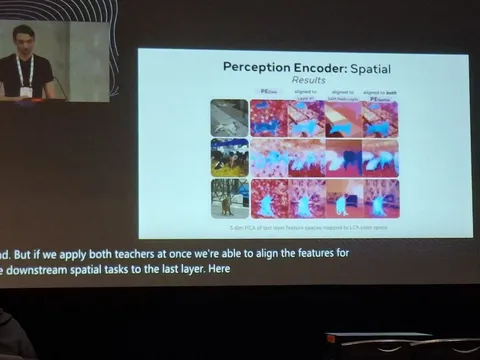
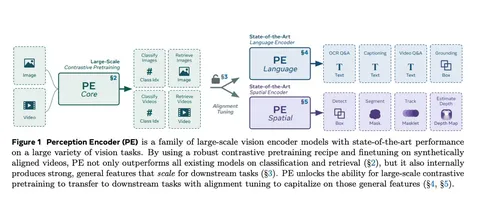
Самая интересная статья дня, по мнению Владислава Фахретдинова, — Perception Encoder: The best visual embeddings are not at the output of the network от Meta*. Мы уже разбирали работу в канале, а теперь делимся тем, что о ней говорят сами авторы.

Исследователи рассказывают, что поставили перед собой цель создать лучший визуальный энкодер для многих downstream-задач. Для этого двухстадийно обучались контрастив-лоссом на парах «изображение-текст» и потом — на парах «видео–текст», используя свою модель как кадровый энкодер.

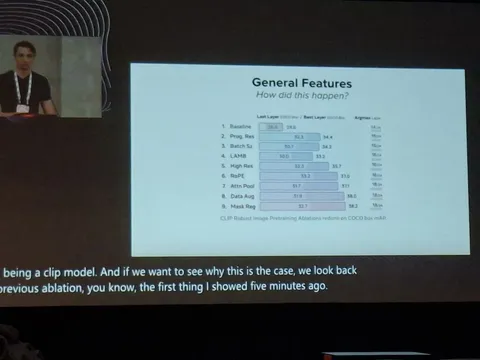
Начав с CLIP-бейзлайна, добавили ряд улучшений и сравнили их по качеству и устойчивости. Уже на этом этапе модель достигла SOTA в zero-shot retrieval и классификации; назвали её PE_core.

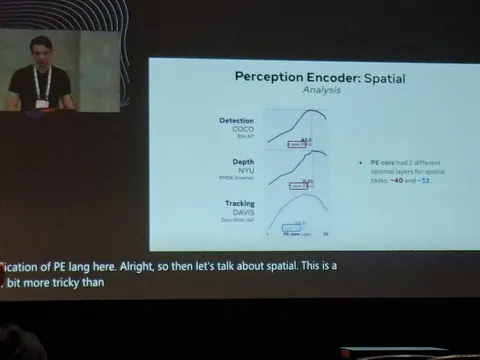
Затем авторы протестировали модель как энкодер на разных downstream-задачах: детекции, трекинге, предсказании глубин. Увидели, что перфоманс оказался ниже ожидаемого.

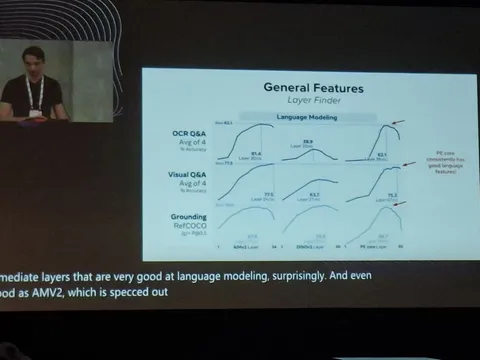
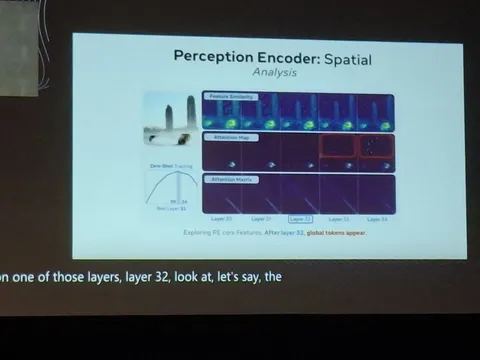
В ходе исследования с помощью аттеншен-карт заметили появление глобальных токенов на определённом слое. Чтобы проверить гипотезу, стали брать эмбеддинги не с последнего слоя, а с предыдущих. Построив график качества по слоям для разных downstream-задач и моделей, увидели, что качество растёт к эмбеддингам средних слоёв, а к последним слоям — резко падает.

Для решения этой проблемы использовали два метода после обучения:

1. Чтобы сохранить глобальную информацию, провели файнтьюн на 41-м слое (который показывает близкие к лучшим значениям по всем задачам) с минимизацией косинусного расстояния между ним и последним слоем.

2. Чтобы сохранить локальную информацию, добавили файнтьюн на MSE попарного косинусного расстояния между эмбеддингами последнего слоя (H×W×1024 -> HW×HW) и попарного косинусного расстояния между логитами SAM для 1024 точек из равномерной сетки исходного изображения.

Эту модель авторы назвали PE_spatial и показали, что она достигает SOTA по многим downstream-задачам. Хотя вышедший позже DinoV3 достиг более высоких результатов, подход остаётся интересным.


#YaNeurIPS25

CV Time
___
Meta признана экстремистской организацией, а Facebook и Instagram запрещены на территории РФ
1 421 просмотров · 28 реакций Открыть в Telegram · Открыть пост на сайте
NeurIPS в Мехико: туториал о геопространственных foundation-моделях

В третий день конференции прошло большое количество туториалов. Один из них — Geospatial Foundation Models: Overview, Application and Benchmarking — посетил Владислав Фахретдинов из команды восприятия робота доставки. Делимся его заметками!

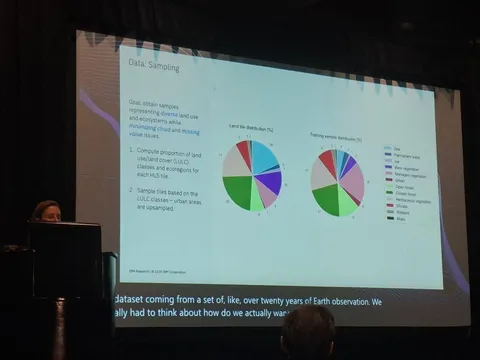
Выступали докладчики из бразильского подразделения IBM Research. Начали с рассказа о задаче remote sensing — дистанционного зондирования по спутниковым данным. Основное отличие от классических задач компьютерного зрения в том, что кроме RGB-сигналов необходимо использовать и другие спектральные каналы, у каждого из которых есть своё физическое назначение.

На основе этих данных можно решать множество задач, таких как сегментация земного покрова, пожарных шрамов и наводнений, предсказание глубины для водного покрова и процента покрытия деревьями.

Затем был базовый экскурс в развитие компьютерного зрения: от свёрточных моделей и трансформеров до автоэнкодеров, а после — рассказ о foundation-моделях в этой сфере.

Докладчики представили множество работ, в которых главный архитектурный вопрос состоит в том, как правильно объединять данные из разных каналов (модальностей). Отчасти это связано с тем, что нельзя просто склеить все каналы из-за отличий в разрешении, поэтому используются разные подходы:

— отдельные энкодер и декодер для каждой модальности, но общий аттеншн;
— динамический подбор размеров патчей для каждой модальности на основе длины волны и общий энкодер;
— либо разные энкодеры, но совместный семплинг патчей со всех модальностей на этапе претрейна.

После этого исследователи рассказали о своём фреймворке для обучения геопространственных моделей TerraTorch. На практике — собрали ноутбук с обучением двум разным задачам: land segmentation и burn scars.

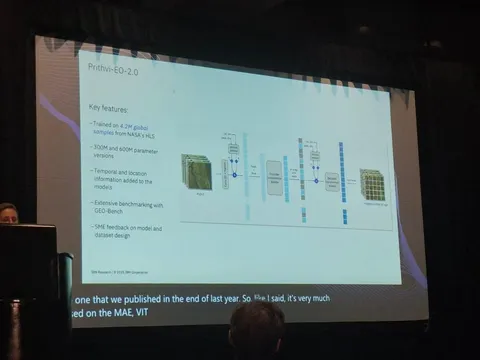
Также авторы представили свой новый бенчмарк GeoBenchV2, который сгруппировали из 19 существующих датасетов. Взяли множество популярных в CV моделей для сравнения и дофайнтюнили их на разные задачи только на основе RGB.

В итоге оказалось, что общие модели, такие как DinoV3, дают гораздо лучшие предсказания на основе RGB-изображений, но на задачах с мультиспектральными данными более маленькие, но узкоспециализированные модели всё ещё побеждают.


#YaNeurIPS25

CV Time
1 360 просмотров · 27 реакций Открыть в Telegram · Открыть пост на сайте
NeurIPS 2025 в Мехико идёт полным ходом

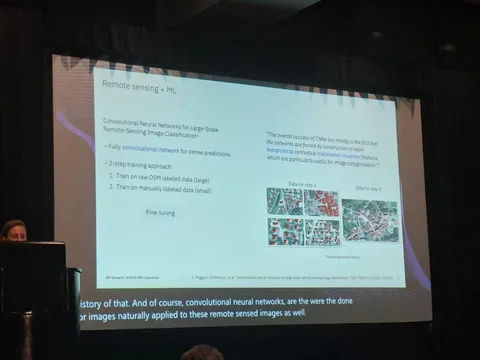
Конференция продолжается, а наш коллега Владислав Фахретдинов делится заметками о воркшопе второго дня — 7th International Workshop on Large Scale Holistic Video Understanding: Toward Video Foundation Models.

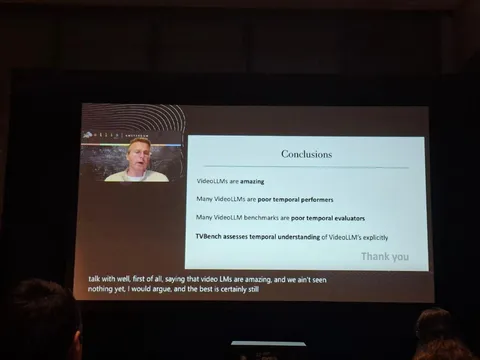
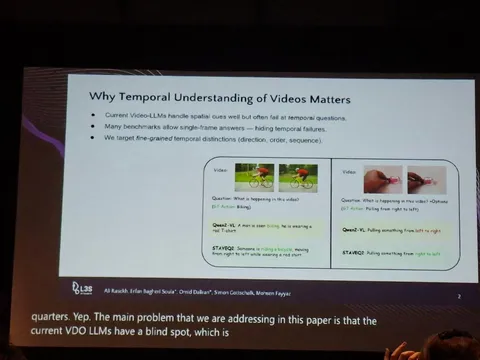
Было немного спикеров, но почти каждый привёз по две-три статьи или исследования, поэтому день получился насыщенным. Основной мотив воркшопа — большинство моделей для работы с видео недостаточно хорошо ориентируются «во времени». Участники разбирались, что с этим можно сделать.

Первым выступил профессор университета Амстердама. Он заметил, что многие VideoLLM не справляются даже с простым синтетическим бенчмарком: какой из двух объектов в видео появляется раньше. Это показывает, что мы до конца не понимаем, как правильно оценивать такие способности модели.

Затем последовал рассказ о работе Bench of Time с более подробными исследованиями — оказалось, что большинство примеров в популярном бенчмарке (MVBench) решается либо знанием всего об одном кадре, либо вообще исключительно по тексту. Чтобы исправить эту ситуацию, авторы сделали свой бенчмарк TVBench. В нём все вопросы были сформулированы так, что без понимания объектов и процессов в кадре нельзя дать правильный ответ.

Сравнение моделей на новом бенчмарке показало, что большинство языковых, картиночных и даже видеомоделей выдают результаты немногим лучше случайного предсказания. При этом все же нашлись несколько моделей, которые были достаточно хороши на обоих бенчмарках, например Gemini-1.5.

Следом было выступление о генерации 3D-представления из изображения. По сути, это продолжение работы DUSt3R, в которой научились по любым входным изображениям без параметров камер и поз делать матчинг и генерировать плотное облако точек 3D-представления сцены.

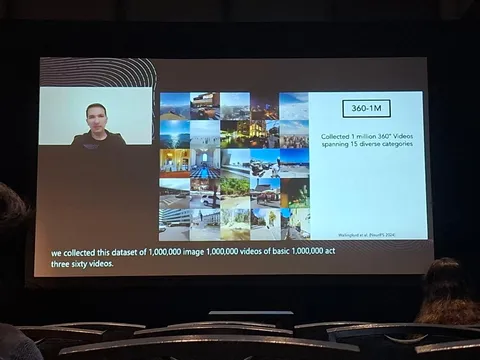
Авторы сделали уточнение, что матчинг изображений по случайному видео с движением — вычислительно сложная задача. Поэтому они собрали датасет 360-1M, где происходит движение и вращение вокруг оси, из-за чего матчить изображения стало гораздо проще. На основе своего датасета они обучили генеративную модель ODIN, которая по изображению и смещению позиции камеры генерирует новое изображение. Подробностей было мало, никаких сравнений с DUSt3R или NeRF не показали, но зато рассказали, что модель хорошо обобщается вне домена — например, на картины.

Самый интересный доклад за день — о том, что визуальные модели знают о нашем мире. Авторы выделили и проверили три свойства: базовое представление о физическом устройстве мира, визуальное предсказание, а также обобщение — понимание аналогий.

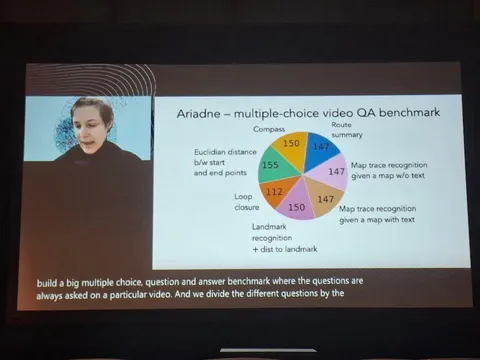
Для первого свойства взяли часовые видео с прогулками по городам и с помощью сервиса визуальной локализации, а также небольшого объёма человеческой проверки, разметили эти видео. В частности, для каждого видео сгенерировали маршрут на карте.

Далее видео нарезали и собрали бенчмарк, в котором модели задавали вопросы по содержанию ролика, например: о евклидовом расстоянии от начальной до конечной точки на полученном маршруте; направлении; зацикленность маршрута; выборе правильного трека на карте среди нескольких вариантов (с текстом на карте и без текста); распознавании окружающей архитектуры. По всем этим вопросам модели уступают человеку — за исключением проверки на зацикленность маршрута.

Авторы также показали, что на самом деле модели не понимали, был цикл в маршруте или нет. Вместо этого они просто смотрели на разметку на карте и сопоставляли её с текстовыми названиями улиц, которые видны в видео.

Напоследок был доклад из трёх частей, из которых я бы выделил как самую интересную — SSL-обучение мультимодальной модели видео+аудио CAV-MAE Sync. Из того, что мне кажется важным: авторы совместно используют аудио- и видеопатчи и добавляют регистровый токен, чтобы переносить накопленную информацию в следующие слои. Больше всего мне понравилось, что новая модель позволяет локализовать на видео источники звука.


#YaNeurIPS25

CV Time
1 227 просмотров · 27 реакций Открыть в Telegram · Открыть пост на сайте
DeepSeek-OCR: Contexts Optical Compression [2/2]

В первой части разбора мы рассказали об особенностях архитектуры DeepSeek-OCR и ключевых задачах, которые решали авторы. А теперь посмотрим на нюансы обучения и на озвученные результаты.

Обучение модели

Процесс упрощён и включает только две стадии: тренировку энкодера и обучение модели целиком.

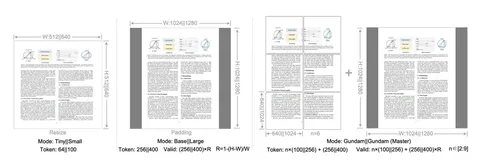
Важный момент: во время тренировки энкодера DeepEncoder учится работать и в режиме native-resolution, и в режиме tile-based-resolution. То есть модель видит как большие картинки, так и маленькие в разных представлениях.

Энкодер тренируется на парах картинок и текстовых описаний по схеме, описанной в статье Vary: к нему приделывается маленький текстовый декодер, и они вместе обучаются авторегрессионно.

Второй этап с обучением всей VLM повторяет обычный претрейн/SFT во множестве других VLM.

Результаты

Авторы представляют небольшую мультиязычную модель, которая может обрабатывать изображения в разном размере и даже в разных режимах динамического разрешения (tile-based, native-resolution).

Замеры точности распознавания в зависимости от размера изображения (и числа токенов) на OCR-бенчмарке Fox показывают, что для надёжного чтения текста можно использовать примерно в 10 раз меньше картиночных токенов, чем необходимо текстовых токенов для представления текста на изображении. При уменьшении этого соотношения качество чтения быстро падает.

DeepSeek-OCR показывает отличное качество на OmniDocBench, опережая в зависимости от разрешения не только сильные опенсорсные бэйзлайны, вроде Qwen-2.5VL, но и Gemini2.5-Pro. При этом скорость обработки на GPU сопоставима с пайплайновыми OCR-пакетами, такими как Miner, обрабатывая около двух изображений в секунду на А100.

В заключение можно заметить, что хотя результаты вышли довольно впечатляющими, в работе использованы только бенчмарки с фокусом на PDF-подобных картинках, а другие, более разнообразные OCR-бенчи для VLM (OCRBench_v2, CC-OCR), не замеряны. Также в статье нет аблейтов влияния на результаты ни выбранной архитектуры, ни этапов обучения, поэтому авторы сами называют свои результаты proof-of-concept.

Разбор подготовил ❣ Борис Зимка
CV Time
2 628 просмотров · 18 реакций Открыть в Telegram · Открыть пост на сайте
DeepSeek-OCR: Contexts Optical Compression [1/2]

Сегодня начинаем разбирать недавнюю статью DeepSeek-OCR. Авторы работы сфокусировались на двух аспектах:

1. обучении эффективной VLM-модели, заточенной именно под OCR-задачи;
2. изучении влияния размера входного изображения на качество работы VLM (и компрессии визуальной информации в целом).

Сначала небольшое интро по каждому из этих аспектов.

OCR-специфичные VLM-модели

Задачи, связанные с чтением текста, встречаются довольно часто и у простых пользователей, и в бизнес-процессах компаний. Такие задачи не требуют знания фактов, агентности, рассуждений, и тратить много GPU на них жалко. За последний год вышло несколько статей по OCR-специализированным легковесным VLM (GOT, Dolphin, UMiner, dots.ocr).

Динамическое разрешение в VLM

Первые VLM, вроде LLaVA, использовали статический размер изображения: любая картинка для обработки ресайзилась к фиксированному квадрату, прогонялась через энкодер (например CLIP), готовя картиночные токены на вход LLM. Так как изображение на входе может быть и пиксельной строкой текста 128 х 16, и большим фото со смартфона 1500 х 4500 пикселей — статический размер работает не оптимально. Сегодня для VLM есть два основных способа сделать разрешение динамическим:

1. Tile-based-resolution (Intern-VL2) — изображение разрезается на квадраты, например 512х512 пикселей, и каждое прогоняется через картиночный энкодер. Все выходные токены (чем больше размер — тем больше тайлов и токенов) подаются на вход LLM.

2. Native-resolution (Qwen-VL2) — картиночный энкодер обучается принимать на вход изображение любого размера, используя подходящие для этого позицинные эмбеддинги типа RoPE.

Модель и данные

DeepSeek-OCR архитектурно повторяет стандартную для VLM схему: картиночный энкодер, присоединенный к предобученной LLM (в этом случае DeepSeek-3B).

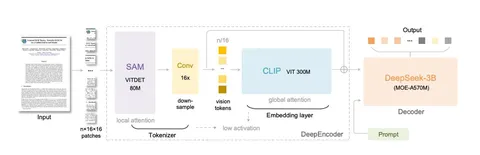
Однако вместо стандартного CLIP/SigLIP в качестве энкодера используется пайплайн из SegmentAnything (SAM-ViT-Det), свёрточного адаптера и CLIP (CLIP-ViT), который в статье называют DeepEncoder. Авторы хотели, чтоб энкодер был эффективным и быстрым, и чтобы в уже обученном энкодере можно было легко «на лету» менять количество картиночных токенов.

SAM-ViT-Det может принимать на вход изображение любого размера; токенизированные патчи обрабатываются независимо друг от друга благодаря window attention — поэтому количество вычислений уменьшается. Затем адаптер снижает количество токенов в 16 раз, а после глобальный аттеншн в CLIP-ViT агрегирует их вместе.

Для обучении используется типичная смесь пар (картинка-описание) и только текстовых данных с упором на OCR: печатный текст, графики и таблицы, формулы. В отличие от других OCR-специализированных VLM (обычно обучаемых только на английском и китайском), датасеты содержат более 100 языков.

Во второй части подробнее разберём, как обучали DeepSeek-OCR и к каким результатам пришли авторы.

Разбор подготовил ❣ Борис Зимка
CV Time
1 764 просмотров · 30 реакций Открыть в Telegram · Открыть пост на сайте
X-Fusion: Introducing New Modality to Frozen Large Language Models

Сейчас индустрия унифицирует подходы к обработке различных видов данных. Существенную часть задач компьютерного зрения решают VLM: генерируют текст на основе изображений и запросов, которые получают на вход. Следующий шаг — наделить модели возможностью генерировать изображения.

Изображения, в отличие от текстов, недискретные, поэтому для них лучше применять вариации диффузионных лоссов, а не next-token prediction. Сегодня рассмотрим статью, где предлагается объединить в одной системе два лосса.

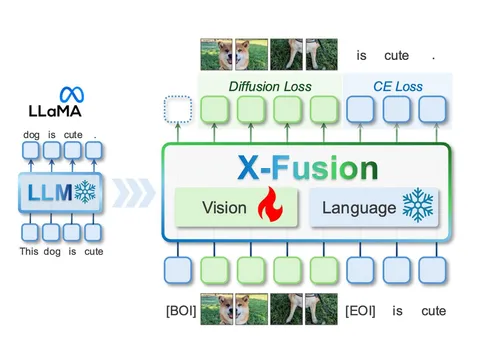
Суперверхнеуровневая схема нового фреймворка X-Fusion — на иллюстрации к посту. Авторы предлагают использовать две одинаковых предобученных LLM: первую заморозить, чтобы она стабильно хорошо справлялась с текстовыми задачами. А её копию — назвать визуальной башней и дообучить для работы с изображениями.

Если нужно обработать изображение, то закодируем его VAE от SD-1,5 и подадим на вход визуальной башне. Таким образом, генерация текста происходит через предсказание следующего токена. А для создания изображений выберем токены, расшумим их диффузией и декодируем VAE.

Авторы сравнили четыре базовые архитектуры:
— Единообразно обрабатывать текстовые и картиночные входы одним трансформером.
— Дублировать каждый слой LLM-gated-слоем. Обучать только визуальные слои, результаты складывать, а визуальный выход домножать на обучаемый скаляр.
— Схема с двойной проекцией: копировать и добучать QKV-матрицы и MLP для визуальной модальности.
— Финальный вариант: две башни, одна из которых применяется для текстовой модальности, а вторая — для визуальной. А потом либо использовать (в целях экономии вычислений) выходы из соответствующих башен, либо суммировать их с некоторыми весами.

X-Fusion обучали на синтетике: caption сгенерировали InternVL-2.0 26B. А для text-to-image взяли свой inhouse-датасет. Хотя по словам авторов, подход с двумя башнями превосходит другие базовые решения в задачах создания изображений, в обратную сторону это не работает: задача генерации текста не помогает получать хорошие caption для изображений. Авторы также изучают, стоит ли зашумлять входные латенты для задач распознавания изображений. Их вывод — нет, это приводит к деградации качества.

Разбор подготовил ❣ Сергей Овчаренко
CV Time
1 912 просмотров · 20 реакций Открыть в Telegram · Открыть пост на сайте
ERNIE 4.5 Technical Report [2/2]

Продолжаем разбирать технический репорт от Baidu. В работе фактически выделены два независимых пайплайна алаймента: LLM и VLM. После посттрейна в мультимодальном семействе модели получаются гибридными: они работают и в режиме с ризонингом, и без него. При этом авторы не объясняют, как эти два направления соотносятся между собой и как VLM-компонента влияет на метрики LLM (и наоборот).

LLM-линия: SFT и RL с множеством ревордов

На этапе SFT всё довольно просто — собрали и сбалансировали нужные срезы под задачи. Дальше идёт многостадийный RL с разными сигналами. Есть rule-based-реворды для ризонинг-задач, есть «верифицируемые» — когда можно проверить ответ прямо в среде, например, запустить код. Также используется LLM-as-a-judge, где отдельная модель оценивает ответы, и стандартный Bradley-Terry-реворд, в котором на вход подаётся ещё и ground truth, что не очень типично для таких моделей.

Вместо классического GRPO в работе используют UPO (Unified Preference Optimization) — смесь онлайн-RL и офлайн-обучения на парах (DPO-подобный лосс). Мотивация — не переобучаться на потенциально шумных сигналах reward-моделей и держать устойчивый сигнал на аккуратно подобранных офлайн-парах. Инструкции отбирают так, чтобы дисперсия ревордов по ним была высокой — это даёт полезный сигнал в RL.

VLM-линия: три SFT-этапа и свой RL

В сложных мультимодальных задачах часто «провисает» не сам ризонинг, а перцепция: модель плохо считывает сложные структуры и объекты на картинке. Проблема — дефицит плотных, подробных пар «картинка-кэпшен». Синтетика тут помогает ограниченно. Поэтому авторы делают детальные кэпшены на реальных картинках в срезе STEM так, чтобы текст-only-модель могла отвечать на вопрос по исходной картинке, имея только кэпшен. Если это работает для множества моделей — кэпшен считается годным и идёт в обучение.

SFT включает три шага:

1. Text-only Reasoning Cold Start. Сначала учат чисто текстовый ризонинг (визуальные эксперты и энкодер тут не участвуют). Интересно, что VLM-способности при этом не разрушаются и даже появляется генерализация reasoning-паттернов на мультимодальные задачи в срезе STEM.

2. Reject Sampling for Multimodal Enhancement. Берут мультимодальные сэмплы, генерят много гипотез, ранжируют мультимодальными reward-моделями, отбирают лучшие — получается датасет для мультимодального reasoning-SFT.

3. Thinking / Non-Thinking Fusion. Обучение на смеси thinking- и non-thinking-данных; дополнительно описывают идею мёрджа экспертов между ризонинг- и неризонинг-моделью, чтобы перенести полезных мультимодальных экспертов.

RL для VLM
Авторы используют как model-based-сигналы вознаграждения, так и верифицируемые задачи, где можно проверить правильность ответа. К таким задачам относятся STEM-примеры (переписывание коротких тестовых вопросов в развёрнутые ответы), визуальные пазлы и генерация HTML по скриншоту интерфейса с автоматической проверкой через сравнение изображений (рендер против эталона).

Результаты

Текстовые модели ERNIE 4.5 чаще выигрывают у DeepSeek V3 на основных бенчмарках. После пост-трейна они держатся на уровне проприетарных моделей, вроде GPT-4, особенно хорошо справляясь с instruction-following и длинным контекстом.

В мультимодальных задачах ERNIE 4.5 показывает результаты примерно на уровне Qwen 2.5-VL — где-то чуть выше, где-то сопоставимо, особенно в reasoning-режиме.

Разбор подготовил ❣ Алексей Григорьев
CV Time
1 841 просмотров · 24 реакций Открыть в Telegram · Открыть пост на сайте
ERNIE 4.5 Technical Report [1/2]

Сегодня начинаем разбирать большой технический репорт (около 40 страниц без аппендикса) от Baidu о том, как они обучали мультимодальные Mixture-of-Experts (MoE)-модели. Авторы предлагают целую линейку моделей: MoE- и dense-версии, с ризонингом и без, варианты под LLM- и VLM-задачи.

В этой части разбираем интересные решения в архитектуре и претрейне.

Архитектура

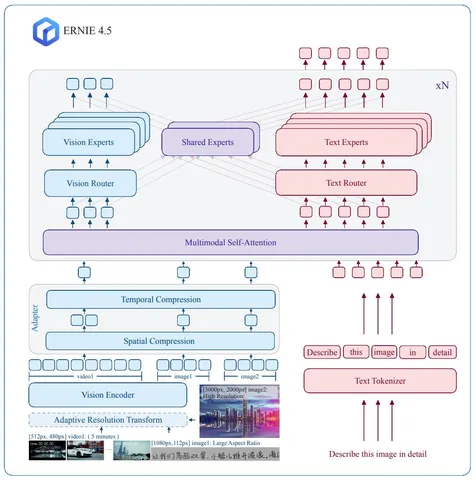
Авторы предлагают мультимодальную гетерогенную MoE-архитектуру. Поддерживаются текст, изображения и видео, на выходе — текст. Внутри блока трансформера два роутера: один маршрутизирует текстовые токены, второй — визуальные.

Кроме специализированных экспертов, есть shared-эксперты, которые всегда активны для обеих модальностей. Это нужно, чтобы не было сдвигов при совместном обучении и модальности не разбегались в эмбеддинговом пространстве (авторы ссылаются на работу Mixture-of-Transformers). Для роутинга используется привычный top-k-подход, знакомый нам по DeepSeek.

Визуальный энкодер реализован аналогично Qwen. С помощью адаптивного 2D RoPE картинку приводят к подходящему разрешению по соотношению сторон, разбивают на патчи и кодируют. Для видео применяют тот же принцип, только с 3D RoPE и таймстемпами.

Если ролик не влезает в контекст, выбираются кадры с нужным шагом (adaptive frame-resolution sampling strategy) и при необходимости уменьшают разрешение. Потом идёт pixel shuffle и темпоральная компрессия — пространственные размеры урезаются, а временная часть остаётся.
В итоге визуальные токены из картинок и видео отправляются в мультимодальный self-attention.

Претрейн

В работе описан стандартный пайплайн с дедупликацией, удалением мусора и quality-фильтрами. Но есть и особенности:

— Data Map: с её помощью данные организуют по языку, домену знаний, сценарию, качеству.
— Human-Model-in-the-Loop Data Refinement: асессоры помогают улучшать качество и разметку, результаты возвращаются в обучение классификаторов.
— Text-only-данные: делятся на пять типов по DIKW-фреймворку; отдельный акцент делается на фактические знания и программирование.
— Interleaved-данные (текст + картинка из веба): аккуратная каталогизация источников, аугментации, чистка, генерация и фильтрация кэпшенов, дедупликация по хешам изображений и текстов; категоризация типов картинок (натуральные сцены, таблицы, скриншоты, чаты, документы и др.).
— Видео: авторы парсили ролики с богатым контекстом, прогоняли через ASR и использовали транскрипты.
— Domain-specific data: здесь используют прогрессивный рефильтринг данных — примерно так же, как это делалось в DeepSeekMath. Собирают пул URL по нужному домену, фильтруют, отправляют на оценку асессором, парсят содержимое, обучают новый классификатор и повторяют цикл.

Интересная находка: авторы собирали сетки из нескольких картинок в один кадр — так модель лучше учится работать с несколькими изображениями сразу и точнее понимает, о каком объекте речь.

Также исследователи пишут о применении REEAO (Record Everything Everywhere All at Once) — способе упаковывать сэмплы так, чтобы максимально заполнять контекст, не теряя остатки, и при этом быть робастными к смене data-parallel-группы.

В следующей части разберём интересное из посттрейна.

Разбор подготовил ❣ Данил Кашин
CV Time
1 935 просмотров · 23 реакций Открыть в Telegram · Открыть пост на сайте
Loong: Generating Minute-level Long Videos with Autoregressive Language Models

Сегодня разберём статью о Loong — авторегрессионной модели для генерации видео на основе LLM. Архитектура у неё типичная:

1. Видео токенизируют. В качестве энкодера использует MAGViT2. Это 3D CNN свёрточная модель, которая обрабатывает темпоральную часть кадров видео, токенизированную с помощью Clustering Vector Quantization. Размер токенайзера — 246M параметров.

2. Вектора видео подают на вход LLM. Авторы учат с нуля LLaMa от 700M до 7B параметров: 32 000 токенов для текста, 8 192 — для видео и 10 специальных — скорее всего, для разделителей между кадрами.

3. LLM возвращает другие вектора, на основе которых модель-декодер VQGAN предсказывает изображения — кадры видео.

Лосс в конце длинной последовательности кадров оказывается меньше, так как видеотокены в одном видео похожи между собой, а модели проще предсказывать похожие токены последовательно. Текстовые токены сильно отличаются от видео: для того чтобы качественно генерировать первые кадры, авторы предлагают перевзвешивать их лосс.

Обучение делят на три стадии:

1-я стадия. Модель предсказывает только одно изображение.
2-я стадия. Генерируется 1 секунда видео и 17 фреймов.
3-я стадия. Самое длинное видео — 10 секунд.

Модель обучают на десятисекундных видео. Этого мало, если на выходе должно получиться качественное длинное видео. Чтобы повысить качество генерации, авторы предлагают так называемый реинкодинг. То есть, генерировать первые кадры по исходному промпту пользователя. А потом брать в качестве следующего промпта несколько последних кадров получившегося видео и генерировать новое.

Такой подход замедляет инференс, но снижает требования к обучающему датасету. Loong тренировали на 100M пар «текст + изображение». Для первой стадии использовали датасеты LAION-2B и CC12M. Обучающие видео — 5,5M клипов, отфильтрованных из HDVG.

Пример Loong подтверждает: генерировать качественные длинные видео можно, даже если обучать модель только на коротких примерах.

Посмотреть результаты генераций можно на GitHub.

Разбор подготовил ❣ Андрей Чернов
CV Time
1 859 просмотров · 24 реакций Открыть в Telegram · Открыть пост на сайте
Что читает команда стримингового зрения: подборка актуальных статей

Заглянули к инженерам команды стримингового зрения в Яндексе — узнали, что они читают и обсуждают в последнее время. В сегодняшней подборке: новый мультивидовый датасет для устойчивого отслеживания объектов, трекинг мяча под окклюзией в спортивных видео и рекурсивное рассуждение маленьких нейросетей, которые обгоняют крупные LLM на логических задачах.

MITracker: Multi-View Integration for Visual Object Tracking

Авторы собрали и разметили крупный мультивидовый датасет (260 видео, около 234 тысяч кадров) с калибровкой камер, BEV-аннотациями и девятью атрибутами (occlusion, motion blur, low-res и др.). С одной стороны, этот датасет отличается разнообразием классов, с другой — ограничен только сценами в помещениях, что снижает переносимость в уличные условия.

Как устроен MITracker:

— View-specific feature extraction: для каждой камеры используется отдельный Vision Transformer, который извлекает представления целевого объекта в поточном кадре; объект задаётся эталонным изображением.

— Multi-view integration: 2D-признаки всех ракурсов проецируются и объединяются в 3D-feature volume с использованием BEV-информации; этот объём применяется в spatial-enhanced attention, который корректирует представления и улучшает локализацию и ассоциацию.

TOTNet: Occlusion-Aware Temporal Tracking for Robust Ball Detection in Sports Videos

TOTNet вводит архитектуру для трекинга мяча в спортивных видео, специально сфокусированную на работе в условиях частичной и полной окклюзии. Модель сохраняет временную структуру данных за счёт применения 3D-свёрток. Это позволяет извлекать динамические признаки движения, а не статические из пачки кадров.

Ключевые компоненты TOTNet:

— Occlusion Augmentation: специальная аугментация, которая имитирует скрытие мяча, чтобы модель училась восстанавливать позицию по контексту.

— Visibility-weighted BCE loss: взвешенная функция потерь, которая усиливает вклад случаев с окклюзией при обучении.

— Интеграция оптического потока (RAFT): используется для более точного захвата движения мяча в быстрых сценах.

В результате модель устойчиво отслеживает мяч, даже когда он временно исчезает из кадра, и превосходит предыдущие методы на всех спортивных датасетах, включая новый датасет TTA (Table Tennis under Occlusion).

Less is More: Recursive Reasoning with Tiny Networks

В статье авторыпредставляют Tiny Recursive Model (TRM) — простой и эффективный подход к решению сложных логических задач. Суть метода в использовании маленькой нейросети (всего 7 млн параметров), которая рекурсивно, шаг за шагом «размышляет» над решением и улучшает свои ответы с помощью механизма deep supervision.

По результатам экспериментов TRM превосходит современные LLM на бенчмарках Sudoku и ARC-AGI, используя при этом в тысячи раз меньше вычислительных ресурсов. Авторы отмечают, что для некоторых типов задач, особенно при ограниченном количестве обучающих данных, глубокая рекурсия компактной сети помогает избежать переобучения и оказывается намного эффективнее простого увеличения размера модели.

CV Time
2 238 просмотров · 27 реакций Открыть в Telegram · Открыть пост на сайте
Look Again, Think Slowly: Enhancing Visual Reflection in Vision-Language Models

Сегодня разбираем статью с любопытным методом разметки данных, который возвращает внимание модели к картинке, а не только к тексту.

При обучении на синтетике визуально-языковые модели быстро перестают смотреть на изображение и уходят в чисто текстовый ризонинг. Пример из статьи: нужно вычислить площадь под графиком. Текстовая модель пересчитывает шаги правильно, но не учитывает, что площадь под осью идёт с минусом. А модель с «визуальным рефлекшеном» может повторно взглянуть на картинку и заметить этот нюанс.

Чтобы показать проблему, в статье приводят несколько метрик. Первая — attention score между токенами рассуждения и визуальными токенами. Чем длиннее ризонинг, тем меньше внимания остаётся на картинку.

Вторая метрика — расстояние Хеллингера. Сначала запускают генерацию с картинкой, а затем убирают визуальные токены и продолжают без них. График показывает, что расстояние со временем уменьшается. Это значит, что итоговые генерации с убранной картинкой (после нескольких токенов, сгенерированных с изображением) почти не отличаются от генераций, где картинка присутствует. Иначе говоря, начиная с какого-то шага модель просто перестаёт использовать изображение и игнорирует его.

Авторы предлагают модель Reflection-V, которая умеет делать рефлекшн именно по изображению.

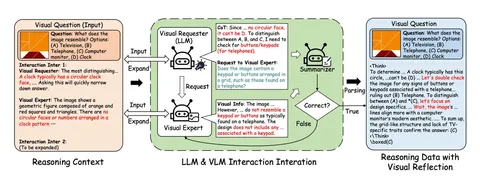
Решением становится новая разметка. Сначала составляется максимально подробный кэпшн, затем сильная текстовая модель (например, DeepSeek) выполняет задачу только по описанию.

Но ключевая идея статьи — агентский пайплайн. LLM-агент получает задачу: «На что похожа фигура — на телевизор, телефон, компьютер или часы?». Он вызывает VLM и уточняет: «Похоже ли это на часы?». VLM отвечает: «Есть треугольники и квадраты, ничего круглого — не часы». Агент делает вывод: «Значит, может быть телефон — у него кнопки сеткой, как клавиатура», и снова уточняет. Так формируется диалог, который суммаризатор превращает в связный reasoning trace. В итоге рассуждение действительно опирается на картинку, а не на текст.

Дополнительно используются фильтрации: если агент ответил без обращения к VLM, пример удаляется. На собранных данных модель обучается с GRPO. К обычной награде за правильный ответ добавляется ещё одна — по attention. Она измеряет, насколько во второй половине ризонинга модель продолжает опираться на изображение. Идея в том, чтобы не дать ей «забыть» картинку в середине рассуждения.

Тесты проводили на MathVision, MathVista, MMMU, IMMU-Pro, M3CoT и HallBench. Обучали две версии — Reflection-V-3B и Reflection-V-7B на базе Qwen2.5-VL. Они уверенно обгоняют опенсорсные ризонёры на синтетике и даже внутренние модели Qwen.

В агентской системе «мозгом» выступает QWQ-32B (LLM-reasoner), визуальным экспертом — Qwen-2.5-VL-72B. Обучение идёт в два этапа: сначала SFT (три эпохи на двух H100), затем GRPO (двенадцать эпох на восьми H100 через vLLM). Всего — около 16 тысяч ризонинг-семплов. Сетап скромный, особенно по объёму данных.
Аблейшны показывают, что полная модель (3B и 7B) даёт лучшие результаты.

Убираем reward по attention — метрики падают. Без SFT — ещё хуже. Убираем и то, и другое — совсем провал. Вывод авторов очевиден: все элементы нужны и каждый вносит свой вклад.

Разбор подготовил ❣ Илья Димов
CV Time
2 514 просмотров · 21 реакций Открыть в Telegram · Открыть пост на сайте
Работы по сбору датасетов для задачи instruction-based editing

Вместе с ростом популярности T2I-генерации стала активно развиваться и задача редактирования изображений. Несмотря на очевидные сходства, между ними есть как минимум одно ключевое отличие: редактирование — не одна задача, а целое семейство, и с точки зрения ML, и с точки зрения данных.

Сергей Кастрюлин, исследователь Yandex Research, разобрал основные работы по сбору датасетов для задачи instruction-based editing.

Paint by Inpaint: Learning to Add Image Objects by Removing Them First [датасет на HF, без лицензии]

Крупный (1,8M сэмплов) датасет, полностью посвящённый задаче добавления/удаления объектов. Авторы стартуют с картинок из COCO и OpenImages, для которых уже просчитаны маски (датасет LVIS). По этим маскам делают Remove через SD-Inpainting.

Основная часть работы посвящена фильтрациям:
— Исходные пары картинка-маска фильтруют по размеру и положению маски (слишком мелкая, слишком близка к краю картинки).
— После инпейнтинга проверяют, что объект действительно удалён, что удалён именно важный объект и что в целом картинка не испортилась, вычисляя набор эвристических метрик на основе локальных CLIP-эмбеддингов.

В статье указано соотношение source- и target-картинок: из ~800К исходных получили 1,800К таргетов. Это довольно сбалансированное распределение.

SEED-Data-Edit Technical Report: A Hybrid Dataset for Instructional Image Editing [датасет на HF, некоммерческий]

Ещё один большой (1,5М сэмплов) датасет, состоящий из трёх частей.

Часть 1: синтетические данные

1) Добавление и удаление объектов:
— Берут изображения из Unsplash и OpenImages.
— С помощью моделей LLAVA-1.5, GroundingDINO и SAM сегментируют объекты, подходящие для удаления.
— Делают удаление с помощью модели инпейнтинга LaMa.
— Для получения данных на задачу добавления объектов инвертируют триплеты.

2) Изменение объектов:
— Берут реальную картинку, кепшенят её.
— С помощью ChatGPT изменяют часть исходного инстракта.
— Берут image-guided T2I-модель PnP, подают в неё исходную картинку и измененный инстракт, получают результат.

Части 2 и 3: реальные данные

— Парсят сайты, где пользователи просят отфотошопить картинки. Получают 52К триплетов.
— Просят асессоров в фотошопе последовательно внести простые изменения и описать их кепшенами. Получают 21К последовательностей разной длины (до пяти редактирований на картинку).

На смеси данных учат LoRA для модели SEED-X. Минусы:
— В отличие от Qwen-Image авторы не перераспределяют данные по стадиям (было бы логично начать с плохой синетики, а закончить обучение на чистых реальных данных).
— Информация о последовательных редактированиях никак не используется — её просто перегруппируют в триплеты.
— О фильтрации не сказано ни слова, так что датасет почти наверняка шумный.

AnyEdit: Mastering Unified High-Quality Image Editing for Any Idea [датасет на HF, без лицензии]

2,5М сэмплов, разбитых на 5 категорий для увеличения разнообразия данных:

— Локальное редактирование: добавление, удаление или замена объектов, изменение цвета и действий;
— Глобальное редактирование: изменение тона, стиля или фона изображения;
— Редактирование, связанное с движением камеры: расширение кадра, поворот, изменение размера;
— Визуальное редактирование: перенос материалов, работа со скетчами и масками;
— Неявное редактирование (Implicit Editing).

Авторы стартуют с 680К из нескольких открытых датасетов. В данных отсутствуют «редкие концепты», поэтому генерят синтетические исходные картинки:

— Определяют редкие концепты.
— Просят LM сгенерить промпты для T2I-модели, чтоб они включали эти концепты.
— Генерят еще 700К картинок, доливают к исходным реальным.

Затем берутся промпты к исходным синтетическим картинкам и кепшены к реальным и — из них с помощью Llama3-8b генерятся editing-инстракты.

В статье описаны 9 пайплайнов генерации данных для покрытия пяти категорий задач указанных выше (Figure 7, appendix). После генерации есть фильтрация на основе CLIP-based эвристик.

Продолжение читайте в авторском канале Сергея Кастрюлина @c_research.

CV Time
2 053 просмотров · 13 реакций Открыть в Telegram · Открыть пост на сайте
GLM-4.5V and GLM-4.1V-Thinking: Towards Versatile Multimodal Reasoning with Scalable Reinforcement Learning

Сегодня разберём статью о том, как с помощью reinforcement learning (RL) и curriculum sampling обучить сильную визуально-языковую модель (VLM), опережающую аналоги в опенсорс-бенчмарках. Именно такой подход помог создать GLM-4.5V.

Авторы позиционируют GLM‑4.5V как одну из лучших открытых моделей для широкого круга задач: работа с длинными документами, агентный режим, видеоанализ, OCR и графика, генерация кода, STEM и VQA.

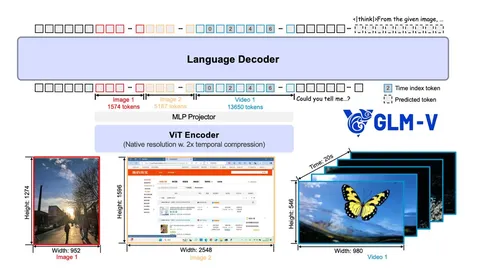
Архитектурно GLM‑4.5V близка к современным VLM и во многом напоминает Qwen2‑VL. Модель состоит из трёх ключевых компонентов: визуального энкодера, MLP‑адаптера и LLM‑декодера (MoE 12А109B). Для кодирования визуальных токенов в ViT применяются 2D‑RoPE и интерполяция абсолютных позиций для произвольных разрешений и экстремальных аспект‑ratios. А в LLM используются 3D‑RoPE и временные индексы для видео, что улучшает моделирование темпоральных зависимостей.

Модель предобучали с нуля на академических текстовых корпусах и больших, разнообразных наборах изображений. Для этого понадобилось свыше 10B пар «изображение + текст», отфильтрованных при помощи CLIP‑подобной модели. Чтобы минимизировать смещения, все операции с данными сопровождались сбором статистик: нормировали частоты в корпусе, следили за распределениями и итеративно улучшали собственный captioning‑пайплайн. Итоговый объём претренировочного датасета составил около 2T токенов.

Крупный претрейн и аккуратно собранный корпус для SFT с чётко заданным форматом ответов создали прочную основу для RL‑стадии. Качество модели оценивали через многократное сэмплирование предсказаний и подсчёт PASS@k на разных бенчмарках — это позволило заранее понимать, как система проявит себя после RL.

Главное новшество — мультидоменный онлайн‑RL с продуманной reward‑системой на базе GRPO. Авторы валидировали отдельные критерии оценки для каждого домена, контролировали риск reward hacking и балансировали сложность примеров. Такой подход позволил получить хорошее межпредметное обобщение: обучение в одном домене повышало качество в других, а совместное обучение сразу в нескольких — приводило к ещё большим улучшениям в каждом из них.

Второе важное нововведение — curriculum sampling: отбор наиболее полезных примеров для обучения. Подготовка выборки (RLCS) и её динамическое расширение реализованы с помощью экспоненциальной скользящей средней (EMA), что стабилизирует траекторию обучения и ускоряет сходимость модели.

По итогам проверки на 42 публичных бенчмарках GLM‑4.5V обеспечивает высокие результаты почти во всех задачах среди открытых моделей сопоставимого размера и демонстрирует конкурентоспособность по отношению к закрытым решениям.

Познакомиться с GLM-4.5V можно на github.

Разбор подготовил ❣ Данил Кашин
CV Time
2 104 просмотров · 20 реакций Открыть в Telegram · Открыть пост на сайте
Что читает команда алайнмента VLM: подборка актуальных статей

Узнали у инженеров Яндекса из команды алайнмента визуально-языковых моделей, какие статьи они читали и обсуждали в последнее время. В сегодняшней подборке: новый способ обучения MAE с прогрессивным замораживанием слоёв для видеолатентов без коллапса, как именно теряется сигнал в коннекторах VLM, объединение текста, картинки и звука в одной модели с сильным алайнментом и другое.

LayerLock: Non-collapsing Representation Learning with Progressive Freezing

В статье предлагается новый способ обучения MAE (Masked AutoEncoder) моделей для сжатия видео в латентные векторы на неразмеченных данных. Авторы заметили, что слои ViT на разной глубине сходятся с разной скоростью, и придумали прогрессивно замораживать по ходу обучения ранние слои, одновременно меняя таргет от восстановления пикселей к всё более глубоким латентным признакам. Это решает проблемы с representation collapse, и модель учится хорошо извлекать высокоуровневые фичи из видео.

Lost in Embeddings: Information Loss in Vision-Language Models

Авторы исследуют потерю информации в коннекторе — модуле, связывающем модальности в архитектуре современных VLM. В статье предлагают довольно интересные методы выявления этой потери, вплоть до определения конкретных участков изображения. Готовых решений нет, но работа помогает лучше понять, как сигнал передаётся от изображения к языковой модели внутри VLM, и подсвечивает информационный bottleneck современных архитектур.

Qwen3-Omni Technical Report

Это инженерное чудо и второй подход к объединению всех модальностей (текста, картинки и звука) в семействе Qwen. На этот раз модель не уступает эквивалентным по размеру моделям-экспертам в каждой из модальностей. В работе описан пайплайн обучения и процесс объединения модальностей на разных стадиях.

Примечательно, что стадия алайнмента включает дистилляцию более сильных тестовых моделей из семейства Qwen, возможно, с использованием моделей-экспертов в других модальностях. А вот об RL доподлинно известно, что часть ревордов в нём относятся к картиночной модальности, причём в обучении фигурируют, как model-based-, так и verifiable-реворды.

Mini-o3: Scaling Up Reasoning Patterns and Interaction Turns for Visual Search

В работе предлагают систему, способную решать сложные задачи визуального поиска с помощью многошаговых рассуждений на основе tool calling в виде зума изображения. В отличие от существующих подходов, ограниченных короткими цепочками действий, Mini-o3 может выполнять десятки взаимодействий методом проб и ошибок. Предложенная стратегия обучения на разнообразных траекториях рассуждений позволяет получить модель, генерирующую длинные цепочки рассуждений и повышающую свою точность с каждым шагом. Интересно, что схожая особенность появилась в передовой модели Qwen3-VL.

BaseReward: A Strong Baseline for Multimodal Reward Model

В работе исследуется рецепт создания мультимодальных моделей вознаграждения (MRM). Путём обширных экспериментов авторы определили оптимальную парадигму обучения, архитектуру, состав и баланс данных, обнаружив, что добавление текстовой информации значительно улучшает оценку мультимодальных задач. В результате исследователи получили модель вознаграждения, превосходящую прочие подходы по ключевым бенчмаркам.

CV Time
2 650 просмотров · 29 реакций Открыть в Telegram · Открыть пост на сайте
Should VLMs be Pre-trained with Image Data?

Сегодня разбираем статью о том, как лучше организовать претрейн для VLM. Архитектурных новшеств здесь нет: модель напоминает стандартные опенсорсные VLM вроде LLaVA. Картинка кодируется вижн-энкодером, эмбеддинги прогоняются через несколько MLP-слоёв и подаются вместе с текстовыми эмбеддингами в LLM-декодер.

Главный вопрос статьи: на каком этапе и в каких пропорциях подключать мультимодальные данные, чтобы итоговая модель была сильной и в text-only, и в мультимодальном режимах.

Разберём три интересных аблейшна, представленных в работе.

Когда останавливать LLM-претрейн

Обычно берут полностью обученную LLM (например, на 3–4T токенов) и затем добавляют мультимодальный претрейн со своим LR-шедулером, который часто начинается с warmup. Авторы считают это неэффективным: мы сначала «убиваем» learning rate, а потом снова разгоняем его на мультимодальных данных.

Исследователи пробуют прервать обучение LLM не в самом конце, а на определённом проценте (например, ~80% от шага). Дальше продолжают обучение уже на смеси текстовых и мультимодальных данных, сохраняя текущий learning rate. По представленным VLM метрикам и отдельно text-only-числам, такой вариант даёт лучше результаты, чем стратегия «сначала — до конца LLM, потом — мультимодальность».

Соотношение текстовых и мультимодальных данных

Во многих открытых моделях текстовые и мультимодальные данные миксуют на претрейне VLM, однако аблейшенов не дают. В статье показано, что оптимально брать в претрейн 10–20% мультимодальных данных.

Это можно объяснить качеством датасета: картинки проще, но сами мультимодальные пары нередко «грязные», особенно в опенсорсе. Исходя из практики, мы тоже видим необходимость подбирать соотношение, однако это сильно зависит от качества данных и представленных в них доменов.

Инструктивность и SFT-эпохи

В классическом VLM-pretrain нет инструктивности — модели просто описывают картинки. В последнее время часть инструктивных примеров добавляется уже на претрейне, и это работает. У авторов эффект почти незаметен, скорее всего, из-за слабого датасета (устаревшие LLaVA-данные) и малого количества инструктивных данных.

Ещё одно наблюдение связано с количеством эпох на SFT. Авторы пишут, что в их случае оптимальны четыре эпохи. При данных среднего качества выводы ограниченные и вряд ли могут быть перенесены на любую модель, однако результат полезный. По нашему же опыту — если данные хорошие, дополнительные эпохи действительно помогают.

В целом статья скорее систематизирует наблюдения, чем открывает новое, но её результаты подтверждают, как важно грамотно комбинировать текст и мультимодальность и где именно стоит искать улучшения.

Разбор подготовил ❣ Владислав Смирнов
CV Time
2 335 просмотров · 26 реакций Открыть в Telegram · Открыть пост на сайте
Эволюция Florence: от генеративных моделей к MLLM

Сегодня разберём сразу две статьи о семействе моделей Florence: что такое Florence-2 и как авторы использовали её в VLM.

Florence-2: Advancing a Unified Representation for a Variety of Vision Tasks

Это cемейство VLM-моделей появилось в 2023 году. По сути, это и была VLM, хотя сам термин тогда ещё не вошёл в широкое употребление. Показательно, что в Florence-2 авторы сделали ставку не на архитектуру, а на огромный и качественно собранный датасет FLD-5B.

В основе архитектуры — обычная схема энкодер-декодер-трансформер. Разве что схему VLM авторы нарисовали не так, как принято в 2025-м.

Вся суть статьи в пайплайне обработки данных. Авторы сформулировали множество разных задач в формате «текст на входе — текст на выходе». Так всю разметку можно условно поделить на три группы:

— понимание картинки в целом (classification, captioning, VQA) — семантика;
— умение локализовать объект (object detection, segmentation, referring expression comprehension) — геометрия;
— поиск и детекция объектов по набору признаков (text grounding) — семантика + геометрия.

Пайплайн обработки данных, с помощью которого получили обучающий датасет — на первой иллюстрации к посту:

1. первичная аннотация с помощью специализированных моделей (детекторы, OCR, сегментаторы);
2. фильтрация данных той же нейросетью: исправляют ошибки, удаляют ненужные аннотации;
3. итеративный процесс уточнения данных всё той же нейросетью.

FLD-5B состоит из 5 млн аннотаций, 126 млн изображений, 500 млн текстовых аннотаций, 1,3 млн текстовых аннотаций для локализации объекта на изображении и 3,6 млн текстовых аннотаций для поиска и детекции объектов по набору признаков.

Как итог, Florence-2 умеет делать 10+ задач (OCR, detection, segmentation, Caption to Phrase Grounding и др.) и довольно редко галлюцинирует. Однако, в отличие от современных VLM, она не справляется со сложными инстрактами, потому что не училась этому. Да и инстракты может принимать небольшие.

Florence-VL: Enhancing Vision-Language Models with Generative Vision Encoder and Depth-Breadth Fusion

Во второй статье авторы предлагают простую идею — использовать в качестве энкодера в VLM Florence-2. Причина проста: эта модель явно училась на OCR, детекцию и сегментацию, в отличие от CLIP/SigLIP (хотя SigLIP2 уже училась с next token prediction).

Заменить Image Encoder на Florence несложно. Нужно трижды инферить Image Encoder — по одному разу для получения признаков с прицелом на OCR, детекцию и сегментацию. Дальше фичи конкатенируются и пропускаются через projection (DBFusion), чтобы получить желаемое число каналов. Так появилось семейство Florence-VL. Подробнее — на второй иллюстрации к посту.

В результате Florence-VL демонстрирует высокую согласованность визуального энкодера и LLM, превосходя другие модели по 25 критериям. В том числе в задачах распознавания объектов, понимания семантики, распознавания текста и построения диаграмм.

Идея интересная, но, как показало время, не прижилась. Видимо, из-за того, что при таком подходе растёт число операций для получения фичей.

Разбор подготовил ❣ Егор Шестопалов
CV Time
11 699 просмотров · 25 реакций Открыть в Telegram · Открыть пост на сайте
Scale-wise Distillation of Diffusion Models

Сегодня разбираем статью от исследователей из Yandex Research, появившуюся на arXiv.org в марте 2025 года. Авторы предложили метод дистилляции Scale-wise Distillation (SwD), при котором диффузионная модель не сразу генерирует изображение в полном разрешении, а постепенно повышает его на каждом шаге. Такой подход позволяет ускорить процесс генерации более чем в два раза по сравнению с обычной дистилляцией.

Диффузия на данный момент — ведущая парадигма в области генерации изображений. Но, к сожалению, генерация даже одной картинки может быть довольно долгой. Причина: нужно делать много шагов, каждый из которых считается в фиксированном конечном разрешении и вычислительно затратен.

Проблему попытались решить с помощью scale-wise-генерации: стартовать с одного пикселя и постепенно повышать разрешение, приходя к результату за несколько шагов. Тогда первые шаги идут в низком разрешении и стоят очень дёшево — затраты растут по мере увеличения размера изображения.

Эта парадигма реализована в VAR (Visual Autoregressive Transformer), но кроме scale-wise-генерации, там используется представление изображения в виде дискретных токенов и авторегрессия. Однако дискретное представление изображений приводит к неустранимым ошибкам в представлении картинок и ограничивает максимально достижимое качество.

Отсюда возникла идея вытащить из VAR scale-wise-генерацию и поместить её во фреймворк, сочетающий лучшие стороны обеих парадигм (VAR и диффузии). Метод обучения SwD-подхода основан на известных процедурах дистилляции диффузионных моделей. Но дистилляция в этом случае позволяет не только уменьшить число шагов генерации, но ещё и генерировать при меньших разрешениях.

Интуиция авторов исходит из анализа диффузионного процесса в фурье-пространстве. У естественных картинок амплитуды частот убывают с ростом частоты, а у гауссова шума спектр плоский. Когда мы добавляем шум, высокочастотные компоненты изображения маскируются — сначала самые тонкие, потом всё больше. В итоге на ранних шагах модели остаются только низкие частоты, а детали всё равно «съедаются» шумом.

Это объясняет, почему диффузия хорошо подходит для генерации изображений: она восстанавливает сигнал от грубых низкочастотных структур к высоким частотам и деталям. Однако становится очевидно, что на начальных этапах нет смысла использовать полное разрешение — всё, что модель посчитает, будет уничтожено шумом.

Есть важные нюансы:

— если напрямую увеличивать разрешение шумных латентных представлений, возникает много артефактов, и качество изображения значительно ухудшается. Поэтому лучше сначала увеличить разрешение чистой картинки в низком разрешении, а затем добавить шум;

— важно подобрать такие шаги, чтобы уровень шума подавлял артефакты увеличения разрешения. Расписание шумов имеет критическое значение: в отличие от базовой дистилляции с равномерным расписанием, здесь его следует сдвинуть в сторону более высокого уровня шума, чтобы «погасить» дефекты увеличения разрешения;

— «перезашумить» — не так страшно, как «недозашумить». Если шума будет меньше, чем требует текущий шаг, качество сильно упадёт, и на финальных картинках появятся артефакты.

Обучение строится на парах соседних разрешений. Исходное изображение уменьшают до меньшего и до целевого размера. Малоразмерное изображение увеличивают, добавляют шум в соответствии с шагом t и подают в генератор, который предсказывает изображение в целевом разрешении. Функция потерь основана на сопоставлении распределения между предсказанием и целевым изображением (distribution matching).

Отдельно важно, что модель учится на синтетике учителя. Предобученной диффузией генерируют много картинок на основе некоторой выборки пользовательских запросов. Такой подход даёт заметный прирост качества по сравнению с обучением на реальных картинках.

Разбор подготовил ❣ Денис Кузнеделев
CV Time
2 387 просмотров · 30 реакций Открыть в Telegram · Открыть пост на сайте
Подборка статей о PEFT в VLM

Сегодня у нас краткий обзор PEFT (Parameter-Efficient Fine-Tuning) в визуальных моделях. Разберём три подхода и ключевые статьи в каждом из них.

Аддитивные методы

AdaptFormer

Базовый метод в этом классе, который фактически копирует адаптер-тюнинг из LLM. Подразумевает добавление адаптер-блока с понижением, нелинейным преобразованием и повышением размерности.

Обычно адаптер-блоки последовательно добавляют к feed-forward-слоям, а авторы подключают их параллельно — при этом адаптер складывается с результатом feed-forward-слоя с некоторым весом. Этот вес задаётся как гиперпараметр. В LLM его обычно берут больше единицы (например, 4), а для ViT у авторов лучший результат получился при 0,1.

В статье утверждают, что этот метод, применённый к VLM, даёт более высокие результаты по сравнению с prompt tuning, а иногда и с full tuning.

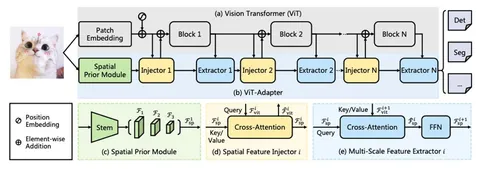
ViT-Adapter

Авторы исходят из того, что CNN лучше извлекают пространственные признаки, поэтому добавляют в ViT адаптер, который объединяет CNN и ViT. Основные компоненты адаптера:

— Spatial prior module — CNN на основе Stem из ResNet (свёртки 3×3 со stride=2 и свёртка 1×1), которая проецирует карты признаков в размерность D. На выходе получается пирамида {F1, F2, F3} из D-мерных карт с разрешениями 1/8, 1/16 и 1/32 от исходного. Эти карты разворачиваются и конкатенируются в один вектор.

— Spatial Feature Injector — компонент, состоящий из n блоков, где i-й блок добавляет пространственную информацию в i-й блок ViT с помощью слоя cross-attention.

— Spatial Feature Extractor — компонент, состоящий из n блоков, где в i-й блок добавляют многоуровневые признаки из i-го блок ViT с помощью: слоя cross-attention, FFN-слоя и skip connection с результатом i-го блока инъектора.

Side Tuning

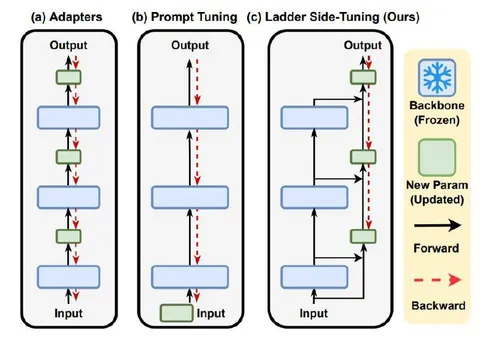
LST: Ladder Side-Tuning

Side-tuning впервые предложили в LST. Идея в том, что адаптеры и prompt-tuning уменьшают число обучаемых параметров, но не решают проблему памяти, так как требуют полного распространения градиента. В side-tuning выходы адаптеров в исходную архитектуру не попадают напрямую, что экономит ресурсы.

Реализация:
— добавляют несколько блоков-адаптеров, которые представляют собой маленькие трансформеры;
— с каждого трансформерного блока основной модели выход подают на соответствующий адаптер через линейное сжатие размерности. При такой подаче выход трансформерного блока суммируется с результатом предыдущего блока адаптера;
— суммирование происходит с помощью gate-механизма (обычный обучаемый гейт);
— метод можно применять как к декодеру, так и к энкодер-декодер-архитектурам. В ViLT-5 авторы использовали его только на уровне энкодеров-декодеров LLM, но не в самом ViT, так как там выход напрямую передаётся в адаптер для перевода визуальных токенов в языковые.

Эксперименты показали, что использование классических адаптеров вместо трансформерных блоков ухудшает качество, как и замена gate на cross-attention. Для инициализации маленьких трансформеров применяли pruning с матрицей информации Фишера.

Prompt-like-методы

Visual prompt tuning

Метод — буквально обычный Ptune, добавленный в сам ViT. Сравнивали, куда именно добавлять промпты: базовый вариант даёт результат не хуже остальных. Аналогично проверяли, куда подключать «классификационную голову» на выходе ViT, и снова базовый вариант оказался не хуже. Есть несколько вариаций: добавление промптов только в первый слой или deep visual prompt tuning — обучаемые векторы для каждого блока.

CoOp: Context Optimization

Метод, сделанный для CLIP в задачах классификации. Вместо ручного промпта используют обучаемые векторы. В отличие от Ptune, текстовый промпт тут убирается полностью. Метод сам по себе тривиальный, но стал базой для других подходов (например, CLIP-Adapter).

Разбор подготовил ❣ Александр Мандров
CV Time
2 169 просмотров · 23 реакций Открыть в Telegram · Открыть пост на сайте
Emerging Properties in Unified Multimodal Pretraining

Сегодня разбираем работу о модели Bagel, способной генерировать и редактировать изображения, а также работать с последовательностями кадров. Авторы заявляют результаты, местами превосходящие Flux.1-dev, и позиционируют Bagel как одну из сильнейших открытых VLM. В своё время команда Bytedance занимала топ-1 на Text-to-Image Arena, сейчас уступают GPT, но остаются в числе лидеров.

Свойства мультимодальных моделей

Понятие VLM постепенно меняется: от простых связок «текст-картинка» к системам, где на вход и выход можно подавать любые комбинации текста и изображений. Ключевые свойства таких моделей:

— Дискретное vs непрерывное представление. Дискретные токенизаторы (например, VQ) ограничены размером словаря, из-за чего страдает качество. Bagel использует непрерывные представления.

— Количество энкодеров. Эксперименты показывают, что для понимания и генерации нужны разные свойства эмбеддингов. Поэтому лучше использовать отдельные энкодеры: один для understanding-задач, другой для генерации.

— Авторегрессивность. В Bagel отдельные патчи каждого изображения предсказываются параллельно, а не последовательно.

— Интегрированный или внешний генератор. Возможны два подхода: всё в едином трансформере или через адаптер + внешнюю диффузионную модель. Bagel реализует первый вариант.

— Open vs closed source. Отличительная черта Bagel — это открытый код, редкость среди моделей с непрерывными токенами.

Архитектура

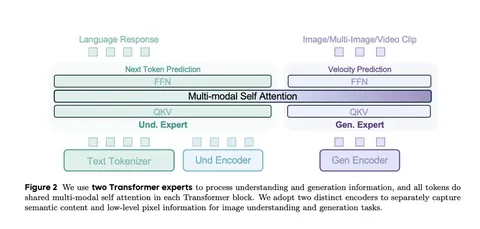
В основе Bagel — крупный трансформер с двумя башнями для задач понимания и генерации. Для понимания используется SigLIP2, а для генерации — Flux VAE. Чтобы согласовать размеры представлений, добавлены MLP-адаптеры.

Архитектура реализует принцип Mixture of Transformers: параллельно работают два трансформера (каждый на ~7B параметров). Токены разделяются между ними, а на отдельных шагах self-attention их представления смешиваются.

Ключевой момент: вместо дискретного next-token prediction используется flow matching, где модель предсказывает векторы скорости в непрерывном пространстве. Эксперименты показывают, что эта стратегия даёт ощутимое преимущество.

Обучающие данные

В основе обучения триплет-схема данных: чистый текст, пары «текст-картинка» для задач понимания и мультимодальные примеры, где текст и изображения перемешаны. Основные источники данных — видео и веб-контент. Большая часть разметки сгенерирована синтетически с помощью Qwen-моделей (до 14B параметров) и DeepSeek для reasoning-трейсов.

​​Для задачи редактирования авторы собирают данные за счёт аннотации различий между кадрами видео. Также берут связанные по смыслу последовательности изображений из веба, например из step-by-step-инструкций.

Обучение

Обучение проходило в четыре стадии. Сначала проводился алайнмент энкодера. Обучался небольшой MLP-адаптер на выходах SigLIP2, тогда как остальные компоненты оставались замороженными.

Затем претрейн: почти все части модели размораживались (кроме VAE), задачи понимания и генерации смешивались —причём оптимальным оказалось соотношение 4:1 в пользу генеративных задач.

На стадии Continued Training разрешения увеличивались, а набор задач становился разнообразнее.

Завершающий шаг — SFT и дообучение. Здесь использовали промты, переформулированные с помощью DeepSeek, и внедряли reasoning-трейсы.

Результаты

В задачах на понимание изображений Bagel показывает топовые результаты почти во всех бенчмарках, уступая лишь Qwen-2.5-VL на MMMU. В генерации модель на GenEval превосходит Flux и делит второе место со своей облегчённой версией, а в более сложном бенчмарке WICE занимает второе место сразу после GPT-Image.

Разбор подготовил ❣ Александр Устюжанин
CV Time
2 074 просмотров · 17 реакций Открыть в Telegram · Открыть пост на сайте
Nexus-Gen: A Unified Model for Image Understanding, Generation, and Editing

Сегодня разбираем статью о Nexus-Gen — мультимодальной модели от Alibaba, которая задумывалась как полностью открытая: авторы выложили не только код и веса, но и датасет. Модель умеет генерировать и редактировать изображения по текстовым запросам.

Качество картинок в целом достойное, хотя не всегда удаётся сохранить идентичность объектов при редактировании: при простых изменениях могут искажаться второстепенные детали — например, у человека слегка меняются черты лица, а в интерьере исчезают или трансформируются объекты, которые трогать не просили.

Архитектура

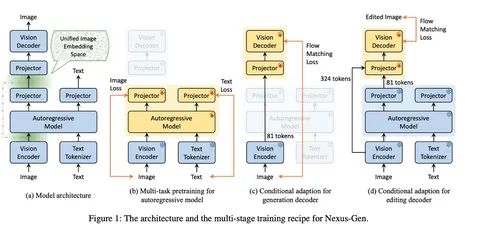
В основе модели авторегрессор (Qwen-2.5-VL) в связке с визуальным энкодером и декодером на базе Flux. Архитектура вдохновлена UniFLUID: текст и изображение проходят через общий авторегрессор, а для визуальной части используется отдельный визуальный декодер. В новой версии также добавлен декодер для редактирования изображений, который работает вместе с генеративным.

Главное улучшение модели связано с проблемой накопления ошибок на непрерывных визуальных токенах. В отличие от текста, где токены дискретны и ошибки не накапливаются, изображения страдают от смещения при последовательной генерации патчей. Авторы предложили решение: ввести специальный обучаемый токен, который обозначает места для генерации визуальных патчей. При обучении он вставляется в последовательность, а при инференсе автоматически генерируется и подаётся в диффузионную голову. Таким образом, модель всегда работает с фиксированным токеном, не накапливая ошибок с предыдущих шагов.

Для обучения используется комбинация лоссов: кросс-энтропия для текстовых токенов, MSE и косинусная близость — для визуальных. Это позволяет согласовать пространство визуального энкодера и выходы авторегрессора, сохраняя совместимость с диффузионной частью.

Этапы обучения

Сначала модель училась на задачах image understanding и image generation без учёта редактирования. На втором этапе задачи редактирования добавлялись в небольшом количестве. На третьем — к обучению подключили новый декодер для задач редактирования, а баланс сместился в сторону таких задач. На заключительном шаге проводили элайнмент между визуальными представлениями на входе и выходе авторегрессора, чтобы стабилизировать работу с диффузией и улучшить согласованность между генеративным и редактирующим декодерами.

Результаты

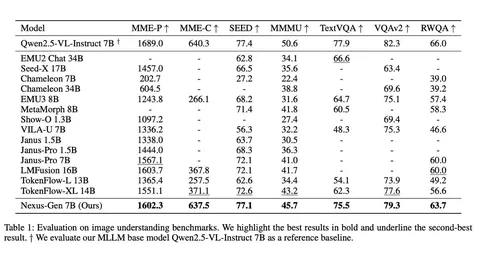
В новой версии Nexus-Gen авторы, наконец, показали количественные результаты: модель на 7B параметров занимает первое место на ряде бенчмарков по пониманию изображений, включая MME-P (1602,3) и TextVQA (75,5). Также она показывает высокий уровень на VQAv2 (79,3) и SEED (77,1), сопоставимый или превосходящий конкурентов ощутимо больших размеров. При этом она сохраняет баланс между пониманием, генерацией и редактированием.

Разбор подготовил ❣ Михаил Колтаков
CV Time
1 999 просмотров · 14 реакций Открыть в Telegram · Открыть пост на сайте
Тематическая подборка статей: генерация с эдитингом и VLM с генерацией

Сегодня подборка объединяет два актуальных направления в CV: развитие генеративных моделей с возможностью редактирования изображений и интеграцию генерации в VLM.

Генерация со встроенным эдитингом

HiDream-I1: A High-Efficient Image Generative Foundation Model with Sparse Diffusion Transformer
Неплохая модель по меркам опенсорса. Авторы используют трансформер с mixture-of-experts-блоками и гибридной архитектурой MM-DiT: текстовые и картиночные токены сначала процессятся отдельными слоями, затем — общими. В решении применяются четыре разных текстовых энкодера — выглядит как рекорд. Также авторы делают дообучение модели под задачи эдитинга — самое горячее направление в генерации картинок, которому посвящены и следующие работы.

ImgEdit: A Unified Image Editing Dataset and Benchmark
В статье предлагают полный набор для задачи эдитинга: датасет для обучения (автоматический пайплайн, которым сгенерировали 1,2 млн сэмплов, в том числе с многошаговым сценарием); обученную на нём модель (соединили VLM и DiT, переиспользовав Qwen и Flux) и бенчмарк для оценки качества (также обучили Qwen-as-a-judge, чтобы избежать разметки людьми).

R-Genie: Reasoning-Guided Generative Image Editing
Модель для редактирования изображений с упором на задачи, требующие рассуждений (пример: «Замени самого сонного человека на изображении на кота»). Авторы предлагают свой бенчмарк под такую задачу. Архитектурно соединяют VLM и DiT, но с хитрыми блоками-перемычками между ними.

VLM со встроенной генерацией

Diagnosing and Mitigating Modality Interference in Multimodal Large Language Models
Предлагают набор регуляризаций, чтобы VLM лучше связывала текстовую и картиночную модальности. В частности, при обучении в текстовых задачах авторы подают случайную (мусорную) картинку и требуют, чтобы предсказание модели не изменилось; добавляют adversarial-шум к картиночным токенам.

OpenUni: A Simple Baseline for Unified Multimodal Understanding and Generation
Соединяют VLM (InternVL3, веса заморожены) и диффузионный генератор (SANA, дообучается на второй стадии на 60 тыс. изображениях) через шестислойный трансформер (обучается на первой и второй стадиях). Пайплайн выглядит просто, качество сравнимо с другими открытыми аналогами.

Muddit: Liberating Generation Beyond Text-to-Image with a Unified Discrete Diffusion Model
Особенность работы в том, что для генерации изображений и текстов авторы используют дискретную диффузию. В качестве бэкбона берут предобученный MM-DiT, и добавляют энкодер/декодер для картинок и текстов. Качество не топовое, работа имеет скорее концептуальную ценность.

Are Unified Vision-Language Models Necessary: Generalization Across Understanding and Generation
Авторы показывают, что задачи генерации и дискриминации могут обогащать друг друга при совместном обучении. Особенно хорошо работает, когда вход и выход имеют схожую природу: «SigLIP in / SigLIP out» или «VQA in / VQA out».

Co-Reinforcement Learning for Unified Multimodal Understanding and Generation
Статья о том, как делать RL для архитектуры вроде Janus-Pro. Интересная идея — использовать GRPO с Cycle Consistency Reward: модель учится и на дискриминации, и на генерации, проверяя, насколько хорошо восстановленный ввод совпадает с исходным.

Подборку подготовил ❣ Артём Конев
CV Time
2 597 просмотров · 15 реакций Открыть в Telegram · Открыть пост на сайте
Cross-Frame Representation Alignment for Fine-Tuning Video Diffusion Models

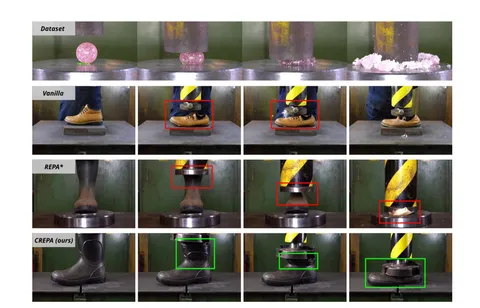
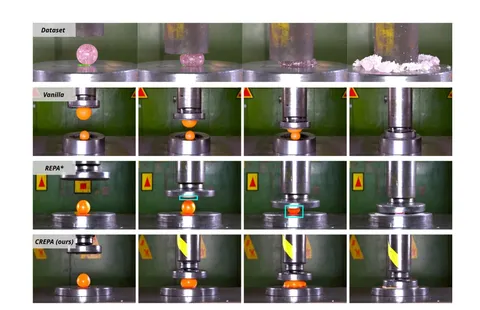
Сегодня речь пойдёт об улучшении генерации видео. Разберём статью о Cross-frame Representation Alignment (CREPA) — адаптированной версии REPA.

Метод REPA разработан для генерации изображений. Он считает similarity-score между промежуточным представлением диффузионной модели и предподсчитанными визуальными фичами (например, DINO). Чтобы приблизить фичи, в модели similarity-score добавляется к диффузионному лоссу. Именно в этом кроется потенциал REPA для тонкой настройки диффузионной модели.

Авторы предлагают два способа обобщения картиночного REPA на видео:

1. Применять REPA для каждого из кадров. Но REPA-составляющая никак не учитывает темпоральную связь между кадрами, что может порождать неконсистентные генерации.

2. CREPA. В лосс для каждого кадра добавляются similarity-score соседних представлений (с некоторым коэффициентом) — темпоральная связь появляется, проблема решена!

Для апробации CREPA авторы использовали две модели CogVideoX-5B и Hunyuan Video. Результаты их работы можно оценить на иллюстрациях (первая генерация — от CogVideoX-5B). Визуально консистентность растёт. А авторы отмечают динамику FVD 305-291-281 для Vanilla-REPA-CREPA.

Разбор подготовил ❣ Андрей Чернов
CV Time
2 513 просмотров · 10 реакций Открыть в Telegram · Открыть пост на сайте
Forte: Finding Outliers with Representation Typicality Estimation

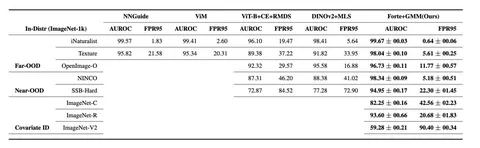
Сегодня разбираем статью, в которой авторы представляют новый метод обнаружения выбросов (out-of-distribution) для картиночных датасетов. Метод показал лучшие результаты в задаче Out-of-Distribution Detection on ImageNet-1k vs NINCO (AUROC = 98.34, FPR@95 = 5.18).

В работе утверждается, что низкое значение likelihood не всегда эффективно для обнаружения аутлаеров в пространствах высокой размерности. Вместо likelihood предлагается использовать оценку typicality, по аналогии с подходом из Density of States Estimator (DoSE): для каждого изображения собираются статистики эмбеддинга, после чего на этих признаках обучается модель оценки плотности. Авторы тестируют One-Class SVM, Gaussian Kernel Density Estimation и Gaussian Mixture Model. Полученные оценки плотности используются для вычисления typicality каждого изображения. При этом для обучения используются только in-distribution-данные. Для получения статистик применяются локальные геометрические признаки из работ по manifold estimation (например, Recall per point — доля in-distribution-семплов в радиусе, равном расстоянию до ближайшего соседа).

Авторы показывают, что метод позволяет успешно обнаруживать сгенерированные изображения. Например, при модификации изображений с помощью Stable Diffusion 2.0 при strength=0.5 (умеренное изменение оригинала) достигаются AUROC = 82.93 и FPR@95 = 46.80.

Этот алгоритм оказался интересен ML-разработке Яндекс Карт в задаче поиска фотографий, которые пользователи по ошибке загрузили в неправильную организацию. Его применили для нахождения аутлаеров на двух датасетах: один разметили вручную, второй — автоматически. Для автоматической разметки использовали косинус между изображением и строкой, состоящей из {название организации} + {рубрика организации}.

На размеченном датасете Forte показал AUROC = 91.68 и FPR@95TPR = 20.95, а на синтетическом — AUROC = 85.24 и FPR@95TPR = 93.24. При этом текущий бейзлайн, который фильтрует аутлайеры по значению косинуса, набирает AUROC = 81.02 и FPR@95TPR = 82.87.

Пока преимущество Forte над нашим бейзлайном не выглядит значительным, но идея использования методов из manifold estimation кажется перспективной.

Разбор подготовил ❣ Иван Балашов
CV Time
2 248 просмотров · 16 реакций Открыть в Telegram · Открыть пост на сайте
Perception Encoder: The best visual embeddings are not at the output of the network

Сегодня разбираем статью, авторы которой предлагают простой визуальный энкодер, обученный только на открытых данных, без сложных архитектур и языковых моделей. Всё обучение — это contrastive learning между изображениями и подписями. Исследователи показывают, что даже в таком режиме можно получить эмбеддинги, которые превосходят существующие модели на стандартных бенчмарках. Главная идея: сильные визуальные представления появляются не обязательно в последнем слое модели, а где-то внутри.

В архитектуре используется базовая ViT-модель с разрешением 224. При обучении применяются стандартные аугментации, attention pooling через CLS-токен и несколько инженерных приёмов: прогрессивное увеличение разрешения, обучение с большим batch size, оптимизатор LAMB вместо AdamW, маскирование части изображений с регуляризацией (maskfit), RoPE вместе с позиционными эмбеддингами. Вся модель обучается на contrastive loss — пары «изображение-текст» берут из общедоступных коллекций. Чтобы сэкономить вычисления, сначала обучают на низком разрешении, потом повышают до 336. Такой подход не только ускоряет обучение, но и, как утверждают авторы, помогает избежать переобучения позиционных эмбеддингов.

После обучения на изображениях авторы подключают видео. Они берут небольшой датасет с роликами и описаниями, прогоняют по 8 кадров через perception encoder, усредняют эмбеддинги и обучают contrastive loss на парах «видео-текст». Часть описаний взяли из открытых источников, часть — сгенерировали своей моделью. Для этого они собрали отдельную VLM (PLM), в которую встроили perception encoder и дообучили на видео и картинках с подписями. Модель даёт черновой текст, который потом правят вручную и добавляют метаинформацию — действия, объекты, временные сегменты. Эти описания идут в обучение. Авторы пишут, что это помогает даже в задачах классификации изображений.

На бенчмарках perception encoder показывает хорошие результаты. Авторы замечают: если взять не последний слой, а, например, 47-й, то на многих задачах это даёт лучший результат. У других моделей эмбеддинги либо слабее в середине, либо не меняются от увеличения модели. У perception encoder эффект усиления заметен.

Чтобы подключить этот энкодер к языковой модели, обучают projection head на выбранном слое — с температурой и двухслойным MLP. Такой подход даёт выигрыш по качеству по сравнению с head'ами на других слоях. Чем больше языковая модель — тем выше метрики.

Однако есть несколько моментов, которые вызывают вопросы. Во-первых, сравнение с конкурентами неполное: в основной статье нет упоминания Qwen, хотя в другом материале от тех же авторов сравнение с ней есть — и Qwen выигрывает по ряду задач. Во-вторых, идея, что видеоданные помогают классификации изображений, не объяснена, авторы не предлагают гипотезу, почему так происходит. В-третьих, подход с выбором «лучшего» слоя работает у их модели, но неясно, насколько он универсален. Отдельно хочется понять, насколько perception encoder стабилен вне тех задач, которые выбрали для оценки.

В целом статья показывает, что простая архитектура с грамотной инженерией и небольшим дообучением может дать представления, которые хорошо работают на downstream-задачах. Авторы не предлагают революции, но аккуратно исследуют поведение модели и дают полезные практические выводы — особенно про выбор слоя и влияние видеоданных.

Разбор подготовил ❣ Малик Газизуллин
CV Time
2 368 просмотров · 27 реакций Открыть в Telegram · Открыть пост на сайте
Тематическая подборка статей: дискриминативные модели

Свежая подборка статей о методах улучшения взаимодействия текста и изображений в мультимодальных моделях. В центре внимания — файнтюн CLIP для понимания отрицаний, новые подходы к retrieval, оптимизации архитектур Vision Transformer и многое другое.

Дообучение CLIP-моделей

TNG-CLIP: Training-Time Negation Data Generation for Negation Awareness of CLIP

Предлагают пайплайн файнтюна текстовой части CLIP на понимание отрицаний: на лету для батча генерируют новые тексты, содержащие отрицания, используя тексты с похожих картинок для усложнения задачи. Также показывают, что можно подменить текстовый энкодер в предобученной диффузионной модели, и генерации с отрицаниями в промпте тоже станут лучше.

Visualized Text-to-Image Retrieval

Авторы говорят, что вместо text-to-image retrieval можно сначала сгенерировать картинку по текстовому запросу, а потом уже делать image-to-image retrieval чисто по картиночным фичам. Тестируются на специфических постановках задач типа RAG, но идея интересная.

Hard Negative Contrastive Learning for Fine-Grained Geometric Understanding in Large Multimodal Models

Доливают в обучение CLIP датасет с геометрией и используют полученную модель как энкодер в VLM. Геометрические датасеты добавляют и в другие стадии обучения VLM, но основная новизна в том, как сделать файнтюн на геометрию в CLIP-постановке.

Distill CLIP (DCLIP): Enhancing Image-Text Retrieval via Cross-Modal Transformer Distillation

Для дообучения CLIP собирают модель-учитель, которая извлекает картиночные фичи по выделенным через YOLO областям и агрегирует их через cross-attention с текстовыми фичами; затем этот учитель используется для дистилляции. С ростом качества на retrieval-задачах метод просаживает точность zero-shot-классификации.

Vision Transformers with Self-Distilled Registers

Изучают проблему токенов-аутлаеров в трансформерных моделях, описанную в статье Vision Transformers Need Registers. В ней предложили на вход модели подавать токены-регистры. Также авторы пишут, что такие токены можно добавлять в уже обученную модель и файнтюнить её так, чтобы аутлаеры «перетекали» в добавленные токены.

Архитектура дискриминативных моделей

Taming Transformer Without Using Learning Rate Warmup

Связывают нестабильность в обучении трансформеров с тем, что матрица аттеншена становится низкоранговой и разреженной. Предлагают добавить в Adam ограничение на learning rate для апдейтов, которые имеют высокую спектральную норму по сравнению с текущей матрицей. Показывают, что в этом случае возможно обучение без lr-warmup'а.

RePaViT: Scalable Vision Transformer Acceleration via Structural Reparameterization on Feedforward Network Layers

Применяют идеи из ShuffleNet к ViT: в FFN-блоке делают нелинейность только для части нейронов промежуточного слоя — вторую часть можно после обучения вмерджить в одну линейную операцию. Также заменяют LayerNorm на BatchNorm и его тоже вмердживают после обучения. Но тестируют всё это только на ImageNet, есть подозрение, что на более сложных датасетах профита не будет.

TextRegion: Text-Aligned Region Tokens from Frozen Image-Text Models

Решают zero-shot-сегментацию и смежные задачи, предлагают пайплайн, в котором объединяют SAM и CLIP-модель: через SAM находят области с объектами, и в CLIP-модели модифицируют аттеншен последнего слоя, чтобы он смотрел на каждую область по отдельности — таким образом получают токены для областей, которые уже можно сопоставлять с текстовыми представлениями класса и делать сегментацию.

REN: Fast and Efficient Region Encodings from Patch-Based Image Encoders

Отличие от предыдущей статьи в том, что теперь область интереса на картинке кодируем координатами точки. Имея предобученный бэкбон, добавляем к нему голову, которая по координатам точки смотрит на карту признаков и возвращает эмбеддинг соответствующего ей объекта; SAM теперь используется только на этапе обучения.

Подборку подготовил ❣ Артём Конев
CV Time
2 154 просмотров · 27 реакций Открыть в Telegram · Открыть пост на сайте
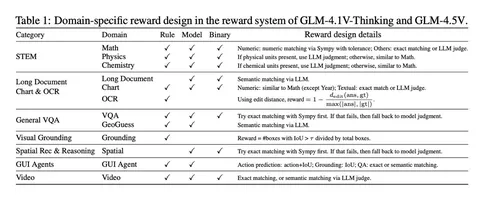
Впечатления от конференции ICLR 2025

ICLR 2025 принесла много полезных работ на тему CV. Мы попросили инженеров Яндекса подвести личные итоги конференции и рассказать, чем она запомнилась. О трендах в индустрии, интересных статьях и многом другом — в наших карточках.

Работы, которые упоминаются в посте:
— Building Safe and Robust AI Systems
— Pursue the Nature of Intelligence
— Adam: A Method for Stochastic Optimization
— Neural Machine Translation by Jointly Learning to Align and Translate
— Finding Outliers Using Representations Typicality Estimation
— MRAG-Bench: Vision-Centric Evaluation for Retrieval-Augmented Multimodal Models
— Benchmarking Multimodal Retrieval Augmented Generation with Dynamic VQA Dataset and Self-adaptive Planning Agent
— MMSEARCH: Unveiling the Potential of Large Models as Multi-modal Search Engines
— MM-Embed: Universal Multimodal Retrieval with Multimodal LLMs
— VLM в Нейро: как мы создавали мультимодальную нейросеть для поиска по картинкам

CV Time

#YaICLR
1 943 просмотров · 21 реакций Открыть в Telegram · Открыть пост на сайте
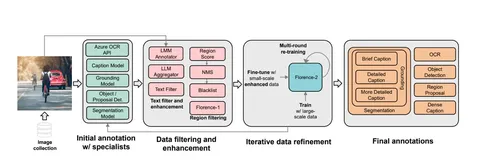
ICLR 2025: полезные статьи на тему CV

Конференция прошла, а интересные статьи, которые мы не успели упомянуть в наших подборках, — остались. Александр Шишеня, ведущий разработчик службы компьютерного зрения, отобрал и прокомментировал несколько работ, заслуживающих внимания.

Symbolic reasoning about LLMs

- Подход Ctrl-G позволяет модели генерировать ответ, который подчиняется жёстким условиям (например, валидный JSON). Основан на использовании детерминистического конечного автомата и скрытой марковской цепи в дополнение к обученной LLM.
- Можно навешивать мягкие ограничения в виде дополнительной LLM, заточенной на сдвиг генерации в нужное направление (например, убирать токсичность).

Neural Networks as Graphs

Используют графовую нейросеть для генерации апдейтов весов сети при обучении. Лучший результат получается, если чередовать такие нейросетевые апдейты с итерациями Adam. Один из авторов работы — Борис Князев.

Training Language Models in Academia: Challenge or Calling?

У академии на несколько порядков меньше ресурсов, чем у индустрии. Какую же роль в таком случае может играть академия в современном DL? Автор даёт свой ответ: возможностей академии хватает, чтобы делать полезный ресерч, а жёсткие ограничения диктуют направление развития — это оптимизация ресурсов и поиск подходов по ускорению обучения. В качестве доказательства приводится список работ Best Paper Awards ICML 2025, где большинство работ выполнено академией. Сомнительное доказательство — ведь можно предположить, что индустрии просто не так важно публиковаться, да и коммерческую тайну никто не отменял.

How much is a noisy image worth? Data Scaling Laws for Ambient Diffusion

Эффективно используются шумные данные для обучения диффузии. Выведен специальный лосс, который применяется к шумным сэмплам, а для чистых данных используется обычный лосс.

HART: Efficient Visual Generation with Hybrid Autoregressive Transformer

Статья от MIT и NVIDIA. Предлагается картиночный токенизатор, который генерирует дискретные токены и непрерывные поправки к ним. Далее дискретные токены предсказываются авторегрессионной моделью, а непрерывные — легковесной диффузионной моделью.

Zigzag Diffusion Sampling: Diffusion Models Can Self-Improve via Self-Reflection

Улучшают качество генерации изображений, чередуя прямую генерацию с высоким гайденсом и обратную генерацию с низким гайденсом.

GoodDrag: Towards Good Practices for Drag Editing with Diffusion Models

Редактирование изображений с помощью варпа. Фишка в том, что итерации варпа и денойзинга применяются попеременно — это позволяет достичь лучшего качества, чем последовательное применение сначала полного варпа, а потом расшумления.

Test-time Alignment of Diffusion Models without Reward Over-optimization

Элайнмент диффузионной модели на этапе сэмплирования. RL-Objective можно явно оптимизировать и выразить целевую плотность вероятности через плотность вероятности претренированной модели и реворд-функцию. Дальше сэмплируются сразу несколько траекторий, попутно отсеивая траектории с низким ревордом, добавляя новые и постепенно уменьшая силу гайденса.

CV Time

#YaICLR
1 809 просмотров · 19 реакций Открыть в Telegram · Открыть пост на сайте
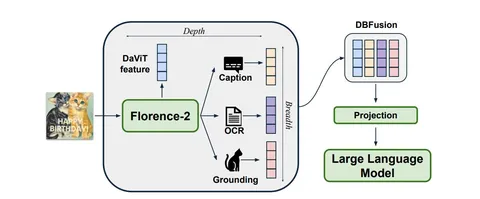
Что читает команда распознавания текста в VLM: подборка актуальных статей

Инженеры VLM-команды Яндекса поделились статьями, которые они в последнее время читали и обсуждали. В сегодняшней подборке: новые подходы к генерации инфографики, свежие бенчмарки для мультимодальных моделей, работающие пайплайны генерации кода по графику и попытки добавить зрение в диффузионки.

ChartGalaxy: A Dataset for Infographic Chart Understanding and Generation
Статья о том, как сгенерировать около миллиона инфографик. Авторы подробно описали каждую стадию процесса: сбор шаблонов, индексирование описаний, иконок и других элементов для заполнения шаблонов, фильтрацию и проверку качества.

InfoChartQA: A Benchmark for Multimodal Question Answering on Infographic Charts
Авторы собрали новый бенчмарк позволяющий проверить, как VLM-модели понимают инфографику. Для каждой инфографики сделали упрощённую версию в виде обычного графика с теми же данными — модели справляются с таким заметно лучше, чем с визуально перегруженным оригиналом. Также добавили новый тип вопросов по отдельным кропам из изображения инфографики — на понимание мелких визуальных деталей.

ChartCoder: Advancing Multimodal Large Language Model for Chart-to-Code Generation
Авторы обучили модель понимать графики: она получает изображение и возвращает код на Python (Matplotlib), чтобы построить такой же график. Для этого использовали стратегию Snippet-of-Thoughts (SoT) — пошаговое рассуждение перед финальной генерацией кода. Взяли LLM, способную писать код, собрали датасет под задачу (160 тысяч картинок, на каждую — один вопрос и ответ). Кратко описали пайплайн его создания. Модель показывает лучшие результаты среди аналогов такого же размера (включая почти самые свежие Qwen и InternVL). В ablation-экспериментах дообучили Qwen на своём датасете — получили прирост; 384 px + Anyres почти хватает для большинства графиков.

Relation-Rich Visual Document Generator for Visual Information Extraction
Статья с CVPR 2025 о генерации синтетических text-rich-документов с логической структурой (таких, как формы). Пайплайн генерации любопытен тем, что в нём сначала генерируют текст с помощью ChatGPT, а уже потом — структуру документа (laytout). Чаще встречается обратный вариант, когда структуру документа заполняют текстом. Авторы показывают, что обучение Qwen2-VL и Llava-NexT-mistral на таких данных улучшает метрики распознавания текста и извлечения информации на публичных бенчмарках.

LLaDA-V: Large Language Diffusion Models with Visual Instruction Tuning
Авторы попытались расширить предобученную текстовую диффузию LLaDA на мультимодальность, добавив визуальный вход через SigLIP2 и MLP-проекцию в языковое пространство. Итоговая модель зафайнтюнена на визуальных и reasoning-focused-инструкциях MAmmoTH-VL и VisualWebInstruct и бьёт автогрессионные и диффузионные бейзлайны по ряду мультидисциплинарных и визуально-математических бенчмарков.

SFT Memorizes, RL Generalizes: A Comparative Study of Foundation Model Post-training
Интересная статья, авторы которой подтверждают тезис из названия: SFT хорошо запоминает жёсткие форматы и правила, но плохо справляется с out-of-distribution-задачами. В то же время RL реально улучшает генерализацию и показывает заметный прирост на OOD-случаях. Но SFT всё равно нужен, чтобы RL вообще завёлся. В противном случае модель не умеет нормально реагировать на инструкции или генерирует неконтролируемый выход. RL-обучение не получает положительного сигнала. Это справедливо как для LLM, так и для VLM.

Подборку подготовила ❣ Команда распознавания текста в VLM
CV Time
4 259 просмотров · 40 реакций Открыть в Telegram · Открыть пост на сайте
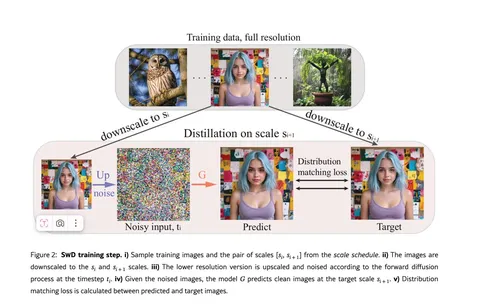
Scaling Vision Pre-Training to 4K Resolution

Большинство доступных визуальных энкодеров предобучено на изображениях низкого разрешения: например, на 378✕378, как SigLIP. Это становится серьёзной проблемой, если вы хотите обрабатывать изображения высокого разрешения с мелкими деталями. Дорожный знак STOP будет неразличим, если сжать кадры записи видеорегистратора до 378✕378. То же касается распознавания текста, где много мелких деталей.

Авторы сегодняшней статьи отмечают, что в индустрии уже борются с этой проблемой. Методом AnyRes режут большое изображение на части поменьше — тайлы без пересечений. Или, как в S2, одновременно ресайзят изображение до нужного размера и делят его оригинал на тайлы, чтобы добавить каналы для описания одних и тех же участков изображения в более высоком разрешении. Но эти методы кодируют картинку заранее — не учитывая запрос пользователя. Логично предположить, что для вопроса, например, про одежду человека, не нужно кодировать автомобили и здания.

Новое решение, которое предлагают авторы сегодняшней статьи, учитывает промпты пользователя. Они предлагают подбирать куски изображения, которые подходят под запрос, и подмешивать их в инпут. Сделать это можно в два шага:

1. предобучить энкодер PS3, который сможет угадывать подходящие области изображения;
2. обучить VLM отвечать на запросы пользователя вместе c энкодером PS3.

А если промпта нет и top-down-selection невозможен, можно подключить bottom-up-selection: попросить нейросеть самостоятельно выбрать интересные области. «Интересность» при этом определяется данными, на которых обучалась модель.

Архитектура PS3 изображена на схеме. На входе — предобученный SigLIP. Энкодим им изображение и получаем low-res-фичи. Из-за ресайза теряются все высокоуровневые фичи. Авторы предлагают исправить это с помощью дополнительного так называемого light-weight-high-res-энкодера (обучаемая урезанная CNN). Третьей фичой будет либо эмбеддинг текста, чтобы выбрать интересный образ, либо обучаемый эмбеддинг, который заменит промпт. По этой тройке для каждой позиции предсказывается вероятность её релевантности: вырезают топ-K областей и энкодят через SigLIP (несколько раз в разных разрешениях).

Итоговые фичи картинки — исходные low-res и вырезанные топ-K областей. Чтобы подключить PS3 к VLM, понадобится LLM: достаточно передать последний токен из запроса к ней в PS3. Отобрав топ выученных с энкодом позиционных эмбеддов, можно переходить к тренировке language modeling.

Для эффективного обучения VLM вместе с PS3 нужно дотюнить выбор региона, чтобы подмена не ощущалась. А дальше можно тренировать модель как обычно.

Модель, которая получилась после подключения PS3 к мультимодальной LLM, авторы назвали VILA-HD. По их замерам, она значительно превосходит по качеству AnyRes и S2, используя при этом в 4,3 раза меньше токенов.

Разбор подготовил ❣ Егор Шестопалов

CV Time
2 043 просмотров · 24 реакций Открыть в Telegram · Открыть пост на сайте
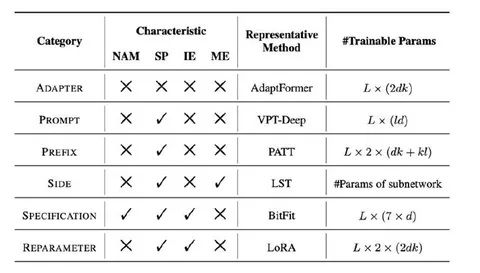
Seedream 3.0 Technical Report

Сегодняшняя статья — описание модели Seedream 3.0, которая генерирует изображения по текстовым запросам. Был момент, когда по замерам Artificial Analysis Arena она обогнала все существующие модели, сейчас — топ-2 модель, уступающая только OpenAI. Правда, с нестатзначимой разницей.
Кажется, что создатели третьей версии Seedream проделали огромную техническую работу и потратили очень много человекочасов, разрабатывая свои модели. Статья вышла всего лишь через месяц после Seedream 2.0, так что её можно воспринимать как набор доработок к прошлой модели, уже неплохо показавшей себя.

Обучая Seedream 3.0, авторы уделили много внимания специфике китайского языка — у многих моделей-конкурентов проблемы с рисованием иероглифов. В частности, обучающие датасеты Seedream обогатили набором объектов китайской культуры. Ещё одна интересная деталь: после первой стадии обучения на изображениях размером 256 пикселей, модель обучается уже на целом диапазоне разрешений — от 512 до 2048 пикселей. А чтобы выкидывать из обучающего датасета меньше картинок с дефектами и вотермарками, авторы просто маскируют в лоссе проблемные области.

В статье упоминается, что авторы обучили собственный VAE, но деталей, к сожалению, нет. Диффузионный трансформер принимает на вход картинку и закодированный текст, но токены для них обрабатываются отдельными MLP. Собственная разработка авторов — расширение 2D RoPE, которое они назвали Scaling RoPE, позволяет генерировать изображения с размером, отличным от того, на чём обучали модель. Стабильность обучения обеспечивает QK-Norm.

Текстовый энкодер дофайнтьюнили из LLM, тренируя её на парах текст-изображение. Так LLM лучше мэтчится с доменом картинок. Закодированные текстовые энкодеры она передаёт в диффузионный трансформер.

Тексты, которые нужно зарендерить на картинке, обрабатывает ByT5 — модель работает на уровне Unicode. Не делит тексты на токены по несколько символов, а кодирует их как последовательность кодов Unicode, чтобы генерировать текст было проще.

Кроме того, в Seedream 3.0 авторы использовали новую парадигму ускорения. Используя разнообразные техники, такие как квантование, консистентное зашумление и семплирование временных шагов с ранжированием по важности, они достигли существенного ускорения при сохранении качества изображения. А встроенный вывод изображений в высоком разрешении (до 2K), делает новую модель ещё более удобной и практичной.

Разбор подготовил ❣ Артём Конев
CV Time
1 967 просмотров · 19 реакций Открыть в Telegram · Открыть пост на сайте