BitDance: Scaling Autoregressive Generative Models with Binary Tokens [3/3]

Завершаем разбор статьи BitDance об авторегрессионной генерации изображений. В первом посте мы обсудили бинарный VQ-VAE с качеством реконструкций, сопоставимым с непрерывными VAE. Во втором — замену линейной классификационной головы авторегрессионного бэкбона на диффузию, что одновременно снижает рост числа параметров и улучшает качество генерации. Сегодня поговорим об экспериментах.

Авторы исследовали, на что влияет размер кодбука бинарного автоэнкодера — подтвердили его корреляцию с качеством реконструкций и проверили взаимосвязь с качеством генеративной модели. Результат оказался неоднозначным: рост словаря улучшает генерацию только при одновременном увеличении размера трансформера. При этом для крупных моделей выигрыш по FID/IS минимален.

Для text-to-image в качестве базовой авторегрессионной модели авторы выбрали Qwen3-14B. Её дообучили на генерацию изображений с помощью 32-канального бинарного токенизатора с 16-кратным пространственным сжатием и генерацией патчами 4×4 токенов.

Обучение включает привычные стадии: претрейн, CT на высоких разрешениях, SFT и дистилляцию. Интересен размер претрейн-датасета — всего 256 млн изображений, что значительно меньше индустриальных стандартов на миллиарды семплов. Зато на файнтюне объём данных резко возрастает за счёт синтетических изображений, сгенерированных SoTA-моделями. Авторы делают ставку на качество данных и отдельно подчёркивают пользу mixed-resolution обучения уже на этапе претрейна.

Под дистилляцией в BitDance понимается переобучение SFT-модели на параллельную генерацию блоков 8×8 токенов, что ускоряет инференс без заметной потери качества.

На t2i-бенчмарках BitDance занимает лидирующие позиции среди AR-моделей и конкурирует с лучшими диффузионками. Любопытно, что для достижения такого качества потребовалось заметно меньше данных, хотя по сути за SFT происходит дистилляция SeedDream и Z-Image.

В финале статьи авторы проводят три аблейшена. Они показывают превосходство своего VAE над непрерывными аналогами, демонстрируют преобладание диффузионной головы над методом Infinity и подтверждают, что наилучшее качество достигается при генерации патчами, а не по отдельным токенам или всей картинки сразу.

Качество генерации у BitDance действительно высокое, однако архитектура остаётся гибридной и использует диффузию внутри. Полностью авторегрессионной генерации визуальных токенов здесь нет, а значит, нет и бесшовной интеграции с текстовой модальностью. Из известных решений ближе всего к этой цели пока остаётся модель GLM Image.

Познакомиться с BitDance поближе можно на GitHub авторов.

Разбор подготовил ❣ Валерий Старцев
CV Time
1 641 просмотров · 23 реакций Открыть в Telegram · Открыть пост на сайте
Как мы научили модель понимать структуру архивных записей

В Поиске по архивам появилась новая модель, которая не только распознаёт текст, но и извлекает связи между людьми — например, определяет, кто в документе отец, мать, жених, невеста, свидетель и прочее. Это умение очень важно, чтобы действительно помогать пользователям находить родственников.

Дарья Виноградова, руководитель команды универсального применения компьютерного зрения в Яндексе, и Анна Сидорова, главный разработчик распознавания архивов, рассказали на Хабре, почему универсальные VLM-модели не подошли для этой задачи и как удалось перейти от распознавания текста к извлечению структуры и смысла из документов.

Как было раньше

Прошлая версия системы представляла собой классический OCR-пайплайн. Детектор находил на скане строки, OCR-модель распознавала их по отдельности, а другая модель собирала в текстовые блоки.

Поиск работал в основном по текстовым совпадениям. Из-за этого вместе с нужными данными в выдачу попадали имена священников, номера записей, служебные пометки и другие нерелевантные части документа. Со временем проблемы стали чаще возникать на уровне структуры документа — из-за разбиения текста на строки и последующей склейки.

Как модель научили понимать структуру документов

В новой версии OCR остаётся отдельным этапом, но сам пайплайн строится уже вокруг структуры документа.

По сути, перед нами стояла KIE-задача (Key Information Extraction) — нужно было по изображению документа извлекать ключевую информацию о людях и их ролях. Но довольно быстро стало понятно, что работать со страницей целиком не получится. Типичный архивный скан имеет размер больше 2500 пикселей по стороне, содержит сразу несколько записей, а суммарно в них может упоминаться до 35 человек. Такой объём информации слишком большой и для модели, и для обучения. Поэтому мы решили сначала находить на странице отдельные записи — о рождении, браке или смерти — а уже потом извлекать информацию о людях из каждой выделенной области.


Для этого используют дообученную VLM‑модель Alice AI. Она получает изображение записи вместе с текстом от OCR и извлекает из документа структуру и связи между людьми. Ключевая метрика — доля людей, которых затем можно корректно найти по ФИО в сервисе. По ней модель достигает качества 90,5% на всех типах архивных записей.

Как усовершенствовали OCR

Параллельно команда перешла от строкового OCR к блочному. Так удалось убрать целый этап сборки строк в блоки, сократить количество моделей в пайплайне и уменьшить объём дополнительного процессинга при обработке сканов.

Однако переход к блочной архитектуре сильно усложнил требования к детектору. Если раньше ошибка означала, что какие-то строки просто плохо склеятся, то теперь модель рисковала целиком потерять нужный фрагмент документа.

При этом сами блоки оказались очень разными по размеру: модель могла получить как маленький кусок с одним словом, так и огромный фрагмент на много строк. Из-за этого команде пришлось отдельно дорабатывать энкодер и оптимизировать токенизацию — иначе обработка больших блоков становилась слишком дорогой по вычислениям.

После перехода на новый OCR-пайплайн recall распознавания вырос до 93,2% на основной выборке и до 88,1% — на сложной.

Детали реализации и сложные кейсы распознавания вы найдёте в полной версии статьи.

ML Underhood
1 458 просмотров · 26 реакций Открыть в Telegram · Открыть пост на сайте
Делимся интересным рассказом об эволюции Поиска по архивам — от классического OCR-пайплайна к системе, которая умеет извлекать структуру документов и понимать связи между людьми.

В посте кратко рассказываем, как команда проекта решала KIE-задачу, зачем понадобилась VLM-модель поверх OCR и почему пришлось перейти от строкового распознавания к блочному⬇️
1 202 просмотров · 14 реакций Открыть в Telegram · Открыть пост на сайте
BitDance: Scaling Autoregressive Generative Models with Binary Tokens [2/3]

Продолжаем разбирать работу ByteDance на тему авторегрессионной генерации изображений. В первой части рассказали, как авторы пытались увеличить размер кодбука и боролись с «коллапсом» с помощью lookup-free-квантизации.

Однако полечив одно, неизбежно столкнулись с другой проблемой: в авторегрессионных языковых моделях для предсказания очередного токена используют линейную классификационную голову, выходная размерность которой равна размеру словаря токенизатора. Чтобы применить такой способ к генерации картиночного токена, где размер кодбука VQ-VAE равен 2^D, нужно хранить в памяти матрицу размера h x 2^D, где h — размерность скрытого слоя трансформерного бэкбона. Для сколь-нибудь больших D и h порядка 10^3 это будет приводить к OOM.

Можно попробовать предположить независимость каждого из D каналов бинарного токена, как было сделано в Infinity — одной из прошлых работ ByteDance по авторегрессионной генерации. Это снизит рост матрицы головы с экспоненциального до линейного: теперь нам потребуется матрица размера h x 2D. Однако при таком предположении качество картиночной генерации заметно падает.

Именно в этом месте исследователям на помощь приходит диффузия. Для предсказания D-мерного бинарного токена (он же — вершина D-мерного куба) предлагают выучить отображение распределения гауссовского шума в вершины D-мерного куба при условии эмбеддинга z, для которого мы и предсказываем бинарный токен. Дизайн денойзера в статье особо не обсуждается и не проверяется: берут «небольшой» трансформер и обучают его по замшумлённому токену x_t, времени t и эмбеддингу z предсказывать x. Причём диффузионный лосс считают во flow-matching-формате, то есть предсказание сети перепараметризовывается в предсказание скорости. После финального шага диффузии от предсказания берётся знак. По сравнению с диффузией на стандартных VAE-латентах, значения которых никак не ограничены, такая жёсткая схема помогает избежать накопления ошибки, которое происходит как в самой диффузии, так и в итеративном авторегрессионном процессе, а также приводит к более быстрой сходимости обучения.

Наконец, авторы пытаются выжать максимум из предсказания картиночных токенов, переходя от потокенной генерации к параллельной генерации патчей из PxP токенов. Во-первых, это ускоряет процесс: предсказывать диффузией сразу целый патч оказывается эффективнее, чем генерировать токены по одному. Во-вторых, это лучше соответствует локальной структуре изображения. Во время генерации патча эмбеддингов LLM-бэкбон использует bidirectional-маску в аттеншне-механизме, тогда как для текстовых токенов остается каузальная. Это положительно влияет на качество генерации.

Так авторегрессия сохраняется на уровне патчей, а внутри патча используется диффузионная генерация.

В экспериментах авторы показывают, что увеличение размера кодбука действительно улучшает реконструкцию. При этом наши тесты показывают, что метрики не совсем честно отражают визуальное качество. Хотя по сравнению с другими дискретными токенизаторами реконструкции выглядят неплохо, особенно на высоких разрешениях.

В последней части разбора посмотрим на результаты масштабирования архитектуры в t2i-сетапе генерации и обсудим аблейшены, проведённые авторами.

Разбор подготовил ❣ Валерий Старцев
CV Time
1 438 просмотров · 14 реакций Открыть в Telegram · Открыть пост на сайте
BitDance: Scaling Autoregressive Generative Models with Binary Tokens [1/3]

Сегодня разбираем статью на тему авторегрессионной генерации изображений. Исследования в этой области интересны с точки зрения практики: было бы здорово иметь мультимодальную модель на базе LLM, которая могла бы одновременно понимать тексты с картинками и генерировать семплы обеих модальностей.

За последний год ресерчеры из ByteDance подходили к этой задаче с разных сторон. В этот раз они попытались разработать produciton-scale t2i-модель, которая бы продуцировала картинки тем же образом, что и текст, а именно — авторегрессионно. Такой единообразный подход максимально удобен как во время обучения, так и на инференсе. Попробуем разобраться в особенностях модели BitDance и понять, действительно ли предложенная архитектура подходит для мультимодальной генерации.

Сначала в статье перечисляют проблемы AR-подходов в t2i-генерации, и основной называют дизайн картиночного токенизатора. В распространённых в сообществе VQ-VAE типа Cosmos картинки дискретизируются в кодбук на десятки тысяч токенов. Для изображений с их непрерывной структурой этого мало, поэтому реконструкция получается плохая.

Логично попробовать увеличить размер кодбука. Но при стандартном обучении возникает проблема codebook collapse: модель из-за особенностей оптимизационного процесса за время тренировки обучается использовать лишь небольшую часть токенов.

Побороть неприятный оптимизационный эффект помогает приём lookup-free-квантизации, предложенный в MAGVIT-v2. Вместо обучаемого кодбука используют неявный бинарный: каждый «пиксель» непрерывного выхода энкодера VAE просто поканально отображается в свой знак. Таким образом каждая spatial-координата латента может быть закодирована бинарным вектором размера D, где D — число каналов латента, то есть размерность кодбука становится равной 2^D. За счёт увеличения числа каналов D потенциально можно «раздувать» кодбук до огромных размеров и предположительно решить проблему качества реконструкций.

Однако при подсчёте энтропийного лосса на обучении VQ-VAE для элемента х приходится вычислять попарные расстояния с каждым элементом кодбука, что с ростом D делает такое обучение вычислительно невозможным. В решении этой проблемы авторы ссылаются на метод из своей прошлой статьи WeTok. Предлагается разбить каналы полученного латента на К непересекающихся групп, считать кросс-энтропийный лосс в рамках каждой группы независимо и затем суммировать.

В конце концов, этот набор трюков для обучения VQ-VAE позволяет масштабировать размеры кодбука вплоть до 2^256. И это положительно отражается на метриках реконструкций: для некторых вариантов бинарного токенизатора предложенной архитектруы получается добиться качества реконструкций по метрикам, сравнимого с непрерывным SDXL-VAE.

Но тут появляется другая проблема, о которой мы расскажем во второй части разбора.

Разбор подготовил ❣ Валерий Старцев
CV Time
1 536 просмотров · 20 реакций Открыть в Telegram · Открыть пост на сайте
SAM 3: Segment Anything with Concepts

Сегодня разберём статью, посвященную сегментации изображений по промптам. Кроме самого подхода к сегментации, авторы описывают сбор данных и добавление фичей, который не было в SAM 2.

Главные преимущества новой модели:
- задачи сегментации и детекции решаются сильно ближе к нашим ожиданиям,
- более сложные маски стали заметно точнее.

Дальше подробнее о том, какие задачи имеются в виду.

1) Promptable Visual Segmentation (PVS). Промпт бывает нескольких видов:

- Геометрический — когда вы даёте точку на картинке и говорите: «Сегментируй объект в этой точке». Позволяет в интерактивном режиме точно и красиво определять маски. Другой вид геометрического промпта — бокс с указанием: «Вот тут какой-то объект, сегментируй его».

- Текстовый — например: «Сегментируй кошку на картинке».

- Визуальный — подаётся запрос: «Вот тебе картинка, обведи кошку», и модель должна выделить всех кошек на изображении. То есть можно передать ей сколько угодно изображений и получить сегментационную маску по этим референсам. В SAM 3 на эту задачу обращают особое внимание.

2) Promptable Concept Segmentation (PСS). Тут предлагают задавать более сложные запросы. Такие концепты в работе называют short noun phrase. Пишут, что PCS позволяет визуальным агентам лучше понимать изображение.

Всего этого авторы добиваются при помощи хитрых изменений SAM 2. Основные из них — введение concept detector (DETR-based) и object presence head, отвечающего за присутствие объекта на картинке.

Для обработки визуальных запросов берут картиночный энкодер, хорошо заалайненный с текстовым. Если в промпте есть картинка с боксом, её эмбедят при помощи этого энкодера (exemplar encoder). Для обработки текстов считаются text features. Все входы передаются в трансформер, а потом — в pixel decoder, который выдаёт маски, как в MaskFormer.

Самое интересное — presence token. Это отдельный обучаемый токен, который отвечает за то, есть ли объект на картинке. Дальше по DETR-логике: есть queries, из них декодируются маски с аттеншном на мультимодальные фичи, но их score дополнительно умножается на score presence token. И если объекта нет, то и score у всех масок становится близким к нулю, и они отбрасываются.

Как обычно, в такой задаче очень многое зависит от данных.

Авторы собирают пайплайн, в котором есть media pool (много картинок) и ontology (граф концептов из Wikipedia). Для каждой картинки добавляют концепты.

Сначала берут SAM 2 и open-world-детекторы, вроде OWL или YOLO-World. Этому пайплайну скармливают немного картинок, просят задетектить и затем найти все объекты. Так получают первый набор для датасета — несколько миллионов семплов. Дальше его рефайнят руками.

Затем берут media pool с концептами и обогащают извлечённые концепты. Предсказывают маски и отдают их разметчикам (людям и моделям). Если что-то не так, люди корректируют маски, причём обычно управляя изменениями при помощи SAM 2 (в качестве промпта используя точки). И снова тот же цикл: шаг обучения, шаг пересборки и обогащения.

AI-верифаеры решают две задачи:
- Mask Verification — корректна ли маска;
- Exhaustivity Verification — все ли объекты по промпту найдены.

Это важно, потому что VLM используется в дискриминативном режиме, то есть она просто говорит «ок / не ок». Также в процессе VLM дообучают на ответах людей-разметчиков.

Видео добавляют только на финальном этапе, после того как обучили несколько версий SAM и нормальный верификатор.

В итоге такой пайплайн ускоряет сбор датасета примерно в два раза.

На LVIS — стандартном бенчмарке по детекции — качество выросло почти на 10%, что очень много.

На H200 GPU модель выдает 30 миллисекунд, при небольшом размере: где-то 1–1,5 млрд параметров. Кажется, что для модели такого размера можно было бы взять L40, но кто мы такие, чтобы мешать выпендриваться?

Статья интересна тем, что в ней сочетается множество трюков из разных областей компьютерного зрения: от DETR-архитектур до VLM. Каждый, кто занимался детекцией и сегментацией, найдёт для себя что-то любопытное.

Разбор подготовил ❣ Илларион Дмитриев
CV Time
2 520 просмотров · 29 реакций Открыть в Telegram · Открыть пост на сайте
Neural Optimal Transport

Сегодня разбираем статью, авторы которой предлагают учить отображение между распределениями с помощью нейросетей. Основная задача, которая тут решается, — перевод изображений из одного домена в другой. Причём как в детерминированном варианте (один к одному), так и в стохастическом (один ко многим).

Сначала немного предыстории. У нас есть два распределения, и хочется перетащить одно в другое с минимальным костом. Кост — это метрика, измеряющая среднее расстояние между объектом из исходного распределения и целевого. Он может быть как сильным, то есть измеряющим расстояние между двумя объектами, так и слабым, где расстояние берётся между исходным объектом х и распределением объектов отображения, которое он собой задаёт. Слабый кост — это по сути параметрический интеграл, а не обычная функция. Он берёт на вход не две переменные, а переменную и вероятностную меру — поэтому работать с ним довольно тяжело. В классических подходах кост используется именно сильный.

Классическая формулировка Монжа предлагает детерминированное отображение, где каждому х соответствует один у. Но это плохо работает, когда нужно отображать один объект в несколько возможных, ведь распределения могут быть разной структуры. Канторович в 1958 году предложил вместо отображения брать совместное распределение π. Но за это платим сложностью: всё становится сильно тяжелее и менее удобным для обучения.

Авторы идут дальше. Вместо того чтобы напрямую работать с этим распределением π и условным распределением p(y|x), которое появляется при переходе от сильного коста к слабому, они предлагают параметризовать отображение x шумом: берём x и случайную переменную z, и уже функция T(x, z) выдаёт результат, лежащий в целевом распределении. За счёт этого условное распределение получается само собой: для одного x можно получать разные y просто благодаря разному z.

Чтобы это оптимизировать, переходят к двойственной задаче. Появляется функция f — её можно воспринимать как вспомогательную. В итоге всё сводится к двум объектам: есть T, которое отвечает за транспорт; есть f, которое участвует в оценке качества этого транспорта. Остаётся задать T и f как нейросетевые функции и приступить к оптимизации.

В итоге приходим к задаче min-max оптимизации, чем-то схожей с GAN: одна нейросеть максимизирует полученный функционал, другая минимизирует. По f делается градиентный подъём, по T — спуск. Но по смыслу это не совсем генератор и дискриминатор в привычном виде — здесь это просто способ решить двойственную задачу. Все интегралы просто оцениваются через Монте-Карло без доптрюков.

На практике это даёт гибкость. Авторы предлагают параметр для функции коста, отвечающий за дисперсию шума: если его занулить, в ходе оптимизации получаем детерминированное отображение — один x всегда переходит в один и тот же y. Если его увеличивать, появляется разнообразие, и можно получать разные варианты для одного входа, при этом чем больше будет этот параметр, тем хаотичнее будет распределение. При этом вся постановка остаётся в рамках одной схемы с двумя сетями.

В экспериментах стандартные примеры с переводом изображений сравниваются с GAN-подходами. Картинки выглядят адекватно, метрики тоже улучшаются, а сама модель получается компактнее по количеству компонентов.

Разбор подготовил ❣ Иван Папай
CV Time
1 499 просмотров · 17 реакций Открыть в Telegram · Открыть пост на сайте
ICLR — всё, но мы продолжаем

У нас ещё остались обзоры интересных постеров. Сегодня расскажем о двух моделях: одна — на тему агентного визуального поиска, другая — о поиске изменённых областей в изображениях и видео.

Mini-o3: Scaling Up Reasoning Patterns and Interaction Turns for Visual Search

Модель для сложного визуального поиска, которая действует как агент: делает много шагов, приближает нужные области, проверяет гипотезы, ошибается, возвращается и продолжает поиск.

Авторы создали датасет Visual Probe с тысячами сложных задач, собрали обучающие траектории с разными паттернами рассуждений — depth-first search, trial-and-error, удержание цели — и вводят over-turn masking, чтобы во время RL не штрафовать модель за слишком длинные незавершённые попытки. В результате Mini-o3, даже обучаясь максимум на шести шагах, на инференсе умеет масштабироваться до десятков шагов, и точность растёт с увеличением числа шагов.

RelayFormer: A Unified Local-Global Attention Framework for Scalable Image and Video Manipulation Localization

RelayFormer — модель для поиска изменённых областей в изображениях и видео. Идея в том, чтобы не сжимать картинку целиком и не терять мелкие forensic-артефакты, а разрезать её на небольшие перекрывающиеся фрагменты (overlapping sub-images) и обрабатывать их в исходном качестве. Каждый кусок обрабатывается отдельно, но между ними есть специальные GLR-токены — своего рода relay-посредники, которые собирают локальные признаки, обмениваются глобальным контекстом и возвращают его обратно. После этого mask decoder строит маску изменённых пикселей.

Интересное заметила ❣ Варвара Фурик

#YaICLR26

CV Time
1 813 просмотров · 13 реакций Открыть в Telegram · Открыть пост на сайте
ECHO: Constantly Improving Image Models Need Constantly Improving Benchmarks

Авторы из Беркли презентуют бенчмарк ECHO для генерации и редактирования изображений. Главная цель — сблизить академическую и индустриальную разработку новых генеративных моделей.

Наиболее известные бенчмарки в этой области (ImgEdit, GEdit, GenEval) имеют достаточно простые промпты и отражают сценарии использования моделей, которые на самом деле не интересны пользователям.

Основная причина в том, что академические группы, предлагающие бенчмарки, составляют наборы семплов, исходя из своих априорных соображений о том, какие навыки генерации и редактирования важны.

Авторы ECHO провели большую работу по сбору реальных сценариев использования моделей, опубликованных в соцсетях. Они собрали, очистили и систематизировали десятки тысяч запросов и ответов в открытые и проприетарные модели, чтобы получить аналитический датасет размером 30 тысяч семплов и бенчмарк размером 1,5 тысячи семплов.

После сбора семплов важно определиться с метриками, которые будут замеряться. Для этого авторы пошли тем же путём: с помощью лингвистического анализа выделили основные критерии качества, обсуждавшиеся пользователями в контексте использования моделей. Так, например, среди метрик появился цветовой сдвиг — характерная черта генераций GPT-Image, которая также в разной степени присутствует и у некоторых других моделей. В работе предлагаются и более традиционные критерии оценки, например, сохранение черт исходного изображения.

Интересно было узнать у автора о его направлении исследований. Работу презентовал лид проекта — человек, искренне верящий в то, что науку двигают датасеты и бенчмарки, с чем трудно не согласиться. Его стремление сделать системный подход к замерам и разобраться в том, чего именно мы хотим от моделей нового поколения, внушает искреннее уважение. Будем ждать его новую статью о замерах качества генерации длинных видео на ближайшей NeurIPS.


Расспросил авторов ❣ Сергей Кастрюлин

#YaICLR26

CV Time
1 947 просмотров · 23 реакций Открыть в Telegram · Открыть пост на сайте
TwinFlow: Realizing One-step Generation on Large Models with Self-adversarial Flows

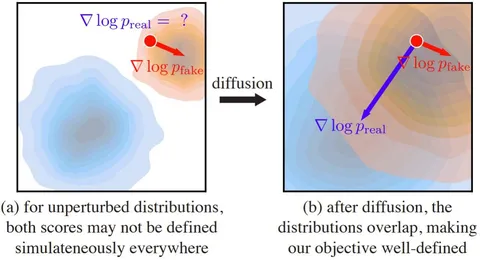
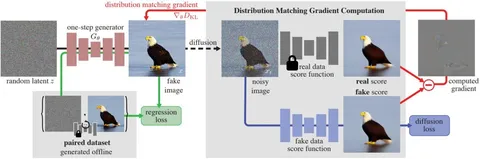
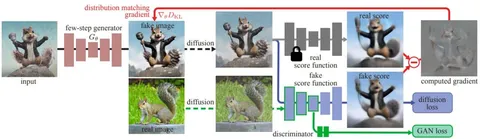
Авторы презентуют метод пошаговой дистилляции диффузионных моделей, который работает без вспомогательных моделей, в отличие от общепринятых техник вроде consistency models, ADD и DMD2.

Конкретно предлагают отразить временную ось относительно нуля — в результате диффузионный процесс происходит на интервале [-1, 1]. Причём участку [-1, 0] соответствует путь из шума в данные, сгенерированные самой моделью — «фейковые данные».

Задача модели в процессе оптимизации — минимизировать разницу между скоростями для «фейковых» (при отрицательных временах) и реальных (при положительных временах) данных. В точке оптимума обе скорости совпадают.

Итоговый лосс — сумма функции потерь из RCGM (некоторого обобщения MeanFlow для многошаговой генерации) и матчинга распределений для «фейковых» и реальных данных.

Полученный метод достигает хорошего качества почти без просадки по сравнению с базовой Qwen-Image и на одном уровне с Qwen-Image-Lightning. При этом сам фреймворк проще, и ожидается, что он меньше просаживает разнообразие.

Интересное заметил ❣ Денис Кузнеделев

#YaICLR26

CV Time
1 684 просмотров · 22 реакций Открыть в Telegram · Открыть пост на сайте
Latent Diffusion Model without Variational Autoencoder

Многие знают о RAE — хайпанувшем недавно методе, суть которого в обучении латентной диффузии на латентах семантического энкодера (например, DINO) вместо VAE. Эта работа — параллельная попытка сделать примерно то же самое, но с некоторыми отличиями. Например, авторы предлагают схему end-to-end-обучения, которая частично решает основную проблему RAE: большее количество структурных артефактов и дефектов генерации.

Было интересно узнать у автора, что группа продолжает работать над этим направлением и планирует выпустить работу в модной нынче теме пиксельной диффузии, только теперь уже используя DINO-фичи для регуляризации латентного пространства. Это, в свою очередь, напоминает REPA.

В целом, область как будто сходится к тому, что семантическую информацию для генерации использовать нужно, но простой и элегантный способ её утилизации ещё предстоит придумать.

Расспросил авторов ❣ Сергей Кастрюлин

#YaICLR26

CV Time
1 778 просмотров · 27 реакций Открыть в Telegram · Открыть пост на сайте
Первые статьи с ICLR 2026

О том, как стартовала конференция, рассказали в канале @MLunderhood. А прямо сейчас исследователь Yandex Research Сергей Кастрюлин делится работой об адаптивном гайдансе без использования классификатора в диффузионках.

Dynamic Classifier-Free Diffusion Guidance via Online Feedback

После обучения диффузионной модели стандартный шаг её подготовки к использованию — это подбор параметров инференса. Например, подбор CFG scale и паттерна распределения CFG в случае с динамическим гайденсом.

Авторы из Google DeepMind предлагают метод для более эффективной настройки параметров инференса. Вместо beam search или ещё более дорогого полного перебора предлагается дообучить версии классификаторов качества (например, CLIP score) для работы с зашумлёнными латентами — и с помощью них динамически выбирать параметры сэмплирования прямо в процессе инференса.

Основной посыл в том, что один раз получить файньюны классификаторов дешевле, чем делать перебор параметров инференса, особенно если делать такое несколько раз.


И в заключение лайфхак, подсмотренный на постерной сессии:

Если научный руководитель просит не оформлять постер в стиле Барби (фото 2), знайте — он ничего не понимает в дизайне, народу зайдёт (фото 3).


#YaICLR26

CV Time
2 100 просмотров · 35 реакций Открыть в Telegram · Открыть пост на сайте
Beyond Language Modeling: An Exploration of Multimodal Pretraining

Разбираем статью Meta*, среди авторов которой указаны небезызвестные Yann LeCun и Saining Xie. В работе не предлагают конкретный трюк, а разбираются в дизайне мультимодального претрейна в целом и смотрят на влияние выбора архитектуры, латентного пространства, данных и масштабирования размера модели и объёма обучающей выборки.

Авторы говорят, что если мы хотим мультимодальные модели для текста, генерации изображений и даже world modeling, нужно перестать смотреть на вижн как на вспомогательный сигнал и начать обучать всё вместе с нуля.

Архитектура

В качестве бейзлайна берут Transfusion. Для языка используется next-token prediction, а для вижна — flow matching. Текст моделируется авторегрессионно через кросс-энтропию, а визуальная часть — как предсказание зашумлённого латента. Всё это учится на смеси языковых и визуальных данных.

При этом сама модель — decoder-only Transformer, который учится с нуля, без инициализации от готовой LLM. В отличие от Transfusion, вместо U-Net для проекций в визуальной модальности применяют более простые линейные проекции. Делают вывод, что лучше использовать modality-specific FFN вместо shared. Аттеншн остаётся общим, а FFN для текста и вижна — разделяются, что даёт выигрыш по text perplexity, image generation и VQA.

По визуальным представлениям сравнивают SD-VAE, FLUX.1, семантические энкодеры вроде SigLIP 2 So400M, DINOv2-L, WebSSL-L и сырые пиксели. Лучший вариант — RAE, причём особенно хорош SigLIP 2. Делают вывод, что один RAE-based encoder может одновременно хорошо работать и для visual understanding, и для генерации, не портя текстовые метрики.

Данные

Авторы взяли большой текстовый корпус DCLM, сырые видео из YouTube и публичных видео-датасетов, пар «изображение-текст» из MetaCLIP и Shutterstock, а также обусловенные на действие траектории навигации. Замечают, что мультимодальные данные не конкурируют с текстовыми. Если добавить видео, текстовая перплексия почти не портится, а местами даже становится лучше. Хуже с image-caption-данными — у кэпшенов другое распределение относительно текста из DCLM.

При этом сами пары «изображение-текст» критичны для понимания и генерации картинок. Без них ничего толком не работает. Если при фиксированном бюджете визуальных токенов добавлять больше текста, то улучшается и diffusion loss, и GenEval. Для VQA полезнее широкий претрейн, чем масштабирование узких данных. Даже если задача узкая, лучше иметь более широкий претрейн, чем просто ещё больше того же самого доменного датасета.

Эксперименты

Есть раздел о Navigation World Model. World modeling возникает скорее из общего мультимодального претрейна, а не из обучения только на navigation-данных. Особенно помогают сырые видео. При этом для хороших world-modeling-способностей доменных navigation-данных нужно совсем немного: если есть хорошая общая мультимодальная инициализация, дальше всё быстро выходит на плато.

Отдельно исследуют MoE. Переходят от простого modality-specific FFN к Mixture-of-Experts. MoE работает лучше, чем вручную заданные схемы разделения, и естественным образом учит специализацию. Чем выше гранулярность экспертов (отношение общего размера эмбеддинга модели к размеру одного эксперта), тем лучше качество, но примерно после значения в 16 всё выходит на плато.

При фиксированном бюджете активных вычислений увеличение общего числа экспертов тоже помогает, и для RAE это особенно заметно. Кроме того, полезно иметь общих (всегда активных) экспертов, причем лучше всего — отдельного общего под каждую модальность.

В конце авторы собирают всё вместе. Оптимальная конфигурация выглядит как MoE + modality-specific FFN + SigLIP 2 / RAE + x-prediction. Она даёт лучший баланс по перплексии, качеству генерации изображений и VQA.

Разбор подготовил ❣ Денис Кузнеделев
CV Time
___
Компания Meta признана экстремистской; её деятельность в России запрещена.
1 652 просмотров · 28 реакций Открыть в Telegram · Открыть пост на сайте
Enabling Disaggregated Multi-Stage MLLM Inference via GPU-Internal Scheduling and Resource Sharing

Сегодня разбираем статью, о том, как ускорить мультимодальный инференс, особенно когда на вход подаётся длинное видео.

Проблема складывается из нескольких факторов. MLLM становятся всё популярнее, мы хотим обрабатывать текст, картинки, видео, — но сервинг таких моделей очень дорогой. Нужно одновременно хорошо утилизировать GPU и быстро отдавать пользователю ответ. А с видео всё становится ещё хуже — препроцессинг долгий, особенно для длинных роликов. В итоге страдают TTFT (time to first token) и TBT (time between tokens).

Если в обычных LLM у нас есть prefill и decode, то в MLLM добавляются ещё две тяжёлые стадии до генерации:

- decoding видео и изображений,
- vision encoding (ViT / SigLip).

Отсюда две ключевые проблемы.

1) Видеодекодирование сильно увеличивает TTFT. CPU-декодинг плохо масштабируется, а GPU-декодеры обычно оптимизированы под throughput, а не под latency одного запроса, нам важно чтобы пользователь быстро получил ответ на свой запрос.

2) Vision encoder. Это отдельная compute-heavy-стадия, которая конкурирует за GPU с decode-частью и из-за этого увеличивается TBT. Просто вставить её в обычный пайплайн нельзя, так как начинаются конфликты за ресурсы.

В статье авторы по очереди решают эти проблемы.

FlashCodec

Главная идея — распараллелить одно видео на несколько GPU, а не просто обрабатывать разные видео параллельно. Видео хранится не как набор независимых кадров, а как compressed bitstream, разбитый на GOPs (Group of Pictures). Внутри такой группы кадры зависят друг от друга, но сами они между собой независимы.

Отсюда решение FlashCodec: видео делим на GOPs, распределяем их по GPU, внутри группы картинок декодируем последовательно, а между ними получаем параллелизм.

Дополнительно вводят stall-free scheduling — видео больше не рассматривается как одна задача. Планирование идёт на уровне GOP, и как только NVDEC освобождается, ему сразу отдаётся следующий GOP.

Ещё важный момент — память. В обычных системах при асинхронном декодировании память под кадры резервируют заранее, из-за чего легко можно упереться в OOM. Здесь же запрос принимают, ставят в очередь, декодируют и только после декодинга на ранке аллоцируют GPU-память под результат.

В итоге FlashCodec ускоряет обработку длинного видео и снижает TTFT.

UnifiedServe

Вторая проблема — конкуренция encode/prefill и decode за GPU. Тут есть два стандартных подхода.

1) Monolithic, когда все GPU в находятся одном runtime. Утилизация высокая, но encode начинает мешать decode, из-за этого растёт TBT.

2) Split, когда GPU жёстко делятся между encode/prefill и decode. Decode защищён, но ухудшается утилизация и появляются дополнительные оверхэды, например KV-cache transfer.

Авторы объединяют лучшее из подходов в UnifiedServe. Пайплайн бьют на три независимых воркера — preprocessing, encode/prefill и decode — связывают их через буферы и передают данные не целиком, а чанками. Каждый воркер забирает их по мере готовности. Можно удобно передавать информацию при асинхронной работе.

Но остаётся конкуренция за GPU, поэтому добавляют оркестрацию: encode и prefill получают ограниченный «бюджет токенов» и не могут занять весь компьют, за счёт чего decode остаётся изолированным и при этом сохраняется общий пул GPU. Так одновременно улучшаются TTFT, TBT и утилизация.

На экспериментах решения выигрывают по latency и throughput по сравнению с существующими.

Разбор подготовил ❣ Андрей Теплов
CV Time
1 477 просмотров · 30 реакций Открыть в Telegram · Открыть пост на сайте
VIBE: Visual Instruction Based Editor [1/2]

Сегодня приступим к разбору статьи об эдитинг-модели от коллег из Сбера. Вторая часть уже опубликована в канале @c_research, который ведёт Сергей Кастрюлин из Yandex Research.

Ключевая цель авторов — сделать небольшую и эффективную модель, которая будет быстро инфериться, дёшево учиться и решать задачу instruction-based image editing. То есть выполнять только указанное в инструкции действие (например, добавить шарф), не делая ничего лишнего (не меняя цвет лица, фон и так далее).

Модель выложена в опенсорс. Она быстрая и при этом действительно компактная, поскольку основана на эффективных базовых блоках — Qwen3-VL-2B-Instruct в качестве текстово-картиночного энкодера и Sana-1.5-1.6B в качестве диффузионного генератора.

Что касается качества генерации, мы провели внутренние замеры, по которым VIBE показала качество примерно на уровне опенсорсной Bagel.

Архитектура

Самое интересное в статье — это внутреннее устройство и обучение системы. Архитектура состоит из двух блоков:

- небольшой энкодер — Qwen3-VL на 2 миллиарда параметров;
- базовая диффузионка — Sana 1.5 на 1,6 миллиарда параметров.

Напомним, что Sana 1.5 — это работа Nvidia начала прошлого года, где авторы пытаются максимально дёшево обучить быструю диффузионку разумного качества. Нам она запомнилась стратегией переиспользования ранее обученной Sana 1 и тем, как реализован inference-time compute scaling. Авторы генерируют очень много изображений (до 2000 за время обычной генерации), после чего VLM выбирает лучшие — таким образом они «хакают» бенчмарки.

Как всё работает

1) VLM обрабатывает входное изображение и промпт. Это стандартная практика, но авторы отдельно подчёркивают, что считают важным выучивание связи между картинкой и промптом именно внутри VLM.

2) Отдельно для подачи в VLM обучаются MetaQueries — полезные добавки-суффиксы к исходному промпту, обогащающие входное представление без модификации весов VLM.

3) Для задачи редактирования в диффузионку важно как-то подать текстовый кондишен. В работе рассматриваются два способа.

Первый — трансформерный: изображение разбивается на патчи, получаются картиночные эмбеддинги, которые конкатенируются с текстовыми и подаются одной последовательностью.

Второй — более классический: поканальная конкатенация. Кондишен-картинка конкатенируется с шумом, из которого генерируется изображение. После этого всё подаётся в свёрточный слой увеличенной размерности.

С одной стороны, авторы пишут, что вариант с единой последовательностью работает лучше. Такой вывод не вызывает удивление, поскольку возможность одинаково обрабатывать картинки и тексты на входе — очень полезная фишка трансформерных моделей. Но в финальной системе авторы используют именно конкатенацию, потому что она не увеличивает длину последовательности и экономит время инференса.

То есть, имея диффузионный трансформер, авторы всё равно делают поканальную конкатенацию со свёрткой, а затем работают с патч-эмбеддингами свёрточных представлений. Это решение — довольно нестандартное.

Во второй части разобрали, как устроено обучение модели, зачем используются Meta Queries и какие данные применяются для тренировки.

Разбор подготовил ❣ Сергей Кастрюлин
CV Time
1 788 просмотров · 23 реакций Открыть в Telegram · Открыть пост на сайте
Xray-Visual Models: Scaling Vision models on Industry Scale Data

Сегодня разбираем статью, название которой может запутать — посвящена она не медицине, а новой vision-модели Meta*. Работа представляет собой не цельную историю, а набор экспериментов, местами слабо связанных между собой. Но зато даёт практический взгляд на то, как реально собирается большая модель.

Начинают авторы с данных. Основной источник — их собственные сервисы (Facebook*, Instagram*). Используются пользовательские изображения и всё, что к ним прилагается: хэштеги, эмоджи, тексты. Очевидная проблема такого источника — сильный перекос распределения. Популярные концепты встречаются намного чаще редких, и модель начинает переобучаться на них. Поэтому данные отдельно выравнивают по концептам и получают заметный прирост качества. Дополнительно фильтруют датасет через CLIP-подобную модель по порогу схожести.

Модель обучается не только на картинках, но и на видео. Теги пользователей приводят к каноническому виду и отображают в фиксированный набор классов (десятки тысяч концептов WordNet). Причём учитывают не только объекты, но и действия. Сэмплинг подбирают так, чтобы за одну эпоху полностью проходить и картиночный датасет, и видеодатасет. Оба имеют внушительные размеры: более 15 млрд изображений и 10 млрд видео.

Текстовые описания к изображениям генерируют своей моделью, но качество не идеальное — есть повторы, шум. Поэтому их просто переписывают с помощью Llama, что даёт небольшой, но стабильный выигрыш. К своим данным авторы добавляют данные с изображениями из интернета, собранными в рамках работы MetaCLIP.

Архитектурно модель представляет собой стандартный трансформер, адаптированный под видео с 3D-сверткой на входе. Любопытный момент: авторы активно выкидывают ненужные токены по аттеншну (ссылаются на статью EViT), и это экономит вычисления без существенной потери качества.

Обучение разбито на три стадии: сначала masked image modeling, затем классификация по тегам, и только потом CLIP-постановка. На финальном этапе добавляют self-supervised-компонент (SLIP), притягиваются разные аугментации одного изображения или кадры из одного видео.

Также в статье описано много мелких «бантиков»: регуляризация эмбедов через добавление шума и восстановление, Gaussian blur как аугментация, переход на Lion вместо AdamW. Каждый из них даёт доли процента — но таких улучшений много.

Интересен текстовый энкодер. Вместо классического BERT берут LLM и модифицируют её под задачу retrieval: переходят на full attention вместо казуального и дообучают на задачу предсказания близости текстов. Этот подход позволяет перенимать сильные стороны языковых моделей, такие как учет деталей и возможность работы с длинными текстами.

Результаты на академических бенчмарках выглядят хорошо: на уровне или выше SigLIP и DINO при более быстром инференсе, хотя сравнения местами не идеально выровнены. В продакшне прирост существенно больше — авторы отмечают, что стандартные бенчмарки не всегда информативны.

Есть и неожиданные наблюдения. Attention pooling и rotary embeddings не помогли. Сжатие эмбеддингов в предложенном авторами виде сильно портит качество (~4%), но ради скорости поиска они идут на это. Авторы отмечают, что их пайплайн не оптимален, если использовать эмбеды для поиска дубликатов: в таком случае лучше убрать тексты из обучения и использовать self-supervised-постановку.

В конце упоминается ещё один трюк — представление изображений через семантические ID, что уже ближе к рекомендательным системам.

В итоге можно сказать, что эта статья — о масштабировании данных и множестве маленьких инженерных улучшений, каждое из которых даёт небольшой прирост, а в сумме позволяет получить SotA-результат.

Разбор подготовил ❣ Артём Конев
CV Time
___
Компания Meta, владеющая Facebook и Instagram, признана экстремистской; её деятельность в России запрещена.
1 399 просмотров · 26 реакций Открыть в Telegram · Открыть пост на сайте
EMMA: Efficient Multimodal Understanding, Generation, and Editing with a Unified Architecture

Сегодня разбираем статью Huawei под названием EMMA. Это мультимодальная модель, которая одной архитектурой пытается решать задачи понимания изображений, генерации и редактирования. То есть объединяет image-to-text, text-to-image и image-to-image.

На вход подаются тексты и изображения. Картинки проходят через два энкодера.

Первый — это DCAE (Deep Compression Autoencoder). Он используется в генеративной ветке и сильно сжимает изображение.

Второй — SigLIP2 (конкретно SigLIP2-so400m), используется для семантического высокоуровневого представления изображений.

Важно, что оба энкодера дают одинаковый уровень сжатия х32. За счёт этого они могут объединять признаки не по токенам, а по каналам, не увеличивая длину последовательности.

После SigLIP2 применяют pixel shuffle, чтобы дополнительно уменьшить число токенов, а после DCAE — адаптер (MLP), чтобы привести размерности.

Для задачи понимания добавляют интересный механизм — mixture-of-experts в энкодере. Есть два эксперта: универсальный (versatile) и специализированный под STEM-задачи (графики, математика и прочее). Отдельный роутер решает, какому эксперту отправлять изображение. Если это STEM-домены – идём к специализированному, остальное — к универсальному.

Причём STEM-эксперт инициализируется из обычного и дообучается только на финальной стадии и только на соответствующих данных.

Архитектура включает две ветки:
- Und (understanding) – для понимания,
- Gen (generation) – для генерации.

На ранних слоях параметры QK-матриц шарятся, а потом ветки становятся полностью независимыми.

При этом взаимодействие между ветками происходит через глобальный self-attention.

Модель инициализируется из Qwen3-4B.

По лоссам всё стандартно: для понимания используют next-token prediction, для генерации — flow matching с velocity prediction.

В качестве данных используют смесь трёх типов:
- I2T (image-to-text) — для анализа изображений,
- T2I (text-to-image) — для генерации,
- IT2I (image editing) — для редактирования.

Глобально данные — комбинация открытых датасетов, внутренних данных и синтетики. Последняя активно используется для генерации и редактирования. Датасет GPT-Image-Edit-1.5M авторы исключили, сославшись на то, что он ухудшает subject consistency.

Обучение состоит из шести стадий:

1. Alignment — обучается только адаптер анализа изображений (Und), энкодеры заморожены.
2. Pre-training — обучаются всё, кроме DCAE.
3. Supervised fine-tuning — добавляются более качественные данные, плюс подключается editing.
4. Quality tuning (QT) — дообучение на отфильтрованных данных высокого качества.
5. STEM expert tuning (ET) — обучается только STEM-эксперт.
6. Router tuning (RT) — отдельно дообучается роутер.

На задачах стандартных VLM-бенчмарков модель примерно на уровне Qwen3-VL. Есть просадка на MMMU и рост на MathVista, вероятно, за счёт STEM-эксперта. НаGenEval модель демонстрирует более высокий prompt following, чем у Qwen-Image.

Пара интересных наблюдений.

- Модель умеет работать с китайскими инструкциями в генерации и редактировании, даже без T2I-данных на китайском — вероятно, это эффект knowledge transfer из I2T-данных.
- Хотя editing обучался на одношаговых инструкциях, модель обобщается на многошаговые инструкции (типа «замени очки, поменяй одежду, измени фон»).
В целом довольно аккуратная попытка собрать unified multimodal-модель.

Разбор подготовил ❣ Сергей Овчаренко
CV Time
1 776 просмотров · 32 реакций Открыть в Telegram · Открыть пост на сайте
Z-Image: An Efficient Image Generation Foundation Model with Single-Stream Diffusion Transformer [3/3]

Продолжаем разбирать большую статью о новой генеративной модели Z-Image. В первой части поговорили о пайплайне подготовки данных, во второй — о тонкостях обучения. А сегодня обсудим архитектуру модели и её обучение.

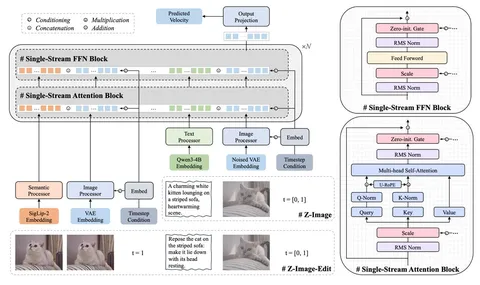
Авторы используют два картиночных энкодера: SigLIP2 и Flux-VAE и один текстовый — Qwen3-4B. Трансформер мультимодальный, диффузионный, Single-Stream. 3D-RoPE стандартное, не такое хитрое, как в Qwen Image.

Рассмотреть архитектуру модели во всех подробностях можно на схеме. Она довольно стандартная: состоит из Attention- и FFN-блоков c Gate и Scale. В кондишн из Scale-/ Gate-слоёв прокидывается только время.

На вход в диффузионную модель как обычно поступают латентны и эмбеддинги промпта. Эмбеддинги конкатенируются вдоль длины последовательности. В editing-режиме на вход также попадают эмбеддинги исходных изображений, полученные из двух картиночных энкодеров, — они также конкатенируются со всем остальным. То есть, на вход Z-Image подаётся вся информация, которая есть в запросе.

Говоря об обучении, хочется отметить несколько интересных особенностей. Претрейн начинается с text-to-image на изображениях низкого разрешения — 256х256. Так модель учат в общих чертах понимать, как устроены картинки. Авторы утверждают, что на эту стадию уходит почти половина времени: скорее всего, именно это сделало маленькую модель такой эффективной.

Далее следует omni-часть предобучения: к исходному датасету добавляют изображения произвольного разрешения, editing-данные и различные виды caption’ов.

После этого — SFT-стадия, где авторы стараются сбалансировать концепты. В процессе обучения для каждого из концептов фиксируется статистика его появлений в батчах. Веса картинок, представляющих разные концепты, перевзвешиваются при сборе следующего батча. Так модель изучает концепты более равномерно.

Для стабилизации модели ей устраивают несколько SFT-стадий, во время каждой из которых перебалансируют концепты в датасетах. Потом веса полученных моделей усредняют.

Потом модель дистиллируют при помощи модифицированного DMD, который авторы называют decoupled DMD. От оригинального он отличается тем, что стадии CFG-Augmentation и Distribution matching’а разделяют и оптимизируют отдельно.

В конце модель дообучают при помощи DPO и GRPO для максимального соответствия человеческим ожиданиям.

Проверенные решения в нетипичных комбинациях позволяют Z-Image показывать хорошие результаты при небольших затратах вычислительных мощностей. Познакомиться с моделью поближе можно на GitHub или HuggingFace.

Разбор подготовил ❣ Илларион Дмитриев
CV Time
1 741 просмотров · 18 реакций Открыть в Telegram · Открыть пост на сайте
Z-Image: An Efficient Image Generation Foundation Model with Single-Stream Diffusion Transformer [2/3]

Продолжаем разбирать большую статью о новой генеративной модели Z-Image. В первой части серии поговорили об инфраструктуре для обработки данных, а сегодня обсудим ошибки модели.

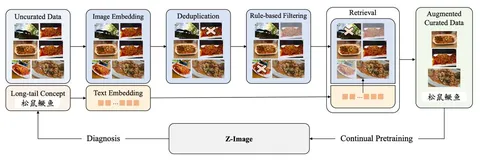
Во время обучения Z-Image авторы статьи столкнулись с тем, что модель некорректно выучивает сложные концепты. В качестве примера (первая схема) они приводят выражение 松鼠鳜鱼 — название блюда китайской кухни «рыба-белка»: когда модель пытается сгенерировать изображение рыбы-белки, она может решить что ей нужно нарисовать 松鼠(рыбу) и 鳜鱼(белку).

Чтобы бороться с такими случаями, авторы используют сложную систему курирования данных с vector engine и деревом концептов. После того как граф концептов подтверждает, что рыб-белок в датасете не хватает, надо найти хорошие примеры и показать их модели. Для этого в части датасета — например, той, что соответствует концепту «китайская еда», — ищут наиболее подходящие изображения с помощью vector engine и добавляют их в текущий батч обучения. А потом регулярно повторяют эту операцию во время обучения.

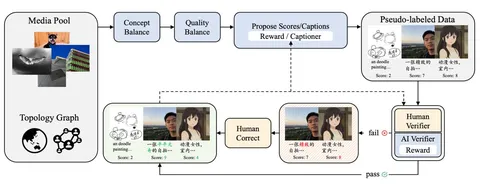
Подробнее рассмотреть общий алгоритм обогащения датасетов можно на второй схеме:

1. Из всего датасета выделяют подмножество изображений, соответствующих непредставленным концептам.
2. При помощи VLM модели присваивают им caption’ы.
3. Люди и VLM оценивают качество полученных семплов.
4. Отвергнутые семплы с некорректными подписями к картинкам правят люди.
5. VLM дообучается на результатах такой разметки на каждой крупной стадии обучения модели. После каждой итерации дообучения доля картинок, оцениваемых VLM, растёт. Условно, если на первой стадии модель проверяла всего 20% семплов, на последней — уже 50%.

Комбинация обоих описанных механизмов постепенно улучшает датасет.

Кроме классической text-to-image-задачи, авторы также обучают модель редактировать изображения. Чтобы подготовить данные для этого, используют несколько стратегий:

- Произвольно переставляют и комбинируют различные версии одного и того же входного изображения, отредактированные другими моделями: например, инпейнтинг или смена ракурса.

- Собирают пары изображений из видеокадров: берут два похожих и описывают разницу между ними в виде инструкции. Например, «перемести машину из города в деревню» для кадров с одной и той же машиной в разных локациях.

Генерируют синтетические данные с текстами — подбирают изображения, пишут на них разные тексты и генерируют инструкции вида «поменяй текст на картинке с "котик" на "собачка"».

Подробнее о том, как устроена архитектура Z-Image, расскажем в третьем посте.

Разбор подготовил ❣ Илларион Дмитриев
CV Time
1 861 просмотров · 19 реакций Открыть в Telegram · Открыть пост на сайте
Z-Image: An Efficient Image Generation Foundation Model with Single-Stream Diffusion Transformer [1/3]

Сегодня начнём разбирать большую статью о новой генеративной модели Z-Image. В первом посте серии поговорим об инфраструктуре для обработки данных, во втором — об ошибках модели, в третьем — о её архитектуре.

Z-Image знаменита двумя вещами. Она:

- небольшая по современным меркам — около 6B параметров;
- весьма эффективно обучена: для тренировки использовали всего 314К GPU-часов на H800 GPU.

Пока авторы зарелизили только text-to-image-модель, но скоро обещают выкатить editing. Текущая версия уже впечатляет: иногда она ошибается в генерации текстов на изображении, но в среднем отлично справляется с этими и другими визуальными эффектами.

Таких результатов удалось добиться благодаря продуманному обучению и хорошей подготовке данных. Для того чтобы собрать качественный датасет, хорошо покрывающий разные домены, авторы настроили пайплайн из четырёх компонент:

1. Data Profiling Engine. Базовая фильтрация по качеству изображений — отсеиваются картинки со слишком высоким уровнем шума или чрезмерным объёмом фона, с артефактами компрессии и т. д.

Эстетичность картинки оценивает отдельная модель: она создаёт дополнительный атрибут aesthetic score.

Что касается caption:

- Пары «изображение + текст» с низкой похожестью фильтрует специально дообученный CLIP. Он возвращает коэффициент того, насколько картинка соответствует тексту (по шкале от 0 до 1). Таким образом датасет очищается от самых не подходящих друг другу пар.

- Чтобы обогатить caption, генерируют три его версии: очень подробную, детальную и короткую. Все три получают с помощью простой VLM. Далее их используют для прогрессивного обучения: постепенно повышают разрешение изображений и длину caption, чтобы модель познакомилась с миром изображений, поняла, как их генерировать, и усовершенствовала свои навыки.

2. Cross-modal Vector Engine. Нестандартный механизм, который проверяет, насколько хорошо датасет покрывает всё множество реальных пар «картинка + текст».

Верхнеуровнево это работает так: пары «картинка + текст» пропускают через энкодеры, получают их векторное представление. На всём множестве векторов строят индекс — далее его используют для дедупликации пар и аналитики.

3. World Knowledge Topological Graph. Для того чтобы оценить, насколько концепты реального мира представлены в датасете, используют необычный механизм. Строят граф: вершины — концепты, рёбра — их ссылки друг на друга. От маловажных концептов избавляются алгоритмом PageRank. Оставшимся точкам присваивают теги и группируют их в иерархические деревья. Такой граф позволяет балансировать датасет во время обучения, повышая вероятность у семплов, представляющих слаборепрезентованные концепты.

4. Active Curation Engine. Люди и VLM поочерёдно проверяют датасет, пока он не окажется достаточно хорошим.

Подробнее об ошибках Z-Image и том, как она устроена, расскажем в следующих постах.

Разбор подготовил ❣ Илларион Дмитриев
CV Time
1 780 просмотров · 27 реакций Открыть в Telegram · Открыть пост на сайте
OmniAlign-V: Towards Enhanced Alignment of MLLMs with Human Preference [2/2]

В первой части разбора рассказали о ключевых проблемах алайнмента VLM и гипотезах авторов. Дальше статья сводится к сбору данных. Вопросы и ответы генерируются через проприетарные модели, в основном GPT-4o. Самое интересное — как отбирают изображения и какие срезы задач выделяют.

Авторы хотят собирать open-ended-вопросы, не подразумевающие односложный ответ. Этим пытаются перенести в мультимодальный сеттинг часть навыков, которые обычно хорошо выучиваются из text-only-данных: креативность, генеративные запросы, более развёрнутые ответы.

По типам задач выделяют два основных среза:
1) общий (знания, ризонинг, генеративные сценарии),
2) инфографика.

У каждого среза — свой пайплайн. Сначала идёт фильтрация изображений: убирают самые простые картинки, оценивают визуальную сложность и стараются оставить те, где много объектов. Для этого используют внешние модели.

Дальше генерация стандартная: few-shot + промптинг GPT-4o для вопросов и ответов. Но на некоторых задачах few-shot работает хуже — там добавляют дополнительные приёмы, чтобы сохранить разнообразие.

Отдельно описана стадия рефайнмента. QA-пары усложняют и переписывают с помощью LLM, добавляя более строгие требования к форме ответа: ограничения длины, стиль, структура.

Ещё одна стадия — фильтрация QA-пар. На некоторых срезах, например в графиках, авторы считают, что даже GPT-4o недостаточно надёжна. Тогда используют ансамбль нескольких проприетарных и опенсорсных моделей, сравнивают ответы и либо мёржат, либо фильтруют, чтобы получить более качественную финальную пару.

В итоге удалось собрать около 200 тысяч QA-пар.

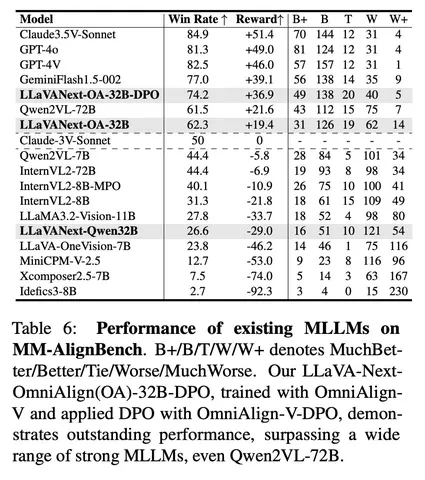
Бенчмарк MM-AlignBench

Существующие бенчмарки обычно проверяют только правильность ответа, когда есть ground truth, но не его качество в смысле human preference. Поэтому собирается отдельный небольшой бенчмарк — MM-AlignBench.

В качестве референса вспоминают попытки сделать VLM-арену, например, WildVision. И используют похожую идею оценки: сравнивают ответы моделей попарно и просят GPT-4o выступить судьёй. Получают вердикт по шкале из нескольких категорий (A лучше B, немного лучше или равны и в обратную сторону). Из этого считают win rate и reward.

Эксперименты и результаты

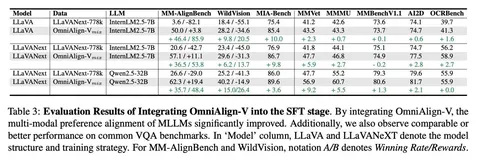
Дальше авторы проводят эксперимент на базе LLaVA-Next: заменяют часть исходных данных на свои новые данные OmniAlign-V и смотрят, что будет с метриками. На прокси-бенчмарках под human preference (WildVision и MM-AlignBench) метрики заметно растут. При этом классические мультимодальные бенчмарки не проседают критично. То есть human preference получилось улучшить, не убив привычные VLM-метрики.

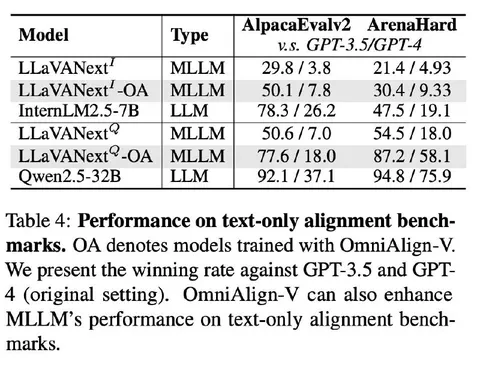
На текстовых бенчмарках деградация всё ещё остаётся, но становится меньше. Если раньше просадка была около 50 пунктов, теперь стало около 30. Это всё ещё много, но разрушение LLM-навыков VLM стало слабее.

В итоге получился неплохой бенчмарк, который отражает другие аспекты качества по сравнению с тем, что обычно замеряют в мире VLM. Причём его не просто собрали, но и вывели на лидерборд — вопрос теперь в том, будут ли остальные игроки им пользоваться. Но сам интент двигать оценку в сторону human preference выглядит интересным и полезным.

Разбор подготовил ❣ Алексей Григорьев
CV Time
1 413 просмотров · 27 реакций Открыть в Telegram · Открыть пост на сайте
OmniAlign-V: Towards Enhanced Alignment of MLLMs with Human Preference [1/2]

Сегодня разбираем статью об алайнменте VLM, которую можно воспринимать как срез главных проблем в области и их решений. В первой части поговорим об основных узких местах, которые выделяют авторы.

1) Автометрики не отражают качество алайнмента полностью. Обычно для VLM его измеряют с помощью бенчмарков, где предполагается один правильный ответ: посчитать число объектов на картинке, ответить на простой вопрос в одно слово и прочее. Такие автометрики удобно считать, и они действительно проверяют базовые навыки модели, но многие аспекты качества VLM с их помощью не оценить.

2) Для VLM долгое время не было общепринятой «арены». Если для LLM была арена, которую знали, смотрели и репортили почти все, то для VLM она появилась не так давно.

3) Мультимодальный SFT портит текстовые способности LLM. Главное утверждение авторов: именно на этой стадии LLM внутри VLM сильно деградирует. Для проверки берут исходную LLM, измеряют на текстовых бенчмарках, затем делают мультимодальный SFT и снова измеряют получившуюся модель на тех же бенчмарках. В результате метрики заметно ухудшаются. Выдвигаются две гипотезы, почему это происходит.

Первая гипотеза: в мультимодальном SFT слишком мало text-only-данных. Если добавить их, возможно, просадка уменьшится. Для проверки берут датасет LLaVA-Next SFT с 40 тысячами текстовых примеров, многие из которых старые и некачественные. Эти примеры заменяют на более качественные, а затем масштабируют долю текстовых данных.

Результат получается контринтуитивный: текстовые метрики алайнмента действительно растут, но мультимодальные метрики падают как на арене, так и для базовых навыков. Таким образом, качество текстового алайнмента плохо обобщается на мультимодальный срез.

Вторая гипотеза: сами по себе мультимодальные данные слишком простые по сравнению с тем, на чём обучают LLM. Они плохо проучивают instruction following и качество ответа в разрезе human preference. Авторы приходят к идее собирать мультимодальные данные, которые по качеству и сложности ближе к задачам алайнмента под human preference.

Во второй части разбора поговорим о том, как происходил сбор данных, подробнее рассмотрим полученный бенчмарк и результаты.

Разбор подготовил ❣ Алексей Григорьев
CV Time
1 846 просмотров · 39 реакций Открыть в Telegram · Открыть пост на сайте
DeepSeek-OCR 2: Casual Visual Flow

Сегодня разбираем статью, которая продолжает идею DeepSeek-OCR. Суть первой версии была в том, чтобы использовать глубокий энкодер на базе SAM и CLIP, а затем подавать токены в небольшой decoder-like-блок. Посмотрим, что нового предложили авторы.

Архитектура

Главное отличие от DeepSeek-OCR v1 в том, что вместо CLIP берут LLM (decoder-like-модель), а также добавляют обучаемые queries. Декодер при этом остаётся тем же.

В качестве визуального токенизатора используется SAM-base на 80M параметров. Дальше идут две свёртки, которые дают сжатие в 16 раз (каждая уменьшает размерность в два раза по каждой из осей). Сжатое представление подаётся в LLM. Токенизатор получается довольно компактным.

Авторы говорят, что теоретически можно было взять encoder-decoder-схему, как в mBART, но это плохо сходилось. И если не объединять всё в одну последовательность, не хватает взаимодействия между токенами, поэтому decoder-like-архитектура работает лучше.

Используются два режима подачи: 1024×1024 (256 токенов) у всего изображения целиком либо 768×768 для локальных кропов. Если документ небольшой, подают только целое изображение. Если документ большой, нарезают на локальные кропы и добавляют сжатое целое изображение.

Идея с обучаемыми queries

Авторы вдохновлялись двумя работами. Первая — DETR (2020) на тему детекции объектов. В ней картинку сначала прогоняют через ResNet и получают визуальные признаки, а затем делают кросс-аттеншн с набором object queries. Каждая query отвечает за потенциальный объект, и decoder-like-модель выдаёт предсказания по этим queries.

Вторая работа — BLIP-2. Это captioning-модель, в которой используется Q-former с обучаемыми queries. Они делают кросс-аттеншн к визуальным токенам из CLIP и передают уже агрегированное представление в LLM. В результате вместо сотен визуальных токенов в LLM передаётся компактное представление через queries.

Подход DeepSeek-OCR 2 во многом похож на Q-former, но здесь число query соответствует числу визуальных токенов.

LLM применяют, потому что они уже хорошо показали себя в инициализации для мультимодальных задач.

Данные

Авторы используют те же данные, что и для предыдущей версии. Чтобы модель не забывала общие визуальные представления, добавляют и обычную зрительную информациию, но распознавание текста преобладает. Распределение немного перебалансируют и делают небольшую доработку меток.

Обучение

Процесс обучения состоит из трёх стадий.

1) Encoder training: обучают только энкодер, а декодер заморожен. Смысл стадии — научить токенизатор и LLM работать как энкодер: извлекать признаки, сжимать токены и собирать представление.

2) Query enhancement: обучают энкодер и декодер вместе. Происходит донастройка их совместной работы.

3) Decoder specialization: замораживают энкодер и финально доучивают только декодер.

Результаты

Авторы замеряются на большом двуязычном (английский и китайский) бенчмарке OmniDocBench v1.5. Он содержит примерно 1400 документов разных категорий, включая журналы, академические статьи и отчёты.

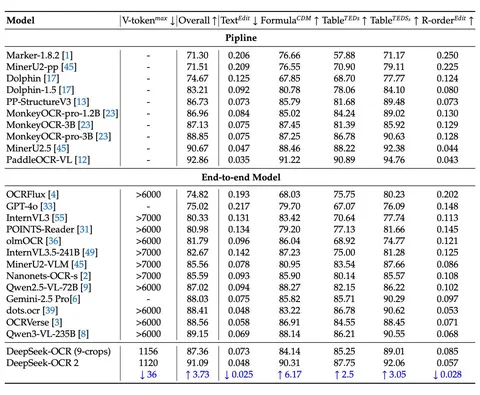
В сравнении с бейзлайнами в новой версии чуть меньше токенов, то есть модель дешевле, но при этом общее качество выросло примерно на 4%. Больше всего улучшились срезы по формулам и таблицам. Также уменьшилась метрика Edit Distance, которая показывает, насколько распознанный текст отличается от эталона в документе.

Сравнение идёт с InternVL, Miner и другими OCR-специфичными подходами. По цифрам PaddleOCR-VL всё ещё выглядит чуть лучше.

В некоторых аспектах DeepSeek-OCR v2 есть куда расти — например, в задаче распознавания текста на газетах. Объясняют это тем, что на очень насыщенных текстом документах выбранные разрешения и степень сжатия могут мешать точному распознаванию, и для улучшения, возможно, нужно обучаться на большем количестве кропов.

В итоге авторам удалось получить решение, которое быстро, недорого и с хорошим качеством обрабатывает документы. Код и модель выложены в публичный доступ.

Разбор подготовил ❣ Денис Кузнеделев
CV Time
1 575 просмотров · 28 реакций Открыть в Telegram · Открыть пост на сайте
When and why vision-language models behave like bags-of-words, and what to do about it?

Сегодня разбираем не новую, но актуальную статью об одной неприятной штуке: bags-of-words-ности CLIP. Другими словами, разберём ситуацию, когда VLM вроде бы должна понимать смысл, порядок и отношения между объектам, но на деле ведёт себя так, будто текст — просто набор слов без структуры. Авторы пытаются выяснить, когда и почему VLM начинают работать как BoW, и можно ли это исправить.

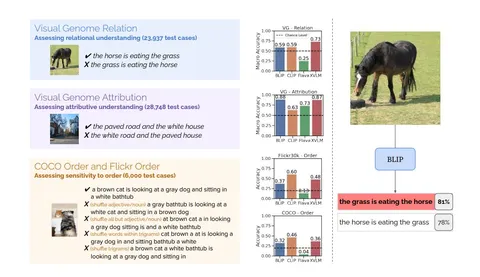
Для этих целей собрали специальный бенчмарк ARO (Attribution, Relation, and Order), который тестирует три вещи:

1) понимает ли модель отношения между объектами (“horse eats grass” vs “grass eats horse”);
2) различает ли она атрибуты (“paved road” vs “white road”);
3) чувствительна ли к порядку слов.

На примерах из Visual Genome делают простой тест: берут картинку и две подписи — правильную и с переставленными словами. Модели должны выбрать корректный вариант, но на графиках видно, что не все уверенно проходят даже порог случайного угадывания — 0,5. Например, Flava в некоторых настройках вообще чаще выбирает неправильные подписи.

Чтобы расширить тесты, добавляют данные из COCO Order и Flickr Order. Там уже не просто меняют местами два слова, а делают несколько видов искажений:
перемешивают существительные и прилагательные, перемешивают почти все слова, перемешивают слова внутри триграмм. Получается набор, где рядом стоит оригинальный текст и несколько сломанных вариантов. И снова видно, что многим моделям всё равно, в каком порядке стоят слова.

Можно ли обучить CLIP как BoW?

Дальше проверяют, что будет, если обучить CLIP так, чтобы текстовый энкодер вообще не видел порядок слов. Текст подают как bag-of-words и смотрят retrieval-метрики. Результат печальный: качество падает совсем немного. То есть модель можно обучить на беспорядочных текстах, и она всё равно будет работать почти так же. Это подтверждает идею, что CLIP-подобные модели часто не используют синтаксис и порядок, а просто ловят совпадения слов.

Эксперимент с картинками

Авторы делают похожий тест и для визуального энкодера: режут изображение на патчи 3×3 и перемешивают. Качество падает сильнее, но всё равно остаётся приемлемым. То есть даже порядок визуальных частей модели часто не критичен.

NegCLIP как решение

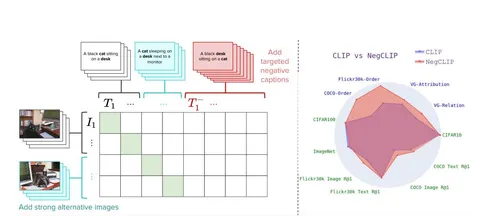
В качестве способа исправления авторы предлагают NegCLIP. Идея в том, что стандартный contrastive learning слишком легко проходит на поверхностных совпадениях, поэтому нужно добавлять более жёсткие негативы.

Вводят два типа таких негативов:

1) srong alternative images — самые похожие картинки по эмбеддингам CLIP, которые добавляются как сильные негативы;
2) targeted negative captions — подписи, где слова специально переставлены или подменены.

По итоговой диаграмме видно, что NegCLIP заметно улучшает результаты на VG-Relation, VG-Attribution, COCO-Order и Flickr-Order, то есть там, где проверяется не просто совпадение слов, а структура.

В итоге работа показывает, что многие VLM действительно ведут себя как BoW: им часто всё равно, кто кого ест и в каком порядке стоят слова. Но этот эффект можно ослабить, если в обучении использовать сложные негативные примеры, как в NegCLIP.

Разбор подготовил ❣ Фёдор Притула
CV Time
2 150 просмотров · 35 реакций Открыть в Telegram · Открыть пост на сайте
Emu3.5: Native Multimodal Models are World Learners

Сегодня разбираем работу от команды китайского Института искусственного интеллекта, которая продолжает гнуть свою линию и выкатывает очередную модель семейства Emu. На этот раз — Emu3.5. В отличие от предыдущих работ, здесь авторы прямо говорят, что пытаются построить не просто мультимодальную модель, а некую world model. Ниже разберёмся, что под этим понимают.

Сразу о путанице в названиях. Есть Emu от Meta* — text-image-модель, важная в своё время как ранний пример качественного SFT на небольших датасетах. И есть отдельная серия работ Emu от авторов этой статьи.

Например, год назад, у них была работа под названием Emu3: Next-Token Prediction is All You Need. Тогда идея была довольно простой: свести текст, картинки и видео к единой задаче next-token prediction. Генерации выглядели сочными, но при внимательном рассмотрении страдали от типичных артефактов дискретизации — текстуры «плыли», мелкие детали разваливались.

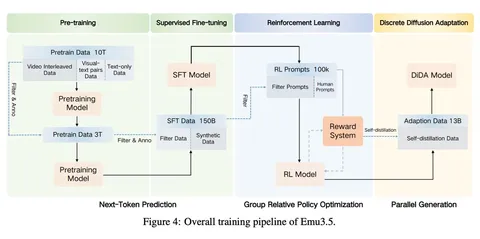
В Emu3.5 амбиции заметно выросли. Архитектурно всё по-прежнему прямолинейно: один decoder-only-трансформер на 34B параметров, обучаемый чисто авторегрессионно. Самое интересное — в данных. Вместо того чтобы опираться в основном на пары картинка-текст, модель обучают преимущественно на чередующихся (interleaved) видео-текстовых последовательностях из интернета. Видео нарезают на ключевые кадры, аудио транскрибируют с помощью ASR с таймстемпами, а затем всё это склеивают в одну длинную последовательность: в сумме — больше 10 триллионов токенов.

Так модель учится не отдельным сценам, а событиям во времени: динамике, переходам, причинно-следственным связям. Это и есть их практическое определение «world learning». Кроме видео используют обычные image-text-данные и большой объём text-only-данных.

И это ещё не финал: после претрейна модель доучивают — сначала на гигантском SFT (150 млрд сэмплов), а потом через RL-алайнмент, чтобы она вела себя адекватно и по тексту, и по картинкам.

Все модальности токенизируются в общее дискретное пространство. Словарь модели — около 280k токенов, из которых ~150k приходятся на текст, а остальная часть — на визуальные токены. Для визуальной части используется собственный токенизатор с REPA-подобной стабилизацией через SigLIP. Авторы честно признают, что дискретизация всё равно даёт артефакты, поэтому опционально добавляют диффузионный декодер поверх авторегрессионной генерации.

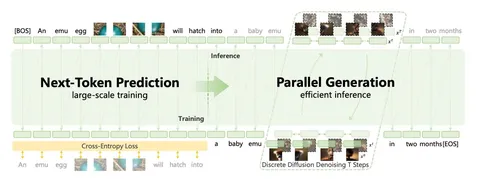
Отдельная важная часть — DiDA (Discrete Diffusion Adaptation). Так пробуют решить главную боль авторегрессии: медленную генерацию изображений. На этапе инференса модель временно переводится в режим дискретной диффузии: визуальные токены зашумляются и затем восстанавливаются за несколько итераций. За счёт этого генерация картинок ускоряется примерно в 20 раз без заметной потери качества.

На выходе Emu3.5 умеет довольно широкий спектр вещей: выдаёт длинные согласованные визуальные нарративы, генерацию историй с картинками, пошаговые визуальные инструкции и даже навигацию по сцене по текстовым командам — как будто внутри есть некоторое представление пространства. В классических задачах text-to-image и image editing модель на уровне сильных закрытых мультимодальных моделей.

В итоге, даже если с громким термином world model можно поспорить, сама траектория развития Emu выглядит любопытно — продолжим следить за ними.

Разбор подготовил ❣ Сергей Кастрюлин
CV Time
___
Компания Meta признана экстремистской; её деятельность в России запрещена.
1 785 просмотров · 33 реакций Открыть в Telegram · Открыть пост на сайте
Qwen3-VL-Embedding and Qwen3-VL-Reranker: A Unified Framework for State-of-the-Art Multimodal Retrieval and Ranking [2/2]

Продолжаем разбирать техрепорт, описывающий новые модели Qwen.

Обучение моделей и результаты

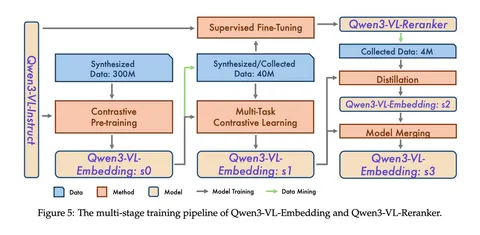
Обучение моделей делается в несколько этапов, причём довольно нетривиальным образом: модели с этапа X используются для последующей фильтрации данных для этапа X+1, а Embedding и Reranker на разных этапах выступают учителями друг для друга.

— На всех этапах модели обучаются как LoRA к Qwen3-VL, чтобы с большей вероятностью не испортить возможности сильного бэкбона.

— На первом этапе (s0) на всём датасете обучается Embedding, используя контрастивный InfoNCE-лосс.

— На следующем этапе Embedding:s0 используется для фильтрации датасета — и на этом фильтре обучается Embedder:s1 и Reranker.

— На последнем этапе снова фильтруется уже Reranker, и скоры Reranker используются как таргет для дистилляции Embedding:s2.

— Наконец, веса полученной модели усредняются (точнее, сферически интерполируются) с Embedding:s1, порождая финальную модель Embedding:s3, которая и пошла в релиз.

По замерам авторов, их модели опережают все существующие открытые и закрытые модели на мультимодальных бенчмарках. При этом на текстовых задачах есть и более сильные модели — в основном существенно большего размера.

Использование моделей

Авторы явно постарались сделать модели production-ready, позаботившись не только о качестве метрик, но и об удобстве использования.

Во-первых, в модель заложены несколько очень важных свойств для производительности (помимо инференса в один prefill-этап).

Тренировка проводилась в quantization-aware-режиме — при вычислении лоссов для эмбеддингов, авторы одновременно вычисляли их для квантизованных в int8-эмбеддингов. В результате, полученные эмбеддинги можно квантизовать в int8 (отмасштабировать в интервал [-127, 128] и округлить), хранить и использовать практически потери качества.

Также в тренировке эмбеддингов использовался подход матрёшки, при котором лоссы применяются не только к эмбеддингам целиком, но и по частям к их первым 32, 64, 128, 256 и 512 элементам. Благодаря этому каждый кратный степени двойки «подсрез» эмбеддинга — тоже эмбеддинг (хоть и худшего качества). При работе с большой базой документов можно, например, брать только первые 128 элементов эмбеддинга вместо 1024 и хранить только их. Суммарно можно сократить размер эмбеддингов базы документов в 10–50 раз.

Во-вторых, в силу архитектуры модель очень гибка в применении. И документ, и запрос могут быть не только одним изображением или текстом, но и их произвольной последовательностью. Довольно большое окно контекста (32К) токенов позволяет обрабатывать 10–20 страниц изображений вместе с текстом.

Также интересная фича таких моделей как класса — наличие инструкции. Мультимодальные семантические эмбеддинги доступны всем и каждому как минимум с момента релиза CLIP (5 лет назад!), но способ вычисления эмбеддинга почти всегда был «зашит» в модель. Для эмбеддеров на основе LLM/VLM можно в инструкции указать, что важно в «кодировании» документов и запросов. Например, в случае поиска по картинкам можно инструктировать модель фокусироваться на стиле изображения или, наоборот, на содержимом — и получить эмбеддинги, поиск по которым будет давать разные результаты.

В итоге у авторов получилась гибкая и эффективная опенсорсная модель для мультимодального поиска. В отчёте приведено много деталей обучения, а в cookbook — примеров использования. Модели такого класса определённо имеют множество применений как в продуктах, так и в рутинных ML-задачах по работе с данными.

Разбор подготовил ❣ Борис Зимка
CV Time
2 243 просмотров · 40 реакций Открыть в Telegram · Открыть пост на сайте
Qwen3-VL-Embedding and Qwen3-VL-Reranker: A Unified Framework for State-of-the-Art Multimodal Retrieval and Ranking [1/2]

Ещё летом 2025-го вышли текстовые Qwen3-Embedding/Reranker. А в январе этого года команда Qwen представила новые модели: Qwen3-VL-Embedding и Qwen3-VL-Reranker. В техрепорте авторы рассказывают, как им удалось адаптировать VLM для решения задач мультимодального поиска и ранжирования — ключевых тем ML с долгой историей развития и огромным количеством применений. Об этом сегодня и поговорим.

Формулировка задачи

Если кратко, задача поиска по базе документов — по запросу Q среди множества документов D[i] найти подходящие под запрос. В текстовом поиске Q и D — текст, а в мультимодальном варианте — Q и D могут быть картинками, текстом или их комбинацией, причём модальности Q и D могут не совпадать. Например, по запросу «пингвины в Южной Америке» релевантны и статьи Википедии, и соответствующие фотографии.

Модели

Один из распространённых подходов в решении задачи поиска — разбиение на два этапа: быстрый поиск кандидатов и более сложное ранжирование их между собой для определения лучших. Исходя из такой схемы, команда Qwen подготовила две модели:

1. Qwen3-VL-Embedding: модель, предсказывающая для документа или запроса вектор признаков в соответствии с инструкцией. Можно считать, `def embedding(instruction: str, query_or_doc: str | Image) -> list[float]`.

2. Qwen3-VL-Reranker: модель, оценивающая согласно инструкции степень соответствия запроса документу от 0 до 1. Интерфейс примерно: `def reranker(instruction: str, query: str | Image, document: str | Image) -> float`.

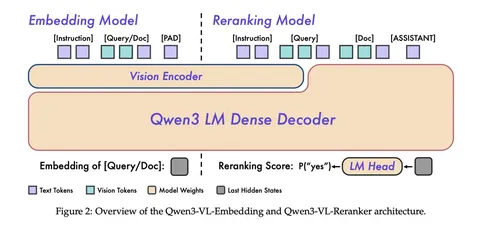
Архитектурно модели — почти точные копии VLM: получают на вход токенизированные инструкции и текст, патчи изображений, но имеют модифицированный выход, и инференсятся несколько иначе.

Reranker выполняет инференс всей VLM целиком, но на выходе в качестве оценки «релевантен ли документ запросу» берётся соотношение вероятностей токенов “yes” и “no”. Embedding выполняет инференс до последнего слоя (проекции токена в вероятности вокабуляра) — и hidden state перед этой проекцией возвращается как эмбеддинг.

В отличие от полноценных VLM, в Embedding и Reranker выполняется только этап prefill (обработка входного контекста), и состояние последнего токена промпта возвращается как ответ. Стадия decoding (предсказания одного токена за другим) отсутствует, что делает инференс многократно быстрее.

Обе модели инициализируются Qwen3-VL и доступны в двух вариантах: на 2 и 8 миллиардов параметров.

Данные

Датасеты для поиска повторяют логику задачи:
— одна текстовая инструкция к задаче I;
— база мультимодальных документов D[i];
— набор мультимодальных запросов Q[j];
— матрица меток R[i, j], определяющих D[i] как релевантный или нерелевантный Q[j].

На таком датасете можно обучать как Reranker (напрямую классифицировать релевантность пары Q-D), так и Embedding (оценивая релевантность пары по скалярному произведению эмбеддингов).

Обучающий корпус Embedding и Reranker состоит из множества таких датасетов. Для каждого из них база документов берётся из реальных данных — эти документы VLM описывает и классифицирует. Некачественные фильтруются, распределение датасетов нормализуется, чтобы избежать сильного перекоса в какой-либо домен.

Затем для документов с помощью VLM генерируют запросы разных типов, причём как релевантные документу, так и hard-negative-примеры — запросы, для которых документ похож на релевантный, но не является таковым.

После этого датасеты дополнительно фильтруются уже существующими моделями и неудачные элементы датасета отсеиваются.

Во второй части разбора поговорим о том, как модели учились, и об их использовании на практике.

Разбор подготовил ❣ Борис Зимка
CV Time
2 117 просмотров · 29 реакций Открыть в Telegram · Открыть пост на сайте
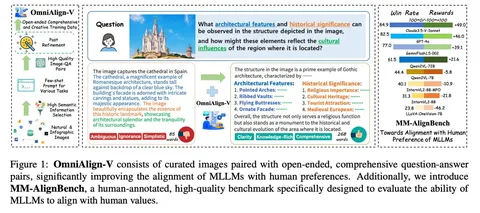
Ovis-U1 Technical Report

Некоторое время назад мы обсуждали MLLM. Сегодня разберём статью о ещё одной универсальной модели, способной обрабатывать и текст, и изображения.

Ovis-U1 — модель-швейцарский-нож. В зависимости от инструкции, она может работать и в режиме image-to-text, и в text-to-image. Например, можно изменить изображение, описать его или сгенерировать совсем новую картинку по текстовому запросу. Архитектуру MLLM можно рассмотреть на первой из трёх схем.

Следите за логикой сверху вниз:

1. Сначала Ovis-U1 обрабатывает входные данные: токенизирует текст и обрабатывает изображения визуальным энкодером, чтобы составить семантический эмбеддинг, или использует VAE-энкодер для составления детализированного представления.

2. Полученная последовательность подаётся в трансформер, инициализируемый с Qwen3-1.7B.

3. Для генерации изображения выходные токены текстов и семантических представлений входной картинки комбинируются с помощью пары трансформерных слоев (авторы называют это Refiner’ом, на схеме обозначено как (с)) и, вместе с VAE-эмбеддингами, отправляются в «визуальный декодер» на базе MMDiT. Эта часть инициализируется с нуля.

Обучение модели происходит в несколько этапов:

— Сначала предобучается визуальный декодер на задачу text-to-image-генерации. Все остальные части при этом заморожены.
— Следом предобучается адаптер между LLM и визуальным энкодером на задачи text-to-image-генерации, а также понимание и редактирование изображений.
— Потом на тех же данных визуальный энкодер и адаптер обучаются вместе.
— На следующей стадии всё, кроме визуального декодера, обучается на задачах понимания изображения.
— Далее на задаче генерации изображений обучается refiner и визуальный декодер.
— На финальном этапе визуальный декодер файнтюнится для задач text-to-image-генерации и редактирования изображений.

Авторы утверждают, что визуальный декодер на основе диффузии в сочетании с Refiner’ом позволяет генерировать изображения почти так же хорошо, как GPT-4o. Интересны ещё несколько замеров:

— 69,6 баллов в мультимодальном академическом тесте OpenCompass (что лучше последних современных моделей, такие как Ristretto-3B и SAIL-VL-1.5-2B);
— 83,72 балла и 0,89 балла при преобразовании текста в изображение в тестах DPG-Bench и GenEval;
— 4,00 и 6,42 для редактирования изображений в ImgEdit-Bench и GEdit-Bench-EN.

Разбор подготовил ❣ Сергей Овчаренко
CV Time
1 846 просмотров · 21 реакций Открыть в Telegram · Открыть пост на сайте
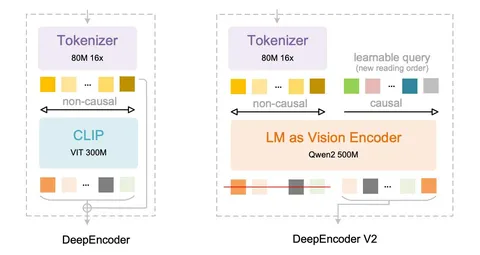
Decoupled DMD: CFG Augmentation as the Spear, Distribution Matching as the Shield

Сегодня разберём статью, авторы которой возвращаются к идее DMD и пытаются понять, что именно заставляет этот метод работать. Их главное наблюдение — главную роль в обучении играет не distribution matching, как можно было ожидать, а CFG Augmentation.

Что такое DMD

DMD относится к ODE-free-дистилляции диффузионных моделей: здесь не важно, по какой траектории происходит сэмплирование, главное — чтобы модель умела выдавать скор-функцию.

Идея метода в том, чтобы форсить совпадение распределения генератора с распределением реальных данных, оптимизируя KL-дивергенцию между P_{fake} и P_{real}. Плотность реальных данных напрямую недоступна, но для обучения достаточно градиента этого лосса. После дифференцирования в выражении появляются скор-функции реальных и фейковых данных: фейковую мы учим, а реальную аппроксимируем замороженной моделью-учителем.

Поскольку скор-модели плохо работают на незашумлённых изображениях и реальные с фейковыми распределениями часто плохо пересекаются по модам, в DMD скоры считают на зашумлённых данных. Это делает их in-distribution и стабилизирует обучение. В итоге реальный скор остаётся замороженным, а фейковый обучается стандартным diffusion loss — это база для всех модификаций DMD.

Что изменилось в DMD2

В DMD2 авторы разомкнули обучение генератора и оценщика. Сделали несколько шагов обучения оценщика на один шаг генератора, и за счёт этого отказались от регрессионного лосса. Также был добавлен GAN loss как регуляризация: используют не как основной источник сигнала, а именно для стабилизации обучения.

Основная идея Decoupled DMD

В новой статье авторы снова смотрят на градиент KL-дивергенции и замечают, что простая conditional-оценка реального скора работает плохо. Зато на практике гораздо лучше CFG-оценка. Возникает вопрос — это просто удачный трюк или за этим стоит какая-то теория?

Оказывается, если подставить CFG прямо в формулу KL-лосса, он раскладывается на две части: классический distribution matching и дополнительный член, соответствующий вектору между real conditional и real unconditional скорами. Именно эту добавку авторы называют CFG Augmentation. Из этого разложения следует ключевой вывод статьи: основной обучающий сигнал в DMD даёт CFG Augmentation, а distribution matching выступает стабилизирующей регуляризацией.

Эксперименты и выводы

Эксперименты подтверждают этот тезис. Обучение только на distribution matching быстро ломает семантику, обучение только на CFG Augmentation приводит к переобучению. Самый стабильный результат получается при совместном использовании обоих компонент лосса.

Авторы также показывают, что CFG Augmentation и distribution matching имеет смысл обучать с разными уровнями шума: больший \tau в CFG-части помогает с высокочастотными деталями, тогда как для distribution matching лучше работает стандартный диапазон шумов.

В итоге статья интересна не столько метриками, сколько самим наблюдением: CFG в DMD — это не эвристика, а осмысленный компонент лосса.

Разбор подготовил ❣ Михаил Колтаков
CV Time
1 755 просмотров · 17 реакций Открыть в Telegram · Открыть пост на сайте
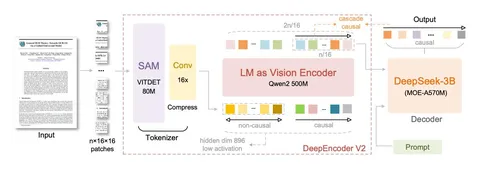
Лучшие статьи 2025 года: выбор авторов СV Time. Часть 2

Хороших статей в прошлом году оказалось слишком много, чтобы уместить их в один пост. Во второй части мы собрали не менее интересные работы, которые во многом определяют, как будет выглядеть генерация изображений и видео в 2026-м.

Why Diffusion Models Don’t Memorize: The Role of Implicit Dynamical Regularization in Training

Работа, отобранная программным комитетом NeurIPS 2025, как одна из лучших. Авторы исследуют причины, по которым диффузионные модели генерируют новые изображения, а не воспроизводят в точности обучающую выборку. Для модельных экспериментов берут датасет лиц Celeba в низком разрешении и сгенерированный случайной двухслойной сетью. Оказывается, что существуют две временные отметки: t_gen и t_mem, между которыми модель умеет создавать качественные примеры и при этом не в точности копировать данные из обучения. Причём с увеличением количества данных интервал растёт. Вывод: диффузионные модели обладают регуляризацией, которая позволяет им избегать переобучения даже при избыточной параметризации. На практике обучающие выборки очень велики и отметка t_mem недостижима.

Mean Flows for One-step Generative Modeling

Группа исследователей из CMU и MIT этой весной представила работу, где предложила способ обучения генеративных моделей — такой, чтобы они могли делать качественные генерации за один или мало шагов. В отличие от общепринятого сейчас подхода Flow Matching, моделирующего мгновенную скорость в точке, Mean Flow учится воспроизводить усредненную по участку траектории скорость, что даёт более надёжную и точную оценку пути из шума в данные. Авторам удалось достичь лучшего качества одношаговой генерации на ImageNet на момент выхода публикации. Работа получила продолжение в статьях AlphaFlow и Improved Mean Flows.

Diffusion Transformers with Representation Autoencoders

Как известно, сейчас в генерации картинок и видео доминирует латентная диффузия: учат VAE, чтобы перевести картинки в более низкоразмерное пространство, и потом — диффузионную модель уже в этом пространстве. Авторы предложили вместо VAE взять сотовый картиночный энкодер (Dino, Siglip), доучить к нему декодер и обучать диффузию в пространстве фичей этого энкодера. Показывают, что диффузия, обученная в этом пространстве, сильно улучшает качество генерации. Вероятно, это будет одно из самых популярных направлений ресёрча на ближайшие полгода-год, как было с REPA.

Back to Basics: Let Denoising Generative Models Denoise

Исторически диффузионные модели чаще всего обучают предсказывать либо шум, который накладывается на картинку, либо разницу между шумом и чистой картинкой. В работе отмечают, что картинки в высоком разрешении, несмотря на большую размерность, лежат в сильно более низкоразмерном пространстве, и поэтому нейронке гораздо проще предсказывать чистую картинку, чем нечто с шумом, который захватывает всё пространство. Исходя из этого, авторы предлагают простейшую диффузионную модель — JiT (Just Image Transformer), которая работает напрямую в пиксель-спейсе (без VAE) и параметризована на предсказание чистой картинки. По архитектуре это обычный ViT с минимальными диффузионными спецификами. Показывают, что такая простая модель отлично работает на больших разрешениях, не требует дополнительных наворотов и внешних моделей. При этом по компьюту они даже эффективнее, чем латетные модели с VAE.
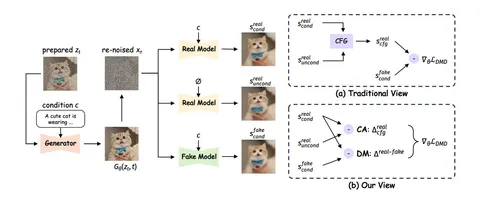
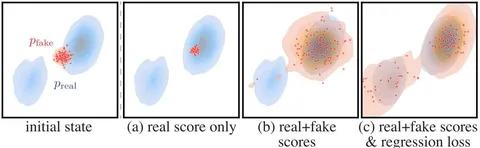
The Principles of Diffusion Models

Классный учебник по диффузионным моделям от их «создателя» Стефано Эрмона. В книге куча пояснений, интуиции и обсуждений, которые помогают получить полную картину о том, что мы сейчас знаем про диффузию. Покрыты почти все ключевые темы — от самой базы и до последних малошаговых моделей, а-ля MeanFlow. Будет крайне полезным для тех, кто хочет глубоко разобраться с диффузией.

Статьи отобрали ❣ Дмитрий Баранчук и Денис Кузнеделев
CV Time
2 122 просмотров · 23 реакций Открыть в Telegram · Открыть пост на сайте