Интересное с ECCV 2024

29 сентября в Милане стартовала конференция ECCV 2024, которая собрала ведущих специалистов в области компьютерного зрения — в том числе, и от Яндекса. Мы не могли обойти такое громкое событие стороной, и будем освещать его с самых разных сторон. Но прежде всего расскажем о самых интересных докладах первого дня мероприятия. К делу!

Synthetic to Authentic: Transferring Realism to 3D Face Renderings for Boosting Face Recognition

Авторы предлагают «механизм реалистичности», который позволяет сократить доменный сдвиг между реальными и синтетическими изображения людей. В итоге — более высокие результаты на исходной задаче по сравнению с обучением на синтетике и без преобразований. На некоторых бенчмарках использование такого механизма сравнимо даже с обучением на реальных данных.

DPA-Net: Structured 3D Abstraction from Sparse Views via Differentiable Primitive Assembly

Современные text-to-3D и image-to-3D-модели не очень хорошо понимают физику — они рисуют неправильные тени и формы объектов. Исследователи предлагают разные подходы к решению этой проблемы: например, использование диффузии и технологий рендера вроде NeRF или 3D Gaussian Splatting. Автор же представленной работы утверждает, что для понимания физики требуется строить сетку с 3D моделированием (противопоставление rendering и modeling) через примитивы.

Воркшоп Knowledge as Association

Дэвид Бау из Северо-Восточного университета предполагает, что модели содержат в себе две сущности. Первая — Knowledge — отражает знания. Они находятся в весах модели. Вторая — Memory — это то, что модель может вспомнить в процессе генерации при определённых входных данных. Memory содержится в активациях.

Доклады бережно отбирали ❣ Дарья Виноградова, Александр Устюжанин и Сергей Кастрюлин.

CV Time

#YaECCV
3 730 просмотров · 18 реакций Открыть в Telegram · Открыть пост на сайте
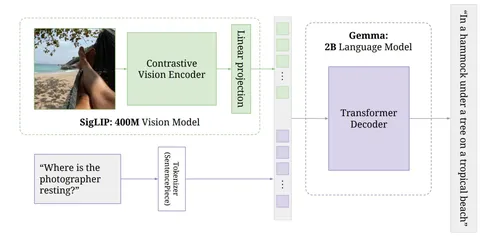
PaliGemma — открытая и производительная VLM

Сегодняшняя статья о PaliGemma. Это VLM, которая разработана на основе технологий семейства моделей PaLI и Gemma. На вход PaliGemma может получать изображения или видео как последовательность кадров.

Модель обучается в четыре этапа:

Unimodal pretraining — на этом этапе PaLI и Gemma обучаются отдельно на данных одного типа.

Multimodal pretraining — здесь вся модель обучается на большом — миллиард сэмплов — наборе мультимодальных задач, таких как объединение визуальных и текстовых данных. Здесь важно, что ни одна часть модели не остаётся «замороженной» — все её компоненты обучаются вместе.

Resolution increase — происходит дополнительное обучение на данных с более высоким разрешением изображений (448 и 896 пикселей).

Трансфер на целевые задачи вроде описания изображений для COCO, VQA для дистанционного зондирования и другие специализированные цели. Этот этап также предполагает дообучение на новых данных, чтобы модель могла решать задачи, для которых она ранее не обучалась.

Важная особенность PaiGemma — использование подхода prefix-LM. Ко всей входной последовательности — изображениям и префиксам — здесь применяется фулл (двунаправленный) аттеншн. Это сделано для того, чтобы большее количество токенов могло активно участвовать в процессе «мышления» с самого начала, так как токены изображения могут обращаться к токенам префикса, которые представляют собой запрос.

Для суффиксов используют кэжуал аттеншн для в авторегресионной генерации. Это позволяет генерировать ответы последовательно, предсказывая следующий токен на основе предыдущих.

В задаче генерации описаний для изображений на датасете COCO PaliGemma выдала результат 141,9 балла при разрешении 224 пикселей и улучшила показатели до 144,6 на 448. В задаче визуальных вопросов и ответов VQAv2 модель продемонстрировала результат в 83,2 и 85,6 балла для разрешения в 224 и 448 пикселей соответственно.

Разбор подготовил ❣ Александр Шишеня
CV Time
1 463 просмотров · 18 реакций Открыть в Telegram · Открыть пост на сайте
One-step Diffusion with Distribution Matching Distillation

С помощью диффузионных моделей можно генерировать изображения отличного качества по текстовому описанию, но без дистилляции они требуют десятки прогонов модели, что снижает их эффективность эффективными по сравнению с альтернативными парадигмами. Авторы сегодняшней статьи разработали Distribution Matching Distillation (DMD) — процедуру дистилляции диффузионной модели (учителя) в одношаговый генератор изображений (студента), который хорошо сохраняет качество картинок и их соответствие текстовому описанию.

Авторы предлагают учить одношаговый генератор изображений p_\theta(x) за счет минимизации обратной KL-дивергенции между распределением студента и распределением данных: KL(p_\theta(x) || p_{data}). Напомним, что в таком KL-е мат-ожидание берется по распределению студента и следовательно при оценке методом Монте-Карло примеры сэмплируются из текущей версии модели-студента.

Тем не менее, посчитать обратный KL явно все еще не получится. Однако главная идея работы заключается в том, что мы можем оценить производную обратного KL-я, используя прямой проход уже обученных диффузионных моделей: одна модель оценивает скор реального распределения (\nabla_x \log p_data(x)), а другая скор распределения студента (\nabla_x \log p_\theta(x)). Отметим, что в самом начале у нас есть только одна модель, которая оценивает \nabla_x \log p_data(x), а вторую нужно учить на текущих генерациях студентов тем самым адаптируя её под изменяющееся распределение студента по ходу обучения. Процедура напоминает обучение GAN-a, но с другим обджективом.

Внимательный читатель обратит внимание, что диффузия обычно предсказывает скоры для зашумленных распределений, а не для чистых, как описано выше. Но в данном методе это не баг, а фича, о которой лучше почитать в самой статье.

Важный нюанс при минимизации обратного KL — он склонен к потере мод распределения, что часто выражается в генерации однотипных картинок для одного текстового описания. Чтобы побороть проблему, авторы предлагают добавить дополнительный дистилляционный лосс, который заставляет модель не забывать куски распределения учителя. Дополнительный обджектив представляет собой регрессионный лосс, когда сначала собираются пары (шум — картинка), сгенерированные учителем, и затем по MSE многошаговый выход учителя сближается с одношаговым студентом по тому же входному шуму.

Таким образом, итоговая процедура обучения состоит из двух лоссов: обратный KL, отвечающий за качество генерации студента, и регрессионный лосс, стабилизирующий процедуру обучения и не дающий потерять разнообразие.

По словам авторов статьи, такой подход позволяет добиться лучших результатов, чем предыдущие методы (на момент декабря 2023 года), достигая 2.62 FID на ImageNet 64x64 и 11.49 FID на zero-shot COCO-30k, что сравнимо с результатами Stable Diffusion, но при этом DMD работает гораздо быстрее, генерируя изображения со скоростью до 20 FPS. Однако, стоит обратить внимание, что метрики для генерации картинок — ненадежный показатель качества, поэтому в идеале нужно проводить оценку на людях, чего авторы не сделали. Модели и кода в открытом доступе тоже не было, поэтому о реальном качестве результатов остается только догадываться.

В оправдание авторов: спустя полгода команда выпустила улучшенную версию метода, к которой приложили и код, и модели, и полноценную оценку качества генерации. Почитать о новом методе можно здесь.

Разбор подготовил ❣ Дмитрий Баранчук
CV Time
1 226 просмотров · 15 реакций Открыть в Telegram · Открыть пост на сайте
InternVL

Визуальные модели в своем развитии несколько отстают от языковых, хотя и то, и то важно для создания сильного искусственного интеллекта (AGI). Преодолеть разрыв попытались авторы сегодняшней статьи, в которой представлена модель InternVL.

InternVL отличается тем, что включает визуальный энкодер InternViT-6B и языковую прослойку QLLaMA с 8 миллиардами параметров. Обучение проходило в несколько этапов:

1. Контрастивный претрейн. Здесь использовали миллионы пар изображений и текстов из датасетов LAION, COYO, CC12M. На этом этапе модель училась сопоставлять картинки и их описание.

2. Генеративный претрейн. Здесь использовали пары с более чистыми изображениями из таких датасетов, как COCO и TextCaps. На этом этапе модель училась создавать текстовое описание для картинок.

3. Файнтюнинг.

В итоге получились две модели, которые призваны решать одну задачу: InternVL-C (contrastive) и InternVL-G (generative). Первая, по сути, это модель раннего связывания, а вторая — позднего. На бенчмарках можно увидеть, какой результат дает ранняя и поздняя привязка изображения к тексту.

Так, в задаче мультиязычного поиска изображений по тексту на наборе данных XTD, средний показатель recall@10 составил 95,1% для InternVL-C и 96,6% для InternVL-G. В задаче zero-shot классификации видео на наборах данных Kinetics-400, Kinetics-600 и Kinetics-700, InternVL-C продемонстрировала точность 76,1%, 75,5% и 67,5% соответственно.

Разбор подготовил ❣ Артём Конев
CV Time
996 просмотров · 14 реакций Открыть в Telegram · Открыть пост на сайте
Привет! Это канал, полностью посвященный CV. Здесь мы, специалисты по компьютерному зрению из Яндекса, будем анализировать и комментировать свежие научные публикации, делиться опытом, рассказывать об интересных кейсах из практики и вместе с вами искать ответы на сложные вопросы. Подписывайтесь и приглашайте друзей и коллег, если вам близка тема CV 👀🤖
851 просмотров · 14 реакций Открыть в Telegram · Открыть пост на сайте