InsightEdit: Towards Better Instruction Following for Image Editing

Авторы сегодняшней статьи рассказывают о том, как построили модель InsightEdit для трёх задач редактирования изображений — добавления, удаления и замены объекта. Для этого:

— собрали автоматический пайплайн генерации данных для обучения задаче редактирования изображений по промпту;
— сгенерировали с помощью этого пайплайна датасет AdvancedEdit;
— на собранном датасете обучили модель InsightEdit.

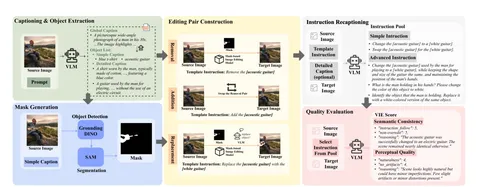
Сначала авторы сгенерировали caption для исходного набора картинок: простые описания (вида «голубая футболка») и сложные (вида «футболка на мужчине, похожая на хлопковую, содержит голубые элементы»). Потом использовали LLM, чтобы создать список объектов, сгенерировали каждому из них маску с помощью GroundedSAM и отфильтровали маски с низким скором уверенности. И, наконец, составили простые инструкции, как и что заменить, и с помощью инпейнтинга сгенерировали отредактированное изображение. А чтобы модель не переобучилась, добавили в датасет перефразированные LLM формулировки.

Такой автоматизированный пайплайн использовали для создания датасета AdvancedEdit. В качестве исходных данных взяли датасет Pixels, который содержит более 1 миллиона фотографий высокого разрешения.

Модель InsideEdit состоит из трёх модулей: понимания, объединения и генерации. Модуль понимания использует MLLM, чтобы понять по промпту, что нужно редактировать. Модуль объединения улучшает взаимодействие промпта и исходного изображения. А модуль генерации — создаёт целевое изображение: редактирует исходное, обуславливаясь векторами признаков из предыдущих модулей.

Для оценки качества обученной модели авторы сравнивают CLIPScore объекта редактирования с эмбеддингом целевого объекта. А чтобы убедиться, что модель не изменила остальные объекты, применяют PSNR, SSIM и LPIPS по фону изображения. Для более точной оценки эффектов редактирования и соответствия человеческим предпочтениям — используют VIEScore.

Обзор подготовил ❣ Александр Шишеня
CV Time
1 992 просмотров · 17 реакций Открыть в Telegram · Открыть пост на сайте
Тематическая подборка статей: генерация

Спешим поделиться очередной подборкой публикаций — на этот раз о генерации.

Обучение

Meissonic: Revitalizing Masked Generative Transformers for Efficient High-Resolution Text-to-Image Synthesis
Авторы обучили 1B-трансформер для генерации изображений, используя VQ-VAE и masked image modelling. По словам инженеров, модель достигла уровня SD XL, что они считают успехом.

Improving Long-Text Alignment for Text-to-Image Diffusion Models
Исследователи пробуют модифицировать Stable Diffusion для работы с длинными текстами. Для этого их нарезают на сегменты, которые по отдельности кодируют через CLIP. Также проанализировали CLIP-реворд, разделив его на text-relevant и text-irrelevant части (последние стремятся сделать картинки более комплексными). Дополнительно в статье показано, что T5-энкодер можно на файнтюне добавлять к CLIP-предобученной модели.

Fluid: Scaling Autoregressive Text-to-image Generative Models with Continuous Tokens
В статье попарно сравнивают четыре подхода к генерации изображений трансформерами: авторегрессивная генерация vs генерация токенов на рандомных позициях, а также предсказание continuous-токенов vs предсказание дискретных токенов из словаря.

Побеждает предсказание continuous-токенов на случайных позициях, но авторам не удалось выровнять качество continuous и дискретных автоэнкодеров — эта часть вызывает вопросы. Авторы отдельно замечают, что лосс на валидации хорошо коррелирует с метриками. Об этом упоминалось и в статье о Movie Gen (пункт 3.6.1, абзац «Correlation between validation loss and human evaluation»).

Бенчмарки

KITTEN: A Knowledge-Intensive Evaluation of Image Generation on Visual Entities
В работе создали корзину концептов из «Википедии» с изображениями-референсами и замерили на ней Imagen, Flux, Stable Diffusion и прочие модели. Выяснилось, что те из них, что на вход принимают картинку-референс (InstructImagen, DreamBooth), лучше воспроизводят концепты, но часто ценой худшего следования промпту. Также авторы сравнили разметку людьми с автооценкой через CLIP/DINO, и ранжирование моделей поменялось (корреляция 0,3–0,5, что указывает на возможность подобрать лучшие модели).

Видео

Koala-36M: A Large-scale Video Dataset Improving Consistency between Fine-grained Conditions and Video Content
Исследователи собрали датасет для обучения видеодиффузионной модели: описали процесс video splitting, схему кэпшнинга и фильтрации. В работе по набору классификаторов учатся предсказывать, насколько видео подходит для добавления в обучающее множество, а также кондишнят генерацию на классификаторы по видео.

Movie Gen: A Cast of Media Foundation Models
Большая статья, в которой Meta адаптирует архитектуру Llama3 с 30B параметров для генерации видео. Интересные моменты:

— используют три текстовых энкодера: UL2, ByT5 и CLIP, которые во время обучения считаются на лету;
— в ByT5 подают только текст, который нужно отрисовать (предлагают помещать его в кавычки в промпте);
— тюнят Llama3 для переформулировки промптов, приближая их к трейну;
— добавляют дополнительный лосс для борьбы с точками-артефактами при обучении VAE;
— обучение начинается с изображений разрешением 256px;
— получают финальную модель путём усреднения весов моделей, дообученных на разных датасетах и гиперпараметрах.

Другое

On the Effectiveness of Dataset Alignment for Fake Image Detection
Авторы описывают хитрый способ обучить классификатор синтетических картинок. Для этого реальные изображения (неважно какие) кодируются и декодируются через VAE — и дальше к ним относятся, как к синтетическим.

Таким образом получается датасет пар картинок, которые отличаются только артефактами VAE — на нём можно обучить детектор синтетических картинок. Но есть нюансы: пайплайн может быть чувствителен к постобработке картинок, и может плохо переноситься на модели с сильно отличающимися VAE.

Обзор подготовил ❣ Артём Конев

CV Time
___
Meta признана экстремистской организацией, а Facebook и Instagram запрещены на территории РФ
2 381 просмотров · 18 реакций Открыть в Telegram · Открыть пост на сайте
Недавно инженеры из Яндекса вместе со Школой анализа данных провели открытый онлайн-интенсив по компьютерному зрению и рассказали о генеративных диффузионных моделях.

Получилась крепкая база для ML`щика — с понятными видеолекциями и практическими разборами.

Делимся этими материалами с вами — на лендинге они удобно сгруппированы по темам. А в карточках наши спикеры рассказывают, чем вам может быть полезна каждая из освещённых тем.

Приятного чтения и увлекательного просмотра!
7 432 просмотров · 26 реакций Открыть в Telegram · Открыть пост на сайте
UniReal: универсальная модель для генерации и редактирования изображений

Разбираем статью UniReal от исследователей из университета Гонконга. Редактирование изображений — обширная область, в которой есть разнообразные подходы, в частности, известные ControlNet и InstructPix2Pix. Однако в случае с UniReal авторы хотели создать универсальную модель, способную из коробки решать разные типы задач.

На тизерной странице есть примеры её работы. Модель может изменить фон исходной картинки, убрать или заменить изображение, добавить новые объекты, поменять стиль, создать композицию из объектов.

Архитектура

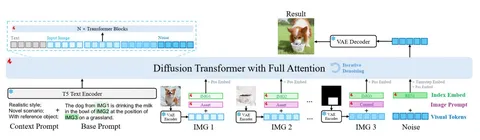
Модель построена на диффузионном трансформере с Full Attention. Архитектура включает следующие компоненты:

— энкодер T5 для обработки текстовых токенов;
— VAE-энкодеры для изображений;
— специальные токены для работы с несколькими изображениями (например, IMG1 для входного изображения и RES1 для результирующего).

Картинки могут выполнять разную роль: быть фоновым изображением (canvas image), давать сигнал, вроде указания границ или глубины (control image), или просто участвовать в качестве объекта на сцене (asset image). Для каждой категории изображений есть обучаемые токены (learnable category embeddings). Они добавляются вместе с картинкой, как промпт.

Авторы используют обучаемые контекстные промпты с несколькими сценариями: реалистичными, синтетическими, статическими, динамическими, а также с референсным объектом.

Данные

Качественных датасетов для редактирования изображений довольно много, например: InstructPix2Pix, UltraEdit, VTON-HD. Но все же их оказалось недостаточно, поэтому исследователи добавили этап обучения на видеоданных. Использовали два типа предобучения:

— С помощью видеоклипов, из которых случайным образом выбирались два кадра, а также добавлялись описания происходящего в клипе. Для генерации синтетических описаний применяли модель GPT-4 mini.

— Генерация описаний изображений с привязкой к границам объектов (bounding boxes) с помощью VLM Kosmos-2. Эти границы комбинировались с Segment Anything Model (SAM) для получения масок. Так создавалась синтетическая разметка видео для задач вставки объектов и заполнения отсутствующих частей изображения (inpainting).

Модель предобучалась на этой смеси: сначала на видеоданных, затем на публичных датасетах. Исследователи делают акцент на том, что для финального результата были важны все компоненты.

Результаты

Сравнение на бенчмарках EMU Edit и MagicBrush в задачах редактирования изображений показало, что UniReal успешно справляется со сложными задачами, такими как добавление и удаление объектов, в то время как базовые модели допускают в них ошибки.

Для генерации референсных объектов на фоне модель сравнивается с Textual Inversion, DreamBooth, BLIP-Diffusion и другими. Не во всех случаях она превосходит конкурентов по метрикам, но показывает хорошие результаты в SBS-замерах.

Сейчас модель неплохо работает с двумя-тремя изображениями, но для генерации на десяти и более изображениях требуется больше данных и доработка архитектуры.

Обзор подготовил ❣ Денис Кузнеделев

CV Time
2 498 просмотров · 14 реакций Открыть в Telegram · Открыть пост на сайте
Личные итоги года инженеров Яндекса — Роман Исаченко

Продолжаем серию постов от ML'щиков из Яндекса, в которых они подводят профессиональные итоги прошедшего года и строят планы на будущий.

Сегодня на очереди — руководитель подгруппы дискриминативного анализа изображений Роман Исаченко. Он рассказал о личных достижениях и поделился взглядом на тренды в ML.

Больше карточек от инженеров — по хештэгу #YaMLpeople.
2 056 просмотров · 42 реакций Открыть в Telegram · Открыть пост на сайте
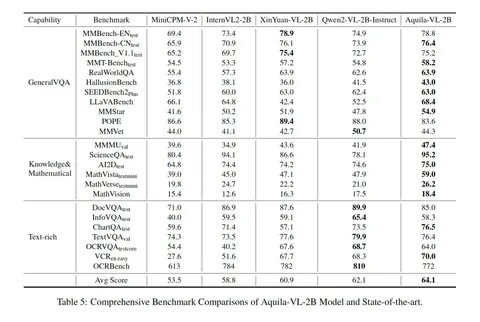
Опыт модели Aquila-VL-2B: почему не всегда стоит доверять бенчмаркам

Сегодня разберём работу Infinity-MM и описанную в ней модель Aquila-VL-2B. Эта маленькая VLM с двумя миллиардами параметров интересна тем, что смогла обойти в своём классе Qwen и InternVL, которые редко уступают первые позиции лидербордов. Расскажем, как в топе MMBench оказалась неизвестная модель и почему иногда бенчмарки могут искажать реальную ситуацию.

Работа представляет собой репорт о проведённом эксперименте. Материал не содержит наукоёмких изменений в пайплайне обучения или архитектуре модели. Авторы сосредоточены на теме данных и отвечают на вопрос: как при ограниченных ресурсах стать SOTA VLM, пусть даже не в самом популярном классе маленьких моделек.

Один из ключевых тезисов: при обучении VLM имеет смысл масштабировать объём SFT-данных. С этой целью авторы собрали всё доступное из опенсорса и получили датасет из нескольких десятков миллионов инстрактов, а также сгенерировали в дополнение небольшую часть синтетики. Все данные фильтровались, проходили дедупликацию и проверку на разнообразие. Итоговый мультимодальный датасет — это и есть Infinity-MM из названия статьи.

Из-за ограничения в вычислительных ресурсах исследователи использовали для генерации и чистки датасета опенсорсные модели, в частности активно прибегали к помощи Qwen.

Пайплайн для генерации синтетических данных выглядит следующим образом:

— Собирается база изображений, их размечают с помощью опенсорс-модели, которая тегирует объекты на картинке.
На основе тегов формируется дерево типов задач, для которых целесообразно создавать инстракты.

— Опенсорсными моделями (преимущественно MiniCPM и Qwen) генерируют инстракт по картинке, тегу и тематике. Происходит автофильтрация через эту же модель (ей дают сгенерированный инстракт и спрашивают, насколько он валиден).

— Затем получают ответ по синтетическому инстракту — та же модель снова отвечает на вопрос, который сама придумала.

— Следующий шаг — фильтрации ответа. Тут интересное решение: опенсорсная модель считает лосс по полученной паре и, если он высокий, пример исключается. Так исследователи автоматически отфильтровали 5% самых «шумных» данных.

Этих несложных манипуляций хватило, чтобы обогнать модели, которыми авторы генерировали и фильтровали свои данные. Скорее всего, так произошло, потому что синтетику целенаправленно собирали под конкретный бенчмарк (MMBench). И в таком случае модель может непредсказуемо вести себя на других задачах.

Можно сделать вывод, что бенчмарки лучше использовать исключительно как «градусник», чтобы следить за изменениями в области. А вот для оценки эффективности моделей надёжнее ориентироваться на SBS-замеры (Side-by-Side), которые позволяют проводить прямое сравнение в реальных условиях.

А как вы оцениваете опыт Aquila-VL-2B и доверяете ли ещё бенчмаркам?


Обзор подготовил ❣ Алексей Григорьев
CV Time
2 154 просмотров · 24 реакций Открыть в Telegram · Открыть пост на сайте
Лучшие CV-статьи за 2024 год: подборка от авторов канала
Часть 3

Сегодня делимся подборкой от Александра Шишени, ведущего разработчика службы компьютерного зрения в Яндексе. Он выбрал интересные направления и статьи в них, чтобы нам не пришлось рыться в тоннах публикаций.

Авторегрессионная генерация изображений

SWITTI: Designing Scale-Wise Transformers for Text-to-Image Synthesis
Команда исследователей из Yandex Research обучила и опубликовала в открытом доступе собственную авторегрессионную модель для генерации изображений по тексту. За основу взяли архитектуру STAR и провели ряд улучшений:
— добавили дополнительные нормализационные слои для стабилизации обучения;
— убрали авторегрессию на прошлые разрешения — тем самым ускорили генерацию и уменьшили потребление памяти;
— отключили технику classifier-free-guidance (CFG) на высоких разрешениях — получили значительное ускорение без ухудшения качества генерации.
В результате Switti имеет паритет по качеству с диффузионками, но при этом генерирует в 7 раз быстрее оригинальной SDXL-модели и в 2 раза быстрее её ускоренных версий.
Можно также прочитать подробный разбор решения в трёх частях: первая, вторая, третья.

Visual Autoregressive Modeling: Scalable Image Generation via Next-Scale Prediction
Один из недостатков авторегрессионных моделей — низкая скорость генерации изображений. Чтобы решить эту и другие проблемы, ByteDance предложили альтернативную авторегрессионную парадигму, которая включает:
— многомасштабный VQ-VAE для одновременного кодирования и декодирования изображений на нескольких уровнях разрешения;
— обучение трансформера для последовательной генерации токенов изображения с постепенным увеличением масштаба.
В результате удалось добиться качества, сопоставимого с современными диффузионками, обученными на ImageNet, и при этом превзойти их по скорости.

Infinity∞: Scaling Bitwise AutoRegressive Modeling for High-Resolution Image Synthesis
Авторы Infinity∞ продолжают развивать идеи масштабируемой авторегрессионной генерации. Их решение использует битовую токенизацию с бесконечным словарём и механизмом самокоррекции. Результат — заметно повышается качество генерируемых изображений.

Диффузионные модели

Neural Flow Diffusion Models: Learnable Forward Process for Improved Diffusion Modelling
На стадии инференса диффузионных моделей приходится делать много итераций, так как траектории сэмплирования, определяемые моделью, существенно отклоняются от прямых.

Это во многом связано с тем, что процесс зашумления в стандартной диффузии задаётся фиксированной формулой. Авторы предлагают обобщить диффузионные модели с подходом flow-matching, добавив обучаемое зашумление. Это позволяет адаптировать процесс зашумления так, чтобы траектории минимально отклонялись от прямых. Интересно, что такая постановка приводит к решению задачи оптимального транспорта.

✨А ещё в канале ML Underhood можно полистать карточки, где автор подборки Александар Шишеня рассказывает, над чем трудился в прошедшем году и какие события в сфере ML считает главными.

CV Time
2 093 просмотров · 19 реакций Открыть в Telegram · Открыть пост на сайте
Лучшие CV-статьи за 2024 год: подборка от авторов канала
Часть 2

Продолжаем делиться самыми полезными публикациями прошлого года. Сегодня на очереди три статьи, которые рекомендует изучить Денис Кузнеделев, исследователь Yandex Research.

Improved Distribution Matching Distillation for Fast Image Synthesis

Авторы пытаются решить вопрос быстрой и качественной генерации картинок. В первой версии подхода из статьи One-step Diffusion with Distribution Matching Distillation предложили обучать вспомогательную модель (функцию fake score), чтобы она оценивала, насколько генерации «быстрой» модели похожи на результаты «медленной» модели-учителя. Подход работал неплохо, но всё же картинки от «быстрой» модели были хуже учительских.

В новой статье авторы существенно модифицировали решение. Теперь «быстрая» модель обновляется не каждый раз, а через несколько шагов функции fake score. Также добавили ещё одну вспомогательную модель-дискриминатор, которая оценивает реалистичность картинок, сгенерированных «быстрой» моделью. С этими изменениями удалось значительно улучшить качество при генерации в один и четыре шага.

Movie Gen: A Cast of Media Foundation Models

Осенью компания Meta* представила семейство моделей MovieGen для генерации видео. С фундаментальной точки зрения технический отчёт проекта предлагает немногое, но содержит ряд нетривиальных идей. В их числе — специальная регуляризация при обучении сети-автокодировщика, архитектурные решения для стабилизации и масштабирования обучения, специальное расписание диффузии.

Процесс сбора и подготовки данных включает как чисто картиночные данные, так и короткие видеоклипы разного разрешения и содержания. Модели умеют:

— генерировать видео по тексту;
— генерировать видео с целевым объектом (человеком, животным, предметом);
— редактировать видео на основе инструкций.

Дополнительно к видеомоделям исследователи и инженеры из Meta обучили модель для озвучки видео — MovieGen-Audio.

Visual Autoregressive Modeling: Scalable Image Generation via Next-Scale Prediction

Авторы переосмысливают авторегрессию в картиночных моделях и предлагают токенизировать изображение по масштабу, а не по пространственным патчам. Новый класс моделей обгоняет предшественников по времени генерации, при этом не уступая по качеству. Подробнее расскажем о статье в следующей части подборки.

CV Time
___
Meta признана экстремистской организацией, а Facebook и Instagram запрещены на территории РФ
2 328 просмотров · 11 реакций Открыть в Telegram · Открыть пост на сайте
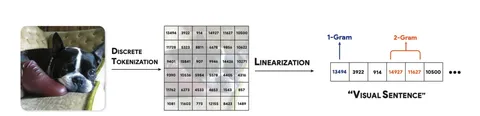
Analyzing The Language of Visual Tokens

Визуальные токены ≠ текстовые, но в мультимодальных моделях (например, LLaVA и Chameleon) они часто используются схожим образом, без искусственного разделения.

Авторы сегодняшней статьи исследуют, насколько близки естественные языки, образованные текстовыми токенами, и визуальные языки, образованные токенами визуальными. Для этого они сопоставляют визуальные языки COCO, ImageNet и других популярных датасетов, используя VQ-VAE-like токенайзеры и линеаризацию токенов изображений в 1D-последовательности (как на картинке). А потом сравнивают полученные для визуальных языков закономерности с зависимостями для естественных.

Ключевые результаты:

— В отличие от естественных языков, визуальные не подчиняются Zipf’s law: среди визуальных токенов нет превалирующих (для текстовых это, например, артикль the).
— Визуальные языки разнообразнее естественных: уникальные изображения чаще состоят из новых токенов. Авторы показывают это с помощью процесса Yule-Simon.
— Визуальные языки «естественны» — удовлетворяют Benford’s law.
— Пытаясь сжать визуальные токены кодированием Хаффмана, исследователи пришли к выводу, что визуальные языки хаотичнее, комплекснее и менее избыточны, чем естественные.
— Визуальные токены изображений чаще соотносятся с частями объектов, а не с целыми предметами.

Эмпирические исследования показали: хотя технически визуальные токены похожи на текстовые, составленные из них языки не совпадают.

По мнению авторов, это важно учитывать в обучении моделей: нейросети, которые работают с визуальными токенами, более подвержены переобучению. А комплексность и разнообразие визуальных языков требуют более долгой тренировки.

Обзор подготовил ❣ Никита Буров
CV Time
2 611 просмотров · 40 реакций Открыть в Telegram · Открыть пост на сайте
Лучшие CV-статьи за 2024 год: подборка от авторов канала
Часть 1

Лучшие публикации прошедшего года не теряют актуальности в новом. Мы попросили постоянных авторов канала отметить самые полезные пейперы из 2024-го — несём вам первую часть подборки.

Scaling Rectified Flow Transformers for High-Resolution Image Synthesis
Исследователи совместили набирающую популярность модель Flow Matching (Rectified Flow) и нейросетевую архитектуру DiT (Diffusion Transformer), чтобы адаптировать их для генерации изображений по тексту. Именно эта работа лежит в основе модели Stable Diffusion 3.

Deep Compression Autoencoder for Efficient High-Resolution Diffusion Models
В статье предложено новое архитектурное семейство картиночных кодировщиков DeepCompression-AE. Они позволяют сжимать изображения в 64 раза (по каждой стороне) с минимальными потерями. DC-AE значительно уменьшает затраты по времени и памяти при генерации, а также обладает высокой точностью реконструкции.

InternVL: Scaling up Vision Foundation Models and Aligning for Generic Visual-Linguistic Tasks
Модели семейства InternVL регулярно оказываются в топе бенчмарков и составляют конкуренцию проприетарным моделям, вроде Gemini и GPT-4o. Авторы придерживаются открытого подхода к исследованиям — все веса моделей доступны для свободного использования. Основная статья была опубликована в конце 2023 года, но в 2024 вышли значимые обновления для версий 1.5, 2 и 2.5.

Playground v3: Improving Text-to-Image Alignment with Deep-Fusion Large Language Models
Как и предыдущая, эта статья даёт возможность узнать детали устройства state-of-the-art модели, в данном случае — text-to-image. Авторы приводят подробности об архитектуре, сборе датасета и стабилизации процесса обучения.

Chameleon: Mixed-Modal Early-Fusion Foundation Models
Статья задала тренд на развитие моделей, которые умеют нативно работать с изображениями как в дискриминативном, так и в генеративном форматах. Такая модель не только ответит на вопрос по изображению, но и при необходимости сгенерирует в своём ответе картинку.

Law of Vision Representation in MLLMs
Выбор картиночного бэкбона для мультимодальных LLM обычно происходит эмпирически: перебираем N вариантов и берём лучший по соотношению скорости и качества. В статье сделана попытка с научной точки зрения ответить на вопрос, что такое хороший картиночный бэкбон. Для этого авторы ввели свойства Alignment и Correspondence, которым должны соответствовать кандидаты. В дополнение можно прочитать неформальный блогпост от автора.

Продолжение следует.

Статьи отобрали и прокомментировали ❣ Александр Устюжанин и Артём Конев
CV Time
2 701 просмотров · 19 реакций Открыть в Telegram · Открыть пост на сайте
🏆 Итоги года: самые популярные посты в CV Time

2024-й на финишной прямой! Потихоньку настраиваемся на подведение итогов и освежаем в памяти самые популярные посты уходящего года. Уверены, это будет почти так же уютно, как пересматривать «Один дома» (только про компьютерное зрение).

Minimalist Vision with Freeform Pixels
Алиса Родионова разобрала статью с ECCV-24, получившую награду Best Paper Award. Авторы создали прототип автономной по электропитанию камеры. Вместо обычной матрицы в ней установлены 24 фотодиода с масками-фильтрами, которые выполняют роль первого слоя нейросети. Такая архитектура позволяет адаптировать камеру под разные задачи и получать результаты с помощью всего 8 пикселей. В обзоре — подробнее о том, как устроено решение.

Интересное с ECCV 2024
Ещё один пост с ECCV-24. Дарья Виноградова, Александр Устюжанин и Сергей Кастрюлин отобрали самые интересные доклады первого дня конференции. В их числе «механизм реалистичности» для сокращения доменного сдвига в 3D-рендеринге лиц, подходы к улучшению реализма в text-to-3D и image-to-3D моделях, а также концепция разделения Knowledge и Memory в нейросетях.

Как LLaMA 3.1 работает с изображениями
Роман Исаченко объяснил, как устроена мультимодальная LLaMA 3.1: какие архитектурные решения в основе, на каких данных её обучали и как она показывает себя на бенчмарках. Он подметил несколько интересных трюков. Среди них — подмена весов на этапе файнтюна через hot-swap и дополнительный пост-претрейн на датасете с редкими скриншотами и таблицами.

DART: Denoising Autoregressive Transformer for Scalable Text-to-Image Generation, часть 2
Александр Шишеня в двух постах рассказал, как устроена DART, диффузионная авторегрессионная модель для генерации изображений. В разборе вы найдёте детали о полезных модификациях, вроде DART-AR с ускорением обучения и DART-FM с Flow Matching для повышения качества генераций. Вторая часть оказалась ещё популярнее первой, — видимо, вам хотелось поскорее узнать развязку.

Pyramidal Flow Matching for Efficient Video Generative Modeling
Александр Маркович разобрал, как Sora-like модели создают видео. Авторы статьи предлагают отказаться от высокого разрешения ради скорости обучения и инференса. Интересная часть — пирамидальный подход: вместо многослойной генерации видео с постепенным апскейлом, как обычно, моделируют все разрешения сразу.

Впечатления от ECCV 2024
Мы попросили инженеров Яндекса подвести личные итоги конференции и рассказать, чем она запомнилась. В посте собрали рекомендации свежих работ по CV и любопытные заметки на полях. Среди трендов заметили фокус на исследованиях за пределами области text-to-image и спад интереса к узким темам. Все детали — на наших красочных карточках.

Movie Gen: A Cast of Media Foundation Models
Денис Кузнеделев взял оригинальный технический отчёт проекта и разобрал решения, использованные в моделях для генерации видео Movie Gen. Некоторые идеи оказались нетривиальными, например, регуляризация при обучении сети-автокодировщика, архитектура для стабилизации и масштабирования обучения, специальное расписание диффузии. Больше подробностей — по ссылке.

CV Time
___
Meta признана экстремистской организацией, а Facebook и Instagram запрещены на территории РФ
2 478 просмотров · 19 реакций Открыть в Telegram · Открыть пост на сайте
LLaVa-CoT: Let Vision Language Models Reason Step-by-Step

Сегодня разберём статью о подходе к обучению и инференсу VLM, вдохновлённом o1-preview от OpenAI.

Авторы начали со сбора 100 тысяч сэмплов из открытых VQA-бенчмарков (и пообещали выложить получившийся датасет!). Потом для этих сэмплов с помощью GPT-4o сгенерировали CoT-синтетику со следующими блоками:

⚪Summary — развернутое описание решаемой проблемы;
⚪Caption — описание изображения с учетом деталей, релевантных задаче;
⚪Reasoning — step-by-step решение задачи;
⚪Conclusion — финальный ответ.

После на этих данных сделали full-finetune поверх Llama-3.2-11B-Vision-Instruct (кстати, всего на восьми H100).

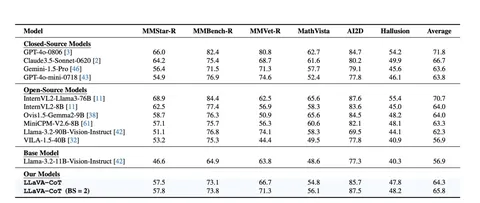
Уже на этом этапе модель стала заметно умнее своего бейзлайна: 56,6 → 63,5 средних попугаев. Но авторы выбили еще полтора попугая за счет собственного inference-time скейлинга: Stage level Beam Search. По сути, это обычный BS. Только ветвление происходит на уровне целых блоков CoT, а не на уровне отдельных предложений.

По замерам авторов, их модель в максимальном сетапе обходит Gemini-1.5-Pro и приближается к Claude3.5-Sonnet (см. табличку). До GPT-4o, правда, еще далековато.

Обзор подготовил ❣ Павел Штыков
CV Time
2 204 просмотров · 21 реакций Открыть в Telegram · Открыть пост на сайте
Роботы — круто

А статьи о робототехнике — ещё круче. Руководитель группы нейросетевых технологий Yandex.Robotics Виктор Юрченко рекомендует семь интересных работ по теме. Все подробности — в карточках.

CV Time
6 779 просмотров · 38 реакций Открыть в Telegram · Открыть пост на сайте
Тематическая подборка статей: картиночные модели

Сегодня у нас новая подборка с рекомендациями нескольких интересных статей. В центре внимания — модели для работы с изображениями и статьи, где авторы предлагают идеи для их развития и улучшения в разных аспектах.

Архитектура
MoH: Multi-Head Attention as Mixture-of-Head Attention
Авторы переносят Mixture-of-Experts в аттеншн: предлагают относиться к головам как к экспертам и активировать только часть из них. Показывают, что так можно дотюнить обученные модели и что этот подход работает для широкого класса задач. На ViT и Llama3 получили неплохие результаты, но непонятно, можно ли теоретический профит перенести на практику.

Дообучение
Locality Alignment Improves Vision-Language Models
Ресерчеры предлагают использовать схему с маскированием для дообучения CLIP-трансформеров, которое улучшает их качество как VLM-бэкбонов на пространственных задачах.

When Does Perceptual Alignment Benefit Vision Representations?
Исследователи файнтюнят через LoRA бэкбоны на датасете Nights (20 тысяч триплетов с разметкой, где отражено, какое из двух изображений более похоже на первое с т. з. человека) и пишут, что после этого модели извлекают более хорошие фичи для широкого класса задач. Удивляет, что в 20 тысячах триплетов оказалось достаточно информации, чтобы заметно повлиять на качество модели.

Дистилляция
TAS: Distilling Arbitrary Teacher and Student via a Hybrid Assistant
Авторы говорят, что при дистилляции между моделями разных семейств (CNN/MLP/ViT) можно использовать модель-ассистента, состоящую из блоков разного типа. Это позволяет повысить гибкость и расширить потенциал дистилляции знаний в случае, если у модели-учителя и ученика разные архитектуры.

Датасеты
WorldCuisines: A Massive-Scale Benchmark for Multilingual and Multicultural Visual Question Answering on Global Cuisines
Датасет с блюдами разных стран и культур, 6 тысяч изображений. Очень много авторов для такой узкой темы и разнообразная аннотация как бонус.

Подборку подготовил ❣ Артём Конев
CV Time
2 706 просмотров · 23 реакций Открыть в Telegram · Открыть пост на сайте
Switti: Designing Scale-Wise Transformers for Text-to-Image Synthesis
Часть 3, эксперименты и результаты

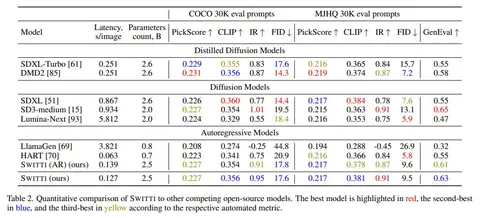
Мы обучили 2.5B модель на внутреннем датасете из 100М картинок. В качестве бейзлайнов взяли сравнимые по размеру SD3-Medium, Lumina-Next, Stable Diffusion XL и её дистиллированные версии: SDXL-Turbo, DMD2; а также авторегрессионные модели: Emu3, Lumina-mGPT, LlamaGen и HART.

Для оценки качества использовали стандартные метрики: FID, CLIP, Pickscore, Image Reward, — а также бенчмарк GenEval и пользовательские предпочтения на корзинке из 128 запросов (Parti Prompts). Юзеры оценивали релевантность, эстетичность, комплексность и дефектность изображений.

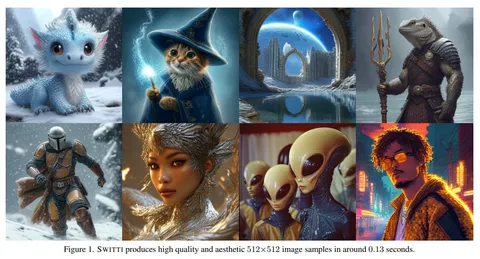
Switti значительно превзошла существующие авторегрессионные подходы, как по метрикам, так и по пользовательским предпочтениям. С диффузионками добились паритета по качеству, но при этом Switti генерирует в 7 раз быстрее оригинальной SDXL-модели и в 2 раза быстрее её ускоренных версий.

Отметим, что это пока лишь шаг в развитии новой генеративной парадигмы и ещё есть, куда расти, чтобы дотянуть качество до уровня ведущих генеративных моделей: YaART, Midjourney, FLUX, Recraft и Ideogram-v2. Наша команда уже приступает к дальнейшему развитию Switti. Так что следите за обновлениями!

Обзор подготовил
❣ Дмитрий Баранчук
CV Time
2 376 просмотров · 37 реакций Открыть в Telegram · Открыть пост на сайте
Switti: Designing Scale-Wise Transformers for Text-to-Image Synthesis
Часть 2, методы

Приступив к созданию Switti (Scale-wise transformer for text-to-image), мы взяли за основу архитектуру STAR и начали постепенно её улучшать. Оригинальная модель оказалась нестабильной при обучении, и, мотивируясь работами по диффузионным трансформерам, мы добавили в модель дополнительные нормализационные слои, что стабилизировало обучение и улучшило итоговое качество.

Затем мы обратили внимание, что модель на входе на текущем уровне уже получает информацию о всех предыдущих уровнях по построению и при этом дополнительно смотрит на них с помощью attention-слоев, что показалось нам лишним и неэффективным. Убрав авторегрессию на прошлые разрешения, удалось ускорить пайплайн генерации для 512х512 изображений на 11%, уменьшить потребление памяти и немного улучшить качество генерации.

Также мы заметили, что модель слабо опирается на текстовые описания на самых последних уровнях генерации. Это натолкнуло на мысль, что можно не использовать технику classifier-free-guidance (CFG) на уровнях высокого разрешения. Напомним, что CFG играет важную для повышения качества генерации и соответствия запросу в text-to-image моделях, но при этом требует дополнительный прогон модели на каждом шаге. Поэтому отключение CFG на последних уровнях значительно ускоряет генерацию. Более того, мы заметили, что помимо скорости, модель также продуцирует меньше артефактов при генерации мелких деталей и позволяет использовать более высокие значения CFG без ущерба качеству.

Обзор подготовил ❣ Дмитрий Баранчук
CV Time
1 819 просмотров · 26 реакций Открыть в Telegram · Открыть пост на сайте
Switti: Designing Scale-Wise Transformers for Text-to-Image Synthesis
Часть 1, предыстория и предшественники

Диффузионные модели уверенно занимают пьедестал почета в задаче генерации изображений по тексту. Но существует альтернативная парадигма — авторегрессионные модели, которые генерируют изображения последовательно патч за патчем (маленькими кусочками, скажем, 16x16 пикселей). На практике они работают медленнее и уступают в качестве диффузионкам, поэтому долгое время считались неконкурентоспособными.

Весной исследователи из ByteDance в работе VAR предложили альтернативную авторегрессионную парадигму для генерации изображений: из одного пикселя 1х1 генерируем картинку 2х2, потом 4х4 и так далее, причем каждое следующее разрешение предсказывается за один проход модели. В пиксельном пространстве работать все еще дорого, поэтому переходим в латентное пространство VAE, где с помощью метода Residual Quantization (RQ), представляем латентную переменную в виде пирамидки: нижние уровни соответствуют общей семантике, а верхние — мелким деталям и текстурам.

На нижних уровнях мало патчей, поэтому прогон модели дешевле. Стоимость возрастает с переходом на следующие уровни. Во время генерации модель смотрит на прошлые разрешения с помощью causal трансформера и генерирует текущее. Итоговую картинку получают, суммируя все предсказанные разрешения. Авторы добились качества, сопоставимого с современными диффузионками на ImageNet, при этом будучи значительно их быстрее.

Но генерация из фиксированного набора (1000 классов) не так интересна, как генерация по произвольным текстовым запросам. Поэтому очевидный шаг — перенести идею в более прикладной сценарий. Так появился STAR, который адаптировал подход для генерации изображений по тексту, но саму модель авторы так и не выложили. Поэтому мы решили обучить свою генеративную модель и опубликовать её в открытом доступе, чтобы стимулировать дальнейшее развитие парадигмы.

Обзор подготовил ❣ Дмитрий Баранчук
CV Time
1 775 просмотров · 25 реакций Открыть в Telegram · Открыть пост на сайте
Тематическая подборка статей: галлюцинации VLM

Сегодня пробуем новый формат — делимся целой подборкой интересных статей по теме. Забирайте в избранное и читайте полные материалы в свободное время! А в комментариях пишите, полезен ли такой формат и хотите ли вы, чтобы наши авторы разобрали одну или несколько статей подробно.

Magnifier Prompt: Tackling Multimodal Hallucination via Extremely Simple Instructions
Авторы получают на бенчмарке POPE буст, просто добавляя в промпт явную просьбу больше внимания обращать на изображение, а в случае конфликта знаний и содержимого изображения приоритизировать именно изображение.

MLLM can see? Dynamic Correction Decoding for Hallucination Mitigation
Для борьбы с галлюцинациями авторы предлагают костыльный фикс: определять, когда в средних слоях VLM уверена в ответе, и пропагейтить эти знания до финальных слоев, где они могут затираться знаниями LLM. Таким образом они исправляют ситуацию, когда по мере прохождения в более глубокие слои language bias начинает перевешивать токены изображения.

The Curse of Multi-Modalities: Evaluating Hallucinations of Large Multimodal Models across Language, Visual, and Audio
Авторы винят в галлюцинациях "Over reliance on unimodal priors" и" Spurious inter-modality correlations", а на основе своих находок делают бенчмарк для диагностики VLM.

Trust but Verify: Programmatic VLM Evaluation in the Wild
Бенчмарк со сложным пайплайном для оценки галлюцинирования: берем картинки с подробными кэпшнами, строим по ним граф сцены, подаем в LLM, которая возвращает вопросы-ответы и программы верификации для них. Авторы утверждают, что такой подход позволяет разложить модель на helpfulness и trustfulness + делают анализ по этому разбиению. Спойлер: большинство моделей оказываются хороши только по одному из этих аспектов.

Mitigating Hallucinations in Large Vision-Language Models via Summary-Guided Decoding
Авторы считают, что по мере написания кэпшна VLM все больше начинает зависеть от language prior’а, а не от изображения; при этом есть трейдофф между числом галлюцинаций и качеством текста. Для борьбы с проблемой предлагают укорачивать сгенерированный текст, а также используют дополнительную LLM.

Подборку подготовил
❣ Артём Конев
CV Time
2 264 просмотров · 32 реакций Открыть в Telegram · Открыть пост на сайте
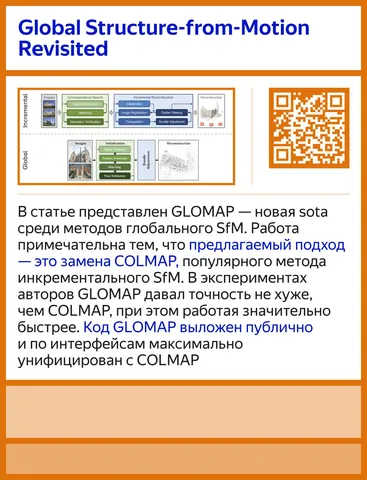
Pyramidal Flow Matching for Efficient Video Generative Modeling

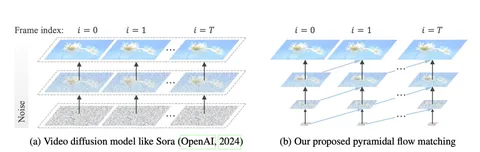
Чтобы сгенерировать видео, свежие Sora-like-модели (как на первой картинке) создают каждый кадр из чистого шума, а потом расшумляют его. Но сделать видео так гораздо сложнее, чем картинку:

1. Нужно смоделировать не одно изображение, а целую последовательность. То есть, если один кадр размером хотя бы 500 пикселей, а видео должно длиться 5 секунд с частотой 30 FPS, то нейросеть нарисует 150 кадров по 500 пикселей — потребуются значительные вычислительные мощности.
2. Sora-like-модели не авторегрессионные, а значит, не могут создать видео длиннее тех, на которых обучались. Это можно обойти трюками, например, генерируя кадры «внахлëст».

Авторы сегодняшнего препринта предлагают поступиться качеством изображений, чтобы повысить эффективность и обучения, и инференса: на низком пространственном разрешении и так много шума, а значит, можно генерировать кадры видео менее чёткими, чем обычные картинки. А ещё их модель by design использует фреймы из прошлого и поэтому в теории может предсказывать без склеек консистентные видео любой длины.

Как и все модные ребята, эти предлагают обучать модель на flow-matching-лоссе: предсказывать векторное поле пикселей. То есть, пытаться угадать, куда они сдвинутся и как изменят кадр с течением времени.

В чём же пирамидальность? Обычно для видео используют multistage-генерацию: сначала предсказывают кадры маленького разрешения, а потом апскейлят их. В препринте избавляются от multistage: моделируют все разрешения в одном лоссе.

На каждом уровне пирамиды есть своя степень зашумления, равномерно распределëнная по высоте. Внутри уровня картинка расшумляется специально предсказанным для него векторным полем. На последнем уровне шум обнуляется — получается чистый кадр.

Шум на разных уровнях пирамиды скоррелирован, чтобы добиться одинакового probability flow на всех этапах генерации и улучшить конечный результат.

Авторы не приводят сравнения с диффузионным лоссом. Как думаете, сошлось бы?

Разбор подготовил ❣ Александр Маркович
CV Time
2 621 просмотров · 28 реакций Открыть в Telegram · Открыть пост на сайте
DART: Denoising Autoregressive Transformer for Scalable Text-to-Image Generation, часть 2

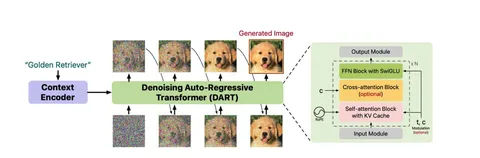
На иллюстрации к посту изображено устройство самой наивной имплементации такой модели — DART. У неё стандартный диффузионный loss, а её единственный существенный недостаток — слишком малый объём входных данных, 4000 токенов. Это накладывает ограничение на скорость обучения модели.

Обойти ограничение помогает модификация DART-AR. При этом один шаг обучения DART-AR занимает столько же времени, как и DART: сходится быстрее, но требует значительно больше времени на инференсе.

Ещё одна модификация — DART-FM, с Flow Matching. Схема усложняется: поверх основного алгоритма DART добавляют несколько прогонов простой нейросети. Эта легковесная «голова» используется на стадии инференса: для итерирования между основными шагами расшумления, чтобы повысить качество генераций.

Статья представляет скорее теоретический, чем практический интерес: инференс занимает слишком много времени, а для сравнения результатов авторы выбрали далеко не самые свежие модели.

Разбор подготовил ❣ Александр Шишеня
CV Time
2 620 просмотров · 30 реакций Открыть в Telegram · Открыть пост на сайте
DART: Denoising Autoregressive Transformer for Scalable Text-to-Image Generation, часть 1

Превратить авторегрессионную визуальную генерацию в диффузионную можно, если соблюдать три ограничения:

1. Фиксировать процесс зашумления.
2. Работать в парадигме, где модель зависит только от одного предыдущего состояния, а не от целой последовательности: тогда процесс становится Марковским.
3. Взвешивать loss на коэффициенты, которые зависят от timestamp и наложенного шума.

Авторы сегодняшнего препринта предлагают ослабить второе условие: добавить зависимость от предыдущих зашумлённых изображений. Такую модель они называют DART — Denoising Autoregressive Transformer или диффузионная авторегрессионная модель.

Саму последовательность при этом можно генерировать по-разному:

1. На каждом шаге генерировать частично расшумлëнное изображение — такой метод называется DART.
2. На каждой стадии расшумления авторегрессионно генерировать изображение по патчам — DART-AR (ДАРТ с авторегрессией).
3. Генерировать изображения, последовательно увеличивая их размер — Matryoshka-DART.
4. Кроме изображения, генерировать ещë и его текстовое описание — Kaleydo-DART.

В качестве трансформера для генерации на основе текстового промпта используется предобученная модель Flan-T5-XL, а для генерации на основе заданного класса — дополнительные слои Adaptive LayerNorm.

Разбор подготовил ❣ Александр Шишеня
CV Time
2 284 просмотров · 20 реакций Открыть в Telegram · Открыть пост на сайте
Впечатления от ECCV 2024

Мы попросили инженеров Яндекса подвести личные итоги конференции ECCV и рассказать, чем она запомнилась. О трендах в индустрии, интересных статьях и многом другом — в наших карточках.

А остальные посты по следам конференции вы можете найти в канале по тегу #YaECCV.

CV Time
2 003 просмотров · 38 реакций Открыть в Telegram · Открыть пост на сайте
Как LLaMA 3.1 работает с изображениями

Сегодня расскажем, как LLaMA 3.1 работает с изображениями. Как устроена архитектура модели, на чём её обучали и какие результаты она показывает на разных бенчмарках.

В основе энкодера изображений в Llama 3 выступает модель ViT-H/14 с 630 миллионами параметров, обученная на наборе из 2,5 миллиарда пар изображений и текстов. Картинку, полученную на вход, делят на патчи размером 16X16, прогоняют через линейное преобразование и трансформерные слои.

На выходе получается картиночное представление из 2 308 токенов, что весьма много. Эта последовательность с помощью кросс-аттеншен блоков подается в LLM. Это интересно, потому что, как правило, в мультимодальных LLM (visual language models, VLM) картиночные токены подают прямо в промпт, добавляя к текстовым. Это сделано для того, чтобы заморозить веса LLM и обучать только голубые блоки на схеме.

Тем самым не забивается исходный контекст LLM, а свойства модели на текстовом домене не теряются. Веса языковой модели остаются замороженными, чтобы сохранить производительность на текстовых задачах, то есть обновляются только веса визуального энкодера и адаптера изображений.

Что касается видео, то тут меняется количество кадров на входе: на претрейне их 16, а на файнтюне — 64. Далее их сводят к фиксированной размерности и точно так же, как с изображениями, добавляют через кросс-аттеншн в LLM.

На претрейне используют 6 миллиардов пар картинка-текст. Для фильтрации датасета убирают все описания на языках, отличных от английского, и пары с низким CLIP-скором. Дальше происходит дедупликация, чтобы исключить часто повторяющиеся картинки.

В ходе ресемплирования текстовых описаний их частотность понижают. Кроме того, в каждое описание добавляют распознанный на картинке текст — это нужно для улучшения результатов на задачах, которые требуют использования OCR.

Существует весьма необычная стадия пост-претрейна — с применением небольшого датасета на 500 миллионов сэмплов. 150 миллионов из них — это изображения вроде скриншотов с HTML-кодами и таблицами.

На файнтюне инженеры прибегают к ещё одному нестандартному трюку — hot-swap. Они подменяют веса предварительно обученной LLM на веса языковой модели, прошедшей Instruction Tuning. На SFT используют академические датасеты, ответы, написанные людьми, и синтетические данные — например, изображения, созданные из текстовых описаний.

Далее создают пары, оцененные асессорами по семибалльной шкале. Кроме того, есть процедура Rejection sampling для итеративного выбора высококачественных ответов, сгенерированных моделью. Потом авторы статьи обучают reward-модель и делают DPO, как и для текстовой модели.

Получившаяся модель на 405 миллиардов параметров показывает 80,2 пункта в бенчмарке VQAv2 и 84,8 пункта в TextVQA. При этом она уступает Claude 3.5 в DocVQA, ChartQA и AI2 Diagram.

Разбор подготовил ❣ Роман Исаченко

CV Time
3 486 просмотров · 43 реакций Открыть в Telegram · Открыть пост на сайте
Movie Gen: A Cast of Media Foundation Models

Кажется, что после ECCV 2024 только ленивый не написал о Movie Gen. Тем не менее далеко не все авторы ссылаются на оригинальный технический отчёт и описывают подробности.

Movie Gen — большая модель на 30 миллиардов параметров, которую исследователи из Meta* разработали для генерации видео. Она может создавать клипы длительностью до 16 секунд с частотой 16 кадров в секунду и разрешением 1080p. Новой модели можно доверить:

— cтандартную генерацию видео по текстовому запросу;
— персонализированную генерацию по референсному изображению;
— редактирование видео по текстовому запросу.

Movie Gen сочетает в себе несколько интересных архитектурных решений. Создатели модели:

— позаимствовали базовый трансформер у языковой модели LLaMA от той же Meta, но дополнили его блоками, специфичными для диффузионных генеративных моделей;
— обучили собственную эффективную модель, которая преобразует высокоразмерное пиксельно-временное пространство в куда более компактное латентное;
— добавили video-super-resolution-модель, которая повышает разрешение исходной генерации с 768p до 1080p;
— скомбинировали несколько моделей для кодирования текстовой информации с разными свойствами;
— использовали отдельную модель, чтобы генерировать синтетические промпты специально для видео.

На иллюстрации к посту — процедура обучения Movie Gen. Сначала модель предобучали на большом количестве изображений с низким разрешением, потом — тренировали на клипах низкого (256p) и высокого (768p) разрешения. А после всего — файнтюнили на небольшом датасете из вручную отобранных и размеченных данных высокого качества.

Для того, чтобы оценить качество модели, команда собрала примерно тысячу текстовых запросов из разных областей и сравнила качество их обработки с текущей SOTA (все closed-source) — Runway Gen3, Kling 1.5 и Sora от OpenAI. Согласно user preference study, модель от Meta превосходит конкурентов (или не уступает им) в большинстве аспектов: например, в следовании текстовому запросу, естественности и плавности движений.

В задачах персонализации и редактирования модель тоже показывает хорошее качество. Самый существенный недостаток Movie Gen — большой размер: для работы с ней потребуются значительные вычислительные ресурсы.

P. S. А ещё команда из Meta обучила модель для генерации звука и музыки — Movie Gen Audio, которая тоже представляет собой большой (на 13 миллиардов параметров) трансформер. Но это уже совсем другая история несколько иная архитектура.

Разбор подготовил ❣ Денис Кузнеделев

CV Time
___
Meta признана экстремистской организацией, а Facebook и Instagram запрещены на территории РФ
1 959 просмотров · 32 реакций Открыть в Telegram · Открыть пост на сайте
Minimalist Vision with Freeform Pixels

На ECCV-24 была секция, посвящённая низкоуровневому устройству систем компьютерного зрения. По настоящему low-level решение предложили в статье Minimalist Vision with Freeform Pixels, которая получила награду Best Paper Award. Авторы создали прототип полностью автономной по электропитанию камеры.

Вместо обычных матриц в камере используются 24 фотодиода. Перед каждым из них установлена маска-фильтр, которая выступает первым слоем нейросети. Оптическая передаточная функция маски зависит от задачи, под которую обучена камера.

По сути первый слой обеспечивает произвольную форму для каждого пикселя — против фиксированной квадратной у традиционных камер. А последующие слои выводят результат задачи. Так авторы демонстрируют возможность мониторинга рабочего пространства и оценки дорожного трафика при помощи всего лишь 8 пикселей из 24.

Кроме того, камера хорошо показала себя в задаче оценки освещённости помещения. Используя те же 8 пикселей, она сумела определить, какие из источников света были включены в каждый конкретный момент. При этом ни один из источников не был виден камере напрямую — она собирала информацию исходя из состояния помещения.

Помимо низкого энергопотребления, такой подход позволяет обеспечивать конфиденциальность людей в кадре, так как записываемой оптической информации недостаточно для восстановления деталей изображения. Прототип камеры оснащён микроконтроллером с Bluetooth. А с четырёх сторон расположены солнечные панели для получения электроэнергии.

Разбор подготовила ❣ Алиса Родионова
CV Time
9 592 просмотров · 42 реакций Открыть в Telegram · Открыть пост на сайте
Making LLaMA SEE and Draw with SEED Tokenizer

LLaMA — семейство больших языковых моделей от Meta AI, которые до недавнего времени понимали только текстовые запросы и не умели обрабатывать изображения.

Популярный подход к тому, чтобы загрузить в такую модель картинку — закодировать изображение в вектор специальным энкодером, привести адаптером в нужную размерность и подать результат на вход нейросети так же, как и текст. А LLaMA вернёт ответ на естественном языке. Например, посчитает для вас яблоки на загруженном фото.

Так можно решить задачу распознавания, но объединить еë с чем-то другим, например, с генерацией изображений уже не получится.

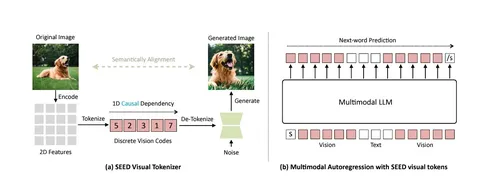
Авторы сегодняшней статьи попробовали это исправить: добавить к обычной LLaMA токенайзер SEED, чтобы она могла не только распознавать, что изображено на картинке, но и генерировать что-то новое на основе входных данных.

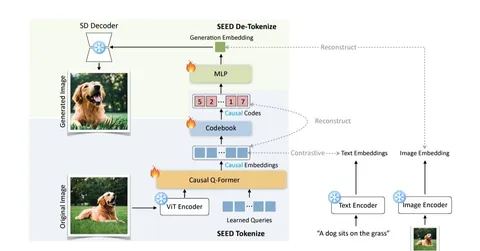
Суть похода — на схемах. Сначала авторы в несколько стадий обучают картиночные токены на VQ-кодбуках — так токен сразу получает причинное свойство и его остаëтся только векторизировать. Интересно, что сначала обучается именно SEED tokenizer, а после того, как он будет готов, языковую VLM-модель отдельно обучают предсказывать следующие токены, в том числе новые картиночные.

А дальше детокенайз — через кодбук дискретные коды превращают обратно в вещественные вектора и подают в диффузионную нейросеть.

Комбинация LLaMA + SEED напоминает по архитектуре EMU. Но если вы внимательно прочитаете статью, о которой я рассказываю, то легко заметите отличительную особенность: множество красивых картинок с результатами, но очень плохие VLM-метрики. Мне удалось пообщаться с авторами, и они честно ответили, что сейчас метрики — не их сильная сторона. Но они продолжают улучшать токенайзер и уже подали на конференцию новую версию — SEED-X. Им удалось избавиться от кодбуков: обучают диффузионную нейросеть теперь на визуальных эмбеддингах.

Разбор подготовил ❣ Андрей Чернов
CV Time
1 839 просмотров · 40 реакций Открыть в Telegram · Открыть пост на сайте
ECCV 2024 — всё!

Это было круто, познавательно и насыщенно. Спасибо, вам, что читали, и спасибо нашим экспертам, которые рассказывали о самых интересных статьях, докладах и воркшопах. Их вы можете найти на канале по хэштегу #YaECCV.

Но это ещё не всё — совсем скоро мы вернёмся с впечатлениями от конференции из первых уст. Ну и, конечно, с новыми разборами статей о CV. Оставайтесь с нами!
1 595 просмотров · 17 реакций Открыть в Telegram · Открыть пост на сайте
Новая порция материалов с ECCV 2024

В последний день конференции принесли ещё несколько статей, которые точно заслуживают внимания.

TurboEdit: Text-Based Image Editing Using Few-Step Diffusion Models

Статья о редактировании реальных изображении при помощи text2image дифузионных моделей. В основе работы лежат два наблюдения:

1. При равных сидах редактирование длинных текстовых промптов заметно меньше влияет на изменение общей композиции генерации, в отличие от манипуляций с короткими промптами. Это объясняется меньшей магнитудой изменения в cross-attention-слоях.

2. Одношаговые генеративные модели вроде SDXL Turbo не сталкиваются с трудностями в оптимизационной задаче инверсии, а также позволяет проводить манипуляции с attention-картами для редактирования изображения.

Совмещение этих идей даёт оптимизационный процесс, который учит инвертирующую модель. С её помощью получается начальный шум, для которого запускается процедура расшумления исходной моделью с редактированным промптом, чтобы получить редактированную генерацию.

Для улучшения реконструкции предлагается два подхода. Вместо одношаговой модели обучать многошаговую refiner-модель в стиле ReStyle. Либо можно маскировать attention-карты для локализации изменений.

EDICT: Exact Diffusion Inversion via Coupled Transformations

Авторы предлагают новый семплер для редактирования картинок на основе текстовой инверсии. Суть в том, что для для интегрирования используют результаты предыдущего и следующего шага. При этом не добавляют вычислительного оверхеда, потому что результаты и так получаются естественным образом. В сравнении с DDIM-инверсией такой подход даёт почти идеальное восстановление.

Be Yourself: Bounded Attention for Multi-Subject Text-to-Image Generation

Работа о multi-subject grounded генерации. Поднимается всем известная проблема «запутанности» семантически похожих концептов, происходящей в аttention-блоках. Авторы предлагают использовать пространственную информацию карт внимания не только для маскирования «соседних» конкурирующих токенов, но и для guidance во время инференса модели. А кроме того — смещать диффузионную траекторию по направлению, максимизирующему концентрацию attention в заданном bounding box для соответствующего объекта в промпте.

ReGround: Improving Textual and Spatial Grounding at No Cost

Статья, в основе которой архитектурный анализ сети. В качестве базовой авторы рассматривают очень популярную в своё время модель GLIGEN — она позволяет добавлять дополнительное условие на пространственное расположение объектов на генерации посредством bounding box.

Исследователи обратили внимание на последовательный характер внедрённого в сеть блока gated self-attention, который отвечает за grounding-токены. Подобный архитектурный выбор нарушает ожидаемое распределение входа в cross-attention-модуль и тем самым нарушает текстовую составляющую условной генерации.

Простая перестановка с последовательного соединения на параллельное решает проблему и позволяет найти компромисс для соответствия обоим условиям. Это также улучшает и все существующие работы, использующие GLIGEN в качестве составляющей метода.

ReCON: Training-Free Acceleration for Text-to-Image Synthesis with Retrieval of Concept Prompt Trajectories

В статье рассматривается метод ускорения генераций с прицелом на продакшн и способом, основанном на кешировании некоторых x_t генераций отдельных концептов. Суть в том, чтобы брать комплексные длинные промпты, разбивать их на концепты, отфильтровывать не визуальные, а потом делать частичную генерацию до шага t и помещать результат в базу.

Для генерации картинки по полному промпту, нужные частичные генерации складывают, а остаток траектории — генерируют отдельно. Авторы завяляют, что ускорение составляет в среднем 30% без сильной потери в качестве.

Поделились любопытным ❣ Александр Устюжанин и Сергей Кастрюлин

#YaECCV

CV Time
1 609 просмотров · 12 реакций Открыть в Telegram · Открыть пост на сайте
⚡️Прямое включение с ECCV 2024

Наш специальный корреспондент Дарья Виноградова заметила роботов, похожих на собак, и постеры со статьями. Наступил последний день конференции, но нам ещё есть, что рассказать!
1 334 просмотров · 19 реакций Открыть в Telegram · Открыть пост на сайте