Kuaishou: обзор ключевых статей и техрепортов

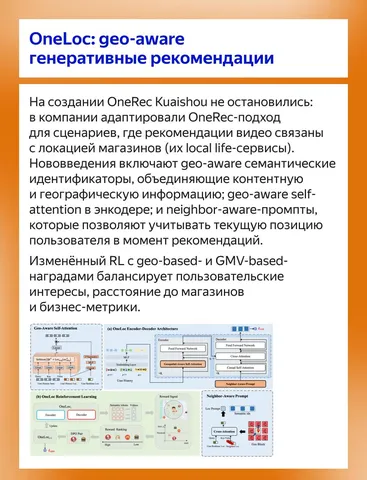
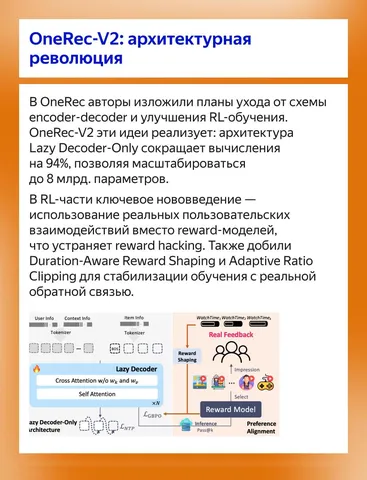
Собрали в карточках краткие описания семи больших работ Kuaishou, включая те, на основе которых вырос OneRec и его продолжения.

Материал поможет быстро сложить в голове картину того, как компания шаг за шагом пришла к созданию первых генеративных рекомендательных систем в индустрии.

Ссылки на работы, упомянутые в посте:

— OneRec: Unifying Retrieve and Rank with Generative Recommender and Iterative Preference Alignment
— OneRec Technical Report
— OneRec-V2 Technical Report
— QARM: Quantitative Alignment Multi-Modal Recommendation at Kuaishou
— TWIN V2: Scaling Ultra-Long User Behavior Sequence Modeling for Enhanced CTR Prediction at Kuaishou
— Pantheon: Personalized Multi-objective Ensemble Sort via Iterative Pareto Policy Optimization
— OneLoc: Geo-Aware Generative Recommender Systems for Local Life Service

@RecSysChannel
Обзор подготовил ❣ Владимир Байкалов
2 005 просмотров · 29 реакций Открыть в Telegram · Открыть пост на сайте
PinRec: Outcome-Conditioned, Multi-Token Generative Retrieval for Industry-Scale Recommendation Systems

Сегодня разбираем статью от Pinterest о модели PinRec. В индустрии существуют два основных подхода к transformer-based retrieval. Первый — классическая двухбашенная схема: трансформер анализирует пользовательскую историю и сжимает её в эмбеддинг, с которым затем обращаемся к HNSW-индексу, построенному на айтемных эмбеддингах. Второй подход — появившиеся относительно недавно генеративные модели, в которых трансформер порождает непосредственно список айтемов, релевантных для данного юзера, например генерируя их в виде последовательностей семантических айдишников.

В модели PinRec авторы совмещают обе парадигмы и получают нечто среднее: с одной стороны, трансформер генерирует последовательность, однако это последовательность не айтемных идентификаторов, а сырых эмбеддингов, с каждым из которых затем ходим в HNSW-индекс для поиска ближайших айтемных эмбеддингов.

В базовой версии модель представляет собой трансформер с каузальной маской, авторегрессивно предсказывающий каждый следующий айтем, с которым провзаимодействовал пользователь, при условии его предыдущей истории. Учится модель на sampled softmax loss с logQ-коррекцией и mixed-negative sampling (используются in-batch и random-негативы). На инференсе предсказываем по истории пользователя эмбеддинг следующего айтема, дописываем его в сыром виде в конец истории и повторяем такой процесс несколько раз — в результате генерируем последовательность эмбеддингов и от каждого из них набираем ближайшие айтемы в HNSW-индексе.

Помимо указанного совмещения парадигм ключевые новшества статьи — это две идеи, навешиваемые поверх базовой версии модели.

Во-первых, авторы предлагают способ, при помощи которого можно обуславливать генерацию на желаемые действия пользователя — не прибегая к SFT и RL. При предсказании следующего айтема будем давать модели информацию о действии, совершенном юзером с этим айтемом. А именно, будем конкатить выход из трансформера, сжимающий предыдущую историю, с эмбеддингом действия и уже из этого конката предсказывать следующий айтем. Такая схема позволяет на инференсе подставить эмбеддинг нужного нам действия и предсказать наиболее вероятные айтемы при условии этого действия.

Во-вторых, авторы замечают, что взаимодействия пользователя с айтемами в сервисе совершенно не обязательно имеют строго последовательную логику и жёсткую очередность. А задача next item prediction как раз предполагает, что для каждой предыстории есть ровно один верный предикт — тот айтем, с которым пользователь провзаимодействовал следующим.

В статье предлагается изменить постановку задачи: важно угадать не в точности следующий айтем, а хотя бы один из будущих айтемов в некотором временном окне. Для этого вводится такая модификация лосса — обычный sampled softmax loss посчитаем по всем айтемам в этом окне и затем возьмём минимум из полученных значений. Тогда и на инференсе можно предсказывать не по одному эмбеддингу за раз, а сразу целыми окнами. В статье утверждается, что это повышает и качество, и разнообразие кандидатов, а за счёт генерации целыми окнами значительно ускоряет инференс.

Авторы репортят, что описываемая ими модель внедрена как один из кандидатогенераторов в Pinterest на весь их внушительный industrial scale. При этом получены значимые приросты онлайн-метрик: на поверхности homefeed +0,28% fulfilled sessions, +0,55% timespent и +3,33% кликов.

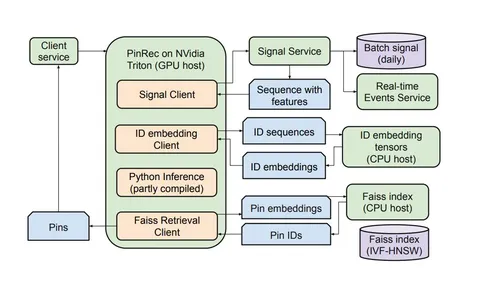
Помимо архитектурных идей статья содержит интересные детали сервинга модели в продакшене (используется Triton Inference Server с Python-бэкендом). Также авторы сравнивают в своём сетапе трансформер с архитектурой HSTU (не в пользу последней), проводят эксперименты со скейлингом трансформера вплоть до миллиарда параметров и репортят, что добавление в модель таблицы id-based-эмбеддингов с 10 миллиардами параметров докидывает +14% к recall@10 поверх только контентных эмбеддингов.

@RecSysChannel
Разбор подготовил ❣ Сергей Лямаев
2 238 просмотров · 25 реакций Открыть в Telegram · Открыть пост на сайте
Подборка статей с RecSys 2025

Делимся ещё несколькими работами, которые показались любопытными инженерам Яндекса. В сегодняшней подборке: диффузионки, которые генерируют целые плейлисты, борьба с cold start, обучение семантических ID на все задачи сразу и презентация с иллюстрациями из мультика «Холодное сердце».

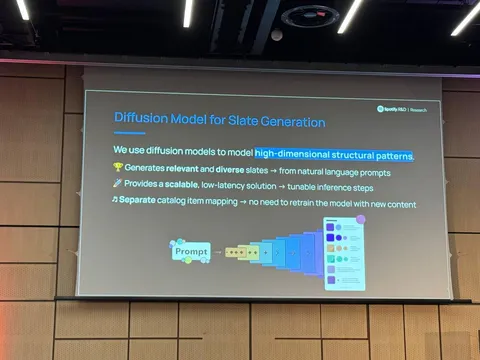
Prompt-to-Slate: Diffusion Models for Prompt-Conditioned Slate Generation

Авторы представили DMSG — диффузионную модель для генерации целых наборов контента (плейлисты, корзины товаров) по текстовому запросу. Ключевая идея: вместо ранжирования отдельных элементов сеть учится порождать весь слейт целиком.

Каждый объект каталога кодируется вектором-эмбеддингом. Слейт фиксированной длины представляют как конкатенацию этих векторов. Текстовый промпт кодируется трансформером и подаётся в Diffusion Transformer через cross-attention. Диффузионная часть пошагово «разшумляет» случайный вектор в латент слейта. Готовые латенты проецируются в ближайшие объекты каталога с фильтрацией дублей.

Такой подход даёт согласованность набора, стохастичность и разнообразие (несколько валидных слейтов для одного промпта). В экспериментах на музыкальных плейлистах и e-commerce-бандлах модель показала до +17% по NDCG и +6,8% взаимодействий в онлайне.

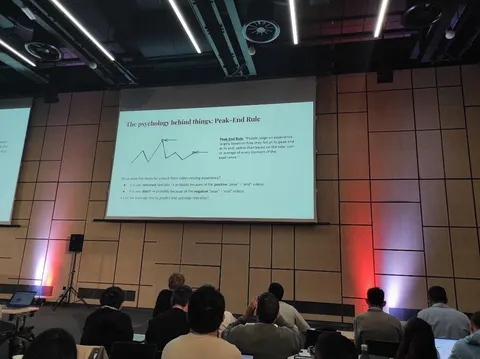
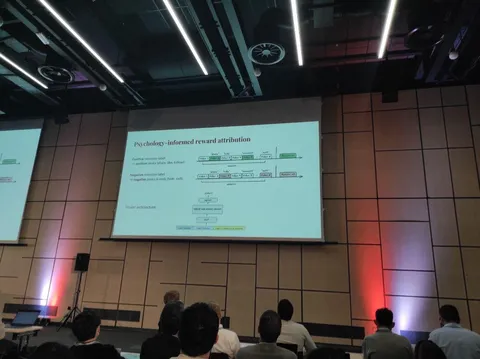
Not All Impressions Are Created Equal: Psychology-Informed Retention Optimization for Short-Form Video Recommendation

Хорошая идея для рексистем с плотным пользовательским сигналом. В таргет ставится ретеншн (вернётся ли пользователь в сервис завтра), а в текущей сессии выделяются пиковый и последний документы — психологически именно они запоминаются и влияют на решение вернуться. Для поиска пика используют как положительные, так и отрицательные взаимодействия в сессии.

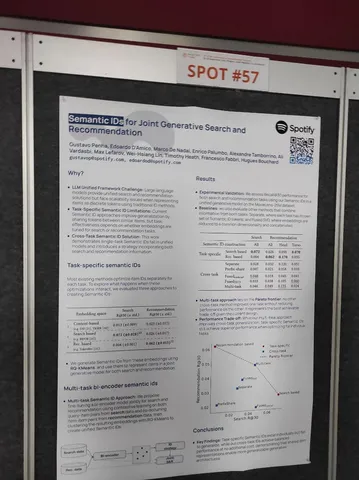
Semantic IDs for Joint Generative Search and Recommendation

Довольно простая, но, скорее всего, рабочая мысль — учить семантические ID документов сразу на все задачи. По сути то же, что и обучение многоголовых сетей, только применительно не к эмбедам, а к семантической токенизации документов.

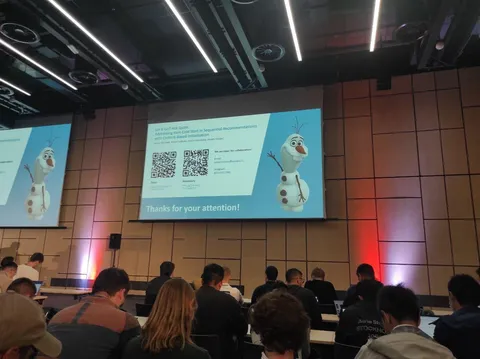
Let it Go? Not Quite: Addressing Item Cold Start in Sequential Recommendations with Content-Based Initialization

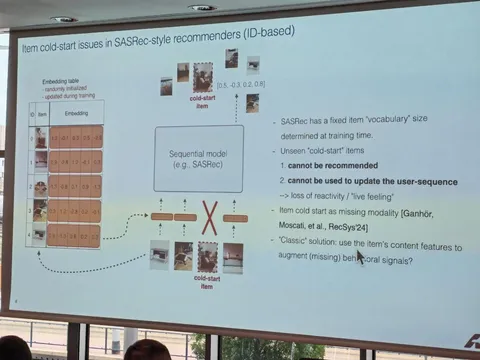
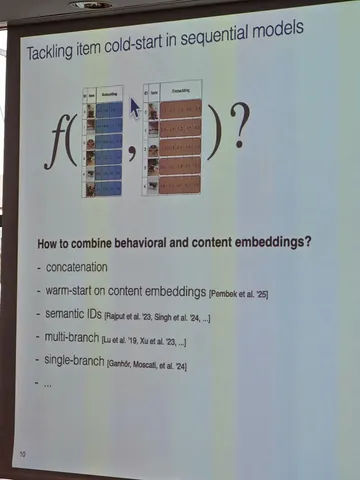
Авторы сначала учат эмбеддинги документов только на контенте, а затем доучивают на ID, контролируя, чтобы норма изменения эмбеддинга оставалась малой. Говорят, это хорошо работает на «холодных» документах, и при этом на «горячих» качество почти не проседает. А ещё в презентации статьи были шикарные иллюстрации с героями из мультика «Холодное сердце».

@RecSysChannel
Статьи выбрали ❣ Александр Шуваев и Андрей Мищенко
1 683 просмотров · 15 реакций Открыть в Telegram · Открыть пост на сайте
Новые впечатления с RecSys 2025

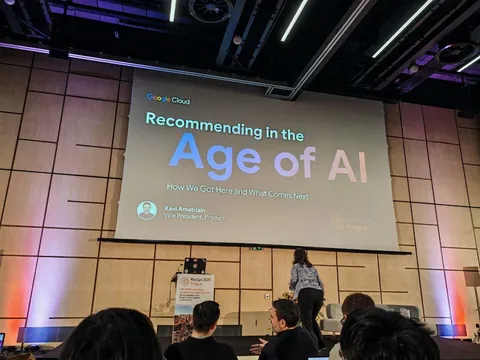
Продолжаем смотреть на конференцию RecSys глазами инженеров Яндекса. Сегодня подсветим три интересные работы и вдохновляющий keynote от Xavier Amatriain.

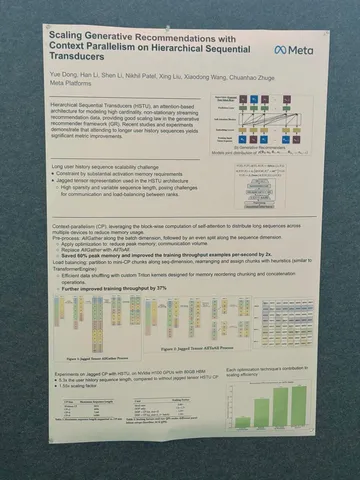
Scaling Generative Recommendations with Context Parallelism
on Hierarchical Sequential Transducers

Авторы рассказали, как наращивают длину пользовательской истории при обучении HSTU-моделей. Оказалось, что использование истории длиной более 10 К событий всё ещё даёт прирост продуктовых метрик. Работа исключительно инженерная, но полезная для масштабирования используемых длин в истории.

Исследователи используют подход context parallelism: шардинг q/k/v по длине последовательностей в батче на P частей. При вычислении аттеншна ключи и значения нужно агрегировать со всех частей. Вместо стандартной схемы all-gather предлагают использовать all-to-all, чтобы пересылать только нужные блоки. Как итог, память под активации и KV-кэш на каждом GPU снизилась в ~1/P, а поддерживаемая длина истории выросла с 3 K до 16 K токенов.

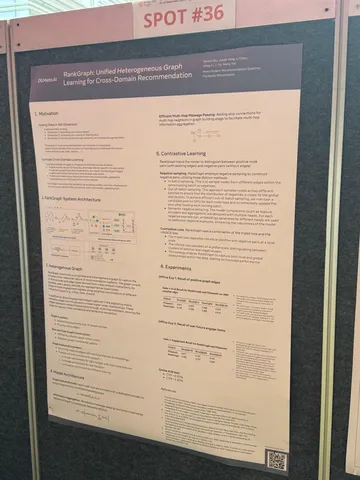
RankGraph: Unified Heterogeneous Graph Learning for
Cross-Domain Recommendation

На конференции прозвучало несколько докладов о графовых нейросетях (GNN), но особенно выделился этот. В онлайновых A/B-тестах решение показало рост продуктовых метрик: +0,92% к кликам и +2,82% к конверсиям.

Для построения графа используются все доступные поверхности — лента, видео, рекламные объявления. Формируется единый гетерогенный граф, включающий пользователей и айтемы из разных доменов. Модель основана на RGCN (Relational Graph Convolutional Network) и обучается на contrastive-лоссы (triplet loss и InfoNCE). Для каждого отношения (типа ребра) агрегируются сообщения от соседей этого типа; затем результаты объединяются через «mixer» и обновляют представление узла.

Ключевой момент — сохранение самопетель (self-loop), чтобы прежнее представление узла также учитывалось при обновлении. Модель используется как для кандидат-генерации (user-to-item и item-to-item), так и как источник эмбеддингов пользователей и объектов, которые затем передаются в другие доменные модели в качестве фичей.

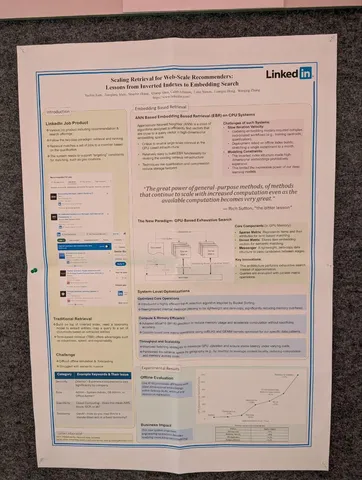
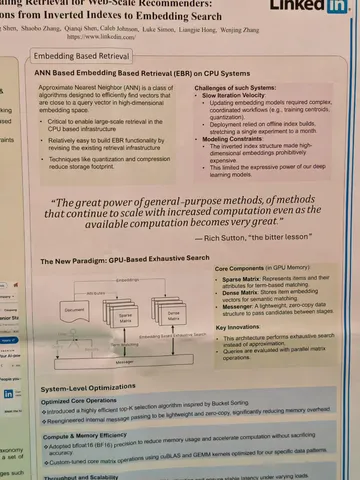
Scaling Retrieval for Web-Scale Recommenders: Lessons from Inverted Indexes to Embedding Search

LinkedIn поделились историей эволюции своей retrieval-системы. Начинали, как многие, с инвертированных индексов: решение быстрое и объяснимое, но требует ручного тюнинга (query expansion, переписывание запросов). Сверху добавили ML — learning to retrieve, графовые методы, атрибутные связи. Это помогало, но ограничения оставались: много ручной работы, оффлайн-билд индекса раз в неделю, больно интегрировать эмбеддинги.

Следующий шаг — embedding-based retrieval на ANN внутри старой системы. Но с такой архитектурой тяжело экспериментировать: квантование портило качество, CPU не тянуло, итерации шли медленно.

Решение — построить с нуля GPU retrieval-систему. Теперь это огромные sparse/dense матрицы в GPU-памяти без «костыльного» ANN. KNN считается честно и быстро, а терм-поиск и эмбеддинги можно гибко комбинировать. Внедрили множество оптимизаций: кастомные CUDA-кернелы, bfloat16, батчинг, шардирование по регионам.

Результаты: –75% инфраструктурных затрат и +30% к скорости экспериментов. В продакшене на кейсе job-matching это дало +4,6% к числу поданных заявок и +5,8% к budget utilization в промовакансиях.

Главный инсайт: inverted index хороши для классического поиска, но в современных ML-рексис они быстро достигают потолка. GPU-based EBR (Embedding-Based Retrieval) даёт гибкость и multi-objective-оптимизацию уже на этапе retrieval, а значит — приносит больше пользы для бизнеса.

Напоследок — впечатление от выступления Xavier Amatriain, посвящённого комплексному подходу к развитию рекомендательных систем:

Главный тезис: нельзя сильно вырасти, если сосредотачиваться на улучшении одной метрики. Развитие должно охватывать сразу несколько уровней — пользовательский опыт, в том числе с применением генеративного AI, алгоритмический стек рекомендаций и сам продукт.

@RecSysChannel
Заметки собрали ❣ Александр Шуваев, Влад Тыцкий, Артём Ваншулин
1 727 просмотров · 19 реакций Открыть в Telegram · Открыть пост на сайте
Продолжаем делиться работами с RecSys 2025

Второй день конференции запомнился нам не только выступлением Александра Плошкина с oral'ом о датасете Yambda, но и интересными статьями. Некоторые из них собрали в этом посте.

LONGER: Scaling Up Long Sequence Modeling in Industrial Recommenders

Авторы из ByteDance обучают модель в неавторегрессивном режиме на 10 000 событий, используя 10 000 GPU. Поскольку исследователи не связаны авторегрессивной схемой обучения (HSTU, Argus), они используют глобальные токены с эмбеддингом пользователя, счётчиками и т. п. Также применяется target-aware-подход: эмбеддинг целевого товара подаётся как глобальный токен.

В первом слое задействован cross-attention: в запросах (query) — глобальные токены и последние события, в ключах (key) — вся последовательность. Таким образом, последовательность сжимается до числа query-токенов на выходе слоя cross-attention. Далее идут стандартные слои self-attention с каузальной маской. Каузальная маска нужна, чтобы на инференсе переиспользовать KV-кэш.

Enhancing Embedding Representation Stability in Recommendation Systems with Semantic ID

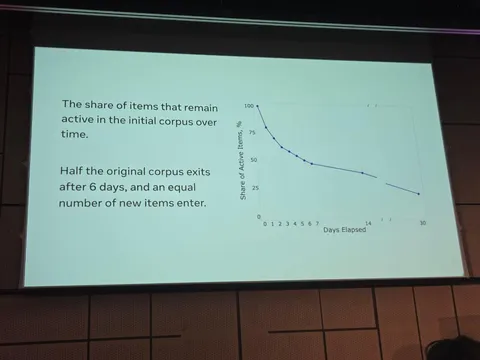
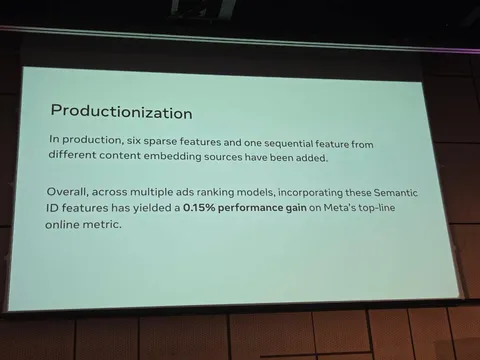
Исследователи рассказали, как применяют семантический ID для повышения стабильности рекламных моделей. В рекламе крайне неравномерное распределение айтемов в датасете, к тому же они быстро меняются (примерно половина корпуса обновляется за шесть дней). Поэтому модели с обычными или случайными ID со временем деградируют.

Как решение предложен семантический ID, который создаётся на основе контента объявления (текста и картинок). В продакшене он генерируется из шести уровней иерархии (codebooks), из которых составляется префикс разной длины. Это позволяет похожим по смыслу объявлениям «обмениваться знаниями» и улучшает офлайн-метрики для новых айтемов и для хвоста распределения. Наибольший выигрыш виден в моделях, анализирующих историю взаимодействий пользователя.

Чтобы оценить влияние на стабильность, замеряют изменение скора модели при замене ID на его точную копию. В онлайне показано, что использование семантического ID снижает изменение скора на 43%. Итог: рост целевой метрики на 0,15%.

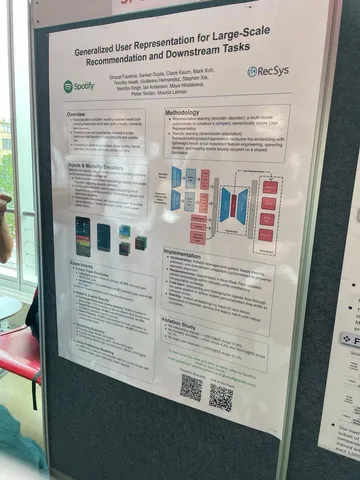
Generalized User Representations for Large-Scale Recommendations and Downstream Tasks

Интересный постер от Spotify. Авторы дообучают модели с дневным и даже более коротким интервалом. Для аудио и коллаборативных эмбеддингов используются одинаковые по размерности векторы — всего 80. При этом исследователи отмечают, что без стабилизации выходных эмбедов (как для аудио, так и для коллаборативных) система вообще не работала.

Отдельно видно, что старых пользователей специально не обрабатывают: модель всё ещё пытается восстанавливать очень давний онбординг, хотя это иногда даёт негативный эффект. Вероятно, основной акцент сделан на работу с холодными пользователями.

Любопытно, что для обучения используется автоэнкодер, причём его тренируют ежедневно всего на одном дне данных. Для аудиоэмбедов применяется трансформер-энкодер с выборкой из истории, чтобы оставить только наиболее релевантные треки.

@RecSysChannel
Работами поделились ❣ Александр Шуваев, Пётр Зайдель, Даниил Бурлаков
1 319 просмотров · 20 реакций Открыть в Telegram · Открыть пост на сайте
Что обсуждают на RecSys 2025

Прямо сейчас в Праге проходит 19-я международная конференция о рекомендательных системах. По традиции, делимся с вами самым интересным. Вот как прошли воркшопы, на которых побывали наши коллеги.

Practical Bandits: An Industry Perspective
Этот доклад мы услышали на воркшопе CONSEQUENCES’25. Сначала спикеры разобрали различия между off-policy- и on-policy-стратегиями и подробно рассказали, что такое importance weighting, Inverse Propensity Scoring (IPS) и для чего они используются. А потом перешли к сбору данных:

— Показали методы сбора: ε-greedy, softmax и гибридный подход.
— Ввели effective sample size — оценку того, сколько данных нужно собрать.
— Уточнили, какие данные необходимо логировать: контекст, все возможные и выбранные действия, награду и распределение вероятностей.

После этого перешли к тому, что делать, если некоторые действия блокируются (например, из-за бизнес-логики) и как выявлять смещение с помощью control variates.

Отдельно отметили проблему symbiosis bias — явление, когда разные политики начинают зависеть друг от друга из-за обучения на всех данных что есть. А завершили всё обсуждением большой кардинальности множества действий и решениям проблем, которые из-за этого возникают.

Gen AI for E-commerce
Докладов было много. Несколько спикеров поделились опытом того, как используют LLM в E-com: генерируют фичи для классического ML, пишут заголовки для e-mail-рассылок, создают поисковые саджесты, размечают данные для active learning, собирают системы из нескольких агентов, чтобы генерировать тексты, привлекающие пользователей.

Доклады интересные, где-то перекликаются с тем, что мы пробуем делать в Яндекс Go. Но ни в одном из выступлений не услышал, как применение LLM бустит метрики, связанные с деньгами — в лучшем случае менялись прокси-метрики.

Как я понял (и уточнил на стендах), самое популярное решение — не хостить LLM самим, а ходить в API готовых ИИ и платить за токены. Было весело, когда у докладчика, который рассказывал про LLM для active learning, спросили, сколько они потратили на OpenAI API — в выступлении упоминалось 1+ млн запросов.

Немного удивило, что существенная часть докладчиков не тестировала свои решения в A/B, только планирует сделать это в будущем.

На конференции в этом году — не протолкнуться. Кому-то даже пришлось обедать на лестнице. Кто знает, может, именно эти воркшопы коллеги обсуждают за трапезой 👀

@RecSysChannel
Суммаризировали для вас воркшопы ❣ Михаил Сёмин и Алексей Ельчанинов
Сгенерировал фото ❣ Андрей Мищенко
1 481 просмотров · 32 реакций Открыть в Telegram · Открыть пост на сайте
RecSys 2025: интересные статьи первого дня

Вчера в Праге стартовала конференция RecSys 2025. Первый день был посвящён в основном воркшопам. В промежутках можно было посмотреть постеры и пообщаться с авторами. Именно этим занимались инженеры Яндекса, которые уже разобрали несколько интересных работ.

In-Context Learning for Addressing User Cold-Start in Sequential Movie Recommenders

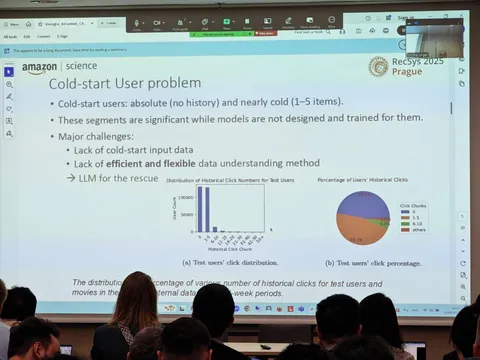
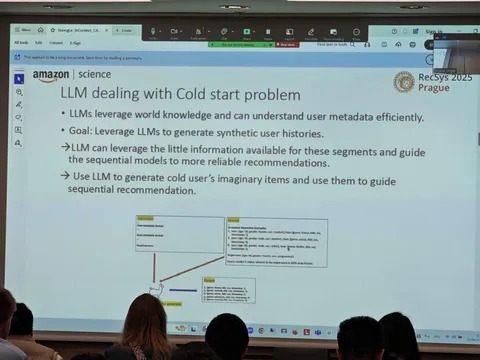
Авторы из Amazon используют sequential models (модели, основанные на цепочке событий пользователя) для задачи рекомендации видео, так как такие модели дают лучшее качество. В своих подходах указывают Recformer, SASRec, GRU4Rec, Tiger, Liger. Однако подобные модели чувствительны к проблеме холодного старта. Когда у пользователя ещё нет никакой истории, что ему показать? По данным авторов, таких пользователей — большинство: 47%, а еще 46% — имеют длину истории до пяти событий.

В качестве решения исследователи предлагают добавить к реальной истории пользователя выдуманную LLM (imaginary interactions). Её получают с помощью специально подготовленного промпта. Причём утверждают, что не так страшно, если модель сгаллюцинирует и вернёт несуществующие фильмы, так как это не финальная последовательность. Затем происходит объединение выдуманной истории с реальной. В работе используют два подхода:

— early fusion — просто объединяют выдуманную историю с реальной (последняя — реальная), формируя одну длинную последовательность;
— late fusion — генерируют k последовательностей независимо, каждую продолжают реальной, а потом делают avg pooling над эмбедами.

В экспериментах авторы репортят два датасета: публичный the MovieLens 1M и проприетарный the Amazon Proprietary. Early fusion лучше себя показал на публичном датасете, причём бустит он именно «холодных» пользователей, тогда как на более «горячих» его влияние пропадает. А вот на проприетарном датасете лучше сработала late fusion. Это объясняют тем, что подход добавляет разнообразия выдаче.

Следующие шаги:
— из k произвольных фильмов заданного жанра предложить LLM выбрать подходящий;
— добавить RAG;
— собирать информацию для «холодных» пользователей путём опроса.

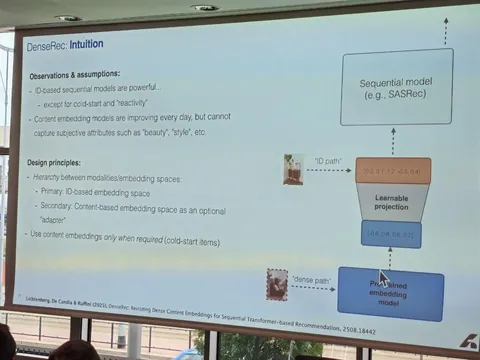
DenseRec: Revisiting Dense Content Embeddings for Sequential Transformer-based Recommendation

Основные идеи:
— SASRec хорошо работает, но плохо справляется с cold items. Надо поправить эту проблему (другие подходы, например, semantic IDs требуют сильного изменения всего пайплайна).
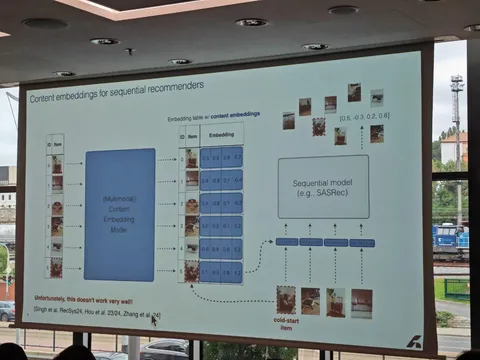
— Предлагается использовать контентные фичи. Но замена «в лоб» просаживает качество.
— Предлагается выучить модель, которая будет работать поверх всё той же embedding table по ID в части случаев, но также научиться переводить в это пространство контентные фичи.
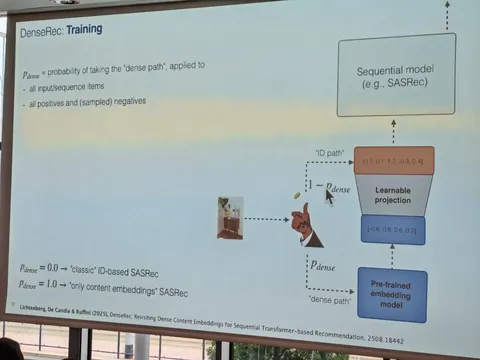
— Формально при обучении подбрасывают монетку для каждой позиции в последовательности айтемов, с вероятностью p берут эмбед из таблицы эмбеддингов, с вероятностью (1-p) берут конктентные фичи и с помощью простой модели (в данном случае — линейной проекции) переводят контентные эмбеды в пространство обычных.
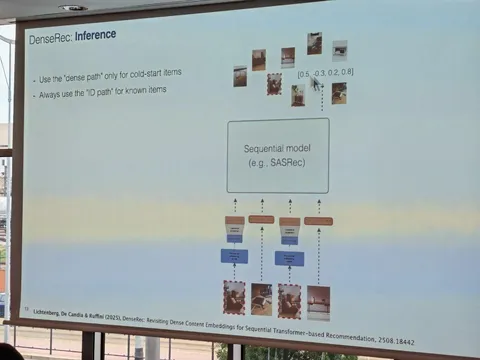
— При инференсе для знакомых ID всегда используют таблицу эмбедов, для новых — конкретные фичи и линейный слой проекции.
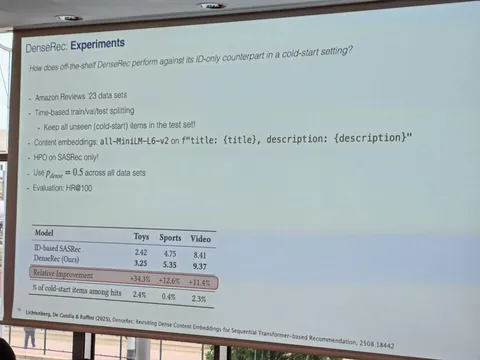
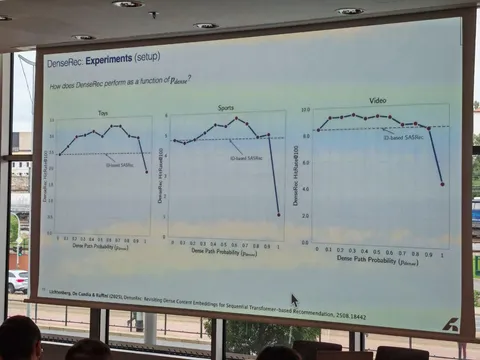
— В экспериментах на датасете Amazon авторы показывают значимое улучшение метрик, причём основной прирост — не на «холодных» документах. Авторы объясняют это тем, что подход обучения с использованием контентных фичей не только улучшает их представление (new items as target), но и улучшает качество самой последовательности (new items in the sequence).

@RecSysChannel
Статьи заметил ❣ Артём Ваншулин
1 486 просмотров · 27 реакций Открыть в Telegram · Открыть пост на сайте
Large Foundation Model for Ads Recommendation

Сегодня разбираем свежую статью Tencent с интригующим названием, содержащим слова large и foundation. Обращает на себя внимание и список авторов: он очень длинный, что обычно указывает на масштабный внутренний проект, важный для компании.

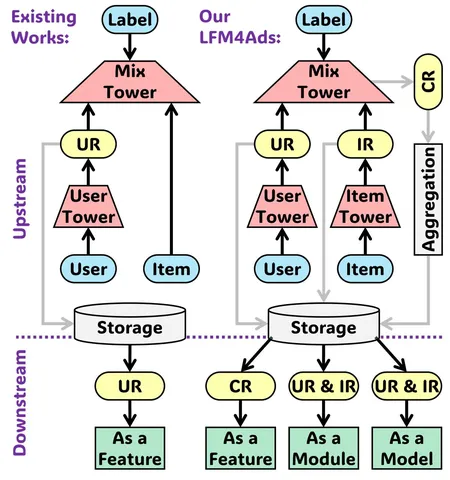
В работе предлагают инкорпорировать большую вычислительно дорогую foundation-модель в более компактные CTR-модели ранжирования. Но авторов не устраивает простое подключение выходов в качестве эмбеддингов или скалярных признаков. Инженеры хотят использовать знания большой модели более умным способом, сохраняя эффективность в проде.

Авторы пишут, что обычно большие foundation-модели используют только user-представления, игнорируя другие важные сигналы. Предлагается перенести в downstream-модель все три вида: user-, item- и user-item-представления.

Напрямую работать с сырыми кросс-представлениями невозможно: они жёстко привязаны к конкретным парам user–item, и для каждой такой пары пришлось бы вычислять большую модель в онлайне. Именно этого авторы стараются избежать, предлагая обновлять и хранить агрегированные user- и item-векторы асинхронно.

Интересная находка: лучшие результаты даёт не использование последнего слоя модели, а извлечение представлений из предпоследнего, хотя замеры противоречивые — на графиках виден шум.

Архитектура Triple Tower

Для обучения используется так называемый triple tower design:
— user-башня,
— item-башня,
— mix-tower для их взаимодействия.

При этом архитектура разделена на две ветви (dual-branch design): одна обучается на органическом контенте (просмотры, лайки, комментарии), другая — на рекламных сэмплах (клики, конверсии). User- и item-вектора остаются общими, а cross-вектор извлекается только из рекламной ветви, так как он ближе к целевым downstream-задачам.

Авторы описывают три способа интеграции foundation-модели в downstream CTR-модель: добавление представлений в качестве новых фичей, подключение блока обработки внутри архитектуры, использование всей большой модели для генерации кандидатов.

Простое добавление эмбеддингов в downstream-модель работает плохо: пробовали и линейные проекции, и alignment-лоссы, но улучшений не добились. Вместо этого применяют другой приём: каждую входную фичу комбинируют с представлением из foundation-модели с помощью покомпонентного умножения и нелинейности. Таким образом, user-item-вектор встраивается в модель уже на уровне входных признаков.

Эксперименты и результаты

Валидацию делали только на внутренних данных Tencent: больших датасетах с рекламными и органическими действиями, онлайн-A/B-тестах. Авторы пишут что систему внедрили уже в десяти с лишним продуктах экосистемы и получили рост GMV на 2,45% по всей платформе.

Больше о внедрении фундаментальных моделей применительно к экосистеме Яндекса можно узнать в канале руководителя службы рекомендательных технологий Николая Савушкина — @light_from_black_box.

@RecSysChannel
Разбор подготовил ❣ Николай Савушкин
2 025 просмотров · 26 реакций Открыть в Telegram · Открыть пост на сайте
RecGPT Technical Report, 2/2

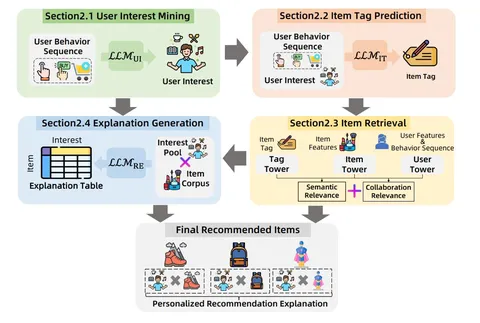
В первой части разбора рассказали об идее и результатах RecGPT. Теперь — детали реализации. Как мы уже упомянули, система состоит из четырёх ключевых компонентов.

User Interest Mining

Главная трудность оказалась в том, что у пользователей слишком длинные истории — в среднем больше 37 тысяч событий, что не помещается в контекст LLM. Авторы придумали механизм сжатия истории: они оставляют только самые информативные события — покупки, добавления в корзину, избранное, поисковые запросы, просмотр отзывов и подробных описаний. Все эти данные дополнительно агрегируются по времени: ближайшие дни учитываются подробно, а более старые периоды объединяются сначала в месяцы, а затем и в годы. Так история превращается в понятный текстовый нарратив, который можно подать на вход модели.

Параллельно Alibaba разработали task alignment framework. Они сформулировали 16 задач — от простых (например, определить категорию товара по запросу) до более сложных (выделение ключевых характеристик, определение релевантности). LLM обучали постепенно, чтобы адаптировать её к специфике рекомендательного домена.

Вдобавок сделали self-training evolution: модели генерировали гипотезы, которые затем фильтровали, чтобы убрать галлюцинации или слишком общие интересы, и использовали отобранное для дообучения. В итоге система научилась извлекать из истории осмысленные интересы, а 98% пользователей теперь помещаются в лимит контекста и на каждого удаётся предсказать в среднем 16 интересов.

Tag Prediction

На основе предсказанных интересов следующая модель формирует так называемые теги — текстовые описания того, что пользователь, возможно, захочет купить. Это не конкретные товары, а их обобщённые характеристики: например, «outdoor waterproof hiking boots». К тегам есть требования: они должны опираться на историю и интересы пользователя, быть конкретными, свежими и релевантными сезону. В среднем нужно получить не меньше пятидесяти тегов.

Для обучения используют два шага. Сначала pre-alignment, когда из названий товаров в истории составляются кандидаты для тегов. Затем self-training: система дообучается на собственных же генерациях, но перед этим данные чистят и перебалансируюют. Это нужно, чтобы популярные категории не полностью доминировали и модель не теряла разнообразие. Такой подход оказался эффективным: вырос hit rate — совпадения между предсказанными тегами и реальными товарами, которые позже были куплены или просмотрены.

Item Retrieval

Следующий этап — сопоставление тегов с конкретными товарами. Здесь Alibaba разработали архитектуру с тремя башнями: пользовательской, товарной и теговой. Она учитывает как семантическую близость, так и коллаборативные сигналы. Для обучения используют выборку с положительными и отрицательными примерами: система учится различать товары из нужной категории и из посторонних. На этапе инференса представления из разных башен объединяются, что позволяет более точно матчить интересы и товары.

Personalized Explanation

Наконец, один из самых заметных элементов — генерация объяснений. Вместо того чтобы каждый раз формировать объяснение заново для пары «пользователь-товар», в Alibaba сделали ставку на связку «интерес-товар». Это экономит ресурсы и сохраняет персонализацию. Датасет для обучения объяснений собирали через другую LLM и фильтровали от галлюцинаций. Дополнительный self-training помог адаптировать модель к новым ситуациям. В итоге рекомендации сопровождаются короткими и понятными комментариями вроде «Мы показали вам этот товар, потому что вы недавно искали похожие вещи для путешествий».

В итоге, RecGPT — это не просто «LLM в рексистеме», а целый пайплайн: от сжатия пользовательской истории и извлечения интересов до генерации тегов, матчинга и интерпретируемых объяснений.

@RecSysChannel
Разбор подготовил ❣ Виктор Януш
2 115 просмотров · 24 реакций Открыть в Telegram · Открыть пост на сайте
RecGPT Technical Report, 1/2

Сегодня начинаем разбор недавнего техрепорта от Alibaba о новом подходе к рекомендациям RecGPT. В нём авторы предлагают по максимуму задействовать большие языковые модели.

Классические рекомендательные системы учатся в основном на логах кликов. Такой подход приводит к ряду ограничений: формируются «пузыри», когда пользователю постоянно показывают одно и то же; сложно работать с длинным хвостом товаров; возникают разные bias'ы (например, популярности). Но главное — при таком обучении теряется семантическая информация, а люди выбирают товары не только на основе кликов, а исходя из более сложных мотивов и контекстов.

В качестве решения Alibaba предлагают использовать LLM с ризонингом, чтобы модель не просто фиксировала клики, а пыталась понять, почему пользователь может захотеть тот или иной товар.

Но и тут свои сложности:

— LLM нужно адаптировать к конкретному домену;
— важно укладываться в ограничения по времени отклика и вычислительным ресурсам;
— по-прежнему сложно интегрироваться в индустриальные системы.

Пайплайн RecGPT состоит из четырёх частей:

1. User Interest Mining — извлечение интересов пользователя из истории;
2. Tag Prediction — генерация тегов (описаний желаемых товаров);
3. Item Retrieval — сопоставление тегов с реальными товарами;
4. Personalized Explanation — генерация объяснений, почему система рекомендует этот товар.

Каждый этап можно интерпретировать — это полезно и для пользователей (доверие к системе), и для разработчиков (удобнее отлаживать).

RecGPT внедрили в сценарий Guess What You Like (беззапросные рекомендации на taobao.com). В результате получили рост CTR, просмотров страниц и доли активных пользователей, а ещё увеличили разнообразие по категориям. Улучшения заметили и мерчанты: товары стали лучше доходить до целевой аудитории.

Alibaba заявляют, что их решение — первый в мире успешный деплой reasoning-LLM в рекомендательную систему.

В следующей части — подробнее об архитектуре рексистемы.

@RecSysChannel
Разбор подготовил ❣ Виктор Януш
2 088 просмотров · 22 реакций Открыть в Telegram · Открыть пост на сайте
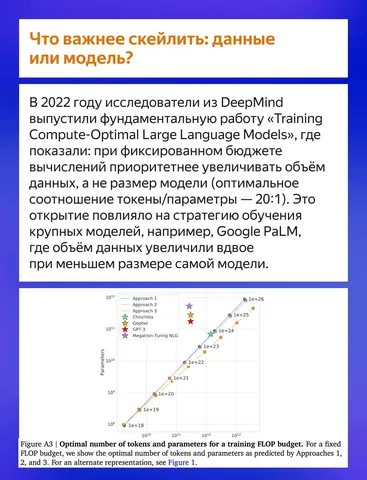
Training Compute-Optimal Large Language Models

Сегодня разберём статью 2022 года от DeepMind, известную также по названию модели Chinchilla. Работа посвящена проблеме правильного распределения фиксированного компьюта между увеличением размера модели и числа токенов, на которых она учится, в домене языковых моделей. Для связи этих трёх величин существует аппроксимация C = 6ND, где C — компьют, N — число параметров, D — число токенов в датасете. Оптимальные N и D масштабируются как C^a и C^b соответственно, где a + b = 1. Задача — найти a и b.

Работа мотивирована статьей 2020 года от OpenAI — Scaling Laws for Neural Language Models, в которой авторы заключили, что большая часть компьюта должна быть аллоцирована под масштабирование самой модели (a > b). Исследователи из DeepMind приходят к другому выводу. Они выводят законы масштабирования тремя разными способами, и все три приводят к схожим результатам (a ≈ b ≈ 0,5).

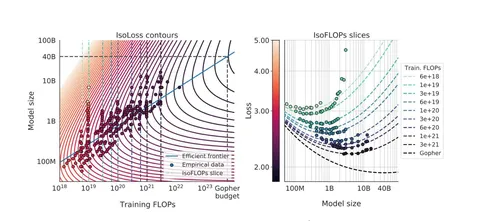
Подход первый: строят график в осях FLOPs — лосс для нескольких моделей с числом параметров от 75M до 10B. Каждому числу флопсов ставится в соответствие точка с минимальным лоссом, для которой известно, какому размеру модели и числу пройденных токенов она относится. Полученные точки переносят на графики в осях FLOPs — N и FLOPs — D, регрессируют их прямой (в прологарифмированных осях), угол наклона которой задаёт a и b. В итоге: a = b = 0,5.

Подход второй: фиксируют компьют и варьируют число параметров, что автоматически задаёт число токенов для обучения. Для каждого фиксированного компьюта находят такую точку, для которой уменьшение или увеличение числа параметров приводит к ухудшению финального лосса. Снова регрессируют эти точки в осях FLOPs — N и FLOPs — D, получая a = 0,49 и b = 0,51.

Подход тертий: здесь авторы моделируют зависимость L(N, D) финального лосса от размера модели и числа пройденных токенов, используя при этом все результаты (L_final, N, D) из первых двух подходов. Благодаря этому выражению, зная компьют, можно найти оптимальное число параметров, которое будет ординатой точки касания вертикальной прямой к линии уровня L(N, D) в осях FLOPs — N (левый график). a и b оказываются равными 0,46 и 0,54 соответственно.

Главный вывод статьи, — число параметров в модели и число токенов в датасете должны масштабироваться равномерно (то есть как квадратный корень из компьюта). Например, при увеличении компьюта в четыре раза обе величины должны вырасти в два раза.

Ещё один интересный вывод авторов — модель Gopher (280B) обучили на недостаточно большом датасете. В качестве доказательства обучают в четыре раза меньшую модель Chinchilla (70B) на в четыре раза большем числе токенов, и эта модель оказывается значительно лучше Gopher.

@RecSysChannel
Разбор подготовил ❣ Сергей Макеев
1 848 просмотров · 19 реакций Открыть в Telegram · Открыть пост на сайте
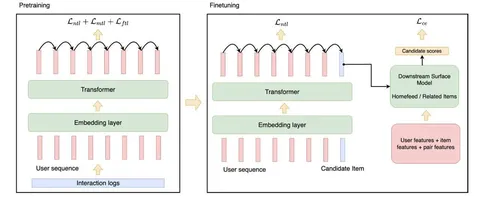
PinFM: Foundation Model for User Activity Sequences at a Billion-scale Visual Discovery Platform [2/2]

Продолжаем разбирать статью от Pinterest. Авторы не делятся внутренними параметрами модели, не уточняют, какого размера декодер и как всё обучалось. Однако они приводят масштабы всей системы — 20 миллиардов параметров. Судя по всему, большая часть этих параметров — матрица эмбеддингов. То есть модель в итоге получилась небольшой.

Отмечают, что в качестве энкодера выбрали архитектуру GPT2 и не увидели улучшений от применения HSTU-энкодера. Обучающую последовательность сформировали из 16 тысяч пользовательских взаимодействий, нарезав их на подпоследовательности длиной несколько сотен событий. Каждое событие кодируют обучаемыми эмбеддингами пина, поверхности и типа взаимодействия, итоговый токен события — сумма этих трёх эмбеддингов. Напоминает то, как формируются токены в Argus: де-факто есть те же context, item и action, но в весьма ограниченном варианте.

В остальном архитектура вышла стандартной. Но вот решаемую задачу авторы определяют весьма интересно. В качестве таргетов берут только позитивные события (при этом последовательность формируется с включением негативов), делают это с помощью Sampled Softmax (почему-то без LogQ-коррекции). В этом сетапе на стадии претрейна предсказывают:

– следующий позитивный токен;
– следующие позитивные токены в некотором временном окне;
– позитивные события, но во временном окне downstream-ранжирующей модели.

Получившийся лосс суммируют.

На файнтюне используют ещё несколько интересных трюков: выравнивают предсказания файнтюна и ранжирующей модели, добавляют дополнительный сигнал (контентно-коллаборативные графовые эмбеддинги) и обучаемые токены перед кандидатами, а также техники для решения проблемы холодного старта.

Команда Pinterest в очередной раз демонстрирует крутые инфраструктурные решения для жизнеспособность всей системы. В частности, эффективная дедупликация последовательности увеличила на 600% пропускную способность модели по сравнению с FlashAttention-2. Для оптимизации гигантской таблицы эмбеддингов применили агрессивную int4-квантизацию практически без потери качества.

В результате получилась сильная модель, хорошо агрегирующая знание о пользователях. Это отражается в результатах A/B-тестирования: на рекомендательной ленте на главной удалось добиться роста числа сохранений пинов на 2,6%, а для свежих пинов — на 5,7%.

@RecSysChannel
Разбор подготовил ❣ Руслан Кулиев
1 819 просмотров · 25 реакций Открыть в Telegram · Открыть пост на сайте
PinFM: Foundation Model for User Activity Sequences at a Billion-scale Visual Discovery Platform [1/2]

Сегодня разбираем свежую статью от Pinterest, которую недавно приняли на RecSys 2025.

Авторы делятся опытом построения foundation-модели. Вместо создания множества маленьких моделей, специализирующихся на отдельных задачах, они обучают одну большую: скармливают ей как можно больше данных о пользовательской активности, чтобы она начала выявлять закономерности в последовательностях. В контексте рекомендаций такими данными могут быть взаимодействия пользователей со всеми поверхностями приложения за длительный период времени.

Foundation-модели и большие претрейны уже давно хорошо зарекомендовали себя и в NLP, и в CV. Если дообучить для своих задач готовую GPT-подобную модель, которая многое знает о мире, результат вас вряд ли разочарует. К тому же, дообучение сильно дешевле обучения с нуля и быстрее дистилляции.

Однако в рекомендательных системах долгое время игнорировали этот подход. Исследователи из Pinterest утверждают, что они первые в индустрии, кто сделал полноценную foundation-модель. В качестве датасета для претрейна авторы собрали двухлетнюю историю взаимодействия пользователей с пинами на разных поверхностях, а во время файнтюна дообучили модель на специфическую поверхность.

При этом в попытке обучить и внедрить такую крупную структуру неизменно возникают следующие проблемы:

1. Косты. Большая модель не зря большая: инферить её дорого и долго.

2. Оптимизация входной информации. Важно не перегружать модель и при этом сохранять приемлемые косты. Чтобы повысить качество ответов, недостаточно просто сообщить, что пользователь взаимодействовал с определённой последовательностью айтемов — нужно передавать и дополнительные знания, при этом оставаясь в рамках практических ограничений.

3. Постоянное пополнение набора айтемов. Пользователи регулярно загружают в Pinterest новый контент: нужно научить модель адекватно оперировать незнакомыми, только что добавленными объектами.

По каждой из этих проблем авторы добиваются удовлетворительного решения. Продолжим разбор во второй части.

@RecSysChannel
Разбор подготовил ❣ Руслан Кулиев
1 792 просмотров · 22 реакций Открыть в Telegram · Открыть пост на сайте
Top-K Off-Policy Correction for a REINFORCE Recommender System

Reinforcement Learning — подход, который логично применять для рекомендаций. При этом работ об использовании RL-алгоритмов в этой области не так много. Сегодня разберём статью 2019 года с конференции WSDM’19, которая посвящена этой теме. В работе описано одно из первых успешных применений RL в рекомендательных системах, внедренное в YouTube на миллионы пользователей и многомиллионные каталоги видео.

Как RecSys сформулировать в терминах RL

Взаимодействие пользователя можно смоделировать как марковский процесс принятия решений:
— состояние — контекст взаимодействия и история пользователя;
— действие — рекомендуемый кандидат (видео и т. п.);
— награда — полезность показа (клик, лайк, время просмотра).
Политика π(a|s) выбирает кандидатов так, чтобы максимизировать долгосрочную полезность.

Дизайн награды

В работе авторы рассматривают горизонт оптимизации внутри одной пользовательской сессии: цель — суммарная полезность за сессию, а не мгновенная. На практике удобно использовать гибридную награду (сочетание клика и времени просмотра), например:

r = α·1_click + β·log(1 + watch_sec)

REINFORCE

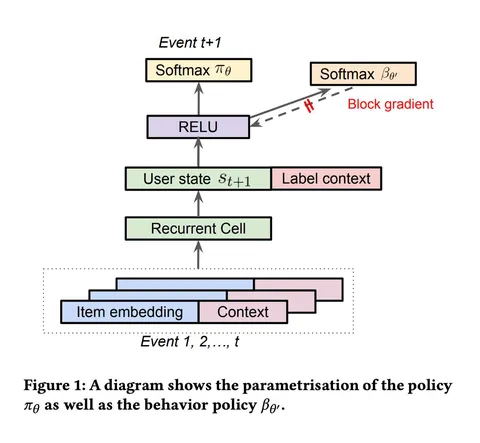
Политику π(a|s) моделируют в виде параметрической функции от состояния (истории пользователя), которая выдаёт распределение на действиях. В качестве модели берут рекуррентную нейронную сеть. Политику обучают с помощью алгоритма REINFORCE. Это on-policy-алгоритм, поэтому обновление весов корректно только на данных, собранных текущей политикой. Поскольку это требует сложной инфраструктуры, обучение проводят на залогированных данных.

Off-policy correction

Залогированные данные получены от предыдущей версии рекомендательной системы β(a|s), которую авторы называют поведенческой политикой. Это приводит к смещению в оценке градиента. Чтобы компенсировать смещение, используют Importance Sampling. Для моделирования β(a|s) применяют ту же архитектуру, что и для π(a|s), но обучают только на логах и не пропускают градиенты этой «головы» в общий backbone модели. Для обеих политик при обучении используется Sampled Softmax.

Top-K correction

На YouTube показывают сразу K элементов на одной странице, то есть политика подбирает не одного кандидата, а набор. Делается предположение, что каждый из K элементов сэмплируется независимо из π(a|s), поэтому от вероятности π(a|s) переходят к вероятности попадания на страницу:

α(a|s) = 1 − (1 − π(a|s))^K

Online A/B-тест

Полученную политику π(a|s) использовали как один из кандидатогенераторов основного алгоритма рекомендаций YouTube. Применение off-policy correction увеличило число просмотренных видео примерно на +0,5%. Добавление Top-K correction увеличило общее время просмотра видео на +0,8–0,9%.

@RecSysChannel
Разбор подготовил ❣ Артём Матвеев
1 898 просмотров · 25 реакций Открыть в Telegram · Открыть пост на сайте
Что интересного показали на конференции KDD 2025

В Торонто прошла конференция KDD 2025, посвященная поиску знаний и анализу данных. На мероприятии, как водится, представили немало интересных публикаций. А мы, как водится, выбрали самые любопытные из них.

TAT: Temporal-Aligned Transformer for Multi-Horizon Peak Demand Forecasting

Статья Amazon о прогнозировании временных рядов (спроса). Авторы предлагают решение на основе трансформера, в котором используется, в том числе, информация о праздниках и днях со всплесками спроса. Сообщают о двузначных числах прироста точности в предсказании пиков.

Automated Query-Product Relevance Labeling using Large Language Models for E-commerce Search

Статья Walmart о том, как инженеры сделали фреймворк для авторазметки соответствия товара запросу. Утверждают, что работает лучше ручной разметки (асессорам пора искать работу).

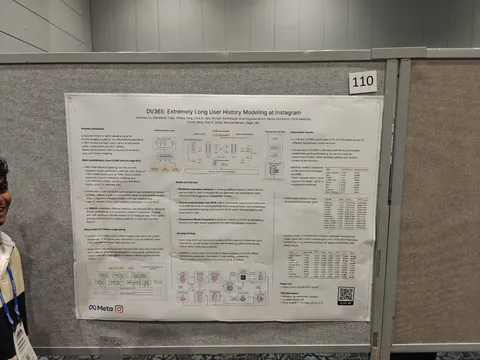
DV365: Extremely Long User History Modeling at Instagram*

Крутая статья Meta* — возможно, самая революционная в прикладном плане. Инженеры компании сделали офлайн-профиль пользователя размером в среднем 40к, так как масштабировать HSTU дальше сложно и дорого. Жертвуют свежестью данных и делают ставку на стабильные интересы пользователей. Получили +0,7% таймспента от внедрения эмбедда в использующих его моделях.

Mini-Game Lifetime Value Prediction in WeChat

Статья WeChat о предсказании LTV в играх. В основе graph representation learning, а также используют интересный подход к zero-inflated lognormal distribution modeling.

Компания Meta, владеющая Instagram, признана экстремистской; её деятельность в России запрещена.

Интересное увидел ❣ Сергей Мить

@RecSysChannel
2 177 просмотров · 18 реакций Открыть в Telegram · Открыть пост на сайте
Blending Sequential Embeddings, Graphs, and Engineered Features: 4th Place Solution in RecSys Challenge 2025

Сегодня рассказываем о статье, в которой описано решение от команды исследователей из Яндекса, получившее в этом году четвёртое место на конкурсе RecSys Challenge. Статью также приняли на конференцию RecSys 2025.

Челлендж был посвящён области e-commerce. В этом направлении рекомендательные модели обучают предсказывать разные виды сигналов: конверсии, релевантные товары и их категории, сумму, которую потратит клиент, и многое другое. Целью челленджа было обучить эмбеддинг пользователя, который объединил бы разнородные сигналы. Затем организаторы использовали этот эмбеддинг, чтобы обучить независимые модели под шесть разных задач, вроде тех, что описаны выше.

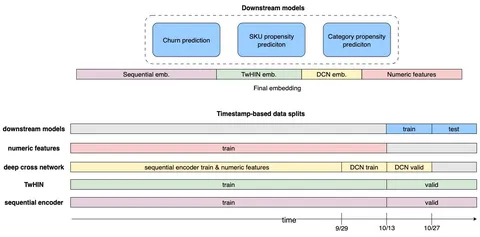
Как видно на картинке, для построения такого эмбеддинга предлагается сконкатенировать векторы от четырёх моделей: трансформера, выбор которого мотивирован подходом ARGUS, графовой нейросети TwHIN, DCN-v2-эмбеддингов и стандартизованных счётчиков.

Взаимодействия пользователей, предоставленные участникам, носят упорядоченный последовательный характер, поэтому важная часть решения — модель, кодирующая последовательности, — трансформер. В качестве истории пользователя брались все типы событий: добавления и удаления из корзины, покупки, посещённые страницы и запросы.

Трансформер в генеративной постановке учился предсказывать тип следующего взаимодействия, время до него, следующую посещённую страницу, а также следующий товар. DCN-v2-модель училась поверх эмбеддинга из трансформера и множества счётчиков, прошедших через кусочно-линейное кодирование, предсказывать отток клиентов, а также актуальные товары и категории, с которыми провзаимодействует пользователь. Графовая модель TwHIN обучалась предсказывать связи (добавления в корзину и покупки) между пользователем и товаром. Счётчики считались по разным временным промежуткам, тематическим кластерам и ценовым сегментам, а для учёта временных зависимостей использовалось экспоненциальное взвешивание. Подробный разбор всех счётчиков доступен в приложении к статье.

Получившийся ансамбль показал качество, сопоставимое с более сложными решениями (из десятков моделей), и занял четвёртое место в финальном лидерборде.

@RecSysChannel
Разбор подготовил ❣ Сергей Макеев
2 015 просмотров · 31 реакций Открыть в Telegram · Открыть пост на сайте
Scaling Recommender Transformers to One Billion Parameters

Инженеры из группы исследования перспективных рекомендательных технологий выложили на arXiv статью о подходе ARGUS, которому ранее посвятили рассказ на Датафесте и пост на Хабре. Сейчас статья находится на ревью на KDD’26, но текст уже доступен для всех желающих.

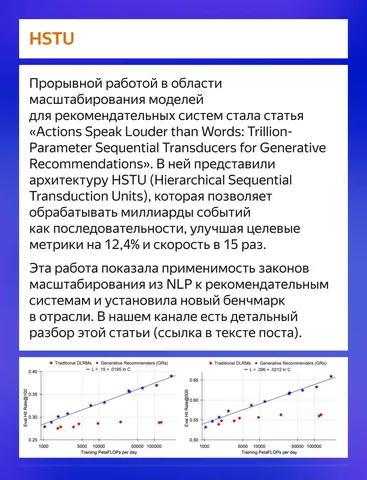
В статье команда авторов делится опытом по масштабированию рекомендательных трансформеров, вдохновлённым нашумевшей работой Actions Speak Louder than Words.

В моделях Sequential Recommendation можно выделить четыре оси масштабирования: число параметров в таблице эмбеддингов, длина истории пользователя, размер датасета и количество параметров в трансформере. В то время как матрицы эмбеддингов могут содержать миллиарды параметров, а датасеты достигать триллионов токенов, размеры индустриальных трансформеров всё ещё остаются чрезвычайно малы в сравнении с языковыми моделями — сотни миллионов параметров. Авторам удалось обучить трансформер с миллиардом параметров на датасете из Яндекс Музыки и добиться прироста метрик.

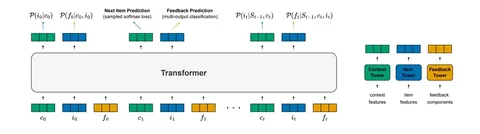
Команда верит, что для успешного масштабирования рекомендательный трансформер должен предобучаться на фундаментальную задачу. Оказывается, Next Item Prediction может быть недостаточно — нужно уметь не только имитировать поведение предыдущей рекомендательной модели, породившей взаимодействия, но и корректировать её навыки. Другими словами, помимо предсказания следующего взаимодействия полезно научиться оценивать его.

Естественный способ это сделать — представить историю в виде пар токенов (item, feedback), из айтема предсказывать фидбек, а из фидбека — следующий айтем. Поскольку каждое взаимодействие представляется парой токенов, длина истории вырастает в два раза, увеличивая вычислительные затраты. Поэтому на практике каждое взаимодействие представляли одним токеном, а предсказание фидбека обуславливали на следующий айтем.

Поскольку модель предобучается не только на рекомендательном трафике, но и на органическом, да ещё и без задержки (которая появляется при offline-применении), возникает необходимость в дообучении под финальную задачу. Для этого авторы в том же авторегрессивном формате обучили модель на попарное ранжирование кандидатов с нужной задержкой.

Офлайн-эксперименты провели для четырёх размеров трансформера, наращивая число параметров экспоненциально: стартуя с 3,2 млн и заканчивая 1,007 млрд. Оказалось, что полученные результаты согласуются с законом масштабирования.

ARGUS уже внедрили в Яндекс Музыку, увеличив вероятность лайка на 6,37% и TLT на 2,26%. Внедрение оказалось самым успешным среди всех нейросетей в Музыке. А ещё ARGUS внедрили в Алису, Маркет, Лавку, и другие сервисы Яндекса.

Подробнее о решении можно прочитать в статье.

Статью написали ❣ Кирилл Хрыльченко, Артём Матвеев, Сергей Макеев, Владимир Байкалов

@RecSysChannel
2 614 просмотров · 38 реакций Открыть в Telegram · Открыть пост на сайте
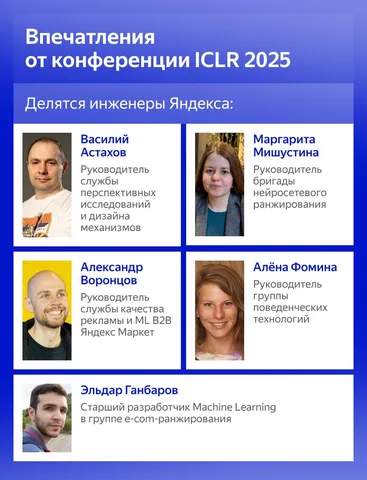
Как прошла ICLR 2025: впечатления инженеров Яндекса

Подводим итоги конференции — для этого собрали впечатления, тенденции и интересные статьи, отмеченные инженерами, посетившими её.

Работы, упоминаемые в карточках:

- Language Representations Can be What Recommenders Need: Findings and Potentials
- TabReD: Analyzing Pitfalls and Filling the Gaps in Tabular Deep Learning Benchmarks
- TabM: Advancing Tabular Deep Learning with Parameter-Efficient Ensembling
- SLMRec: Distilling Large Language Models into Small for Sequential Recommendation
- CoS: Enhancing Personalization and Mitigating Bias with Context Steering
- Amulet: ReAlignment During Test Time for Personalized Preference Adaptation of LLMs

@RecSysChannel

#YaICLR
2 061 просмотров · 20 реакций Открыть в Telegram · Открыть пост на сайте
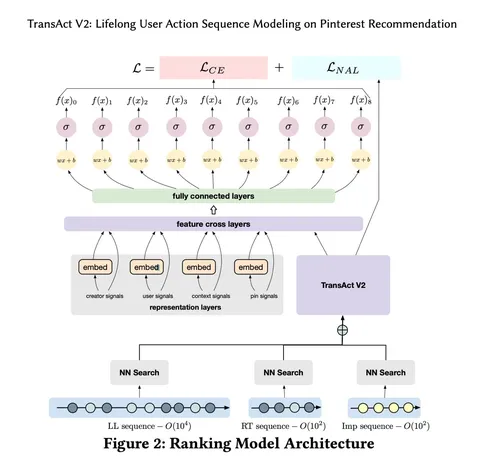
TransAct V2: Lifelong User Action Sequence Modeling on Pinterest Recommendation

Разбираем статью от Pinterest, в которой говорят об использовании максимально длинной истории действий для улучшения рекомендаций в ленте. Задача осложняется жёсткими инфраструктурными ограничениями: Pinterest обслуживает более 500 млн пользователей в месяц, а объём возможных кандидатов — миллиарды пинов. При этом инференс должен укладываться в строгие тайминги, несмотря на тысячи параллельных GPU-запросов.

Pinterest остаётся верен классической трёхстадийной архитектуре: retrieval — scoring — blending. На первом этапе модель отбирает несколько тысяч кандидатов, которые затем проходят pointwise-ранжирование. Ранжирующая модель оптимизируется исключительно под фид. Особое внимание уделяется тому, как используется длинная история действий — ключевое отличие от предыдущих решений.

Несмотря на эффектный посыл про «десятки тысяч событий в истории», фактически модель работает не с «сырой» историей, а с её сжатием. История формируется из трёх источников: полной пользовательской активности, событий в рантайме и импрессий. Для каждого кандидата модель отбирает ближайшие по контенту события из этих источников (а также несколько последних взаимодействий независимо от контента), формируя итоговую последовательность фиксированной длины — порядка сотен событий. Эта сжатая история и обрабатывается в трансформере.

Модель представляет собой multitask-архитектуру в pointwise-постановке. На вход она получает эмбеддинги, включающие обучаемые параметры, категорию взаимодействия, позиционный эмбеддинг и эмбеддинг пина. Последний строится как объединение эмбеддинга кандидата и карточек из истории, к которым кандидат наиболее близок по контенту. Трансформер с минимальным числом параметров (два слоя, одна attention-глава, скрытое представление размерности 64) пропускает эту последовательность и генерирует выходные векторы, которые подаются в линейный слой для генерации прогнозов.

Loss-модель использует два компонента: взвешенную кросс-энтропию по каждому действию (лайк, добавление в избранное и прочее) и sampled softmax loss на задачу next action prediction. В качестве позитивов используются все позитивные взаимодействия в последовательности, а в качестве негативов — показы. Авторы отмечают, что подход показывает себя лучше, чем batch sampling. Среди архитектурных решений также интересно, что один и тот же пин, встретившийся с разными действиями, кодируется как multi-hot-вектор, а эмбеддинги пинов хранятся в квантизованном виде (int8) и деквантизируются в float16 перед подачей в трансформер.

Ключевые нововведения — в инфраструктуре. Стандартные решения на PyTorch оказались неприменимы из-за избыточной материализации данных. Разработчики переписали инференс на собственный сервер с кастомными трансформерными ядрами в Triton (речь не о сервере NVIDIA, а о языке для компиляции под GPU). Такой подход позволил избежать дополнительных обращений к памяти: квантизованные векторы декодируются, нормализуются и сразу же используются для поиска ближайших соседей.

Ещё в работе реализовали оптимизации вроде кэширования длинных пользовательских историй в сессии (чтобы избежать их загрузки при каждом реквесте), дедупликации запросов и эффективного распределения памяти между CPU и GPU. Всё вместе это дало серьезный прирост производительности: latency снизился в 2–3 раза по сравнению с PyTorch, использование памяти тоже оказалось эффективным. Переход на собственные ядра позволил сократить время инференса на 85% и расход памяти на 13% при длине последовательности 192. Решение выигрывает и у FlashAttention 2: ядра оказались на 66% быстрее и потребляли на 5% меньше памяти, при этом FlashAttention 2 не поддерживает пользовательское маскирование токенов.

Авторы сравнивают эффективность TransAct V2 с другими моделями, в том числе с первым TransAct. Основной вывод: использование гораздо более длинной пользовательской истории и набор инженерных решений дают заметный прирост качества рекомендаций без потерь в скорости и стабильности.

@RecSysChannel
Разбор подготовил ❣ Руслан Кулиев
4 349 просмотров · 24 реакций Открыть в Telegram · Открыть пост на сайте
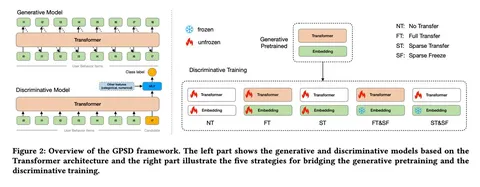
Scaling Transformers for Discriminative Recommendation via Generative Pretraining

Тема масштабирования моделей в рекомендательных системах продолжает набирать популярность. Недавно Alibaba представила работу о масштабировании ранжирующих моделей для персональных рекомендаций товаров на AliExpress. О ней и поговорим.

В ML выделяют два класса вероятностных моделей:

— Дискриминативные — моделируют условное распределение p(y|x) (предсказывают метку y по данным x). Примеры: логистическая регрессия, большинство моделей для ранжирования.
— Генеративные — моделируют совместное распределение p(x, y), что позволяет генерировать данные. Примеры: GPT, диффузионные модели.

Авторы фокусируются на дискриминативных ранжирующих моделях, предсказывающих CTR и CVR. Однако при попытке масштабировать трансформер, обучаемый только на дискриминативную задачу, наблюдается переобучение. Это связано с сильной разреженностью позитивного таргета для ранжирования: увеличение модели ведёт к деградации качества.

Решение — добавить генеративное предобучание (метод назван GPSD — Generative Pretraining for Scalable Discriminative Recommendation), а затем — дискриминативное дообучение. Ключевое преимущество заключается в том, что генеративное предобучание не страдает от сильного разрыва в обобщающей способности между обучением и валидацией, что и открывает путь к масштабированию.

Технические детали

1. Генеративное предобучение

— Используется архитектура трансформера с каузальной маской над историей взаимодействий.
— Модель решает две задачи: предсказание следующего товара (Sampled Softmax Loss с равномерно семплированными негативами из каталога) и предсказание его категории.
— При кодировании товаров применяются обучаемые эмбеддинги для каждого айтема, а также дополнительные фичи, такие как категория.
— Агрегация делается путём суммирования.

2. Дискриминативное дообучение

— Добавляется CLS-токен в историю. Его выходной вектор используется как представление пользователя.
— Это представление конкатенируется с фичами кандидата (товара, для которого предсказывается CTR) и подается на вход MLP.

3. Стратегия переноса весов

— Наилучшие результаты даёт инициализация и заморозка матриц эмбеддингов (item embeddings) с этапа генеративного предобучения.
— Веса самого трансформера можно инициализировать как предобученными, так и случайными значениями — результат сопоставим.

Ключевые результаты

— Без генеративного предобучения: увеличение модели не даёт прироста качества (AUC) из-за переобучения, наблюдается даже деградация.
— С GPSD: устойчивое масштабирование — рост AUC при увеличении размера модели от 13 тысяч до 300 млн параметров. Выведен степенной закон зависимости AUC от числа параметров.
— A/B-тест на рекомендательной платформе AliExpress: в продакшен выведена модель с тремя слоями трансформера и скрытой размерностью 160 (очень компактная).
Результат: +7,97% GMV, +1,79% покупок.

Замечания

1. Использованные модели и датасеты — небольшие, что немного подрывает веру в результаты.

2. При масштабировании одновременно с dense-частью (трансформер) увеличивались и sparse-часть (матрицы эмбеддингов), что также могло быть фактором роста качества. Для более честного замера её размер нужно было зафиксировать.

@RecSysChannel
Разбор подготовил ❣ Артём Матвеев
1 934 просмотров · 19 реакций Открыть в Telegram · Открыть пост на сайте
Preference Diffusion и Decoupled Embeddings: две статьи о масштабируемых рекомендациях

Сегодня разбираем ещё две статьи с ICLR — о диффузионных моделях в рекомендациях и о борьбе с градиентными конфликтами в длинных пользовательских историях.

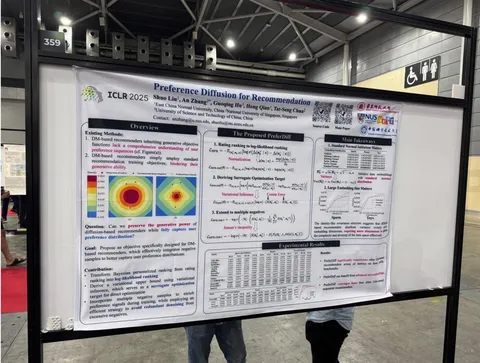
Preference Diffusion for Recommendation

Авторы пробуют использовать диффузионные модели в рекомендательных системах. Изначально это направление кажется не вполне очевидным: если с изображением ясно, как его зашумить, то что значит «наложить шум» на эмбеддинг айтема или пользователя — не совсем понятно.

Авторы основываются на более ранней статье — DreamRec — и развивают её идею. В DreamRec использовали диффузионку как генератор: сначала генерировали «идеальный» вектор айтема, а потом искали ближайший из базы. В этой статье пошли дальше: встроили диффузионную модель в стандартный стек рекомендательных систем и учли важные инженерные моменты.

Во-первых, MSE заменили на косинусное расстояние в лоссе. Во-вторых, стали учитывать негативы в обучении, чтобы модель не просто приближалась к позитивному айтему, но и отличала его от негативных.

Вместо того чтобы обрабатывать сотни негативов по отдельности (что тяжело вычислительно), авторы сэмплируют 256 негативов, усредняют, берут центроид — и используют как один «усреднённый негатив». Такая тактика резко снижает нагрузку, но сохраняет информативность. По словам одной из соавторов, Ан Чжан, идея эффективного добавления негативов и упрощение вычислений — главный вклад статьи в индустрию — без этого диффузионка в рекомендациях просто не взлетает.

Ещё одно улучшение касается больших размерностей эмбеддингов. Авторы показали, что такие модели начинают работать только на размерностях больше 2 тысяч. Привычные 64 или 128 не дают никакого результата — лосс почти не убывает.

Итог: модель обучается быстрее, чем в предыдущих подходах. Её удалось встроить в классический пайплайн даже без больших кандидатов (в отличие от AlphaRec).

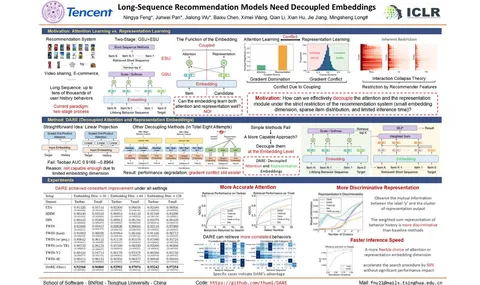
Long-Sequence Recommendation Models Need Decoupled Embeddings

Интересная работа от команды из Tencent. У них большая рекомендательная система с очень длинными пользовательскими историями и огромным числом айтемов. Это накладывает ограничения и по вычислениям, и по архитектуре. Они используют трансформер, который сначала применяет attention к длинной истории, чтобы выбрать важные элементы, и уже по ним строит итоговую репрезентацию.

В стандартном подходе одни и те же эмбеддинги используются и для блока attention, и для блока representation.

Авторы показывают, что в таком случае возникает конфликт между градиентами: одна часть модели (например, attention) толкает эмбеддинги в одну сторону, другая (representation) — в другую. В статье подсчитали, как часто градиенты конфликтуют — оказалось, больше чем в половине случаев.

Ещё исследователи измеряют, сколько лосса проходит через каждую часть — и оказывается, что representation тянет на себя ощутимо больше, чем attention. Это приводит к перекосу: одна часть доминирует, другая «умирает».

Авторы пробуют решить это простыми способами — например, добавить линейные преобразования до и после эмбеддингов. Но это не помогает. Несмотря на раздельную обработку, на вход всё равно идут одинаковые эмбедды, и конфликт сохраняется.

Тогда исследователи делают жёсткое разнесение: делят эмбеддинг на две части — одна идёт в attention, другая — в representation. Причём первая в 3–4 раза меньше, потому что attention всё равно получает меньше градиентного сигнала, и для него достаточно компактного представления. Это решение устраняет конфликт, ускоряет инфернес и не ухудшает качество. Визуально это хорошо видно на графиках: чем больше разнесение и уменьшение attention-части, тем выше эффективность.

Интересный побочный эффект — за счёт того, что attention работает на меньших векторах, система становится до 50% быстрее.

Авторы утверждают, что решение уже внедрено в продакшн и работает там на больших масштабах.

@RecSysChannel
Обзор подготовил ❣ Василий Астахов

#YaICLR
1 461 просмотров · 13 реакций Открыть в Telegram · Открыть пост на сайте
Scaling law в рекомендательных системах

Законы масштабирования вышли за рамки NLP и успешно применяются в рекомендательных системах. В наших карточках исследователь Владимир Байкалов затронул последние работы на эту тему. С обзором прошлых статей можно ознакомиться в этом посте.

Работы, упомянутые в карточках:
- Language Models are Unsupervised Multitask Learners
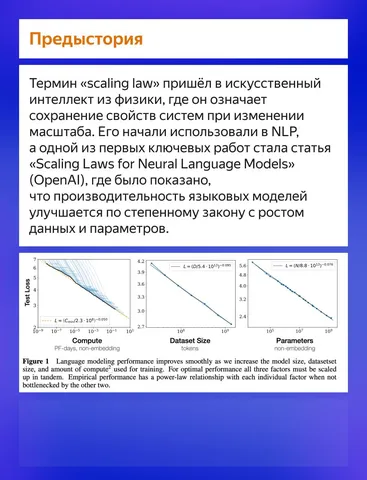
- Scaling Laws for Neural Language Models
- Training Compute-Optimal Large Language Models
- Actions Speak Louder than Words: Trillion-Parameter Sequential Transducers for Generative Recommendations
- Scaling New Frontiers: Insights into Large Recommendation Models
- Unlocking Scaling Law in Industrial Recommendation Systems with a Three-step Paradigm based Large User Model
- Scalable Cross-Entropy Loss for Sequential Recommendations with Large Item Catalogs
- Разбор статьи HSTU в канале «Рекомендательная»

@RecSysChannel
Обзор подготовил ❣ Владимир Байкалов
1 973 просмотров · 40 реакций Открыть в Telegram · Открыть пост на сайте
Conservative RL и ContextGNN: два подхода к рекомендациям с ICLR 2025

ICLR прошла, но неразобранные статьи о RecSys остались. Василий Астахов, руководитель службы перспективных исследований и дизайна механизмов, отобрал пять работ на тему рекомендательных систем — части мы уже касались в подборках, сейчас хотим остановиться на них подробнее.

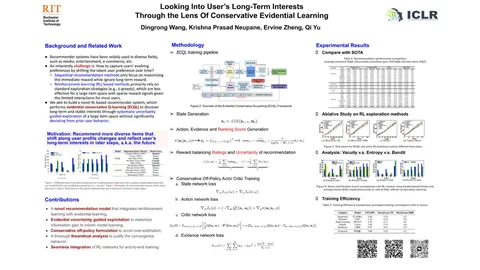
Looking into User’s Long-term Interests through the Lens of Conservative Evidential Learning

Статья на тему RL в рекомендациях. В ней рассматривают две постановки: классическую — где используют RL, чтобы лучше исследовать предпочтения пользователя во времени; нестандартную — когда RL помогает даже в оффлайн-задаче рекомендаций, без интерактивного взаимодействия.

Из более ранних работ мы знаем, что оффлайн-прогнозатор не всегда хорошо догадывается о полезных латентных признаках. RL, за счёт обучения с другой формулировкой, может «подсказать» модели, какие сигналы стоит запоминать — даже если они редкие.

Аналогичный эффект и в этой статье. Хотя RL-сценарий тут продвинутый — авторы предлагают подход ECQ-L (Evidential Conservative Q-Learning). В нём комбинируется несколько идей.

Evidential learning — вместо классического эксплорейшена, они учатся на уменьшение неопределённости. То есть выбирают айтемы, которые дают больше информации (не просто максимальный reward, а максимальное снижение неуверенности).

Conservative learning — модель не переоценивает редкие положительные примеры. Если какая-то рекомендация «сработала», но по данным это было маловероятно, её вес занижается. Это сделано, чтобы не переобучаться на случайные удачи. Например, пользователь смотрел романтические фильмы, а вы случайно порекомендовали хоррор, и он понравился. ECQ-L в этом случае не будет придавать слишком большого значения этому событию, потому что оно слабо объясняется историей.

Это и есть суть conservative-части подхода — модель целится не просто в reward, а в нижнюю границу его оценки, основанную на уверенности.

Архитектура довольно сложная: один модуль отвечает за обновление состояния; другой — за выбор действия (какой айтем рекомендовать), третий — за то, насколько выбранный айтем надёжен по текущему распределению.

Также используются разные типы лосса — отдельно на состояние, на действие, на оценку и на неопределённость.

Авторы показывают хорошие метрики — как в классическом RL-сценарии, так и в оффлайн-постановке.

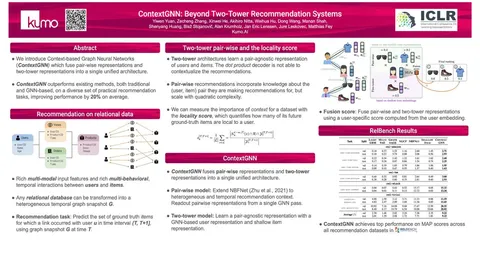
ContextGNN: Beyond Two-Tower Recommendation Systems

Главный посыл статьи: двухбашенные модели работают не очень хорошо, особенно когда есть плотные взаимодействия между пользователем и айтемом. Авторы предлагают решение, которое работает в одну стадию, без двухфазного ранжирования, и при этом способно учитывать и известные, и новые айтемы.

Архитектура состоит из двух веток. Первая работает с айтемами, с которыми пользователь уже взаимодействовал. Используется графовая модель, которая обучается на конкретных связях пользователя и айтемов, учитывая категории, типы взаимодействий. Это более «умная» часть, хорошо работающая в зонах, где есть история.

Вторая ветка — простая двухбашенная модель, работает с айтемами, которых пользователь пока не видел. Здесь задача — пробовать предсказать интерес к новому, опираясь только на общую репрезентацию пользователя и айтема. Ещё есть третий модуль, который учится предсказывать, чего хочет пользователь в данный момент. И на основе этой мотивации система решает, какую из двух моделей использовать сильнее, или как взвесить их выходы при финальном ранжировании.

Что показывают эксперименты:

- Если в датасете пользователь в основном «ходит по кругу», то выигрывает первая ветка — графовая.
- Если он часто пробует новое — вторая модель начинает давать вклад.
- Их основная модель всегда оказывается лучше, чем каждая по отдельности.

В целом, это не радикально новая архитектура, но хорошее объединение знакомых подходов: модуль, который учится на известном (GNN); модуль, который работает с новым (two-tower); модуль-медиатор, который учится понимать, чего хочет пользователь сейчас.

@RecSysChannel
Обзор подготовил ❣ Василий Астахов

#YaICLR
1 899 просмотров · 18 реакций Открыть в Telegram · Открыть пост на сайте
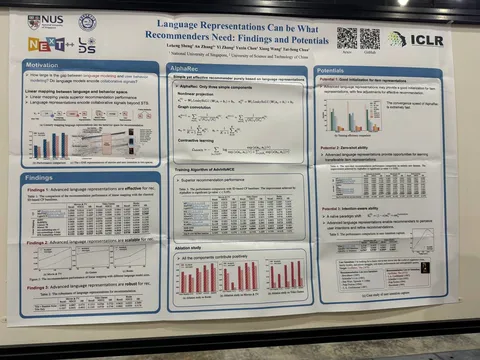
Language Representations Can be What Recommenders Need: Findings and Potentials

Разбираем одну из самых интересных статей на тему рекомендательных систем с ICLR 2025. Её авторы задаются вопросом: действительно ли LLM неявно кодируют информацию о предпочтениях пользователей. В работе предлагается использовать эмбеддинги айтемов из LLM для улучшения качества рекомендаций.

В начале статьи упоминается, что LLM хорошо показывают себя во многих доменах, а также приводится обзор вариантов их применения к ранжированию в рекомендательных системах. Один из таких вариантов — использовать замороженную языковую модель для получения эмбеддинга текста/названия айтема, а затем — дообучать линейный слой для подсчёта итогового представления айтема.

Таким образом можно извлечь и представление пользователя, усреднив эмбеддинги айтемов из его истории взаимодействий. Представления пользователей и айтемов затем используются для получения скора ранжирования (например, с помощью dot-product).

Этот подход немного улучшает качество существующих методов, и авторы задумываются о причинах этого улучшения. Они отмечают, что фильмы на разные темы близки в пространстве языковых эмбеддов (например, запросы пользователей) и в пространстве непосредственно айтемов (например, названия фильмов). Внимание акцентируют на линейном отображении, которое позволяет кластеризовать эмбеддинги айтемов, отображая схожесть пользователей, которые ими интересуются.

В статье рассуждают о нескольких вариантах кодирования айтемов: с использованием ID и матриц эмбеддов, с использованием LLM. У первого подхода есть недостатки: например, плохая переносимость эмбеддингов между доменами и отсутствие явной возможности распознавать намерения пользователей. Их и призван нивелировать второй подход.

Главные вопросы, на которые хотят ответить в статье: кодируют ли LLM коллаборативный сигнал и насколько наличие сигнала зависит от размеров модели. Сравниваясь с существующими методами на модельных датасетах, авторы приходят к выводам о превосходстве представлений, полученных с помощью LLM, над ID-based подходом. Также утверждают, что с увеличением размера модели увеличивается репрезентативность пользовательских интересов.

Ключевая идея — итеративное построение эмбеддингов пользователей и айтемов по графу взаимодействий с использованием нелинейностей и представлений LLM — в статье этот метод называется AlphaRec. Для обучения моделей авторы предлагают использовать случайно сэмплированные негативы из числа тех айтемов, с которыми пользователи не взаимодействовали. На рассмотренных датасетах AlphaRec обходит существующие алгоритмы как по качеству, так и по необходимым вычислительным мощностям. Ещё одно преимущество этого фреймворка — возможность предоставить готовые эмбеддинги для инициализации другими алгоритмами ранжирования.

В конце статьи авторы рассматривают применение пользовательского интента (например, запрос с описанием фильма, который пользователь хотел бы потенциально посмотреть) для улучшения качества рекомендаций. Использование AlphaRec в этом случае позволяет получить результаты, кратно превосходящие другие методы. Однако датасет для такого исследования был сгенерирован синтетически с помощью асессоров и не защищен от ликов — то есть, скорее всего, он не означает, что в случае использования чат-бота или поискового запроса предложенный алгоритм будет настолько же хорош.

@RecSysChannel
Обзор подготовила ❣ Маргарита Мишустина

#YaICLR
1 980 просмотров · 13 реакций Открыть в Telegram · Открыть пост на сайте
Исследователи Яндекса выложили в опенсорс Yambda — датасет на 5 млрд событий

В открытом доступе появился Yandex Music Billion-Interactions Dataset (Yambda) — один из крупнейших в мире датасетов в области рекомендательных систем. В этом посте рассказываем, зачем он нужен и какие у него ключевые особенности.

В последние годы рекомендации вышли на плато по сравнению с более быстро развивающимся областями, такими как LLM. Исследователям недоступны терабайты данных, которые нужны для развития рекомендательных систем, а коммерческие платформы редко делятся данными. Поэтому приходится использовать устаревшие и маленькие наборы. Модели, обученные на таких данных, теряют эффективность при масштабировании.

Существующие доступные датасеты, такие как MovieLens, Netflix Prize dataset, Amazon Reviews, Music4All-Onion, Steam и несколько других имеют ряд недостатков. Например, сравнительно небольшой размер делает их нерепрезентативным для коммерческих масштабов, а фокус на явных сигналах ограничивает полезность для моделирования реальных последовательных взаимодействий.

Чтобы решить эти проблемы и дать исследователям больше возможностей для разработки и тестирования новых гипотез в рекомендациях, исследователи Яндекса выложили в опенсорс свой датасет Yambda.

Ключевые особенности Yambda:

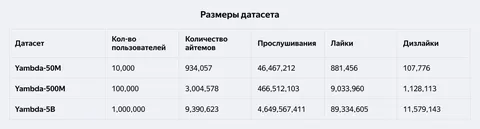
— Содержит 4,79 млрд обезличенных взаимодействий пользователей с музыкальными треками в Яндекс Музыке.
— Есть три версии: полная (5 млрд событий) и уменьшенные (500 млн и 50 млн
событий).
— Включает два основных типа взаимодействий: неявную обратную связь (прослушивания) и явную обратную связь (лайки, дизлайки, анлайки и андизлайки).
— Для большинства треков есть нейросетевые вектора, сгенерированные с помощью свёрточной нейронной сети (CNN), что позволяет учитывать некоторые характеристики музыкальных треков.
— Включены анонимизированные признаки метаданных треков, такие как длительность, содержание вложений, исполнитель и альбом.
— Каждое событие помечено флагом is_organic, который позволяет различать органические действия пользователей и действия, вызванные рекомендациями алгоритма.
— Все события имеют временные метки, что позволяет проводить анализ временных последовательностей и оценивать алгоритмы в условиях, приближённых к реальным.
— Данные распределены в формате Apache Parquet, что обеспечивает совместимость с распределёнными системами обработки данных (например, Hadoop, Spark) и современными аналитическими инструментами (например, Polars, Pandas).

Методы оценки

В отличие от метода Leave-One-Out (LOO), который исключает последнее положительное взаимодействие пользователя из обучающей выборки для предсказания, Yambda-5B использует глобальный временной сплит (Global Temporal Split, GTS). Преимущество GTS в том, что он сохраняет временную последовательность событий, предотвращая нарушение временных зависимостей между тренировочным и тестовым наборами данных. Это позволяет более точно оценить, как модель будет работать в реальных условиях, когда доступ к будущим данным ограничен или невозможен.

Вместе с датасетом представлены baseline-алгоритмы (MostPop, DecayPop, ItemKNN, iALS, BPR, SANSA, SASRec). Они служат отправной точкой для сравнения эффективности новых подходов в области рекомендательных систем.

Используются следующие метрики:

— NDCG@k (Normalized Discounted Cumulative Gain) — оценивает качество ранжирования рекомендаций.
— Recall@k — измеряет способность алгоритма генерировать релевантные рекомендации из общего набора возможных рекомендаций.
— Coverage@k — показывает, насколько широко представлен каталог элементов в рекомендации.

Датасет и код для оценочных бейзлайнов уже доступны на Hugging Face, а статья — на arXiv.

UPD: Появилось видео выступления Саши Плошкина на ACM RecSys — оставим его здесь для истории 💫

Статью подготовили ❣ Александр Плошкин, Владислав Тыцкий, Алексей Письменный, Владимир Байкалов, Евгений Тайчинов, Артём Пермяков, Даниил Бурлаков, Евгений Крофто, Николай Савушкин

@RecSysChannel
4 230 просмотров · 53 реакций Открыть в Telegram · Открыть пост на сайте
Что делают в мире: LLM & RecSys. Часть 2/2

В одном из предыдущих постов мы обсуждали, что LLM оказывает значительное влияние на RecSys, и это проявляется не только в переносе архитектурных решений, но и в непосредственном применении языковых моделей. Сегодня обсудим несколько примечательных статей, вышедших в последние месяцы и демонстрирующих, как применение языковых моделей способно улучшать качество рекомендаций.

Real-time Ad retrieval via LLM-generative Commercial Intention for Sponsored Search Advertisin

Статья от Tencent, в которой LLM используются для кандидатогенерации в рекламе. Исследования последних лет показывали эффективность LLM в этом направлении, но подходы сводились к следующему: в офлайне строятся индексы документов, а в онлайне на основе запроса LLM генерирует подходящий индекс. Такой подход концептуально неплох, но имеет ряд недостатков с точки зрения как качества, так и эффективности инференса. Tencenet же делают следующее: в офлайне с помощью LLM генерируют «коммерческие предложения» (CI) для рекламного корпуса, строят динамический индекс формата {CI: Рекламные объявления} так, что одному CI ставится в соответствие сразу пачка объявлений. В онлайне же — отдельной затюненной LLM генерирует CI для запроса и по соответствующему CI достаёт объявления-кандидаты из офлайн-хранилища. Такой формат хранения ключей позволяет значительно лучше утилизировать способности LLM к обработке, внезапно, естественного языка и отлично себя показывает на онлайн-метриках: на различных поверхностях прирост GMV составил от 5,02% до 6,37%.

The Blessing of Reasoning: LLM-Based Contrastive Explanations in Black-Box Recommender Systems

Гигантская статья с участием небезызвестной Minmin Chen. Представим, что нам удалось построить хорошую рекомендательную модель, которая прекрасно работает в продакшене. Но как для самих исследователей, так и для внешнего мира (и внутренних заказчиков) может быть интересно и важно, почему система приняла именно такое решение. Это банально интересно, позволяет лучше понять аудиторию, да и просто это отличные вводные для улучшений в будущем. К сожалению, ответить на вопрос почему крайне сложно, особенно если модель нейросетевая — сложность архитектуры просто не позволяет связать входы и выходы модели и составить понятную интерпретацию. Но буквально по соседству продолжается бурное развитие LLM — с глубоким знанием о мире и потрясающей способностью к рассуждению. Мы можем делегировать reasoning-моделям задачу «понимания» пользователя и поиск наиболее важных точек соприкосновения между ним и товаром-кандидатом, чтобы получить обоснование релевантности. Авторы показывают, что помимо хорошей объясняющей способности, добавление в рекомендательную систему знания LLM о мире также позволяет добиться лучшего качества на публичных датасетах.

LLM-Alignment Live-Streaming Recommendation

Статья от Kuaishou, где авторы пытаются объединить RecSys, LLM, мультимодальность — и всё это упаковать в реалтаймовый сценарий. Сначала происходит подготовка языковой модели для стриминга: используют 100B модель для разметки 30-секундных видеофрагметов, на основе которых тюнят 7B-модель для быстрого инференса, чтобы в реалтайме строить высокоинформативные эмбеддинги, которые далее передаются рекомендательной модели. LLM-эмбеддинги выравнивают с рекомендательными id-based-эмбеддингами с помощью отдельного гейтинг-механизма, чтобы получить итоговое представление, связывающее рекомендательный сигнал автора, пользователя и LLM-знание о происходящем на стриме. Полученный единый эмбеддинг переводят в Semantic ID и используют в итоговой модели ранжирования. A/B-эксперимент показал рост времени просмотра на двух стриминговых платформах на 0,07% и 0,17%, число лайков на 2,5% и 2,8% соответственно на стадии ранжирования. При этом особенно сильный рост числа показов наблюдается для контент-мейкеров с хвоста распределения, с числом подписчиков до порядка 100~1000.

@RecSysChannel
Обзор подготовил ❣ Руслан Кулиев
2 292 просмотров · 17 реакций Открыть в Telegram · Открыть пост на сайте
Unified Embedding: Battle-Tested Feature Representations for Web-Scale ML Systems

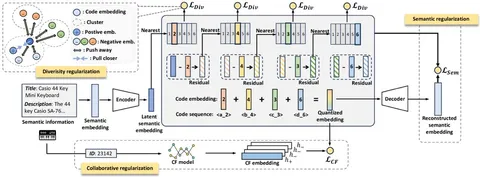
Сейчас в RecSys много говорят о семантических ID для кодирования айтемов. У нас в «Рекомендательной» уже были материалы о разных алгоритмах с этой техникой:

• Recommender Systems with Generative Retrieval
• From Features to Transformers: Redefining Ranking for Scalable Impact
• OneRec: Unifying Retrieve and Rank with Generative Recommender and Iterative Preference Alignment
• Learnable Item Tokenization for Generative Recommendation

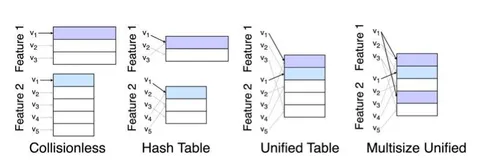
Но также вспомним классические методы кодирования айтемов. Один из популярных и очень мощных на практике — Multisize Unified Embeddings. Он предоставляет способ кодирования набора категориальных признаков произвольной кардинальности в единый вектор.

Как это работает.

Пусть дан набор айтемов D={x₁,…,x_N}. Каждый из них описан T категориальными признаками x = [v₁,…,v_T], где vₜ∈Vₜ.

Классические подходы к кодированию

1. Collisionless (без коллизий)
– Для каждого признака t и каждого его значения vₜ хранится отдельный вектор-эмбеддинг.
– Плюс: нет коллизий.
– Минус: память растёт пропорционально сумме кардинальностей всех Vₜ.

2. Hash Table (feature hashing)
– Каждое значение одного признака хешируется в таблицу размера M.
– Плюс: фиксированный объём памяти, независимо от числа значений.
– Минус: внутрипризнаковые коллизии искажают градиенты и ухудшают качество.

Подход Unified Table

Авторы предлагают объединить всё в одну общую хеш-таблицу размера M, но использовать для каждого признака свою хеш-функцию hₜ:
– Плюс: только одна таблица, всего два гиперпараметра (M и параметры хеша).
– Минус: появляются межпризнаковые коллизии, когда значения разных признаков попадают в один и тот же бакет.

Полученные эмбеддинги всех признаков конкатенируют, а затем подают в последующую нейросеть.

Теоретический анализ из статьи показывает:
– Межпризнаковые коллизии (случай t≠s, когда hₜ(v) и hₛ(u) уходят в один бакет) нейтрализуются последующей нейросетью: для каждой группы модель учит почти ортогональные проекции. Такие коллизии не влияют на качество.
– Внутрипризнаковые коллизии (разные v₁,v₂∈Vₜ хешируются в один бакет) создают устойчивое смещение градиента и ухудшают качество решаемой задачи.

Улучшение: Multisize Unified Table

Для каждого признака t вместо одного хеша используют сразу k независимых хеш-функций hₜ¹…hₜᵏ→[1…M].
– «Плохие» внутрипризнаковые коллизии почти исчезают;
– Объём памяти остаётся таким же, как в Unified Table.

Итог

Multisize Unified Embeddings дают качество, сопоставимое с отдельными таблицами эмбеддингов, но требуют в разы меньше памяти и отлично масштабируются на web-scale.

@RecSysChannel
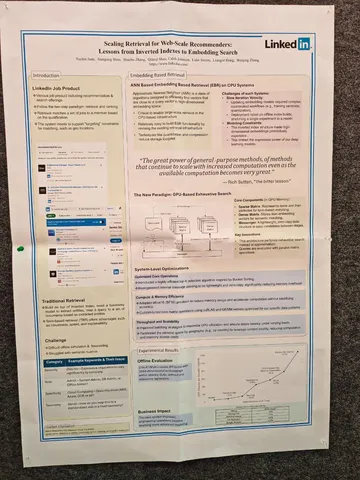
Разбор подготовил ❣ Артём Матвеев
2 220 просмотров · 26 реакций Открыть в Telegram · Открыть пост на сайте
Learnable Item Tokenization for Generative Recommendation

Тренд на семантические ID развивается уже более полугода. Начало положила статья TIGER, в которой для генеративного ретривала контентные эмбеддинги айтемов квантовали с помощью RQ-VAE. Статья вышла ещё в 2023 году, но популярность к подходу начала приходить только после конференции RecSys в 2024-м.

В сегодняшней статье авторы предлагают модификацию алгоритма квантизации — Learnable Item Tokenization for Generative Recommendation (LETTER). Новый подход основан на трёх идеях:

1. сохранение иерархичности семантической квантизации;
2. контрастивное сближение квантизаций и коллаборативных эмбеддингов (полученных через предобученный SASRec или LightGCN);
3. сглаживание распределений айтемов по центроидам кодбуков.

Еще одно отличие от TIGER — для того чтобы генерировать валидные коды, используются префиксные деревья по аналогии со статьей How to Index Item IDs for Recommendation Foundation Models.

Отдельное спасибо авторам хочется выразить за подробный ablation study числа кодов в иерархии квантизации: они отмечают, что увеличение числа кодов не всегда улучшает работу модели из-за накопления ошибки при авторегрессивном инференсе без teacher forcing. Очень полезны и данные о числах эмбеддингов в кодбуках.

Несмотря на большой вклад статьи в развитие семантической квантизации, у этой техники всё ещё остаются нерешенные проблемы. Для его реализации нужны:

1. предобученная контентная модель (в их случае это LLaMA-7B);
2. предобученная коллаборативная модель (например, SASRec или LightGCN);
3. другой подход к экспериментам — сейчас они, как правило, проводятся на открытых датасетах без time-split, из-за этого применимость метода в индустрии пока под вопросом.

@RecSysChannel
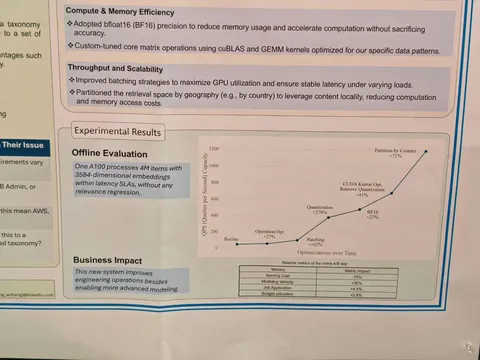
Разбор подготовил ❣ Сергей Макеев
2 211 просмотров · 17 реакций Открыть в Telegram · Открыть пост на сайте